兩個 AI 可見性檢查器可以在同一天讀同一批回答,卻給出完全相反的結論。一個回傳引用數量,另一個什麼都不回傳,因為那段回答點名推薦了你的品牌,卻從未連結到它。
我們在 2026 年 9 月跨三個 AI 介面跑了 20 個提示詞,並在每一條回答上記錄了兩個訊號:回答在正文中點名的品牌,以及回答作為來源呈現的網域。這兩個訊號不是同一次測量的兩個視角。它們會在可預測的地方分開,而分開的那些地方正是報告裡最有用的部分。
簡短的版本:Perplexity 在每一個提示詞上都引用了來源,Gemini 平均每條回答回傳 47 條來源標註,而 ChatGPT 在 20 個提示詞中有 12 個完全沒有回傳引用,卻仍在那其中 13 個裡點名了廠商。單一介面上的重複執行波動是另一個問題,我們此前在 AI 可見性追蹤器的執行波動 中測量過。
我們跑了什麼
項目 | 設定 |
|---|---|
提示詞 | 買家會問的 20 個關於 AI 可見性工具的問題 |
介面 | ChatGPT(gpt-5-2025-08-07)、Gemini(gemini-2.5-flash)、Perplexity(sonar) |
網路搜尋 | 三個介面全部開啟 |
地區與語言 | 美國,英語 |
日期 | 2026 年 9 月 12 日 |
收集到的回答 | 60 條 |
整輪執行成本 | $1.444,即每條回答 $0.024 |
重複執行 | 把同樣的 5 個提示詞再跑一遍,看行為是否穩定 |
每條回答的成本從 Perplexity 的 $0.006 到 Gemini 的 $0.037 不等。最便宜的介面產出了最一致的來源清單,而最貴的介面並不是回傳來源最多的那一個。
分別測量這兩個訊號
每條回答都被捕獲了兩次:一次作為文字,一次作為該介面附加到這段文字上的來源清單。
介面 | 來源標註 | 每條回答 | 零引用的回答 | 每條回答的不同網域數 |
|---|---|---|---|---|
ChatGPT(gpt-5) | 90 | 0 到 18,中位數 0 | 20 條中 12 條 | 0 到 10 |
Gemini 2.5 Flash | 989 | 14 到 122,中位數 47 | 20 條中 0 條 | 3 到 23 |
Perplexity | 399 | 19 到 20 | 20 條中 0 條 | 16 到 20 |
這三份清單不是同一類物件,而這正是檢查器最先搞錯的地方。
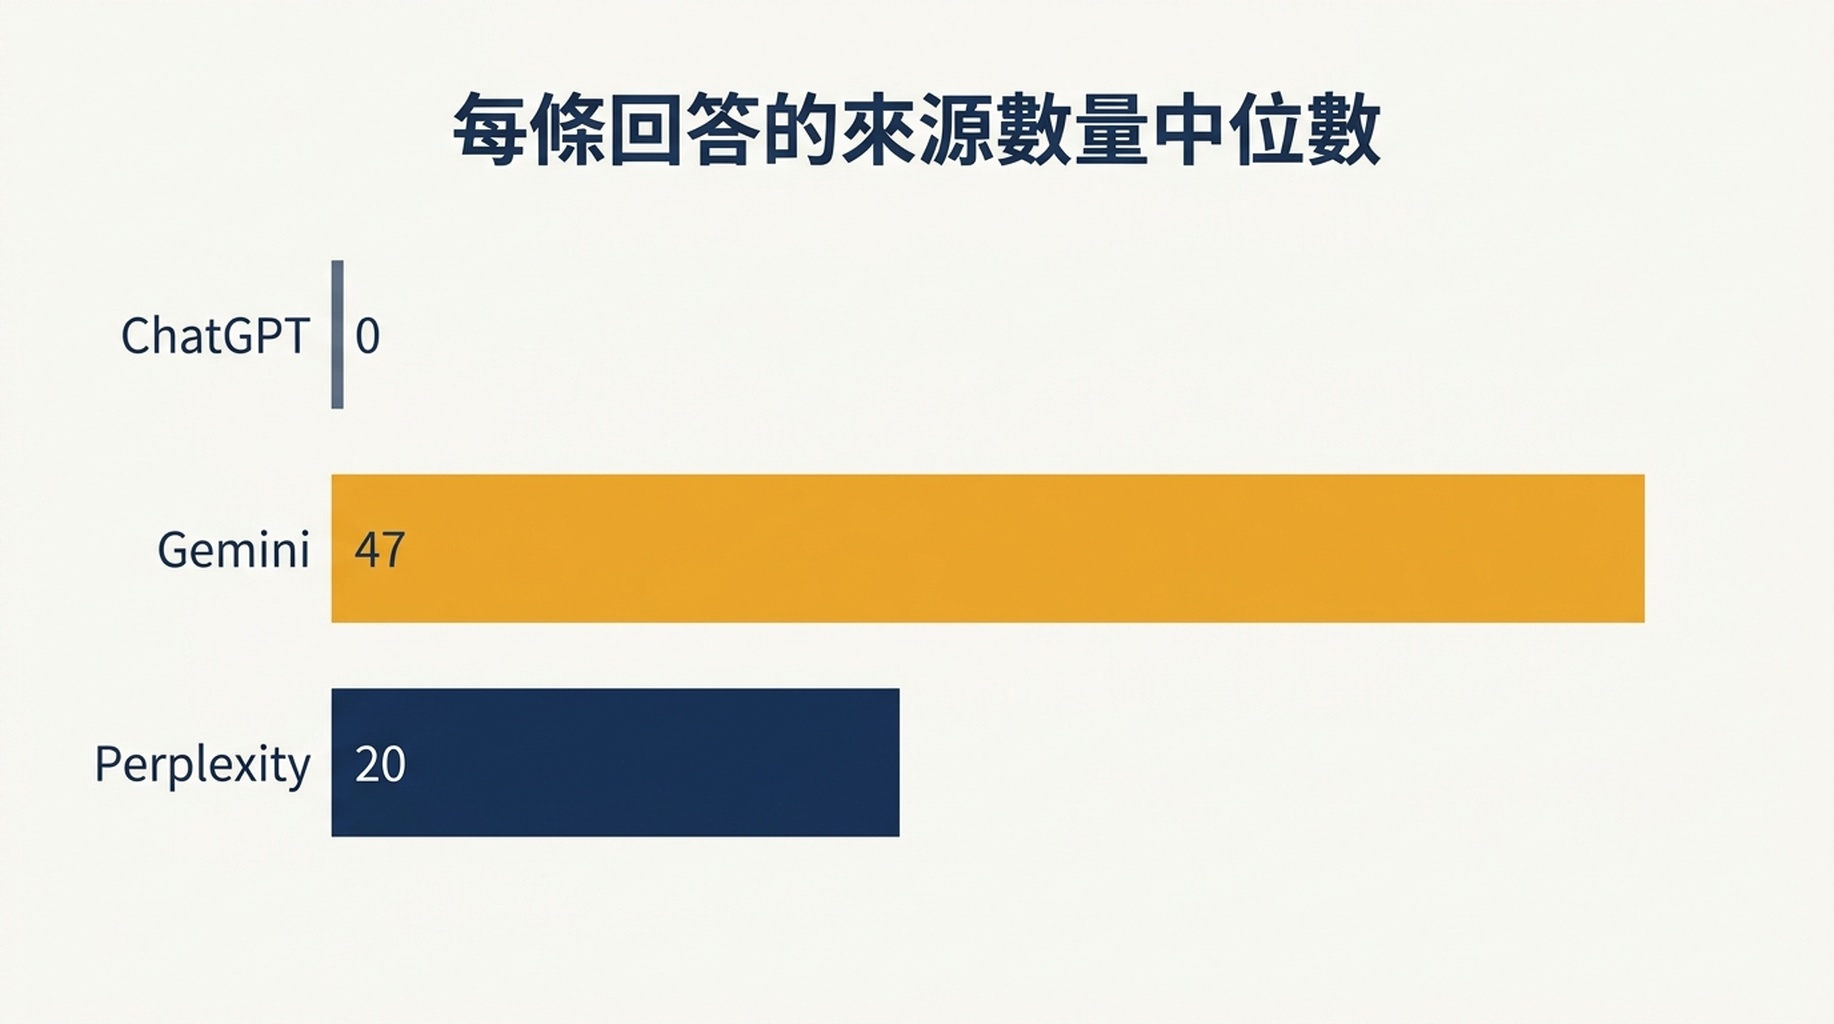
Gemini 幾乎給每一條主張都附上來源。同一個頁面可以在一條回答裡佔據許多個位置,這也是數量之所以這麼高的原因:在 20 條 Gemini 回答中,semrush.com 佔了 44 個位置,maxaeo.ai 佔 26 個,google.com 佔 22 個,adobe.com 佔 21 個,medium.com 佔 20 個。這個介面上的高標註數說的是模型拆解得有多細,而不是你的品牌有多廣為人知。
Perplexity 發布的是一個有上限的面板。它在 20 個提示詞中的 19 個上恰好回傳 20 條來源,在第 20 個上回傳 19 條。這就固定了分母:你在一條 Perplexity 回答中的份額永遠是 20 的份額,所以一個位置被拿到,就代表某個別處丟了一個位置。
ChatGPT 只在它搜尋過的時候才回傳來源清單。它在 20 個提示詞中的 8 個上發出了搜尋查詢,在另外 12 個上一無所引。在那 12 個上它仍然回答了問題,仍然點名了工具。舉一個未加編輯的例子:當被問到追蹤 AI 搜尋結果中品牌提及的最佳工具時,它列出了 Brand24、Mention、BuzzSumo、Talkwalker 和 Google Alerts,而這些都沒有附任何來源。我們用來稽核 ChatGPT 回答是否落入這種失敗模式的清單在 ChatGPT 可見性清單。
被點名卻未被引用
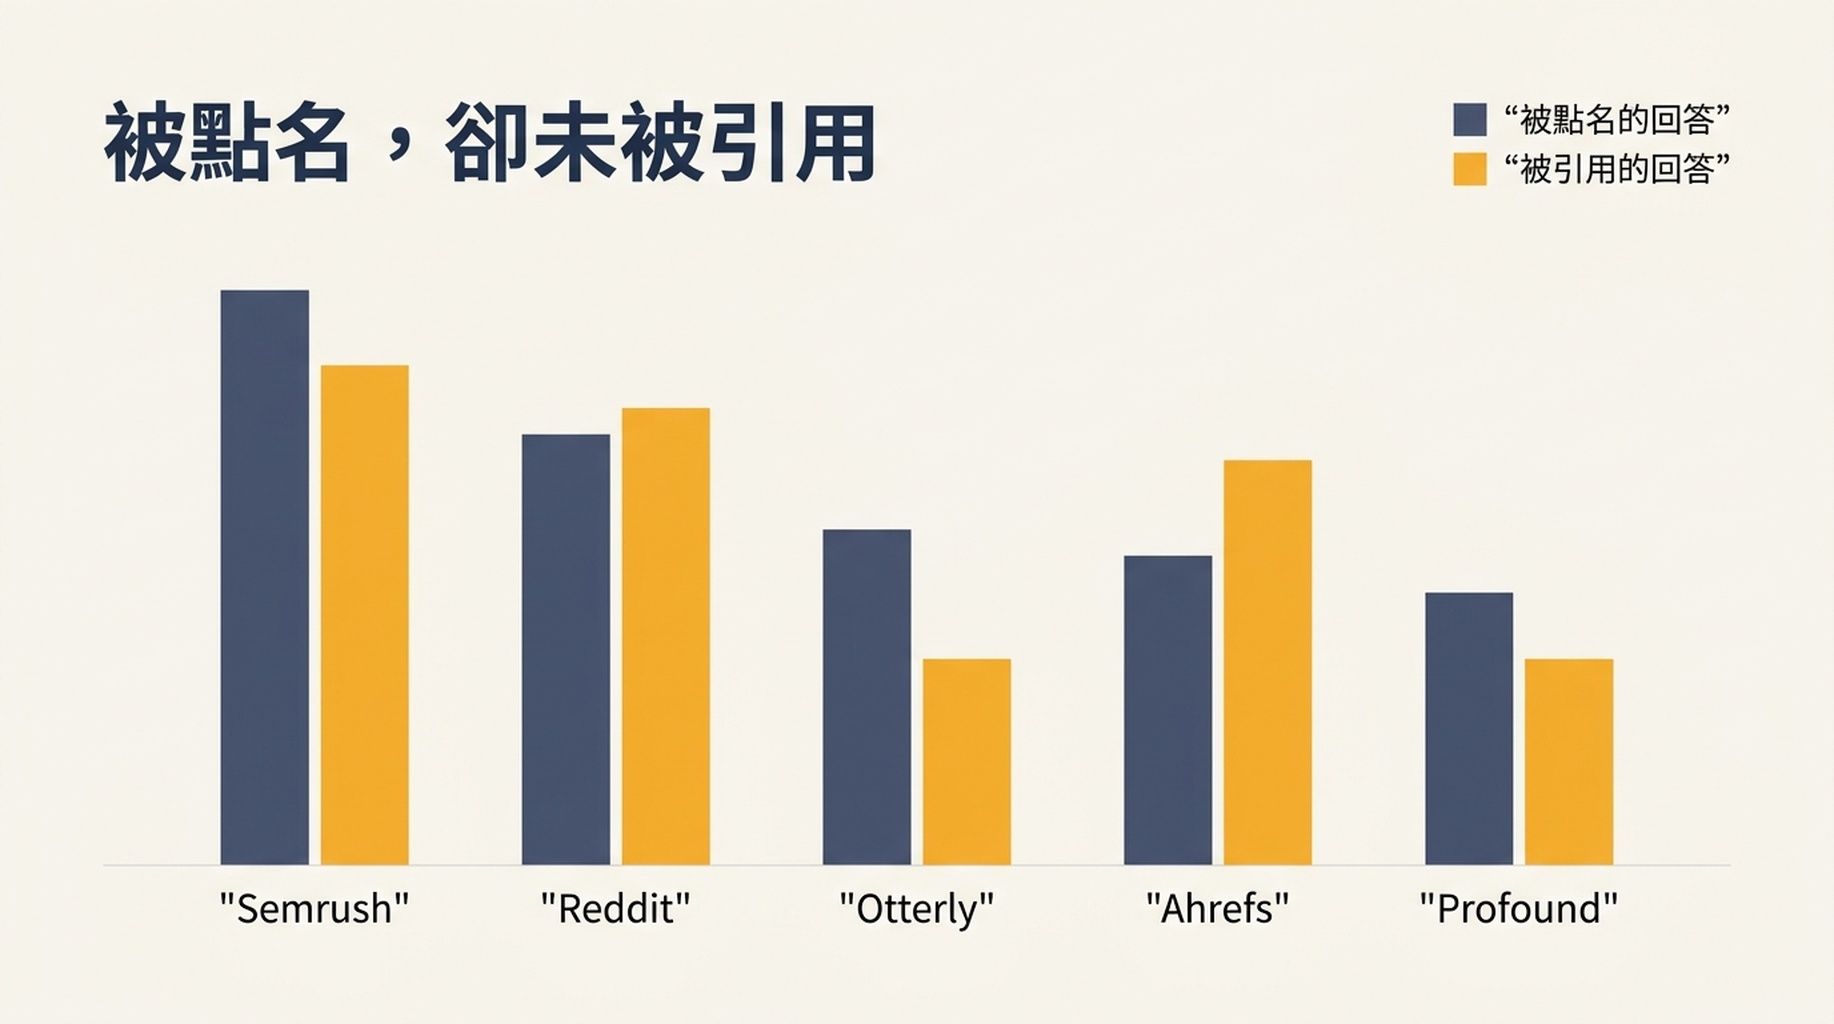
接著我們針對 27 個品牌與媒體,統計了 60 條回答中有多少條在正文裡點名了該品牌,有多少條把它的網域作為來源引用。這兩欄在兩個方向上都不一致。
品牌 | 點名它的回答 | 引用其網域的回答 |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
這張表裡有兩個模式。Peec AI、Otterly、Profound 和 ZipTie 在回答中被推薦的頻率遠高於它們的頁面被連結的頻率。MaxAEO、Cognizo、LLM Pulse、Searchable、AirOps 和 Menra 正好相反:它們的頁面作為來源被拉進來,而回答從未點出公司名。只看連結的檢查器會把第二組判為可見,把第一組判為不可見。只看提及的檢查器則相反。
在全部 60 條回答中,三個介面合計引用了 432 個不同網域。ChatGPT 佔其中 47 個,即 11 個百分點;Gemini 佔 184 個(43 個百分點);Perplexity 佔 285 個(66 個百分點)。無論你檢查哪個介面,你看到的都是一個大得多的來源宇宙中的一份樣本。這裡不包含 Google 自己的介面,那裡的存在感用另一種方式測量,我們的 AI Overview 追蹤器 對此有說明。
檢查器必須記錄什麼
一個只回傳單一數字的可見性檢查器,正在丟掉它四個欄位中的三個。值得留下的是這四個。
欄位 | 記錄形式 | 它為什麼改變結論 |
|---|---|---|
該介面是否搜尋過 | 是或否 | 未搜尋的回答不可能產生引用,所以它的零不是可見性訊號 |
回答正文中是否點名品牌 | 回答條數 | 這是無依據回答上唯一還活著的訊號 |
來源清單中是否有該網域 | 回答條數 | 這是大多數工具單獨報告的那個訊號 |
分母 | 回答條數,以及每條回答的來源位置數 | 固定 20 位的面板和 47 條標註的清單不能作為百分比相互比較 |
實際後果就是一個假的零。在我們的資料裡,ChatGPT 的 20 條回答中有 13 條至少點名了一個廠商,而只有 8 條引用了任何東西,所以這個介面大約四分之一的回答,會為同一條回答點名推薦的品牌報告零引用。
如何做這件事而不騙自己
如果你把這件事交給代理,失敗模式不是一個錯誤的數字,而是一個從從未被收集的欄位裡算出來的自信的數字。
- 在計算任何東西之前先捕獲原始酬載。保留回答文字、來源清單、模型識別碼,以及一個表示是否發出了搜尋查詢的布林值。衍生指標屬於第二步的程式碼裡,不屬於蒐集提示詞裡。
- 讓代理去引用,而不是去摘要。寫「報告品牌出現了多少次」的評分標準產出的是散文。寫「逐字回傳回答文字和來源清單」的評分標準產出的才是你能複核的資料。
- 在相信任何變化之前重跑同一個提示詞。我們重複了 5 個提示詞,搜尋與否的決定在 5 個中 5 個上一致,這意味著引用數的突然跳升更可能是模型版本或提示詞改動,而不是雜訊。
- 把模型識別碼留在每一行裡。同樣的 20 個提示詞在同一端點用 gpt-4o 跑,只有 20 條中的 2 條回傳了來源標註,而 gpt-5 是 20 條中的 8 條。
- 為它留預算。整整 60 條回答的執行花了 $1.444,所以按這些價格,同樣檢查的每週版本一個月約 $6。
限制
- 一天、一個地區、英語、三個介面。不同地區的回答會不一樣。
- 每個介面一個模型版本。在我們自己的執行中,行為在模型版本之間就動過。
- 品牌辨識是按名稱做的字串比對,所以只靠產品名被推薦的品牌可能被漏掉。
- 網路搜尋是透過 API 開啟的。消費級應用搜尋的頻率可能比這些執行多,也可能更少。
- 成本只涵蓋回答生成,不含儲存或複核時間。
常見問題
為什麼 ChatGPT 在 20 個提示詞中有 12 個報告零引用?
因為它在那些提示詞上沒有搜尋就作答了。一個從不檢索頁面的模型不可能引用頁面,所以那個零描述的是這次執行,不是你的品牌。在從任何聊天介面讀取引用數字之前,先確認該介面到底有沒有用網路。
如果沒有任何連結,在回答裡被點名還有價值嗎?
在一條無依據的回答上,它就是訊號的全部,而且它也是先於連結出現的那個訊號。在我們的資料裡,提及與連結來自不同的來源:提及跟隨比較類與評測類內容,引用跟隨被結構化得便於被引用的頁面。
我應該把提及和引用合併成一個可見性分數嗎?
不應該。正如品牌表所示,它們在兩個方向上都系統性地不一致,合併後的分數會掩蓋到底是哪一個動了。把它們作為兩條線報告,讓讀者看見那道差距。
我應該先檢查哪個介面?
如果你想要一個穩定、便宜、寬度固定的面板,就選 Perplexity,因為它的清單長度不變。如果你想要廣度,就選 Gemini,它觸達了我們看到的 432 個網域中的 184 個。ChatGPT 只在附帶有效性檢查時才用,否則它五分之一的回答會把一個品牌讀成不可見。
Auspia 觀點:把提及和引用作為兩條獨立的線來報告,並在記錄任何其他東西之前先記錄該介面是否搜尋過。單一的可見性分數恰好掩蓋了那道告訴你下一步該修什麼的差距,而在我們的資料裡,最便宜的修法不是增加內容,而是去檢查一個真正看過網路的介面。
作者:阿德裡安·科爾