Dos verificadores de visibilidad en IA pueden leer las mismas respuestas el mismo día y llegar a veredictos opuestos. Uno devuelve el recuento de citas, el otro no devuelve nada, porque la respuesta nombró tu marca y la recomendó sin enlazarla ni una sola vez.
En septiembre de 2026 ejecutamos veinte prompts en tres superficies de IA y registramos, en cada respuesta, dos señales: la marca que la respuesta nombró en el texto y el dominio que la respuesta presentó como fuente. No son dos ángulos de una misma medición. Divergen en puntos predecibles, y esos puntos son la parte más útil del informe.
La versión corta: Perplexity citó fuentes en todos los prompts, Gemini devolvió una mediana de 47 fuentes por respuesta, y ChatGPT no devolvió ninguna cita en 12 de los 20 prompts, aunque aun así nombró proveedores en 13 de ellos. La variación entre ejecuciones en una misma superficie es otra cuestión, y la medimos antes en variación de ejecución del rastreador de visibilidad en IA.
Qué ejecutamos
Elemento | Configuración |
|---|---|
Prompts | Veinte preguntas que haría un comprador sobre herramientas de visibilidad en IA |
Superficies | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Búsqueda web | Activada en las tres superficies |
Región e idioma | Estados Unidos, inglés |
Fecha | 12 de septiembre de 2026 |
Respuestas recogidas | 60 |
Coste de la ejecución completa | 1,444 dólares, es decir 0,024 dólares por respuesta |
Repetición | Volvimos a ejecutar los mismos cinco prompts para ver si el comportamiento es estable |
El coste por respuesta fue de 0,006 dólares en Perplexity a 0,037 dólares en Gemini. La superficie más barata produjo la lista de fuentes más consistente, y la más cara no fue la que más fuentes devolvió.
Las dos señales, medidas por separado
Capturamos cada respuesta dos veces: una como texto y otra como la lista de fuentes que la superficie adjuntó a ese texto.
Superficie | Anotaciones de fuente | Por respuesta | Respuestas sin cita | Dominios distintos por respuesta |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | de 0 a 18, mediana 0 | 12 de 20 | de 0 a 10 |
Gemini 2.5 Flash | 989 | de 14 a 122, mediana 47 | 0 de 20 | de 3 a 23 |
Perplexity | 399 | de 19 a 20 | 0 de 20 | de 16 a 20 |
Estas tres listas no son el mismo tipo de objeto, y aquí es donde el verificador se equivoca primero.
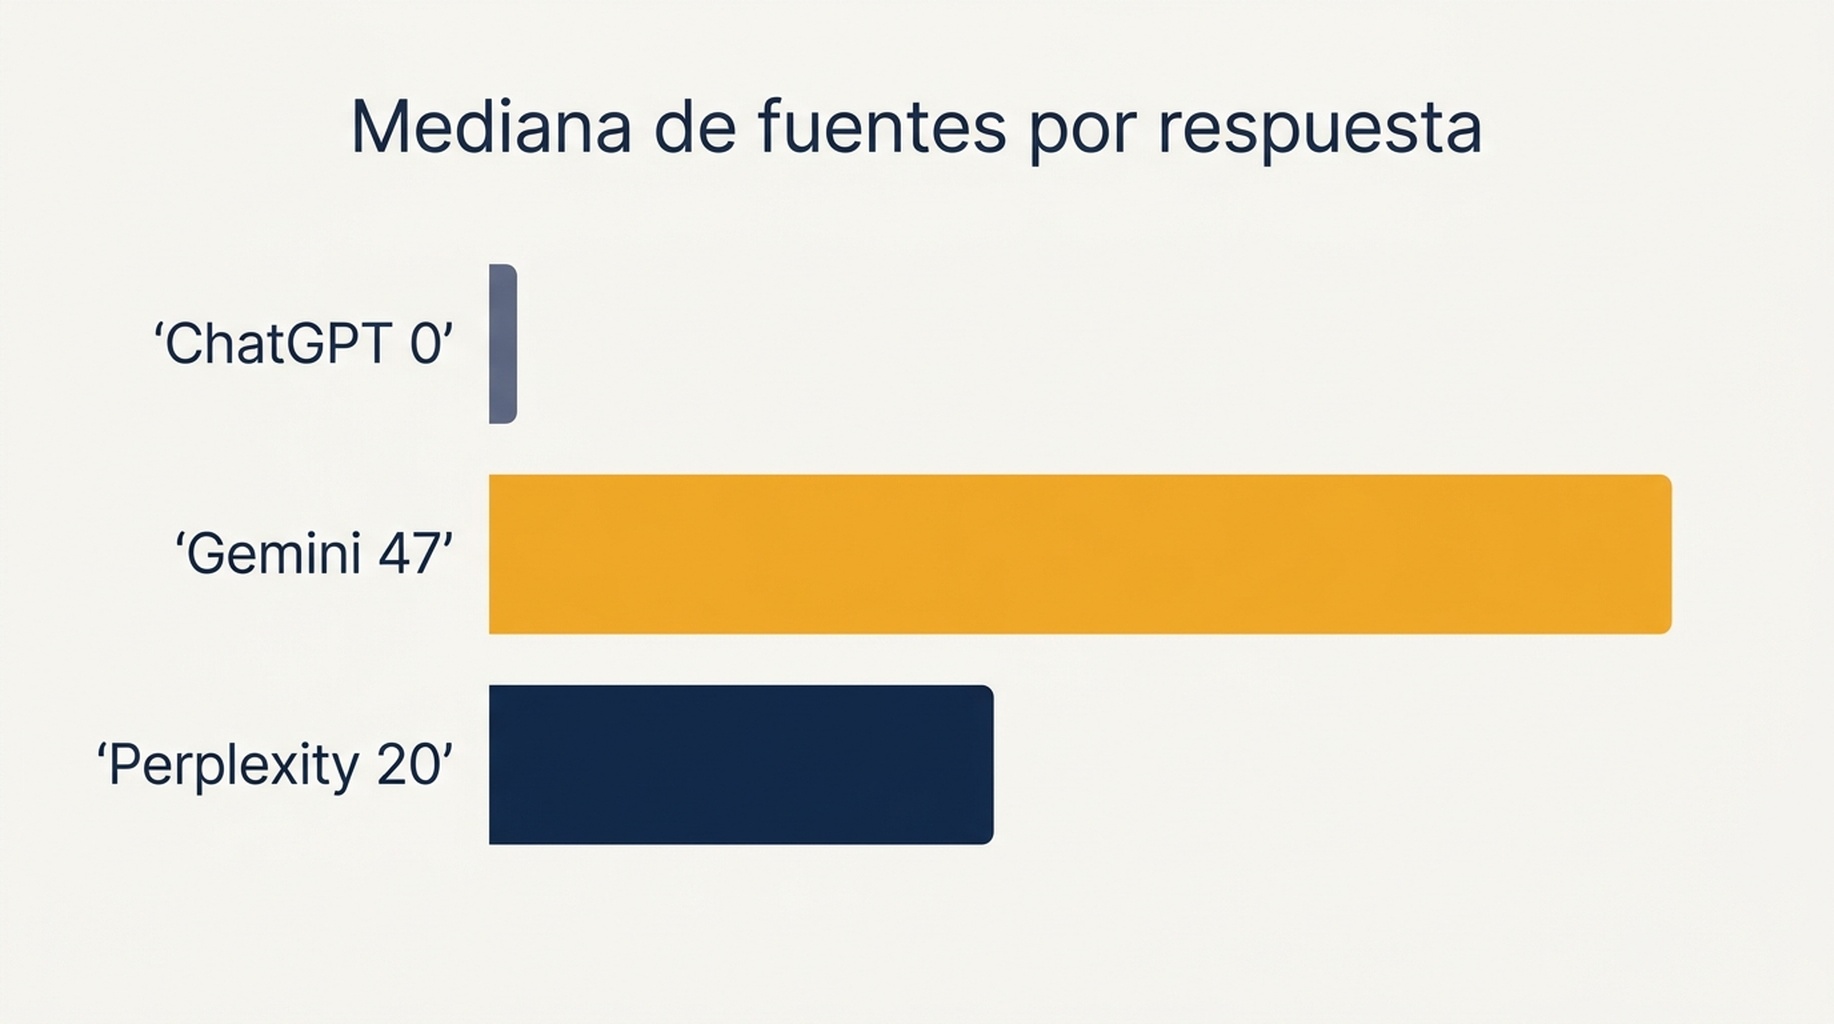
Gemini adjunta una fuente a casi todas las afirmaciones. Una misma página puede ocupar muchos lugares dentro de una sola respuesta, y por eso las cifras son tan altas: a lo largo de 20 respuestas de Gemini, el dominio semrush.com ocupó 44 lugares, maxaeo.ai veintiséis, google.com veintidós, adobe.com veintiuno y medium.com veinte. El recuento alto de anotaciones en esta superficie habla de lo fino que corta el modelo, no de lo conocida que sea tu marca.
Perplexity, en cambio, expone un panel con techo. Devolvió exactamente veinte fuentes en 19 de los 20 prompts y diecinueve en el vigésimo. Eso fija el denominador: tu cuota en una respuesta de Perplexity es siempre una cuota de veinte, así que conseguir un lugar significa que alguien perdió un lugar en otro sitio.
ChatGPT solo devuelve lista de fuentes cuando buscó. Lanzó una consulta de búsqueda en 8 de los 20 prompts y no citó nada en los otros doce. En esos doce igualmente respondió a la pregunta e igualmente nombró herramientas. Un ejemplo sin editar: al preguntarle por las mejores herramientas para seguir menciones de marca en resultados de búsqueda de IA, enumeró Brand24, Mention, BuzzSumo, Talkwalker y Google Alerts, sin ninguna fuente adjunta a ninguna de ellas. La lista de comprobación que usamos para auditar respuestas de ChatGPT en busca de este modo de fallo está en lista de comprobación de visibilidad en ChatGPT.
Nombrada sin ser citada
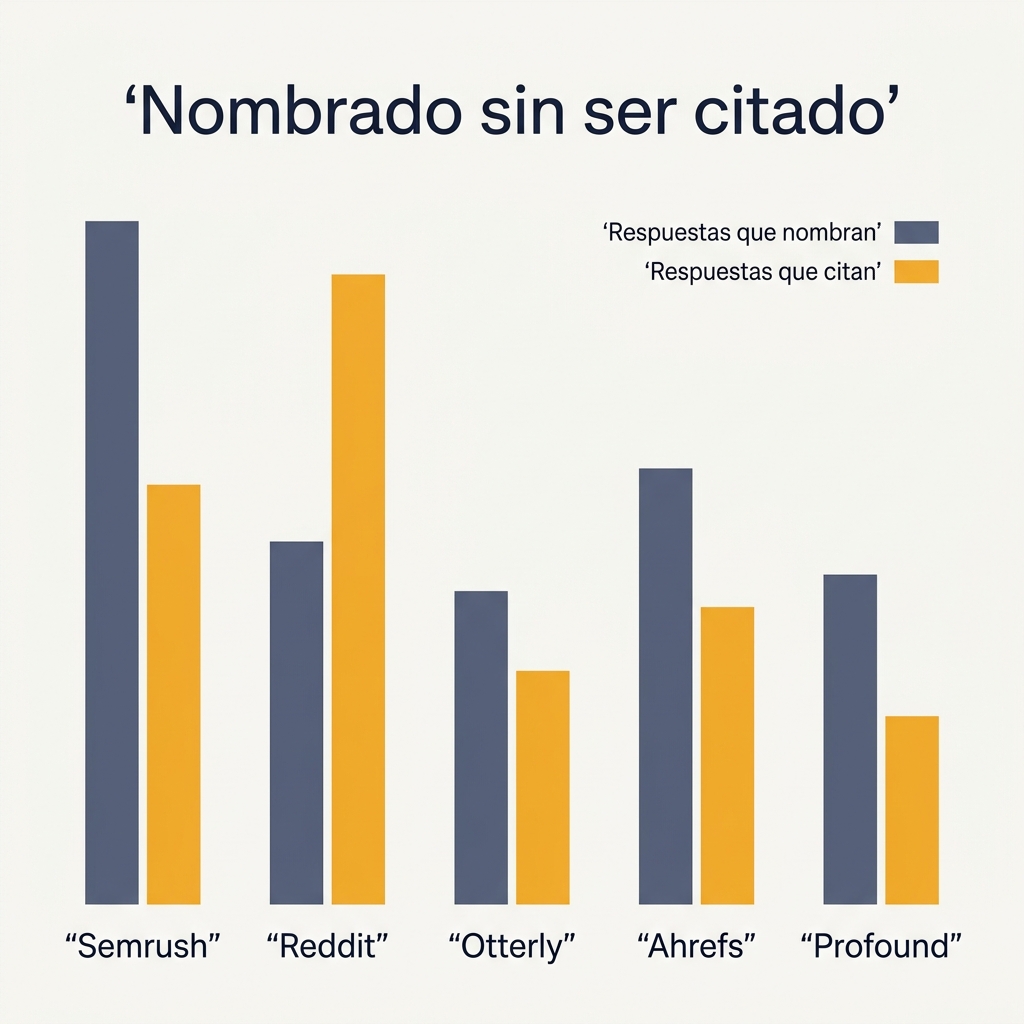
Después contamos, para 27 marcas y medios, en cuántas de las 60 respuestas se nombró la marca en el texto y en cuántas se citó su dominio como fuente. Las dos columnas divergen en ambos sentidos a la vez.
Marca | Respuestas que la nombraron | Respuestas que citaron su dominio |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
Hay dos patrones en esta tabla. Peec AI, Otterly, Profound y ZipTie se recomiendan en las respuestas muchas más veces de las que se enlazan sus páginas. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps y Menra son lo contrario: sus páginas se arrastran como fuentes mientras la respuesta nunca nombra a la empresa. Un verificador que solo mira enlaces juzga visible al segundo grupo e invisible al primero. Un verificador que solo mira menciones hace lo contrario.
A lo largo de las 60 respuestas, las tres superficies juntas citaron 432 dominios distintos. ChatGPT aporta 47 de ellos, es decir 11 por ciento, Gemini 184 (43 por ciento) y Perplexity 285 (66 por ciento). Mires la superficie que mires, estás viendo una muestra de un universo de fuentes mucho mayor. Esto no incluye la propia superficie de Google, donde la presencia se mide de otra forma, y lo explicamos en el rastreador de AI Overview.
Qué tiene que registrar un verificador
Un verificador de visibilidad que devuelve un solo número está tirando tres de sus cuatro campos. Estos son los cuatro que merece la pena conservar.
Campo | Forma de registro | Por qué cambia el veredicto |
|---|---|---|
Si la superficie buscó | sí o no | Una respuesta que no buscó no puede generar citas, así que su cero no es señal de visibilidad |
Si la marca se nombró en el texto de la respuesta | número de respuestas | La única señal que sobrevive en una respuesta sin fundamento |
Si el dominio está en la lista de fuentes | número de respuestas | La señal que la mayoría de herramientas informa por sí sola |
El denominador | número de respuestas y número de huecos de fuente por respuesta | Un panel con veinte huecos fijos y una lista con 47 anotaciones no se pueden comparar como porcentaje |
La consecuencia práctica es el cero falso. En nuestros datos, 13 de las 20 respuestas de ChatGPT nombraron al menos un proveedor, mientras que solo 8 de 20 citaron algo, de modo que alrededor de un cuarto de las respuestas de esta superficie informará de cero citas para una marca que esa misma respuesta nombró y recomendó.
Cómo hacer esto sin engañarte
El modo de fallo cuando le entregas este trabajo a un agente no es un número equivocado, sino un número seguro de sí mismo calculado a partir de un campo que nunca se recogió.
- Captura la carga bruta antes de calcular nada. Guarda el texto de la respuesta, la lista de fuentes, el identificador del modelo y un booleano de si se lanzó una consulta de búsqueda. Las métricas derivadas se construyen en el código en una segunda etapa, no se meten dentro del prompt de recogida.
- Haz que el agente cite en lugar de resumir. Una rúbrica de «informa de cuántas veces apareció la marca» produce prosa. Una rúbrica de «devuelve literalmente el texto de la respuesta y la lista de fuentes» produce datos que puedes volver a comprobar.
- Vuelve a ejecutar el mismo prompt antes de creerte un cambio. Repetimos cinco prompts y la decisión de buscar coincidió en 5 de 5, así que un salto repentino en el número de citas es más probablemente una versión de modelo o una edición del prompt que ruido.
- Deja el identificador del modelo en cada fila. Los mismos veinte prompts en el mismo endpoint con gpt-4o devolvieron anotaciones de fuente en solo 2 de 20, frente a 8 de 20 con gpt-5.
- Reserva presupuesto. La ejecución completa de 60 respuestas costó 1,444 dólares, así que a estos precios una versión semanal de la misma comprobación ronda los 6 dólares al mes.
Límites
- Un día, una región, inglés, tres superficies. Las respuestas cambian de una región a otra.
- Una versión de modelo por superficie. Incluso en nuestras propias ejecuciones el comportamiento se movió entre versiones de modelo.
- La detección de marcas es coincidencia de cadenas por nombre, así que una marca recomendada solo por el nombre del producto puede pasarse por alto.
- La búsqueda web se activó vía API. Las aplicaciones de consumo pueden buscar más que estas ejecuciones, o menos.
- El coste cubre solo la generación de respuestas y no incluye tiempo de almacenamiento ni de revisión.
Preguntas frecuentes
¿Por qué ChatGPT informó de cero citas en 12 de los 20 prompts?
Porque respondió a esos prompts sin buscar. Un modelo que nunca recupera una página no puede citarla. Ese cero describe la ejecución, no tu marca. Antes de leer una cifra de citas de cualquier superficie de chat, comprueba primero si esa superficie usó la web.
¿Sirve de algo una mención si no hay ningún enlace?
En una respuesta sin fundamento es toda la señal, y además es la señal que llega antes que el enlace. En nuestros datos, mención y enlace se consiguen desde fuentes distintas: la mención sigue a contenido comparativo y de análisis, y la cita sigue a páginas estructuradas para ser citadas.
¿Debería fusionar menciones y citas en una sola puntuación de visibilidad?
No. Como muestra la tabla de marcas, divergen sistemáticamente en ambos sentidos, y una puntuación fusionada esconde cuál de las dos se movió. Infórmalas como dos líneas y deja que el lector vea la brecha.
¿Qué superficie debería comprobar primero?
Si quieres un panel estable, barato y de ancho fijo, elige Perplexity, porque la longitud de su lista no cambia. Si quieres amplitud, elige Gemini, que alcanzó 184 de los 432 dominios que vimos. ChatGPT solo con una comprobación de plausibilidad al lado, porque si no, una quinta parte de sus respuestas se leerá como marca invisible.
Visión de Auspia: informa de menciones y citas como dos líneas separadas y registra si la superficie buscó antes de registrar cualquier otra cosa. Una puntuación única de visibilidad esconde justamente la brecha que te dice qué arreglar después, y el arreglo más barato en nuestros datos no fue añadir contenido, sino comprobar una superficie que de verdad miró a la web.
Autoría: Adrian Cole