Deux vérificateurs de visibilité dans l'IA peuvent lire les mêmes réponses le même jour et rendre des verdicts opposés. L'un renvoie un nombre de citations, l'autre ne renvoie rien, parce que la réponse a nommé votre marque et l'a recommandée sans jamais la lier.
En septembre 2026, nous avons lancé vingt prompts sur trois surfaces d'IA et relevé, sur chaque réponse, deux signaux : la marque que la réponse a nommée dans le texte et le domaine que la réponse a présenté comme source. Ce ne sont pas deux angles d'une même mesure. Ils divergent à des endroits prévisibles, et ces endroits sont la partie la plus utile du rapport.
La version courte : Perplexity a cité des sources sur chaque prompt, Gemini a renvoyé une médiane de 47 sources par réponse, et ChatGPT n'a renvoyé aucune citation sur 12 des 20 prompts, tout en nommant des fournisseurs sur 13 d'entre eux. La variabilité entre exécutions sur une même surface est une autre question, et nous l'avons mesurée plus tôt dans variabilité d'exécution du traceur de visibilité dans l'IA.
Ce que nous avons lancé
Élément | Réglage |
|---|---|
Prompts | Vingt questions qu'un acheteur poserait sur les outils de visibilité dans l'IA |
Surfaces | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Recherche web | Activée sur les trois surfaces |
Région et langue | États-Unis, anglais |
Date | 12 septembre 2026 |
Réponses collectées | 60 |
Coût de l'exécution complète | 1 444 dollars, soit 0,024 dollar par réponse |
Répétition | Nous avons relancé les cinq mêmes prompts pour voir si le comportement est stable |
Le coût par réponse allait de 0,006 dollar chez Perplexity à 0,037 dollar chez Gemini. La surface la moins chère a produit la liste de sources la plus cohérente, et la plus chère n'était pas celle qui renvoyait le plus de sources.
Les deux signaux, mesurés séparément
Nous avons capturé chaque réponse deux fois : une fois sous forme de texte, une fois sous forme de la liste de sources que la surface a attachée à ce texte.
Surface | Annotations de source | Par réponse | Réponses sans citation | Domaines distincts par réponse |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | de 0 à 18, médiane 0 | 12 sur 20 | de 0 à 10 |
Gemini 2.5 Flash | 989 | de 14 à 122, médiane 47 | 0 sur 20 | de 3 à 23 |
Perplexity | 399 | de 19 à 20 | 0 sur 20 | de 16 à 20 |
Ces trois listes ne sont pas le même type d'objet, et c'est ici que le vérificateur se trompe en premier.
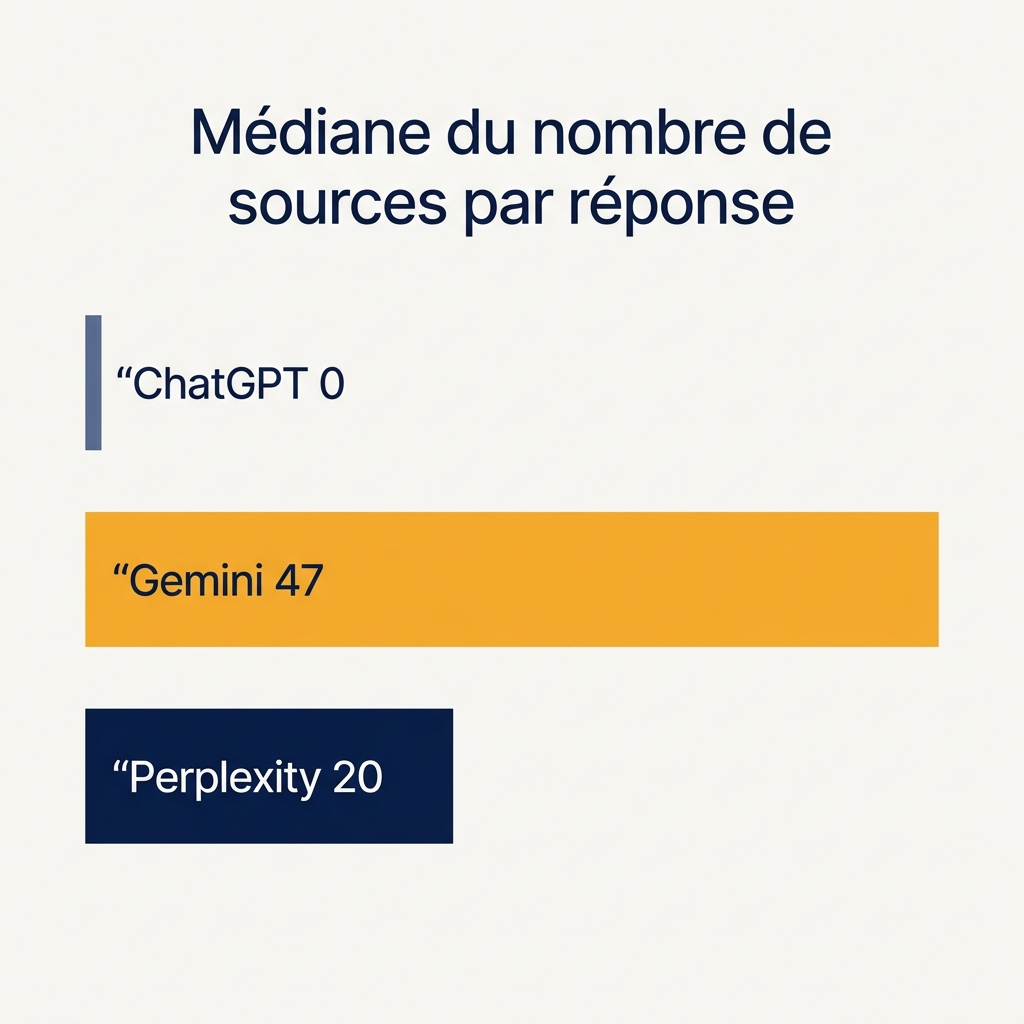
Gemini attache une source à presque chaque affirmation. Une même page peut occuper de nombreux emplacements dans une seule réponse, et c'est pourquoi les chiffres sont si élevés : sur 20 réponses de Gemini, le domaine semrush.com a occupé 44 emplacements, maxaeo.ai vingt-six, google.com vingt-deux, adobe.com vingt et un et medium.com vingt. Le nombre élevé d'annotations sur cette surface dit à quel point le modèle découpe finement, pas à quel point votre marque est connue.
Perplexity, lui, expose un panneau plafonné. Il a renvoyé exactement vingt sources sur 19 des 20 prompts et dix-neuf sur le vingtième. Cela fixe le dénominateur : votre part dans une réponse Perplexity est toujours une part sur vingt, donc gagner une place signifie que quelqu'un a perdu une place ailleurs.
ChatGPT ne renvoie une liste de sources que lorsqu'il a cherché. Il a émis une requête de recherche sur 8 des 20 prompts et n'a rien cité sur les douze autres. Sur ces douze, il a tout de même répondu à la question et tout de même nommé des outils. Un exemple non retouché : interrogé sur les meilleurs outils pour suivre les mentions de marque dans les résultats de recherche IA, il a énuméré Brand24, Mention, BuzzSumo, Talkwalker et Google Alerts, sans aucune source attachée à aucun d'entre eux. La liste de contrôle dont nous nous servons pour auditer les réponses de ChatGPT sur ce mode de défaillance se trouve dans liste de contrôle de visibilité dans ChatGPT.
Nommée sans être citée
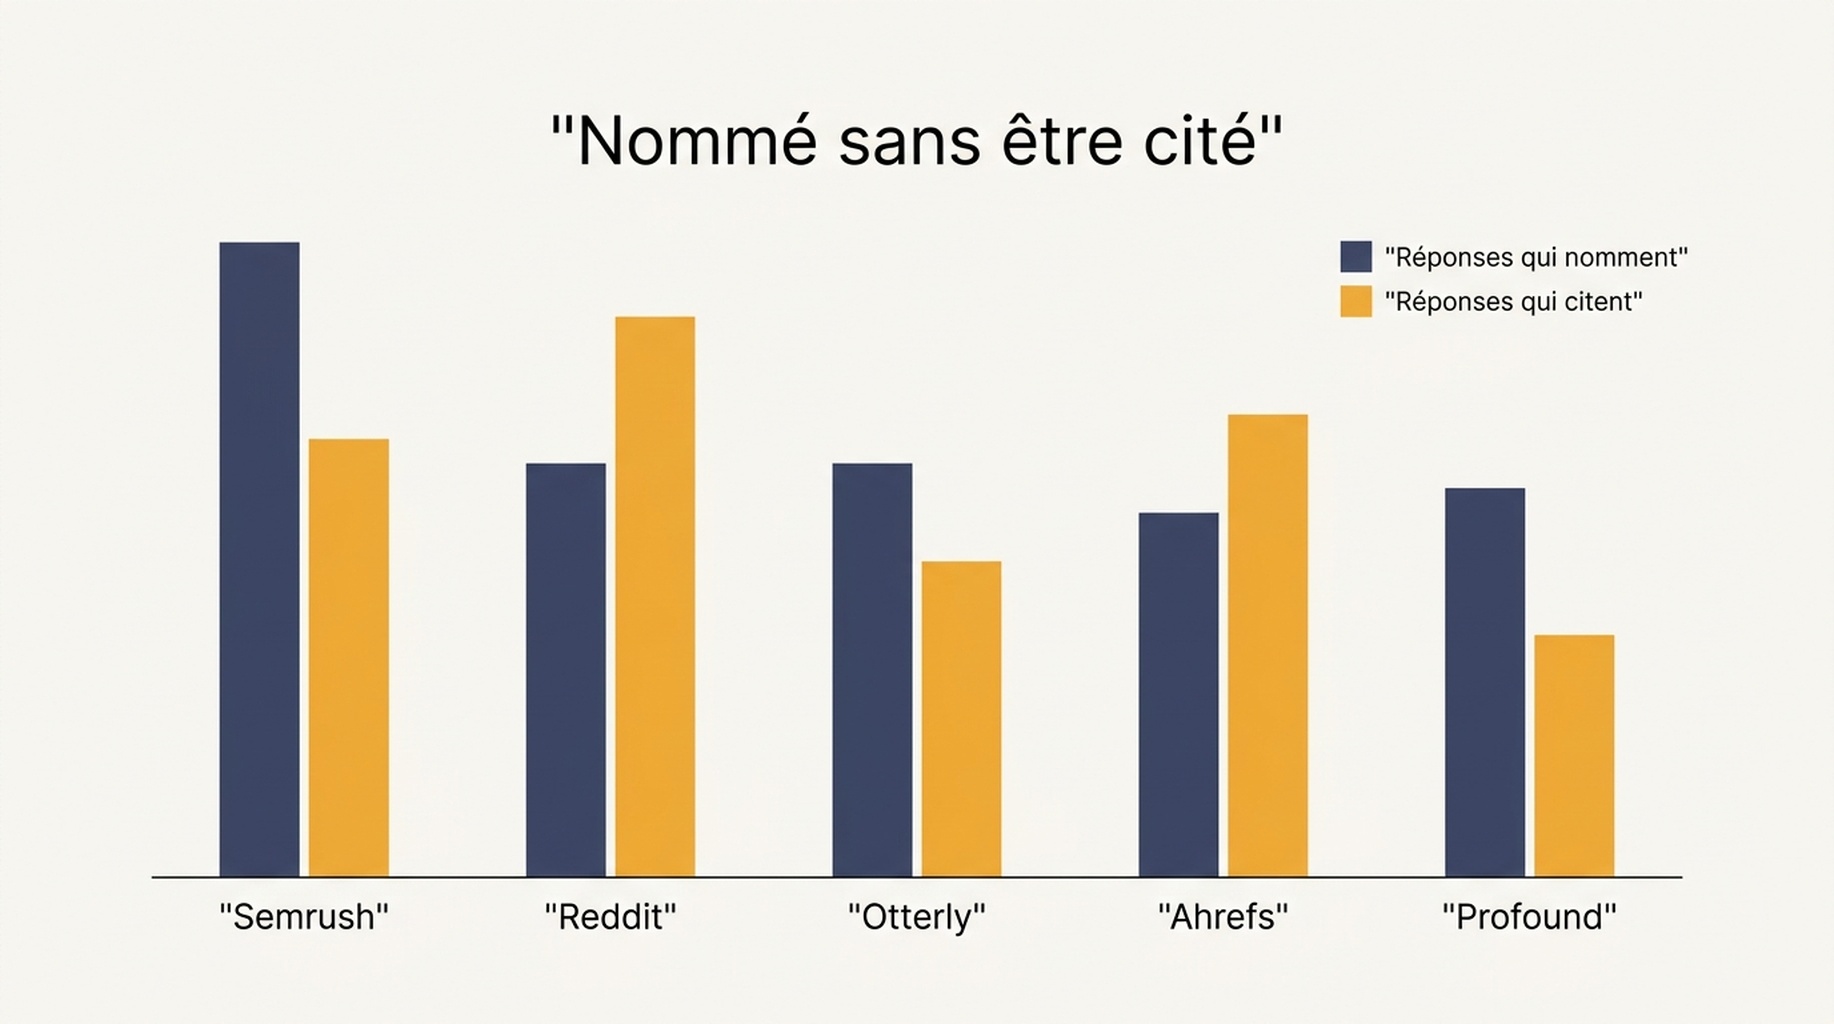
Nous avons ensuite compté, pour 27 marques et médias, sur combien des 60 réponses la marque était nommée dans le texte et sur combien son domaine était cité comme source. Les deux colonnes divergent dans les deux sens à la fois.
Marque | Réponses qui l'ont nommée | Réponses qui ont cité son domaine |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
Il y a deux motifs dans ce tableau. Peec AI, Otterly, Profound et ZipTie sont recommandées dans les réponses bien plus souvent que leurs pages ne sont liées. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps et Menra, c'est l'inverse : leurs pages sont tirées comme sources alors que la réponse ne nomme jamais l'entreprise. Un vérificateur qui ne regarde que les liens juge le second groupe visible et le premier invisible. Un vérificateur qui ne regarde que les mentions fait l'inverse.
Sur l'ensemble des 60 réponses, les trois surfaces ont cité ensemble 432 domaines distincts. ChatGPT en représente 47, soit 11 pour cent, Gemini 184 (43 pour cent) et Perplexity 285 (66 pour cent). Quelle que soit la surface que vous vérifiez, vous regardez un échantillon d'un univers de sources bien plus vaste. Cela n'inclut pas la surface de Google elle-même, où la présence se mesure autrement, ce que nous expliquons dans le traceur d'AI Overview.
Ce qu'un vérificateur doit enregistrer
Un vérificateur de visibilité qui renvoie un seul chiffre jette trois de ses quatre champs. Voici les quatre qui valent la peine d'être conservés.
Champ | Forme d'enregistrement | Pourquoi cela change le verdict |
|---|---|---|
La surface a-t-elle cherché | oui ou non | Une réponse qui n'a pas cherché ne peut pas produire de citations, son zéro n'est donc pas un signal de visibilité |
La marque a-t-elle été nommée dans le texte de la réponse | nombre de réponses | Le seul signal qui survit sur une réponse sans fondement |
Le domaine figure-t-il dans la liste des sources | nombre de réponses | Le signal que la plupart des outils rapportent seul |
Le dénominateur | nombre de réponses, et nombre d'emplacements de source par réponse | Un panneau à vingt emplacements fixes et une liste à 47 annotations ne se comparent pas en pourcentage |
La conséquence pratique est le zéro fallacieux. Dans nos données, 13 des 20 réponses de ChatGPT ont nommé au moins un fournisseur, alors que 8 sur 20 seulement ont cité quoi que ce soit, soit environ un quart des réponses de cette surface qui rapporteront zéro citation pour une marque que cette même réponse a nommée et recommandée.
Comment faire cela sans se tromper soi-même
Le mode de défaillance quand vous confiez ce travail à un agent n'est pas un chiffre faux, mais un chiffre assuré calculé à partir d'un champ qui n'a jamais été collecté.
- Capturez la charge brute avant de calculer quoi que ce soit. Conservez le texte de la réponse, la liste des sources, l'identifiant du modèle et un booléen indiquant si une requête de recherche a été émise. Les métriques dérivées se construisent dans le code à une seconde étape, elles ne se mettent pas dans le prompt de collecte.
- Faites citer l'agent plutôt que résumer. Une grille du type « indique combien de fois la marque est apparue » produit de la prose. Une grille du type « renvoie mot pour mot le texte de la réponse et la liste des sources » produit des données que vous pouvez revérifier.
- Relancez le même prompt avant de croire à un changement. Nous avons répété cinq prompts et la décision de chercher concordait sur 5 cas sur 5, donc un bond soudain du nombre de citations relève plus probablement d'une version de modèle ou d'une modification de prompt que du bruit.
- Gardez l'identifiant du modèle sur chaque ligne. Les mêmes vingt prompts sur le même point d'entrée via gpt-4o n'ont renvoyé des annotations de source que sur 2 cas sur 20, contre 8 sur 20 avec gpt-5.
- Prévoyez un budget. L'exécution complète de 60 réponses a coûté 1 444 dollars, donc à ces tarifs une version hebdomadaire de la même vérification revient à environ 6 dollars par mois.
Limites
- Un jour, une région, l'anglais, trois surfaces. Les réponses diffèrent d'une région à l'autre.
- Une version de modèle par surface. Même dans nos propres exécutions, le comportement a bougé entre versions de modèle.
- La détection de marque est une correspondance de chaîne par nom, une marque recommandée uniquement par le nom de son produit peut donc être manquée.
- La recherche web a été activée via l'API. Les applications grand public cherchent peut-être plus que ces exécutions, ou moins.
- Le coût couvre uniquement la génération des réponses et n'inclut pas le temps de stockage ou de relecture.
Questions fréquentes
Pourquoi ChatGPT a-t-il rapporté zéro citation sur 12 des 20 prompts ?
Parce qu'il a répondu à ces prompts sans chercher. Un modèle qui ne récupère jamais une page ne peut pas la citer. Ce zéro décrit donc l'exécution, pas votre marque. Avant de lire un chiffre de citations sur une surface de chat, vérifiez d'abord si cette surface a utilisé le web.
Une mention a-t-elle de la valeur s'il n'y a aucun lien ?
Sur une réponse sans fondement, elle est tout le signal, et c'est aussi le signal qui précède le lien. Dans nos données, mention et lien s'obtiennent à partir de sources différentes : la mention suit le contenu comparatif et les tests, la citation suit les pages structurées pour être citées.
Faut-il fusionner mentions et citations en un seul score de visibilité ?
Non. Comme le montre le tableau des marques, ils divergent systématiquement dans les deux sens, et un score fusionné masque lequel des deux a bougé. Rapportez-les comme deux lignes et laissez le lecteur voir l'écart.
Quelle surface vérifier en premier ?
Si vous voulez un panneau stable, bon marché et de largeur fixe, prenez Perplexity, car la longueur de sa liste ne change pas. Si vous voulez de l'ampleur, prenez Gemini, qui a atteint 184 des 432 domaines que nous avons vus. ChatGPT seulement avec un contrôle de plausibilité en accompagnement, sinon un cinquième de ses réponses se lira comme une marque invisible.
Point de vue Auspia : rapportez mentions et citations comme deux lignes distinctes et enregistrez si la surface a cherché avant d'enregistrer quoi que ce soit d'autre. Un score unique de visibilité masque exactement l'écart qui vous dit quoi corriger ensuite, et la correction la moins chère dans nos données n'était pas d'ajouter du contenu, mais de vérifier une surface qui a réellement regardé le web.
Auteur : Adrian Cole