Dwa sprawdzacze widoczności w AI mogą przeczytać te same odpowiedzi tego samego dnia i wydać przeciwne werdykty. Jeden zwraca liczbę cytowań, drugi nie zwraca nic, bo odpowiedź wymieniła twoją markę z nazwy i poleciła ją, ani razu jej nie linkując.
We wrześniu 2026 roku przepuściliśmy dwadzieścia promptów przez trzy powierzchnie AI i na każdej odpowiedzi zapisaliśmy dwa sygnały: markę, którą odpowiedź wymieniła w treści, oraz domenę, którą odpowiedź podała jako źródło. To nie są dwa ujęcia jednego pomiaru. Rozchodzą się w przewidywalnych miejscach, a właśnie te miejsca są najużyteczniejszą częścią raportu.
Krótka wersja: Perplexity cytował źródła w każdym prompcie, Gemini zwracał medianę 47 źródeł na odpowiedź, a ChatGPT nie zwrócił żadnego cytowania w 12 z 20 promptów, choć i tak wymienił dostawców w 13 z nich. Zmienność między uruchomieniami na jednej powierzchni to osobna kwestia i mierzyliśmy ją wcześniej w artykule zmienność uruchomień trackera widoczności w AI.
Co uruchomiliśmy
Pozycja | Ustawienie |
|---|---|
Prompty | Dwadzieścia pytań, jakie kupujący zadałby o narzędzia widoczności w AI |
Powierzchnie | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Wyszukiwanie w sieci | Włączone na wszystkich trzech powierzchniach |
Region i język | Stany Zjednoczone, angielski |
Data | 12 września 2026 |
Zebrane odpowiedzi | 60 |
Koszt całego uruchomienia | 1,444 dolara, czyli 0,024 dolara za odpowiedź |
Powtórne uruchomienie | Powtórzyliśmy te same pięć promptów, żeby sprawdzić, czy zachowanie jest stabilne |
Koszt odpowiedzi mieścił się między 0,006 dolara w Perplexity a 0,037 dolara w Gemini. Najtańsza powierzchnia dała najbardziej spójną listę źródeł, a najdroższa nie była tą, która zwróciła najwięcej źródeł.
Dwa sygnały mierzone osobno
Każdą odpowiedź przechwyciliśmy dwa razy: raz jako tekst, raz jako listę źródeł, którą powierzchnia dołączyła do tego tekstu.
Powierzchnia | Znaczniki źródeł | Na odpowiedź | Odpowiedzi bez cytowań | Różne domeny na odpowiedź |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | od 0 do 18, mediana 0 | 12 z 20 | od 0 do 10 |
Gemini 2.5 Flash | 989 | od 14 do 122, mediana 47 | 0 z 20 | od 3 do 23 |
Perplexity | 399 | od 19 do 20 | 0 z 20 | od 16 do 20 |
Te trzy listy nie są tym samym typem obiektu i właśnie tutaj sprawdzacz myli się najpierw.
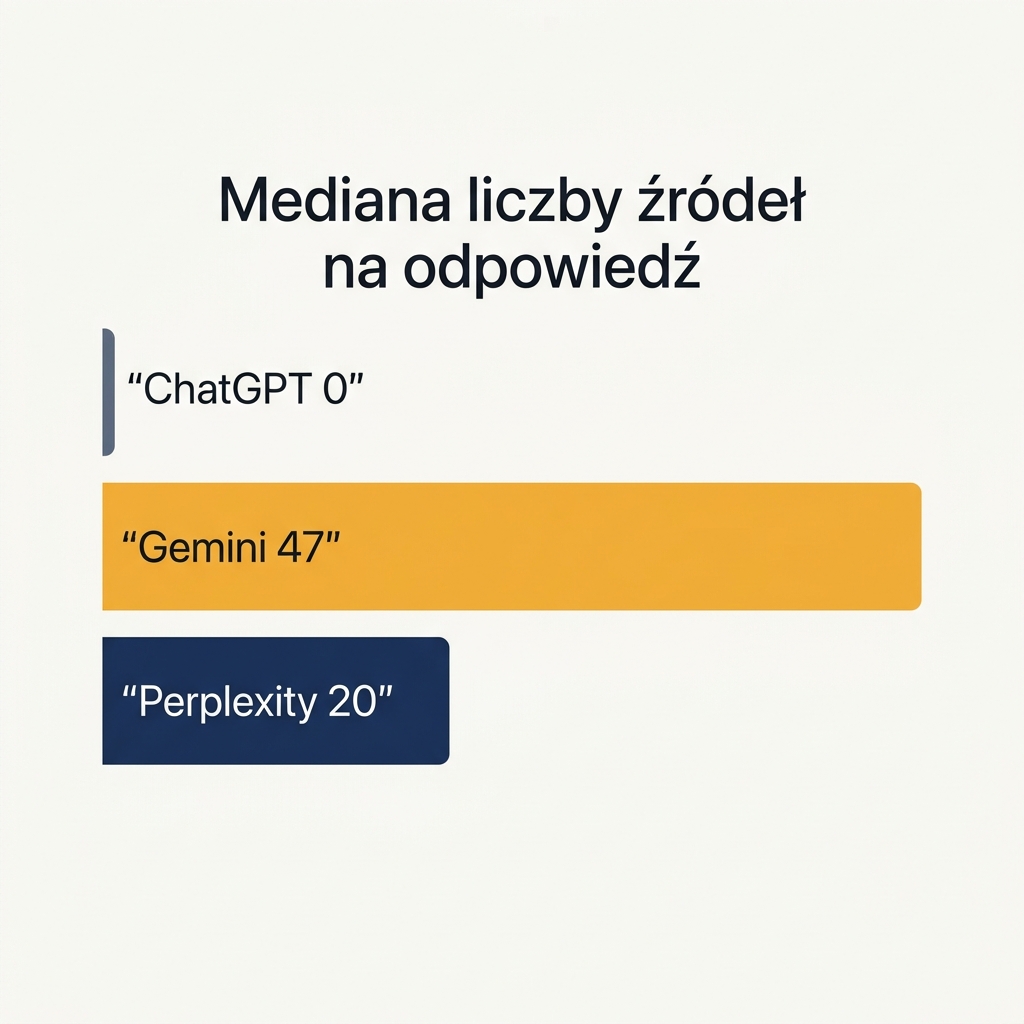
Gemini dołącza źródło niemal do każdego twierdzenia. Ta sama strona może zająć w jednej odpowiedzi wiele miejsc i dlatego liczby są tak wysokie: przez 20 odpowiedzi Gemini domena semrush.com zajęła 44 miejsca, maxaeo.ai dwadzieścia sześć, google.com dwadzieścia dwa, adobe.com dwadzieścia jeden, a medium.com dwadzieścia. Wysoka liczba znaczników na tej powierzchni mówi o tym, jak drobno model rozkłada materiał, a nie o tym, jak szeroko znana jest twoja marka.
Perplexity ujawnia panel z sufitem. Zwrócił dokładnie dwadzieścia źródeł w 19 z 20 promptów i dziewiętnaście w dwudziestym. To ustala mianownik: twój udział w odpowiedzi Perplexity to zawsze udział z dwudziestu, więc zdobycie miejsca oznacza, że ktoś gdzieś indziej miejsce stracił.
ChatGPT zwraca listę źródeł tylko wtedy, gdy szukał. Zapytanie wyszukiwania wysłał w 8 z 20 promptów, a w pozostałych dwunastu nie zacytował niczego. W tych dwunastu wciąż odpowiedział na pytanie i wciąż wymienił narzędzia. Jeden przykład bez redakcji: zapytany o najlepsze narzędzia do śledzenia wzmianek o marce w wynikach wyszukiwania AI wymienił Brand24, Mention, BuzzSumo, Talkwalker i Google Alerts, nie dołączając źródła do żadnego z nich. Lista kontrolna, której używamy do audytu odpowiedzi ChatGPT pod kątem tego wzorca awarii, jest w artykule lista kontrolna widoczności w ChatGPT.
Wymieniona z nazwy, ale niecytowana
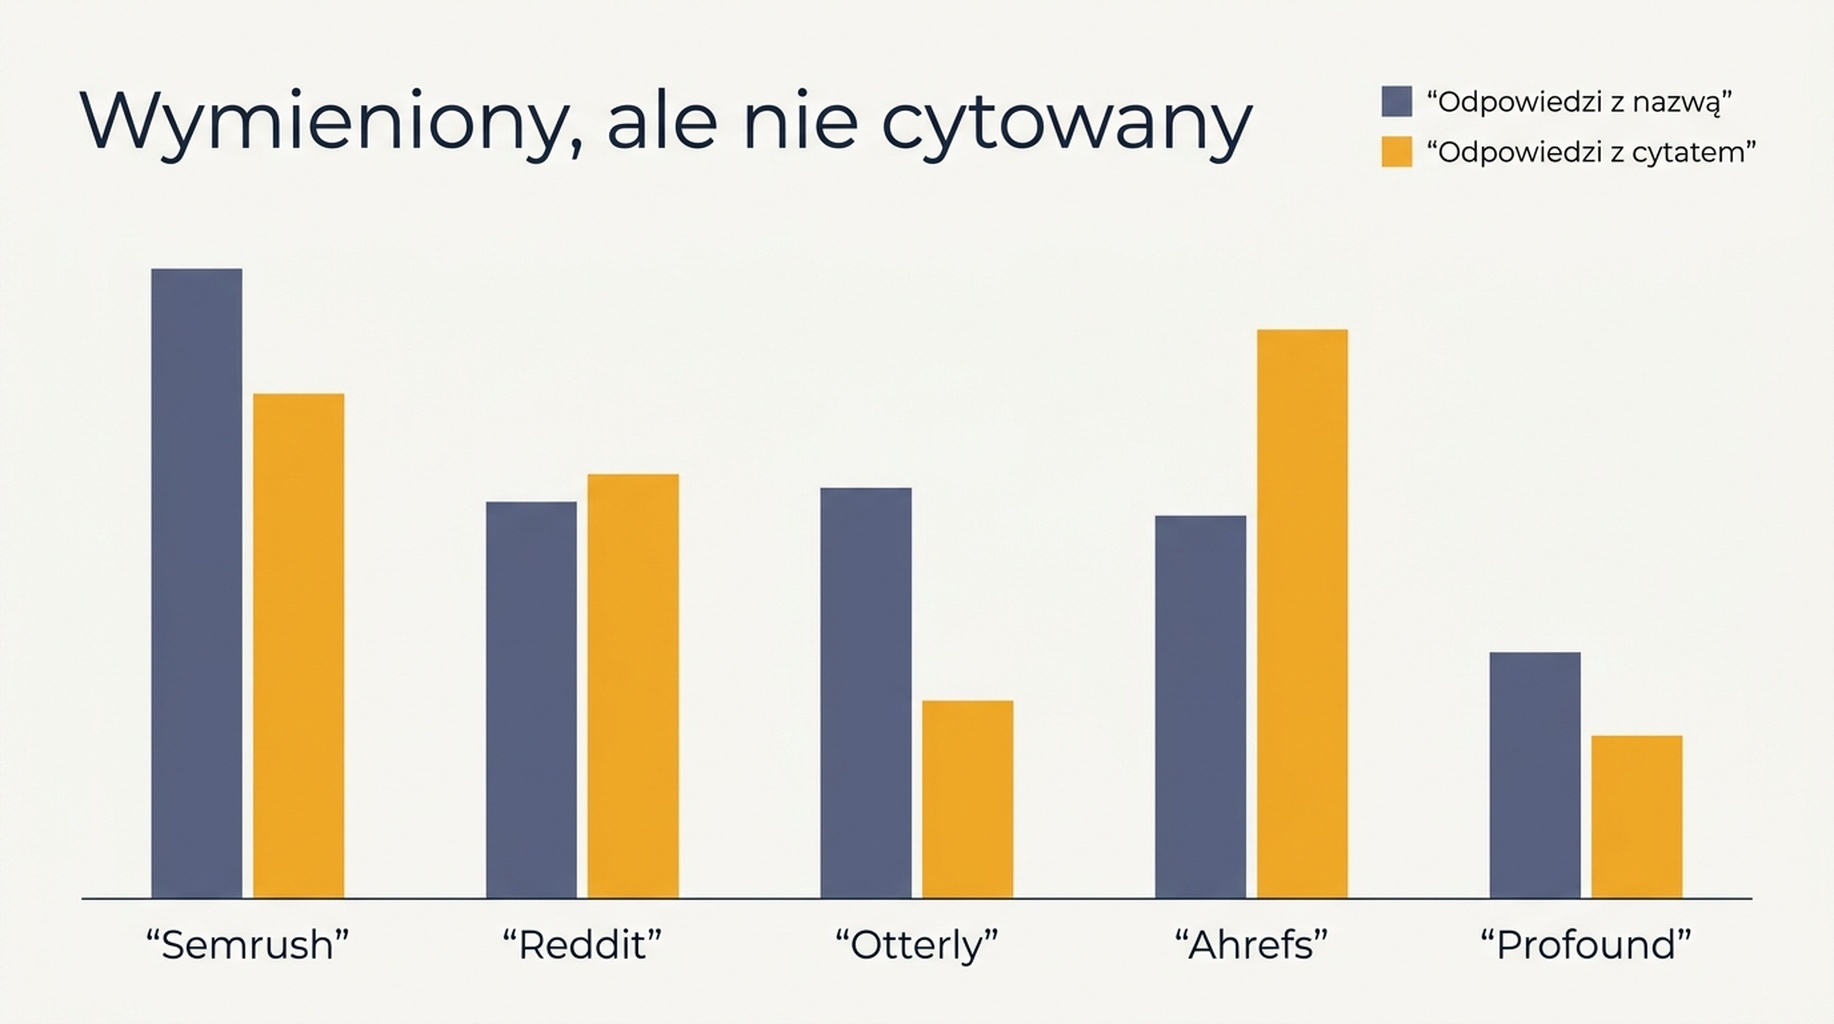
Następnie policzyliśmy dla 27 marek i mediów, w ilu z 60 odpowiedzi marka została wymieniona w treści, a w ilu zacytowano jej domenę jako źródło. Obie kolumny rozchodzą się w obu kierunkach naraz.
Marka | Odpowiedzi, które ją wymieniły | Odpowiedzi, które zacytowały jej domenę |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
W tej tabeli są dwa wzorce. Peec AI, Otterly, Profound i ZipTie są polecane w odpowiedziach znacznie częściej, niż linkuje się ich strony. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps i Menra mają odwrotnie: ich strony są wciągane jako źródła, podczas gdy odpowiedź ani raz nie wymienia nazwy firmy. Sprawdzacz patrzący tylko na linki uzna drugą grupę za widoczną, a pierwszą za niewidoczną. Sprawdzacz patrzący tylko na wzmianki zrobi odwrotnie.
Przez wszystkie 60 odpowiedzi trzy powierzchnie razem zacytowały 432 różne domeny. Na ChatGPT przypada 47 z nich, czyli 11 procent, na Gemini 184 (43 procent), na Perplexity 285 (66 procent). Którąkolwiek powierzchnię sprawdzasz, patrzysz na próbkę ze znacznie większego wszechświata źródeł. Nie obejmuje to własnej powierzchni Google, gdzie obecność mierzy się inaczej i opisujemy to w artykule tracker AI Overview.
Co sprawdzacz musi rejestrować
Sprawdzacz widoczności zwracający jedną liczbę wyrzuca trzy ze swoich czterech pól. Oto cztery, które warto zachować.
Pole | Forma zapisu | Dlaczego zmienia werdykt |
|---|---|---|
Czy powierzchnia szukała | tak lub nie | Odpowiedź, która nie szukała, nie może wytworzyć cytowań, więc jej zero nie jest sygnałem widoczności |
Czy marka została wymieniona w treści odpowiedzi | liczba odpowiedzi | Jedyny sygnał, który przeżywa na odpowiedzi bez uzasadnienia |
Czy domena jest na liście źródeł | liczba odpowiedzi | Sygnał, o którym większość narzędzi raportuje samotnie |
Mianownik | liczba odpowiedzi oraz liczba miejsc na źródła w odpowiedzi | Panel z ustalonymi dwudziestoma miejscami i lista na 47 znaczników nie dają się porównywać jako procenty |
Praktyczna konsekwencja to fałszywe zero. W naszych danych 13 z 20 odpowiedzi ChatGPT wymieniło co najmniej jednego dostawcę, podczas gdy tylko 8 z 20 zacytowało cokolwiek, czyli około jednej czwartej odpowiedzi tej powierzchni zaraportuje zero cytowań dla marki, którą ta sama odpowiedź wymieniła z nazwy i poleciła.
Jak robić to, nie oszukując siebie
Wzorzec awarii, gdy oddasz tę pracę agentowi, to nie błędna liczba, lecz pewna siebie liczba policzona z pola, którego nigdy nie zebrano.
- Przechwyć surowy ładunek, zanim cokolwiek policzysz. Zachowaj tekst odpowiedzi, listę źródeł, identyfikator modelu i wartość logiczną tego, czy wysłano zapytanie wyszukiwania. Metryki pochodne buduje się w kodzie na drugim etapie, a nie umieszcza w prompcie zbierającym.
- Każ agentowi cytować, a nie streszczać. Kryterium „zaraportuj, ile razy wystąpiła marka" produkuje prozę. Kryterium „zwróć dosłownie tekst odpowiedzi i listę źródeł" produkuje dane, które możesz sprawdzić ponownie.
- Uruchom ten sam prompt ponownie, zanim uwierzysz w zmianę. Powtórzyliśmy pięć promptów i decyzja o wyszukiwaniu zgadzała się w 5 przypadkach na 5, czyli nagły skok liczby cytowań to raczej wersja modelu albo edycja promptu niż szum.
- Zostaw identyfikator modelu w każdym wierszu. Te same dwadzieścia promptów na tym samym punkcie końcowym przez gpt-4o zwróciło znaczniki źródeł tylko w 2 z 20 przypadków wobec 8 z 20 przy gpt-5.
- Zaplanuj budżet. Pełne uruchomienie 60 odpowiedzi kosztowało 1,444 dolara, więc przy tych stawkach cotygodniowa wersja tej samej kontroli to około 6 dolarów miesięcznie.
Ograniczenia
- Jeden dzień, jeden region, angielski, trzy powierzchnie. Odpowiedzi różnią się między regionami.
- Jedna wersja modelu na powierzchnię. Nawet w naszych uruchomieniach zachowanie przesuwało się między wersjami modelu.
- Rozpoznawanie marek to dopasowanie ciągu znaków po nazwie, więc marka polecona wyłącznie nazwą produktu może zostać pominięta.
- Wyszukiwanie w sieci włączaliśmy przez API. Aplikacje konsumenckie mogą szukać częściej niż te uruchomienia albo rzadziej.
- Koszt obejmuje tylko generowanie odpowiedzi, bez czasu na przechowywanie czy przegląd.
Częste pytania
Dlaczego ChatGPT zaraportował zero cytowań w 12 z 20 promptów?
Bo odpowiedział na te prompty bez wyszukiwania. Model, który ani razu nie pobierze strony, nie może jej zacytować. To zero opisuje więc uruchomienie, a nie twoją markę. Zanim odczytasz liczbę cytowań z dowolnej powierzchni czatu, najpierw sprawdź, czy ta powierzchnia w ogóle korzystała z sieci.
Czy wzmianka ma wartość, jeśli nie ma żadnego linku?
Na odpowiedzi bez uzasadnienia to cały sygnał, a do tego sygnał, który przychodzi przed linkiem. W naszych danych wzmiankę i link zdobywa się z różnych źródeł: wzmianka idzie za treścią porównawczą i recenzencką, a link za stronami ustrukturyzowanymi tak, by je cytowano.
Czy scalać wzmianki i cytowania w jeden wynik widoczności?
Nie. Jak pokazuje tabela marek, rozchodzą się systematycznie w obu kierunkach, a scalony wynik ukrywa, które z nich się ruszyło. Raportuj je jako dwie linie i pozwól czytelnikowi zobaczyć tę lukę.
Którą powierzchnię sprawdzać najpierw?
Jeśli chcesz stabilnego, taniego panelu o stałej szerokości, wybierz Perplexity, bo długość jego listy się nie zmienia. Jeśli chcesz szerokości, wybierz Gemini, który dotarł do 184 ze 432 domen, które widzieliśmy. ChatGPT tylko z dołączoną kontrolą wiarygodności, inaczej jedna piąta jego odpowiedzi zostanie odczytana jako niewidoczna marka.
Spojrzenie Auspia: raportuj wzmianki i cytowania jako dwie osobne linie i zapisuj, czy powierzchnia szukała, zanim zapiszesz cokolwiek innego. Pojedynczy wynik widoczności ukrywa dokładnie tę lukę, która mówi ci, co naprawić dalej, a najtańsza poprawka w naszych danych nie polegała na dodaniu treści, lecz na sprawdzeniu powierzchni, która naprawdę zajrzała do sieci.
Autor: Adrian Cole