เครื่องมือตรวจสอบการมองเห็นใน AI สองตัวสามารถอ่านคำตอบชุดเดียวกันในวันเดียวกัน แล้วสรุปผลตรงข้ามกันได้ ตัวหนึ่งคืนจำนวนการอ้างอิง อีกตัวไม่คืนอะไรเลย เพราะคำตอบเอ่ยชื่อแบรนด์ของคุณแล้วแนะนำมัน โดยไม่ลิงก์ไปหามันแม้แต่ครั้งเดียว
เราเรียกใช้ยี่สิบพรอมป์ข้ามพื้นผิว AI สามแบบในเดือนกันยายน 2026 และบันทึกสัญญาณสองอย่างบนทุกคำตอบ ได้แก่แบรนด์ที่คำตอบเอ่ยชื่อในเนื้อความ และโดเมนที่คำตอบยกมาเป็นแหล่งข้อมูล สองสัญญาณนี้ไม่ใช่สองมุมมองของการวัดครั้งเดียว มันแยกจากกันในจุดที่คาดเดาได้ และจุดที่มันแยกจากกันคือส่วนที่มีประโยชน์ที่สุดในรายงาน
เวอร์ชันสั้นคือ Perplexity อ้างอิงแหล่งข้อมูลทุกพรอมป์ Gemini คืนค่ามัธยฐาน 47 แหล่งต่อคำตอบ ส่วน ChatGPT ไม่คืนการอ้างอิงเลยใน 12 จาก 20 พรอมป์ แต่ก็ยังเอ่ยชื่อผู้ให้บริการใน 13 พรอมป์ ความแปรปรวนระหว่างรอบบนพื้นผิวเดียวเป็นอีกเรื่องหนึ่ง ซึ่งเราวัดไว้ก่อนหน้านี้ใน ความแปรปรวนระหว่างรอบของตัวติดตามการมองเห็นใน AI
เราทำอะไรไปบ้าง
รายการ | การตั้งค่า |
|---|---|
พรอมป์ | ยี่สิบคำถามที่ผู้ซื้อน่าจะถามเกี่ยวกับเครื่องมือวัดการมองเห็นใน AI |
พื้นผิว | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
การค้นเว็บ | เปิดใช้บนทั้งสามพื้นผิว |
ภูมิภาคและภาษา | สหรัฐอเมริกา ภาษาอังกฤษ |
วันที่ | 12 กันยายน 2026 |
คำตอบที่เก็บได้ | 60 คำตอบ |
ค่าใช้จ่ายทั้งรอบ | 1,444 ดอลลาร์ หรือ 0.024 ดอลลาร์ต่อคำตอบ |
การรันซ้ำ | รันห้าพรอมป์เดิมอีกครั้งเพื่อดูว่าพฤติกรรมนิ่งหรือไม่ |
ค่าใช้จ่ายต่อคำตอบอยู่ระหว่าง 0.006 ดอลลาร์ของ Perplexity ถึง 0.037 ดอลลาร์ของ Gemini พื้นผิวที่ถูกที่สุดให้รายการแหล่งข้อมูลที่สม่ำเสมอที่สุด และพื้นผิวที่แพงที่สุดไม่ใช่ตัวที่คืนแหล่งข้อมูลมากที่สุด
แยกวัดสัญญาณสองอย่าง
เราจับทุกคำตอบสองครั้ง ครั้งหนึ่งเป็นข้อความ อีกครั้งเป็นรายการแหล่งข้อมูลที่พื้นผิวแนบมากับข้อความนั้น
พื้นผิว | ป้ายกำกับแหล่งข้อมูล | ต่อคำตอบ | คำตอบที่ไม่มีการอ้างอิง | โดเมนต่างกันต่อคำตอบ |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | 0 ถึง 18 มัธยฐาน 0 | 12 จาก 20 | 0 ถึง 10 |
Gemini 2.5 Flash | 989 | 14 ถึง 122 มัธยฐาน 47 | 0 จาก 20 | 3 ถึง 23 |
Perplexity | 399 | 19 ถึง 20 | 0 จาก 20 | 16 ถึง 20 |
รายการทั้งสามนี้ไม่ใช่วัตถุชนิดเดียวกัน และนี่คือจุดแรกที่เครื่องมือตรวจสอบพลาด
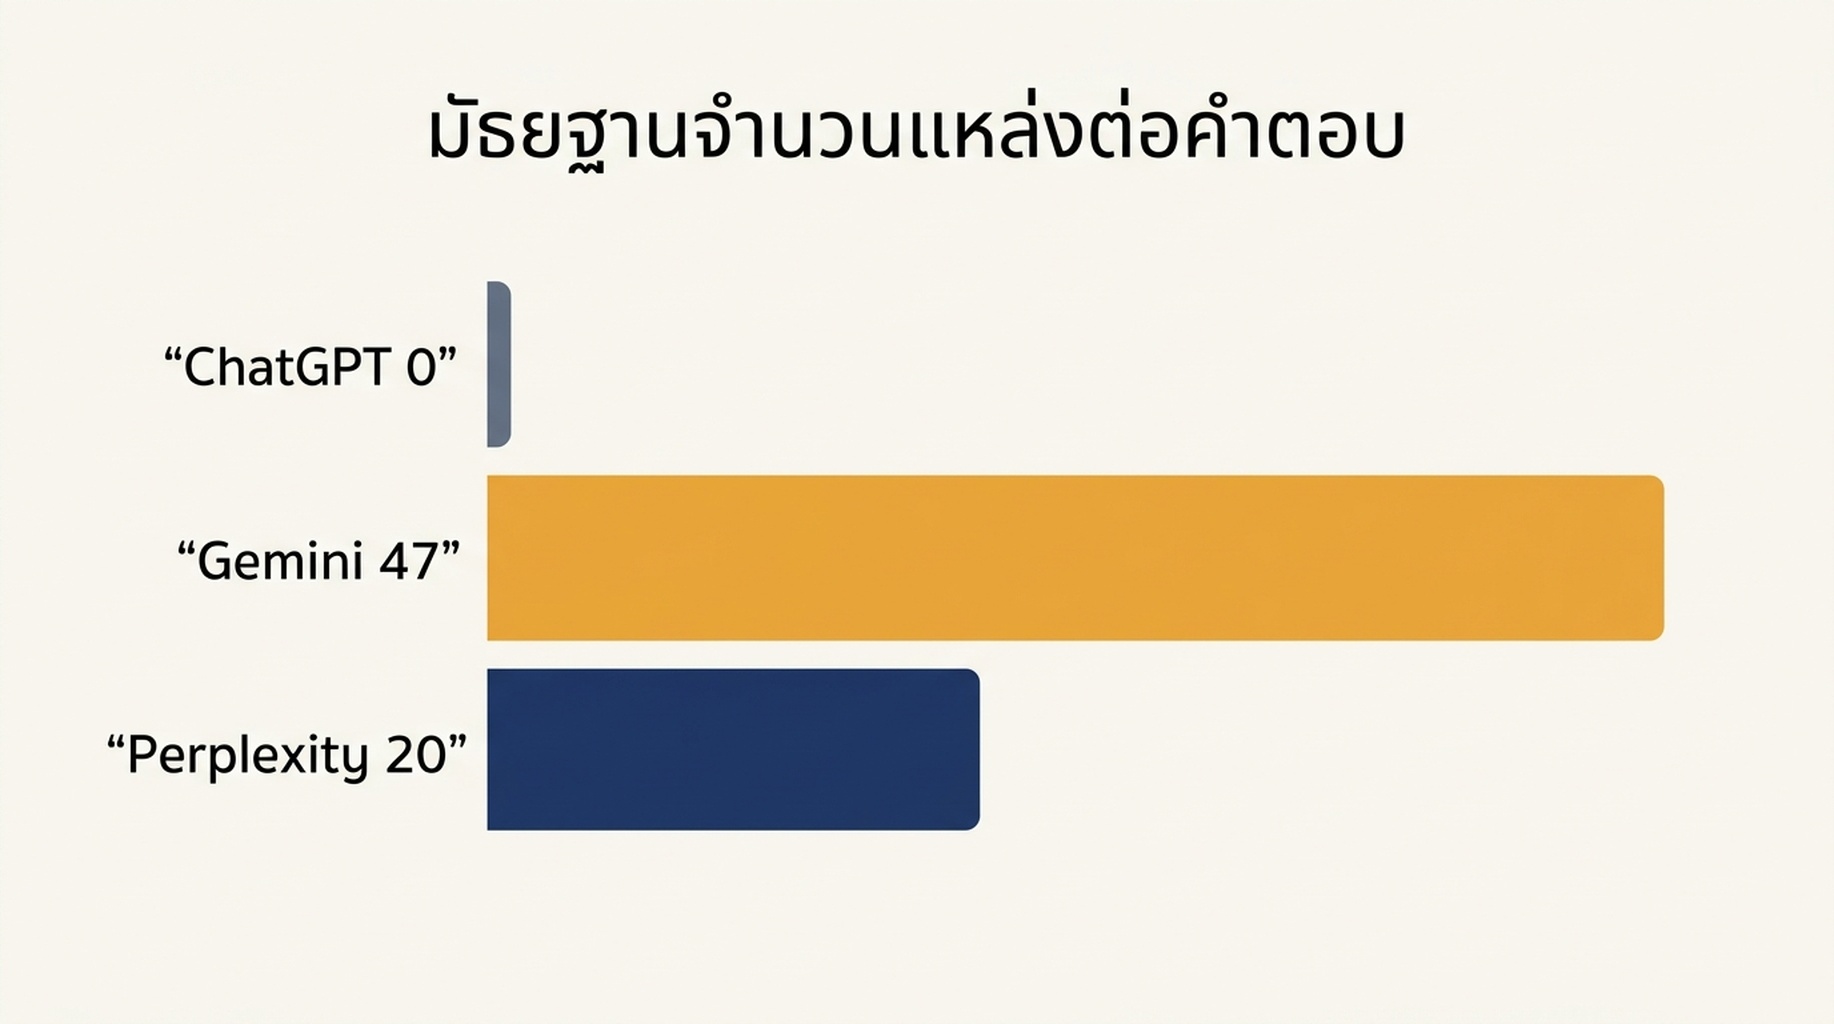
Gemini แนบแหล่งข้อมูลให้แทบทุกข้อกล่าวอ้าง หน้าเดียวกันสามารถกินตำแหน่งได้หลายตำแหน่งในคำตอบเดียว ซึ่งเป็นเหตุที่ตัวเลขสูงขนาดนี้ ตลอด 20 คำตอบของ Gemini โดเมน semrush.com กินไป 44 ตำแหน่ง maxaeo.ai ยี่สิบหกตำแหน่ง google.com ยี่สิบสองตำแหน่ง adobe.com ยี่สิบเอ็ดตำแหน่ง และ medium.com ยี่สิบตำแหน่ง จำนวนป้ายที่สูงบนพื้นผิวนี้บอกว่าตัวแบบแยกย่อยละเอียดแค่ไหน ไม่ได้บอกว่าแบรนด์ของคุณเป็นที่รู้จักกว้างแค่ไหน
ส่วน Perplexity เปิดแผงที่มีเพดานชัดเจน มันคืนแหล่งข้อมูลยี่สิบรายการพอดีใน 19 จาก 20 พรอมป์ และสิบเก้ารายการในพรอมป์ที่ยี่สิบ นี่ตรึงตัวหารไว้ ส่วนแบ่งของคุณในคำตอบ Perplexity จึงเป็นส่วนแบ่งจากยี่สิบเสมอ การได้หนึ่งตำแหน่งหมายความว่ามีใครบางคนเสียตำแหน่งไปที่อื่น
ChatGPT จะคืนรายการแหล่งข้อมูลเฉพาะตอนที่มันค้นหา มันยิงคำค้นใน 8 จาก 20 พรอมป์ และไม่อ้างอิงอะไรเลยในอีกสิบสองพรอมป์ที่เหลือ ในสิบสองพรอมป์นั้นมันยังตอบคำถามและยังเอ่ยชื่อเครื่องมือ ตัวอย่างที่ไม่ได้แก้ไขมีอยู่ว่า เมื่อถูกถามถึงเครื่องมือที่ดีที่สุดสำหรับติดตามการกล่าวถึงแบรนด์ในผลการค้นหาของ AI มันไล่ชื่อ Brand24, Mention, BuzzSumo, Talkwalker และ Google Alerts โดยไม่มีแหล่งข้อมูลแนบมากับตัวใดเลย เช็กลิสต์ที่เราใช้ตรวจคำตอบ ChatGPT หารูปแบบความล้มเหลวนี้อยู่ใน เช็กลิสต์การมองเห็นใน ChatGPT
ถูกเอ่ยชื่อโดยไม่ถูกอ้างอิง
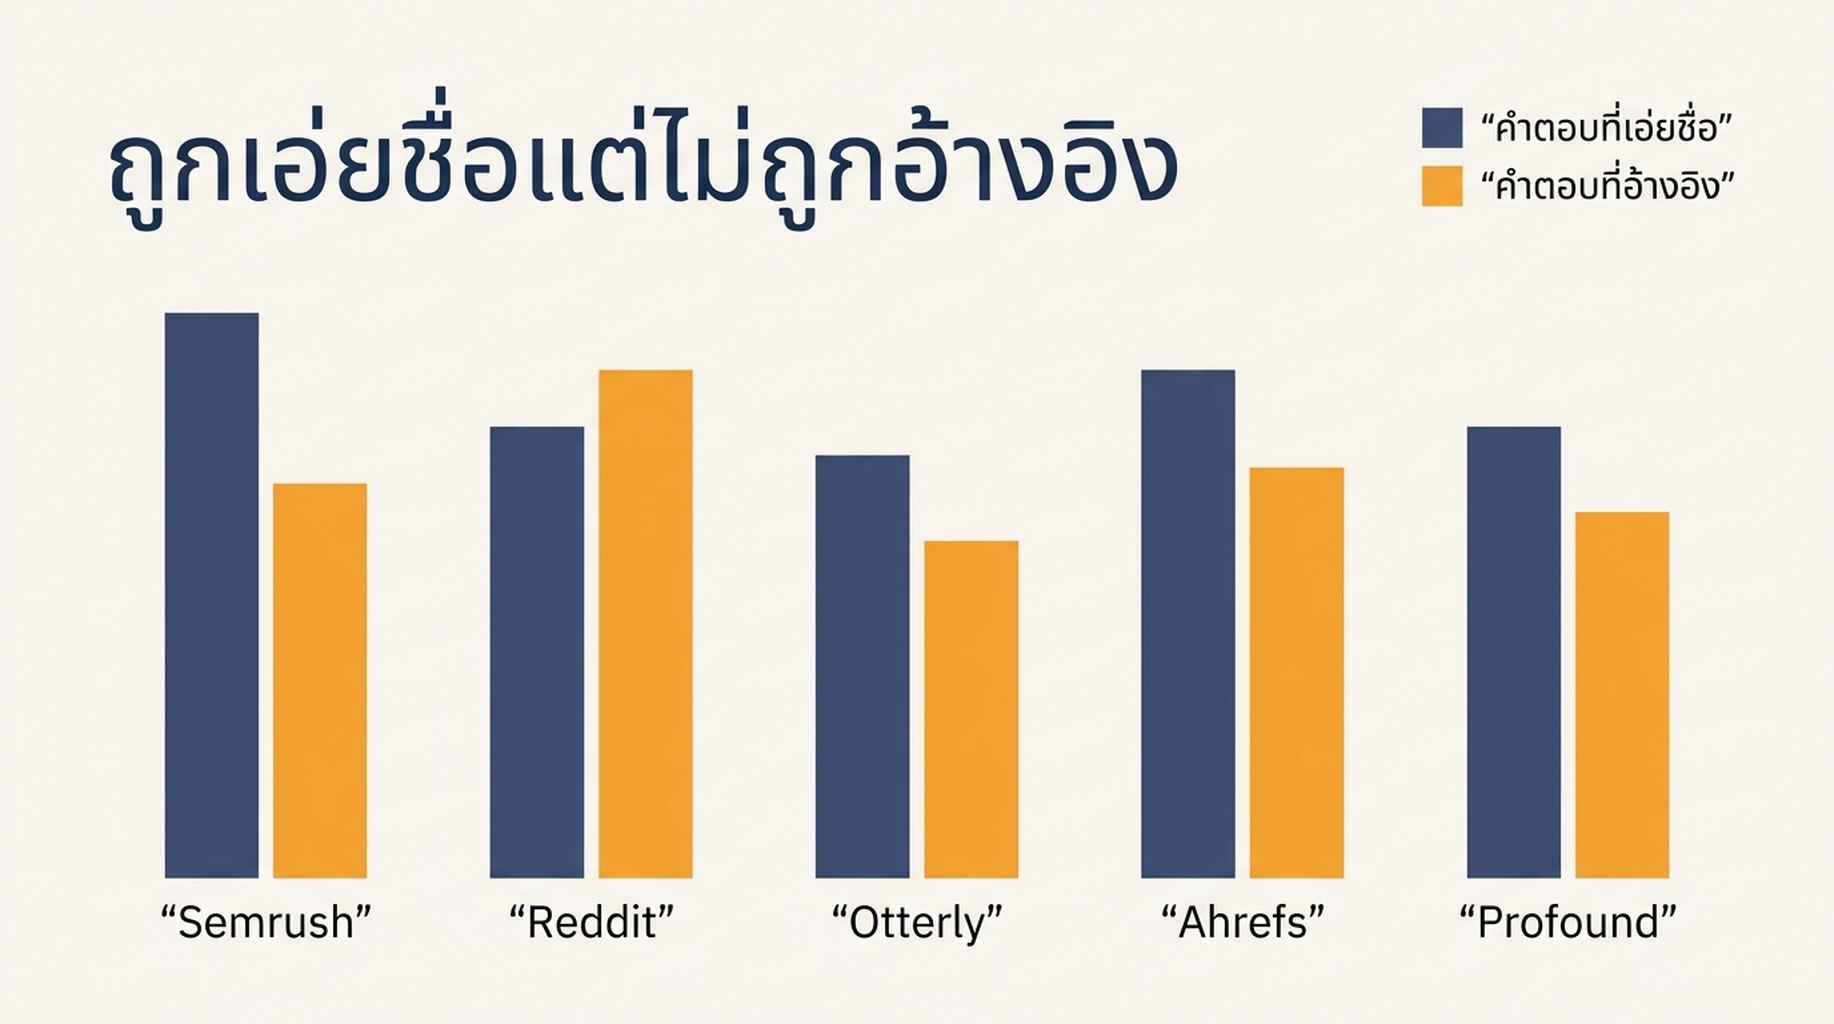
จากนั้นเรานับแบรนด์และสำนักพิมพ์ 27 ราย ว่าใน 60 คำตอบ มีกี่คำตอบที่เอ่ยชื่อแบรนด์ในเนื้อความ และกี่คำตอบที่อ้างอิงโดเมนของมันเป็นแหล่งข้อมูล สองคอลัมน์นี้ไม่ตรงกันทั้งสองทิศทาง
แบรนด์ | คำตอบที่เอ่ยชื่อ | คำตอบที่อ้างอิงโดเมน |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
ในตารางนี้มีสองรูปแบบ Peec AI, Otterly, Profound และ ZipTie ถูกแนะนำในคำตอบบ่อยกว่าที่หน้าของพวกเขาถูกลิงก์มาก ส่วน MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps และ Menra กลับกัน หน้าของพวกเขาถูกดึงเข้ามาเป็นแหล่งข้อมูลโดยที่คำตอบไม่เคยเอ่ยชื่อบริษัทเลย เครื่องมือที่ดูแค่ลิงก์จะตัดสินว่ากลุ่มที่สองมองเห็นได้ และกลุ่มแรกมองไม่เห็น ส่วนเครื่องมือที่ดูแค่การกล่าวถึงจะทำตรงกันข้าม
ตลอดทั้ง 60 คำตอบ สามพื้นผิวรวมกันอ้างอิงโดเมนต่างกัน 432 โดเมน โดย ChatGPT ได้ 47 โดเมน หรือ 11 เปอร์เซ็นต์ Gemini ได้ 184 โดเมน (43 เปอร์เซ็นต์) และ Perplexity ได้ 285 โดเมน (66 เปอร์เซ็นต์) ไม่ว่าคุณจะตรวจพื้นผิวไหน คุณกำลังดูตัวอย่างจากจักรวาลแหล่งข้อมูลที่ใหญ่กว่านั้นมาก สิ่งนี้ไม่รวมพื้นผิวของ Google เอง ซึ่งการปรากฏที่นั่นวัดกันคนละวิธีและอธิบายไว้ใน ตัวติดตาม AI Overview ของเรา
เครื่องมือตรวจสอบต้องบันทึกอะไร
เครื่องมือวัดการมองเห็นที่คืนตัวเลขเดียวกำลังทิ้งสามในสี่ช่องของตัวเอง สี่ช่องที่ควรเก็บไว้มีดังนี้
ช่อง | รูปแบบการบันทึก | ทำไมมันเปลี่ยนข้อสรุป |
|---|---|---|
พื้นผิวค้นหาหรือไม่ | ใช่หรือไม่ | คำตอบที่ไม่ได้ค้นหาสร้างการอ้างอิงไม่ได้ เลขศูนย์ของมันจึงไม่ใช่สัญญาณการมองเห็น |
มีการเอ่ยชื่อแบรนด์ในเนื้อความหรือไม่ | จำนวนคำตอบ | สัญญาณเดียวที่ยังอยู่บนคำตอบที่ไม่มีหลักฐานรองรับ |
มีโดเมนในรายการแหล่งข้อมูลหรือไม่ | จำนวนคำตอบ | สัญญาณที่เครื่องมือส่วนใหญ่รายงานเพียงอย่างเดียว |
ตัวหาร | จำนวนคำตอบ และจำนวนตำแหน่งแหล่งข้อมูลต่อคำตอบ | แผงที่ตรึงไว้ยี่สิบตำแหน่งกับรายการที่มี 47 ป้ายเทียบกันเป็นเปอร์เซ็นต์ไม่ได้ |
ผลในทางปฏิบัติคือเลขศูนย์ปลอม ในข้อมูลของเรา 13 จาก 20 คำตอบของ ChatGPT เอ่ยชื่อผู้ให้บริการอย่างน้อยหนึ่งราย ขณะที่มีเพียง 8 จาก 20 ที่อ้างอิงอะไรก็ตาม นั่นหมายความว่าราวหนึ่งในสี่ของคำตอบบนพื้นผิวนี้จะรายงานการอ้างอิงเป็นศูนย์ให้กับแบรนด์ที่คำตอบเดียวกันนั้นเอ่ยชื่อและแนะนำ
ทำอย่างไรให้ไม่หลอกตัวเอง
รูปแบบความล้มเหลวเมื่อคุณมอบงานนี้ให้เอเจนต์ไม่ใช่ตัวเลขที่ผิด แต่เป็นตัวเลขที่มั่นใจซึ่งคำนวณจากช่องที่ไม่เคยถูกเก็บเลย
- เก็บเพย์โหลดดิบก่อนจะคำนวณอะไรทั้งนั้น เก็บข้อความคำตอบ รายการแหล่งข้อมูล ตัวระบุรุ่น และค่าจริงเท็จว่ามีการยิงคำค้นหรือไม่ ตัวชี้วัดที่ได้มาจากการคำนวณให้สร้างในโค้ดขั้นที่สอง ไม่ใช่ใส่ไว้ในพรอมป์เก็บข้อมูล
- ให้เอเจนต์อ้างอิงแทนที่จะสรุป เกณฑ์ที่ว่า "รายงานว่าแบรนด์ปรากฏกี่ครั้ง" ให้ผลเป็นความเรียง ส่วนเกณฑ์ที่ว่า "คืนข้อความคำตอบและรายการแหล่งข้อมูลตามตัวอักษร" ให้ผลเป็นข้อมูลที่คุณตรวจซ้ำได้
- รันพรอมป์เดิมซ้ำก่อนจะเชื่อการเปลี่ยนแปลง เราเรียกห้าพรอมป์ซ้ำ และการตัดสินใจว่าจะค้นหรือไม่ตรงกัน 5 จาก 5 นั่นแปลว่าการพุ่งขึ้นทันทีของจำนวนการอ้างอิงน่าจะเป็นเพราะรุ่นของตัวแบบหรือการแก้พรอมป์ มากกว่าเป็นสัญญาณรบกวน
- เก็บตัวระบุรุ่นไว้ในทุกแถว ยี่สิบพรอมป์เดิมบนปลายทางเดิมผ่าน gpt-4o คืนป้ายกำกับแหล่งข้อมูลเพียง 2 จาก 20 เทียบกับ 8 จาก 20 ของ gpt-5
- กันงบไว้ รอบเต็ม 60 คำตอบใช้เงิน 1,444 ดอลลาร์ ดังนั้นที่ราคานี้ การตรวจแบบเดียวกันรายสัปดาห์จะอยู่ที่ราว 6 ดอลลาร์ต่อเดือน
ข้อจำกัด
- หนึ่งวัน หนึ่งภูมิภาค ภาษาอังกฤษ สามพื้นผิว คำตอบแตกต่างกันไปตามภูมิภาค
- หนึ่งรุ่นของตัวแบบต่อพื้นผิว แม้ในรอบของเราเอง พฤติกรรมก็ขยับไปมาระหว่างรุ่นของตัวแบบ
- การตรวจจับแบรนด์เป็นการจับคู่สตริงตามชื่อ แบรนด์ที่ถูกแนะนำด้วยชื่อผลิตภัณฑ์เท่านั้นจึงอาจถูกมองข้าม
- การค้นเว็บเปิดผ่าน API แอปสำหรับผู้ใช้ทั่วไปอาจค้นมากกว่ารอบเหล่านี้ หรือน้อยกว่าก็ได้
- ค่าใช้จ่ายครอบคลุมเฉพาะการสร้างคำตอบ ไม่รวมเวลาจัดเก็บหรือตรวจทาน
คำถามที่พบบ่อย
ทำไม ChatGPT รายงานการอ้างอิงเป็นศูนย์ใน 12 จาก 20 พรอมป์
เพราะมันตอบพรอมป์เหล่านั้นโดยไม่ได้ค้นหา ตัวแบบที่ไม่เคยดึงหน้าเว็บมาใช้ย่อมอ้างอิงหน้านั้นไม่ได้ เลขศูนย์นั้นจึงบรรยายถึงรอบการรัน ไม่ได้บรรยายถึงแบรนด์ของคุณ ก่อนจะอ่านตัวเลขการอ้างอิงจากพื้นผิวแชตใด ๆ ให้ตรวจก่อนว่าพื้นผิวนั้นใช้เว็บหรือไม่
การถูกเอ่ยชื่อมีค่าอะไรไหมถ้าไม่มีลิงก์เลย
บนคำตอบที่ไม่มีหลักฐานรองรับ มันคือสัญญาณทั้งหมด และยังเป็นสัญญาณที่มาก่อนลิงก์ด้วย ในข้อมูลของเรา การกล่าวถึงกับลิงก์ได้มาจากแหล่งต่างกัน การกล่าวถึงตามเนื้อหาเชิงเปรียบเทียบและรีวิว ส่วนการอ้างอิงตามหน้าที่ถูกจัดโครงสร้างให้ถูกอ้างถึง
ควรยุบการกล่าวถึงและการอ้างอิงเป็นคะแนนการมองเห็นเดียวไหม
ไม่ควร อย่างที่ตารางแบรนด์แสดง ทั้งสองอย่างไม่ตรงกันอย่างเป็นระบบในทั้งสองทิศทาง และคะแนนที่ยุบรวมจะซ่อนว่าตัวไหนขยับ รายงานเป็นสองเส้น แล้วให้ผู้อ่านเห็นช่องว่างนั้น
ควรตรวจพื้นผิวไหนก่อน
ถ้าต้องการแผงที่นิ่ง ถูก และความกว้างคงที่ ให้เลือก Perplexity เพราะความยาวรายการไม่เปลี่ยน ถ้าต้องการความกว้าง ให้เลือก Gemini ซึ่งไปถึง 184 จาก 432 โดเมนที่เราเห็น ส่วน ChatGPT ใช้เฉพาะเมื่อแนบการตรวจความสมเหตุสมผลไปด้วย ไม่งั้นหนึ่งในห้าของคำตอบมันจะถูกอ่านเป็นแบรนด์ที่มองไม่เห็น
มุมมองของ Auspia: รายงานการกล่าวถึงและการอ้างอิงเป็นสองเส้นแยกกัน และบันทึกว่าพื้นผิวค้นหาหรือไม่ก่อนจะบันทึกอย่างอื่น คะแนนการมองเห็นเพียงตัวเดียวซ่อนช่องว่างที่บอกคุณว่าควรแก้อะไรต่อไปพอดี และการแก้ที่ถูกที่สุดในข้อมูลของเราไม่ใช่การเพิ่มเนื้อหา แต่เป็นการตรวจพื้นผิวที่มองเว็บจริง ๆ
ผู้เขียน: เอเดรียน โคล