Dua pemeriksa visibilitas AI bisa membaca jawaban yang sama pada hari yang sama dan memberi putusan yang berlawanan. Yang satu mengembalikan jumlah kutipan, yang lain tidak mengembalikan apa pun, karena jawaban itu menyebut merek Anda dan merekomendasikannya tanpa pernah menautkannya.
Pada September 2026 kami menjalankan dua puluh prompt di tiga permukaan AI dan mencatat, pada setiap jawaban, dua sinyal: merek yang disebut jawaban di dalam teks, dan domain yang disajikan jawaban sebagai sumber. Keduanya bukan dua sudut dari satu pengukuran. Keduanya berbeda di titik-titik yang bisa diprediksi, dan titik-titik itulah bagian paling berguna dalam laporan.
Versi singkatnya: Perplexity mengutip sumber di setiap prompt, Gemini mengembalikan median 47 sumber per jawaban, dan ChatGPT tidak mengembalikan satu pun kutipan pada 12 dari 20 prompt, namun tetap menyebut vendor pada 13 di antaranya. Variasi antar jalan pada satu permukaan adalah persoalan lain, dan itu kami ukur sebelumnya di variasi jalan pelacak visibilitas AI.
Apa yang kami jalankan
Butir | Pengaturan |
|---|---|
Prompt | Dua puluh pertanyaan yang akan diajukan pembeli tentang alat visibilitas AI |
Permukaan | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Pencarian web | Aktif di ketiga permukaan |
Wilayah dan bahasa | Amerika Serikat, Inggris |
Tanggal | 12 September 2026 |
Jawaban terkumpul | 60 |
Biaya seluruh jalan | 1,444 dolar, atau 0,024 dolar per jawaban |
Pengulangan | Kami menjalankan lagi lima prompt yang sama untuk melihat apakah perilakunya stabil |
Biaya per jawaban berkisar dari 0,006 dolar di Perplexity sampai 0,037 dolar di Gemini. Permukaan termurah menghasilkan daftar sumber paling konsisten, dan yang termahal bukanlah yang mengembalikan sumber paling banyak.
Dua sinyal, diukur terpisah
Kami menangkap setiap jawaban dua kali: sekali sebagai teks, sekali sebagai daftar sumber yang dilampirkan permukaan pada teks itu.
Permukaan | Anotasi sumber | Per jawaban | Jawaban tanpa kutipan | Domain berbeda per jawaban |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | 0 sampai 18, median 0 | 12 dari 20 | 0 sampai 10 |
Gemini 2.5 Flash | 989 | 14 sampai 122, median 47 | 0 dari 20 | 3 sampai 23 |
Perplexity | 399 | 19 sampai 20 | 0 dari 20 | 16 sampai 20 |
Ketiga daftar ini bukan jenis objek yang sama, dan di sinilah pemeriksa pertama kali keliru.
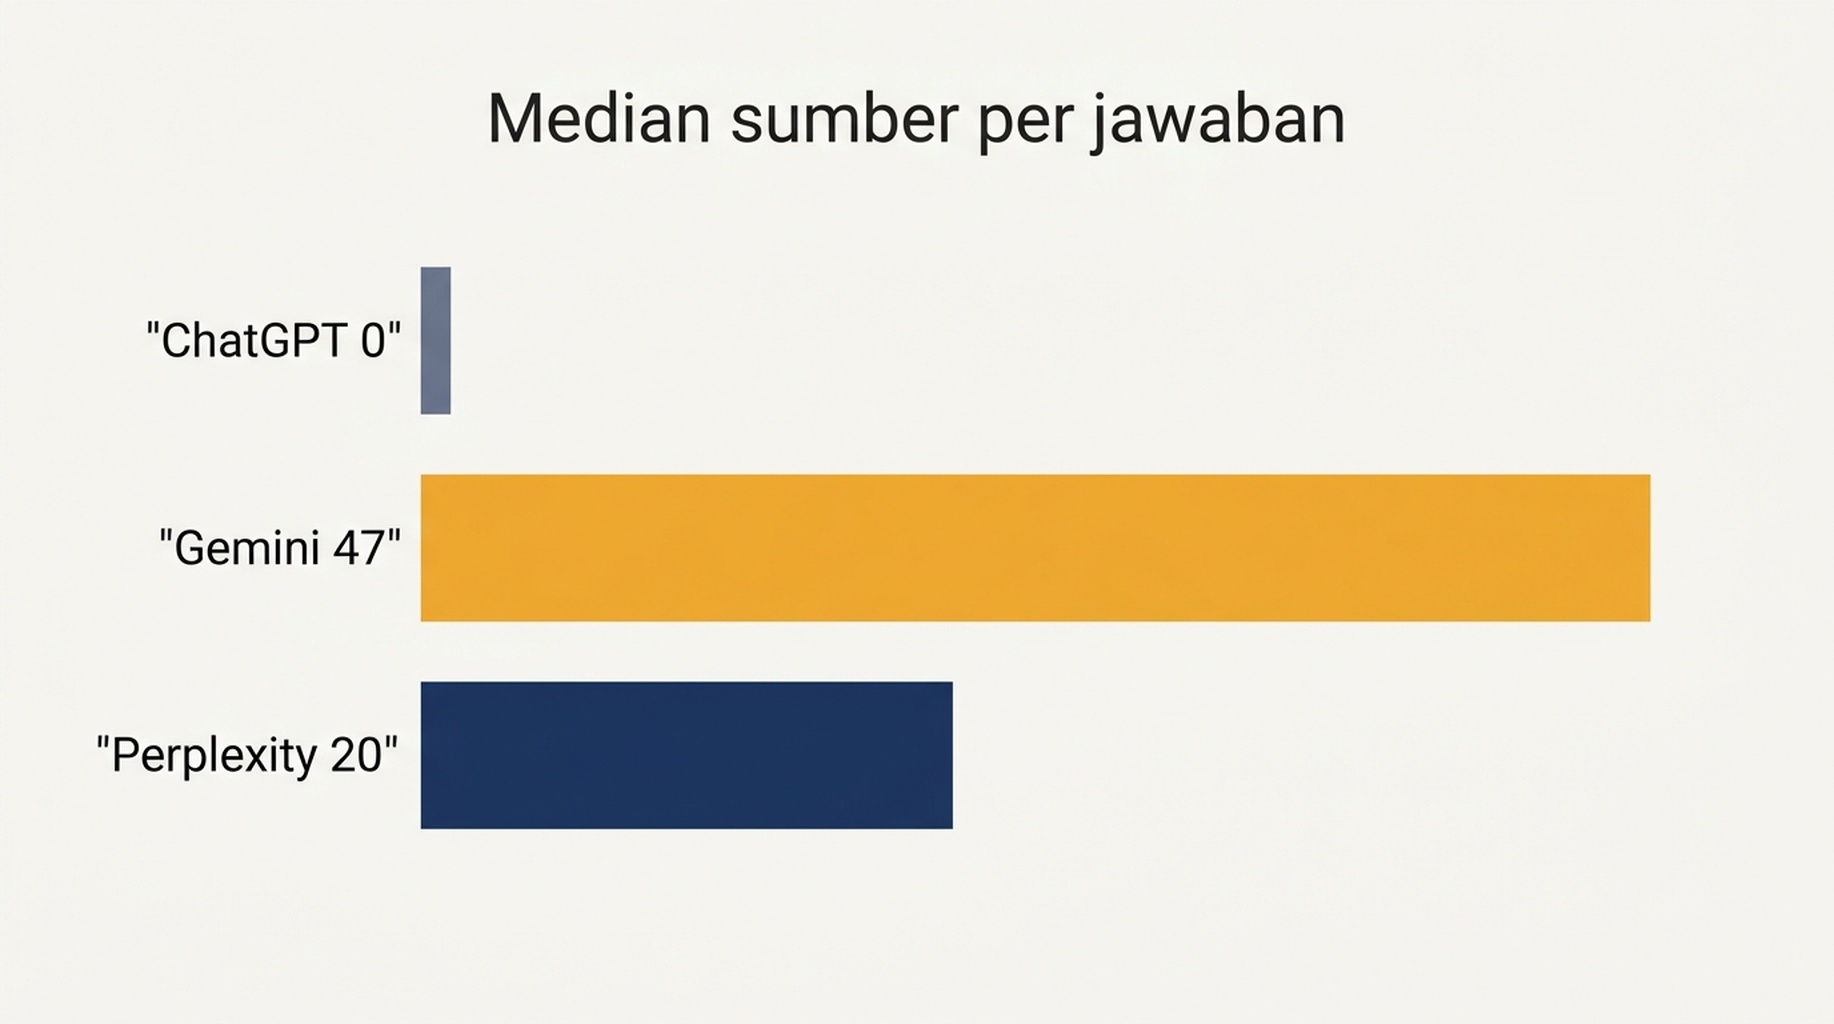
Gemini melampirkan sumber pada hampir setiap klaim. Halaman yang sama bisa menempati banyak slot dalam satu jawaban, dan itulah sebabnya angkanya setinggi itu: sepanjang 20 jawaban Gemini, semrush.com menempati 44 slot, maxaeo.ai dua puluh enam, google.com dua puluh dua, adobe.com dua puluh satu, dan medium.com dua puluh. Tingginya jumlah anotasi di permukaan ini berbicara tentang seberapa halus model memecah bahan, bukan tentang seberapa dikenal merek Anda.
Perplexity justru membuka panel yang punya batas atas. Ia mengembalikan tepat dua puluh sumber pada 19 dari 20 prompt dan sembilan belas pada prompt kedua puluh. Itu mematok penyebut: porsi Anda dalam jawaban Perplexity selalu porsi dari dua puluh, jadi merebut satu slot berarti seseorang kehilangan satu slot di tempat lain.
ChatGPT hanya mengembalikan daftar sumber ketika ia mencari. Ia melepas kueri pencarian pada 8 dari 20 prompt dan tidak mengutip apa pun pada dua belas sisanya. Pada dua belas itu ia tetap menjawab pertanyaannya dan tetap menyebut nama alat. Satu contoh tanpa penyuntingan: ketika ditanya alat terbaik untuk memantau penyebutan merek di hasil pencarian AI, ia menyebut Brand24, Mention, BuzzSumo, Talkwalker, dan Google Alerts, tanpa satu pun sumber dilampirkan pada salah satunya. Daftar periksa yang kami pakai untuk mengaudit jawaban ChatGPT atas pola kegagalan ini ada di daftar periksa visibilitas di ChatGPT.
Disebut tanpa dikutip
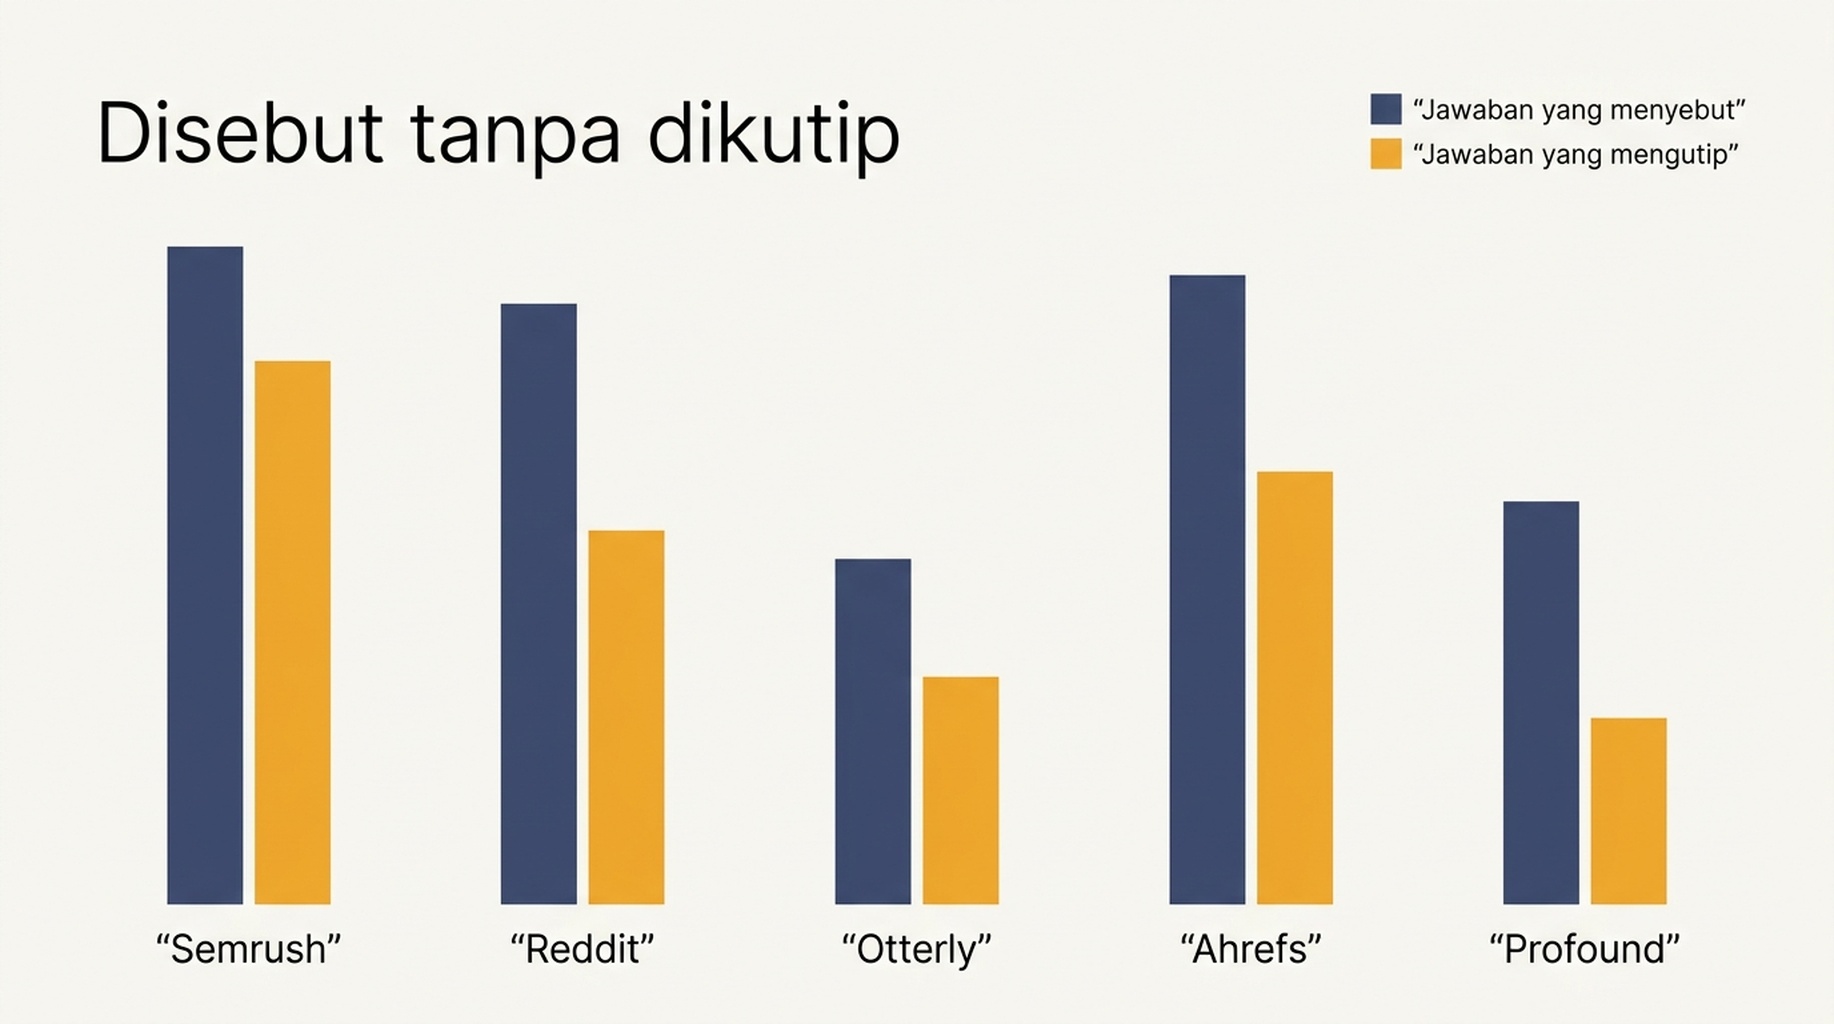
Berikutnya kami menghitung, untuk 27 merek dan media, pada berapa dari 60 jawaban merek itu disebut di dalam teks dan pada berapa domainnya dikutip sebagai sumber. Kedua kolom berbeda di kedua arah sekaligus.
Merek | Jawaban yang menyebutnya | Jawaban yang mengutip domainnya |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
Ada dua pola di tabel ini. Peec AI, Otterly, Profound, dan ZipTie direkomendasikan dalam jawaban jauh lebih sering daripada halaman mereka ditautkan. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps, dan Menra sebaliknya: halaman mereka ditarik masuk sebagai sumber sementara jawaban tidak pernah menyebut nama perusahaannya. Pemeriksa yang hanya melihat tautan akan menilai kelompok kedua terlihat dan kelompok pertama tidak terlihat. Pemeriksa yang hanya melihat penyebutan melakukan sebaliknya.
Sepanjang 60 jawaban, ketiga permukaan bersama-sama mengutip 432 domain berbeda. ChatGPT menyumbang 47 di antaranya, yaitu 11 persen, Gemini 184 (43 persen), dan Perplexity 285 (66 persen). Permukaan mana pun yang Anda periksa, Anda sedang melihat sampel dari semesta sumber yang jauh lebih besar. Ini tidak termasuk permukaan Google sendiri, yang di sana kehadirannya diukur dengan cara lain dan kami jelaskan di pelacak AI Overview.
Apa yang wajib dicatat pemeriksa
Pemeriksa visibilitas yang mengembalikan satu angka sedang membuang tiga dari empat kolomnya. Inilah empat yang layak dipertahankan.
Kolom | Bentuk pencatatan | Mengapa itu mengubah putusan |
|---|---|---|
Apakah permukaannya mencari | ya atau tidak | Jawaban yang tidak mencari tidak bisa menghasilkan kutipan, jadi nolnya bukan sinyal visibilitas |
Apakah merek disebut di dalam teks jawaban | jumlah jawaban | Satu-satunya sinyal yang bertahan pada jawaban tanpa dasar |
Apakah domainnya ada di daftar sumber | jumlah jawaban | Sinyal yang dilaporkan sebagian besar alat sendirian |
Penyebut | jumlah jawaban, dan jumlah slot sumber per jawaban | Panel dengan dua puluh slot tetap dan daftar berisi 47 anotasi tidak bisa dibandingkan sebagai persentase |
Akibat praktisnya adalah nol palsu. Dalam data kami, 13 dari 20 jawaban ChatGPT menyebut setidaknya satu vendor, sementara hanya 8 dari 20 mengutip apa pun, jadi sekitar seperempat jawaban di permukaan ini akan melaporkan nol kutipan untuk merek yang jawaban yang sama itu sebut dan rekomendasikan.
Cara melakukannya tanpa menipu diri sendiri
Pola kegagalan ketika Anda menyerahkan pekerjaan ini ke agen bukan angka yang salah, melainkan angka yang percaya diri yang dihitung dari kolom yang tidak pernah dikumpulkan.
- Tangkap muatan mentahnya sebelum menghitung apa pun. Simpan teks jawaban, daftar sumber, pengenal model, dan nilai benar-salah tentang apakah kueri pencarian dilepas. Metrik turunan dibangun di dalam kode pada tahap kedua, bukan ditaruh di dalam prompt pengumpulan.
- Buat agennya mengutip, bukan merangkum. Rubrik "laporkan berapa kali merek muncul" menghasilkan prosa. Rubrik "kembalikan teks jawaban dan daftar sumber apa adanya" menghasilkan data yang bisa Anda periksa ulang.
- Jalankan ulang prompt yang sama sebelum mempercayai perubahan. Kami mengulang lima prompt dan keputusan mencari itu cocok pada 5 dari 5, jadi lonjakan mendadak pada jumlah kutipan lebih mungkin versi model atau suntingan prompt daripada derau.
- Simpan pengenal model di setiap baris. Dua puluh prompt yang sama di titik akhir yang sama lewat gpt-4o hanya mengembalikan anotasi sumber pada 2 dari 20, sedangkan gpt-5 pada 8 dari 20.
- Sisihkan anggaran. Jalan penuh 60 jawaban menghabiskan 1,444 dolar, jadi pada tarif ini versi mingguan dari pemeriksaan yang sama berada di sekitar 6 dolar per bulan.
Batasan
- Satu hari, satu wilayah, bahasa Inggris, tiga permukaan. Jawaban berbeda antar wilayah.
- Satu versi model per permukaan. Bahkan pada jalan kami sendiri, perilakunya bergeser antar versi model.
- Deteksi merek adalah pencocokan untai berdasarkan nama, jadi merek yang direkomendasikan hanya lewat nama produknya bisa terlewat.
- Pencarian web dinyalakan lewat API. Aplikasi konsumen mungkin mencari lebih banyak daripada jalan ini, atau lebih sedikit.
- Biaya hanya mencakup pembuatan jawaban dan tidak termasuk waktu penyimpanan atau peninjauan.
Pertanyaan umum
Mengapa ChatGPT melaporkan nol kutipan pada 12 dari 20 prompt?
Karena ia menjawab prompt itu tanpa mencari. Model yang tidak pernah mengambil halaman tidak bisa mengutipnya. Jadi nol itu menggambarkan jalannya, bukan merek Anda. Sebelum membaca angka kutipan dari permukaan obrolan mana pun, periksa dulu apakah permukaan itu benar-benar memakai web.
Apakah penyebutan masih bernilai kalau tidak ada tautannya sama sekali?
Pada jawaban tanpa dasar, itulah seluruh sinyalnya, dan itu juga sinyal yang datang sebelum tautan. Dalam data kami, penyebutan dan tautan diperoleh dari sumber yang berbeda: penyebutan mengikuti konten perbandingan dan ulasan, sedangkan kutipan mengikuti halaman yang disusun agar dikutip.
Haruskah saya menggabungkan penyebutan dan kutipan jadi satu skor visibilitas?
Tidak. Seperti ditunjukkan tabel merek, keduanya berbeda secara sistematis di kedua arah, dan skor gabungan menyembunyikan mana yang bergerak. Laporkan keduanya sebagai dua garis dan biarkan pembaca melihat selisihnya.
Permukaan mana yang harus saya periksa lebih dulu?
Kalau Anda ingin panel yang stabil, murah, dan lebarnya tetap, pilih Perplexity, karena panjang daftarnya tidak berubah. Kalau Anda ingin keluasan, pilih Gemini, yang mencapai 184 dari 432 domain yang kami lihat. ChatGPT hanya dengan pemeriksaan kelayakan yang disertakan, kalau tidak, seperlima jawabannya akan terbaca sebagai merek yang tak terlihat.
Pandangan Auspia: laporkan penyebutan dan kutipan sebagai dua garis terpisah, dan catat apakah permukaannya mencari sebelum mencatat hal lain apa pun. Satu skor visibilitas justru menyembunyikan selisih yang memberi tahu Anda apa yang harus diperbaiki berikutnya, dan perbaikan termurah dalam data kami bukan menambah konten, melainkan memeriksa permukaan yang benar-benar melihat ke web.
Penulis: Adrian Cole