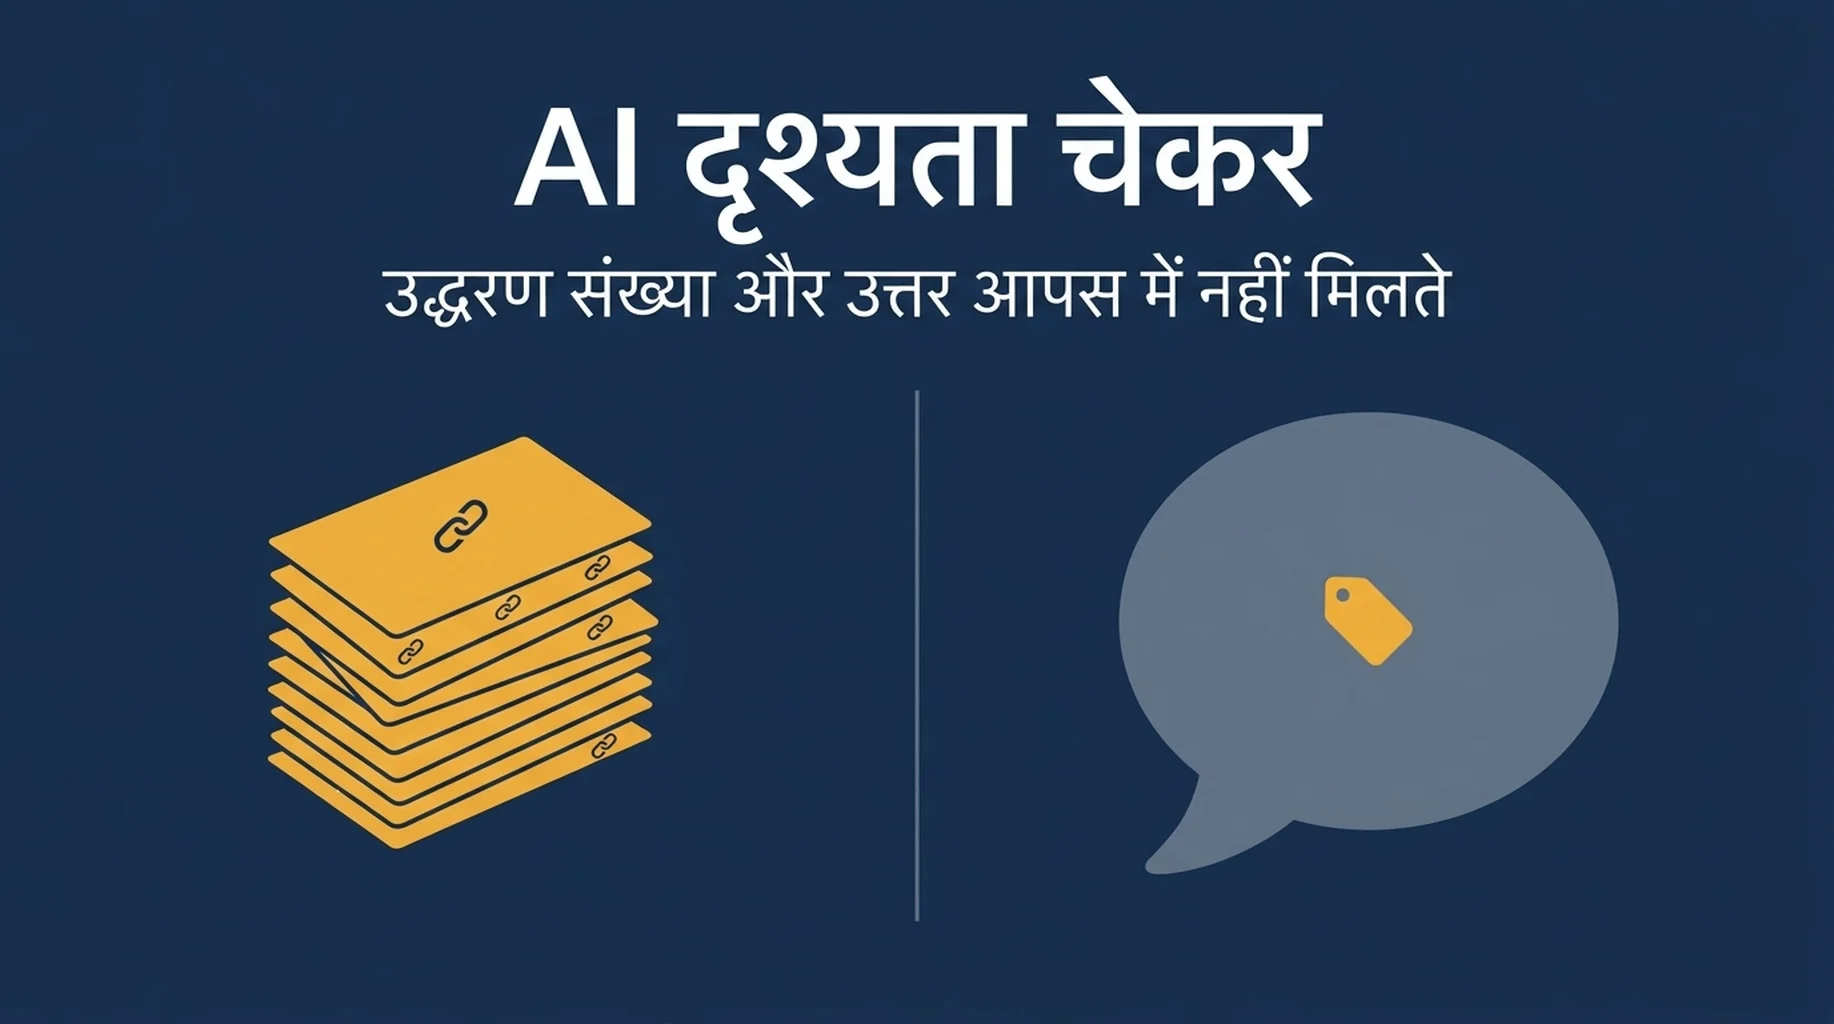
AI दृश्यता के दो चेकर एक ही दिन वही उत्तर पढ़कर उलटे नतीजे निकाल सकते हैं। एक उद्धरणों की संख्या लौटाता है, दूसरा कुछ भी नहीं लौटाता, क्योंकि उत्तर ने आपके ब्रांड का नाम लेकर उसकी सिफ़ारिश की और एक बार भी उससे लिंक नहीं किया।
सितंबर 2026 में हमने तीन AI सतहों पर बीस प्रॉम्प्ट चलाए और हर उत्तर पर दो संकेत दर्ज किए: उत्तर ने पाठ में जिस ब्रांड का नाम लिया, और उत्तर ने जिस डोमेन को स्रोत के रूप में पेश किया। ये एक ही माप के दो कोण नहीं हैं। ये अनुमान लगाए जा सकने वाले स्थानों पर अलग हो जाते हैं, और वही स्थान रिपोर्ट का सबसे उपयोगी हिस्सा हैं।
संक्षेप में: Perplexity ने हर प्रॉम्प्ट पर स्रोत उद्धृत किए, Gemini ने प्रति उत्तर 47 स्रोतों का माध्यक लौटाया, जबकि ChatGPT ने 20 में से 12 प्रॉम्प्ट पर कोई उद्धरण नहीं लौटाया, फिर भी उनमें से 13 पर विक्रेताओं के नाम गिनाए। एक ही सतह पर बार-बार चलाने के बीच का उतार-चढ़ाव अलग मुद्दा है, और हमने उसे पहले AI दृश्यता ट्रैकर के रन-दर-रन उतार-चढ़ाव में मापा था।
हमने क्या चलाया
मद | सेटिंग |
|---|---|
प्रॉम्प्ट | खरीदार AI दृश्यता उपकरणों के बारे में जो बीस सवाल पूछता |
सतहें | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
वेब खोज | तीनों सतहों पर चालू |
क्षेत्र और भाषा | संयुक्त राज्य अमेरिका, अंग्रेज़ी |
तारीख | 12 सितंबर 2026 |
एकत्र उत्तर | 60 |
पूरे रन की लागत | 1,444 डॉलर, यानी प्रति उत्तर 0.024 डॉलर |
दोहराव | वही पाँच प्रॉम्प्ट दोबारा चलाए ताकि पता चले कि व्यवहार स्थिर है या नहीं |
प्रति उत्तर लागत Perplexity के 0.006 डॉलर से Gemini के 0.037 डॉलर तक रही। सबसे सस्ती सतह ने सबसे सुसंगत स्रोत सूची दी, और सबसे महँगी सतह वह नहीं थी जिसने सबसे ज़्यादा स्रोत लौटाए।
दो संकेत, अलग-अलग मापे गए
हमने हर उत्तर को दो बार कैद किया: एक बार पाठ के रूप में, और एक बार उस स्रोत सूची के रूप में जो सतह ने उस पाठ के साथ जोड़ी।
सतह | स्रोत एनोटेशन | प्रति उत्तर | बिना उद्धरण वाले उत्तर | प्रति उत्तर अलग डोमेन |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | 0 से 18, माध्यक 0 | 20 में से 12 | 0 से 10 |
Gemini 2.5 Flash | 989 | 14 से 122, माध्यक 47 | 20 में से 0 | 3 से 23 |
Perplexity | 399 | 19 से 20 | 20 में से 0 | 16 से 20 |
ये तीन सूचियाँ एक ही तरह की वस्तु नहीं हैं, और यहीं चेकर सबसे पहले गलती करता है।
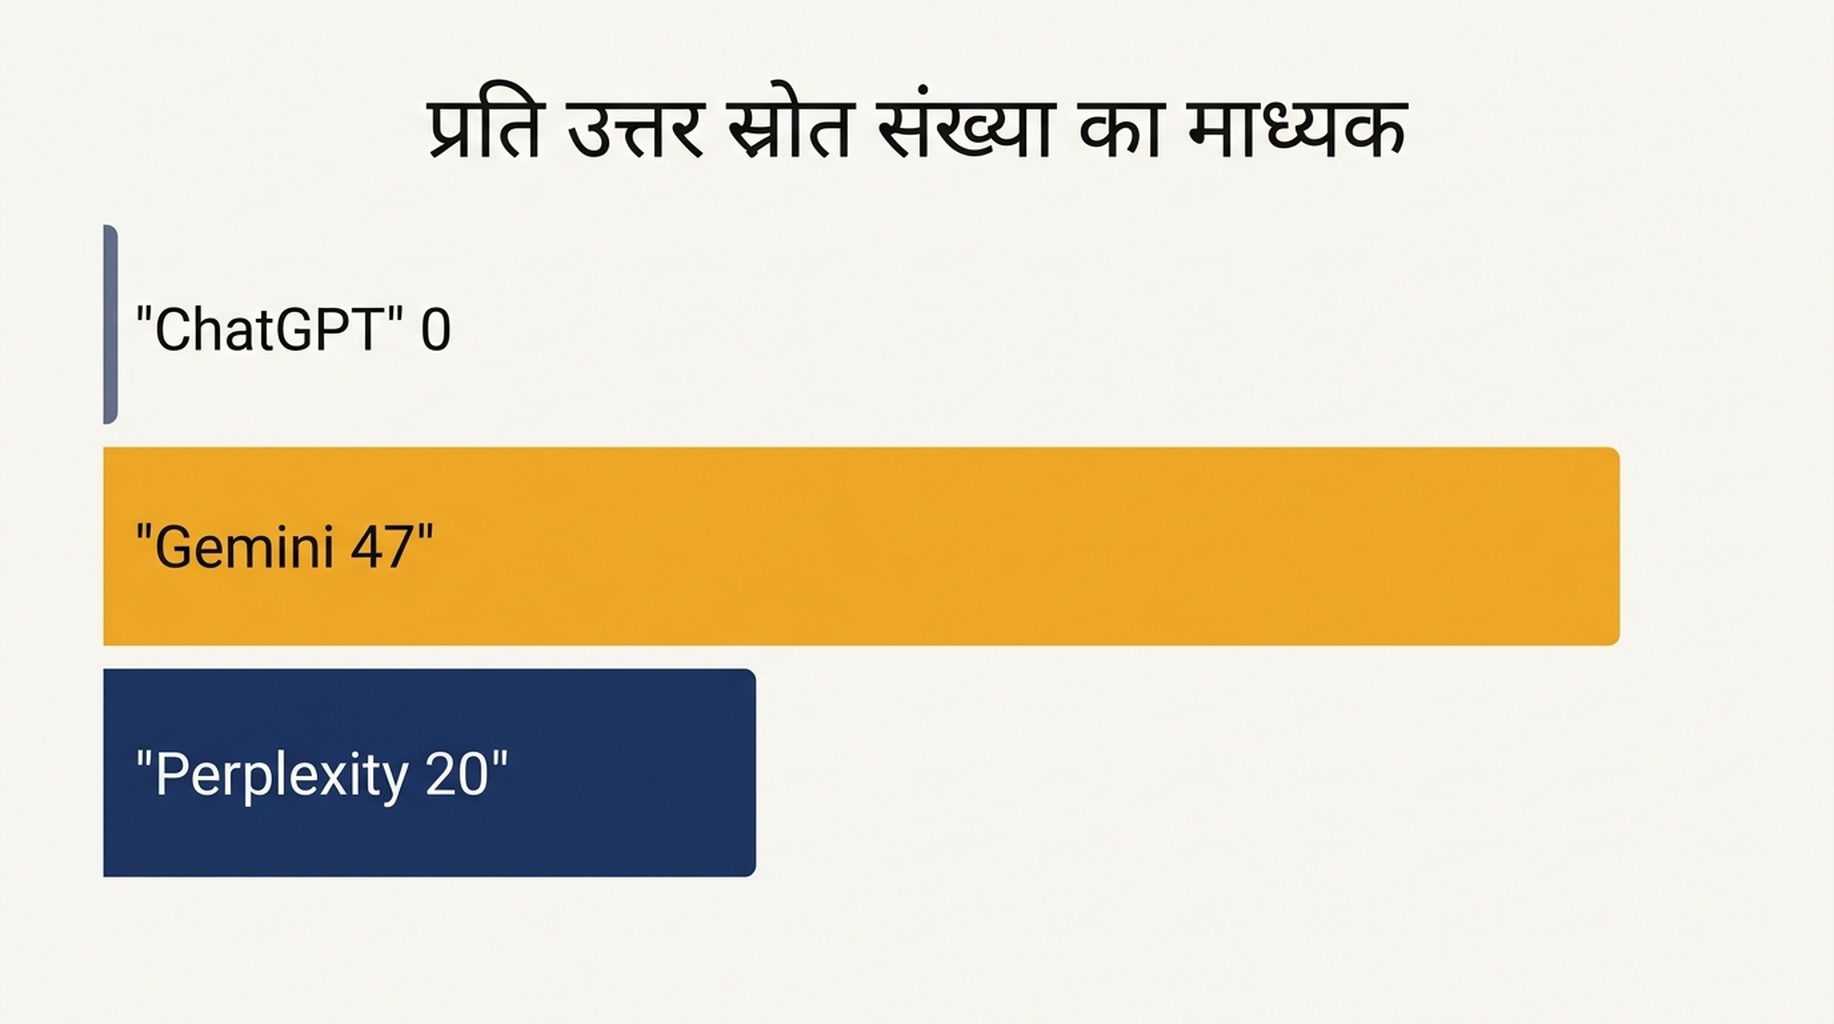
Gemini लगभग हर दावे के साथ एक स्रोत जोड़ता है। एक ही पृष्ठ किसी एक उत्तर में कई जगहें ले सकता है, और इसीलिए संख्याएँ इतनी ऊँची हैं: 20 Gemini उत्तरों में semrush.com ने 44 जगहें लीं, maxaeo.ai छब्बीस, google.com बाईस, adobe.com इक्कीस और medium.com बीस। इस सतह पर ऊँची एनोटेशन संख्या यह बताती है कि मॉडल सामग्री को कितने बारीक टुकड़ों में बाँटता है, यह नहीं कि आपका ब्रांड कितना जाना-पहचाना है।
Perplexity इसके उलट एक ऐसा पैनल दिखाता है जिसकी एक ऊपरी सीमा है। उसने 20 में से 19 प्रॉम्प्ट पर ठीक बीस स्रोत लौटाए और बीसवें पर उन्नीस। इससे हर बार का भाजक तय हो जाता है: Perplexity के उत्तर में आपका हिस्सा हमेशा बीस में से एक हिस्सा होता है, यानी एक जगह जीतने का मतलब है कि कहीं और किसी ने एक जगह खोई।
ChatGPT स्रोत सूची तभी लौटाता है जब उसने खोज की हो। उसने 20 में से 8 प्रॉम्प्ट पर खोज क्वेरी भेजी और बाकी बारह पर कुछ भी उद्धृत नहीं किया। उन बारह पर भी उसने सवाल का जवाब दिया और उपकरणों के नाम गिनाए। एक बिना संपादित उदाहरण: AI खोज नतीजों में ब्रांड उल्लेखों पर नज़र रखने के सबसे अच्छे उपकरण पूछे जाने पर उसने Brand24, Mention, BuzzSumo, Talkwalker और Google Alerts की सूची दी, और इनमें से किसी के साथ कोई स्रोत नहीं जोड़ा। इस विफलता पैटर्न के लिए ChatGPT के उत्तरों की जाँच में हम जो चेकलिस्ट इस्तेमाल करते हैं, वह ChatGPT दृश्यता चेकलिस्ट में है।
नाम लिए बिना उद्धृत
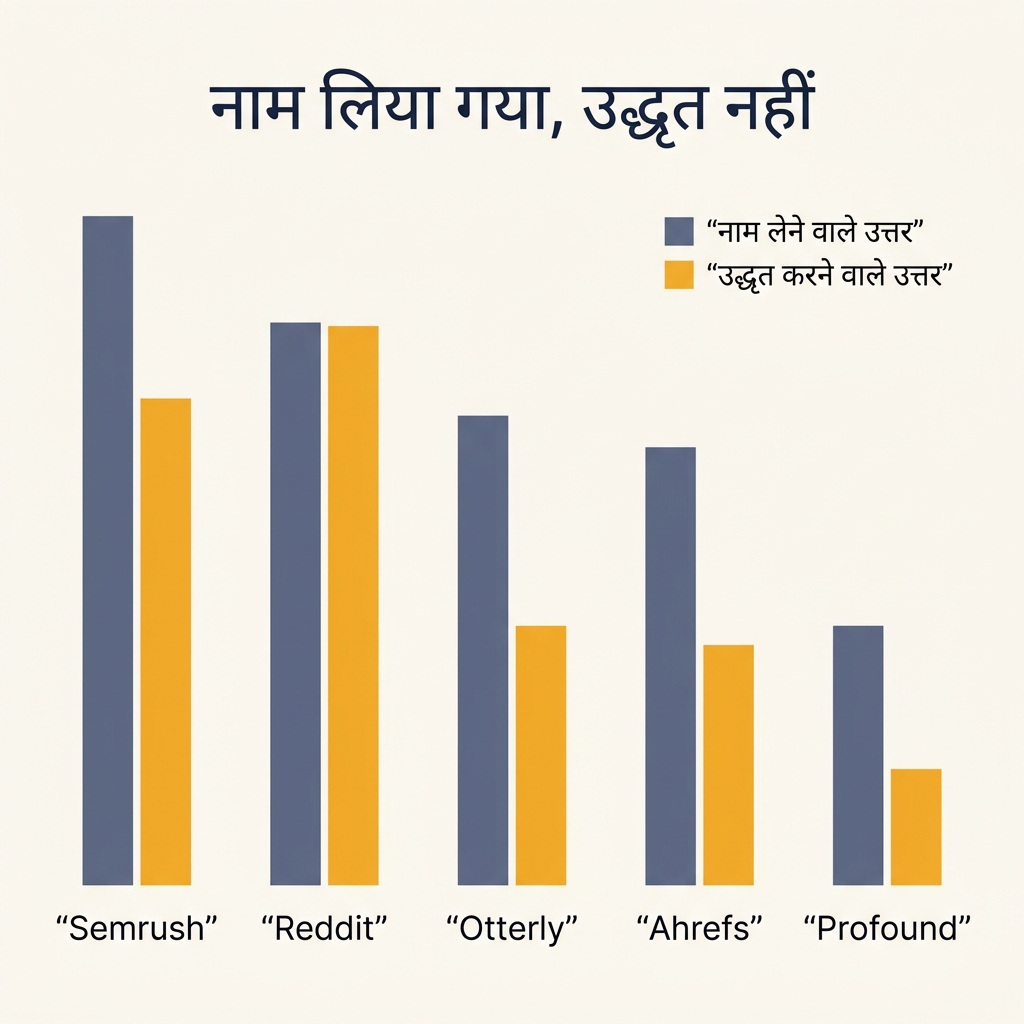
इसके बाद हमने 27 ब्रांडों और प्रकाशनों के लिए गिना कि 60 उत्तरों में से कितनों ने ब्रांड का नाम पाठ में लिया और कितनों ने उसके डोमेन को स्रोत के रूप में उद्धृत किया। दोनों स्तंभ एक साथ दोनों दिशाओं में अलग होते हैं।
ब्रांड | नाम लेने वाले उत्तर | डोमेन उद्धृत करने वाले उत्तर |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
इस तालिका में दो पैटर्न हैं। Peec AI, Otterly, Profound और ZipTie का ज़िक्र उत्तरों में उससे कहीं ज़्यादा होता है जितनी बार उनके पृष्ठों से लिंक जुड़ते हैं। MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps और Menra इसके उलट हैं: उनके पृष्ठ स्रोत के रूप में खिंचकर आते हैं जबकि उत्तर कभी कंपनी का नाम नहीं लेता। सिर्फ़ लिंक देखने वाला चेकर दूसरे समूह को दिखने वाला और पहले को अदृश्य ठहराएगा। सिर्फ़ उल्लेख देखने वाला चेकर उलटा करेगा।
सभी 60 उत्तरों में तीनों सतहों ने मिलकर 432 अलग डोमेन उद्धृत किए। इनमें से 47 ChatGPT के हैं, यानी 11 प्रतिशत, 184 Gemini के (43 प्रतिशत) और 285 Perplexity के (66 प्रतिशत)। आप चाहे कोई भी सतह जाँचें, आप एक बहुत बड़े स्रोत ब्रह्मांड का नमूना देख रहे हैं। इसमें Google की अपनी सतह शामिल नहीं है, जहाँ मौजूदगी किसी और तरह मापी जाती है और हमने उसे AI Overview ट्रैकर में समझाया है।
चेकर को क्या दर्ज करना ही चाहिए
सिर्फ़ एक संख्या लौटाने वाला दृश्यता चेकर अपने चार में से तीन फ़ील्ड फेंक रहा है। बचाने लायक चार ये हैं।
फ़ील्ड | दर्ज करने का रूप | यह नतीजा क्यों बदलता है |
|---|---|---|
सतह ने खोजा या नहीं | हाँ या नहीं | जिस उत्तर ने खोजा ही नहीं, वह उद्धरण पैदा नहीं कर सकता, इसलिए उसका शून्य दृश्यता का संकेत नहीं |
उत्तर के पाठ में ब्रांड का नाम लिया गया या नहीं | उत्तरों की संख्या | बिना आधार वाले उत्तर पर ज़िंदा बचने वाला इकलौता संकेत |
स्रोत सूची में डोमेन है या नहीं | उत्तरों की संख्या | वह संकेत जिसकी सूचना ज़्यादातर उपकरण अकेले देते हैं |
भाजक | उत्तरों की संख्या, और प्रति उत्तर स्रोत जगहें | बीस तय जगहों वाला पैनल और 47 एनोटेशन वाली सूची प्रतिशत के रूप में तुलनीय नहीं |
व्यवहार में नतीजा झूठा शून्य है। हमारे आँकड़ों में ChatGPT के 20 में से 13 उत्तरों ने कम से कम एक विक्रेता का नाम लिया, जबकि सिर्फ़ 20 में से 8 ने कुछ भी उद्धृत किया, यानी इस सतह के करीब एक चौथाई उत्तर ऐसे ब्रांड के लिए शून्य उद्धरण बताएँगे जिसे वही उत्तर नाम लेकर सिफ़ारिश कर रहा है।
खुद को धोखा दिए बिना यह कैसे करें
जब आप यह काम किसी एजेंट को सौंपते हैं तो विफलता पैटर्न गलत संख्या नहीं होता, बल्कि ऐसी आत्मविश्वासी संख्या होती है जो कभी जमा ही न किए गए फ़ील्ड से निकाली गई हो।
- कुछ भी गणना करने से पहले कच्चा पेलोड कैद करें। उत्तर का पाठ, स्रोत सूची, मॉडल पहचानकर्ता, और यह बताने वाला सत्य-असत्य मान कि खोज क्वेरी भेजी गई थी या नहीं, रख लें। व्युत्पन्न मीट्रिक कोड में दूसरे चरण में बनते हैं, संग्रह प्रॉम्प्ट के अंदर नहीं रखे जाते।
- एजेंट से सारांश नहीं, उद्धरण कराएँ। "ब्रांड कितनी बार आया बताओ" जैसा रूब्रिक गद्य बनाता है। "उत्तर का पाठ और स्रोत सूची शब्दशः लौटाओ" जैसा रूब्रिक ऐसा डेटा बनाता है जिसे आप दोबारा जाँच सकें।
- किसी बदलाव पर भरोसा करने से पहले वही प्रॉम्प्ट दोबारा चलाएँ। हमने पाँच प्रॉम्प्ट दोहराए और खोजने का फ़ैसला 5 में से 5 बार मेल खाया, यानी उद्धरण संख्या में अचानक उछाल शोर से ज़्यादा संभवतः मॉडल संस्करण या प्रॉम्प्ट संपादन है।
- हर पंक्ति में मॉडल पहचानकर्ता रखें। वही बीस प्रॉम्प्ट उसी एंडपॉइंट पर gpt-4o से चलाने पर सिर्फ़ 20 में से 2 में स्रोत एनोटेशन लौटे, जबकि gpt-5 से 20 में से 8 में।
- बजट तय रखें। 60 उत्तरों के पूरे रन पर 1,444 डॉलर लगे, यानी इन दरों पर उसी जाँच का साप्ताहिक संस्करण महीने के करीब 6 डॉलर का पड़ेगा।
सीमाएँ
- एक दिन, एक क्षेत्र, अंग्रेज़ी, तीन सतहें। उत्तर क्षेत्र-दर-क्षेत्र अलग होते हैं।
- प्रति सतह एक मॉडल संस्करण। हमारे अपने रनों में भी व्यवहार मॉडल संस्करणों के बीच खिसका।
- ब्रांड पहचान नाम पर आधारित शब्द-मिलान है, इसलिए सिर्फ़ उत्पाद नाम से सिफ़ारिश किया गया ब्रांड छूट सकता है।
- वेब खोज API के ज़रिए चालू की गई थी। उपभोक्ता ऐप इन रनों से ज़्यादा खोज सकते हैं, या कम।
- लागत सिर्फ़ उत्तर निर्माण को कवर करती है और इसमें भंडारण या समीक्षा का समय शामिल नहीं।
अक्सर पूछे जाने वाले प्रश्न
ChatGPT ने 20 में से 12 प्रॉम्प्ट पर शून्य उद्धरण क्यों बताए?
क्योंकि उसने वे प्रॉम्प्ट बिना खोजे ही हल किए। जो मॉडल कभी कोई पृष्ठ नहीं लाता, वह उसे उद्धृत नहीं कर सकता। यानी वह शून्य रन का वर्णन करता है, आपके ब्रांड का नहीं। किसी भी चैट सतह से उद्धरण संख्या पढ़ने से पहले यह जाँचें कि उस सतह ने वाकई वेब इस्तेमाल किया या नहीं।
अगर कोई लिंक ही न हो तो उल्लेख का कोई मूल्य है?
बिना आधार वाले उत्तर पर वही पूरा संकेत है, और वही संकेत लिंक से पहले आता है। हमारे आँकड़ों में उल्लेख और लिंक अलग-अलग स्रोतों से मिलते हैं: उल्लेख तुलनात्मक और समीक्षा सामग्री के पीछे चलता है, उद्धरण उन पृष्ठों के पीछे जो उद्धृत होने के लिए गढ़े गए हैं।
क्या मुझे उल्लेखों और उद्धरणों को एक ही दृश्यता स्कोर में मिला देना चाहिए?
नहीं। जैसा ब्रांड तालिका दिखाती है, दोनों दोनों दिशाओं में व्यवस्थित रूप से अलग होते हैं, और मिला हुआ स्कोर छिपा देता है कि हिला कौन। इन्हें दो अलग रेखाओं के रूप में बताएँ और पाठक को वह अंतर देखने दें।
पहले कौन सी सतह जाँचनी चाहिए?
अगर आप स्थिर, सस्ता और तय चौड़ाई वाला पैनल चाहते हैं तो Perplexity चुनें, क्योंकि उसकी सूची की लंबाई नहीं बदलती। अगर विस्तार चाहिए तो Gemini चुनें, जो हमारे देखे 432 डोमेन में से 184 तक पहुँचा। ChatGPT सिर्फ़ साथ में एक तर्कसंगतता जाँच रखकर, वरना उसके उत्तरों का पाँचवाँ हिस्सा अदृश्य ब्रांड के रूप में पढ़ा जाएगा।
Auspia की राय: उल्लेखों और उद्धरणों को दो अलग रेखाओं के रूप में बताएँ, और बाकी कुछ भी दर्ज करने से पहले यह दर्ज करें कि सतह ने खोजा या नहीं। एक ही दृश्यता स्कोर ठीक उसी अंतर को छिपाता है जो बताता है कि आगे क्या ठीक करना है, और हमारे आँकड़ों में सबसे सस्ता सुधार सामग्री बढ़ाना नहीं था, बल्कि ऐसी सतह जाँचना था जिसने वाकई वेब देखा हो।
लेखन: एड्रियन कोल