Два чекера видимости в ИИ могут прочитать одни и те же ответы в один и тот же день и вынести противоположные вердикты. Один возвращает число цитирований, другой не возвращает ничего, потому что ответ назвал ваш бренд по имени и порекомендовал его, ни разу не сославшись на него ссылкой.
В сентябре 2026 года мы прогнали двадцать запросов по трём поверхностям ИИ и на каждом ответе зафиксировали два сигнала: бренд, который ответ назвал в тексте, и домен, который ответ предъявил как источник. Это не два ракурса одного измерения. Они расходятся в предсказуемых местах, и именно эти места — самое полезное в отчёте.
Короткая версия: Perplexity сослался на источники на каждом запросе, Gemini вернул медиану 47 источников на ответ, а ChatGPT не вернул ни одной ссылки на 12 из 20 запросов, но при этом назвал вендоров в 13 из них. Разброс между запусками на одной поверхности — отдельный вопрос, и его мы измеряли раньше в материале разброс запусков трекера видимости в ИИ.
Что мы прогнали
Пункт | Настройка |
|---|---|
Запросы | Двадцать вопросов, которые задал бы покупатель об инструментах видимости в ИИ |
Поверхности | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Поиск в вебе | Включён на всех трёх поверхностях |
Регион и язык | США, английский |
Дата | 12 сентября 2026 года |
Собрано ответов | 60 |
Стоимость всего прогона | 1,444 доллара, то есть 0,024 доллара за ответ |
Повторный прогон | Прогнали те же пять запросов второй раз, чтобы увидеть, устойчиво ли поведение |
Стоимость ответа лежала в диапазоне от 0,006 доллара у Perplexity до 0,037 доллара у Gemini. Самая дешёвая поверхность дала самый согласованный список источников, а самая дорогая не была той, что вернула больше всего источников.
Два сигнала, измеренные по отдельности
Каждый ответ мы фиксировали дважды: один раз как текст, второй раз как список источников, который поверхность приложила к этому тексту.
Поверхность | Разметки источников | На ответ | Ответов без ссылок | Разных доменов на ответ |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | от 0 до 18, медиана 0 | 12 из 20 | от 0 до 10 |
Gemini 2.5 Flash | 989 | от 14 до 122, медиана 47 | 0 из 20 | от 3 до 23 |
Perplexity | 399 | от 19 до 20 | 0 из 20 | от 16 до 20 |
Эти три списка — не один и тот же тип объекта, и именно здесь чекер ошибается в первую очередь.
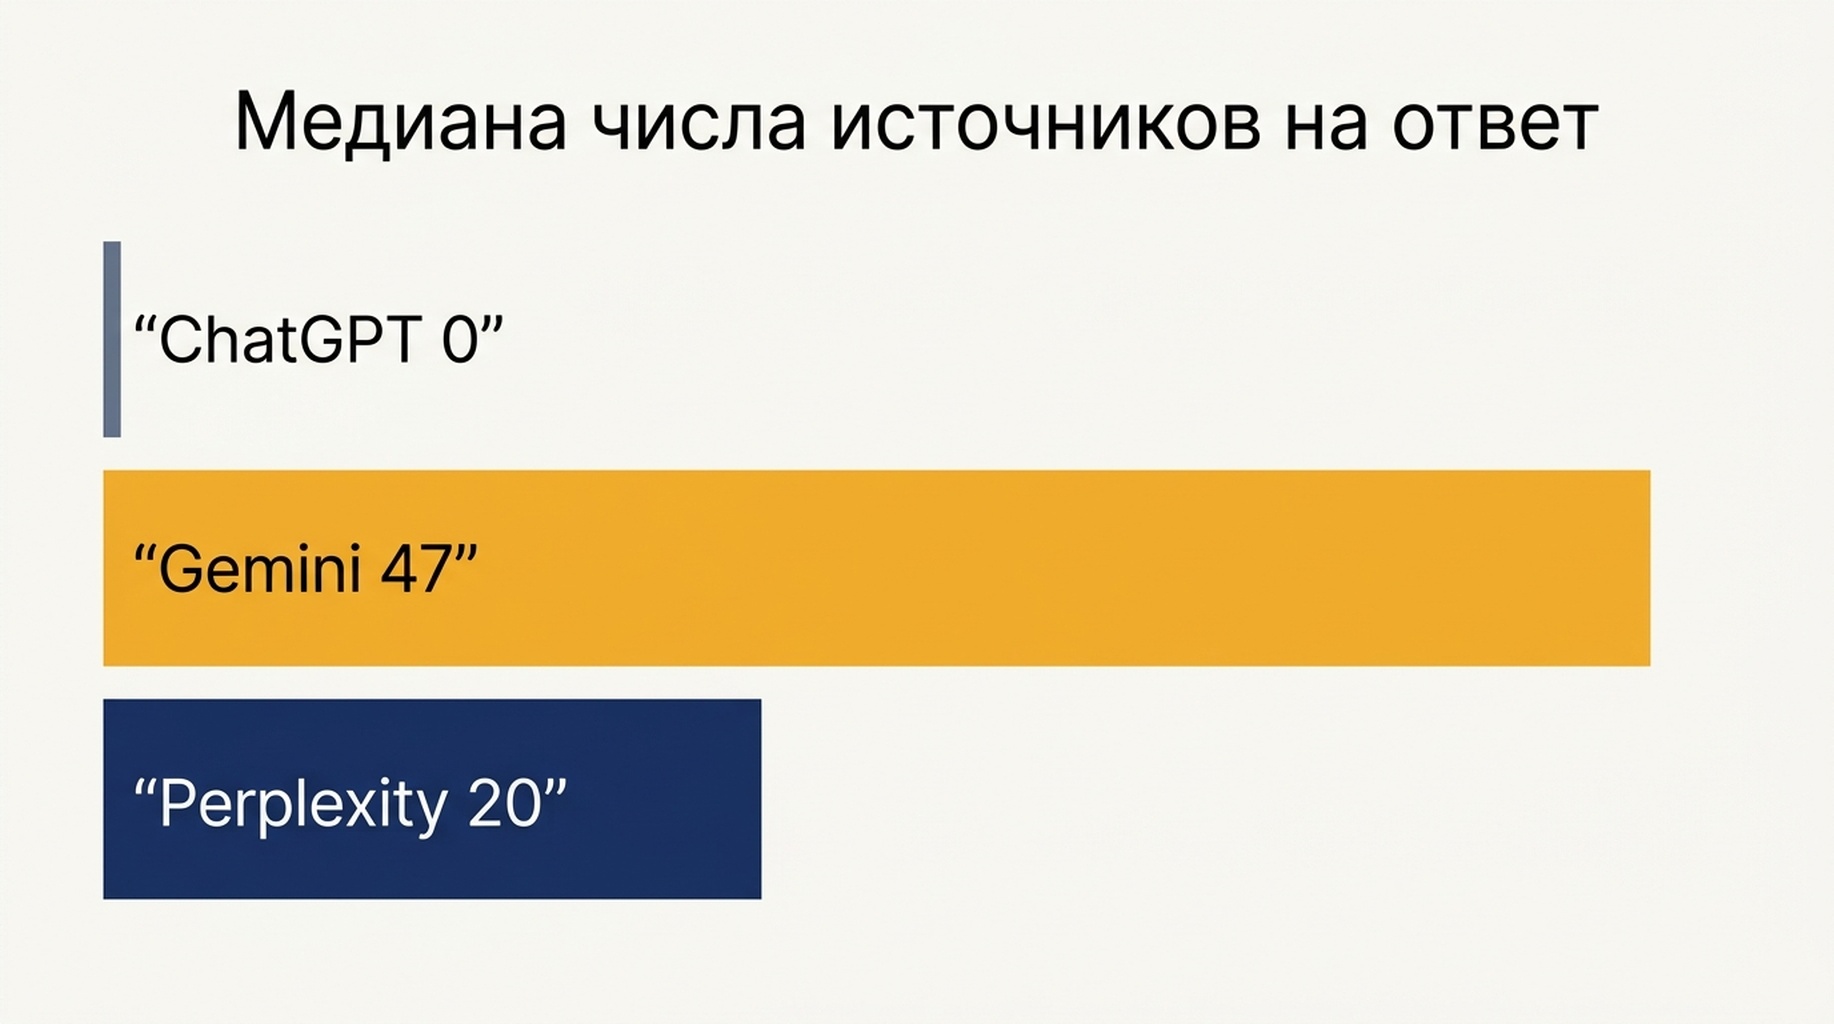
Gemini прикладывает источник почти к каждому утверждению. Одна и та же страница может занимать в одном ответе множество мест, и именно поэтому числа такие высокие: по 20 ответам Gemini домен semrush.com занял 44 места, maxaeo.ai — двадцать шесть, google.com — двадцать два, adobe.com — двадцать одно, medium.com — двадцать. Высокое число разметок на этой поверхности говорит о том, насколько мелко модель разбирает материал, а не о том, насколько широко известен ваш бренд.
Perplexity публикует панель с потолком. Он вернул ровно двадцать источников в 19 из 20 запросов и девятнадцать в двадцатом. Это фиксирует знаменатель: ваша доля в ответе Perplexity — это всегда доля из двадцати, так что полученное место означает, что кто-то в другом месте место потерял.
ChatGPT возвращает список источников только тогда, когда он искал. Поисковый запрос он отправил в 8 из 20 случаев, а в остальных двенадцати не процитировал ничего. В этих двенадцати он всё равно ответил на вопрос и всё равно назвал инструменты. Один пример без редактуры: на вопрос о лучших инструментах отслеживания упоминаний бренда в результатах ИИ-поиска он перечислил Brand24, Mention, BuzzSumo, Talkwalker и Google Alerts, и ни к одному не приложил источник. Чек-лист, которым мы пользуемся, чтобы проверять ответы ChatGPT на этот режим отказа, лежит в материале чек-лист видимости в ChatGPT.
Назван по имени, но не процитирован
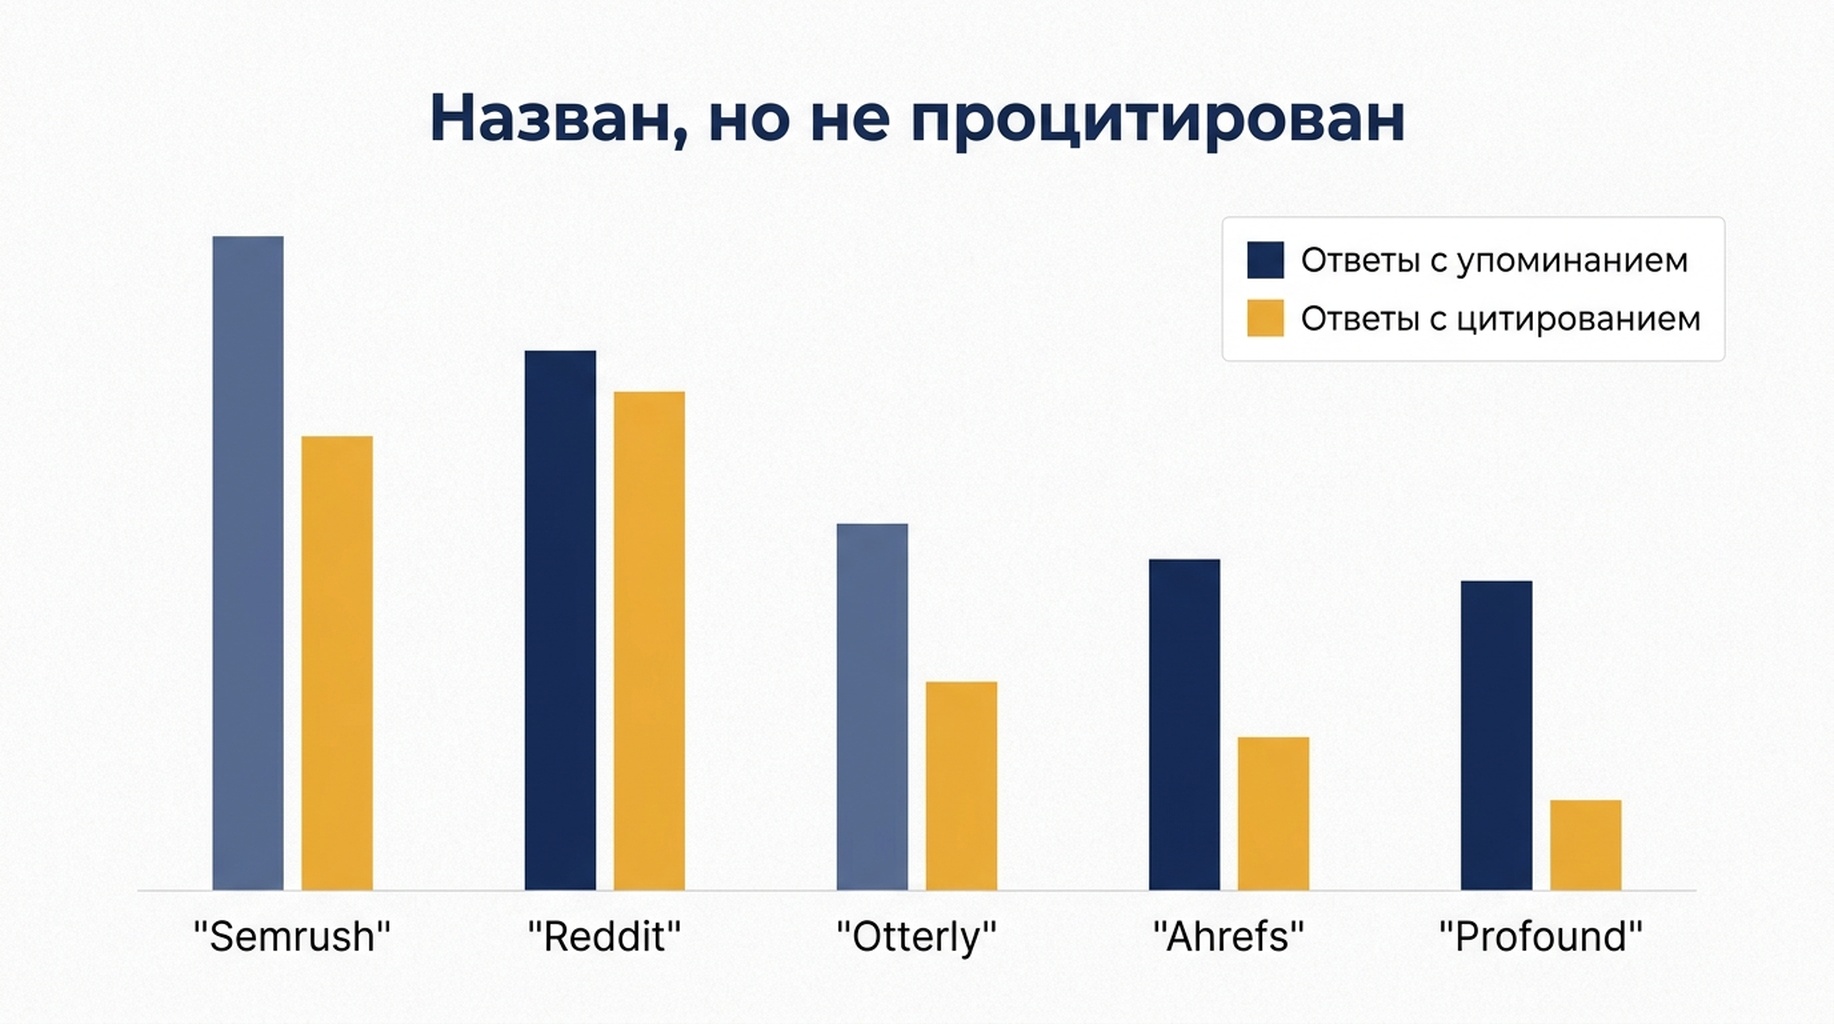
Затем мы посчитали по 27 брендам и медиа, в скольких из 60 ответов бренд был назван в тексте и в скольких был процитирован его домен как источник. Два столбца расходятся в обе стороны сразу.
Бренд | Ответов, назвавших его | Ответов, процитировавших его домен |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
В этой таблице два узора. Peec AI, Otterly, Profound и ZipTie рекомендуются в ответах куда чаще, чем ссылаются на их страницы. У MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps и Menra всё наоборот: их страницы втягиваются как источники, тогда как ответ ни разу не называет компанию. Чекер, который смотрит только на ссылки, признает вторую группу видимой, а первую — невидимой. Чекер, который смотрит только на упоминания, сделает наоборот.
По всем 60 ответам три поверхности вместе процитировали 432 разных домена. На ChatGPT приходится 47 из них, то есть 11 процентов, на Gemini — 184 (43 процента), на Perplexity — 285 (66 процентов). Какую бы поверхность вы ни проверяли, вы смотрите на выборку из гораздо более крупной вселенной источников. Сюда не входит собственная поверхность Google, где присутствие измеряется иначе — об этом в материале трекер AI Overview.
Что чекер обязан фиксировать
Чекер видимости, который возвращает одно число, выбрасывает три из четырёх своих полей. Вот четыре, которые стоит сохранить.
Поле | Форма фиксации | Почему это меняет вердикт |
|---|---|---|
Искала ли поверхность | да или нет | Ответ, который не искал, не может породить ссылки, поэтому его ноль — не сигнал видимости |
Назван ли бренд в тексте ответа | число ответов | Единственный сигнал, который выживает на ответе без обоснования |
Есть ли домен в списке источников | число ответов | Сигнал, о котором большинство инструментов сообщает в одиночку |
Знаменатель | число ответов и число мест под источники на ответ | Панель с фиксированными двадцатью местами и список на 47 разметок нельзя сравнивать как проценты |
Практическое следствие — ложный ноль. В наших данных 13 из 20 ответов ChatGPT назвали хотя бы одного вендора, тогда как процитировали хоть что-то лишь 8 из 20, то есть примерно четверть ответов этой поверхности будет сообщать ноль ссылок по бренду, который тот же самый ответ назвал по имени и порекомендовал.
Как делать это, не обманывая себя
Режим отказа, когда вы отдаёте эту работу агенту, — не неверное число, а уверенное число, посчитанное из поля, которое никогда не собирали.
- Захватывайте сырую нагрузку до того, как что-либо посчитаете. Сохраняйте текст ответа, список источников, идентификатор модели и булево значение о том, был ли отправлен поисковый запрос. Производные метрики строятся в коде на втором этапе, а не кладутся внутрь запроса на сбор.
- Заставляйте агента цитировать, а не пересказывать. Критерий «сообщи, сколько раз встретился бренд» порождает прозу. Критерий «верни дословно текст ответа и список источников» порождает данные, которые можно перепроверить.
- Прогоняйте один и тот же запрос заново, прежде чем поверить в изменение. Мы повторили пять запросов, и решение о поиске совпало в 5 случаях из 5, то есть резкий скачок числа ссылок скорее окажется версией модели или правкой запроса, а не шумом.
- Оставляйте идентификатор модели в каждой строке. Те же двадцать запросов на той же конечной точке через gpt-4o вернули разметки источников лишь в 2 из 20 случаев против 8 из 20 у gpt-5.
- Закладывайте бюджет. Полный прогон из 60 ответов стоил 1,444 доллара, так что еженедельная версия той же проверки по этим ценам обойдётся примерно в 6 долларов в месяц.
Ограничения
- Один день, один регион, английский язык, три поверхности. Ответы различаются от региона к региону.
- Одна версия модели на поверхность. Даже в наших прогонах поведение смещалось между версиями модели.
- Распознавание брендов — это сопоставление строк по имени, поэтому бренд, рекомендованный только по названию продукта, может быть пропущен.
- Поиск в вебе включался через API. Потребительские приложения могут искать чаще этих прогонов, а могут и реже.
- Стоимость покрывает только генерацию ответов и не включает время на хранение или проверку.
Частые вопросы
Почему ChatGPT сообщил ноль ссылок на 12 из 20 запросов?
Потому что он отвечал на эти запросы, не выполняя поиск. Модель, которая ни разу не забирает страницу, не может на неё сослаться. Значит, этот ноль описывает прогон, а не ваш бренд. Прежде чем читать число ссылок с любой чат-поверхности, сначала выясните, пользовалась ли эта поверхность вебом.
Есть ли ценность в упоминании, если ссылки нет вообще?
На ответе без обоснования это весь сигнал, и это ещё и сигнал, который приходит раньше ссылки. В наших данных упоминание и ссылка добываются из разных источников: упоминание идёт за сравнительным и обзорным контентом, а ссылка — за страницами, структурированными так, чтобы их цитировали.
Стоит ли объединять упоминания и ссылки в один балл видимости?
Нет. Как показывает таблица брендов, они систематически расходятся в обе стороны, а объединённый балл скрывает, что именно сдвинулось. Сообщайте о них двумя линиями и дайте читателю увидеть этот разрыв.
Какую поверхность проверять первой?
Если вам нужна стабильная, дешёвая панель с фиксированной шириной, берите Perplexity: длина его списка не меняется. Если нужна широта, берите Gemini: он дотянулся до 184 из 432 доменов, которые мы видели. ChatGPT — только с проверкой на правдоподобие, иначе пятая часть его ответов прочитается как невидимый бренд.
Взгляд Auspia: сообщайте об упоминаниях и ссылках двумя отдельными линиями и фиксируйте, искала ли поверхность, прежде чем фиксировать что-либо ещё. Единый балл видимости скрывает ровно тот разрыв, который говорит вам, что чинить дальше, а самая дешёвая правка в наших данных состояла не в добавлении контента, а в проверке поверхности, которая действительно смотрела в веб.
Автор: Адриан Коул