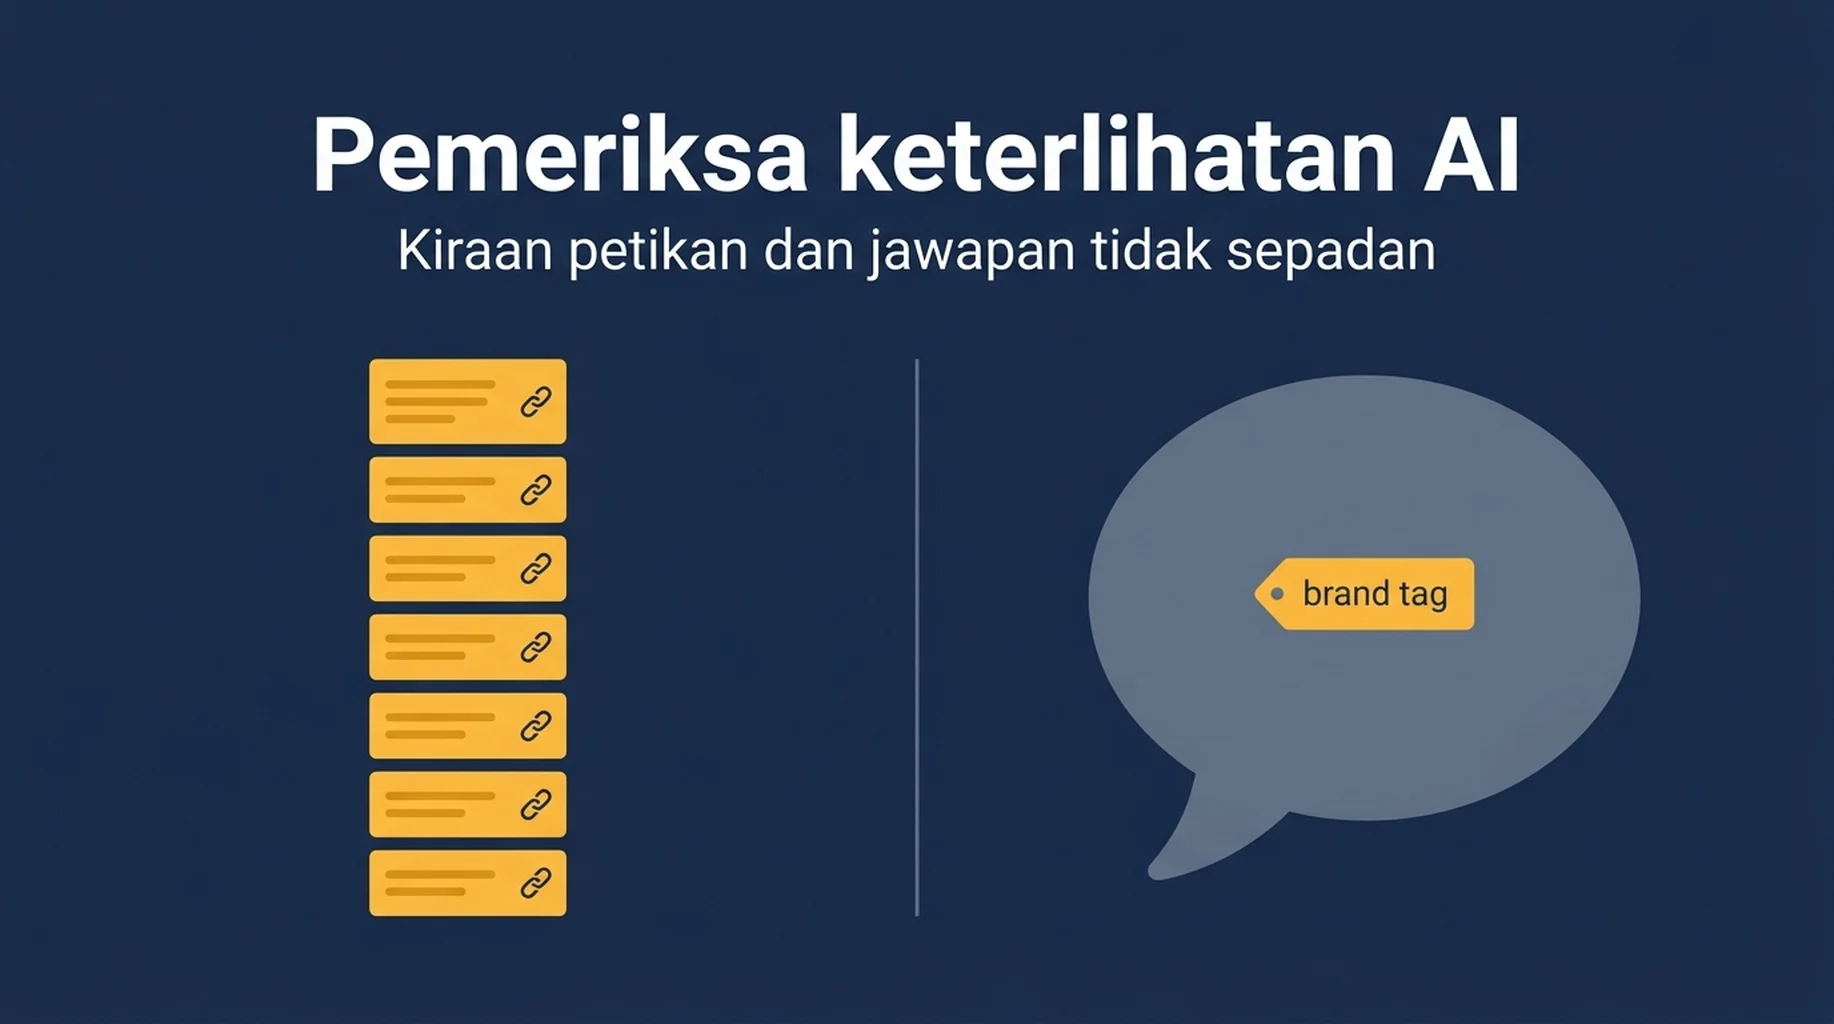
Dua pemeriksa keterlihatan AI boleh membaca jawapan yang sama pada hari yang sama dan memberi keputusan yang bertentangan. Satu mengembalikan kiraan petikan, satu lagi tidak mengembalikan apa-apa, kerana jawapan itu menyebut nama jenama anda dan mengesyorkannya tanpa pernah memautkannya.
Pada September 2026 kami menjalankan dua puluh gesaan merentas tiga permukaan AI dan merekodkan, pada setiap jawapan, dua isyarat: jenama yang disebut jawapan di dalam teks, dan domain yang dikemukakan jawapan sebagai sumber. Kedua-duanya bukan dua sudut bagi satu ukuran. Kedua-duanya berpisah di tempat yang boleh dijangka, dan tempat itulah bahagian paling berguna dalam laporan.
Versi pendeknya: Perplexity memetik sumber pada setiap gesaan, Gemini mengembalikan median 47 sumber setiap jawapan, manakala ChatGPT tidak mengembalikan sebarang petikan pada 12 daripada 20 gesaan, namun tetap menyebut nama pembekal pada 13 daripadanya. Kelainan antara jalan pada satu permukaan ialah persoalan lain, dan kami mengukurnya sebelum ini dalam kelainan jalan penjejak keterlihatan AI.
Apa yang kami jalankan
Perkara | Tetapan |
|---|---|
Gesaan | Dua puluh soalan yang akan ditanya pembeli tentang alat keterlihatan AI |
Permukaan | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Carian web | Diaktifkan pada ketiga-tiga permukaan |
Wilayah dan bahasa | Amerika Syarikat, bahasa Inggeris |
Tarikh | 12 September 2026 |
Jawapan dikumpulkan | 60 |
Kos keseluruhan jalan | 1,444 dolar, iaitu 0,024 dolar setiap jawapan |
Jalan ulangan | Kami jalankan semula lima gesaan yang sama untuk melihat sama ada tingkah lakunya stabil |
Kos setiap jawapan berjulat dari 0,006 dolar di Perplexity hingga 0,037 dolar di Gemini. Permukaan termurah menghasilkan senarai sumber paling konsisten, dan yang termahal bukanlah permukaan yang mengembalikan sumber paling banyak.
Dua isyarat, diukur secara berasingan
Kami menangkap setiap jawapan dua kali: sekali sebagai teks, sekali sebagai senarai sumber yang dilampirkan permukaan pada teks itu.
Permukaan | Anotasi sumber | Setiap jawapan | Jawapan tanpa petikan | Domain berbeza setiap jawapan |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | 0 hingga 18, median 0 | 12 daripada 20 | 0 hingga 10 |
Gemini 2.5 Flash | 989 | 14 hingga 122, median 47 | 0 daripada 20 | 3 hingga 23 |
Perplexity | 399 | 19 hingga 20 | 0 daripada 20 | 16 hingga 20 |
Ketiga-tiga senarai ini bukan jenis objek yang sama, dan di sinilah pemeriksa mula-mula tersilap.
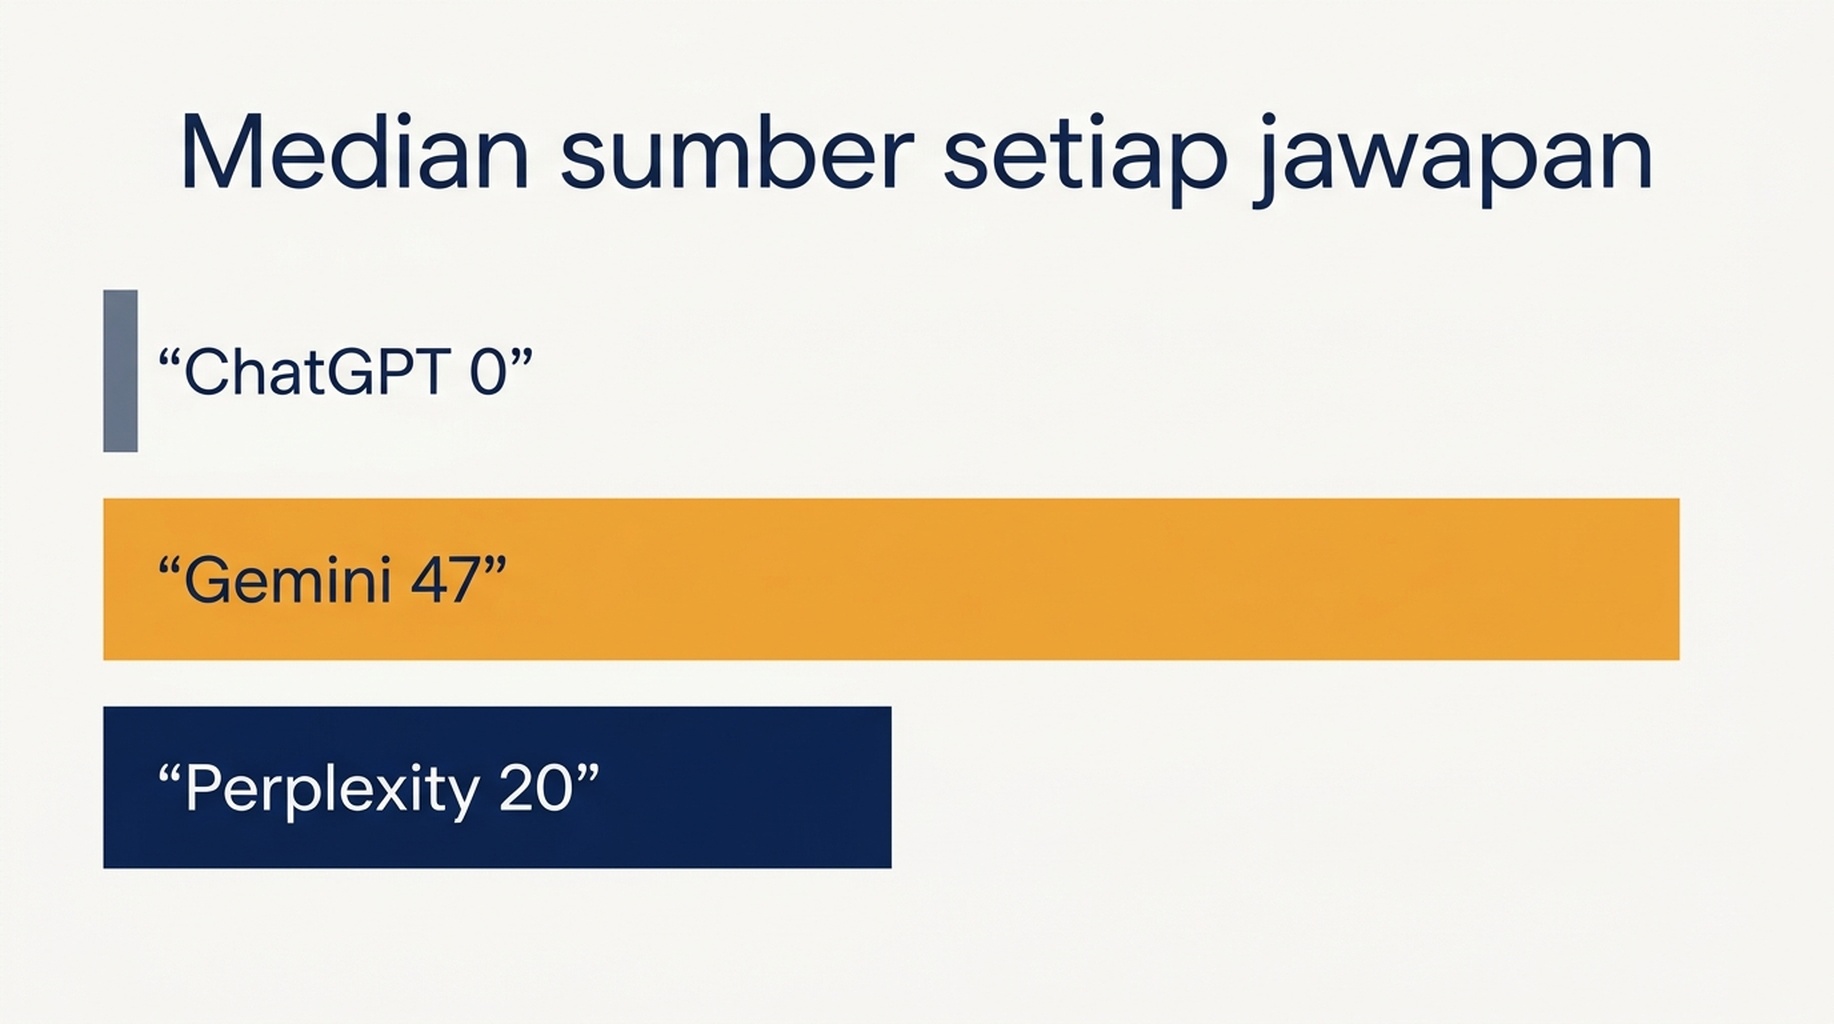
Gemini melampirkan sumber pada hampir setiap dakwaan. Halaman yang sama boleh menduduki banyak slot dalam satu jawapan, dan itulah sebabnya angkanya setinggi itu: sepanjang 20 jawapan Gemini, semrush.com menduduki 44 slot, maxaeo.ai dua puluh enam, google.com dua puluh dua, adobe.com dua puluh satu dan medium.com dua puluh. Bilangan anotasi yang tinggi pada permukaan ini bercakap tentang betapa halusnya model memecahkan bahan, bukan tentang betapa dikenali jenama anda.
Perplexity pula mendedahkan panel yang mempunyai had atas. Ia mengembalikan tepat dua puluh sumber pada 19 daripada 20 gesaan dan sembilan belas pada gesaan kedua puluh. Itu menetapkan penyebut: bahagian anda dalam jawapan Perplexity sentiasa bahagian daripada dua puluh, jadi merebut satu slot bermakna seseorang kehilangan satu slot di tempat lain.
ChatGPT hanya mengembalikan senarai sumber apabila ia mencari. Ia melepaskan kueri carian pada 8 daripada 20 gesaan dan tidak memetik apa-apa pada dua belas yang selebihnya. Pada dua belas itu ia tetap menjawab soalan itu dan tetap menyebut nama alat. Satu contoh tanpa suntingan: apabila ditanya tentang alat terbaik untuk memantau sebutan jenama dalam hasil carian AI, ia menyenaraikan Brand24, Mention, BuzzSumo, Talkwalker dan Google Alerts, tanpa satu pun sumber dilampirkan pada mana-mana daripadanya. Senarai semak yang kami gunakan untuk mengaudit jawapan ChatGPT bagi pola kegagalan ini ada dalam senarai semak keterlihatan dalam ChatGPT.
Disebut tanpa dipetik
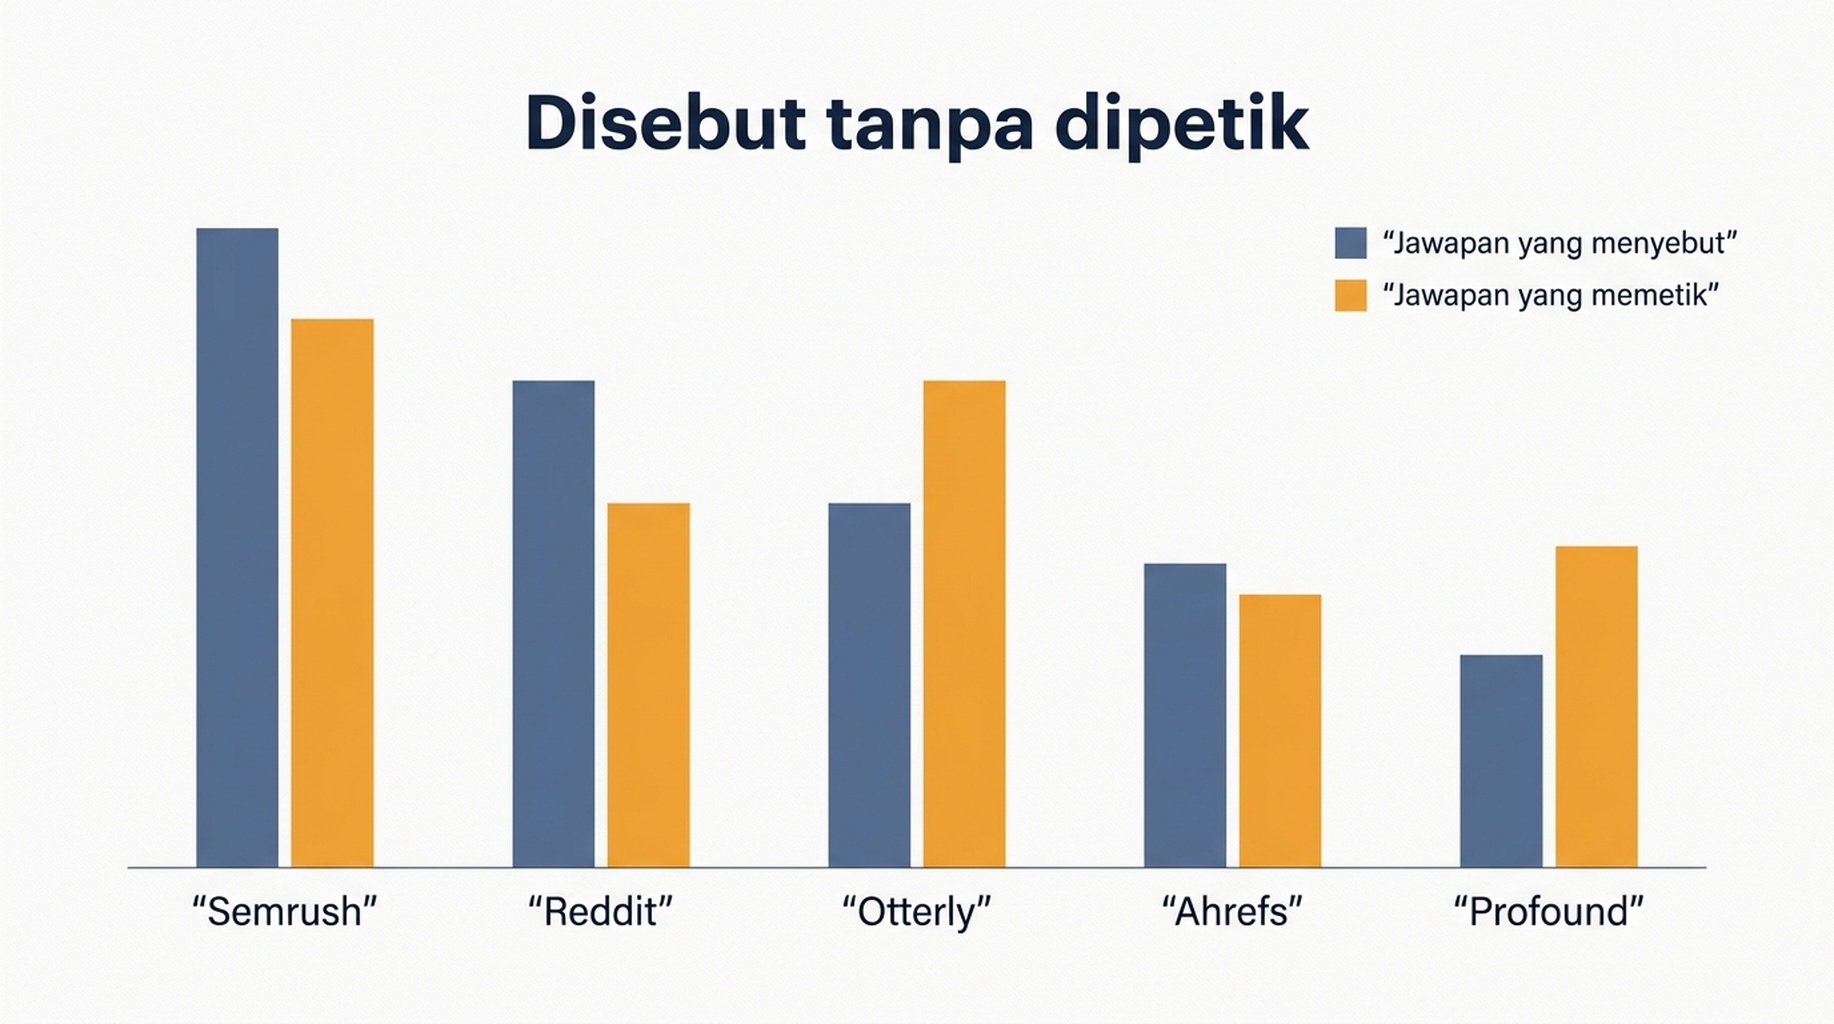
Seterusnya kami mengira, bagi 27 jenama dan penerbit, berapa daripada 60 jawapan menyebut jenama itu di dalam teks dan berapa yang memetik domainnya sebagai sumber. Kedua-dua lajur berbeza dalam kedua-dua arah sekali gus.
Jenama | Jawapan yang menyebutnya | Jawapan yang memetik domainnya |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
Ada dua pola dalam jadual ini. Peec AI, Otterly, Profound dan ZipTie disyorkan dalam jawapan jauh lebih kerap daripada halaman mereka dipautkan. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps dan Menra sebaliknya: halaman mereka ditarik masuk sebagai sumber sedangkan jawapan tidak pernah menyebut nama syarikat itu. Pemeriksa yang hanya melihat pautan akan menilai kumpulan kedua sebagai kelihatan dan kumpulan pertama sebagai tidak kelihatan. Pemeriksa yang hanya melihat sebutan melakukan sebaliknya.
Sepanjang 60 jawapan itu, ketiga-tiga permukaan bersama-sama memetik 432 domain berbeza. ChatGPT menyumbang 47 daripadanya, iaitu 11 peratus, Gemini 184 (43 peratus) dan Perplexity 285 (66 peratus). Apa juga permukaan yang anda periksa, anda sedang melihat sampel daripada alam sumber yang jauh lebih besar. Ini tidak termasuk permukaan Google sendiri, yang di sana kehadirannya diukur dengan cara lain dan kami jelaskan dalam penjejak AI Overview.
Apa yang wajib direkodkan oleh pemeriksa
Pemeriksa keterlihatan yang mengembalikan satu nombor sedang membuang tiga daripada empat medannya. Inilah empat yang wajar dikekalkan.
Medan | Bentuk rakaman | Mengapa ia mengubah keputusan |
|---|---|---|
Sama ada permukaan itu mencari | ya atau tidak | Jawapan yang tidak mencari tidak boleh menghasilkan petikan, jadi sifarnya bukan isyarat keterlihatan |
Sama ada jenama disebut di dalam teks jawapan | bilangan jawapan | Satu-satunya isyarat yang terus hidup pada jawapan tanpa asas |
Sama ada domain ada dalam senarai sumber | bilangan jawapan | Isyarat yang dilaporkan oleh kebanyakan alat secara bersendirian |
Penyebut | bilangan jawapan, dan bilangan slot sumber setiap jawapan | Panel dengan dua puluh slot tetap dan senarai berisi 47 anotasi tidak boleh dibandingkan sebagai peratus |
Kesan praktikalnya ialah sifar palsu. Dalam data kami, 13 daripada 20 jawapan ChatGPT menyebut sekurang-kurangnya satu pembekal, manakala hanya 8 daripada 20 memetik apa-apa, jadi kira-kira satu perempat jawapan pada permukaan ini akan melaporkan sifar petikan bagi jenama yang jawapan itu sendiri sebut dan syorkan.
Cara melakukannya tanpa menipu diri sendiri
Pola kegagalan apabila anda menyerahkan kerja ini kepada ejen bukanlah nombor yang salah, tetapi nombor yang yakin diri yang dikira daripada medan yang tidak pernah dikumpulkan.
- Tangkap muatan mentah sebelum mengira apa-apa. Simpan teks jawapan, senarai sumber, pengecam model, dan nilai benar-salah tentang sama ada kueri carian dilepaskan. Metrik terbitan dibina dalam kod pada peringkat kedua, bukan diletakkan di dalam gesaan pengumpulan.
- Buat ejen itu memetik, bukan meringkaskan. Rubrik "laporkan berapa kali jenama muncul" menghasilkan prosa. Rubrik "kembalikan teks jawapan dan senarai sumber sebagaimana adanya" menghasilkan data yang boleh anda semak semula.
- Jalankan semula gesaan yang sama sebelum mempercayai sesuatu perubahan. Kami mengulang lima gesaan dan keputusan mencari itu sepadan pada 5 daripada 5, jadi lonjakan mendadak dalam bilangan petikan lebih berkemungkinan versi model atau suntingan gesaan daripada bunyi bising.
- Simpan pengecam model pada setiap baris. Dua puluh gesaan yang sama pada titik akhir yang sama melalui gpt-4o hanya mengembalikan anotasi sumber pada 2 daripada 20, berbanding 8 daripada 20 dengan gpt-5.
- Sediakan belanjawan. Jalan penuh 60 jawapan menelan 1,444 dolar, jadi pada kadar ini versi mingguan bagi pemeriksaan yang sama berada sekitar 6 dolar sebulan.
Batasan
- Satu hari, satu wilayah, bahasa Inggeris, tiga permukaan. Jawapan berbeza antara wilayah.
- Satu versi model bagi setiap permukaan. Malah dalam jalan kami sendiri, tingkah lakunya berganjak antara versi model.
- Pengesanan jenama ialah padanan rentetan berdasarkan nama, jadi jenama yang disyorkan hanya melalui nama produknya mungkin terlepas pandang.
- Carian web diaktifkan melalui API. Aplikasi pengguna mungkin mencari lebih banyak daripada jalan ini, atau lebih sedikit.
- Kos hanya meliputi penjanaan jawapan dan tidak termasuk masa penyimpanan atau semakan.
Soalan lazim
Mengapa ChatGPT melaporkan sifar petikan pada 12 daripada 20 gesaan?
Kerana ia menjawab gesaan itu tanpa mencari. Model yang tidak pernah mengambil halaman tidak boleh memetiknya. Jadi sifar itu menggambarkan jalannya, bukan jenama anda. Sebelum membaca angka petikan daripada mana-mana permukaan sembang, periksa dahulu sama ada permukaan itu benar-benar menggunakan web.
Adakah sebutan masih bernilai jika tiada pautan sama sekali?
Pada jawapan tanpa asas, itulah keseluruhan isyaratnya, dan itulah juga isyarat yang datang sebelum pautan. Dalam data kami, sebutan dan pautan diperoleh daripada sumber yang berbeza: sebutan mengikut kandungan perbandingan dan ulasan, manakala petikan mengikut halaman yang distrukturkan supaya dipetik.
Patutkah saya gabungkan sebutan dan petikan menjadi satu skor keterlihatan?
Tidak. Seperti yang ditunjukkan jadual jenama, kedua-duanya berbeza secara sistematik dalam kedua-dua arah, dan skor gabungan menyembunyikan yang mana satu berganjak. Laporkan keduanya sebagai dua garis dan biarkan pembaca melihat jurang itu.
Permukaan mana yang patut saya periksa dahulu?
Jika anda mahu panel yang stabil, murah dan lebarnya tetap, pilih Perplexity, kerana panjang senarainya tidak berubah. Jika anda mahu keluasan, pilih Gemini, yang mencapai 184 daripada 432 domain yang kami lihat. ChatGPT hanya dengan pemeriksaan kewajaran disertakan, jika tidak satu perlima jawapannya akan terbaca sebagai jenama yang tidak kelihatan.
Pandangan Auspia: laporkan sebutan dan petikan sebagai dua garis berasingan, dan rekod sama ada permukaan itu mencari sebelum merekod apa-apa yang lain. Satu skor keterlihatan menyembunyikan tepat jurang yang memberitahu anda apa yang perlu dibaiki seterusnya, dan pembaikan termurah dalam data kami bukanlah menambah kandungan, tetapi memeriksa permukaan yang benar-benar memandang ke web.
Penulis: Adrian Cole