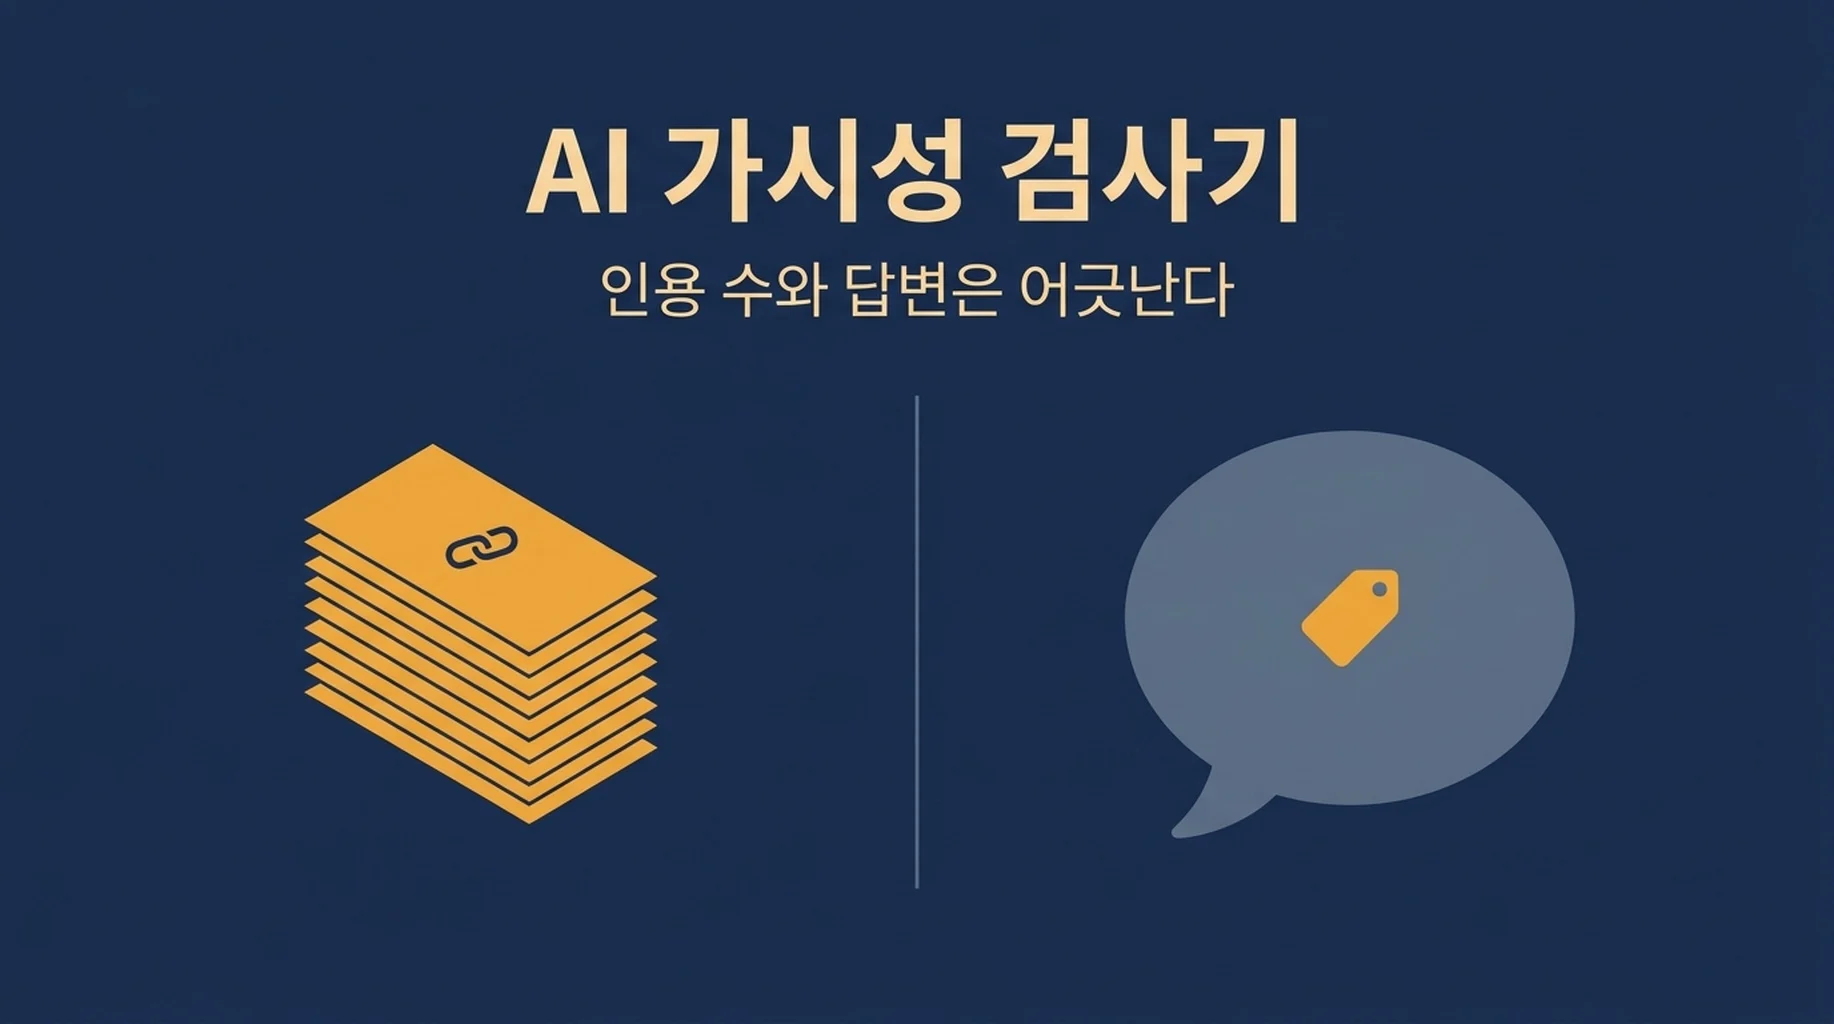
AI 가시성 검사기 두 개가 같은 날 같은 답변을 읽고 정반대의 판정을 내놓을 수 있습니다. 하나는 인용 수를 돌려주고, 다른 하나는 아무것도 돌려주지 않습니다. 답변이 브랜드 이름을 들어 추천했으면서 한 번도 링크하지 않았기 때문입니다.
우리는 2026년 9월에 세 개의 AI 표면에서 20개의 프롬프트를 실행하고 모든 답변에서 두 가지 신호를 기록했습니다. 답변이 본문에서 언급한 브랜드와, 답변이 출처로 제시한 도메인입니다. 이 둘은 하나의 측정을 보는 두 가지 관점이 아닙니다. 예측 가능한 지점에서 어긋나고, 어긋나는 그 지점이 보고서에서 가장 쓸모 있는 부분입니다.
짧게 말하면 Perplexity는 모든 프롬프트에서 출처를 인용했고 Gemini는 답변당 중앙값 47건의 출처 주석을 돌려줬습니다. 반면 ChatGPT는 20건 중 12건의 프롬프트에서 인용을 전혀 돌려주지 않았고, 그럼에도 13건에서는 벤더 이름을 언급했습니다. 단일 표면에서의 실행 간 변동은 별개의 문제이며, 그것은 앞서 AI 가시성 트래커의 실행 변동에서 측정했습니다.
무엇을 실행했는가
항목 | 설정 |
|---|---|
프롬프트 | AI 가시성 도구에 대해 구매자가 물을 만한 20개의 질문 |
표면 | ChatGPT(gpt-5-2025-08-07), Gemini(gemini-2.5-flash), Perplexity(sonar) |
웹 검색 | 세 표면 모두에서 활성화 |
지역과 언어 | 미국, 영어 |
날짜 | 2026년 9월 12일 |
수집한 답변 | 60건 |
전체 실행 비용 | $1.444, 답변당 $0.024 |
반복 실행 | 같은 5개 프롬프트를 두 번째로 실행해 동작이 안정적인지 확인 |
답변당 비용은 Perplexity의 $0.006에서 Gemini의 $0.037까지 분포했습니다. 가장 저렴한 표면이 가장 일관된 출처 목록을 냈고, 가장 비싼 표면이 가장 많은 출처를 돌려준 표면은 아니었습니다.
두 신호를 따로 측정하기
모든 답변은 두 번 포착했습니다. 한 번은 텍스트로, 한 번은 그 텍스트에 표면이 붙인 출처 목록으로.
표면 | 출처 주석 | 답변당 | 인용이 0인 답변 | 답변당 서로 다른 도메인 |
|---|---|---|---|---|
ChatGPT(gpt-5) | 90 | 0~18, 중앙값 0 | 20건 중 12건 | 0~10 |
Gemini 2.5 Flash | 989 | 14~122, 중앙값 47 | 20건 중 0건 | 3~23 |
Perplexity | 399 | 19~20 | 20건 중 0건 | 16~20 |
이 세 목록은 같은 종류의 대상이 아닙니다. 검사기가 가장 먼저 틀리는 지점이 바로 여기입니다.
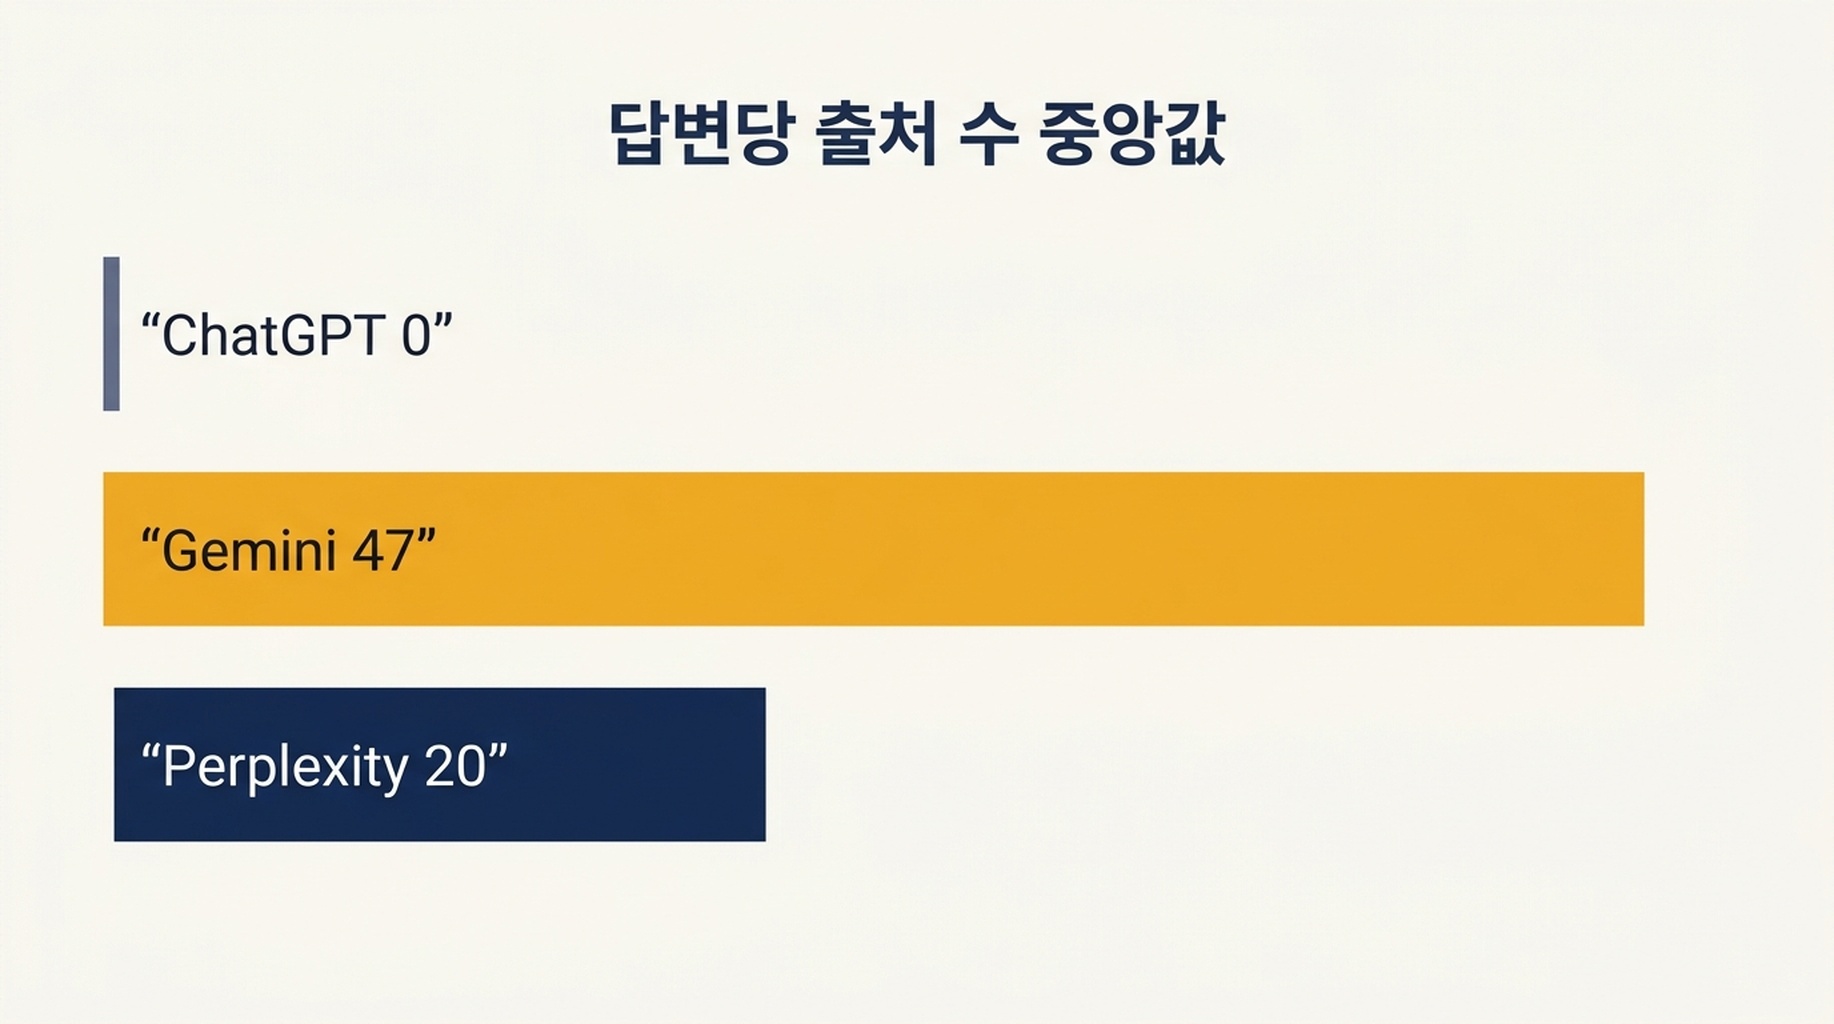
Gemini는 거의 모든 주장에 출처를 붙입니다. 같은 페이지가 한 답변 안에서 여러 자리를 차지할 수 있고, 그래서 수치가 이렇게 높아집니다. 20건의 Gemini 답변 전체에서 semrush.com이 44자리, maxaeo.ai가 26자리, google.com이 22자리, adobe.com이 21자리, medium.com이 20자리를 차지했습니다. 이 표면에서 주석 수가 높다는 것은 모델이 얼마나 잘게 쪼개고 있는지에 대한 진술이며, 당신 브랜드가 얼마나 널리 알려졌는지에 대한 진술이 아닙니다.
Perplexity는 상한이 있는 패널을 공개합니다. 20건 중 19건의 프롬프트에서 정확히 20건의 출처를 돌려주고, 스무 번째에서는 19건을 돌려줬습니다. 이것이 분모를 고정합니다. Perplexity 답변에서 당신의 몫은 항상 20의 몫이고, 한 자리를 얻는 것은 누군가가 한 자리를 잃는 것입니다.
ChatGPT는 검색했을 때만 출처 목록을 돌려줍니다. 20건 중 8건의 프롬프트에서 검색 쿼리를 발행했고 나머지 12건에서는 아무것도 인용하지 않았습니다. 그 12건에서도 질문에는 답했고 도구 이름도 언급했습니다. 편집하지 않은 예가 하나 있습니다. AI 검색 결과에서 브랜드 언급을 추적할 최선의 도구를 묻자 Brand24, Mention, BuzzSumo, Talkwalker, Google Alerts를 나열했고 어느 것에도 출처가 붙지 않았습니다. 이 실패 모드에 대해 ChatGPT 답변을 감사할 때 우리가 쓰는 체크리스트는 ChatGPT 가시성 체크리스트에 있습니다.
인용되지 않은 채 이름만 오르기
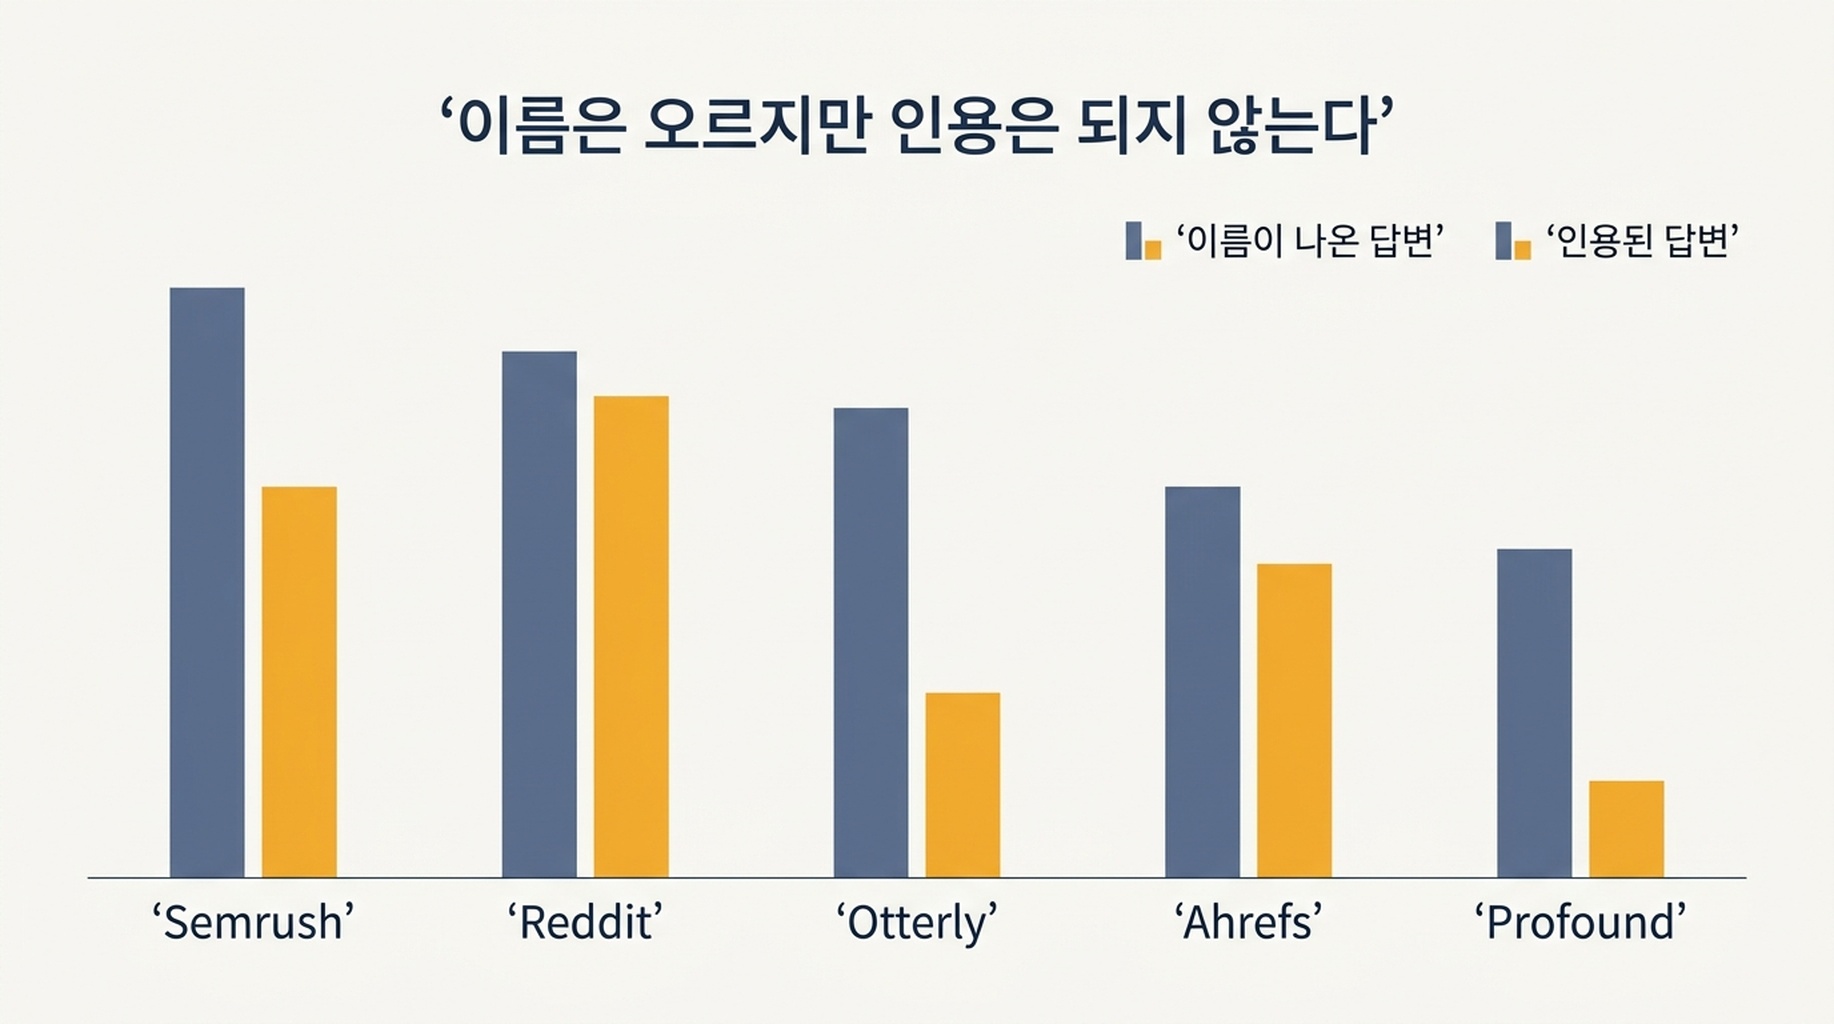
다음으로 27개 브랜드와 매체에 대해, 60건의 답변 중 몇 건이 본문에서 그 브랜드를 언급했고 몇 건이 그 도메인을 출처로 인용했는지 세었습니다. 두 열은 양방향으로 어긋납니다.
브랜드 | 언급한 답변 | 그 도메인을 인용한 답변 |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
이 표에는 두 가지 패턴이 있습니다. Peec AI, Otterly, Profound, ZipTie는 자사 페이지가 링크되는 빈도보다 훨씬 자주 답변에서 추천됩니다. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps, Menra는 반대로, 답변이 회사 이름을 한 번도 언급하지 않은 채 페이지가 출처로 끌려 들어옵니다. 링크만 보는 검사기는 두 번째 집단을 보인다고 채점하고 첫 번째 집단을 보이지 않는다고 채점합니다. 언급만 보는 검사기는 그 반대입니다.
60건의 답변 전체에서 세 표면이 합쳐 432개의 서로 다른 도메인을 인용했습니다. ChatGPT가 그중 47개(11퍼센트), Gemini가 184개(43퍼센트), Perplexity가 285개(66퍼센트)입니다. 어느 표면을 확인하든 당신은 훨씬 큰 출처 우주의 표본을 보고 있는 것입니다. 여기에는 Google 자체의 표면이 포함되지 않으며, 그곳의 존재감은 다르게 측정됩니다. 그것은 AI Overview 트래커에서 설명합니다.
검사기가 기록해야 하는 것
숫자 하나만 돌려주는 가시성 검사기는 네 칸 중 세 칸을 버리고 있는 것입니다. 남길 가치가 있는 네 가지는 이렇습니다.
항목 | 기록 방식 | 왜 판정을 바꾸는가 |
|---|---|---|
표면이 검색했는가 | 예 또는 아니오 | 검색하지 않은 답변은 인용을 만들 수 없으므로 그 0은 가시성 신호가 아니다 |
답변 본문에 브랜드가 언급되었는가 | 답변 수 | 근거 없는 답변에서도 살아남는 유일한 신호 |
출처 목록에 도메인이 있는가 | 답변 수 | 대부분의 도구가 이것만 보고한다 |
분모 | 답변 수, 그리고 답변당 출처 자리 | 고정 20자리 패널과 47건 주석 목록은 비율로 비교할 수 없다 |
실무적 결과는 거짓 0입니다. 우리 데이터에서 ChatGPT 답변 20건 중 13건이 적어도 하나의 벤더를 언급한 반면, 무언가를 인용한 것은 20건 중 8건이었습니다. 즉 이 표면 답변의 약 4분의 1은, 같은 답변이 이름을 들어 추천하는 브랜드에 대해 인용 0을 보고하게 됩니다.
자신을 속이지 않고 이것을 실행하는 방법
이 일을 에이전트에 맡길 때의 실패 모드는 틀린 숫자가 아닙니다. 한 번도 수집되지 않은 항목에서 계산된 자신감 있는 숫자입니다.
- 무엇이든 계산하기 전에 원본 페이로드를 포착하세요. 답변 텍스트, 출처 목록, 모델 식별자, 검색 쿼리가 발행되었는지의 불리언을 남기세요. 파생 지표는 두 번째 단계에서 코드로 만드는 것이지 수집 프롬프트 안에 두는 것이 아닙니다.
- 에이전트에게 요약시키지 말고 인용시키세요. "브랜드가 몇 번 나타나는지 보고하라"는 루브릭은 산문을 만듭니다. "답변 텍스트와 출처 목록을 그대로 돌려달라"는 루브릭은 다시 확인할 수 있는 데이터를 만듭니다.
- 변화를 믿기 전에 같은 프롬프트를 다시 실행하세요. 우리는 5개 프롬프트를 반복했고, 검색 여부 판단은 5건 중 5건 일치했습니다. 즉 인용 수의 갑작스러운 도약은 잡음이라기보다 모델 버전이나 프롬프트 편집일 가능성이 더 큽니다.
- 모델 식별자를 모든 행에 남기세요. 같은 20개 프롬프트를 같은 엔드포인트에서 gpt-4o로 돌리면 출처 주석을 돌려준 것은 20건 중 2건뿐이었습니다. gpt-5는 20건 중 8건입니다.
- 예산을 잡으세요. 60건 답변 실행 전체에 $1.444가 들었으니, 같은 확인을 매주 돌리면 이 가격에서 한 달에 약 $6입니다.
한계
- 하루, 한 지역, 영어, 세 표면. 지역별 답변은 다릅니다.
- 표면당 하나의 모델 버전. 우리 자체 실행에서도 모델 버전 사이에 동작이 움직였습니다.
- 브랜드 탐지는 이름 문자열 일치이므로, 제품 이름으로만 추천된 브랜드는 놓칠 수 있습니다.
- 웹 검색은 API를 통해 켰습니다. 소비자용 앱은 이 실행보다 더 자주 검색할 수도 있고 덜 자주 검색할 수도 있습니다.
- 비용은 답변 생성만을 덮고, 저장이나 검토 시간은 포함하지 않습니다.
자주 묻는 질문
ChatGPT가 20건 중 12건의 프롬프트에서 인용 0을 보고한 이유는 무엇인가요?
그 프롬프트들에 검색하지 않고 답했기 때문입니다. 페이지를 한 번도 가져오지 않는 모델은 페이지를 인용할 수 없습니다. 따라서 그 0은 실행에 대한 서술이고 당신 브랜드에 대한 서술이 아닙니다. 채팅 표면에서 인용 수를 읽기 전에, 그 표면이 웹을 사용했는지부터 확인하세요.
링크가 없어도 답변에서 이름이 오르는 것이 가치가 있나요?
근거 없는 답변에서는 그것이 신호의 전부이고, 링크에 앞서는 신호이기도 합니다. 우리 데이터에서 언급과 링크는 서로 다른 출처에서 얻어집니다. 언급은 비교와 리뷰 콘텐츠를 따르고, 인용은 인용되도록 구조화된 페이지를 따릅니다.
언급과 인용을 하나의 가시성 점수로 합쳐야 하나요?
아니요. 브랜드 표가 보여주듯 둘은 양방향으로 체계적으로 어긋나고, 합친 점수는 어느 쪽이 움직였는지를 감춥니다. 두 개의 선으로 보고하고 그 간격을 독자가 보게 하세요.
어느 표면을 먼저 확인해야 하나요?
안정적이고 저렴하며 너비가 고정된 패널을 원하면 Perplexity입니다. 목록 길이가 변하지 않기 때문입니다. 넓이를 원하면 Gemini이며, 우리가 본 432개 도메인 중 184개에 도달했습니다. ChatGPT는 타당성 점검을 붙일 때만입니다. 그렇지 않으면 답변의 5분의 1이 보이지 않는 브랜드로 읽히게 됩니다.
Auspia 관점: 언급과 인용을 두 개의 별도 선으로 보고하고, 무엇을 기록하기 전에 그 표면이 검색했는지부터 기록하세요. 단일 가시성 점수는 다음에 무엇을 고쳐야 하는지 알려주는 바로 그 간격을 감춥니다. 그리고 우리 데이터에서 가장 저렴한 수정은 콘텐츠를 늘리는 것이 아니었습니다. 실제로 살펴본 표면을 확인하는 것이었습니다.
글: 에이드리언 콜