مدقّقا ظهورٍ في الذكاء الاصطناعي يمكن أن يقرآ الإجابات نفسها في اليوم نفسه ويخرجا بحكمين متعاكسين. أحدهما يعيد عدد الاستشهادات، والآخر لا يعيد شيئاً، لأن الجواب ذكر علامتك بالاسم وأوصى بها ولم يربطها مرة واحدة.
شغّلنا في سبتمبر 2026 عشرين مُدخلاً عبر ثلاثة أسطح للذكاء الاصطناعي، وسجّلنا على كل جواب إشارتين: العلامة التي ذكرها الجواب في نصه، والنطاق الذي قدّمه الجواب كمصدر. وهاتان الإشارتان ليستا زاويتين لقياس واحد. إنهما تفترقان في مواضع يمكن توقعها، وتلك المواضع هي أكثر ما يفيد في التقرير.
النسخة القصيرة: استشهد Perplexity بمصادر في كل مُدخل، وأعاد Gemini وسيط 47 مصدراً لكل جواب، بينما لم يُعِد ChatGPT أي استشهاد في 12 من 20 مُدخلاً، ومع ذلك ذكر أسماء مورّدين في 13 منها. أما تقلّب التشغيل المتكرر على سطح واحد فمسألة أخرى، وقد قِسناها سابقاً في تقلّب تشغيل متتبّع الظهور في الذكاء الاصطناعي.
ما الذي شغّلناه
البند | الإعداد |
|---|---|
المُدخلات | عشرون سؤالاً من الأسئلة التي يطرحها المشتري عن أدوات الظهور في الذكاء الاصطناعي |
الأسطح | ChatGPT (gpt-5-2025-08-07)، Gemini (gemini-2.5-flash)، Perplexity (sonar) |
البحث على الويب | مُفعَّل على الأسطح الثلاثة |
المنطقة واللغة | الولايات المتحدة، الإنجليزية |
التاريخ | 12 سبتمبر 2026 |
الإجابات المجموعة | 60 جواباً |
تكلفة التشغيل كاملاً | 1,444 دولاراً، أي 0.024 دولار لكل جواب |
إعادة التشغيل | أعدنا تشغيل المُدخلات الخمسة نفسها لمعرفة ما إذا كان السلوك مستقراً |
تراوحت تكلفة الجواب الواحد بين 0.006 دولار عند Perplexity و0.037 دولار عند Gemini. وأنتج أرخص سطح أكثر قوائم المصادر اتساقاً، ولم يكن أغلى سطح هو الأكثر إعادة للمصادر.
الإشارتان، مقيسَتين على حدة
التقطنا كل جواب مرتين: مرة كنص، ومرة كقائمة المصادر التي ألحقها السطح بذلك النص.
السطح | وسوم المصادر | لكل جواب | إجابات بصفر استشهاد | نطاقات مختلفة لكل جواب |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | من 0 إلى 18، الوسيط 0 | 12 من 20 | من 0 إلى 10 |
Gemini 2.5 Flash | 989 | من 14 إلى 122، الوسيط 47 | 0 من 20 | من 3 إلى 23 |
Perplexity | 399 | من 19 إلى 20 | 0 من 20 | من 16 إلى 20 |
هذه القوائم الثلاث ليست من نوع واحد، وهنا يخطئ المدقّق أول ما يخطئ.
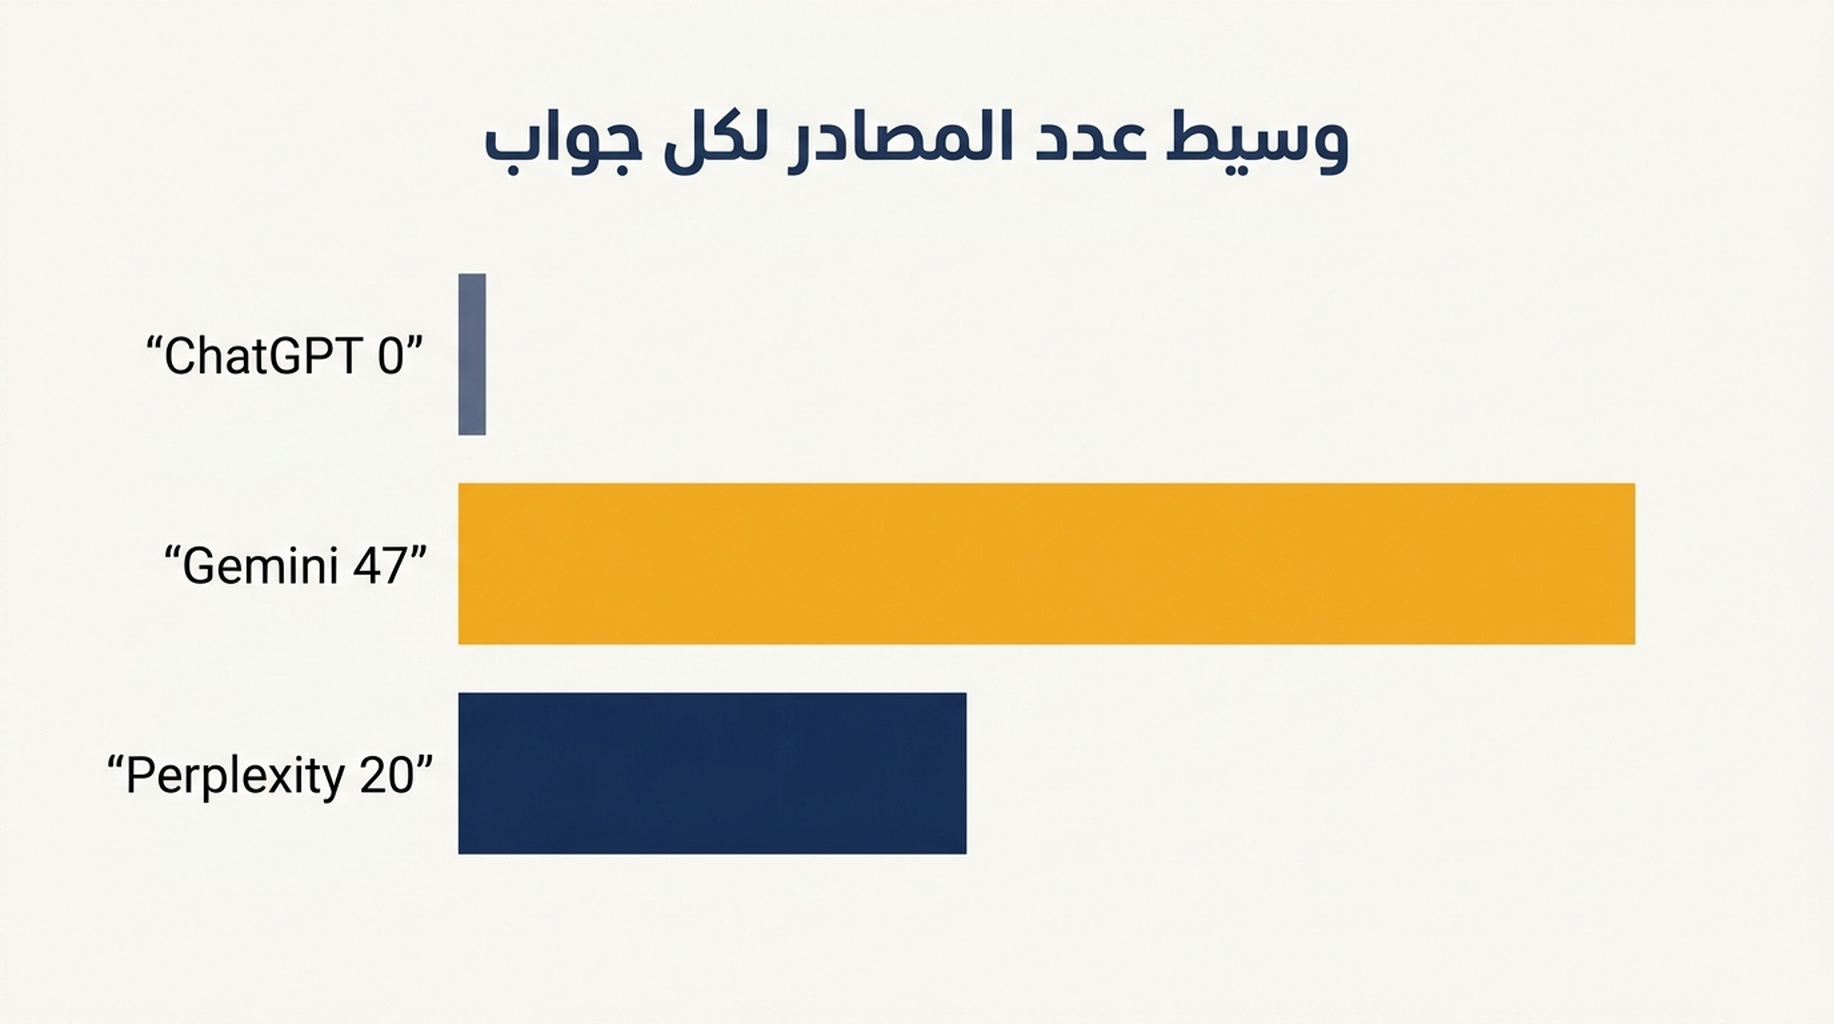
يُلحق Gemini مصدراً بكل ادعاء تقريباً. ويمكن للصفحة نفسها أن تشغل مواضع كثيرة داخل الجواب الواحد، ولهذا تكون الأعداد بهذا الارتفاع: عبر 20 جواباً من Gemini، شغلت semrush.com 44 موضعاً، وmaxaeo.ai ستة وعشرين، وgoogle.com اثنين وعشرين، وadobe.com واحداً وعشرين، وmedium.com عشرين. العدد المرتفع للوسوم على هذا السطح يقول شيئاً عن مدى تفكيك النموذج، لا عن مدى شهرة علامتك.
أما Perplexity فيكشف لوحة ذات سقف. أعاد عشرين مصدراً بالضبط في 19 من 20 مُدخلاً، وتاسعة عشر في المُدخل العشرين. وهذا يثبّت المقام: نصيبك في أي جواب من Perplexity هو دائماً نصيب من عشرين، فالحصول على موضع يعني أن أحداً ما فقد موضعاً في مكان آخر.
وChatGPT لا يعيد قائمة مصادر إلا حين يبحث. أطلق استعلام بحث في 8 من 20 مُدخلاً، ولم يستشهد بشيء في الاثني عشر الباقية. وفي تلك الاثني عشر أجاب عن السؤال وذكر أسماء أدوات. ومن الأمثلة غير المحرَّرة: حين سُئل عن أفضل أدوات متابعة ذكر العلامة في نتائج بحث الذكاء الاصطناعي، أورد Brand24 وMention وBuzzSumo وTalkwalker وGoogle Alerts دون أي مصدر ملحق بأي منها. وقائمة التحقق التي نستخدمها لتدقيق إجابات ChatGPT بحثاً عن نمط الفشل هذا موجودة في قائمة تحقق الظهور في ChatGPT.
مذكور في النص دون استشهاد
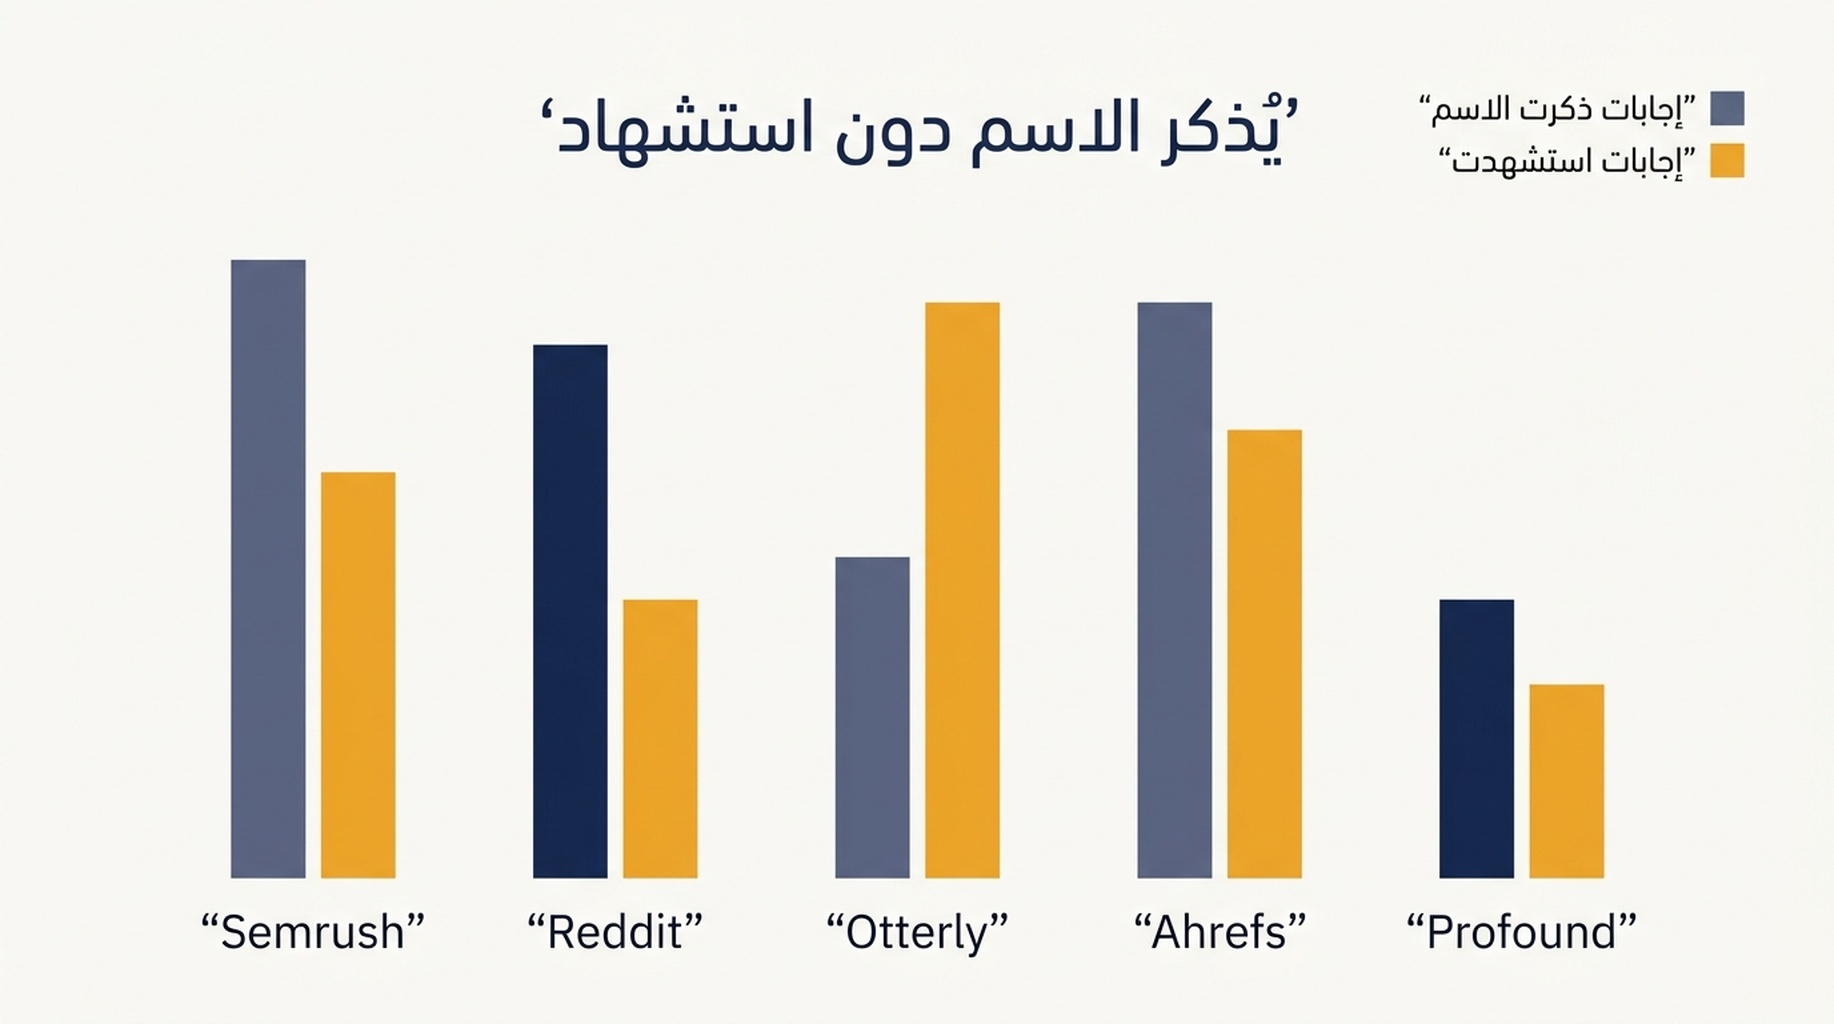
ثم عددنا، عبر 27 علامة ومنصة، في كم جواب من الستين ذُكرت العلامة في النص، وفي كم جواب استُشهد بنطاقها كمصدر. والعمودان يختلفان في الاتجاهين معاً.
العلامة | إجابات ذكرتها | إجابات استشهدت بنطاقها |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
في هذا الجدول نمطان. فـ Peec AI وOtterly وProfound وZipTie تُوصى بها الإجابات أكثر بكثير مما تُربط صفحاتها. أما MaxAEO وCognizo وLLM Pulse وSearchable وAirOps وMenra فالعكس: تُسحب صفحاتها كمصادر دون أن تذكر الإجابات اسم الشركة قط. والمدقّق الذي ينظر إلى الروابط وحدها سيحكم على المجموعة الثانية بأنها ظاهرة وعلى الأولى بأنها غائبة. والمدقّق الذي ينظر إلى الذكر وحده يفعل العكس.
عبر الإجابات الستين كلها، استشهدت الأسطح الثلاثة مجتمعة بـ 432 نطاقاً مختلفاً. منها 47 لـ ChatGPT، أي 11 بالمئة، و184 لـ Gemini، أي 43 بالمئة، و285 لـ Perplexity، أي 66 بالمئة. فأياً كان السطح الذي تفحصه، فأنت تنظر إلى عيّنة من كون مصادر أكبر بكثير. ولا يشمل ذلك سطح Google نفسه، حيث يُقاس الحضور بطريقة مختلفة نشرحها في متتبّع AI Overview.
ما يجب أن يسجّله أي مدقّق
مدقّق ظهور يعيد رقماً واحداً يرمي ثلاثة من حقوله الأربعة. وهذه هي الأربعة التي تستحق البقاء.
الحقل | شكل التسجيل | لماذا يغيّر الحكم |
|---|---|---|
هل بحث السطح | نعم أو لا | الجواب الذي لم يبحث لا يمكنه إنتاج استشهادات، فالصفر عنده ليس إشارة ظهور |
هل ذُكرت العلامة في نص الجواب | عدد الإجابات | الإشارة الوحيدة التي تبقى حية على جواب بلا سند |
هل النطاق في قائمة المصادر | عدد الإجابات | الإشارة التي تبلّغ عنها معظم الأدوات وحدها |
المقام | عدد الإجابات، وعدد مواضع المصادر لكل جواب | لوحة بستة عشر موضعاً ثابتاً عشرين لا تقارَن كنسَبة بقائمة تحمل 47 وسماً |
والنتيجة العملية هي الصفر الكاذب. في بياناتنا، ذكر 13 من 20 جواباً لـ ChatGPT مورّداً واحداً على الأقل، بينما استشهد 8 من 20 بأي شيء. أي أن نحو ربع إجابات هذا السطح ستبلّغ عن صفر استشهادات لعلامة يذكرها الجواب نفسه بالاسم ويوصي بها.
كيف تفعل هذا دون أن تخدع نفسك
نمط الفشل حين تسلّم هذا العمل لوكيل ليس رقماً خاطئاً، بل رقماً واثقاً محسوباً من حقل لم يُجمع قط.
- اقتنص الحمولة الخام قبل أن تحسب أي شيء. احتفظ بنص الجواب، وقائمة المصادر، ومعرّف النموذج، وقيمة منطقية لما إذا كان قد أُطلق استعلام بحث. فالمؤشرات المشتقة تُبنى في الكود في مرحلة ثانية، ولا تُوضع داخل مُدخل الجمع.
- اجعل الوكيل يستشهد بدل أن يلخّص. فمعيار «أبلغ عن عدد مرات ظهور العلامة» ينتج نثراً. ومعيار «أعد نص الجواب وقائمة المصادر حرفياً» ينتج بيانات يمكنك التحقق منها.
- أعد تشغيل المُدخل نفسه قبل أن تصدّق أي تغيّر. أعدنا خمسة مُدخلات، واتفق قرار البحث في 5 من 5. أي أن القفزة المفاجئة في عدد الاستشهادات هي على الأرجح نسخة نموذج أو تعديل مُدخل، لا ضجيج.
- أبقِ معرّف النموذج في كل صف. عشرون مُدخلاً نفسها على النقطة نفسها عبر gpt-4o أعادت وسوم مصادر في 2 من 20 فقط، مقابل 8 من 20 مع gpt-5.
- خصّص ميزانية. كلف التشغيل الكامل بستين جواباً 1,444 دولاراً، فبنية الأسعار هذه تضع النسخة الأسبوعية من الفحص نفسه عند نحو 6 دولارات شهرياً.
الحدود
- يوم واحد، ومنطقة واحدة، وبالإنجليزية، وثلاثة أسطح. والإجابات تختلف من منطقة إلى أخرى.
- نسخة نموذج واحدة لكل سطح. وقد تحرّك السلوك بين نسخ النماذج في تشغيلنا نفسه.
- كشف العلامات مطابقة نصية بالاسم، فقد تُفوَّت علامة أوصى بها الجواب باسم المنتج وحده.
- فعّلنا البحث على الويب عبر الواجهة البرمجية. وقد تبحث التطبيقات الاستهلاكية أكثر من هذه التشغيلات أو أقل.
- التكلفة تغطي توليد الإجابات فقط، ولا تشمل وقت التخزين أو المراجعة.
الأسئلة الشائعة
لماذا أبلغ ChatGPT عن صفر استشهادات في 12 من 20 مُدخلاً؟
لأنه أجاب عن تلك المُدخلات دون أن يبحث. والنموذج الذي لا يجلب صفحة لا يمكنه الاستشهاد بها. فذلك الصفر يصف التشغيل لا علامتك. وقبل أن تقرأ أي رقم استشهادات من أي سطح محادثة، تأكد أولاً مما إذا كان ذلك السطح قد استخدم الويب.
هل للنص المذكور قيمة إذا لم يكن هناك رابط؟
على جواب بلا سند، هو الإشارة كلها، وهو أيضاً الإشارة التي تسبق الرابط. في بياناتنا يُكتسب الذكر والرابط من مصادر مختلفة: فالذكر يتبع المحتوى المقارن والمراجعات، والاستشهاد يتبع الصفحات المهيكَلة لتُقتبس.
هل يجب أن أدمج الذكر والاستشهاد في درجة ظهور واحدة؟
لا. فكما يوضح جدول العلامات، يختلفان منهجياً في الاتجاهين، والدرجة المدموجة تخفي أيّهما تحرّك. أبلغ عنهما كخطين، ودع القارئ يرى الفجوة.
أي سطح أفحص أولاً؟
إذا أردت لوحة مستقرة ورخيصة وثابتة العرض، فاختر Perplexity، لأن طول قائمته لا يتغير. وإذا أردت الاتساع، فاختر Gemini، الذي بلغ 184 من 432 نطاقاً رأيناها. أما ChatGPT فمع فحص مصداقية فقط، وإلا فسيُقرأ خُمس إجاباته كعلامة غائبة.
رأي Auspia: أبلغ عن الذكر والاستشهاد كخطين منفصلين، وسجّل ما إذا كان السطح قد بحث قبل أن تسجّل أي شيء آخر. فالدرجة الواحدة للظهور تخفي بالضبط الفجوة التي تخبرك بما تُصلحه تالياً، وأرخص إصلاح في بياناتنا لم يكن إضافة محتوى، بل فحص سطح نظر إلى الويب فعلاً.
الكاتب/ة: أدريان كول