AI 可見性追蹤器聽起來很直接。向助手提幾個品類問題,記錄你的品牌是否出現,再按時間畫成圖表。
問題出在記錄的上游。你要測的東西根本不會靜止。把同一個提示詞發給同一個模型兩次,你會得到兩個只部分重疊的答案。記錄其中之一,你就等於把從某個分布中抽出的一個樣本當成了事實。
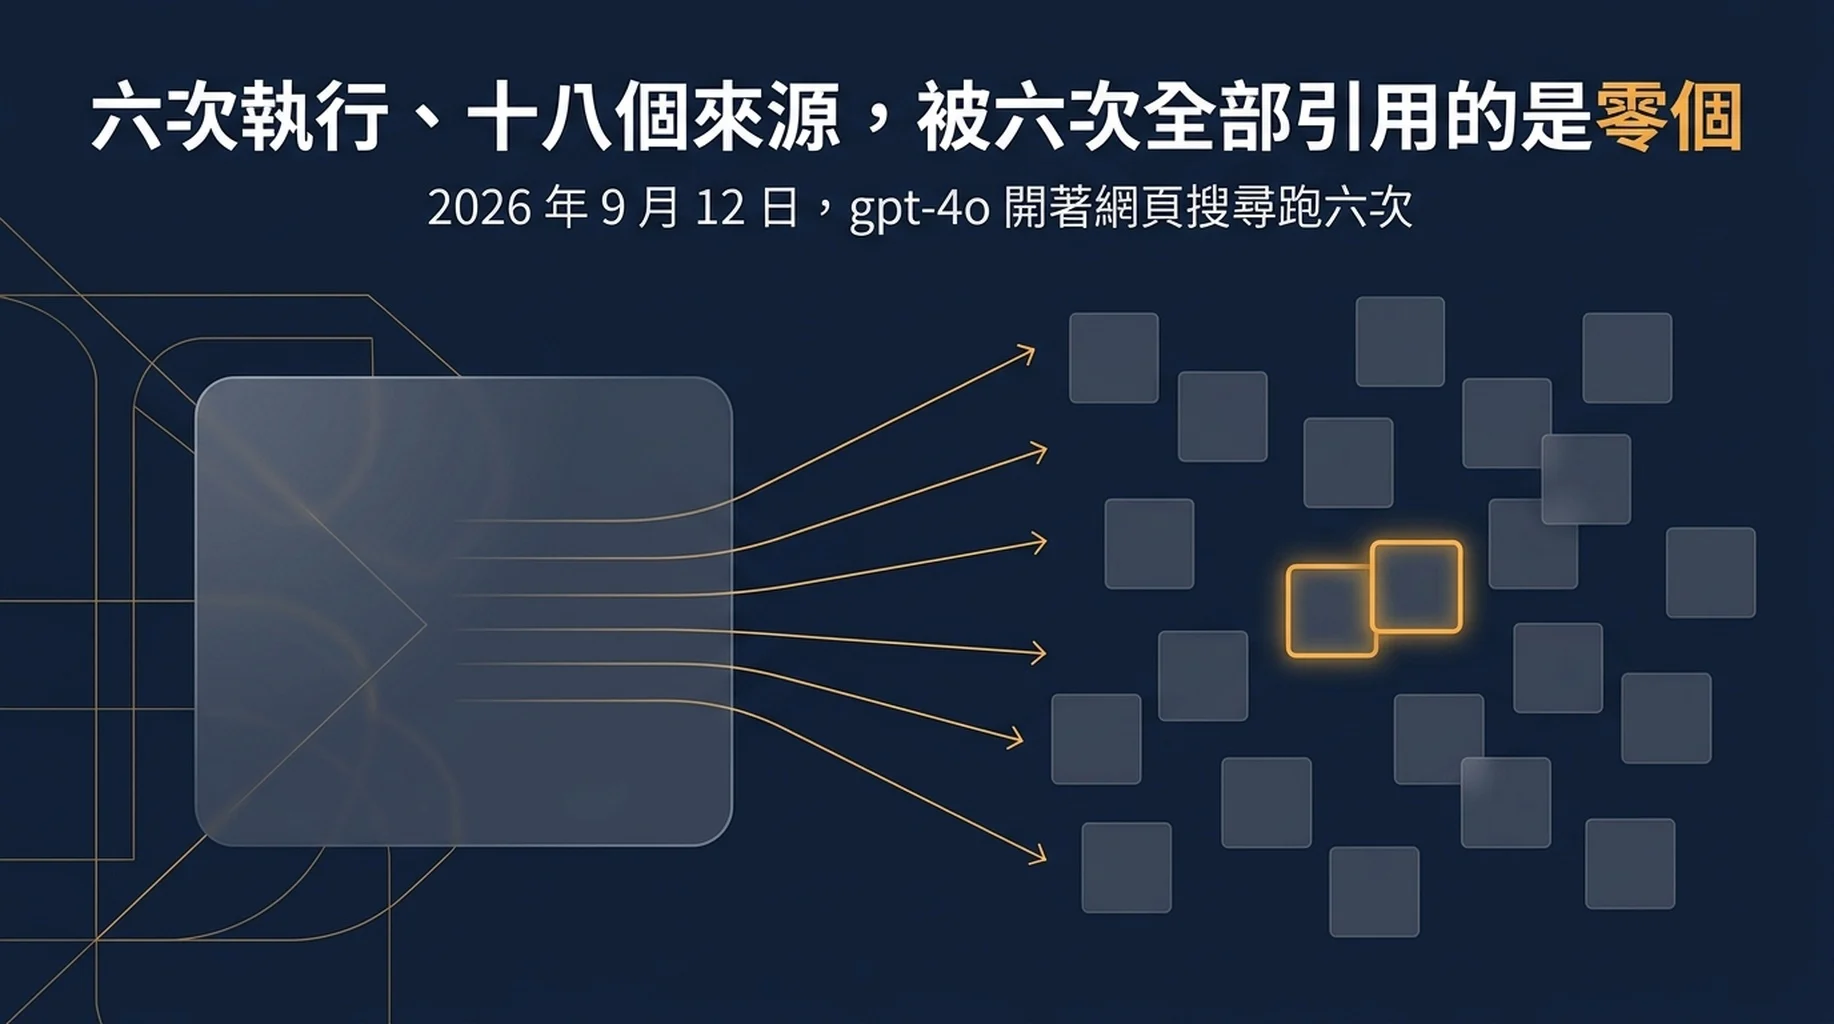
我們想知道這個離散度到底有多大,所以沒有假設,而是直接做了實驗。簡短版本:六次完全相同的請求產生了十八個被引用的來源,而沒有任何一個來源被六次全部引用。
本文講我們跑了什麼、返回了什麼,以及一個 AI 可見性追蹤器必須儲存哪四個欄位,這個數字下個月才值得再看一眼。
我們跑了什麼
兩個實驗,用的都是 SaaS 團隊在做品類調研時真的會用的提示詞。
實驗 1:一個提示詞、一個模型、六次執行。 模型 gpt-4o,開啟網頁搜尋,美國,英語。提示詞:「2026 年最適合小型 SaaS 團隊的排名追蹤工具有哪些?請給出簡短清單並附來源。」六次獨立的即時呼叫,在同一工作階段視窗內連續執行。
實驗 2:兩個模型、同一提示詞、各三次。 同一個提示詞分別發給 Claude Sonnet 5 和 Gemini 3.8 Flash,各三次,不開網頁搜尋。不開搜尋時,我們測的是模型憑自身知識說出了哪些產品,這與它引用了哪些來源是兩回事。
我們還把第二個提示詞走網頁搜尋路徑發了四次,看看引用行為在不同問題類型之間是否一致:「我該如何為自己的網站追蹤 AI Overview?請給出帶來源的具體方法。」
六次不是大樣本,我們也按這個前提處理。它足以顯示變異數的方向與大致量級,而這正是重點。
結果 1:十八個來源,六次執行共享的為零
六次網頁搜尋執行合計引用了 18 個不同的 URL。以下是每個網域的出現次數。
被引次數(6 次執行中) | 網域 |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital、techradar.com |
2 | thesharpdigital.com、piperocket.digital、digiinte.com、tajo.io、gtm.help、softwaresift.com |
1 | impressivemagazine.com、theguidex.com、gtmonly.com、honeyb.ai、seo.com、blog.contentforce.ai、crowdreply.io、seomonster.ai、rankpy.com |
沒有任何一個網域被六次執行全部引用。也沒有任何一個 URL 被六次執行全部引用。
真正重要的是執行之間的重疊度。比較每一對執行,被引 URL 的平均 Jaccard 重疊度為 0.167。十五對中有兩對的重疊度恰好為零,也就是說那兩個答案完全沒有共享來源。
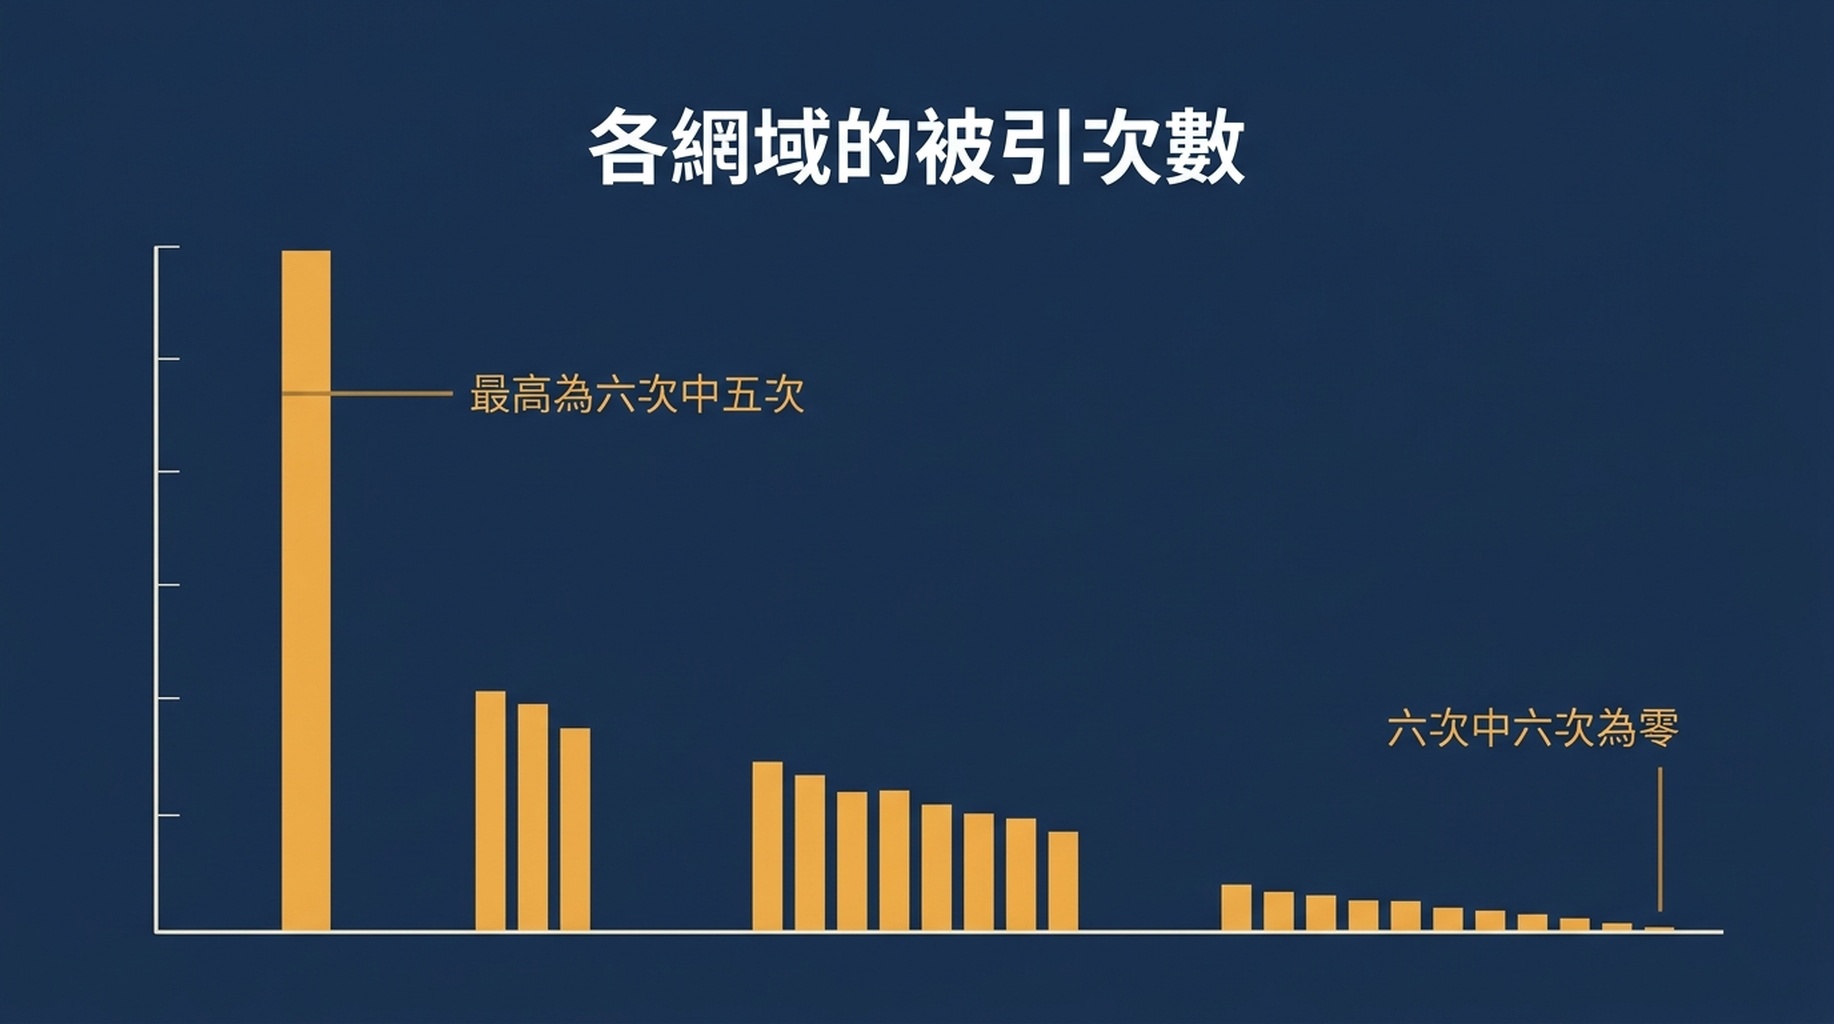
六次中五次被引用,是我們觀測到的上限。沒有任何東西每次都出現。
那張表裡還藏著第二個發現。模型伸手去夠的網域,大多不是這個品類裡知名的比較站點。十八個網域中有九個只出現過一次,其中幾個是小型站點,其內容讀起來像是為這個查詢拼裝出來的,而非報導所得。對品牌來說這是把雙面刃。它意味著引用位比傳統的「最佳工具」排名更容易拿下。它同時也意味著,這個位子正被那個當初做出了符合該次查詢形態的頁面的人占著,而下一次又會被重新填上。
結果 2:答案本身的體量會變
引用在動,答案長度也在動。
執行 | 輸出 token | 答案長度 | 執行成本 |
|---|---|---|---|
1 | 505 | 2,153 字元 | $0.0735 |
2 | 860 | 3,728 字元 | $0.0770 |
3 | 1,108 | 4,746 字元 | $0.0797 |
4 | 832 | 3,555 字元 | $0.0765 |
5 | 870 | 3,547 字元 | $0.0772 |
6 | 813 | 3,544 字元 | $0.0768 |
輸出長度從 505 到 1,108 個 token,跨度 603 個 token,約為平均值的 73%。最長答案是最短答案的兩倍多。六次中有五次落在 813 到 1,108 這個相當窄的區間內;有一次在 505 處提前停住,只引用了五個來源,而不是九到十四個。
對測量來說,這一點的影響很具體。如果你的追蹤器捕捉的是「品牌是否出現在答案中、出現在第幾位」,那麼一次短的執行可供出現的位子就更少。每週取樣一次、恰好抽到短執行的團隊,會記錄到比抽到長執行的團隊更差的結果——而網站上什麼都沒變。
結果 3:有些提示詞完全沒有任何引用
第二個關於追蹤 AI Overview 的提示詞,走同一條網頁搜尋路徑四次,每次都回傳零引用。
執行 | 輸出 token | 答案長度 | 引用數 |
|---|---|---|---|
1 | 479 | 2,135 字元 | 0 |
2 | 522 | 2,240 字元 | 0 |
3 | 534 | 2,312 字元 | 0 |
4 | 497 | 2,228 字元 | 0 |
答案長度很穩定,四次之間只變化了 8%。但模型是憑自身知識作答的,沒有點名任何來源,所以引用那一欄根本無物可記。
這就產生了一種特定且具有誤導性的追蹤器讀數。引用率儀表板會對這個問題顯示零,看起來像一次可見性失敗。並不是。這是一種不會觸發來源查找的問題形態。正確的讀數是「引用不適用」,而一個無法把它與「已檢查引用但你不存在」區分開的追蹤器,會讓你去追一個根本不存在的問題。
結果 4:換模型是另一次測量,而不是一次重複
在關閉網頁搜尋的情況下,我們測了每個模型說出了哪些產品。這樣就把模型自身的推薦集合,與那一分鐘搜尋索引回傳的東西隔離開來。
Claude Sonnet 5 每次說出四到五個產品。三次執行合計說出六個不同產品:AccuRanker、Ahrefs、SEMrush、SE Ranking、Serpstat 和 SerpWatcher。其中三個在三次執行中都出現過:AccuRanker、Ahrefs 和 SEMrush。平均兩兩重疊度 0.587。
Gemini 3.8 Flash 每次說出兩到五個產品。三次執行合計說出七個不同產品:AccuRanker、Ahrefs、Looker Studio、Nightwatch、SE Ranking、SEMrush 和 Wincher。其中只有 SE Ranking 在三次執行中都出現。平均兩兩重疊度 0.306。
在兩個模型之間,有四個產品被雙方同時提到,五個產品只被其中一方提到。
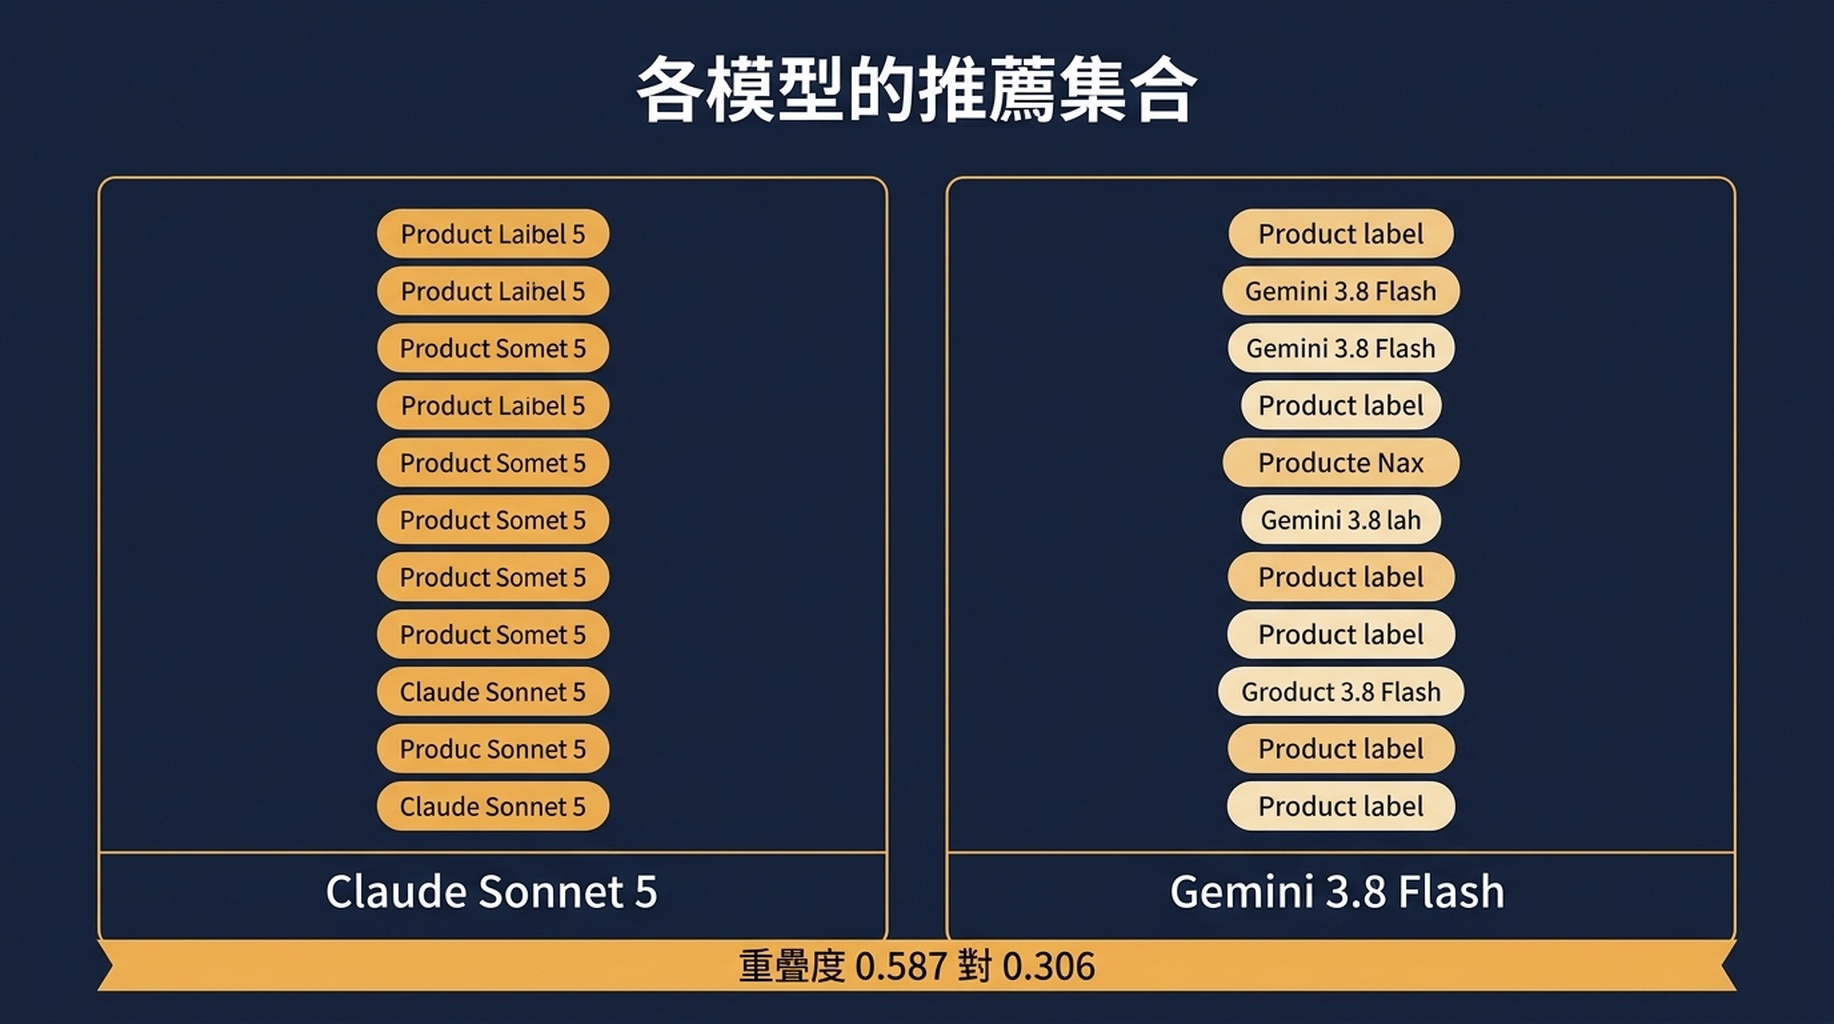
同一個問題,在每個模型、每次執行上都會產生部分不同的推薦集合。
實際後果是:如果你把「AI 可見性」當作一個數字來追蹤,你就是在對至少兩個獨立的變異來源取平均——執行與模型。一個在某個助手裡穩定出現、在另一個裡不出現的品牌,是一個真實的、可據以行動的發現。而一個單樣本測量移動了兩個位置的品牌,是雜訊。
AI 可見性追蹤器應該記錄什麼
四個欄位能把一張截圖變成一次測量。
執行次數,而不是執行結果。 儲存每一次執行並回報區間。「六次中四次被引用」是事實。「被引用,第三位」是巧合。小型專案六次是合理的下限;如果這個提示詞有商業價值,十二次更好。
把引用欄位和提及欄位分開。 「模型推薦了我們」和「模型連結了我們」是兩種不同的結果,修法也不同。我們這六次執行從 18 個不同 URL 產生了 18 條引用;只記錄品牌提及的追蹤器,一條這樣的變動都捕捉不到。
答案通道狀態。 記錄該次執行是否使用了網頁搜尋,以及答案長度。零引用的一次執行和零提及的一次執行在儀表板上看起來一模一樣,含義卻相反。
逐字記錄提示詞文本,並帶上版本號。 提示詞措辭決定哪些來源會被拉進來。如果提示詞在月份之間變了,趨勢線就斷了。像給追蹤腳本做版本管理那樣給提示詞做版本管理。
搭建執行迴圈
人工檢查撐不過一次和日曆的接觸。這個迴圈是一個腳本:把提示詞執行 N 次,把每次原始回應連同引用存下來,再把當前視窗與上一個視窗做差分。
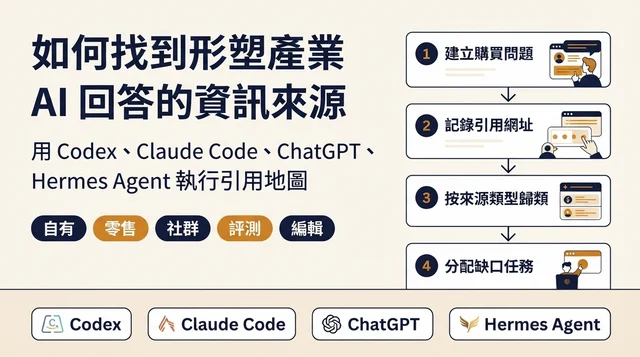
這很適合交給代理,因為工作重複、受規則約束,而且需要書面記錄。在 Claude Code 或 Codex 裡,有用的指令是:把原始執行留在磁碟上、永不覆寫,然後回報一張彙總表而不是單一數字。如果你已經在透過 MCP 伺服器拉取 Search Console 和 Bing 資料,同一個工作階段就能把引用日誌放在曝光資料旁邊——兩個數字開始產生合力正是在那裡。關於這些伺服器暴露了什麼,我們的筆記在四個 SEO MCP 伺服器實際做了什麼,同一個問題的「存在」一側則在我們的四十查詢 AI Overview 快照。
有一條設計規則比其餘都重要:追蹤器的輸出應該是一個分布。回報「六次中四次被引用」,而不是「被引用」。回報來源清單,而不是頭號來源。任何把六次執行壓成一個數字的儀表板,都已經扔掉了額外執行買來的唯一資訊。
如果目標是競品對比而非監控,那麼一條按時間推進的排名追蹤迴圈是更趁手的工具,資料來源之間的取捨見用兩個來源搭建排名追蹤器。
六次樣本的局限
三條誠實的說明。
樣本很小。六次只能鬆散地框定離散度。它能確立執行之間的重疊是部分的、並且會出現零重疊的對子;它給不了你自己品類的信賴區間。
結果是受時間約束的。這些執行是在 2026 年 9 月 12 日針對當時的線上模型做的。模型和底層搜尋結果都會變。
被引網域是一個商業提示詞的樣本。不同的問題形態,比如對比類問題或操作類問題,會產生不同的引用模式。有用的做法是把同樣的設計跑在你自己最有商業價值的十個提示詞上,記錄你這個品類會怎麼表現。
常見問題
AI 可見性數字要有意義,需要跑多少次? 單個提示詞的實用下限是六次,而且這個數字應當回報為「執行次數中的計數」而不是排名。如果某個提示詞驅動營收決策,十二次只需幾美元就能得到更緊的讀數。
這是否意味著 AI 可見性追蹤不值得做? 它意味著單樣本追蹤不值得。變異數本身就是發現。一個回報「六次中四次被引用,來源較上月變動了 12 個網域」的追蹤器,描述的正是競爭對手正在其中角逐的真實系統。
為什麼有一個提示詞回傳了零引用? 模型憑自身知識作答,而沒有做來源查找。那是問題的屬性,不是你網站的失敗。請把它記為不適用,而不是零。
我應該分開追蹤 ChatGPT、Claude 和 Gemini 嗎? 應該。在我們的三次對比中,兩個模型在九個被點名產品上只重疊了四個。取平均會掩蓋一個專案層面的決策:先優化哪個助手。
降低模型溫度能減少變異數嗎? 部分能,值得在你自己的提示詞上測一測。但引用集合還受搜尋索引驅動,而那個你控制不了。執行次數是更可靠的槓桿。
Auspia 觀點:如果你這個季度要搭建 AI 可見性追蹤,先建執行日誌,再建儀表板。儀表板是渲染選擇,執行日誌才是測量。從十個提示詞、各六次、逐字儲存開始,你一週學到的東西會比單樣本檢查一年告訴你的還多。
作者:Ethan Marlowe,在 Auspia 負責涵蓋 500 多個提示詞的 GEO 測量。撰寫關於提示詞追蹤、引用報告,以及能經受真實測量週期考驗的可見性儀表板的文章。