AI可視性チェッカーは、同じ日に同じ回答を読んでも正反対の判定を出すことがあります。片方は引用数を返し、もう片方は何も返しません。回答がブランド名を挙げて推薦しているのに、一度もリンクしていないからです。
私たちは2026年9月に3つのAI面で20個のプロンプトを実行し、すべての回答で2つのシグナルを記録しました。回答が本文中で挙げたブランドと、回答が情報源として提示したドメインです。この2つは1つの測定の2つの見方ではありません。予測できる場所で食い違い、その食い違う場所こそがレポートで最も役に立つ部分です。
短く言えば、Perplexityはすべてのプロンプトで情報源を引用し、Geminiは1回答あたり中央値47件の情報源注釈を返しました。一方ChatGPTは20件中12件のプロンプトで引用を一切返さず、それでも13件ではベンダー名を挙げていました。単一の面での実行間の変動は別の問題で、それは以前に AI可視性トラッカーの実行変動 で測っています。
何を実行したか
項目 | 設定 |
|---|---|
プロンプト | AI可視性ツールについて買い手が尋ねるであろう20の質問 |
面 | ChatGPT(gpt-5-2025-08-07)、Gemini(gemini-2.5-flash)、Perplexity(sonar) |
ウェブ検索 | 3つの面すべてで有効 |
地域と言語 | アメリカ合衆国、英語 |
日付 | 2026年9月12日 |
収集した回答 | 60件 |
実行全体のコスト | $1.444、1回答あたり $0.024 |
再実行 | 同じ5つのプロンプトをもう一度実行し、挙動が安定しているか確認 |
1回答あたりのコストはPerplexityの $0.006 からGeminiの $0.037 までの幅がありました。最も安い面が最も安定した情報源リストを出し、最も高い面が最も多くの情報源を返した面ではありませんでした。
2つのシグナルを別々に測る
すべての回答は2回捕捉しました。1回はテキストとして、もう1回はそのテキストに面が添付した情報源リストとして。
面 | 情報源注釈 | 1回答あたり | 引用ゼロの回答 | 1回答あたりの異なるドメイン数 |
|---|---|---|---|---|
ChatGPT(gpt-5) | 90 | 0〜18、中央値0 | 20件中12件 | 0〜10 |
Gemini 2.5 Flash | 989 | 14〜122、中央値47 | 20件中0件 | 3〜23 |
Perplexity | 399 | 19〜20 | 20件中0件 | 16〜20 |
この3つのリストは同じ種類の対象ではありません。チェッカーが最初に間違えるのはまさにここです。
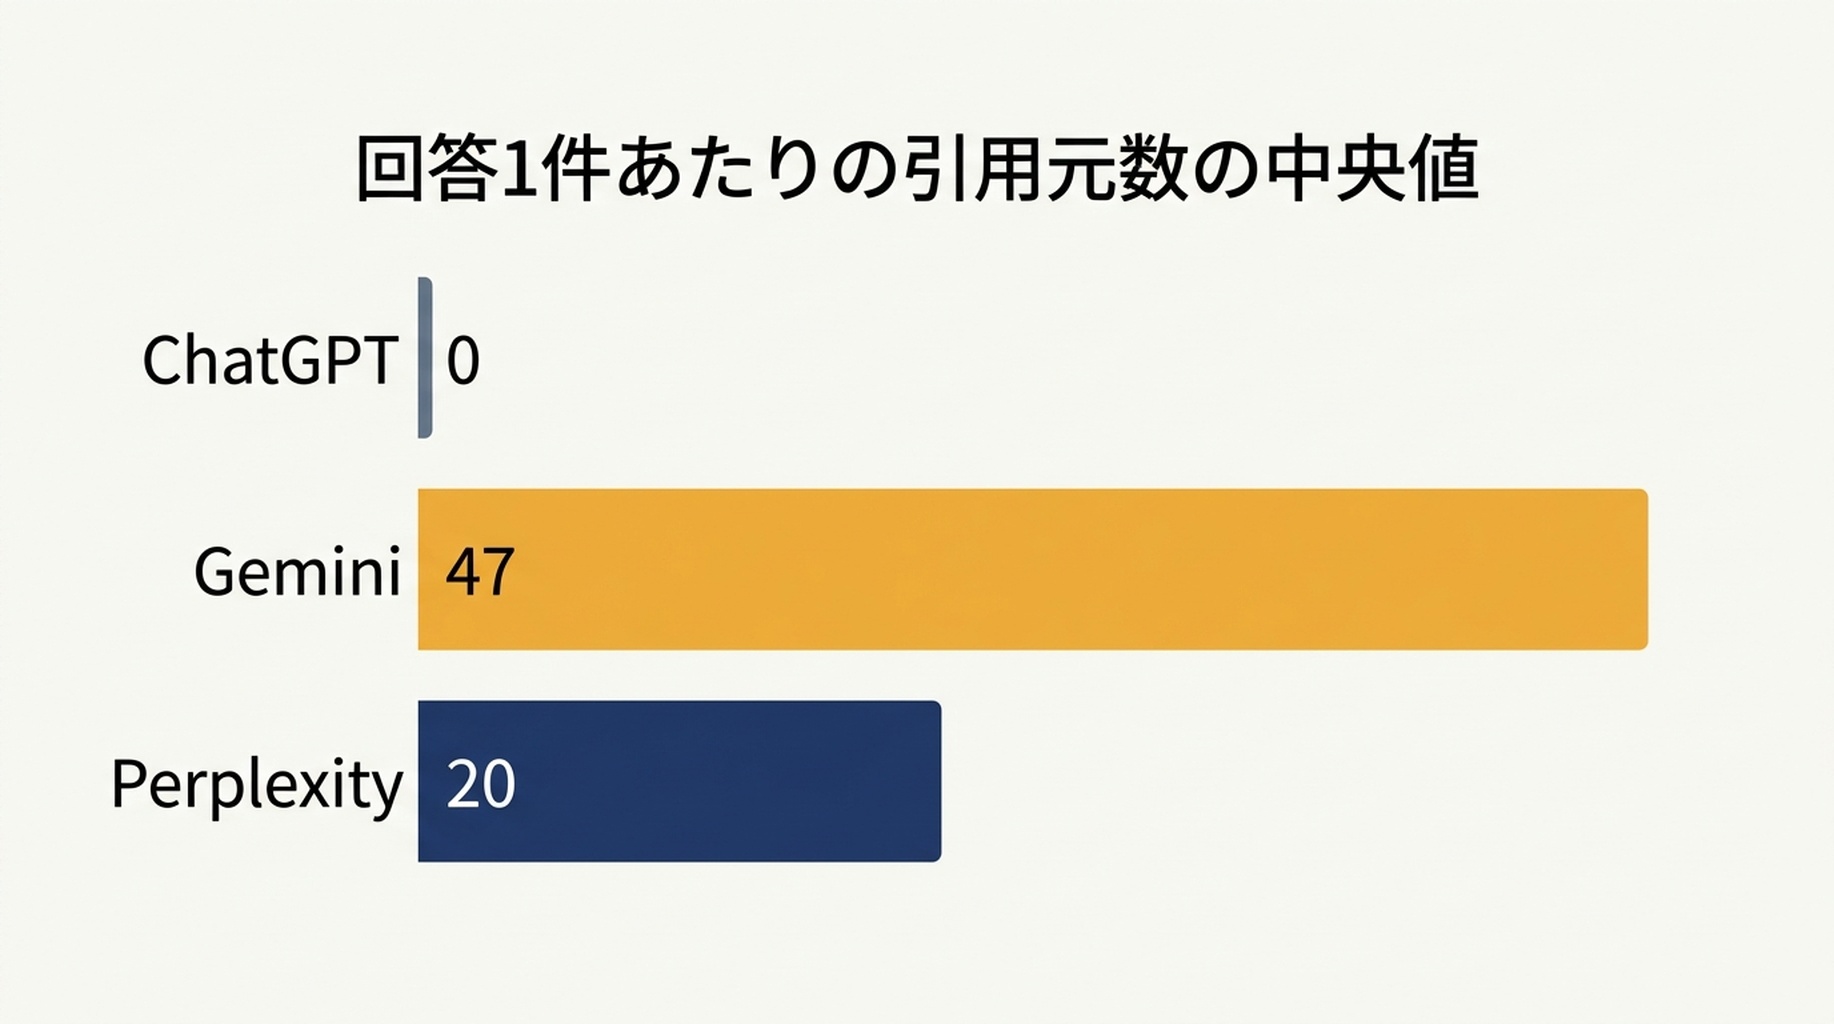
Geminiはほぼすべての主張に情報源を添付します。同じページが1つの回答の中で多数の枠を占めることがあり、だから件数がここまで高くなるのです。20件のGemini回答全体で、semrush.comが44枠、maxaeo.aiが26枠、google.comが22枠、adobe.comが21枠、medium.comが20枠を占めました。この面での注釈数の多さは、モデルがどれだけ細かく分解しているかの話であり、あなたのブランドがどれだけ広く知られているかの話ではありません。
Perplexityは上限のあるパネルを公開します。20件中19件のプロンプトでちょうど20件の情報源を返し、20件目では19件を返しました。これが分母を固定します。Perplexityの回答におけるあなたのシェアは常に20のシェアであり、1枠を得ることは誰かが1枠を失うことです。
ChatGPTは検索したときにだけ情報源リストを返します。20件中8件のプロンプトで検索クエリを発行し、残りの12件では何も引用しませんでした。その12件でも質問には回答し、ツール名も挙げていました。編集していない例を1つ挙げます。AI検索結果でブランド言及を追跡する最良のツールを尋ねられて、Brand24、Mention、BuzzSumo、Talkwalker、Google Alertsを列挙し、どれにも情報源は付いていませんでした。この失敗モードについてChatGPTの回答を監査するために私たちが使っているチェックリストは ChatGPT可視性チェックリスト にあります。
引用されずに名指しされる
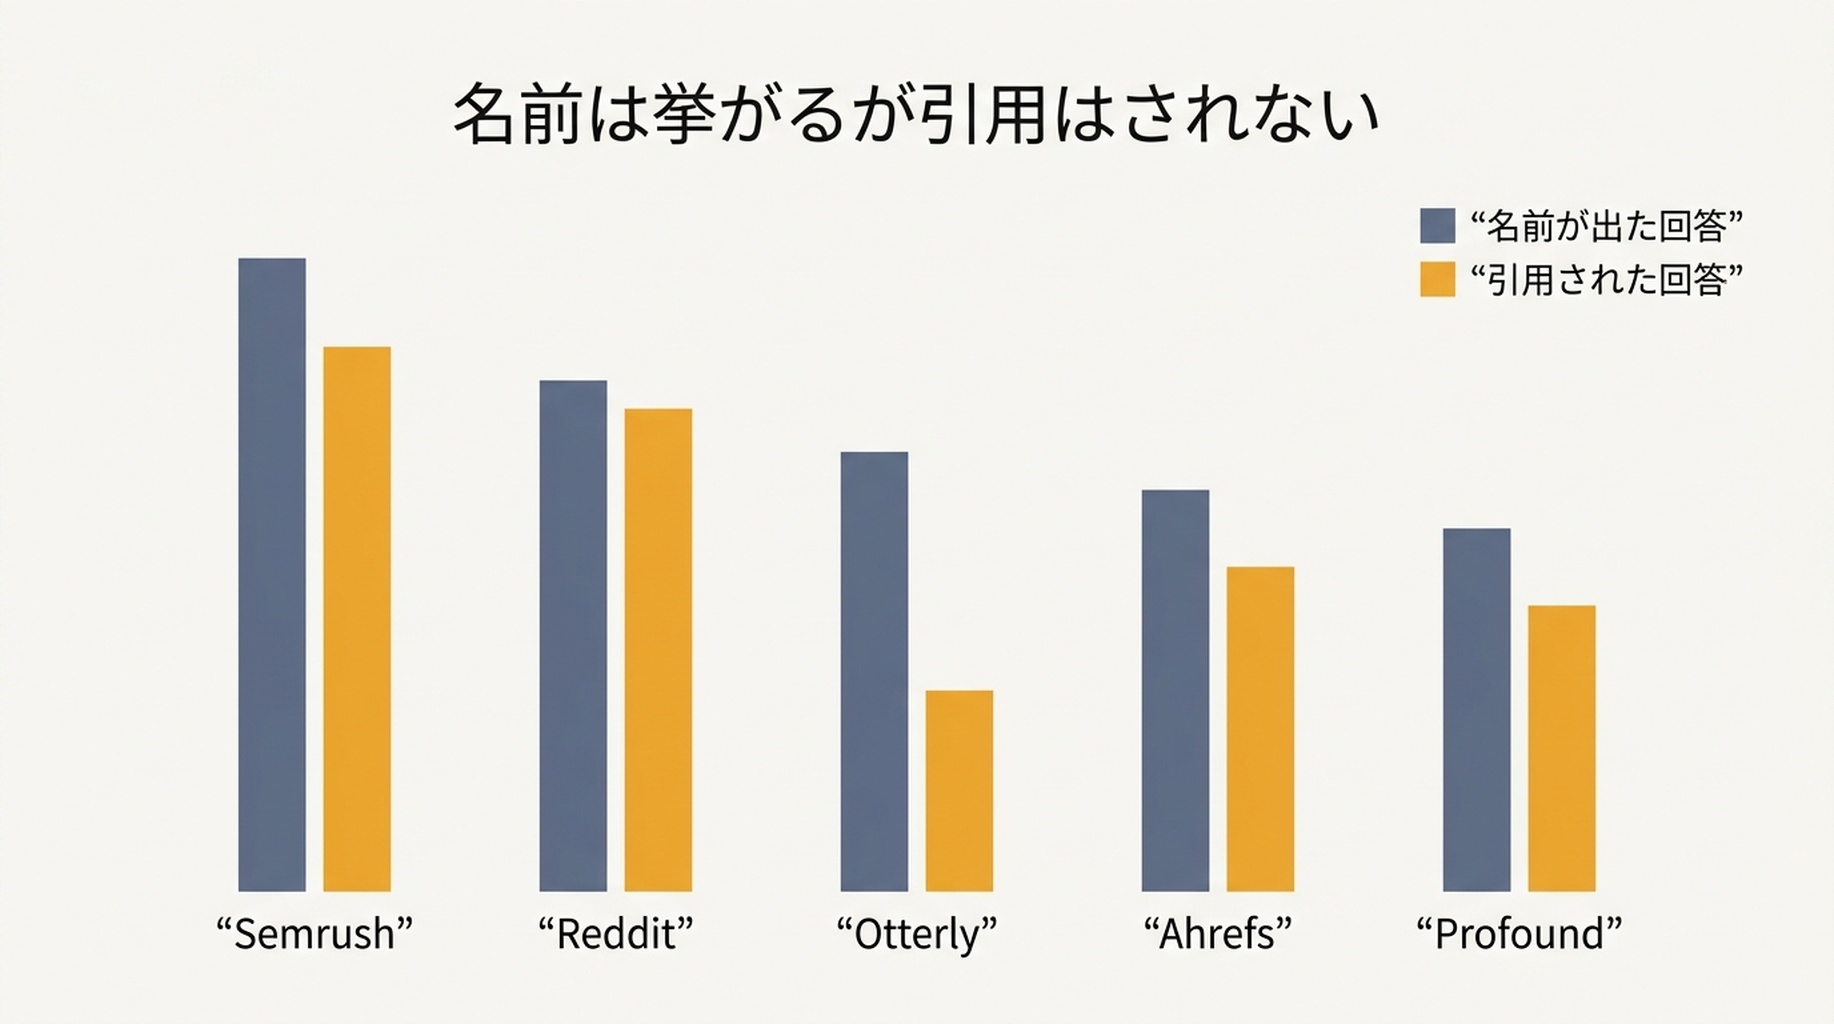
次に27のブランドと出版物について、60件の回答のうち何件が本文中でそのブランドを挙げたか、何件がそのドメインを情報源として引用したかを数えました。2つの列は両方向に食い違います。
ブランド | 挙げた回答 | そのドメインを引用した回答 |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
この表には2つのパターンがあります。Peec AI、Otterly、Profound、ZipTieは、自社ページがリンクされる頻度よりもはるかに多く回答で推薦されています。MaxAEO、Cognizo、LLM Pulse、Searchable、AirOps、Menraは逆で、回答が企業名を一度も挙げないままページだけが情報源として引かれています。リンクだけを見るチェッカーは2番目の群を可視と判定し、1番目の群を見えないと判定します。言及だけを見るチェッカーはその逆です。
60件の回答全体で、3つの面が合わせて432の異なるドメインを引用しました。ChatGPTが47(11パーセント)、Geminiが184(43パーセント)、Perplexityが285(66パーセント)です。どの面を調べても、あなたははるかに大きな情報源の宇宙の標本を見ていることになります。ここにはGoogle自身の面は含まれていません。そこでの存在感は別の方法で測られ、それは AI Overviewトラッカー で説明しています。
チェッカーが記録すべきもの
数字を1つだけ返す可視性チェッカーは、4つの欄のうち3つを捨てています。残す価値のある4つはこれです。
欄 | 記録の形 | なぜ判定を変えるか |
|---|---|---|
面が検索したか | はい/いいえ | 検索していない回答は引用を生み出せないので、そのゼロは可視性のシグナルではない |
回答本文でブランドが挙げられたか | 回答数 | 根拠づけのない回答でも生き残る唯一のシグナル |
情報源リストにドメインがあるか | 回答数 | ほとんどのツールがこれだけを報告する |
分母 | 回答数、および1回答あたりの情報源枠 | 固定20枠のパネルと47件の注釈リストは割合として比較できない |
実務上の帰結は誤ったゼロです。私たちのデータでは、ChatGPTの20件中13件の回答が少なくとも1つのベンダーを挙げた一方、何かを引用したのは20件中8件でした。つまりこの面の回答のおおよそ4分の1は、同じ回答が名前を挙げて推薦しているブランドについて、引用ゼロを報告することになります。
自分を欺かずにこれを実行する方法
この仕事をエージェントに任せるときの失敗モードは、間違った数字ではありません。一度も収集されなかった欄から計算された、自信満々の数字です。
- 何かを計算する前に生のペイロードを捕捉します。回答テキスト、情報源リスト、モデル識別子、検索クエリが発行されたかどうかの真偽値を残します。派生指標は2番目の段階でコードの中で作るものであり、収集プロンプトの中に置くものではありません。
- エージェントには要約させず、引用させます。「ブランドが何回現れたかを報告せよ」というルーブリックは文章を生みます。「回答テキストと情報源リストを一字一句そのまま返せ」というルーブリックは、再確認できるデータを生みます。
- 変化を信じる前に同じプロンプトを再実行します。私たちは5つのプロンプトを繰り返し、検索するかどうかの判断は5件中5件で一致しました。つまり引用数の突然の跳ね上がりは、ノイズであるよりモデルのバージョンかプロンプトの編集である可能性のほうが高いということです。
- モデル識別子をすべての行に残します。同じ20のプロンプトを同じエンドポイントでgpt-4oに通すと、情報源注釈を返したのは20件中2件だけでした。gpt-5では20件中8件です。
- 予算を確保します。60回答の実行全体で $1.444 かかったので、同じ確認を毎週回すとこの価格では月およそ $6 になります。
限界
- 1日、1地域、英語、3つの面。地域ごとの回答は異なります。
- 面ごとに1つのモデルバージョン。私たち自身の実行でも、モデルバージョン間で挙動は動きました。
- ブランド検出は名前の文字列一致なので、製品名だけで推薦されたブランドは見落とされ得ます。
- ウェブ検索はAPI経由で有効にしました。消費者向けアプリはこの実行より多く検索するかもしれませんし、少ないかもしれません。
- コストは回答生成のみを覆い、保存やレビューの時間は含みません。
よくある質問
ChatGPTが20件中12件のプロンプトで引用ゼロを報告したのはなぜですか?
それらのプロンプトに検索せずに答えたからです。ページを一度も取得しないモデルはページを引用できません。したがってそのゼロは実行について述べているのであって、あなたのブランドについて述べているのではありません。チャット面から引用数を読む前に、その面がウェブを使ったかどうかを確認してください。
リンクがなくても、回答で名指しされることに価値はありますか?
根拠づけのない回答ではそれがシグナルのすべてであり、リンクに先立つシグナルでもあります。私たちのデータでは、言及とリンクは別々の情報源から獲得されます。言及は比較記事やレビュー記事に従い、引用は引用されるよう構造化されたページに従います。
言及と引用を1つの可視性スコアにまとめるべきですか?
いいえ。ブランド表が示すとおり、両者は体系的に両方向へ食い違い、まとめたスコアはどちらが動いたかを隠します。2本の線として報告し、その差を読者に見せてください。
どの面から先に調べるべきですか?
安定していて安く、幅が固定されたパネルが欲しいならPerplexityです。リストの長さが変わらないからです。広さが欲しいならGeminiで、私たちが見た432ドメインのうち184に到達しました。ChatGPTは妥当性チェックを添える場合に限ります。そうでなければ回答の5分の1が、見えないブランドとして読まれてしまいます。
Auspia の見解:言及と引用は2本の別々の線として報告し、何かを記録する前にその面が検索したかどうかを記録してください。単一の可視性スコアは、次に何を直すべきかを教えてくれるまさにその差を隠してしまいます。そして私たちのデータで最も安い修正は、コンテンツを増やすことではありませんでした。実際に調べた面を確認することでした。
執筆: エイドリアン・コール