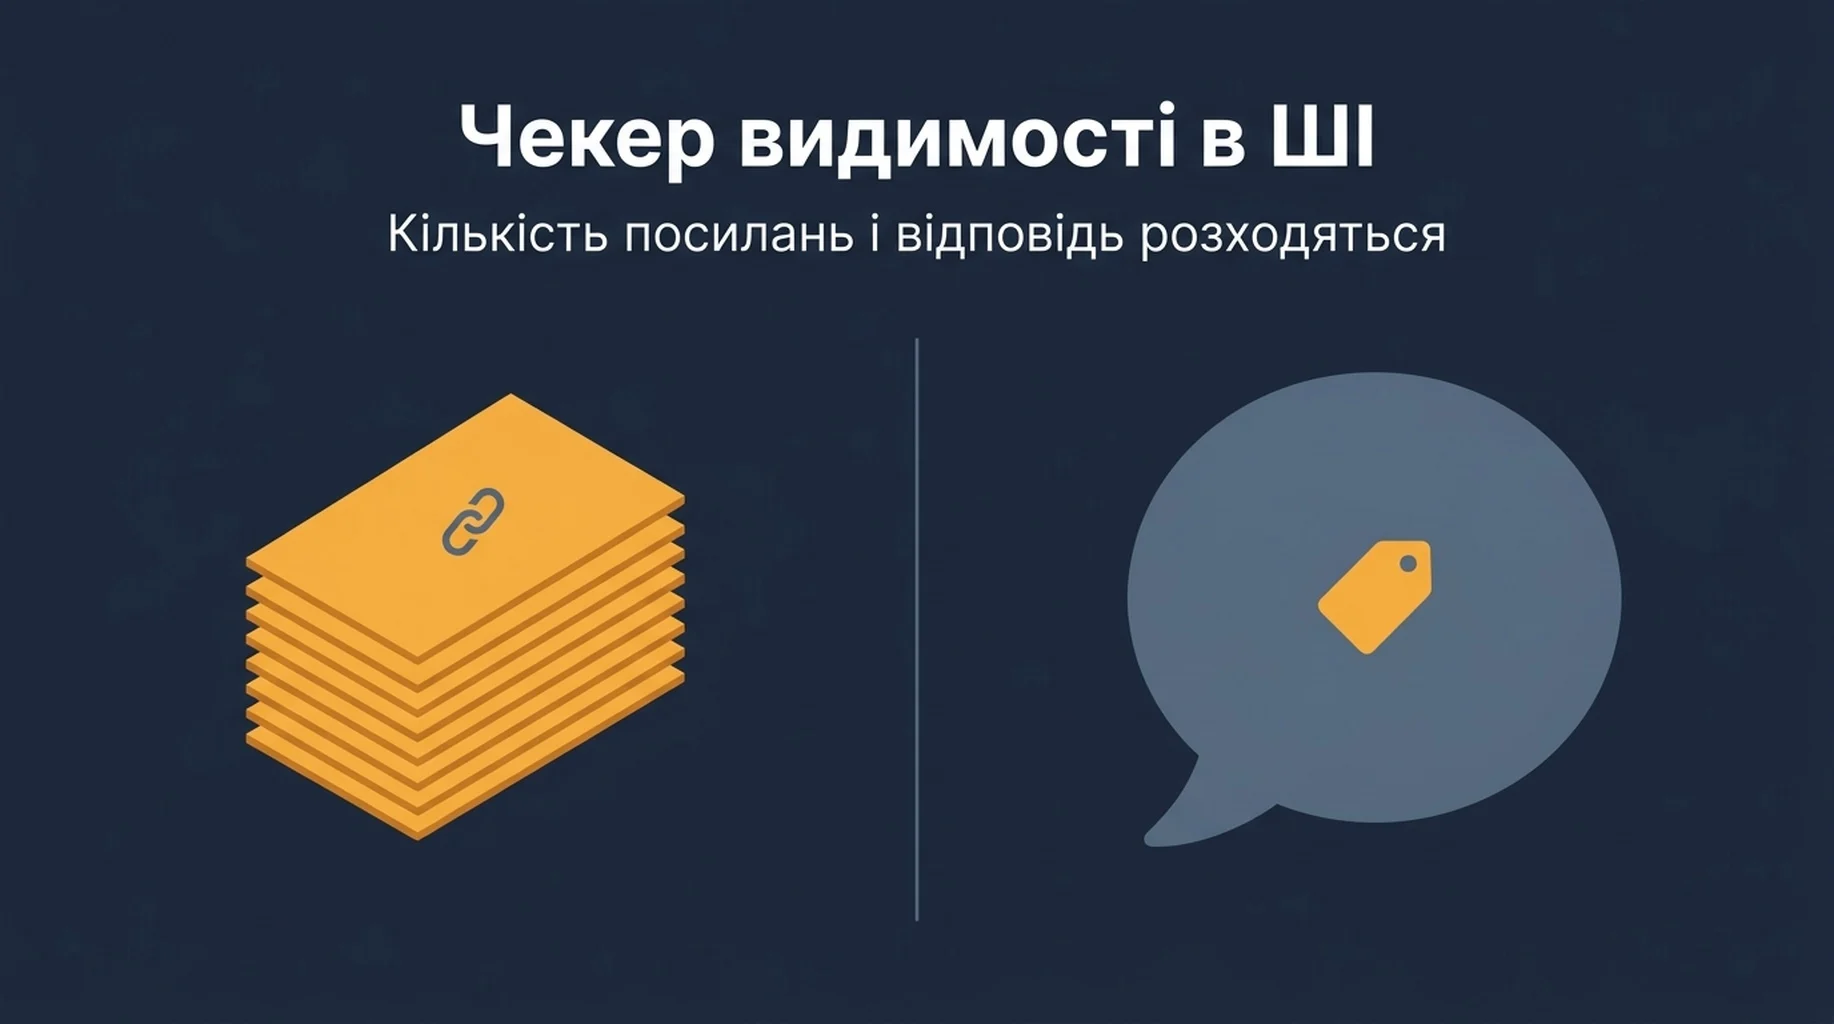
Два чекери видимості в ШІ можуть прочитати ті самі відповіді того самого дня й ухвалити протилежні вердикти. Один повертає кількість цитувань, другий не повертає нічого, бо відповідь назвала ваш бренд на ім'я й порадила його, жодного разу не пославшись на нього посиланням.
У вересні 2026 року ми прогнали двадцять запитів по трьох поверхнях ШІ й на кожній відповіді зафіксували два сигнали: бренд, який відповідь назвала в тексті, і домен, який відповідь подала як джерело. Це не два ракурси одного вимірювання. Вони розходяться в передбачуваних місцях, і саме ці місця — найкорисніше в звіті.
Коротка версія: Perplexity послався на джерела в кожному запиті, Gemini повернув медіану 47 джерел на відповідь, а ChatGPT не повернув жодного цитування в 12 з 20 запитів, але все одно назвав постачальників у 13 з них. Розбіжність між запусками на одній поверхні — окреме питання, і ми міряли її раніше в матеріалі розбіжність запусків трекера видимості в ШІ.
Що ми прогнали
Пункт | Налаштування |
|---|---|
Запити | Двадцять питань, які поставив би покупець про інструменти видимості в ШІ |
Поверхні | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Пошук у вебі | Увімкнений на всіх трьох поверхнях |
Регіон і мова | США, англійська |
Дата | 12 вересня 2026 року |
Зібрано відповідей | 60 |
Вартість усього прогону | 1,444 долара, тобто 0,024 долара за відповідь |
Повторний прогін | Прогнали ті самі п'ять запитів удруге, щоб побачити, чи поведінка стабільна |
Вартість відповіді лежала в діапазоні від 0,006 долара в Perplexity до 0,037 долара в Gemini. Найдешевша поверхня дала найузгодженіший список джерел, а найдорожча не була тією, що повернула найбільше джерел.
Два сигнали, виміряні окремо
Кожну відповідь ми фіксували двічі: один раз як текст, удруге як список джерел, який поверхня долучила до цього тексту.
Поверхня | Позначки джерел | На відповідь | Відповідей без цитувань | Різних доменів на відповідь |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | від 0 до 18, медіана 0 | 12 з 20 | від 0 до 10 |
Gemini 2.5 Flash | 989 | від 14 до 122, медіана 47 | 0 з 20 | від 3 до 23 |
Perplexity | 399 | від 19 до 20 | 0 з 20 | від 16 до 20 |
Ці три списки — не один і той самий тип об'єкта, і саме тут чекер помиляється насамперед.
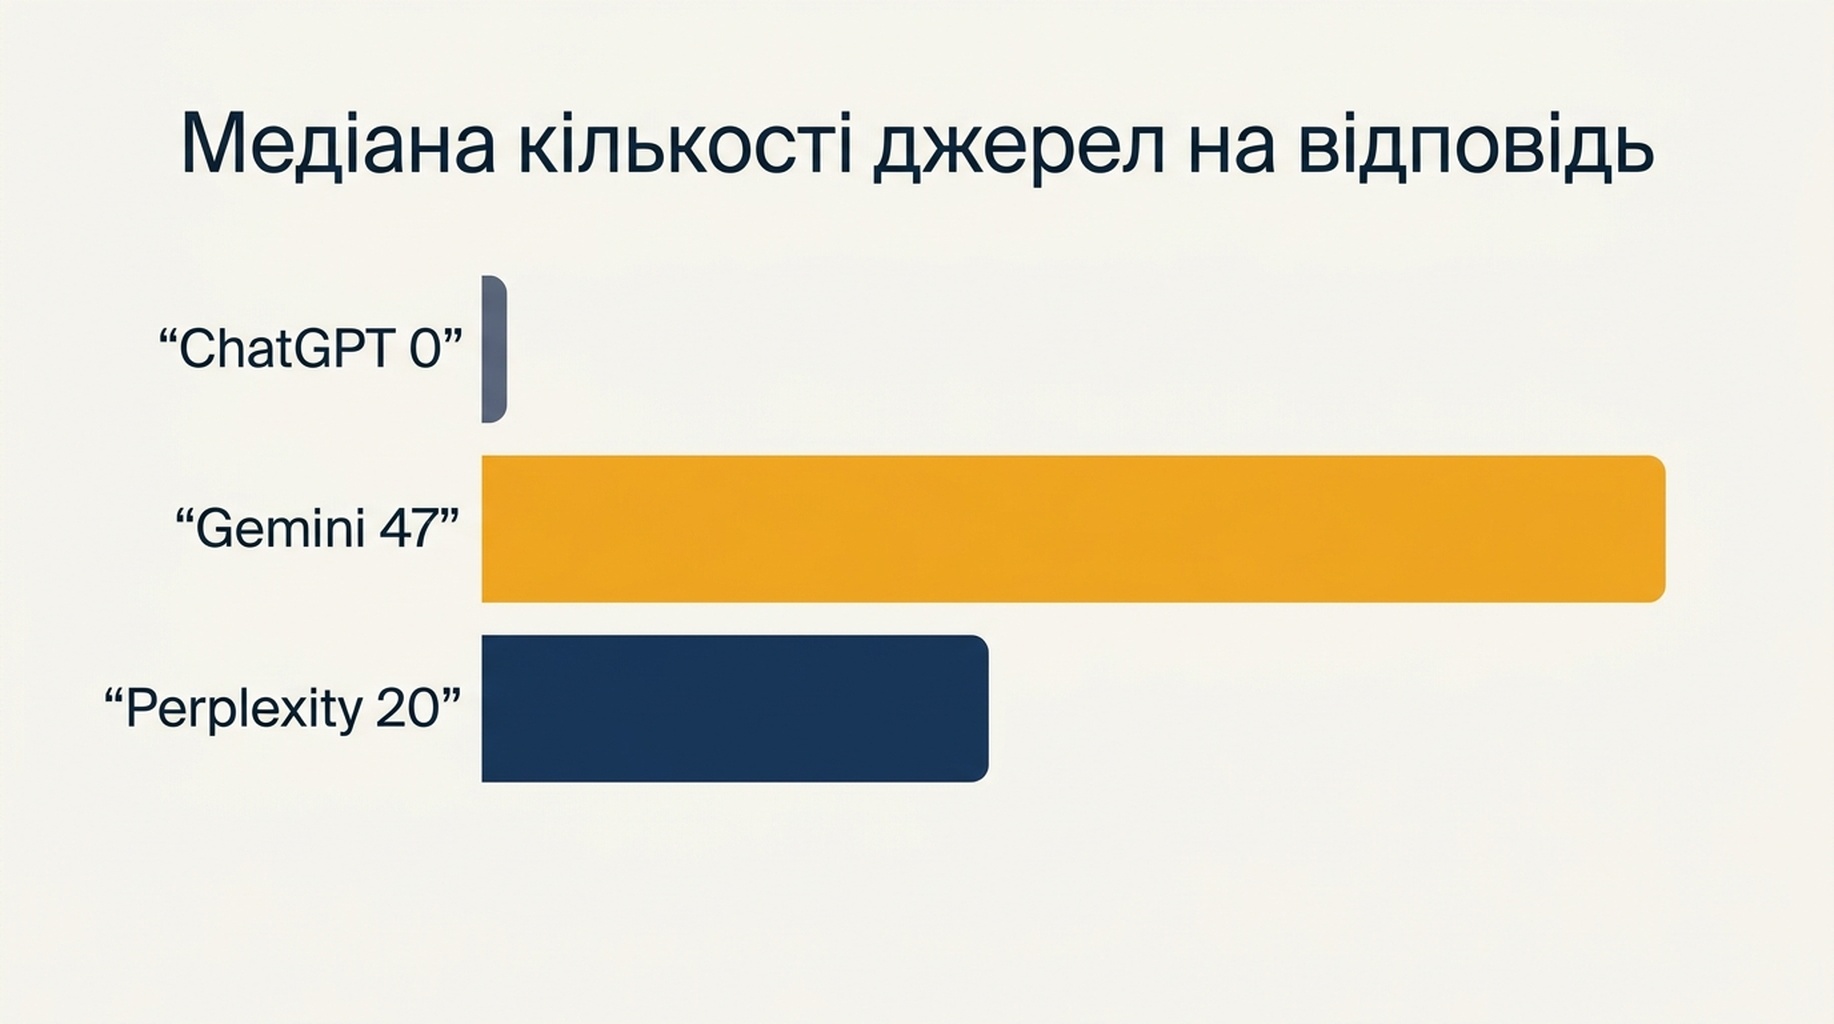
Gemini долучає джерело майже до кожного твердження. Одна й та сама сторінка може займати в одній відповіді безліч місць, і саме тому числа такі високі: по 20 відповідях Gemini домен semrush.com зайняв 44 місця, maxaeo.ai — двадцять шість, google.com — двадцять два, adobe.com — двадцять одне, medium.com — двадцять. Високе число позначок на цій поверхні говорить про те, наскільки дрібно модель розбирає матеріал, а не про те, наскільки широко відомий ваш бренд.
Perplexity публікує панель із стелею. Він повернув рівно двадцять джерел у 19 з 20 запитів і дев'ятнадцять у двадцятому. Це фіксує знаменник: ваша частка у відповіді Perplexity — це завжди частка з двадцяти, тож отримане місце означає, що хтось деінде місце втратив.
ChatGPT повертає список джерел лише тоді, коли він шукав. Пошуковий запит він надіслав у 8 з 20 випадків, а в решті дванадцяти не процитував нічого. У цих дванадцяти він усе одно відповів на питання й усе одно назвав інструменти. Один приклад без редагування: на питання про найкращі інструменти відстеження згадок бренду в результатах ШІ-пошуку він перелічив Brand24, Mention, BuzzSumo, Talkwalker і Google Alerts, і до жодного не долучив джерела. Чек-ліст, яким ми користуємося, щоб перевіряти відповіді ChatGPT на цей режим відмови, лежить у матеріалі чек-ліст видимості в ChatGPT.
Названий на ім'я, але не процитований
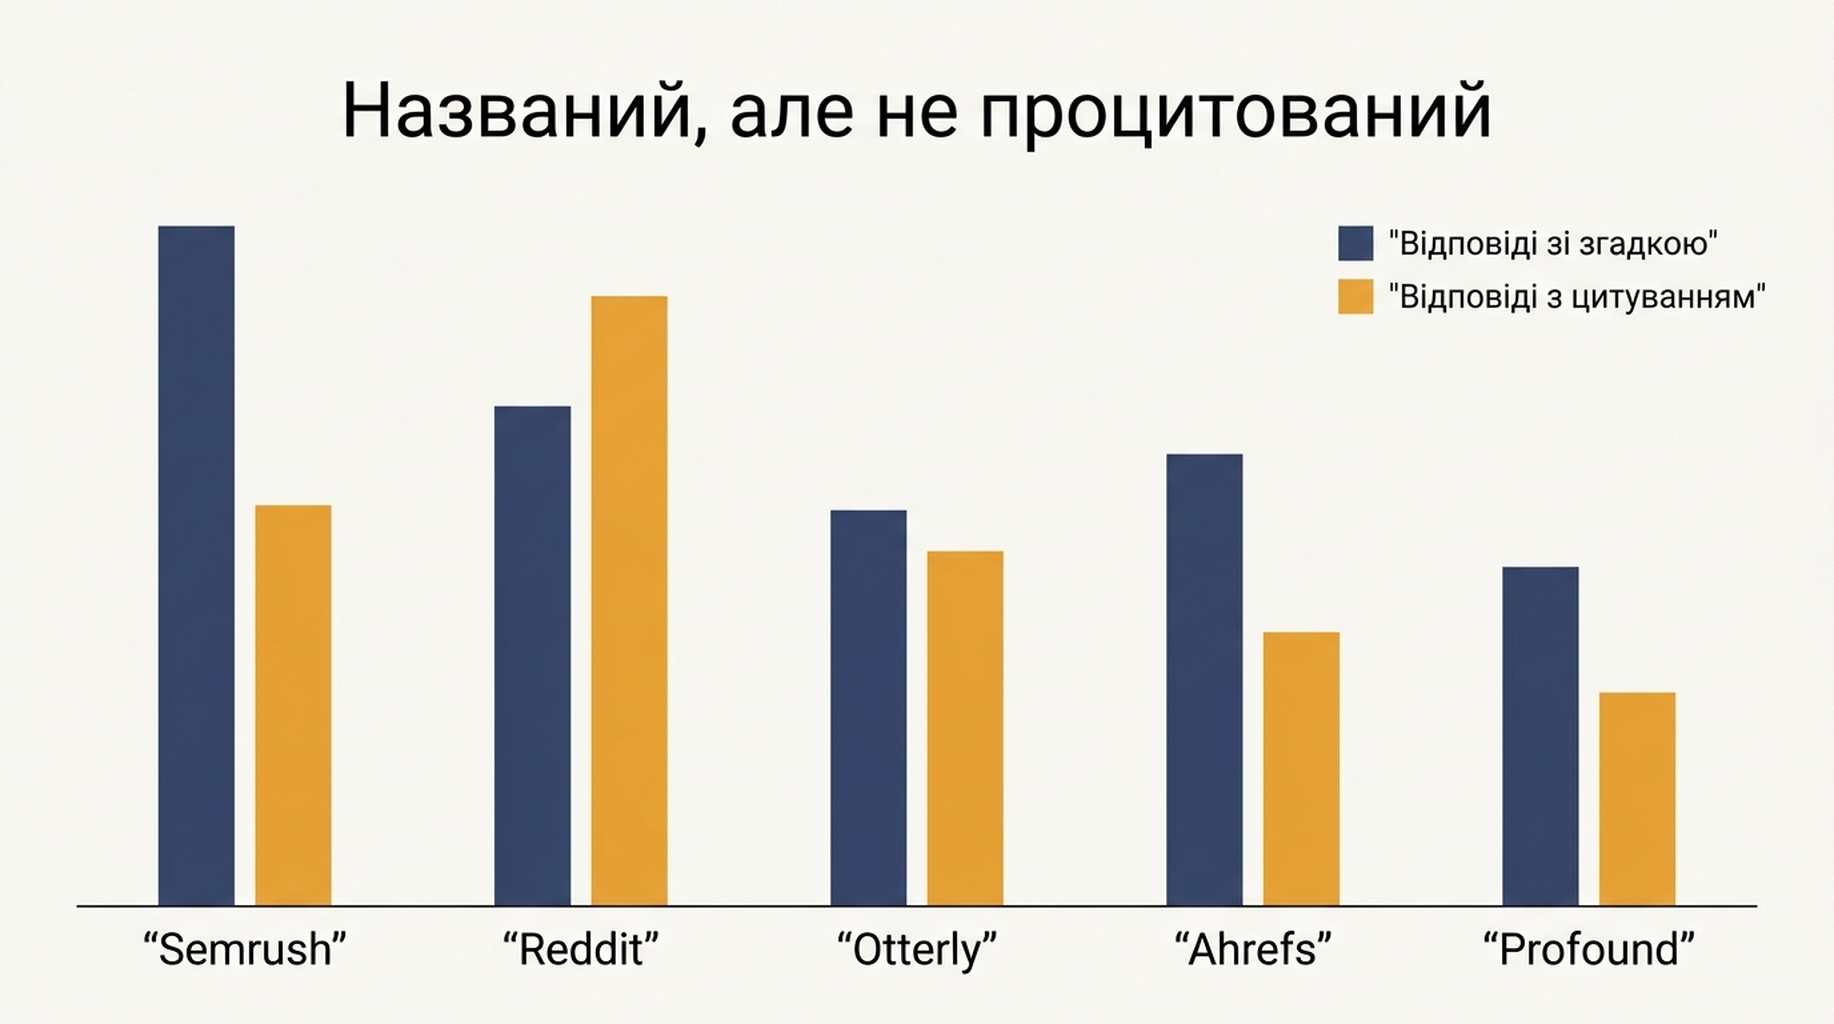
Далі ми порахували по 27 брендах і медіа, у скількох із 60 відповідей бренд був названий у тексті й у скількох був процитований його домен як джерело. Два стовпці розходяться в обидва боки водночас.
Бренд | Відповідей, що назвали його | Відповідей, що процитували його домен |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
У цій таблиці два візерунки. Peec AI, Otterly, Profound і ZipTie рекомендують у відповідях куди частіше, ніж посилаються на їхні сторінки. У MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps і Menra все навпаки: їхні сторінки втягують як джерела, тоді як відповідь жодного разу не називає компанію. Чекер, який дивиться лише на посилання, визнає другу групу видимою, а першу — невидимою. Чекер, який дивиться лише на згадки, зробить навпаки.
По всіх 60 відповідях три поверхні разом процитували 432 різні домени. На ChatGPT припадає 47 із них, тобто 11 відсотків, на Gemini — 184 (43 відсотки), на Perplexity — 285 (66 відсотків). Яку б поверхню ви не перевіряли, ви дивитеся на вибірку з куди більшого всесвіту джерел. Сюди не входить власна поверхня Google, де присутність міряють інакше — про це в матеріалі трекер AI Overview.
Що чекер зобов'язаний фіксувати
Чекер видимості, який повертає одне число, викидає три з чотирьох своїх полів. Ось чотири, які варто зберегти.
Поле | Форма фіксації | Чому це змінює вердикт |
|---|---|---|
Чи шукала поверхня | так або ні | Відповідь, яка не шукала, не може породити цитування, тож її нуль — не сигнал видимості |
Чи названо бренд у тексті відповіді | кількість відповідей | Єдиний сигнал, який виживає на відповіді без обґрунтування |
Чи є домен у списку джерел | кількість відповідей | Сигнал, про який більшість інструментів повідомляє саме собою |
Знаменник | кількість відповідей і кількість місць під джерела на відповідь | Панель із фіксованими двадцятьма місцями й список на 47 позначок не можна порівнювати як відсотки |
Практичний наслідок — фальшивий нуль. У наших даних 13 з 20 відповідей ChatGPT назвали хоча б одного постачальника, тоді як процитували хоч щось лише 8 з 20, тобто приблизно чверть відповідей цієї поверхні повідомлятиме нуль цитувань для бренду, який та сама відповідь назвала на ім'я й порадила.
Як робити це, не обманюючи себе
Режим відмови, коли ви віддаєте цю роботу агенту, — не хибне число, а впевнене число, пораховане з поля, яке ніколи не збирали.
- Захоплюйте сире навантаження до того, як щось порахуєте. Зберігайте текст відповіді, список джерел, ідентифікатор моделі та булеве значення про те, чи був надісланий пошуковий запит. Похідні метрики будують у коді на другому етапі, а не кладуть усередину запиту на збирання.
- Змушуйте агента цитувати, а не переказувати. Критерій «повідом, скільки разів трапився бренд» породжує прозу. Критерій «поверни дослівно текст відповіді та список джерел» породжує дані, які можна переперевірити.
- Проганяйте той самий запит заново, перш ніж повірити в зміну. Ми повторили п'ять запитів, і рішення про пошук збіглося в 5 випадках із 5, тобто різкий стрибок кількості цитувань радше виявиться версією моделі або правкою запиту, а не шумом.
- Залишайте ідентифікатор моделі в кожному рядку. Ті самі двадцять запитів на тій самій кінцевій точці через gpt-4o повернули позначки джерел лише в 2 з 20 випадків проти 8 з 20 у gpt-5.
- Закладайте бюджет. Повний прогін із 60 відповідей коштував 1,444 долара, тож щотижнева версія тієї самої перевірки за цими цінами коштуватиме приблизно 6 доларів на місяць.
Обмеження
- Один день, один регіон, англійська мова, три поверхні. Відповіді різняться від регіону до регіону.
- Одна версія моделі на поверхню. Навіть у наших прогонах поведінка зсувалася між версіями моделі.
- Розпізнавання брендів — це зіставлення рядків за назвою, тож бренд, пораджений лише за назвою продукту, може бути пропущений.
- Пошук у вебі вмикали через API. Споживчі застосунки можуть шукати частіше за ці прогони, а можуть і рідше.
- Вартість покриває лише генерацію відповідей і не включає час на зберігання чи перевірку.
Часті питання
Чому ChatGPT повідомив нуль цитувань у 12 з 20 запитів?
Бо він відповідав на ці запити, не виконуючи пошук. Модель, яка жодного разу не забирає сторінку, не може на неї послатися. Отже, цей нуль описує прогін, а не ваш бренд. Перш ніж читати число цитувань з будь-якої чат-поверхні, спершу з'ясуйте, чи користувалася ця поверхня вебом.
Чи має згадка цінність, якщо посилання немає взагалі?
На відповіді без обґрунтування це весь сигнал, і це ще й сигнал, який приходить раніше за посилання. У наших даних згадку й посилання здобувають із різних джерел: згадка йде за порівняльним і оглядовим контентом, а посилання — за сторінками, структурованими так, щоб їх цитували.
Чи варто об'єднувати згадки й цитування в один бал видимості?
Ні. Як показує таблиця брендів, вони систематично розходяться в обидва боки, а об'єднаний бал приховує, що саме зрушило. Повідомляйте про них двома лініями й дайте читачеві побачити цей розрив.
Яку поверхню перевіряти першою?
Якщо вам потрібна стабільна, дешева панель із фіксованою шириною, беріть Perplexity: довжина його списку не змінюється. Якщо потрібна широта, беріть Gemini: він дотягнувся до 184 з 432 доменів, які ми бачили. ChatGPT — лише з перевіркою на правдоподібність, інакше п'ята частина його відповідей прочитається як невидимий бренд.
Погляд Auspia: повідомляйте про згадки й цитування двома окремими лініями та фіксуйте, чи поверхня шукала, перш ніж фіксувати будь-що інше. Єдиний бал видимості приховує рівно той розрив, який каже вам, що лагодити далі, а найдешевша правка в наших даних полягала не в додаванні контенту, а в перевірці поверхні, яка справді дивилася у веб.
Автор: Адріан Коул