两个 AI 可见性检查器可以在同一天读同一批回答,却给出完全相反的结论。一个返回引用数量,另一个什么都不返回,因为那段回答点名推荐了你的品牌,却从未链接到它。
我们在 2026 年 9 月跨三个 AI 界面跑了 20 个提示词,并在每一条回答上记录了两个信号:回答在正文中点名的品牌,以及回答作为来源呈现的域名。这两个信号不是同一次测量的两个视角。它们会在可预测的地方分开,而分开的那些地方正是报告里最有用的部分。
简短的版本:Perplexity 在每一个提示词上都引用了来源,Gemini 平均每条回答返回 47 条来源标注,而 ChatGPT 在 20 个提示词中有 12 个完全没有返回引用,却仍在那其中 13 个里点名了厂商。单一界面上的重复运行波动是另一个问题,我们此前在 AI 可见性追踪器的运行波动 中测量过。
我们跑了什么
项目 | 设置 |
|---|---|
提示词 | 买家会问的 20 个关于 AI 可见性工具的问题 |
界面 | ChatGPT(gpt-5-2025-08-07)、Gemini(gemini-2.5-flash)、Perplexity(sonar) |
网络搜索 | 三个界面全部开启 |
地区与语言 | 美国,英语 |
日期 | 2026 年 9 月 12 日 |
收集到的回答 | 60 条 |
整轮运行成本 | $1.444,即每条回答 $0.024 |
重复运行 | 把同样的 5 个提示词再跑一遍,看行为是否稳定 |
每条回答的成本从 Perplexity 的 $0.006 到 Gemini 的 $0.037 不等。最便宜的界面产出了最一致的来源列表,而最贵的界面并不是返回来源最多的那一个。
分别测量这两个信号
每条回答都被捕获了两次:一次作为文本,一次作为该界面附加到这段文本上的来源列表。
界面 | 来源标注 | 每条回答 | 零引用的回答 | 每条回答的不同域名数 |
|---|---|---|---|---|
ChatGPT(gpt-5) | 90 | 0 到 18,中位数 0 | 20 条中 12 条 | 0 到 10 |
Gemini 2.5 Flash | 989 | 14 到 122,中位数 47 | 20 条中 0 条 | 3 到 23 |
Perplexity | 399 | 19 到 20 | 20 条中 0 条 | 16 到 20 |
这三份列表不是同一类对象,而这正是检查器最先搞错的地方。
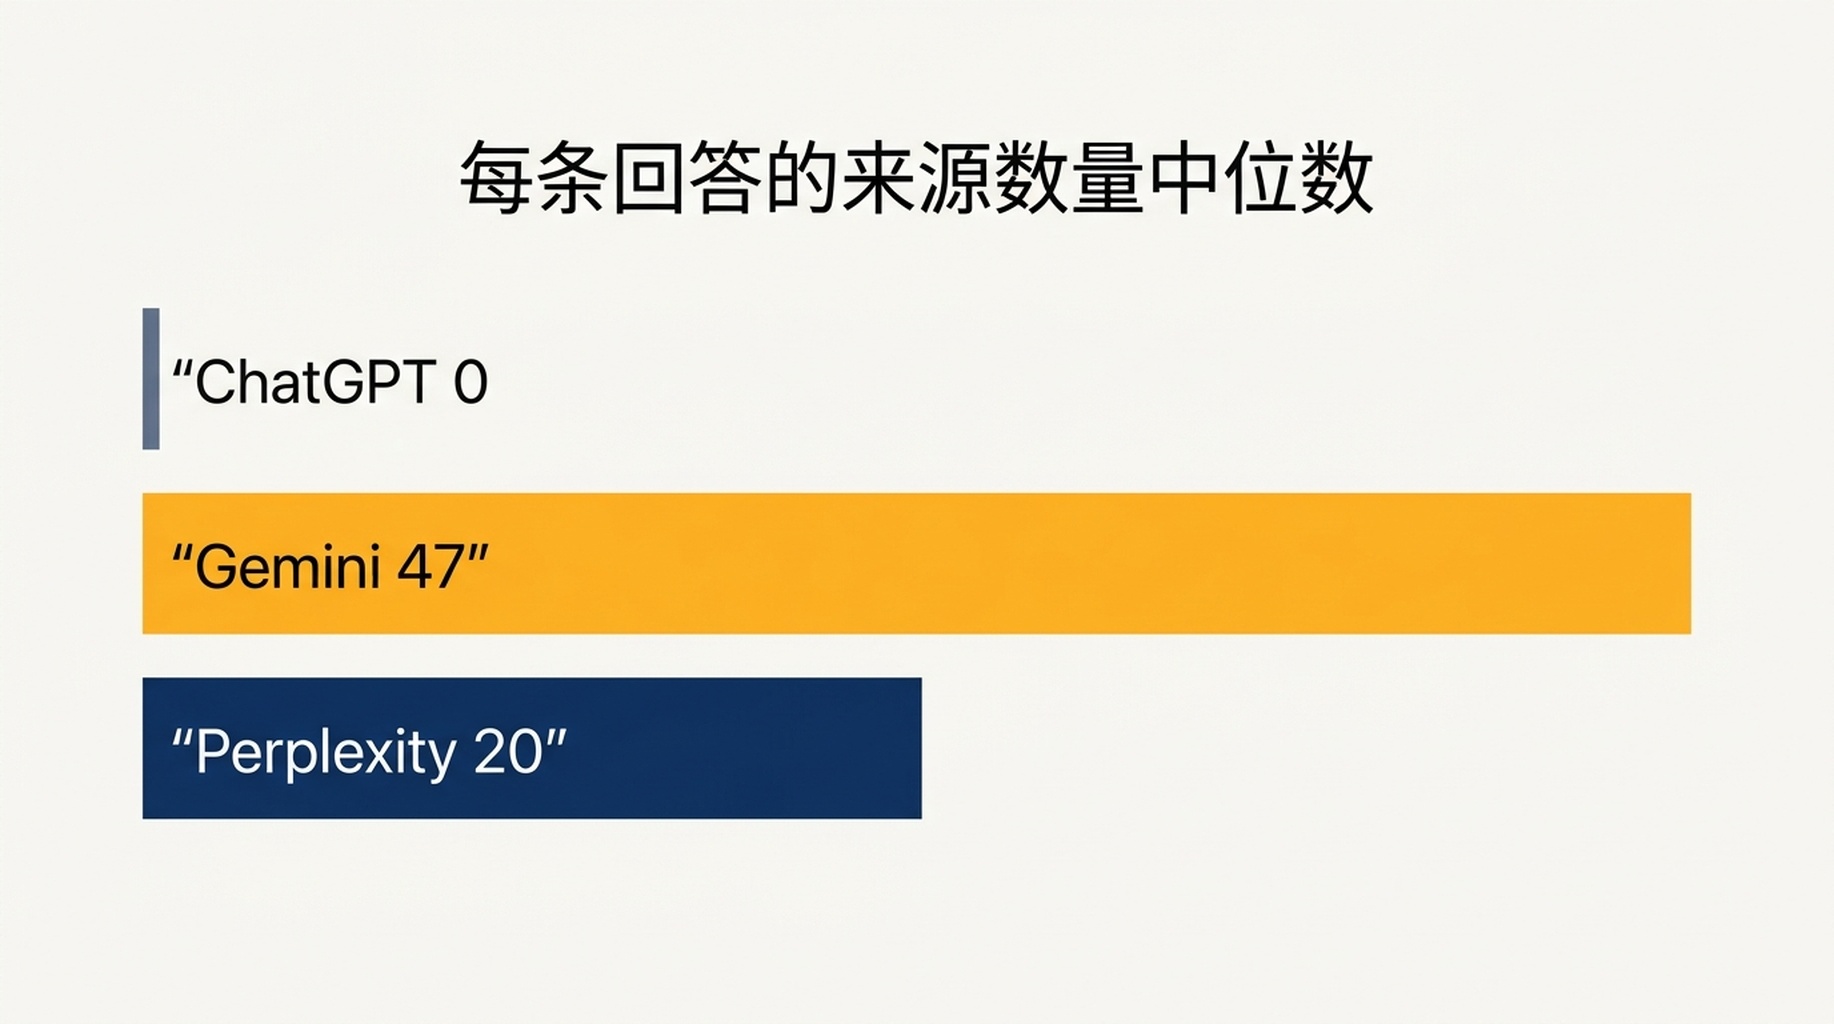
Gemini 几乎给每一条主张都附上来源。同一个页面可以在一条回答里占据许多个位置,这也是数量之所以这么高的原因:在 20 条 Gemini 回答中,semrush.com 占了 44 个位置,maxaeo.ai 占 26 个,google.com 占 22 个,adobe.com 占 21 个,medium.com 占 20 个。这个界面上的高标注数说的是模型拆解得有多细,而不是你的品牌有多广为人知。
Perplexity 发布的是一个有上限的面板。它在 20 个提示词中的 19 个上恰好返回 20 条来源,在第 20 个上返回 19 条。这就固定了分母:你在一条 Perplexity 回答中的份额永远是 20 的份额,所以一个位置被拿到,就意味着某个别处丢了一个位置。
ChatGPT 只在它搜索过的时候才返回来源列表。它在 20 个提示词中的 8 个上发出了搜索查询,在另外 12 个上一无所引。在那 12 个上它仍然回答了问题,仍然点名了工具。举一个未加编辑的例子:当被问到追踪 AI 搜索结果中品牌提及的最佳工具时,它列出了 Brand24、Mention、BuzzSumo、Talkwalker 和 Google Alerts,而这些都没有附任何来源。我们用来审计 ChatGPT 回答是否落入这种失败模式的清单在 ChatGPT 可见性清单。
被点名却未被引用
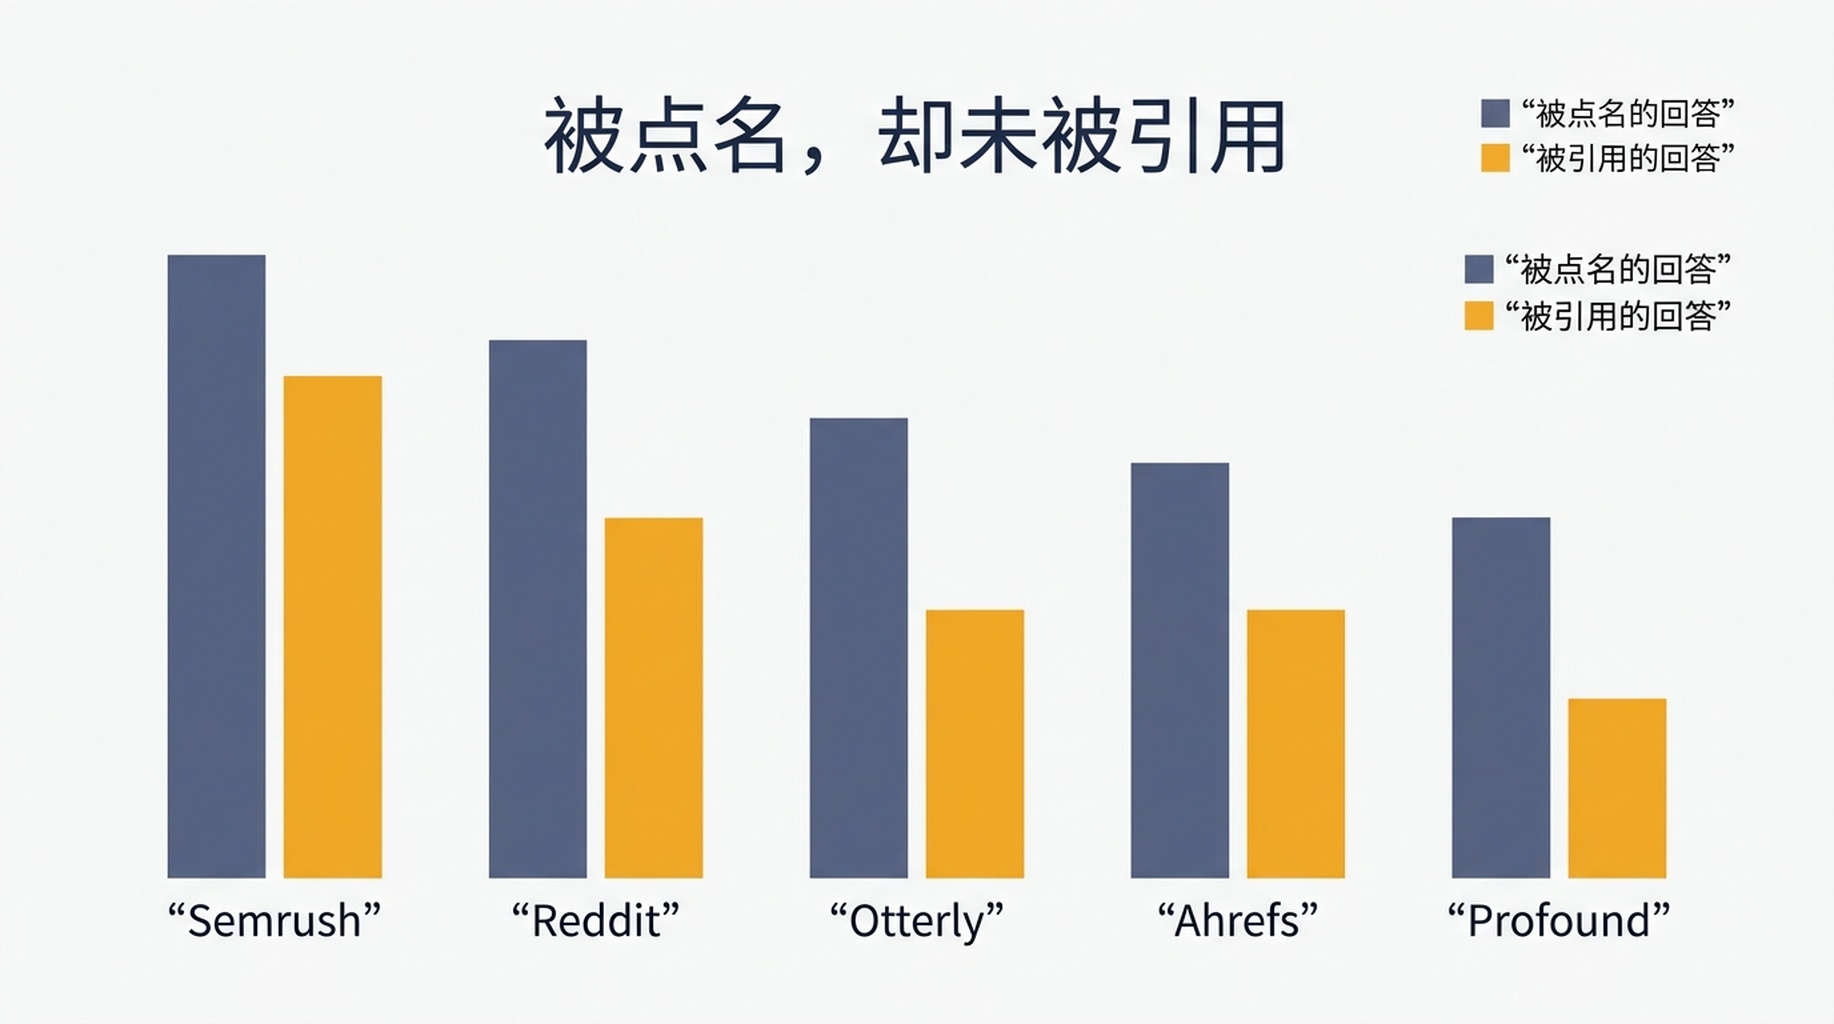
接着我们针对 27 个品牌与媒体,统计了 60 条回答中有多少条在正文里点名了该品牌,有多少条把它的域名作为来源引用。这两列在两个方向上都不一致。
品牌 | 点名它的回答 | 引用其域名的回答 |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
这张表里有两个模式。Peec AI、Otterly、Profound 和 ZipTie 在回答中被推荐的频率远高于它们的页面被链接的频率。MaxAEO、Cognizo、LLM Pulse、Searchable、AirOps 和 Menra 正好相反:它们的页面作为来源被拉进来,而回答从未点出公司名。只看链接的检查器会把第二组判为可见,把第一组判为不可见。只看提及的检查器则相反。
在全部 60 条回答中,三个界面合计引用了 432 个不同域名。ChatGPT 占其中 47 个,即 11 个百分点;Gemini 占 184 个(43 个百分点);Perplexity 占 285 个(66 个百分点)。无论你检查哪个界面,你看到的都是一个大得多的来源宇宙中的一份样本。这里不包含 Google 自己的界面,那里的存在感用另一种方式测量,我们的 AI Overview 追踪器 对此有说明。
检查器必须记录什么
一个只返回单个数字的可见性检查器,正在丢掉它四个字段中的三个。值得留下的是这四个。
字段 | 记录形式 | 它为什么改变结论 |
|---|---|---|
该界面是否搜索过 | 是或否 | 未搜索的回答不可能产生引用,所以它的零不是可见性信号 |
回答正文中是否点名品牌 | 回答条数 | 这是无依据回答上唯一还活着的信号 |
来源列表中是否有该域名 | 回答条数 | 这是大多数工具单独报告的那个信号 |
分母 | 回答条数,以及每条回答的来源位置数 | 固定 20 位的面板和 47 条标注的列表不能作为百分比相互比较 |
实际后果就是一个假的零。在我们的数据里,ChatGPT 的 20 条回答中有 13 条至少点名了一个厂商,而只有 8 条引用了任何东西,所以这个界面大约四分之一的回答,会为同一条回答点名推荐的品牌报告零引用。
如何做这件事而不骗自己
如果你把这件事交给智能体,失败模式不是一个错误的数字,而是一个从从未被收集的字段里算出来的自信的数字。
- 在计算任何东西之前先捕获原始载荷。保留回答文本、来源列表、模型标识符,以及一个表示是否发出了搜索查询的布尔值。派生指标属于第二步的代码里,不属于采集提示词里。
- 让智能体去引用,而不是去总结。写「报告品牌出现了多少次」的评分标准产出的是散文。写「逐字返回回答文本和来源列表」的评分标准产出的才是你能复核的数据。
- 在相信任何变化之前重跑同一个提示词。我们重复了 5 个提示词,搜索与否的决定在 5 个中 5 个上一致,这意味着引用数的突然跳升更可能是模型版本或提示词改动,而不是噪声。
- 把模型标识符留在每一行里。同样的 20 个提示词在同一端点用 gpt-4o 跑,只有 20 条中的 2 条返回了来源标注,而 gpt-5 是 20 条中的 8 条。
- 为它留预算。整整 60 条回答的运行花了 $1.444,所以按这些价格,同样检查的每周版本一个月约 $6。
局限
- 一天、一个地区、英语、三个界面。不同地区的回答会不一样。
- 每个界面一个模型版本。在我们自己的运行中,行为在模型版本之间就动过。
- 品牌识别是按名称做的字符串匹配,所以只靠产品名被推荐的品牌可能被漏掉。
- 网络搜索是通过 API 开启的。消费级应用搜索的频率可能比这些运行多,也可能更少。
- 成本只覆盖回答生成,不含存储或复核时间。
常见问题
为什么 ChatGPT 在 20 个提示词中有 12 个报告零引用?
因为它在那些提示词上没有搜索就作答了。一个从不检索页面的模型不可能引用页面,所以那个零描述的是这次运行,不是你的品牌。在从任何聊天界面读取引用数字之前,先确认该界面到底有没有用网络。
如果没有任何链接,在回答里被点名还有价值吗?
在一条无依据的回答上,它就是信号的全部,而且它也是先于链接出现的那个信号。在我们的数据里,提及与链接来自不同的来源:提及跟随比较类与评测类内容,引用跟随被结构化得便于被引用的页面。
我应该把提及和引用合并成一个可见性分数吗?
不应该。正如品牌表所示,它们在两个方向上都系统性地不一致,合并后的分数会掩盖到底是哪一个动了。把它们作为两条线报告,让读者看见那道差距。
我应该先检查哪个界面?
如果你想要一个稳定、便宜、宽度固定的面板,就选 Perplexity,因为它的列表长度不变。如果你想要广度,就选 Gemini,它触达了我们看到的 432 个域名中的 184 个。ChatGPT 只在附带有效性检查时才用,否则它五分之一的回答会把一个品牌读成不可见。
Auspia 观点:把提及和引用作为两条独立的线来报告,并在记录任何其他东西之前先记录该界面是否搜索过。单一的可见性分数恰好掩盖了那道告诉你下一步该修什么的差距,而在我们的数据里,最便宜的修法不是增加内容,而是去检查一个真正看过网络的界面。
作者:阿德里安·科尔