Hai công cụ kiểm tra khả năng hiển thị trên AI có thể đọc cùng một tập câu trả lời trong cùng một ngày và đưa ra hai kết luận trái ngược. Một công cụ trả về số lượng trích dẫn, công cụ kia không trả về gì, vì câu trả lời đã nêu tên thương hiệu của bạn và đề xuất nó mà chưa một lần liên kết tới nó.
Tháng 9 năm 2026, chúng tôi chạy hai mươi prompt trên ba bề mặt AI và ghi lại, trên mỗi câu trả lời, hai tín hiệu: thương hiệu mà câu trả lời nêu tên trong phần văn bản, và tên miền mà câu trả lời trình ra làm nguồn. Đây không phải hai góc nhìn của cùng một phép đo. Chúng tách rời nhau ở những chỗ có thể đoán trước, và chính những chỗ đó là phần hữu ích nhất của báo cáo.
Bản ngắn: Perplexity trích dẫn nguồn ở mọi prompt, Gemini trả về trung vị 47 nguồn mỗi câu trả lời, còn ChatGPT không trả về trích dẫn nào ở 12 trong 20 prompt, nhưng vẫn nêu tên nhà cung cấp ở 13 prompt trong số đó. Dao động giữa các lần chạy trên cùng một bề mặt là vấn đề khác, và chúng tôi đã đo nó trước đây trong dao động giữa các lần chạy của công cụ theo dõi hiển thị trên AI.
Chúng tôi đã chạy những gì
Mục | Cấu hình |
|---|---|
Prompt | Hai mươi câu hỏi mà người mua sẽ đặt về các công cụ hiển thị trên AI |
Bề mặt | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Tìm kiếm web | Bật trên cả ba bề mặt |
Khu vực và ngôn ngữ | Hoa Kỳ, tiếng Anh |
Ngày | 12 tháng 9 năm 2026 |
Câu trả lời thu được | 60 |
Chi phí cả lần chạy | 1,444 đô la, tức 0,024 đô la mỗi câu trả lời |
Lần chạy lặp | Chạy lại đúng năm prompt đó để xem hành vi có ổn định không |
Chi phí mỗi câu trả lời nằm trong khoảng từ 0,006 đô la ở Perplexity đến 0,037 đô la ở Gemini. Bề mặt rẻ nhất cho ra danh sách nguồn nhất quán nhất, và bề mặt đắt nhất không phải là bề mặt trả về nhiều nguồn nhất.
Đo riêng hai tín hiệu
Chúng tôi bắt mỗi câu trả lời hai lần: một lần dưới dạng văn bản, một lần dưới dạng danh sách nguồn mà bề mặt gắn vào đoạn văn bản đó.
Bề mặt | Chú thích nguồn | Mỗi câu trả lời | Câu trả lời không có trích dẫn | Tên miền khác nhau mỗi câu trả lời |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | từ 0 đến 18, trung vị 0 | 12 trên 20 | từ 0 đến 10 |
Gemini 2.5 Flash | 989 | từ 14 đến 122, trung vị 47 | 0 trên 20 | từ 3 đến 23 |
Perplexity | 399 | từ 19 đến 20 | 0 trên 20 | từ 16 đến 20 |
Ba danh sách này không cùng một loại đối tượng, và đây chính là chỗ công cụ kiểm tra sai trước tiên.
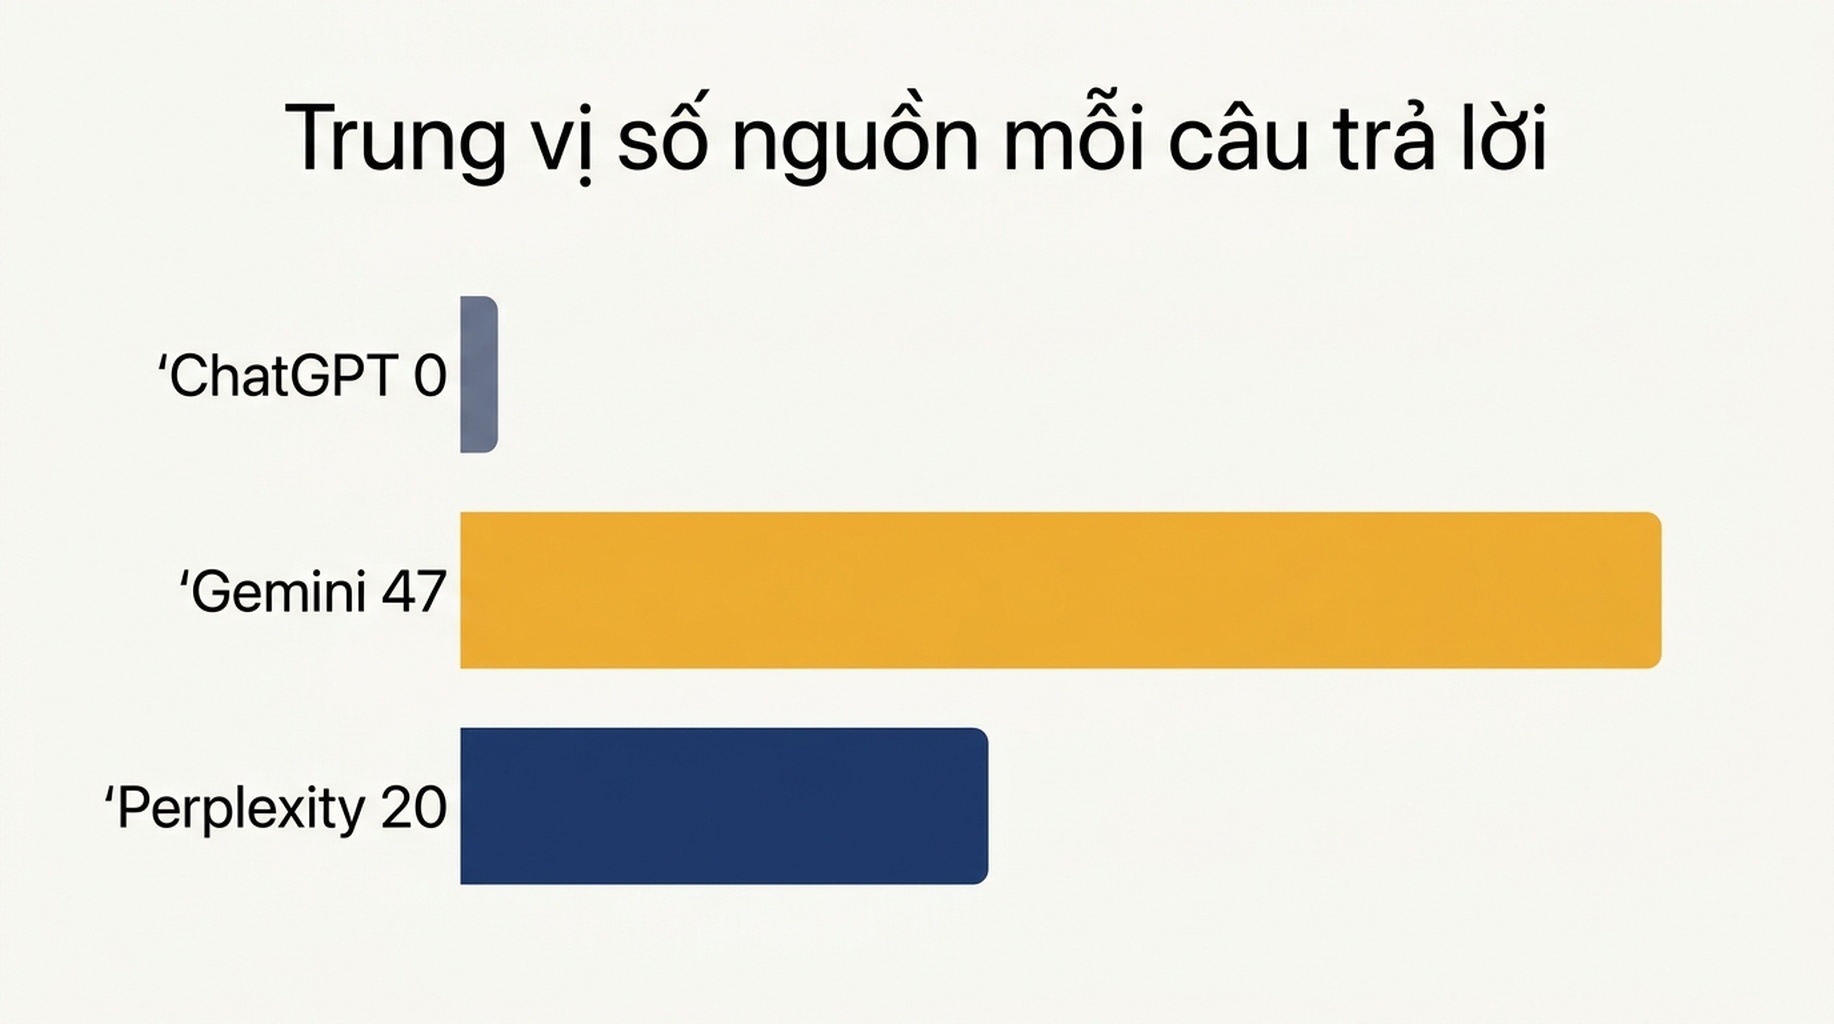
Gemini gắn một nguồn vào gần như mọi khẳng định. Cùng một trang có thể chiếm nhiều vị trí trong một câu trả lời, và đó là lý do các con số cao đến vậy: qua 20 câu trả lời của Gemini, semrush.com chiếm 44 vị trí, maxaeo.ai hai mươi sáu, google.com hai mươi hai, adobe.com hai mươi mốt và medium.com hai mươi. Số chú thích cao trên bề mặt này nói lên mức độ chia nhỏ của mô hình, không nói lên mức độ được biết đến của thương hiệu bạn.
Ngược lại, Perplexity công khai một bảng có trần. Nó trả về đúng hai mươi nguồn ở 19 trong 20 prompt và mười chín nguồn ở prompt thứ hai mươi. Điều đó cố định mẫu số: phần của bạn trong một câu trả lời Perplexity luôn là phần trên hai mươi, nên giành được một vị trí nghĩa là ai đó đã mất một vị trí ở nơi khác.
ChatGPT chỉ trả về danh sách nguồn khi nó đã tìm kiếm. Nó phát một truy vấn tìm kiếm ở 8 trong 20 prompt và không trích dẫn gì ở mười hai prompt còn lại. Ở mười hai prompt đó, nó vẫn trả lời câu hỏi và vẫn nêu tên công cụ. Một ví dụ chưa qua biên tập: khi được hỏi về những công cụ tốt nhất để theo dõi nhắc đến thương hiệu trong kết quả tìm kiếm AI, nó liệt kê Brand24, Mention, BuzzSumo, Talkwalker và Google Alerts mà không gắn nguồn nào cho bất kỳ cái tên nào. Danh sách kiểm tra chúng tôi dùng để rà soát câu trả lời của ChatGPT theo dạng lỗi này nằm trong danh sách kiểm tra hiển thị trên ChatGPT.
Được nêu tên mà không được trích dẫn
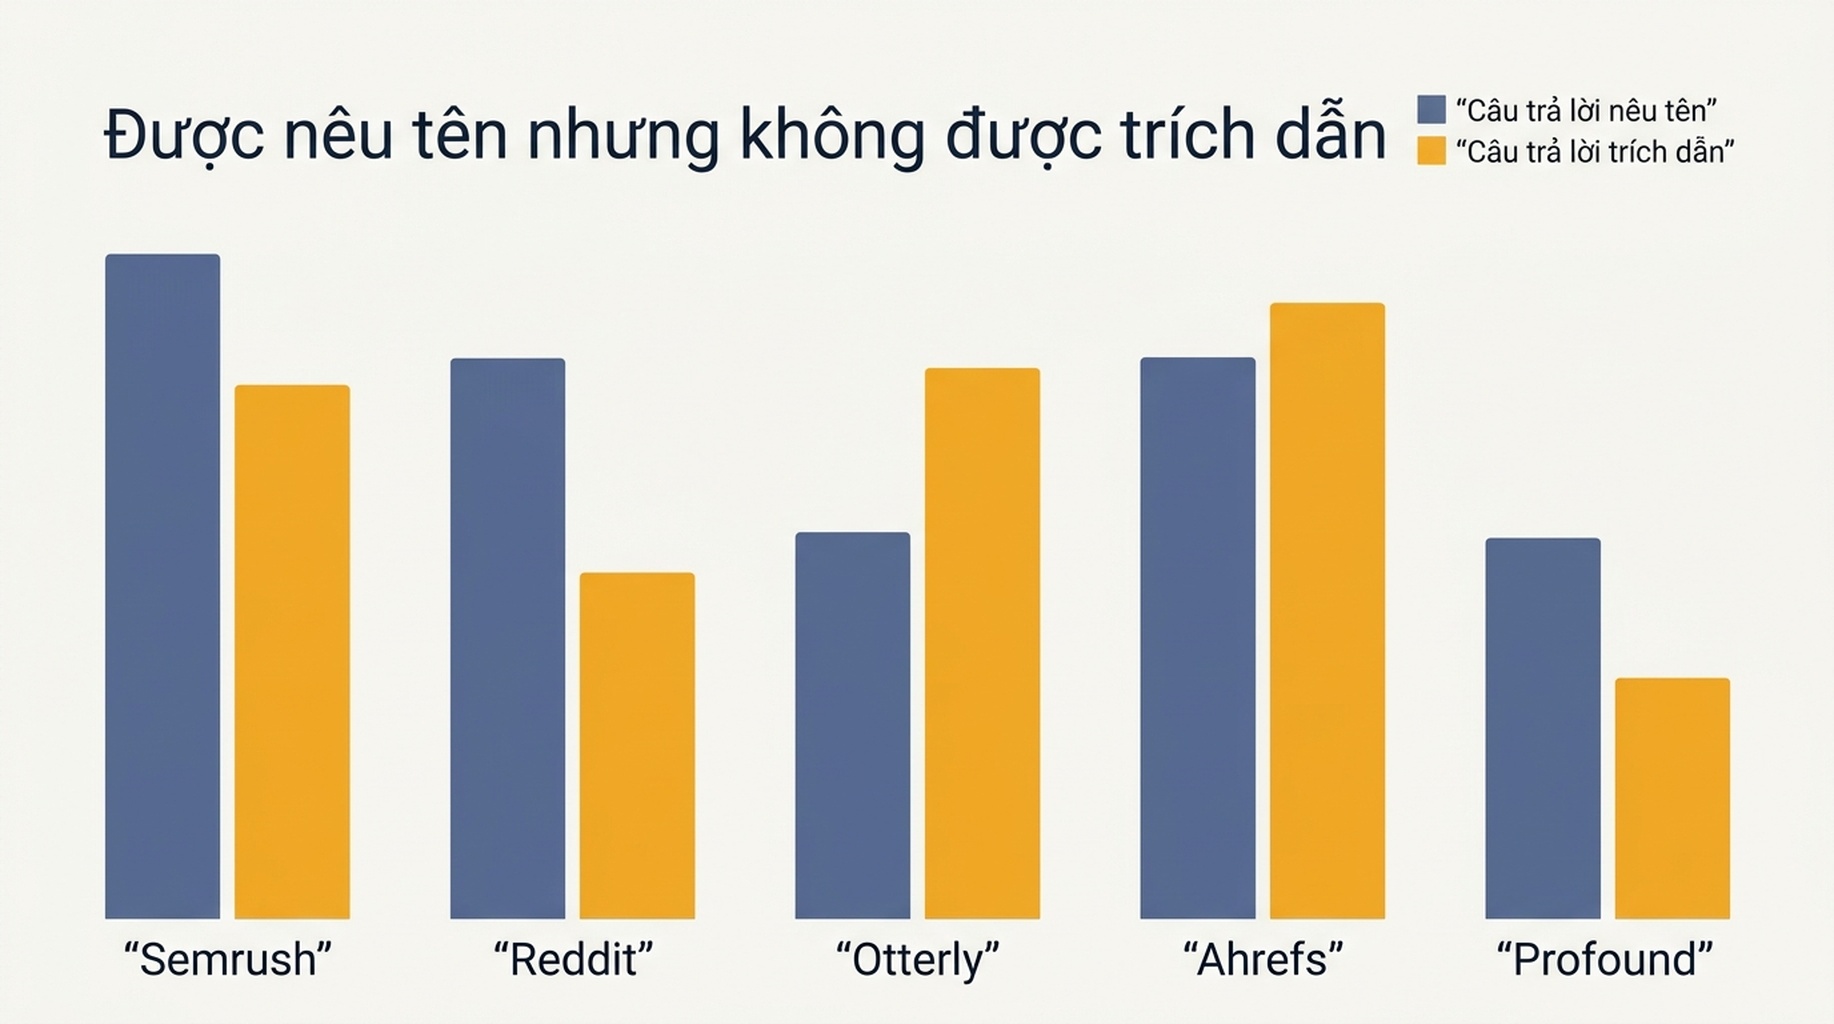
Tiếp theo, với 27 thương hiệu và cơ quan báo chí, chúng tôi đếm xem trong bao nhiêu câu trả lời trong số 60, thương hiệu được nêu tên trong phần văn bản, và trong bao nhiêu câu trả lời, tên miền của nó được trích dẫn làm nguồn. Hai cột lệch nhau theo cả hai hướng cùng lúc.
Thương hiệu | Câu trả lời nêu tên | Câu trả lời trích dẫn tên miền |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
Bảng này có hai kiểu mẫu. Peec AI, Otterly, Profound và ZipTie được đề xuất trong câu trả lời nhiều hơn hẳn so với số lần trang của họ được liên kết. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps và Menra thì ngược lại: trang của họ bị kéo vào làm nguồn trong khi câu trả lời không hề nêu tên công ty. Một công cụ chỉ nhìn vào liên kết sẽ đánh giá nhóm thứ hai là hiển thị và nhóm thứ nhất là vô hình. Một công cụ chỉ nhìn vào nhắc đến sẽ làm ngược lại.
Qua cả 60 câu trả lời, ba bề mặt cùng nhau trích dẫn 432 tên miền khác nhau. ChatGPT chiếm 47 trong số đó, tức 11 phần trăm, Gemini 184 (43 phần trăm) và Perplexity 285 (66 phần trăm). Dù bạn kiểm tra bề mặt nào, bạn cũng đang nhìn một mẫu từ một vũ trụ nguồn lớn hơn nhiều. Con số này không bao gồm bề mặt của chính Google, nơi sự hiện diện được đo bằng cách khác và chúng tôi giải thích trong công cụ theo dõi AI Overview.
Công cụ kiểm tra bắt buộc phải ghi gì
Một công cụ kiểm tra hiển thị chỉ trả về một con số đang vứt đi ba trong bốn trường của nó. Đây là bốn trường đáng giữ lại.
Trường | Hình thức ghi | Vì sao nó đổi kết luận |
|---|---|---|
Bề mặt có tìm kiếm hay không | có hoặc không | Câu trả lời không tìm kiếm thì không thể sinh ra trích dẫn, nên số không của nó không phải tín hiệu hiển thị |
Thương hiệu có được nêu trong phần văn bản không | số câu trả lời | Tín hiệu duy nhất còn sống trên một câu trả lời không có căn cứ |
Tên miền có trong danh sách nguồn không | số câu trả lời | Tín hiệu mà hầu hết công cụ chỉ báo cáo một mình nó |
Mẫu số | số câu trả lời, và số vị trí nguồn mỗi câu trả lời | Một bảng có hai mươi vị trí cố định và một danh sách 47 chú thích không thể so sánh như phần trăm |
Hệ quả thực tế là số không giả. Trong dữ liệu của chúng tôi, 13 trong 20 câu trả lời của ChatGPT nêu tên ít nhất một nhà cung cấp, trong khi chỉ 8 trên 20 trích dẫn bất cứ thứ gì, nghĩa là khoảng một phần tư số câu trả lời trên bề mặt này sẽ báo cáo không trích dẫn cho một thương hiệu mà chính câu trả lời đó đã nêu tên và đề xuất.
Làm việc này mà không tự lừa mình
Kiểu lỗi khi bạn giao việc này cho một tác nhân không phải là một con số sai, mà là một con số đầy tự tin được tính từ một trường chưa bao giờ được thu thập.
- Bắt lấy phần dữ liệu thô trước khi tính bất cứ thứ gì. Giữ lại văn bản câu trả lời, danh sách nguồn, mã định danh mô hình và một giá trị đúng-sai cho biết truy vấn tìm kiếm có được phát đi hay không. Các chỉ số dẫn xuất được dựng trong mã ở bước thứ hai, không đặt vào bên trong prompt thu thập.
- Buộc tác nhân trích dẫn thay vì tóm tắt. Một tiêu chí kiểu "báo cáo thương hiệu xuất hiện bao nhiêu lần" tạo ra văn xuôi. Một tiêu chí kiểu "trả về nguyên văn văn bản câu trả lời và danh sách nguồn" tạo ra dữ liệu bạn kiểm tra lại được.
- Chạy lại đúng prompt đó trước khi tin vào một thay đổi. Chúng tôi lặp năm prompt và quyết định có tìm kiếm hay không khớp ở 5 trên 5, nghĩa là một cú nhảy đột ngột về số trích dẫn nhiều khả năng là phiên bản mô hình hoặc chỉnh sửa prompt hơn là nhiễu.
- Giữ mã định danh mô hình trên mọi dòng. Đúng hai mươi prompt đó trên cùng một điểm cuối qua gpt-4o chỉ trả về chú thích nguồn ở 2 trên 20, so với 8 trên 20 ở gpt-5.
- Dành một khoản ngân sách. Lần chạy trọn vẹn 60 câu trả lời tốn 1,444 đô la, nên với mức giá này, phiên bản hằng tuần của cùng phép kiểm tra rơi vào khoảng 6 đô la một tháng.
Giới hạn
- Một ngày, một khu vực, tiếng Anh, ba bề mặt. Câu trả lời khác nhau giữa các khu vực.
- Một phiên bản mô hình cho mỗi bề mặt. Ngay trong các lần chạy của chúng tôi, hành vi cũng dịch chuyển giữa các phiên bản mô hình.
- Nhận diện thương hiệu là khớp chuỗi theo tên, nên một thương hiệu chỉ được đề xuất bằng tên sản phẩm có thể bị bỏ sót.
- Tìm kiếm web được bật qua API. Các ứng dụng dành cho người dùng có thể tìm kiếm nhiều hơn hoặc ít hơn những lần chạy này.
- Chi phí chỉ bao gồm việc tạo câu trả lời, không gồm thời gian lưu trữ hay rà soát.
Câu hỏi thường gặp
Vì sao ChatGPT báo cáo không trích dẫn ở 12 trong 20 prompt?
Vì nó trả lời những prompt đó mà không tìm kiếm. Một mô hình không bao giờ lấy về một trang thì không thể trích dẫn trang đó. Số không ấy mô tả lần chạy, không mô tả thương hiệu của bạn. Trước khi đọc một con số trích dẫn từ bất kỳ bề mặt trò chuyện nào, hãy kiểm tra trước xem bề mặt đó có thực sự dùng web hay không.
Một nhắc đến có giá trị gì nếu không có liên kết nào?
Trên một câu trả lời không có căn cứ, nó là toàn bộ tín hiệu, và nó cũng là tín hiệu đến trước liên kết. Trong dữ liệu của chúng tôi, nhắc đến và liên kết được giành từ những nguồn khác nhau: nhắc đến đi theo nội dung so sánh và đánh giá, còn trích dẫn đi theo những trang được cấu trúc để được trích dẫn.
Tôi có nên gộp nhắc đến và trích dẫn thành một điểm hiển thị không?
Không. Như bảng thương hiệu cho thấy, hai thứ đó lệch nhau một cách có hệ thống theo cả hai hướng, và một điểm gộp sẽ che mất việc cái nào vừa dịch chuyển. Hãy báo cáo chúng thành hai đường riêng và để người đọc thấy khoảng cách đó.
Nên kiểm tra bề mặt nào trước?
Nếu bạn muốn một bảng ổn định, rẻ và có độ rộng cố định, hãy chọn Perplexity, vì độ dài danh sách của nó không đổi. Nếu bạn muốn độ phủ rộng, hãy chọn Gemini, bề mặt đã chạm tới 184 trong 432 tên miền mà chúng tôi thấy. ChatGPT thì chỉ dùng kèm một phép kiểm tra độ hợp lý, nếu không một phần năm số câu trả lời của nó sẽ bị đọc thành một thương hiệu vô hình.
Góc nhìn của Auspia: hãy báo cáo nhắc đến và trích dẫn thành hai đường riêng biệt, và ghi lại bề mặt có tìm kiếm hay không trước khi ghi bất cứ thứ gì khác. Một điểm hiển thị duy nhất che mất đúng cái khoảng cách cho bạn biết cần sửa gì tiếp theo, và cách sửa rẻ nhất trong dữ liệu của chúng tôi không phải là thêm nội dung, mà là kiểm tra một bề mặt đã thực sự nhìn vào web.
Tác giả: Adrian Cole