שני בודקי נראות ב-AI יכולים לקרוא את אותן תשובות באותו יום ולצאת בשני פסקי דין הפוכים. האחד מחזיר מספר ציטוטים, והשני לא מחזיר דבר, מפני שהתשובה הזכירה את המותג שלך בשמו והמליצה עליו בלי לקשר אליו אפילו פעם אחת.
בספטמבר 2026 הרצנו עשרים פרומפטים על פני שלושה משטחי AI, ותיעדנו בכל תשובה שני אותות: המותג שהתשובה נקבה בשמו בגוף הטקסט, והדומיין שהתשובה הציגה כמקור. שני האותות האלה אינם שתי זוויות של מדידה אחת. הם נפרדים במקומות שאפשר לחזות, והמקומות שנפרדים בהם הם החלק השימושי ביותר בדוח.
הגרסה הקצרה: Perplexity ציטט מקורות בכל פרומפט, Gemini החזיר חציון של 47 מקורות לתשובה, ואילו ChatGPT לא החזיר שום ציטוט ב-12 מתוך 20 פרומפטים, ובכל זאת נקב בשמות ספקים ב-13 מהם. תנודתיות בין הרצות על משטח בודד היא שאלה אחרת, ואת זו מדדנו קודם בתנודתיות ההרצה של גשש הנראות ב-AI.
מה הרצנו
פריט | הגדרה |
|---|---|
פרומפטים | עשרים שאלות שקונה היה שואל על כלי נראות ב-AI |
משטחים | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
חיפוש ברשת | פעיל בשלושת המשטחים |
אזור ושפה | ארצות הברית, אנגלית |
תאריך | 12 בספטמבר 2026 |
תשובות שנאספו | 60 |
עלות ההרצה כולה | 1,444 דולר, כלומר 0.024 דולר לתשובה |
הרצה חוזרת | הרצנו מחדש את אותם חמישה פרומפטים כדי לראות אם ההתנהגות יציבה |
עלות התשובה נעה בין 0.006 דולר ב-Perplexity ל-0.037 דולר ב-Gemini. המשטח הזול ביותר הוא שהפיק את רשימת המקורות העקבית ביותר, והמשטח היקר ביותר לא היה זה שהחזיר הכי הרבה מקורות.
שני האותות, נמדדים בנפרד
לכדנו כל תשובה פעמיים: פעם כטקסט, ופעם כרשימת המקורות שהמשטח הצמיד לאותו טקסט.
משטח | תגי מקור | לתשובה | תשובות בלי ציטוט | דומיינים שונים לתשובה |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | 0 עד 18, חציון 0 | 12 מתוך 20 | 0 עד 10 |
Gemini 2.5 Flash | 989 | 14 עד 122, חציון 47 | 0 מתוך 20 | 3 עד 23 |
Perplexity | 399 | 19 עד 20 | 0 מתוך 20 | 16 עד 20 |
שלוש הרשימות האלה אינן אותו סוג של אובייקט, וכאן הבודק טועה קודם כל.
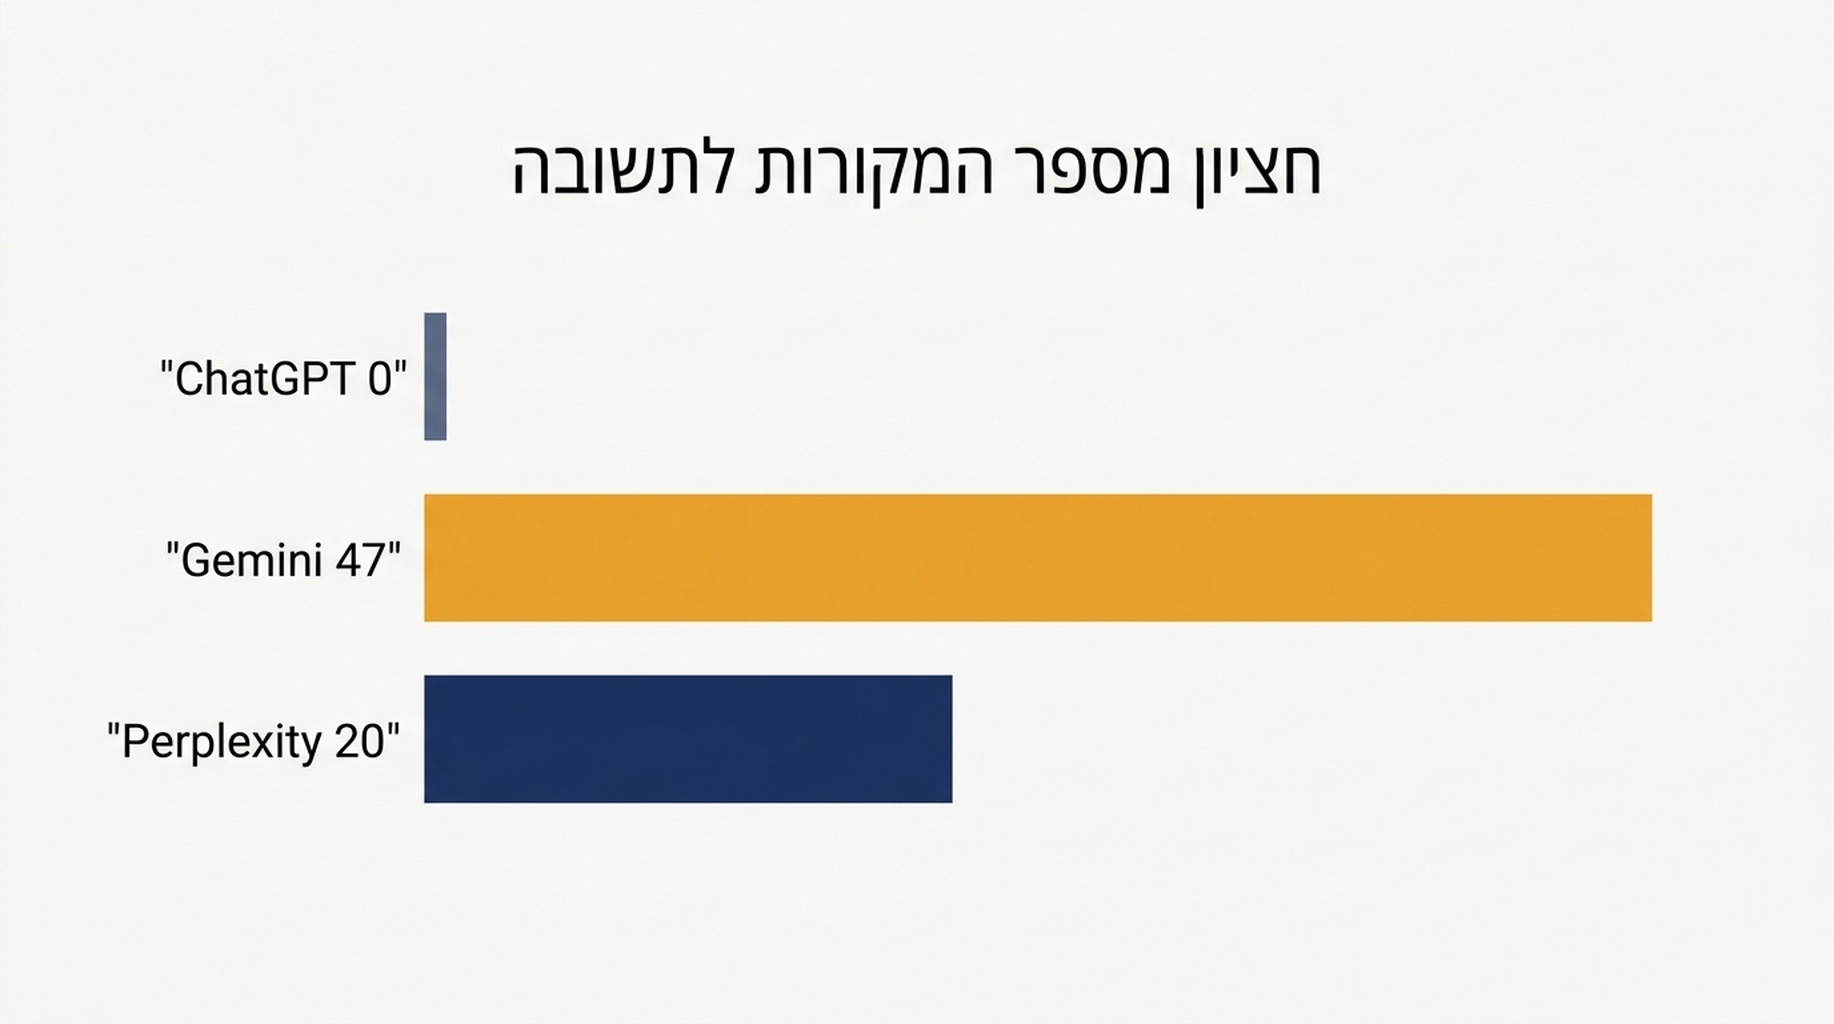
Gemini מצרף מקור כמעט לכל טענה. אותו עמוד יכול לתפוס מקומות רבים בתוך תשובה אחת, ולכן המספרים גבוהים כל כך: על פני 20 תשובות של Gemini, semrush.com תפס 44 מקומות, maxaeo.ai עשרים ושישה, google.com עשרים ושניים, adobe.com עשרים ואחד, ו-medium.com עשרים. מספר תגים גבוה במשטח הזה אומר משהו על המידה שבה המודל מפרק את הדברים, לא על כמה המותג שלך מוכר.
Perplexity חושף לוח עם תקרה. הוא החזיר בדיוק עשרים מקורות ב-19 מתוך 20 פרומפטים, ותשעה עשר בפרומפט העשרים. זה קובע את המכנה: החלק שלך בתשובת Perplexity הוא תמיד חלק מתוך עשרים, כך שהשגת מקום אחד פירושה שמישהו אחר איבד מקום במקום אחר.
ChatGPT מחזיר רשימת מקורות רק כשחיפש. הוא שלח שאילתת חיפוש ב-8 מתוך 20 פרומפטים, ובשנים עשר הנותרים לא ציטט דבר. גם בשנים עשר האלה הוא השיב לשאלה וציין כלים. דוגמה אחת בלי עריכה: כשנשאל על הכלים הטובים ביותר למעקב אחר אזכורי מותג בתוצאות חיפוש AI, הוא פירט Brand24, Mention, BuzzSumo, Talkwalker ו-Google Alerts, ובלי שום מקור מצורף לאף אחד מהם. רשימת הבדיקה שאנחנו משתמשים בה כדי לבקר תשובות של ChatGPT לאיתור דפוס הכשל הזה נמצאת ברשימת הבדיקה לנראות ב-ChatGPT.
נקרא בשמו בלי להיות מצוטט
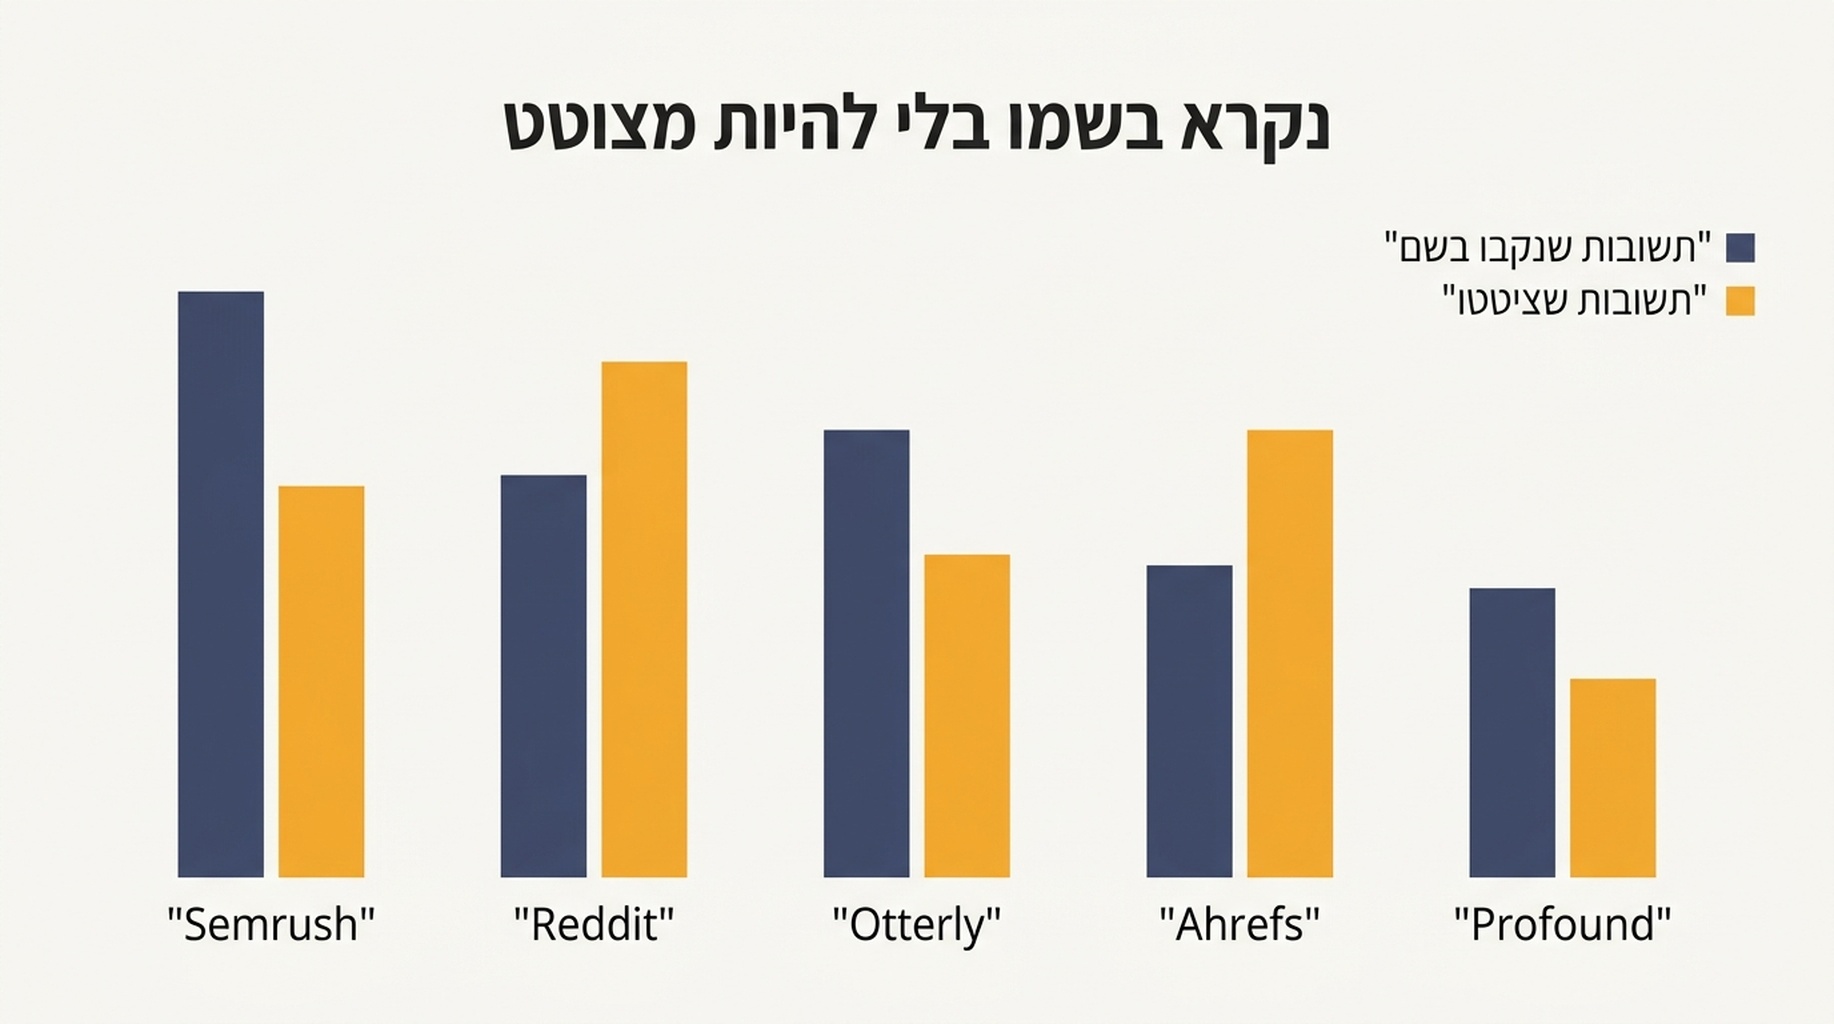
לאחר מכן ספרַנו, על פני 27 מותגים וכלי תקשורת, בכמה מתוך 60 התשובות הוזכר המותג בגוף הטקסט, ובכמה מהן צוטט הדומיין שלו כמקור. שתי העמודות נפרדות בשני הכיוונים גם יחד.
מותג | תשובות שנקבו בשמו | תשובות שציטטו את הדומיין שלו |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
בטבלה הזאת יש שני דפוסים. Peec AI, Otterly, Profound ו-ZipTie מומלצים בתשובות הרבה יותר מכפי שהעמודים שלהם מקושרים. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps ו-Menra הם ההיפך: העמודים שלהם נגררים פנימה כמקורות בזמן שהתשובה מעולם לא נקבה בשם החברה. בודק שמסתכל רק על קישורים ישפוט את הקבוצה השנייה כנראית ואת הראשונה כבלתי נראית. בודק שמסתכל רק על אזכורים יעשה את ההפוך.
על פני כל 60 התשובות, שלושת המשטחים יחד ציטטו 432 דומיינים שונים. 47 מהם של ChatGPT, כלומר 11 אחוז, 184 של Gemini (43 אחוז), ו-285 של Perplexity (66 אחוז). באיזה משטח שתבחר, אתה מסתכל על מדגם מתוך יקום מקורות גדול בהרבה. זה לא כולל את המשטח של Google עצמו, ששם הנוכחות נמדדת אחרת ומוסברת בגשש ה-AI Overview שלנו.
מה בודק חייב לתעד
בודק נראות שמחזיר מספר אחד בלבד זורק שלושה מארבעת השדות שלו. אלה הארבעה ששווה להשאיר.
שדה | צורת התיעוד | למה זה משנה את פסק הדין |
|---|---|---|
האם המשטח חיפש | כן או לא | תשובה שלא חיפשה לא יכולה לייצר ציטוטים, ולכן האפס שלה אינו אות נראות |
האם המותג הוזכר בגוף התשובה | מספר תשובות | האות היחיד שנשאר בחיים בתשובה בלי ביסוס |
האם הדומיין נמצא ברשימת המקורות | מספר תשובות | האות שרוב הכלים מדווחים עליו לבדו |
המכנה | מספר התשובות, ומספר מקומות המקור בכל תשובה | לוח עם עשרים מקומות קבועים ורשימה עם 47 תגים אינם בני השוואה כאחוזים |
התוצאה המעשית היא אפס כוזב. בנתונים שלנו, 13 מתוך 20 תשובות של ChatGPT נקבו בשם של ספק אחד לפחות, בעוד שרק 8 מתוך 20 ציטטו משהו. כלומר כרבע מתשובות המשטח הזה ידווחו על אפס ציטוטים עבור מותג שאותה תשובה עצמה נקבה בשמו והמליצה עליו.
איך לעשות את זה בלי לרמות את עצמך
דפוס הכשל כשמסירים את העבודה הזאת לסוכן אינו מספר שגוי, אלא מספר בטוח בעצמו שחושב משדה שמעולם לא נאסף.
- לתפוס את המטען הגולמי לפני שמחשבים משהו. לשמור את טקסט התשובה, את רשימת המקורות, את מזהה המודל, ואת הערך הבוליאני של האם נשלחה שאילתת חיפוש. מדדים נגזרים נבנים בקוד בשלב שני, ולא מניחים אותם בתוך פרומפט האיסוף.
- לגרום לסוכן לצטט במקום לסכם. קריטריון של "דווח בכמה פעמים הופיע המותג" מייצר פרוזה. קריטריון של "החזר מילה במילה את טקסט התשובה ואת רשימת המקורות" מייצר נתונים שאפשר לבדוק שוב.
- להריץ מחדש את אותו פרומפט לפני שמאמינים בשינוי. הרצנו שוב חמישה פרומפטים, וההחלטה אם לחפש הייתה זהה ב-5 מתוך 5. כלומר קפיצה פתאומית במספר הציטוטים היא כנראה גרסת מודל או עריכת פרומפט, לא רעש.
- להשאיר את מזהה המודל בכל שורה. אותם עשרים פרומפטים על אותו נקודת קצה דרך gpt-4o החזירו תגי מקור ב-2 מתוך 20 בלבד, לעומת 8 מתוך 20 עם gpt-5.
- להקצות תקציב. ההרצה המלאה של 60 תשובות עלתה 1,444 דולר, כך שבתעריפים האלה גרסה שבועית של אותה בדיקה עומדת על כ-6 דולר בחודש.
מגבלות
- יום אחד, אזור אחד, אנגלית, שלושה משטחים. תשובות נבדלות מאזור לאזור.
- גרסת מודל אחת לכל משטח. גם בהרצות שלנו ההתנהגות זזה בין גרסאות מודל.
- זיהוי מותגים הוא התאמת מחרוזת לפי שם, ולכן מותג שהומלץ רק בשם המוצר שלו עלול להיפספס.
- חיפוש ברשת הופעל דרך ה-API. ייתכן שאפליקציות צרכניות מחפשות יותר מההרצות האלה, או פחות.
- העלות מכסה רק יצירת תשובות, ולא זמן אחסון או סקירה.
שאלות נפוצות
למה ChatGPT דיווח על אפס ציטוטים ב-12 מתוך 20 פרומפטים?
מפני שהוא השיב לאותם פרומפטים בלי לחפש. מודל שאף פעם לא מביא עמוד לא יכול לצטט עמוד. לכן האפס הזה מתאר את ההרצה ולא את המותג שלך. לפני שאתה קורא מספר ציטוטים מכל משטח צ'אט, בדוק קודם אם אותו משטח השתמש בכלל ברשת.
האם לאזכור יש ערך אם אין שום קישור?
בתשובה בלי ביסוס הוא כל האות, והוא גם האות שמגיע לפני הקישור. בנתונים שלנו אזכור וקישור נרכשים ממקורות שונים: אזכור הולך אחרי תוכן השוואתי ותוכן ביקורת, וציטוט הולך אחרי עמודים שמבנה שלהם מאפשר לצטט אותם.
כדאי למזג אזכורים וציטוטים לציון נראות אחד?
לא. כפי שטבלת המותגים מראה, הם נפרדים באופן שיטתי בשני הכיוונים, וציון ממוזג מסתיר איזה מהם זז. דווח עליהם כשני קווים, ותן לקורא לראות את הפער.
באיזה משטח לבדוק קודם?
אם אתה רוצה לוח יציב, זול וברוחב קבוע, בחר ב-Perplexity, מפני שאורך הרשימה שלו לא משתנה. אם אתה רוצה רוחב, בחר ב-Gemini, שהגיע ל-184 מתוך 432 הדומיינים שראינו. את ChatGPT רק עם בדיקת סבירות מצורפת, אחרת חמישית מהתשובות שלו תיקרא כמותג בלתי נראה.
עמדת Auspia: לדווח על אזכורים ועל ציטוטים כשני קווים נפרדים, ולתעד אם המשטח חיפש לפני שמתעדים כל דבר אחר. ציון נראות אחד מסתיר בדיוק את הפער שאומר לך מה לתקן בהמשך, והתיקון הזול ביותר בנתונים שלנו לא היה להוסיף תוכן, אלא לבדוק משטח שבאמת הסתכל על הרשת.
מאת: אדריאן קול