Zwei KI-Sichtbarkeitsprüfer können am selben Tag dieselben Antworten lesen und zu gegensätzlichen Urteilen kommen. Der eine gibt eine Zitationszahl zurück, der andere gar nichts, weil die Antwort deine Marke beim Namen genannt und empfohlen hat, ohne sie ein einziges Mal zu verlinken.
Im September 2026 haben wir zwanzig Prompts über drei KI-Oberflächen laufen lassen und bei jeder Antwort zwei Signale festgehalten: die Marke, die die Antwort im Text nannte, und die Domain, die die Antwort als Quelle auswies. Das sind nicht zwei Blickwinkel auf dieselbe Messung. Sie weichen an vorhersehbaren Stellen voneinander ab, und genau diese Stellen sind der nützlichste Teil des Berichts.
Die Kurzfassung: Perplexity zitierte bei jedem Prompt Quellen, Gemini gab einen Median von 47 Quellen pro Antwort zurück, und ChatGPT gab bei 12 von 20 Prompts überhaupt keine Zitation zurück, nannte aber trotzdem bei 13 davon Anbieter. Die Schwankung zwischen Läufen auf einer einzelnen Oberfläche ist eine andere Frage, und die haben wir vorher in Laufschwankung des KI-Sichtbarkeitstrackers gemessen.
Was wir gefahren haben
Punkt | Einstellung |
|---|---|
Prompts | Zwanzig Fragen, die ein Käufer zu KI-Sichtbarkeitstools stellen würde |
Oberflächen | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Websuche | Auf allen drei Oberflächen aktiviert |
Region und Sprache | Vereinigte Staaten, Englisch |
Datum | 12. September 2026 |
Gesammelte Antworten | 60 |
Kosten des gesamten Laufs | 1.444 Dollar, also 0,024 Dollar pro Antwort |
Wiederholung | Dieselben fünf Prompts erneut gefahren, um zu sehen, ob das Verhalten stabil ist |
Die Kosten pro Antwort lagen zwischen 0,006 Dollar bei Perplexity und 0,037 Dollar bei Gemini. Die günstigste Oberfläche lieferte die konsistenteste Quellenliste, und die teuerste war nicht die, die die meisten Quellen zurückgab.
Die zwei Signale, getrennt gemessen
Wir haben jede Antwort zweimal erfasst: einmal als Text und einmal als die Quellenliste, die die Oberfläche an diesen Text angehängt hat.
Oberfläche | Quellenannotationen | Pro Antwort | Antworten ohne Zitation | Verschiedene Domains pro Antwort |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | 0 bis 18, Median 0 | 12 von 20 | 0 bis 10 |
Gemini 2.5 Flash | 989 | 14 bis 122, Median 47 | 0 von 20 | 3 bis 23 |
Perplexity | 399 | 19 bis 20 | 0 von 20 | 16 bis 20 |
Diese drei Listen sind nicht derselbe Objekttyp, und hier irrt der Prüfer zuerst.
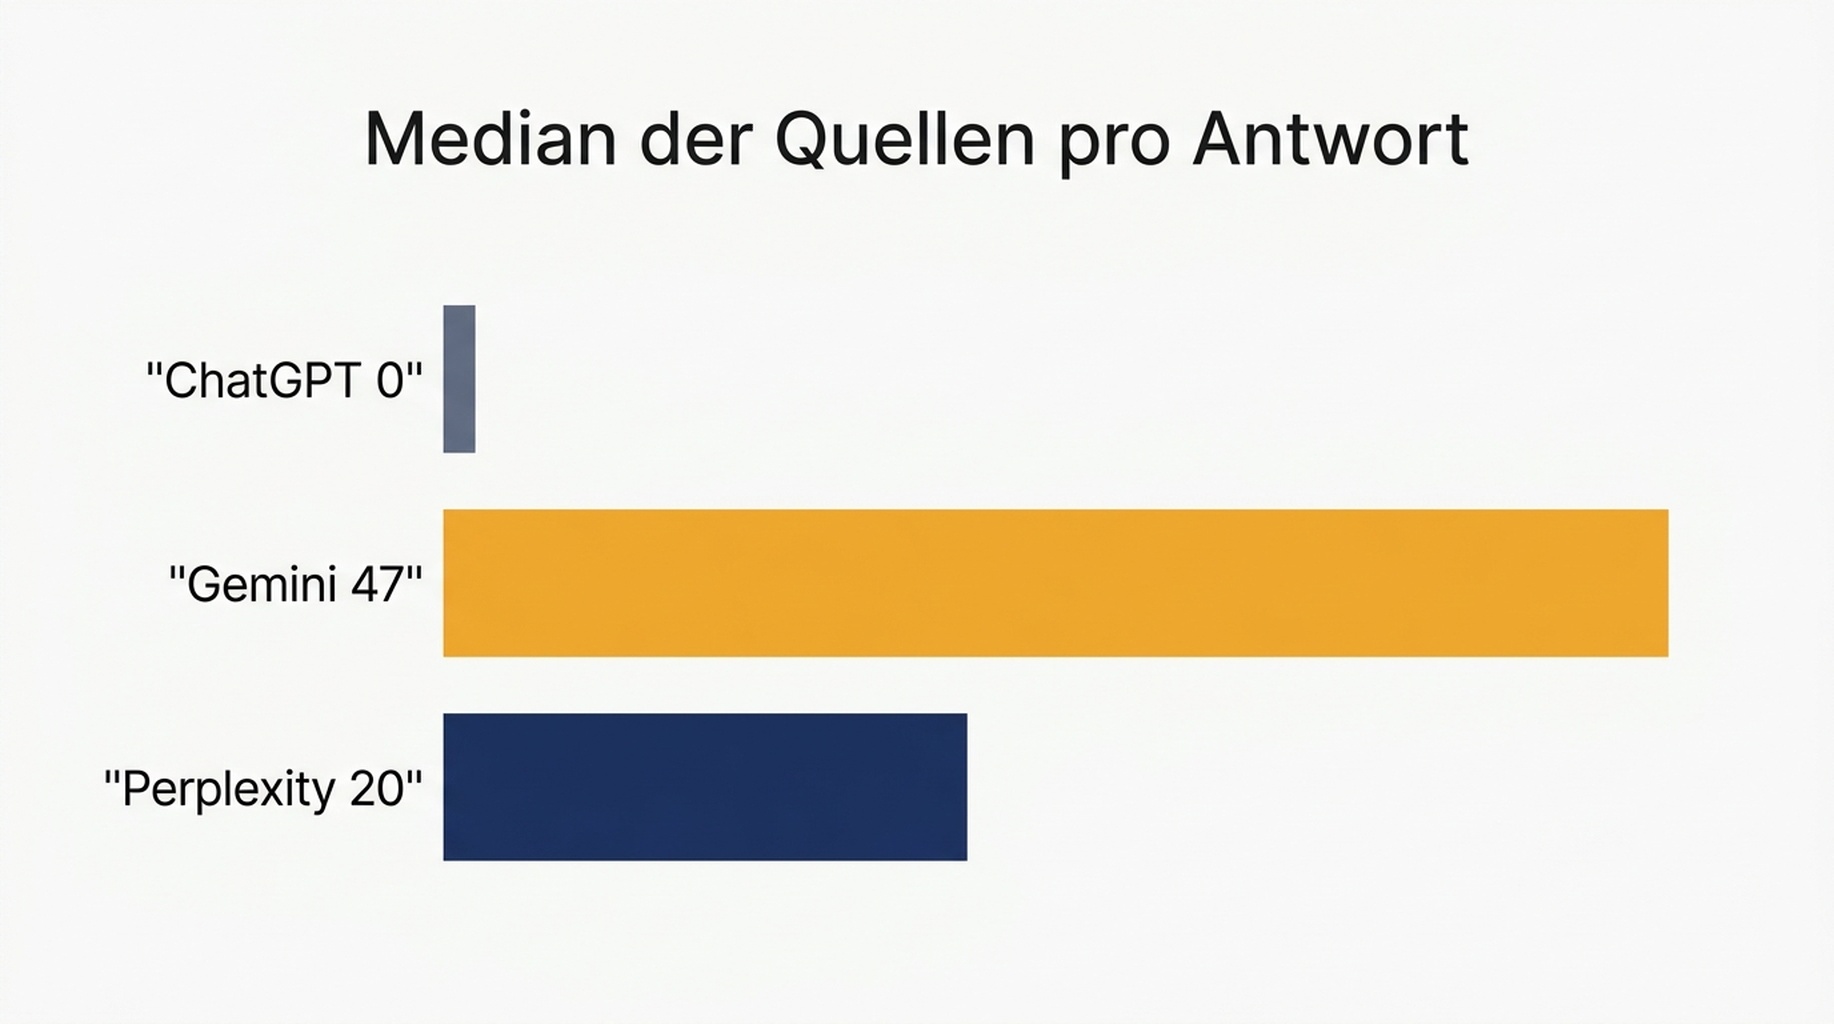
Gemini hängt fast jeder Behauptung eine Quelle an. Dieselbe Seite kann in einer einzigen Antwort viele Plätze belegen, und deshalb sind die Zahlen so hoch: über 20 Gemini-Antworten belegte semrush.com 44 Plätze, maxaeo.ai sechsundzwanzig, google.com zweiundzwanzig, adobe.com einundzwanzig und medium.com zwanzig. Die hohe Annotationszahl auf dieser Oberfläche sagt etwas darüber, wie fein das Modell zerlegt, nicht darüber, wie bekannt deine Marke ist.
Perplexity legt dagegen ein Panel mit Obergrenze offen. Es gab in 19 von 20 Prompts genau zwanzig Quellen zurück und im zwanzigsten neunzehn. Das fixiert den Nenner: Dein Anteil an einer Perplexity-Antwort ist immer ein Anteil von zwanzig, ein gewonnener Platz bedeutet also, dass jemand anderswo einen Platz verloren hat.
ChatGPT gibt eine Quellenliste nur zurück, wenn es gesucht hat. In 8 von 20 Prompts setzte es eine Suchanfrage ab, in den übrigen zwölf zitierte es nichts. Auch in diesen zwölf beantwortete es die Frage und nannte Werkzeuge. Ein unredigiertes Beispiel: Auf die Frage nach den besten Werkzeugen zur Verfolgung von Markennennungen in KI-Suchergebnissen listete es Brand24, Mention, BuzzSumo, Talkwalker und Google Alerts auf, ohne dass an irgendeines eine Quelle angehängt war. Die Checkliste, mit der wir ChatGPT-Antworten auf dieses Fehlermuster prüfen, steht in der Checkliste zur Sichtbarkeit in ChatGPT.
Genannt, ohne zitiert zu werden
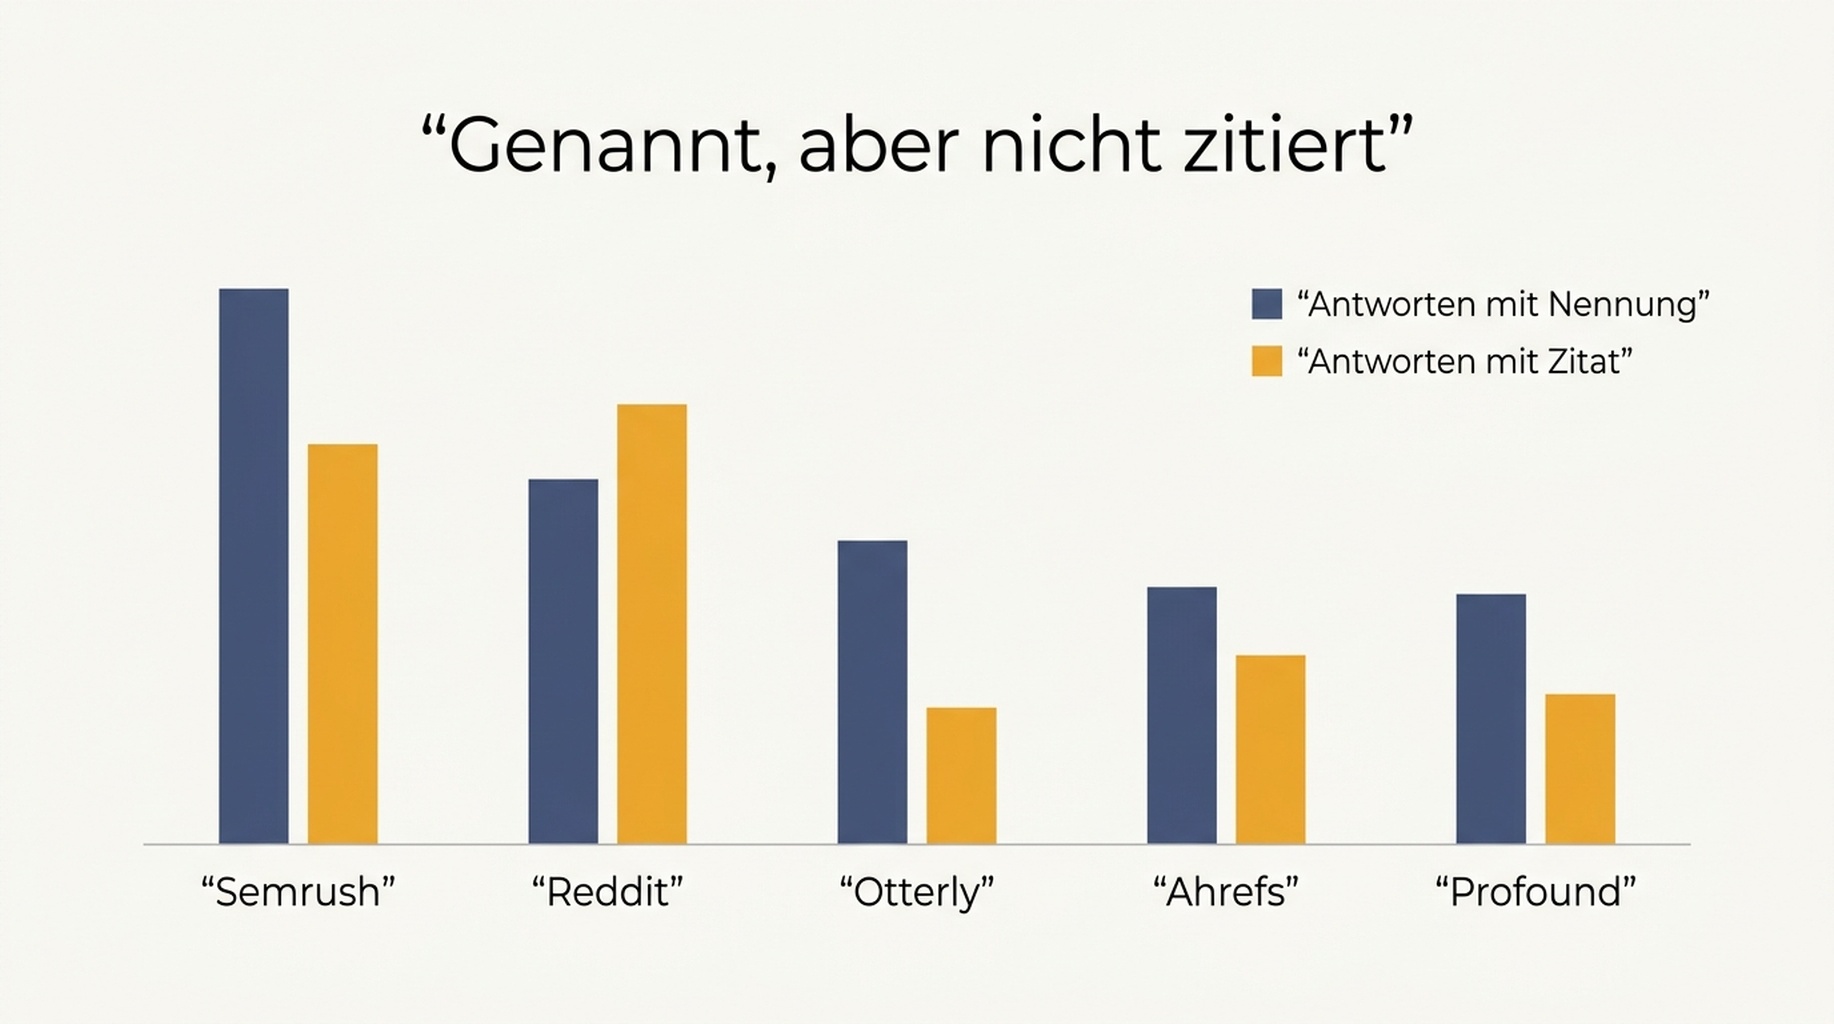
Danach haben wir für 27 Marken und Medien gezählt, in wie vielen der 60 Antworten die Marke im Text genannt und in wie vielen ihre Domain als Quelle zitiert wurde. Die beiden Spalten weichen in beide Richtungen zugleich ab.
Marke | Antworten, die sie nannten | Antworten, die ihre Domain zitierten |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
In dieser Tabelle stecken zwei Muster. Peec AI, Otterly, Profound und ZipTie werden in Antworten deutlich häufiger empfohlen, als ihre Seiten verlinkt werden. Bei MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps und Menra ist es umgekehrt: Ihre Seiten werden als Quellen hereingezogen, während die Antwort nie den Firmennamen nennt. Ein Prüfer, der nur auf Links schaut, hält die zweite Gruppe für sichtbar und die erste für unsichtbar. Ein Prüfer, der nur auf Nennungen schaut, macht es andersherum.
Über alle 60 Antworten hinweg zitierten die drei Oberflächen zusammen 432 verschiedene Domains. Auf ChatGPT entfallen 47 davon, also 11 Prozent, auf Gemini 184 (43 Prozent) und auf Perplexity 285 (66 Prozent). Welche Oberfläche du auch prüfst, du siehst eine Stichprobe aus einem weit größeren Quellenuniversum. Das schließt Googles eigene Oberfläche nicht ein, wo Präsenz anders gemessen wird und was wir im AI-Overview-Tracker erklären.
Was ein Prüfer erfassen muss
Ein Sichtbarkeitsprüfer, der eine einzige Zahl zurückgibt, wirft drei seiner vier Felder weg. Diese vier sind es wert, erhalten zu bleiben.
Feld | Form der Erfassung | Warum es das Urteil ändert |
|---|---|---|
Ob die Oberfläche gesucht hat | ja oder nein | Eine Antwort, die nicht gesucht hat, kann keine Zitationen erzeugen, ihre Null ist also kein Sichtbarkeitssignal |
Ob die Marke im Antworttext genannt wurde | Anzahl der Antworten | Das einzige Signal, das auf einer unbegründeten Antwort überlebt |
Ob die Domain in der Quellenliste steht | Anzahl der Antworten | Das Signal, das die meisten Werkzeuge allein berichten |
Der Nenner | Anzahl der Antworten und Anzahl der Quellenplätze pro Antwort | Ein Panel mit festen zwanzig Plätzen und eine Liste mit 47 Annotationen lassen sich nicht als Prozent vergleichen |
Die praktische Folge ist die falsche Null. In unseren Daten nannten 13 von 20 ChatGPT-Antworten mindestens einen Anbieter, während nur 8 von 20 überhaupt etwas zitierten. Rund ein Viertel der Antworten dieser Oberfläche meldet also null Zitationen für eine Marke, die dieselbe Antwort namentlich genannt und empfohlen hat.
Wie du das machst, ohne dich selbst zu täuschen
Das Fehlmuster, wenn du diese Arbeit an einen Agenten übergibst, ist keine falsche Zahl, sondern eine selbstsichere Zahl, die aus einem nie erhobenen Feld berechnet wurde.
- Sichere die Rohdaten, bevor du irgendetwas berechnest. Behalte den Antworttext, die Quellenliste, die Modellkennung und einen Wahrheitswert darüber, ob eine Suchanfrage abgesetzt wurde. Abgeleitete Kennzahlen entstehen im Code in einem zweiten Schritt und gehören nicht in den Erhebungs-Prompt.
- Lass den Agenten zitieren statt zusammenzufassen. Die Vorgabe „melde, wie oft die Marke vorkam" erzeugt Prosa. Die Vorgabe „gib Antworttext und Quellenliste wörtlich zurück" erzeugt Daten, die du nachprüfen kannst.
- Fahre denselben Prompt erneut, bevor du einer Veränderung glaubst. Wir haben fünf Prompts wiederholt, und die Suchentscheidung stimmte in 5 von 5 Fällen überein. Ein plötzlicher Sprung bei den Zitationen ist also eher eine Modellversion oder eine Prompt-Änderung als Rauschen.
- Behalte die Modellkennung in jeder Zeile. Dieselben zwanzig Prompts am selben Endpunkt über gpt-4o gaben nur in 2 von 20 Fällen Quellenannotationen zurück, gegenüber 8 von 20 bei gpt-5.
- Plane Budget ein. Der komplette Lauf mit 60 Antworten kostete 1.444 Dollar, bei diesen Preisen liegt eine wöchentliche Version derselben Prüfung also bei rund 6 Dollar im Monat.
Grenzen
- Ein Tag, eine Region, Englisch, drei Oberflächen. Antworten unterscheiden sich von Region zu Region.
- Eine Modellversion pro Oberfläche. Auch in unseren eigenen Läufen bewegte sich das Verhalten zwischen Modellversionen.
- Markenerkennung ist ein Namensabgleich auf Zeichenketten, eine Marke, die nur über den Produktnamen empfohlen wurde, kann also übersehen werden.
- Die Websuche wurde über die API aktiviert. Verbraucher-Apps suchen möglicherweise mehr als diese Läufe, oder weniger.
- Die Kosten decken nur die Antworterzeugung ab und enthalten keine Zeit für Speicherung oder Prüfung.
Häufige Fragen
Warum meldete ChatGPT bei 12 von 20 Prompts null Zitationen?
Weil es diese Prompts ohne Suche beantwortet hat. Ein Modell, das nie eine Seite abruft, kann sie nicht zitieren. Diese Null beschreibt also den Lauf und nicht deine Marke. Bevor du eine Zitationszahl von irgendeiner Chat-Oberfläche liest, prüfe zuerst, ob diese Oberfläche überhaupt das Web genutzt hat.
Hat eine Nennung Wert, wenn es keinen Link gibt?
Auf einer unbegründeten Antwort ist sie das gesamte Signal, und sie ist außerdem das Signal, das vor dem Link kommt. In unseren Daten werden Nennung und Link aus verschiedenen Quellen erworben: Die Nennung folgt Vergleichs- und Testinhalten, die Zitation folgt Seiten, die so strukturiert sind, dass man sie zitiert.
Sollte ich Nennungen und Zitationen zu einem Sichtbarkeitswert verschmelzen?
Nein. Wie die Markentabelle zeigt, weichen sie systematisch in beide Richtungen ab, und ein verschmolzener Wert verbirgt, welches von beiden sich bewegt hat. Berichte beide als zwei Linien und lass die Leserschaft die Lücke sehen.
Welche Oberfläche sollte ich zuerst prüfen?
Wenn du ein stabiles, günstiges Panel mit fester Breite willst, nimm Perplexity, weil sich die Länge seiner Liste nicht ändert. Wenn du Breite willst, nimm Gemini, das 184 der 432 Domains erreichte, die wir gesehen haben. ChatGPT nur mit beigelegter Plausibilitätsprüfung, sonst wird ein Fünftel seiner Antworten als unsichtbare Marke gelesen.
Auspia-Sicht: Berichte Nennungen und Zitationen als zwei getrennte Linien und erfasse, ob die Oberfläche gesucht hat, bevor du irgendetwas anderes erfasst. Ein einzelner Sichtbarkeitswert verbirgt genau die Lücke, die dir sagt, was als Nächstes zu reparieren ist, und die günstigste Reparatur in unseren Daten war nicht mehr Inhalt, sondern die Prüfung einer Oberfläche, die tatsächlich ins Web geschaut hat.
Autor: Adrian Cole