Due verificatori di visibilità nell'IA possono leggere le stesse risposte lo stesso giorno e arrivare a verdetti opposti. Uno restituisce un conteggio di citazioni, l'altro non restituisce nulla, perché la risposta ha nominato il tuo brand e l'ha consigliato senza mai collegarlo.
A settembre 2026 abbiamo eseguito venti prompt su tre superfici IA e abbiamo registrato, su ogni risposta, due segnali: il brand che la risposta ha nominato nel testo e il dominio che la risposta ha presentato come fonte. Non sono due angolazioni di una stessa misura. Divergono in punti prevedibili, e quei punti sono la parte più utile del rapporto.
La versione breve: Perplexity ha citato fonti su ogni prompt, Gemini ha restituito una mediana di 47 fonti per risposta e ChatGPT non ha restituito alcuna citazione su 12 dei 20 prompt, pur nominando fornitori su 13 di essi. La variabilità tra esecuzioni su una singola superficie è un'altra questione, e l'abbiamo misurata prima in variabilità di esecuzione del tracker di visibilità nell'IA.
Cosa abbiamo eseguito
Voce | Impostazione |
|---|---|
Prompt | Venti domande che un acquirente porrebbe sugli strumenti di visibilità nell'IA |
Superfici | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Ricerca web | Attiva su tutte e tre le superfici |
Regione e lingua | Stati Uniti, inglese |
Data | 12 settembre 2026 |
Risposte raccolte | 60 |
Costo dell'esecuzione completa | 1,444 dollari, cioè 0,024 dollari per risposta |
Ripetizione | Abbiamo rieseguito gli stessi cinque prompt per vedere se il comportamento è stabile |
Il costo per risposta è andato da 0,006 dollari su Perplexity a 0,037 dollari su Gemini. La superficie meno cara ha prodotto la lista di fonti più coerente, e quella più cara non è stata quella che ha restituito più fonti.
I due segnali, misurati separatamente
Abbiamo catturato ogni risposta due volte: una come testo e una come la lista di fonti che la superficie ha allegato a quel testo.
Superficie | Annotazioni di fonte | Per risposta | Risposte senza citazioni | Domini distinti per risposta |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | da 0 a 18, mediana 0 | 12 su 20 | da 0 a 10 |
Gemini 2.5 Flash | 989 | da 14 a 122, mediana 47 | 0 su 20 | da 3 a 23 |
Perplexity | 399 | da 19 a 20 | 0 su 20 | da 16 a 20 |
Queste tre liste non sono lo stesso tipo di oggetto, ed è qui che il verificatore sbaglia per primo.
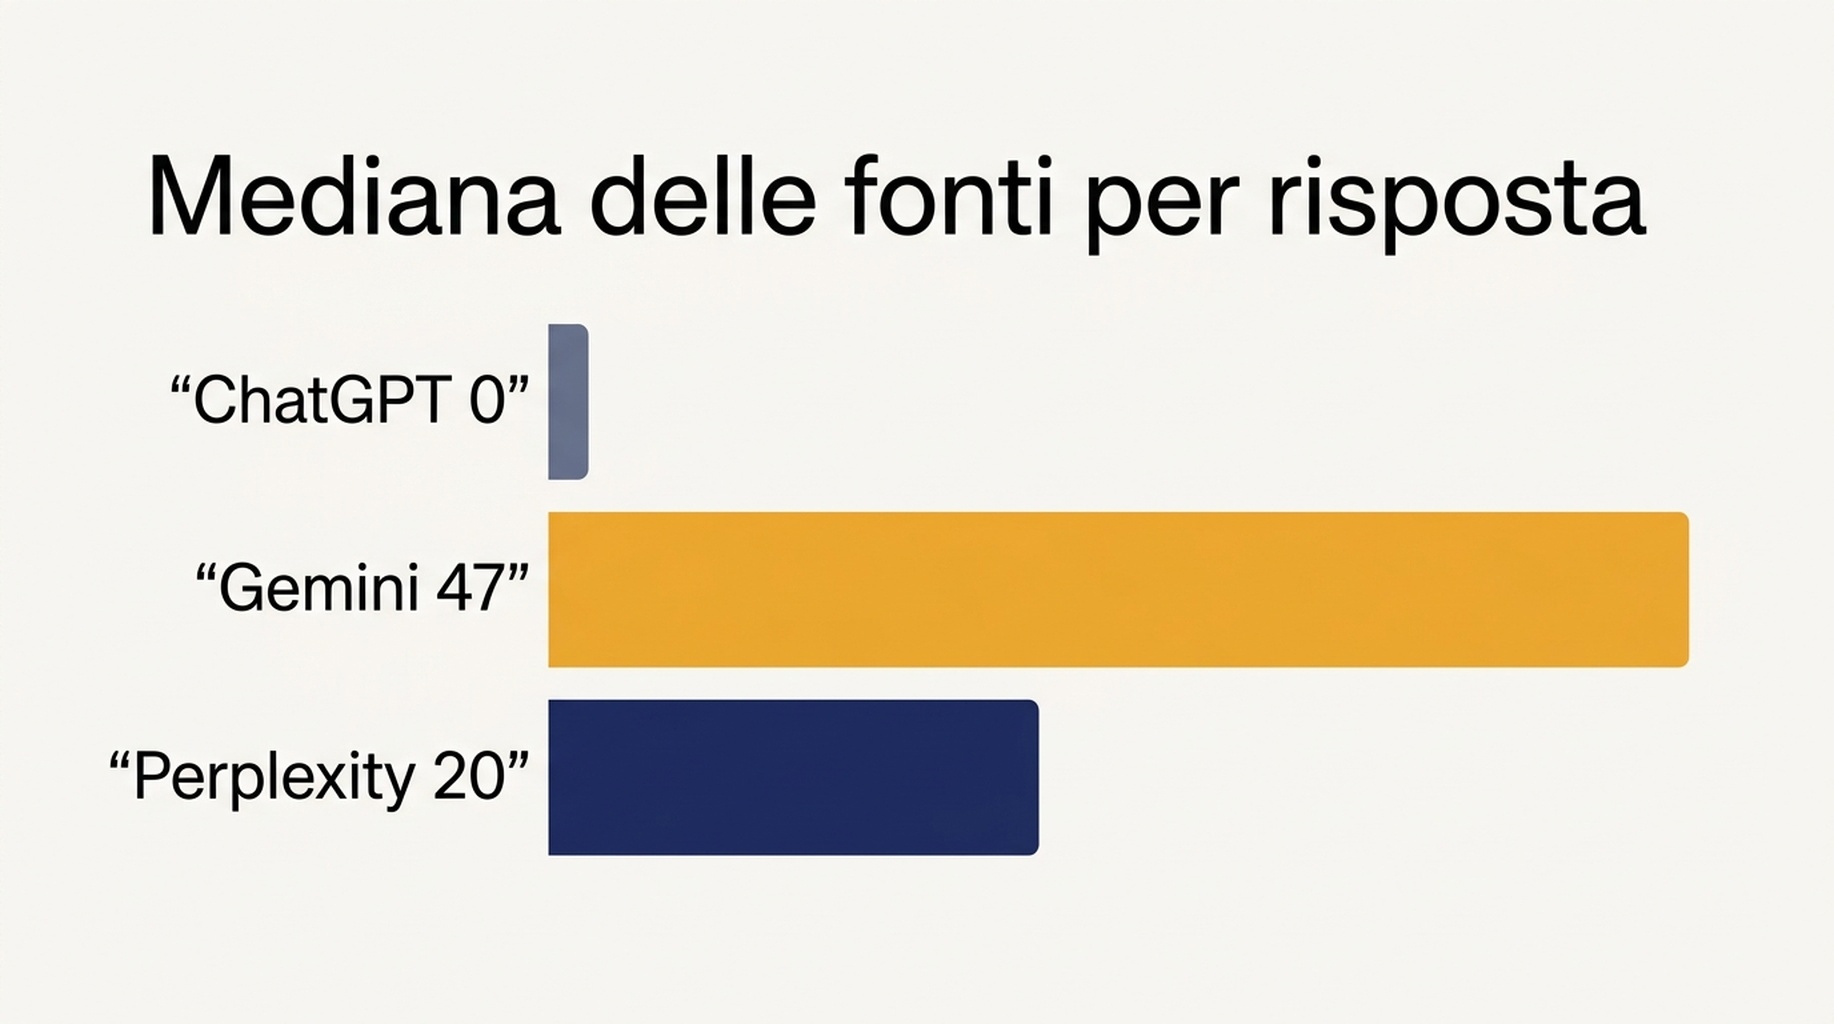
Gemini allega una fonte a quasi ogni affermazione. La stessa pagina può occupare molti slot dentro una sola risposta, ed è per questo che i numeri sono così alti: su 20 risposte di Gemini, semrush.com ha occupato 44 slot, maxaeo.ai ventisei, google.com ventidue, adobe.com ventuno e medium.com venti. L'elevato numero di annotazioni su questa superficie dice quanto finemente il modello scomponga il materiale, non quanto sia conosciuto il tuo brand.
Perplexity, invece, espone un pannello con un tetto. Ha restituito esattamente venti fonti in 19 dei 20 prompt e diciannove nel ventesimo. Questo fissa il denominatore: la tua quota in una risposta di Perplexity è sempre una quota su venti, quindi conquistare uno slot significa che qualcuno ha perso uno slot altrove.
ChatGPT restituisce una lista di fonti solo quando ha cercato. Ha emesso una query di ricerca in 8 dei 20 prompt e non ha citato nulla negli altri dodici. In quei dodici ha comunque risposto alla domanda e ha comunque nominato strumenti. Un esempio non editato: alla domanda sui migliori strumenti per monitorare le menzioni di brand nei risultati di ricerca IA, ha elencato Brand24, Mention, BuzzSumo, Talkwalker e Google Alerts, senza alcuna fonte allegata a nessuno di essi. La checklist che usiamo per verificare le risposte di ChatGPT rispetto a questa modalità di guasto è in checklist di visibilità su ChatGPT.
Nominato senza essere citato
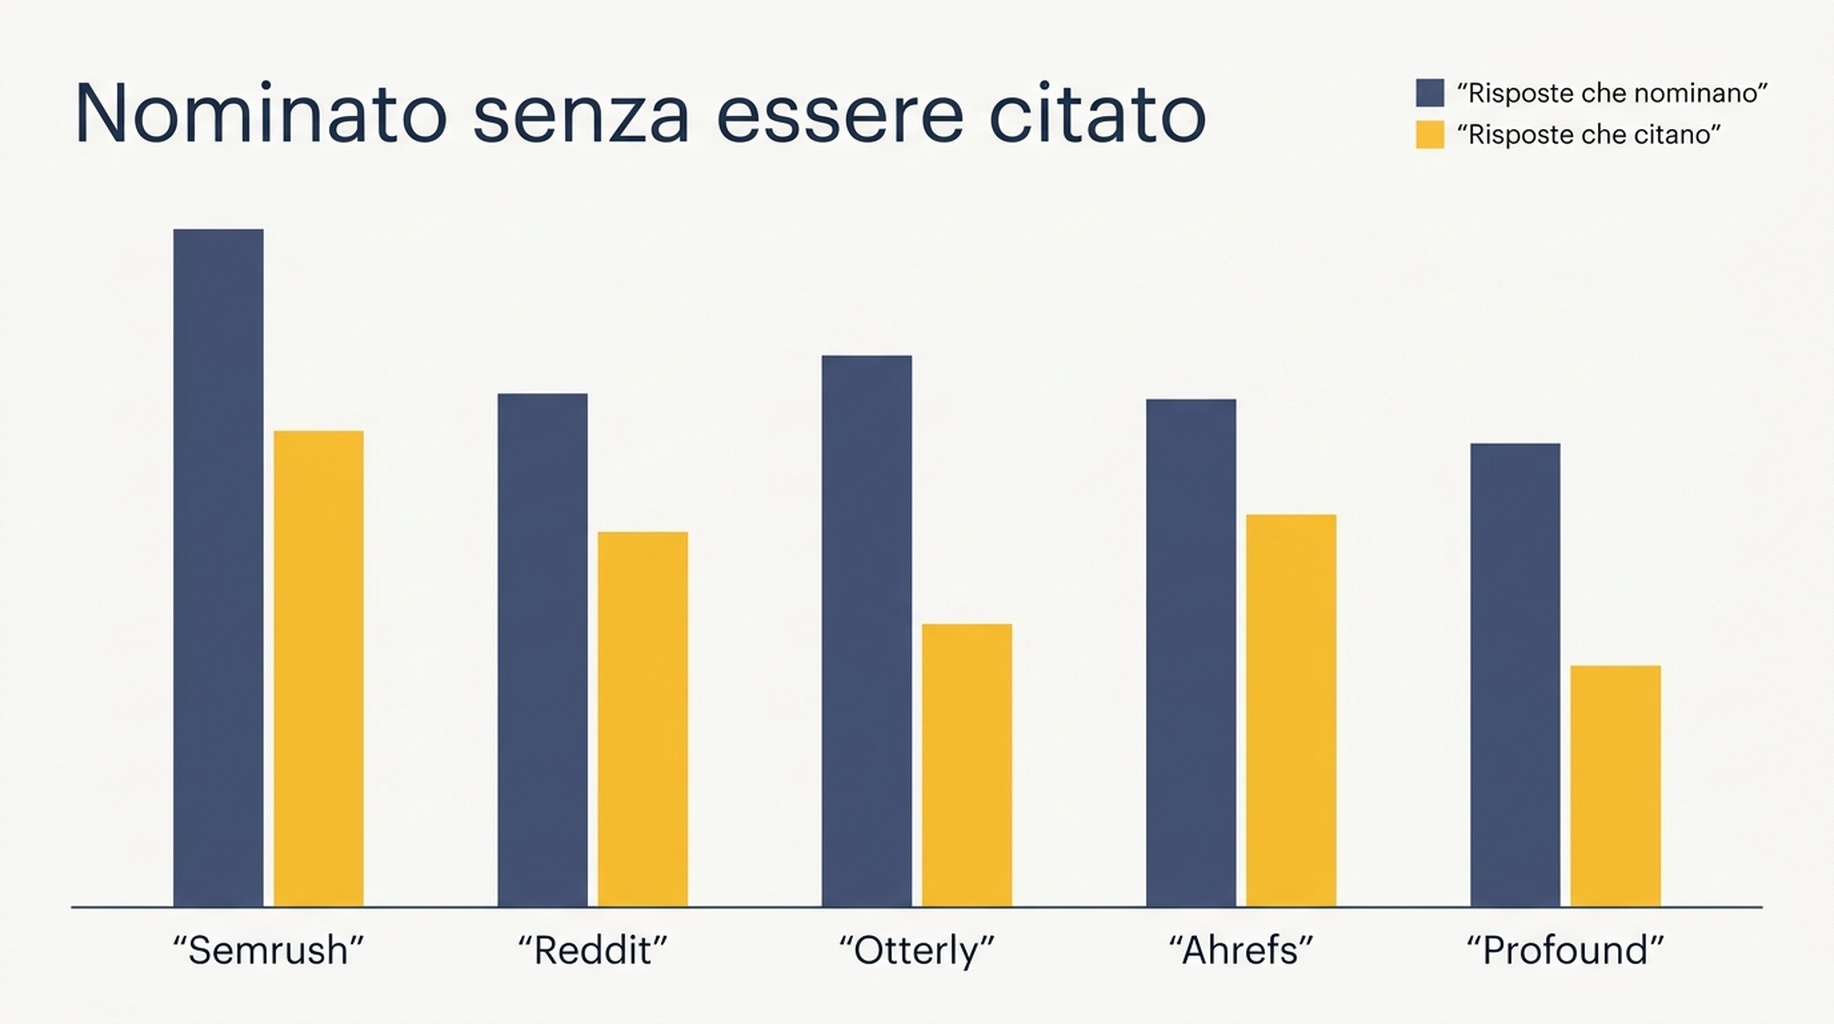
Poi abbiamo contato, per 27 brand e testate, in quante delle 60 risposte il brand è stato nominato nel testo e in quante è stato citato il suo dominio come fonte. Le due colonne divergono in entrambe le direzioni insieme.
Brand | Risposte che l'hanno nominato | Risposte che hanno citato il suo dominio |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
In questa tabella ci sono due schemi. Peec AI, Otterly, Profound e ZipTie vengono consigliati nelle risposte molto più spesso di quanto vengano collegati i loro siti. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps e Menra sono l'opposto: le loro pagine vengono trascinate dentro come fonti mentre la risposta non nomina mai l'azienda. Un verificatore che guarda solo i link giudica il secondo gruppo visibile e il primo invisibile. Un verificatore che guarda solo le menzioni fa il contrario.
Su tutte le 60 risposte, le tre superfici insieme hanno citato 432 domini distinti. ChatGPT ne copre 47, cioè 11 per cento, Gemini 184 (43 per cento) e Perplexity 285 (66 per cento). Qualunque superficie tu verifichi, stai guardando un campione di un universo di fonti molto più grande. Questo non include la superficie di Google stessa, dove la presenza si misura in un altro modo e lo spieghiamo nel tracker di AI Overview.
Cosa deve registrare un verificatore
Un verificatore di visibilità che restituisce un solo numero sta buttando via tre dei suoi quattro campi. Questi sono i quattro che vale la pena tenere.
Campo | Forma di registrazione | Perché cambia il verdetto |
|---|---|---|
Se la superficie ha cercato | sì o no | Una risposta che non ha cercato non può produrre citazioni, quindi il suo zero non è un segnale di visibilità |
Se il brand è stato nominato nel testo della risposta | numero di risposte | L'unico segnale che sopravvive su una risposta senza fondamento |
Se il dominio è nella lista delle fonti | numero di risposte | Il segnale che la maggior parte degli strumenti riporta da solo |
Il denominatore | numero di risposte e numero di slot fonte per risposta | Un pannello con venti slot fissi e una lista con 47 annotazioni non si confrontano come percentuali |
La conseguenza pratica è lo zero falso. Nei nostri dati, 13 delle 20 risposte di ChatGPT hanno nominato almeno un fornitore, mentre solo 8 su 20 hanno citato qualcosa, quindi circa un quarto delle risposte di questa superficie riporterà zero citazioni per un brand che quella stessa risposta ha nominato e consigliato.
Come farlo senza ingannare te stesso
La modalità di guasto quando affidi questo lavoro a un agente non è un numero sbagliato, ma un numero sicuro di sé calcolato da un campo che non è mai stato raccolto.
- Cattura il payload grezzo prima di calcolare qualsiasi cosa. Conserva il testo della risposta, la lista delle fonti, l'identificatore del modello e un valore booleano che dica se è stata emessa una query di ricerca. Le metriche derivate si costruiscono nel codice in una seconda fase, non si mettono dentro il prompt di raccolta.
- Fai citare l'agente invece di fargli riassumere. Un criterio del tipo «riporta quante volte è comparso il brand» produce prosa. Un criterio del tipo «restituisci letteralmente il testo della risposta e la lista delle fonti» produce dati che puoi ricontrollare.
- Riesegui lo stesso prompt prima di credere a un cambiamento. Abbiamo ripetuto cinque prompt e la decisione di cercare coincideva in 5 casi su 5, quindi un balzo improvviso nel numero di citazioni è più probabilmente una versione del modello o una modifica del prompt che rumore.
- Tieni l'identificatore del modello su ogni riga. Gli stessi venti prompt sullo stesso endpoint via gpt-4o hanno restituito annotazioni di fonte solo in 2 casi su 20, contro 8 su 20 con gpt-5.
- Prevedi un budget. L'esecuzione completa di 60 risposte è costata 1,444 dollari, quindi a questi prezzi una versione settimanale della stessa verifica sta intorno ai 6 dollari al mese.
Limiti
- Un giorno, una regione, l'inglese, tre superfici. Le risposte cambiano da regione a regione.
- Una versione di modello per superficie. Anche nelle nostre esecuzioni il comportamento si è spostato tra versioni di modello.
- Il rilevamento dei brand è una corrispondenza di stringhe sul nome, quindi un brand consigliato solo con il nome del prodotto può sfuggire.
- La ricerca web è stata attivata via API. Le app per consumatori possono cercare più di queste esecuzioni, o meno.
- Il costo copre solo la generazione delle risposte e non include il tempo di archiviazione o revisione.
Domande frequenti
Perché ChatGPT ha riportato zero citazioni in 12 dei 20 prompt?
Perché ha risposto a quei prompt senza cercare. Un modello che non recupera mai una pagina non può citarla. Quello zero descrive quindi l'esecuzione, non il tuo brand. Prima di leggere un numero di citazioni da qualsiasi superficie di chat, verifica prima se quella superficie ha usato il web.
Una menzione ha valore se non c'è alcun link?
Su una risposta senza fondamento è tutto il segnale, ed è anche il segnale che arriva prima del link. Nei nostri dati menzione e link si ottengono da fonti diverse: la menzione segue i contenuti comparativi e di recensione, la citazione segue le pagine strutturate per essere citate.
Dovrei fondere menzioni e citazioni in un unico punteggio di visibilità?
No. Come mostra la tabella dei brand, divergono sistematicamente in entrambe le direzioni, e un punteggio fuso nasconde quale dei due si è mosso. Riportali come due linee e lascia che il lettore veda lo scarto.
Quale superficie dovrei verificare per prima?
Se vuoi un pannello stabile, economico e a larghezza fissa, scegli Perplexity, perché la lunghezza della sua lista non cambia. Se vuoi ampiezza, scegli Gemini, che ha raggiunto 184 dei 432 domini che abbiamo visto. ChatGPT solo con un controllo di plausibilità accanto, altrimenti un quinto delle sue risposte si leggerà come brand invisibile.
Vista Auspia: riporta menzioni e citazioni come due linee separate e registra se la superficie ha cercato prima di registrare qualunque altra cosa. Un punteggio unico di visibilità nasconde esattamente lo scarto che ti dice cosa sistemare dopo, e la correzione più economica nei nostri dati non è stata aggiungere contenuti, ma verificare una superficie che ha davvero guardato il web.
Scritto da: Adrian Cole