說自己在做「代理式 SEO」的團隊,大多數其實只是在對話視窗裡貼了一段很長的提示詞。第一次跑還行。到第二次就出問題了:輸出結構變了,資料還是一週前的,而且沒人分得清是數字動了,還是提示詞飄了。
真正能長期跑下去的版本,只在一個地方不同:方法寫在檔案裡,而不是寫在你的訊息裡。流程寫一次,交給代理,之後不管你有沒有記得要求,同一套檢查每次都會執行。
這就是全部的思路。下面是具體怎麼搭、哪個任務該交給哪個代理,以及它會在哪裡悄悄壞掉。
「代理化」到底改變了什麼
可以自動化的東西有三種,而它們並不是同一件事。
工作流自動化 | AI 輔助 SEO | 代理式 SEO | |
|---|---|---|---|
誰決定步驟 | 你事先決定 | 你每次對話決定 | 你一次性以書面方法決定 |
資料來自哪裡 | 預先接好的整合 | 你貼進去的東西 | 代理自己去取 |
遇到意外輸入時 | 直接壞掉 | 看你的措辭 | 按既定規則處理,或往上呈報 |
每次執行的一致性 | 完美但死板 | 低 | 高,同時還能適應 |
最適合的情境 | 大批量、不變的任務 | 探索和一次性問題 | 需要判斷的重複性分析 |
實際差別體現在你不再做的事情上。在對話式工作流裡,你要一遍遍重新解釋網站、受眾、優先順序規則和輸出格式。每解釋一次,就多一次漏掉某項的機會。在代理式工作流裡,這些東西都在代理每次都會讀取的檔案裡,提示詞縮短成一句話:跑一下 9 月的內容衰退檢查。
代價也是真實存在的。如果這個任務每次真的都不一樣,那就沒有可寫下來的方法,搭建它只是沒有回報的負擔。檢查 5 萬個 URL 的狀態碼是腳本的活,不是代理的活。分界線在於:這個任務是否會重複,以及是否需要判斷。兩條都成立,代理式就贏。有一條不成立,就別折騰。
四個層次,以及各自的作用
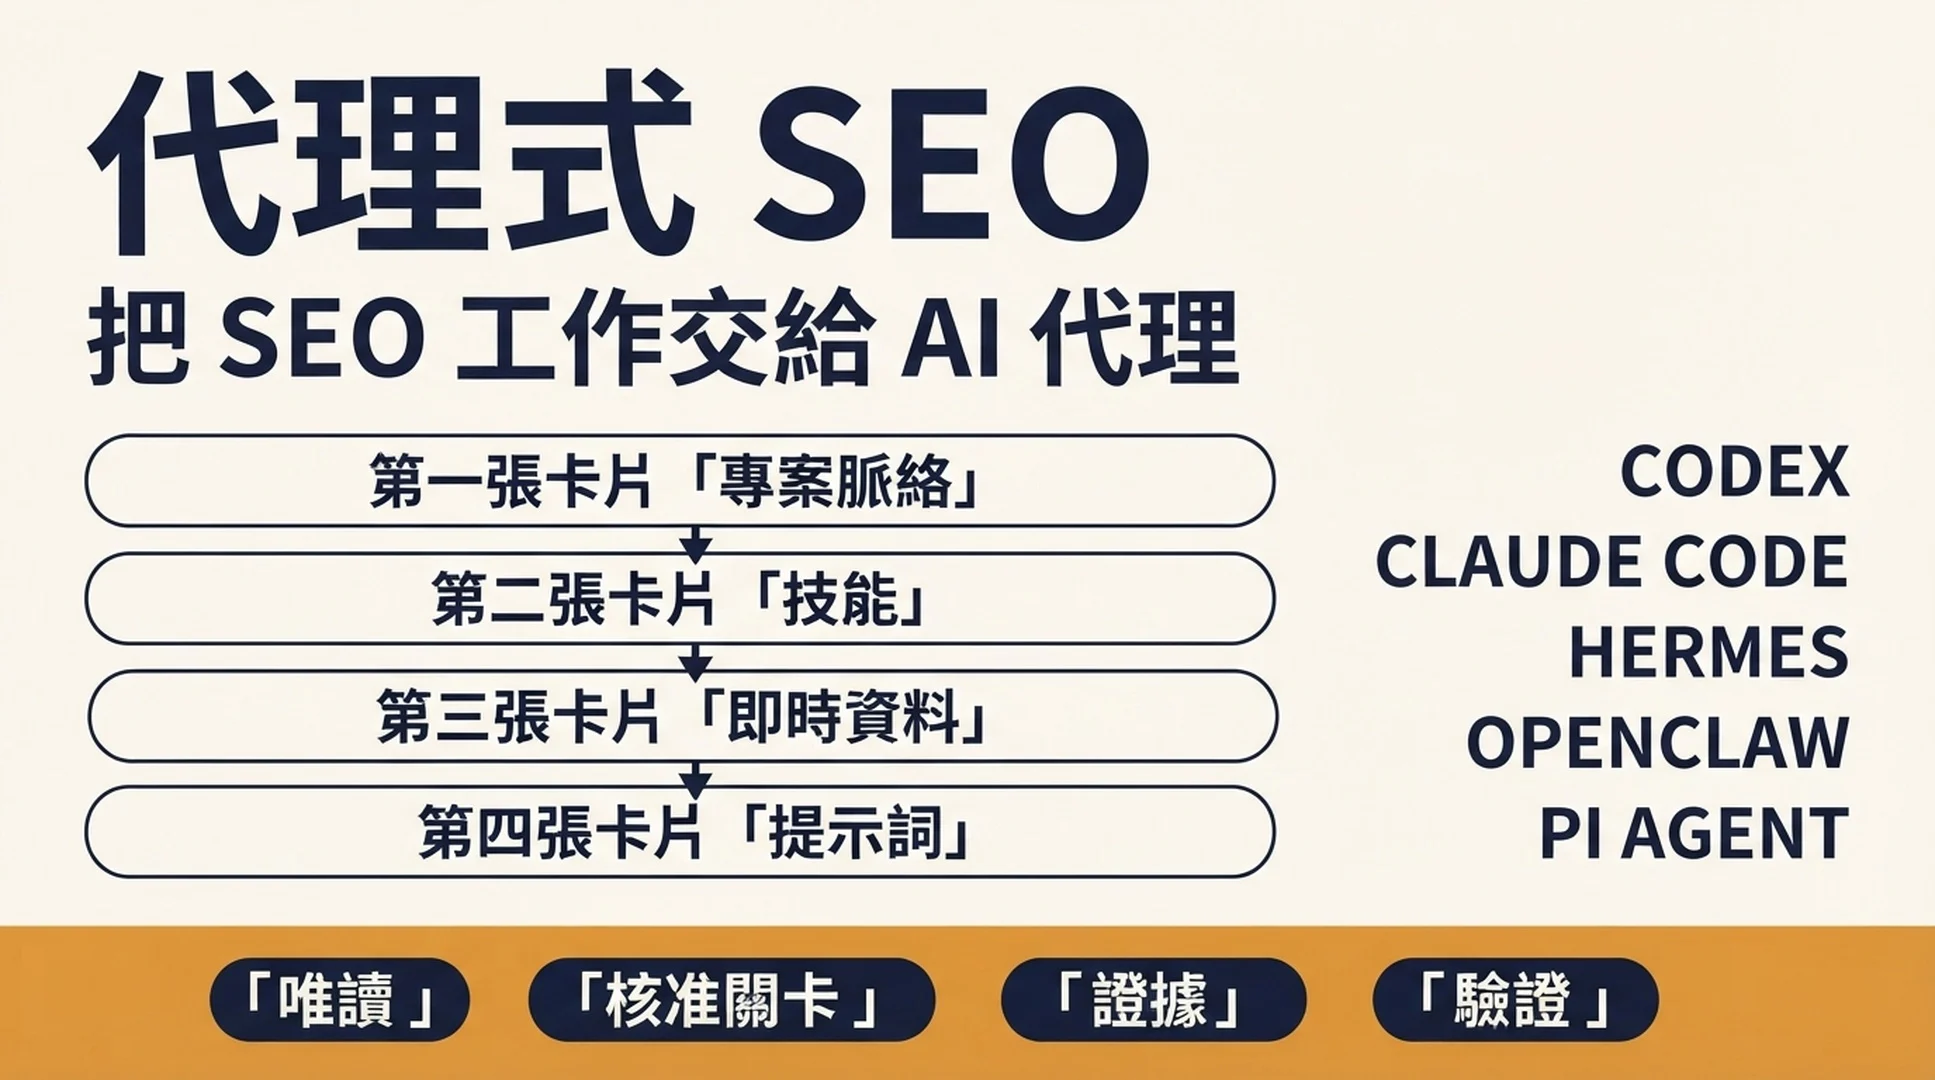
能活下來的代理式 SEO 配置,永遠由同樣四個部件組成。少一個,就會出現特定形式的失敗。
專案脈絡。一個存放不變內容的資料夾:網站、服務市場、誰為什麼買、什麼算轉換、真正的競爭對手是誰、編輯規則。它阻止代理在不理解業務的情況下寫出泛泛之談。跳過這一層,你會得到自信、合理、但毫無用處的輸出。
技能。寫下來的流程。每一個都說明:什麼時候用、需要什麼資料、步驟順序、評分規則、輸出格式,以及哪些操作需要你核准。讓工作流可重現的就是這一層,而大多數團隊跳過的也是這一層。
即時資料接入。讓代理自己去取當前數字,而不是等你匯出再貼上。看自己的表現用 Search Console。看行為資料用分析工具。看自己站點看不到的部分用排名或 SERP 資料源。看頁面級事實用爬蟲或 CMS 連接。沒有這一層,你只是得到一個拿著上個月表格幹活的優秀分析師。
提示詞。本次任務,僅此而已。如果你的提示詞在承載脈絡或方法,那它們屬於第一層和第二層。
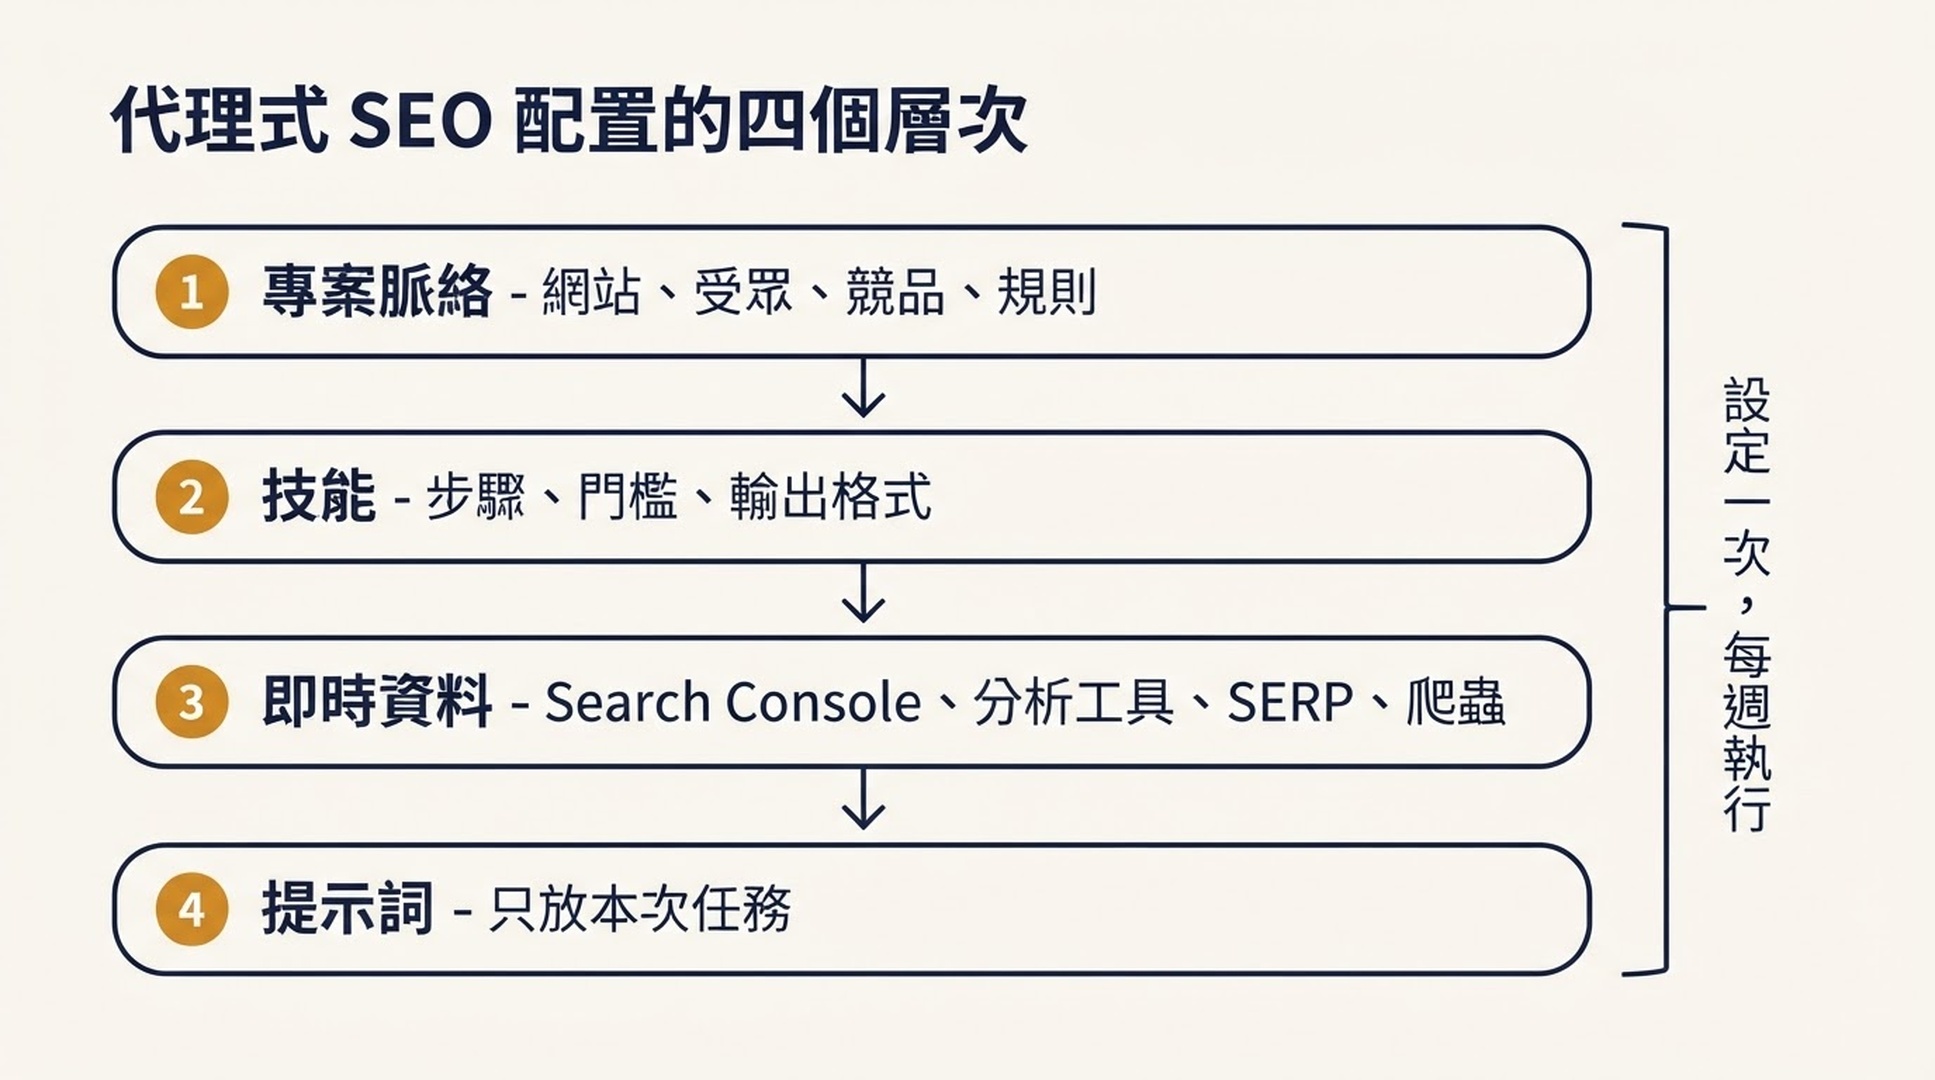
四個層次設定一次,每週的執行就只剩一行。結果不對時,先查是哪一層出了問題,再去改提示詞。
Auspia 的觀點: 四層模型是這個領域裡最有用的概念,同時也是大多數團隊過早停下的地方。他們建了脈絡資料夾,跳過了技能,最後得到一個消息靈通的聊天機器人。真正的產品是技能。其餘都是管路。
哪個任務交給哪個代理
這是我們被問得最多的問題,而誠實的回答是:差異沒有配置差異那麼重要。只要使勁推,下面這些幾乎都能做大部分 SEO 工作。真正拉開差距的,是各自「最不彆扭」的地方,而這決定了三週後你還在不在用它。
代理 | 最擅長 | 接入方式 | 合適的第一個 SEO 任務 |
|---|---|---|---|
Codex | 程式碼倉庫工作、定時執行、可審查的改動 | 本機檔案、終端機、git、自動化 | 把每週快照存進倉庫,並開一個帶報告的拉取請求 |
Claude Code | 依據明確書面策略做長脈絡審查 | 終端機、專案記憶檔案、MCP 連接 | 讀取 Search Console 匯出和頁面原始碼,給出有依據的判定 |
Hermes Agent | 跨工作階段記憶的可重複技能 | 帶技能體系和持久記憶的開源代理 | 裝一個技能,按同樣的節奏跑同樣的工作流 |
OpenClaw | 在嚴格權限下採集瀏覽器證據 | 瀏覽器優先,其次本機檔案 | 採集行動裝置搜尋實際回傳什麼,然後停下 |
Pi Agent | 幾個月後依然小巧、可預測 | 極簡核心,Markdown 技能作為擴充點 | 在你想稽核它全部能力時,跑一個範圍窄、可讀性強的流程 |
兩點提醒。這個領域每月都在變,所以讓團隊選定一個之前,先去各家官方文件核對目前的限制和價格。另外這張表是起點,不是上限。
每種代理的新手安全版入門方法,我們都單獨寫了指南:Codex、Claude Code、Hermes Agent、OpenClaw。四個的形態一樣:先唯讀,一次只核准一個改動,上線前先驗證。
實際的選擇規則取決於你的工作現在在哪裡。網站放在 git 倉庫裡、頁面改動就是程式碼改動,那就從 Codex 或 Claude Code 開始。工作主要是匯出、對話和判斷,那就從基於技能的代理開始。你需要看到真實瀏覽器回傳什麼,那就需要瀏覽器接入和嚴格的權限邊界。你想要一個能一口氣從頭讀到尾的最小表面,Pi Agent 的極簡核心正是為此設計,代價是你需要的東西都得自己加進技能裡。
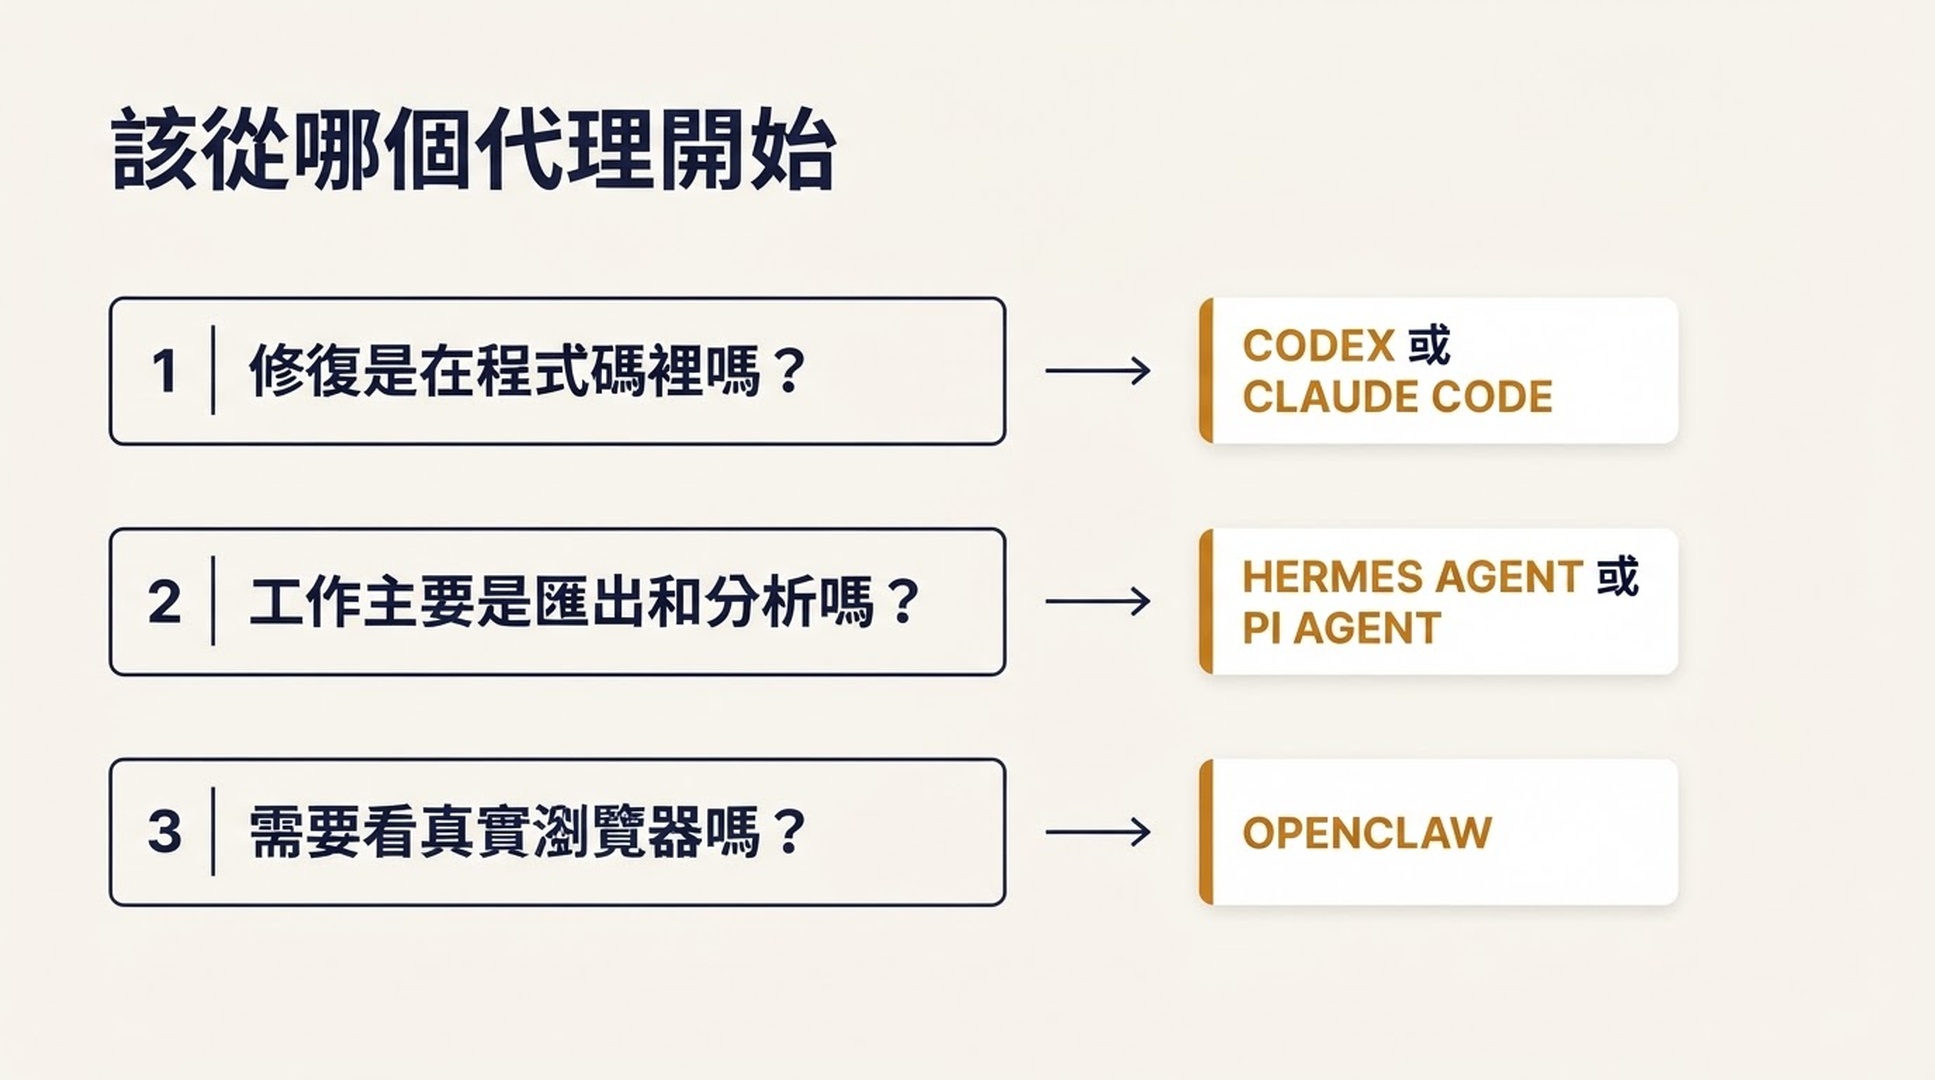
三個問題就能把五個代理收斂到一個。先回答它們,再去比較功能清單。
最值得先交出去的任務
別從有趣的那個開始。從無聊、按週期重複、產出物有人讀的那個開始。這些回本最快。
內容衰退分診。拉取同比和環比表現,丟掉低於重要性門檻的項,先查收錄狀態再看排名、需求、連結和關鍵字蠶食。你會得到一張 URL 表:流失的點擊、可能的原因、支撐證據,以及首選和備選動作。掉了排名的頁面需要重寫。掉了需求的頁面什麼都不用做。丟了 canonical 的頁面五分鐘就能修。團隊經常把這三者搞混,而這個混淆並不便宜。
技術問題分診。按根本原因而不是問題類型來分組,把受影響的 URL 與流量和排名關聯,按影響對工作量打分,寫修復清單之前先在真實頁面上驗證排在最前的幾項。價值就在這個分組方式上。十行「暫時重新導向」通常只有一個根本原因,修一個模板勝過修十個 URL。
競爭對手動向。把流量變化背後的頁面和關鍵字切出來,區分品牌詞和非品牌詞,把每個變化對照一個具名因素去驗證:新內容、排名提升、季節性、遷移,或資料假影。答案是因素和信心水準。一個信心水準低的大數字,是去細看的理由,不是去反應的理由。
內部連結和孤島頁面。從已經獲得排名或連結的頁面裡建候選池,找到與每個目標頁直接相關的段落,套用讀者價值測試:讀到這句話中間的人,真的會想點過去嗎?輸出裡關於結構的那一半,價值常常高於連結本身。發現第二大的頁面沒有任何內部連結指向它,是一個五分鐘就能修、效果卻很大的問題。
引用缺口映射。把提示詞按主題和購買階段分組,找出被引用最多的網域和頁面,區分來源類型,再讀被引用的頁面,弄清到底什麼才能拿到提及。要有心理準備:輸出裡有相當一部分來源,正確答案是根本不去聯繫。論壇和競爭對手自有的資產不是外聯目標。
發布後回歸檢查。用相同設定對比發布前後的抓取,在比對之前先確認兩者可比,然後把每處差異歸類為「預期內」「預期內但實作錯了」或「計畫外」。這個分類才是報告可用的原因。沒有它,你只會得到一堵差異牆和一個做不了的判斷。
最常出現的幾項,我們寫了更詳細的流程:每週排名報告、每日監控、外部連結檔案工作,以及不會把你淹沒的告警設計。
從一個技能開始,而不是一個部門
最常見的失敗,是在一次都沒跑過之前,先搭好八個技能、七個連接和一個排程器。結果什麼都不運作,而且十六個部件裡到底是哪個出問題也說不清。
換成這個順序來做。
挑一個產出可見的任務。最快能驗證的是技術問題分診,因為你可以直接指向已有的抓取,幾分鐘內就能判斷結果。如果你有 Search Console 歷史資料,內容衰退是第二容易的。
在接任何東西之前,先把技能寫出來。技能檔案應該能放進一頁,並回答六個問題:什麼時候用、需要什麼資料、步驟順序、評分或門檻規則、輸出格式,以及哪些操作需要核准。如果一頁寫不完,說明這個任務還沒定義到可以自動化的程度。
只接一個資料源。就是那個技能真正需要的。用不上的連接只會擴大表面,不增加價值。
以唯讀方式執行,並人工檢查輸出。挑兩條結論,對著來源資料自己驗證。如果代理的解釋和你看到的對不上,問題在技能,不在模型。
在加第二個技能之前,先加上核准關卡。所有寫入操作(發布、重新導向、刪除、改程式碼、合併、對外傳送)都應該停下來等核准。趁風險還只是一個技能的時候,把這個習慣建立起來。
讓它不出錯的護欄
這些是我們第一天就會寫進專案指令的規則。故意做得很無聊,這正是重點。
- 在你核准寫入操作之前,正式環境工具保持唯讀。
- 任何多步驟工作流開始前,先讓它給出計畫。
- 用接好的工具去取證據,而不是靠假設。
- 有對應技能時,遵循該技能,而不是臨場發揮。
- 工具呼叫失敗先重試一次,仍然失敗就把錯誤暴露出來,不要繞過去。
- 每條結論都用一句話說明支撐證據。
- 在輸出裡把已確認的結論和假設分開。
- 缺資料和低信心水準的結論要標出來,而不是把空缺填滿。
- 超過約定的 URL、列數或 API 用量上限就停下。
- 發布、重新導向、刪除、改程式碼、合併或對外傳送之前,先請求核准。
其中兩條比其餘的更有用。把已確認結論和假設分開,能讓輸出可信到可以據以行動。用量上限則能防止一個設定錯誤的迴圈在一夜之間燒掉 API 預算。
它會在哪裡壞掉
轉換資料太薄。一個把所有 URL 分成保留、更新、合併、重新導向、刪除或待查的內容組合決策引擎,需要轉換資料才能下判斷。如果追蹤沒設好,它會回傳一大堆零,報告在修好之前都沒用。代理做了它該做的。錯的是輸入。
結構判斷。代理能找出人類簡報漏掉的四點,比如一個會帶出完全不同類型搜尋結果、因此不該放在這個頁面上的關鍵字。但它決定不了文章該怎麼組織。這個判斷留在人手裡,假裝不是這樣,產出的內容讀起來就像零件拼的。
靜默的解釋錯誤。代理在資料環節會大聲失敗,在解釋環節會安靜地失敗。匯出檔案缺失會報錯。一個自信的錯誤原因不會報錯。這就是為什麼「每條結論附證據」這條規則比看起來更重要。
你沒預料到的工具缺口。有些資料根本接不進來。排名資料連接可能無法建立抓取專案、觸發抓取,或匯出完整的已抓取 URL 集合。要圍繞連接實際能回傳什麼來設計工作流,否則技能會卡在中途。
在信任這個迴圈之前,先驗證結果
前三次跑這個檢查,之後每月一次。
- 隨機挑兩條結論,對著來源資料人工驗證。
- 確認所有依賴資料的說法,代理都標註了來源和日期。
- 確認至少有一條結論被標為低信心水準。對什麼都自信的代理,說明它沒有在分辨。
- 確認輸出結構和上一次一致。如果飄了,說明技能檔案變了,或者代理不再遵循它。
- 確認沒有任何東西在核准步驟未觸發的情況下被寫入、發布或傳送。
如果五項連續三次都通過,你就有了工作流。任何一項失敗,去修造成它的那一層,而不是重寫提示詞。
常見問題
什麼是代理式 SEO?代理式 SEO 是把一個定義好的 SEO 工作流交給 AI 代理,由它自行取得資料、遵循書面方法,並在每次執行時回傳結構一致的分析。決定性特徵不是自主性,而是可重現性:方法存在於對話之外,所以不管你記不記得要求,同一套檢查都會生效。
它和 AI 輔助 SEO 有什麼不同?差別在於誰決定下一步發生什麼。在 AI 輔助 SEO 裡,你在每次對話中選擇步驟並貼上資料。在代理式 SEO 裡,你一次性定義方法,代理自行取得資料,遇到意外輸入時遵循書面規則。工作流自動化是第三種:一致性完美,但沒有適應性。
我需要寫程式的代理嗎?不需要。當修復是程式碼改動,或者網站就在程式碼倉庫裡時,Codex 和 Claude Code 這類寫程式的代理更合適。如果你的工作主要是匯出、分析和判斷,基於技能的代理不用碰終端機就能涵蓋。
一開始應該建幾個技能?一個。挑一個產出可見的任務,把技能寫到一頁以內,只接它需要的資料源,以唯讀方式跑到輸出可信為止。一個都沒跑就建八個的團隊,通常會放棄這個專案。
代理式 SEO 工作流能自己發布內容嗎?能,但不應該。把發布、重新導向、刪除、改程式碼、合併和對外發訊息都放在明確的核准關卡之後。工作流的價值在於它拼裝出的證據,而不在於它被授予的權限。
執行成本是多少?取決於資料源,而不是代理。Search Console 對自己的站點是免費的。持續成本在排名資料、SERP 資料和抓取服務上,而且它們大多有免費額度,足夠在正式投入之前驗證一個工作流。
作者:Aaron Wolfe(亞倫・沃爾夫),Auspia 擁有 15 年 SEO/GEO 經驗的自然成長系統設計師。他撰寫關於團隊如何把 AI 代理、資料和審查環節整合進能跨過季度規劃週期依然有效的搜尋工作流。