讀完之後你會得到什麼
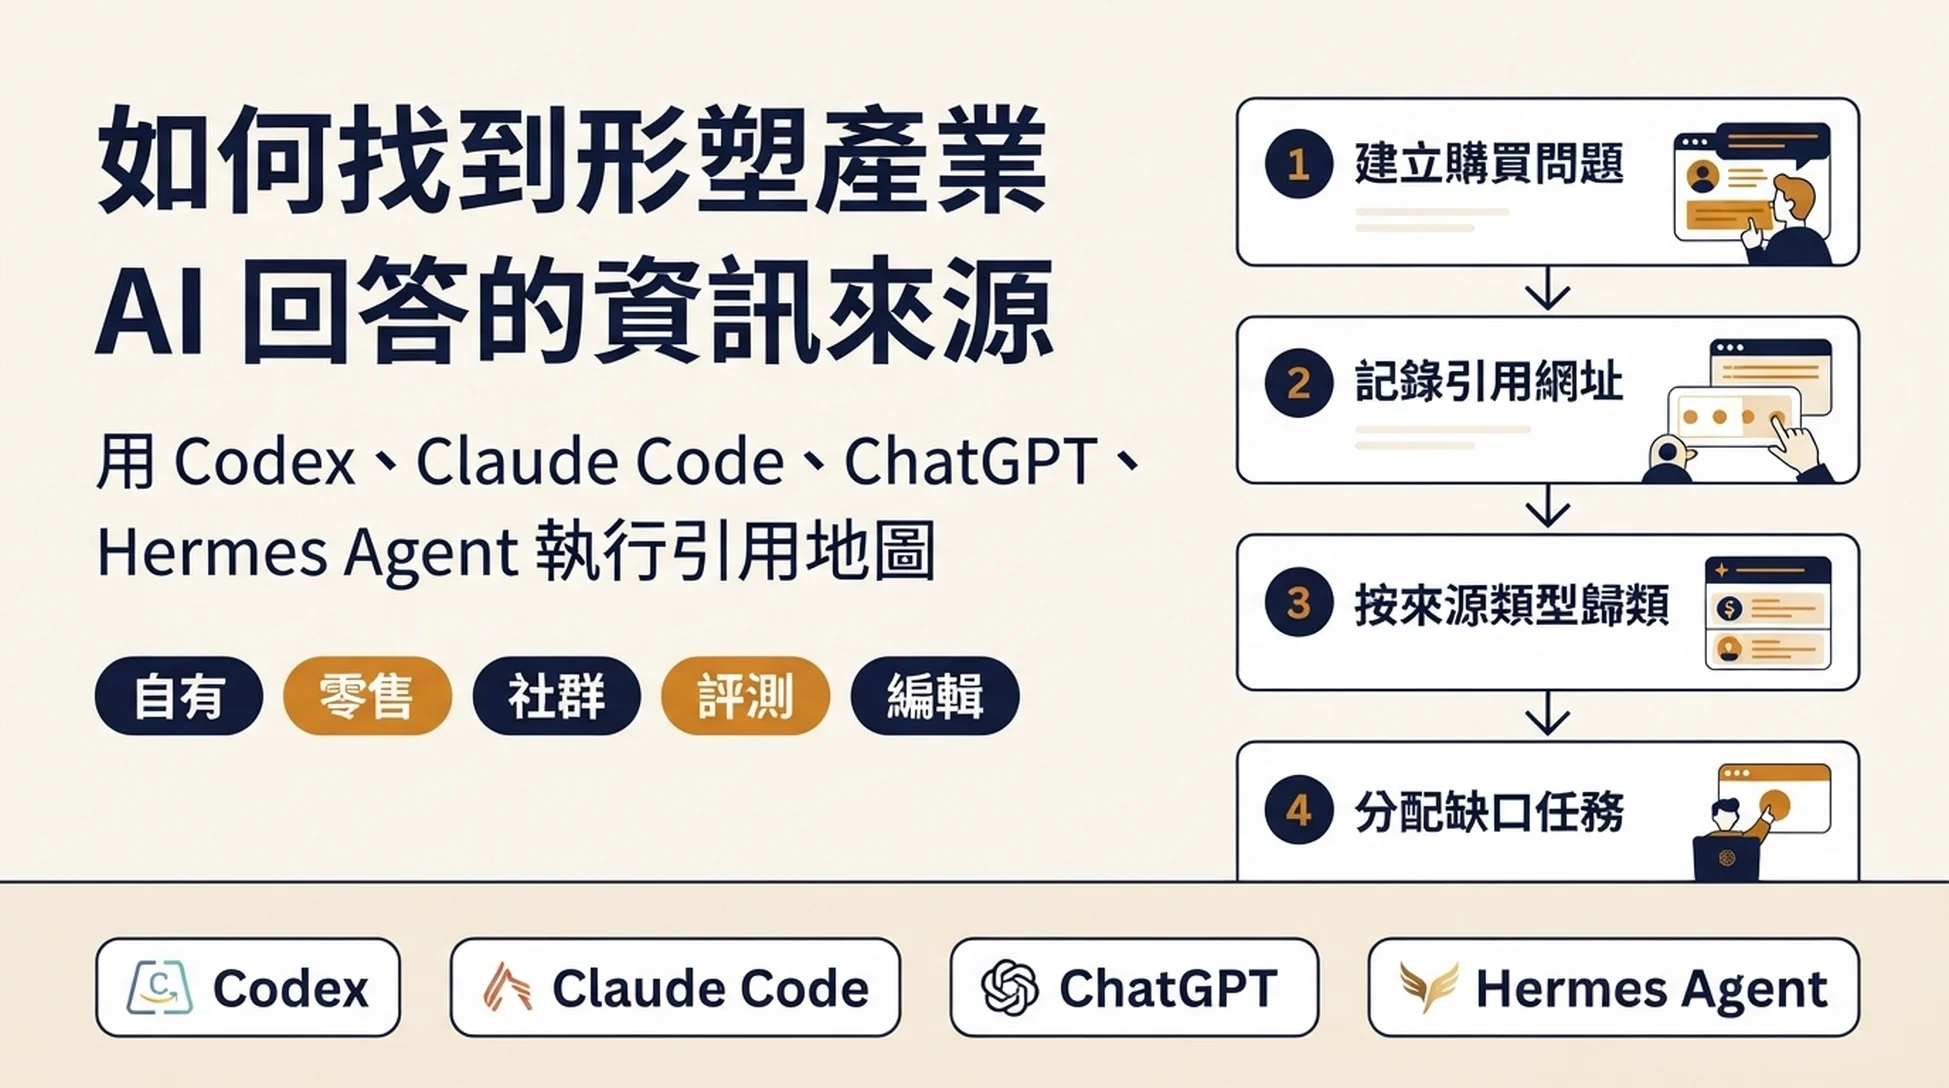
引用地圖,是記錄 AI 引擎在回答你的潛在客戶提問時,實際引用了哪些頁面的檔案。它不是你的品牌有沒有出現在回答裡,而是這個回答是由哪些來源拼出來的。
我在足夠多的品類上跑過這件事,所以知道第一次的結果通常不太好看。團隊都以為自家網站撐起了那些回答。實際上往往不是。在某個 B2B 品類裡,廠商自己的頁面只佔極小一部分,而一個沒人去認領的評測網站承擔了大部分工作。
這就是做這件事的意義。你不再靠猜,而是開始看真實的頁面。
走完這套流程,你會拿到:
- 針對一個產品或服務品類的 10 到 20 個真實購買問題,用客戶自己的說法寫出來
- 每個問題都在買家真正使用的 AI 引擎裡跑過,引用來源帶日期記錄下來
- 這些來源按類型整理好,你能看清自己品類的回答從哪裡來
- 一份簡短清單,列出競品被引用而你沒有被引用的頁面,每條都配一個正當的下一步
- 負責人和複查日期,免得這份地圖在共用磁碟裡爛掉
適合誰: 企業內部的 SEO、GEO 或內容負責人,或者即便由別人落地、也能提出改進建議的代理商策略人員。不強制使用付費工具,但規模上來之後會有幫助。
前置條件: 一個瀏覽器、一份試算表,以及你自己網站的檢視權限。用 agent 版本的話,還需要裝好你選的那個 agent,以及一個可以指向的資料夾。
耗時: 單一品類的第一輪大約兩小時。其中約 45 分鐘用於跑提示詞和複製來源。這 45 分鐘正是值得交給 agent 的部分,剩下的部分需要你的判斷。
完成的定義: 你能說出自己品類裡支撐回答的三到四類來源,能指出你缺席而競品在場的具體頁面,並且能把帶 URL 的任務交給別人。如果你手上只有一串網域和「Reddit 好像挺重要」這種模糊感覺,那還沒完成。
Auspia 的看法: 大多數團隊會直奔「我們需要更多品牌提及」,因為他們從沒看過回答到底是由什麼拼出來的。地圖的作用,就是把這種模糊直覺變成一頁可以行動的東西。
開始之前:決定一切的兩個選擇
後面的產出由這兩個選擇決定。兩個都容易選錯,而且事後都不好改。
只選一個品類,不要覆蓋整個業務。 一家既賣軟體又做服務業務的公司,有兩套完全不同的來源生態。同時映射兩者,只會得到一個誰都不像的平均值。選營收權重最大的那個品類,剩下的留到下個季度。
有意識地選擇引擎。 Google AI Overview、ChatGPT、Perplexity、Gemini 並不是從同一個池子裡取料。某個來源在一個引擎裡失勢了,在另一個引擎裡可能依然有分量。至少跑兩個。如果不知道選哪兩個,問問業務團隊客戶會提到哪個介面,或者查一下來自 AI 網域的推薦流量。
現在劃一條界線。這是觀察工作,不是證明工作。你記錄的是某個引擎在某一天回傳了什麼。回答每次執行都會變,所以單次觀察是一個資料點,不是趨勢。所有記錄都要帶日期,否則整份檔案一個月後就沒法用了。
第一步:建立問題集
寫下 10 到 20 個客戶在做選擇時會問的問題。不是關鍵字。是問題,用客戶自己的話。
這一步很多人會趕著過,而它恰恰決定了後面值不值得做。用關鍵字匯出做出來的問題集,產出的是「人們怎麼搜尋」的地圖。用業務通話記錄做出來的問題集,產出的是「人們怎麼購買」的地圖。這兩份清單不是一回事。
可以拿來出題的素材:
- 業務團隊最常被問到的購買前問題
- 購買後 30 天內的支持工單
- 主要商業查詢的「大家還想問」區塊
- 你自己的關鍵字研究,改寫成問句
- 買家會做的競品比較搜尋
把問題類型混著來,因為不同形狀會拉出不同的來源。
問題形狀 | 例子 | 容易帶出的來源 |
|---|---|---|
品類適配 | 「中型物流公司挑路線規劃工具時該看什麼?」 | 編輯類榜單、評測網站 |
直接對比 | 「20 人團隊選工具 A 還是工具 B」 | 對比頁、社群貼文 |
風險與異議 | 「工具 A 真的安全到能處理醫療資料嗎?」 | 論壇、合規解讀、廠商文件 |
價格與價值 | 「工具 A 每席位到底多少錢?」 | 定價頁、社群貼文、評測網站 |
落地導入 | 「從工具 B 搬走要多久?」 | 文件、YouTube 講解、論壇 |
預期產出: 一份試算表,每個問題一列,一欄是問題形狀,一欄是你要跑它的引擎。
品質檢查: 把清單讀一遍,問自己真實買家會不會這樣輸入。如果一個問題只有已經懂你產品分類的人才看得懂,就重寫。買家真會問的 10 個問題,勝過 50 個聽起來像關鍵字匯出的問題。
補救路徑: 如果湊不到 10 個問題,那是調研問題,不是映射問題。先把最近 20 筆業務通話記錄或最近 50 張支持工單翻出來,從裡面提取問題再繼續。
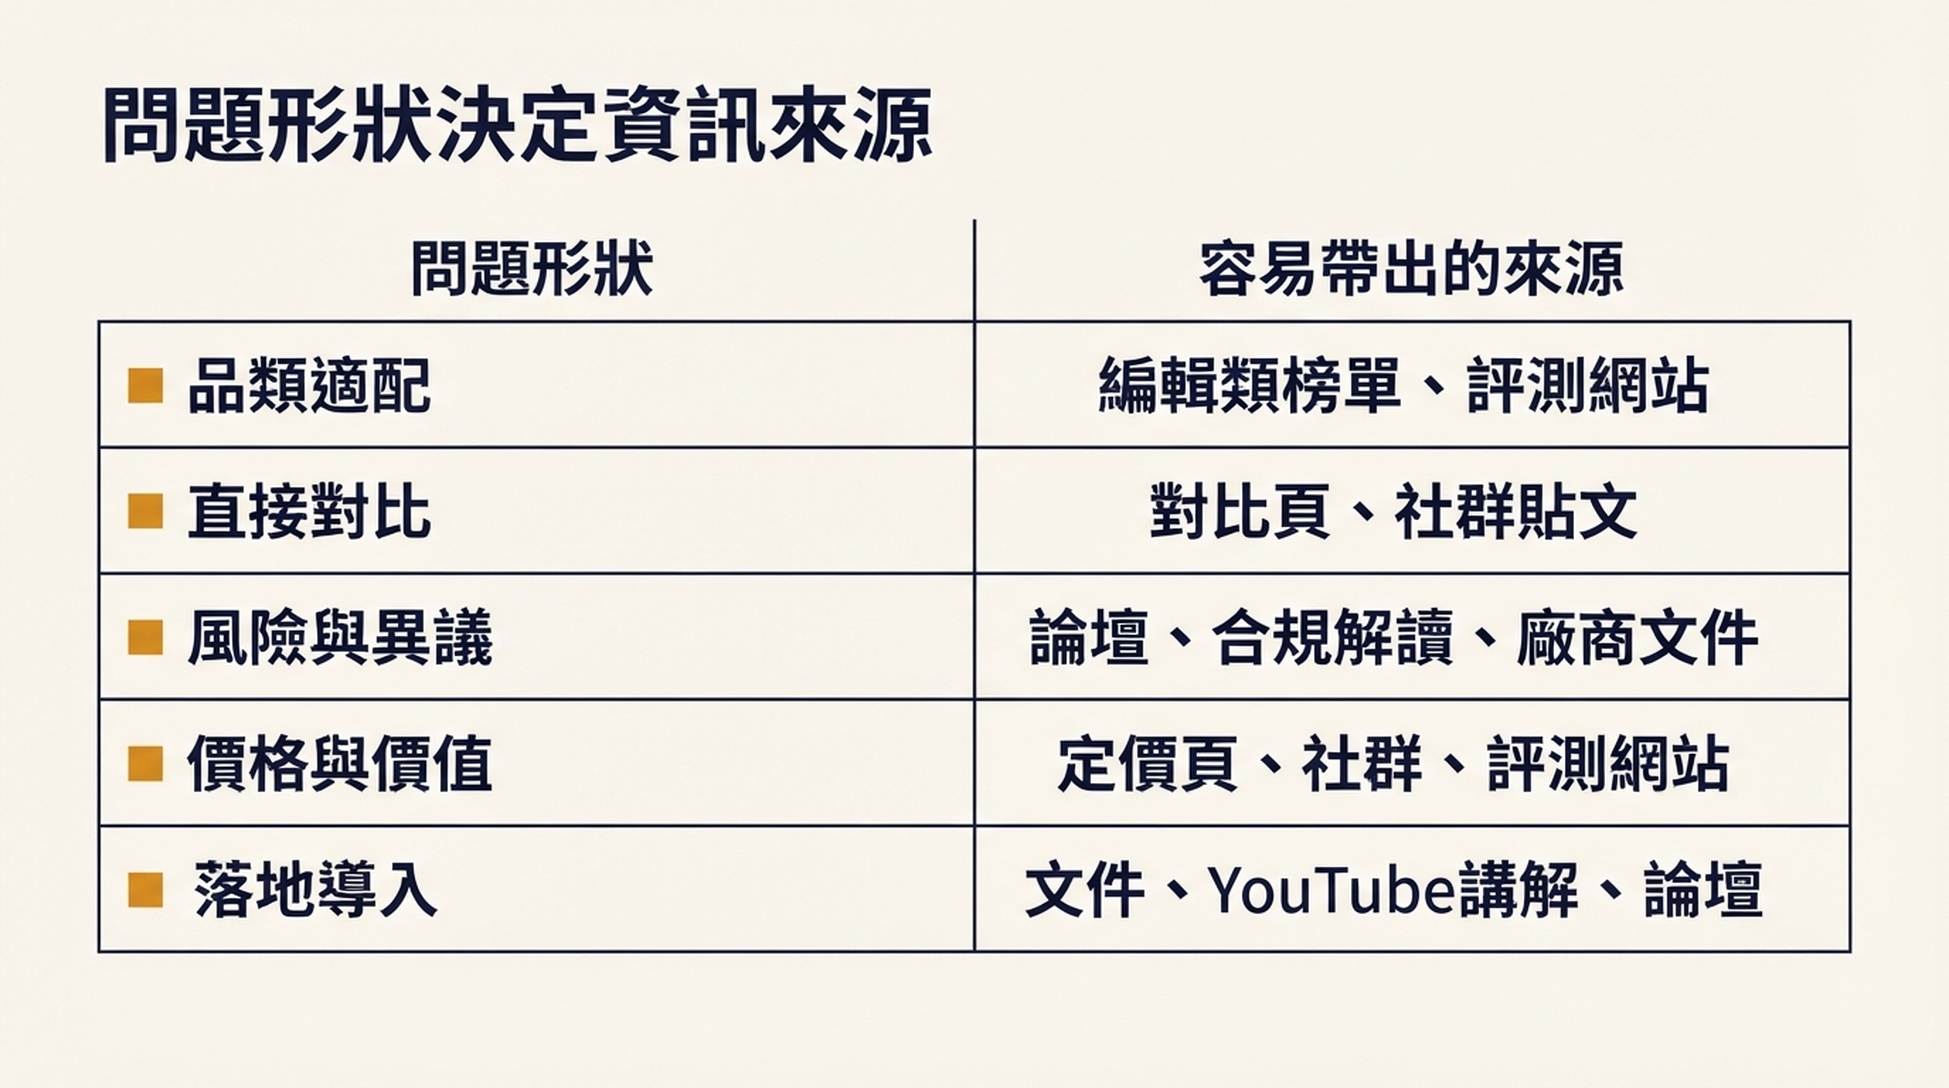
問題形狀是那個隱藏變數。同一個產品的直接對比問題和風險問題,回傳的來源並不一樣。
第二步:跑問題並記錄來源
這裡是機械性的核心,也是手工做會崩掉的地方。先手動做 5 個問題,搞清楚產出應該長什麼樣。剩下的再自動化。
對每個問題,在每個引擎裡:
- 開一個新對話。之前的上下文會改變引擎檢索到什麼。
- 原樣照抄地問。
- 打開引用面板或來源清單。多數引擎裡這是回答旁邊的一個小圖示,而不是一個可見清單。
- 記錄每一個被引用的 URL,同時記下網域和來源類型。
- 記下日期、引擎,以及這次回答到底有沒有引用。
按這個結構記錄:
欄位 | 為什麼重要 |
|---|---|
問題 ID | 把每筆觀察掛回購買問題 |
引擎 | 之後可以拆出引擎層面的規律 |
日期與時間 | 回答會漂移,沒日期的列一個月後就沒用 |
引用 URL | 是真實頁面,不只是網域 |
網域 | 用於歸組和頻次統計 |
來源類型 | 自有、零售/市集平台、社群、評測目錄、編輯類 |
競品是否出現 | 是/否,以及是哪一家 |
我們是否出現 | 出現在回答裡、出現在來源裡、兩者都有,或都沒有 |
最後一列值得多想一會兒。品牌可能被回答點名,但自家頁面一條都沒被引用。反過來,品牌也可能被引用卻沒有被顯著點名。這是兩個不同的訊號,如果你只追「有沒有出現」,兩個都會看錯。我見過團隊為一個來自批評自家頁面的提及而慶祝。
預期產出: 一張長表,每個問題、每個引擎、每筆被引用的來源各一列。
品質檢查: 至少挑三列點進去,確認被引用的頁面確實支撐了它被引用的那個說法。引擎偶爾會引用一個只是提到話題、但並沒有回答問題的頁面。這類列是雜訊,要標出來。
補救路徑: 如果某個引擎對某個問題沒有回傳任何引用,那是一個發現,不是失敗。記成零來源然後繼續。那些不需要檢索就能被回答的問題,是自家內容影響不到的問題。
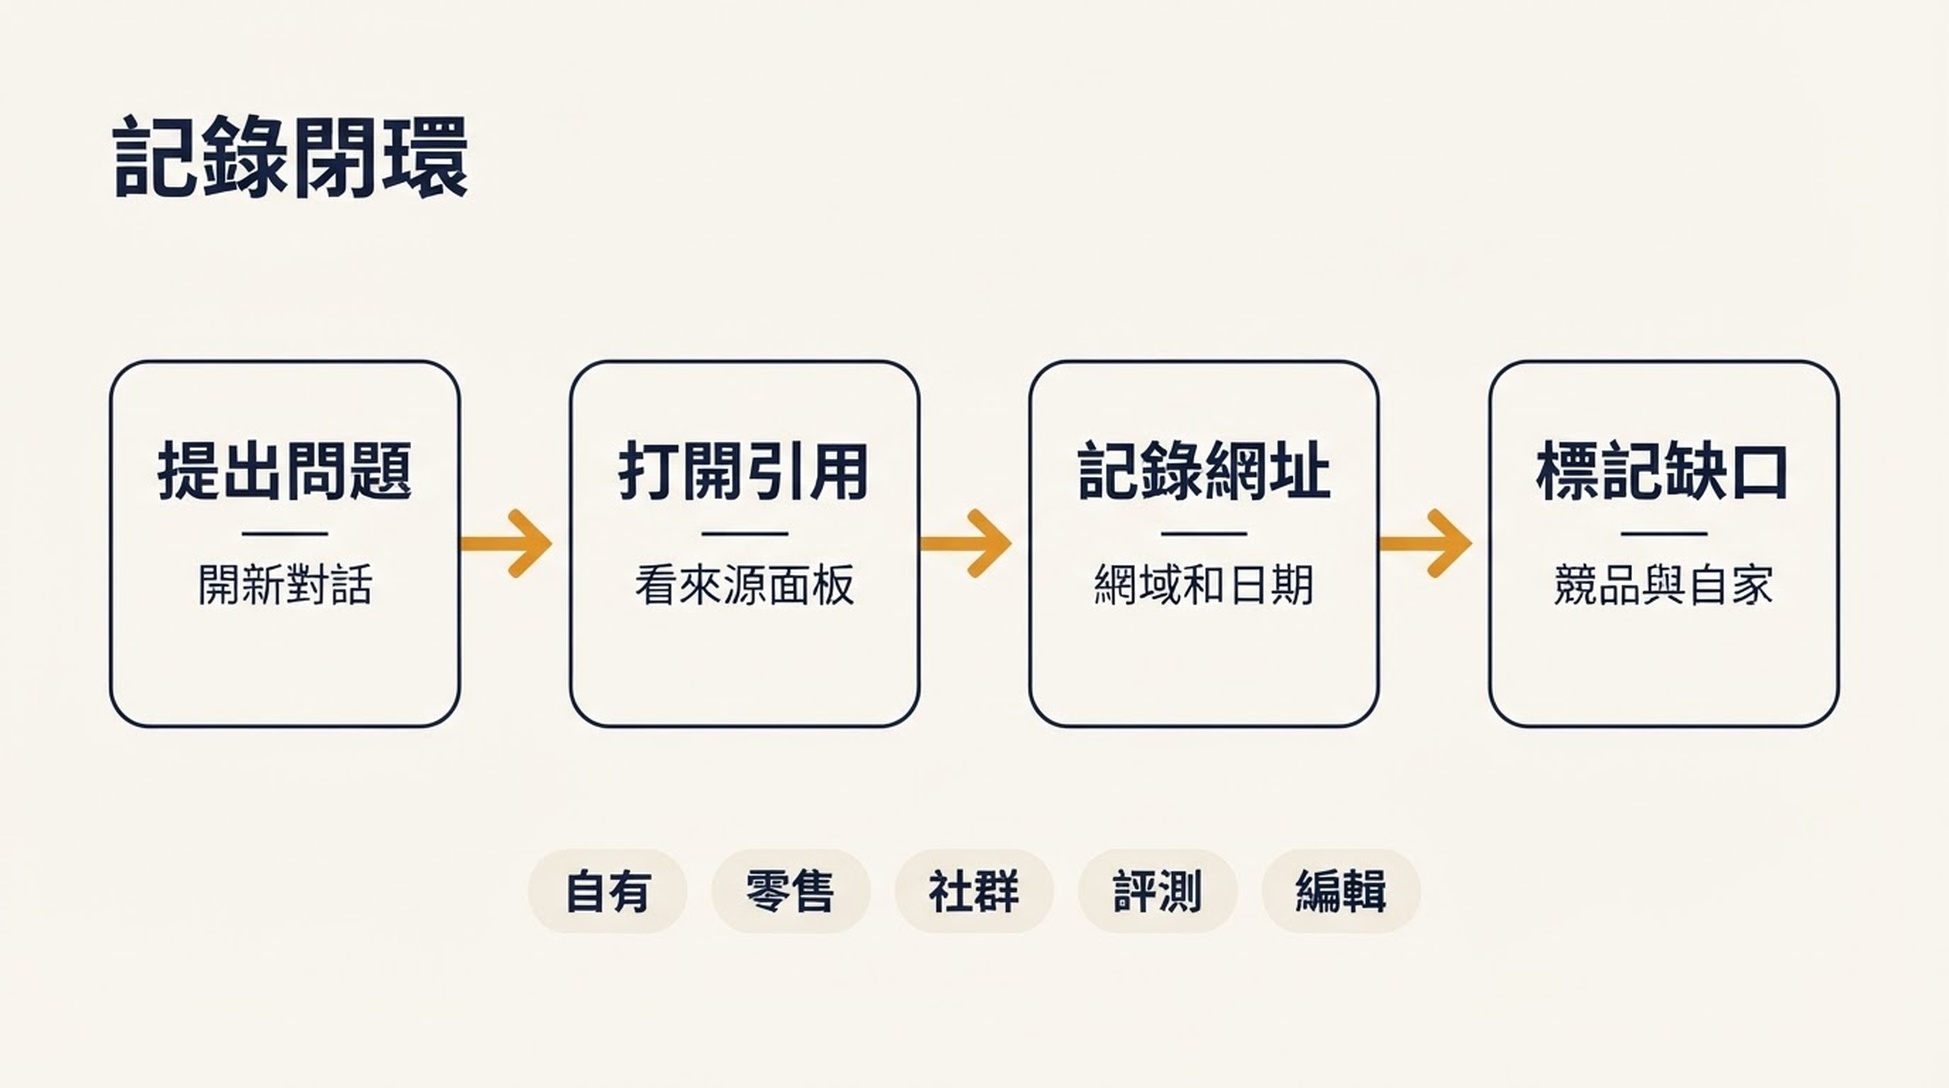
這個閉環簡單又枯燥。正是這種組合,讓它成為適合交給 agent 的活兒。
第三步:按類型給來源歸類
現在把長表壓縮成你品類的全景圖。把每個被引用的 URL 歸到五個桶之一:
- 自有: 你自己的網站,或競品的網站
- 零售與市集平台: 產品頁、比價頁、應用程式商店
- 社群與 UGC: Reddit、YouTube、Quora、論壇、被收錄的 Discord 貼文
- 評測目錄與 B2B 平台: G2、Capterra、Clutch、Trustpilot、行業垂直目錄
- 獨立編輯與參考資料: 行業媒體、新聞、Wikipedia、分析師解讀、獨立部落格
按桶、按引擎數一遍,引用地圖就出來了。
你要看的不是單一數字,而是形狀。有些品類幾乎全靠社群貼文和行業媒體撐著,品牌自家網站幾乎沒有存在感。另一些品類由產品頁主導,因為答案本身就在產品頁裡。這個配比取決於買家問什麼,而不是誰的網站做得多好。對已經在網站上砸了兩年的人來說,這話不太好接受。
預期產出: 一張小表,每類來源一列,每個引擎一行,顯示被引用來源的佔比。
品質檢查: 如果某個桶佔了引用的 70% 以上,從裡面抽 5 個 URL 確認它們真的屬於這一類。一個高流量的聚合站可能偽裝成編輯類來源,實際上是个目錄。
補救路徑: 如果數字看起來毫無規律,多半是你把不同形狀的問題混在一起,把規律蓋住了。按問題形狀拆開表格再看一遍。價格問題和風險問題的來源構成經常完全不同。
第四步:找出競品被引用而你缺席的缺口
把長表篩成「競品出現、我們沒出現」的列。篩出來的這份清單就是你的工作清單。它比「我們需要更多提及」這種籠統指令有用得多,因為每一列都已經掛著 URL 和客戶問題。週一交給同事,他就能直接開工。
對每一列,打開被引用的頁面,回答三個問題:
- 我們的產品真的應該出現在這個頁面上嗎?
- 如果應該,缺的是什麼——一個我們從沒認領的收錄、一個我們缺席的對比、一個沒人提到我們的貼文,還是一次我們沒去要的評測?
- 讓我們出現在那裡,最小的正當動作是什麼?
第三個問題才是紀律所在。動作因桶而異。這裡搞錯,就是 SEO 跑去給記者群發關於 Reddit 貼文的冷郵件。
來源類型 | 正當動作 | 不要做的事 |
|---|---|---|
評測目錄 | 認領並補全資料頁,邀請客戶寫評測 | 買評測,或塞假評測 |
社群貼文 | 以實名員工身分誠實回答問題,揭露身分 | 當網軍,或丟個連結就走 |
編輯類 | 提出該媒體還沒寫過的、真正有用的角度 | 把同一份新聞稿群發給 200 個網域 |
市集平台或零售頁 | 修好規格、圖片和描述,讓事實可被取用 | 往頁面裡堆關鍵字 |
自有頁面 | 重新組織,讓那個具體事實好找好引用 | 加一段什麼也沒回答的 FAQ |
預期產出: 一份篩過並排好優先順序的清單。按來源在你的問題集裡出現的頻次排序,而不是按網域聽起來多權威。一個在 20 個問題裡被引用 6 次的論壇貼,排在一次性的行業媒體前面,而且動手也容易得多。
品質檢查: 對每列保留下來的列,確認你能說出它對應的客戶問題。說不出來就刪掉。為管道裡沒人問的問題而被引用的頁面,只會分散注意力。
補救路徑: 如果篩出來的清單還是巨大,說明篩得不夠狠。第一輪最多留 10 列,按引用頻次排序,做完再回頭打開完整清單。
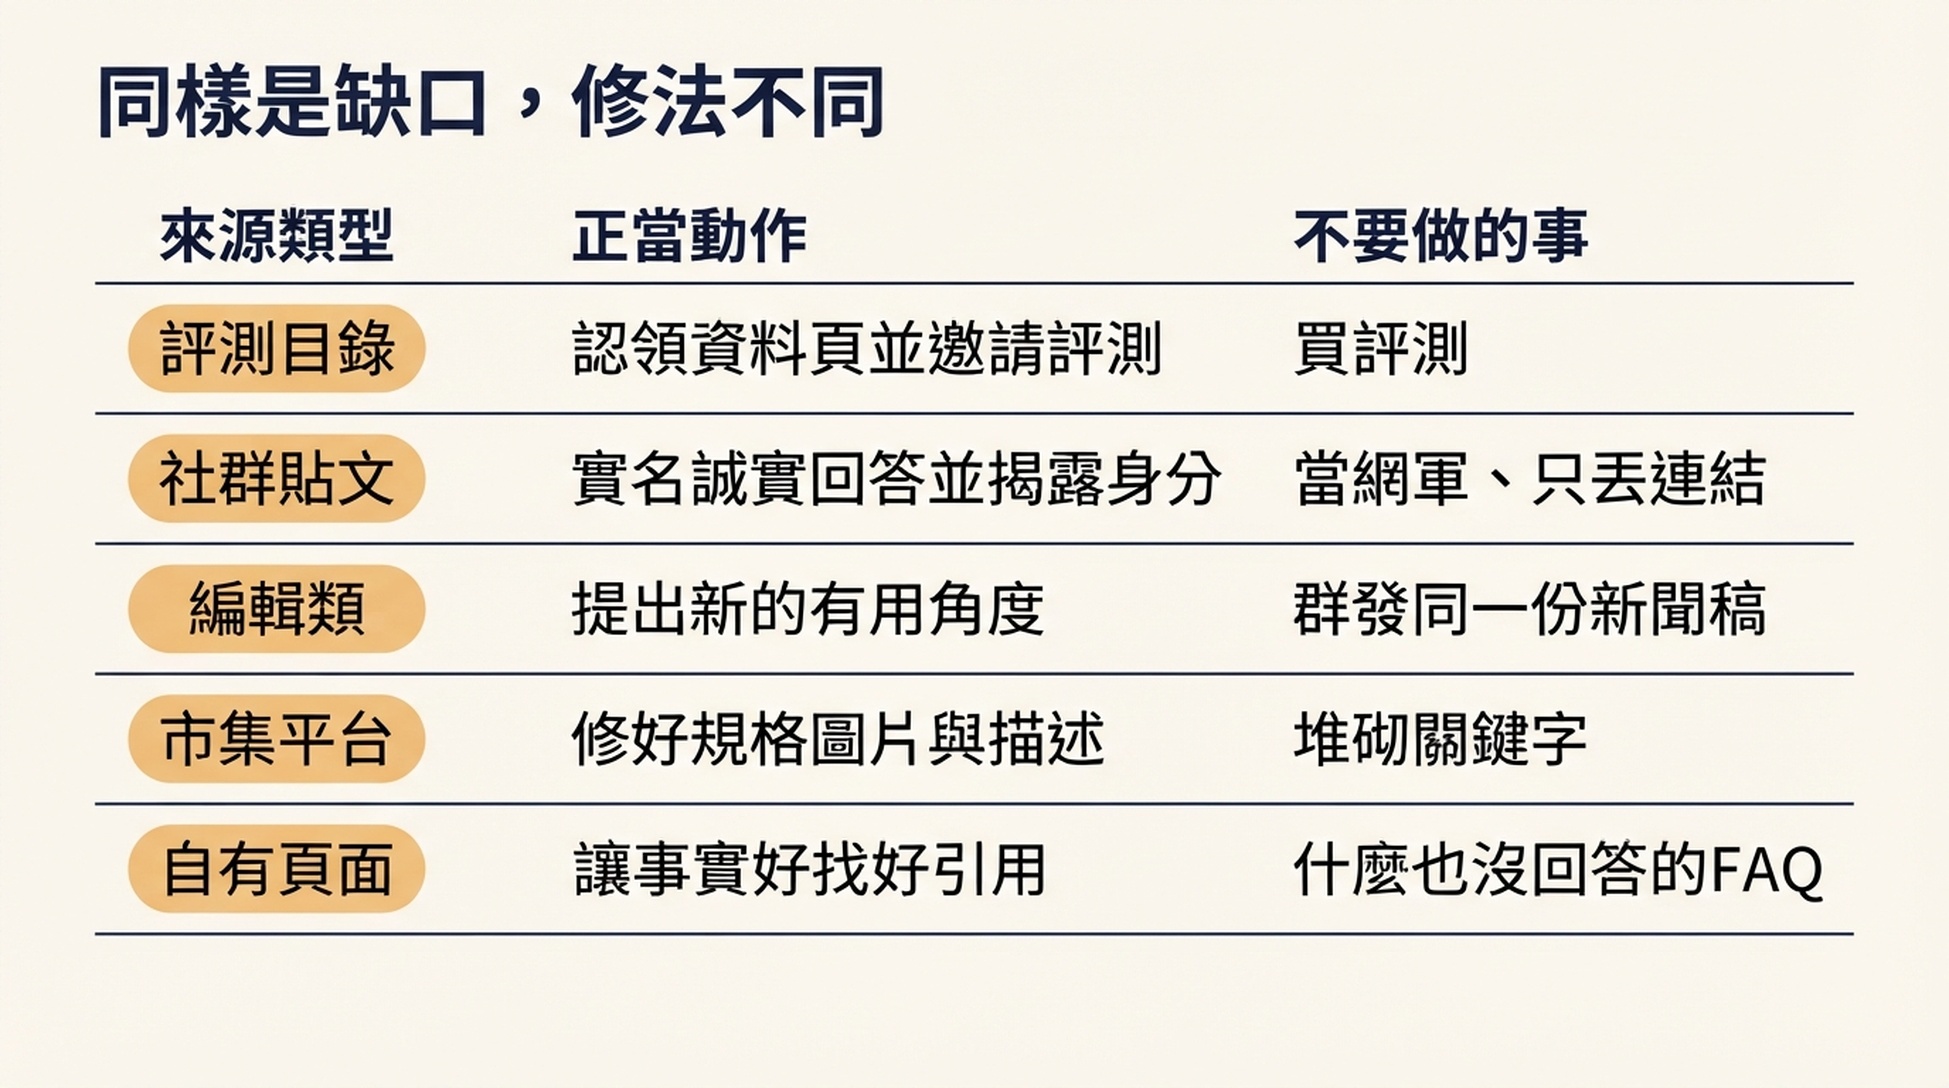
同樣是缺口,修法不同。把每一次引用缺失都當成外聯問題,團隊最後就會去跟編輯推銷 Reddit 貼文。
第五步:把機械的那一半交給 agent
第二步和第三步最耗時間、最不需要判斷。這正是值得委派的工作的定義。問題集和優先順序排序留在人手上,因為這兩處一旦判斷錯,整套動作就白做了。
下面四個 agent 都能跑同一套方法。變的是方法存在哪裡、產出怎麼回到你手上。按這個選,而不是按這個月哪個模型在榜單上得分高。
Codex
適合你想讓地圖住在程式碼倉庫裡、每次執行都產出一份經過複核的成品。如果你的網站本來就在 git 裡,這條路摩擦最小。
建一個專案資料夾,裡面放 citation-map/ 目錄、存問題集的 questions.csv,以及一個寫明方法的 SKILL.md。SKILL.md 裡寫清楚:查哪些引擎、記哪些欄位、怎麼給來源分類、輸出檔案長什麼樣。每次執行存一個檔案,用日期命名,這樣是累積歷史而不是覆蓋。
讓 Codex 跑這些問題,把列追加到當次執行檔案裡,並輸出一張按引擎分列的來源佔比彙總表。因為產出是倉庫裡的檔案,你能拿到可複核的 diff,再決定什麼算最終版。這個複核環節才是重點:你檢查的是分類,不是重做採集。
有一條規則無論如何都要寫進 SKILL.md:agent 只記錄它觀察到的內容,不得推斷它沒看到的引用。憑空造出來源是這套流程裡破壞性最強的失敗模式。一條明文規則加三列抽查就能擋住大部分,而且每次抽查的三列都要換。
Claude Code
適合你需要把方法對照一份明文政策來讀,並且想用長上下文複核被引用的頁面。
把方法寫進 CLAUDE.md 或一個專案 skill,包含你的來源類型定義和精確的輸出結構。把 Claude Code 指向執行資料夾,讓它給每個被引用的 URL 分類,然後標記出那些頁面內容其實並不支撐該引用的列。
第二件事才是值得付費的部分。讀 200 個被引用的頁面,判斷每一個是否真的回答了問題,對人來說很痛苦,對有明文標準的 agent 來說是合理的活兒。讓它給每一列輸出一個信心標記,你只複核低信心的那些。
ChatGPT
適合你想把搭建成本壓到最低,而且這件事是一次性做完而不是週期性執行。
把方法作為自訂指令或儲存好的專案提示詞貼進去,附上你的問題清單,按引擎分批處理。要求它輸出一張欄結構和第二步完全一致的表,這樣可以直接貼進試算表。
要注意的是,ChatGPT 本身也是你要測量的介面之一。如果你在映射 ChatGPT 自己的引用,請在一個沒有載入你方法的乾淨對話裡做,否則觀察就被污染了。用一個對話採集,用另一個對話整理。
Hermes Agent
適合你想讓方法作為 skill 持久化,不用每次重新解釋就能跨執行改進。
把引用地圖這套方法連同問題集和輸出結構一起裝成 Hermes skill,然後按週期執行,月度通常合適。因為 skill 和它的記憶是持久的,你第一個月做的修正會帶到第二個月。如果 agent 把一個目錄誤判成編輯類來源,改一次規則就行。
代價是持久記憶需要定期複查。每隔幾次執行,讀一遍 skill 檔案,確認累積下來的修正仍然描述的是你想要的方法,而不是一堆沒人說得清的一次性例外。
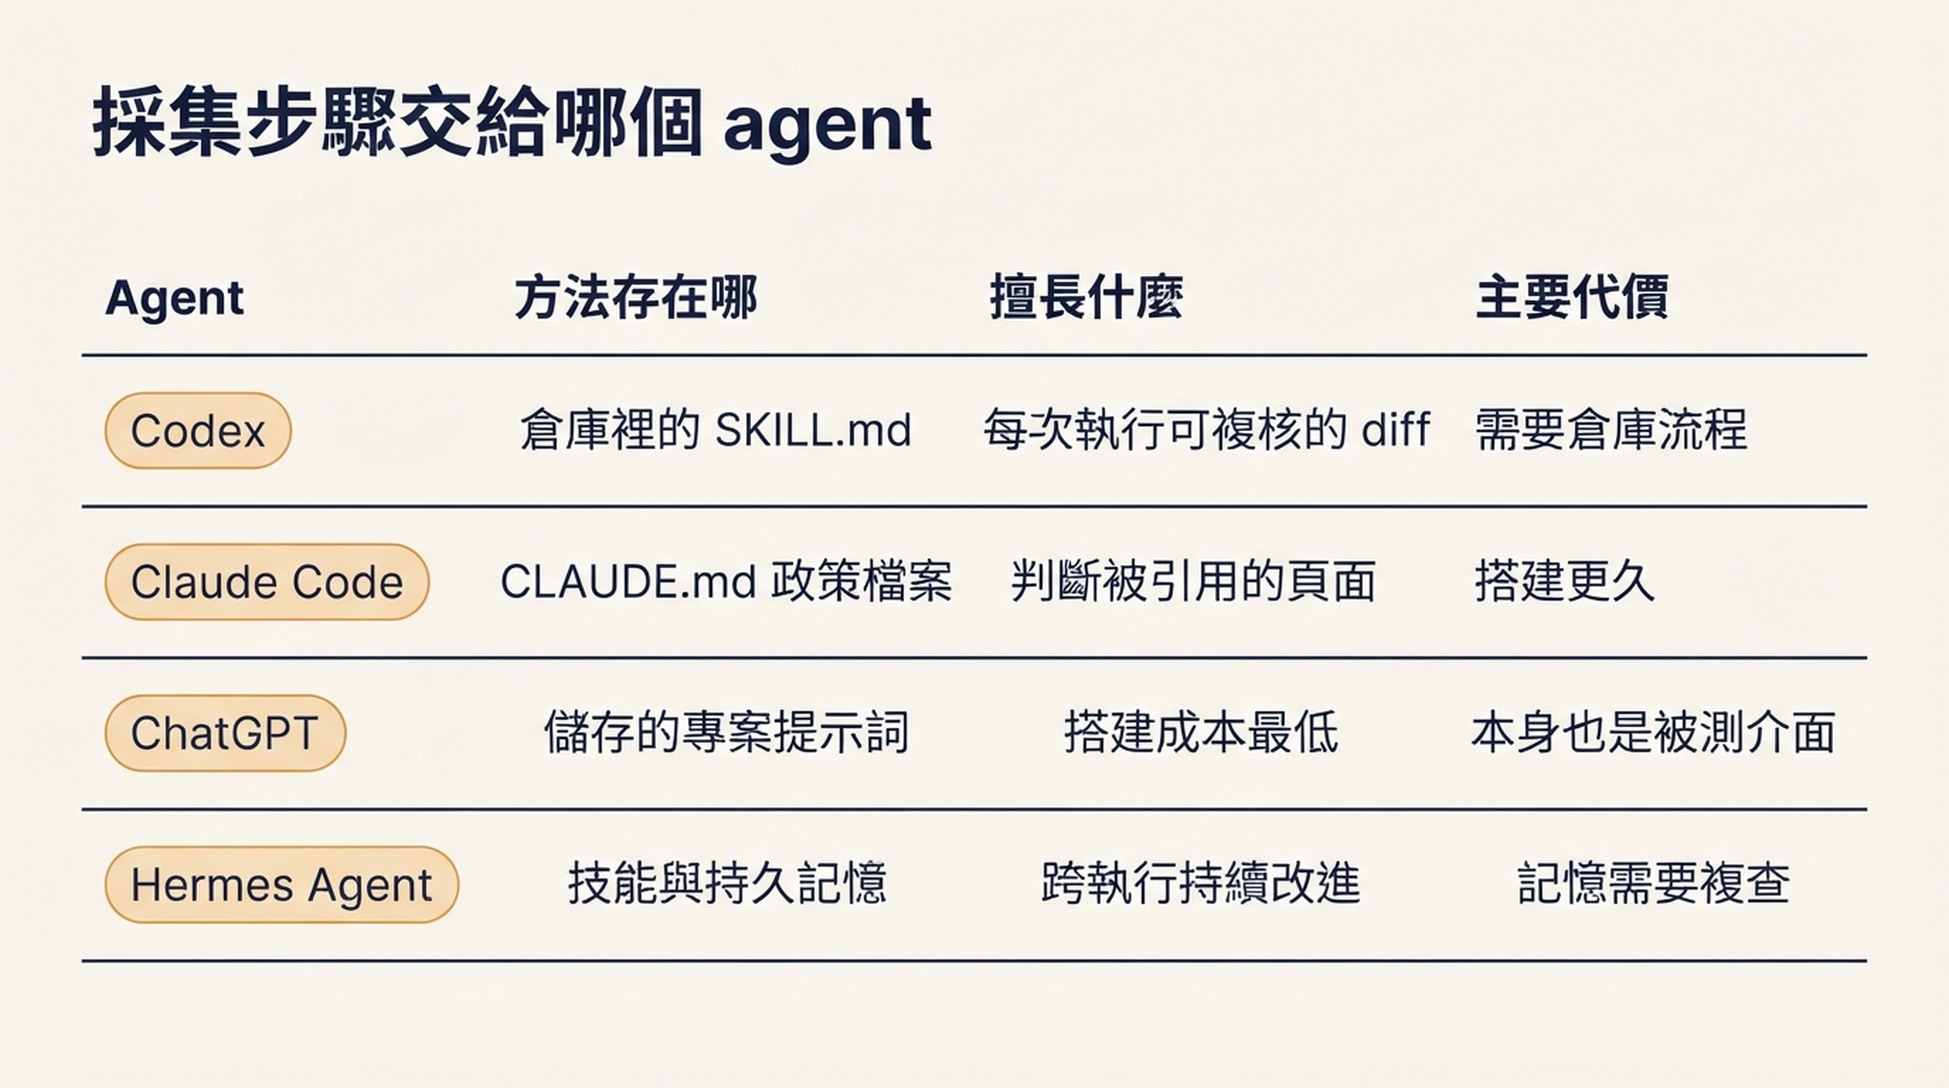
四個 agent 跑的是同樣的五個步驟。按方法該放在哪裡來選,而不是按哪個模型在榜單上得分最高。
第六步:動手之前先驗證地圖
不要拿一份沒驗證過的地圖去派活。先跑這套檢查。這裡的五分鐘能省下一個季度的方向性浪費。
- 一週後重跑三個問題。 如果來源構成完全變了,要嘛你的問題集太不穩定,要嘛樣本太小。記下這種波動,別把第一次當成標準答案。一定程度的波動是正常的,整體換血才是警告。
- 確認引擎,而不只是確認回答。 出現在 Perplexity 的來源,在同一個問題的 ChatGPT 裡可能缺席。彙總時把引擎分列保留,合併後的總數恰好會蓋住你需要的訊號。
- 也檢查你自己的引用。 如果品牌被引用了,打開那個頁面。有時候引擎引用的是一個批評你的頁面,或者一個你根本管不到的頁面。那是有用的資訊,不是勝利。
- 確認每一列都有日期。 沒有日期的引用地圖,之後跟什麼都比不了。
- 核對來源數量。 如果一個問題回傳了 40 個來源,其餘都是 3 個,檢查一下你是不是抓到了「相關」面板而不是真正的引用。
完成的定義: 你能把彙總表和一份篩好的工作清單交給同事,他們不用問任何一列的含義就能開工。
維護這份地圖
每季度用同一套問題集跑一次全量,每月對商業價值最高的 5 個問題跑一次輕量版。舊記錄留著。有意思的訊號通常不是快照,而是漂移:某一類來源在悄悄增長,或者某個競品開始出現在它以前不在的桶裡。
問題集每半年重看一次。購買問題會隨產品和市場變化,過期的問題集會產出一份你已經不在賣的品類的地圖。
有一件事要克制:別把它做成儀表板。產出是一份帶負責人和 URL 的工作清單。如果最後沒人手上有任務,這份地圖就沒起作用。
常見問題
做這件事需要付費的 AI 可見性工具嗎?不需要。手工版對單一品類是可行的,半天就能做完。當你要追蹤多個品類或多個市場,或者想要歷史趨勢線又不想自己維護試算表時,工具才值這個錢。
多少個問題才夠?每個品類 10 到 20 個。少於 10 個,你分不清規律和巧合。第一輪超過 20 個,分析就做不完,而分析才是產出工作清單的部分。
要不要把我們已經出現的問題也算進去?要。知道哪些來源在支撐你,和知道哪些漏掉了你一樣有用。它還能告訴你改內容的時候該守住什麼。
如果每次問都得到不同的回答怎麼辦?這很正常,也值得記錄。把同一個問題跑三次,記下波動。如果來源集合每次都完全不同,就把這個問題當作低信心,在排優先順序時降低它的權重。
能直接用引擎自己的來源清單,不打開頁面嗎?第一輪採集可以。對於你打算動手的那些列,不行。你需要讀頁面才能判斷自家品牌是否真的該出現在那裡,以及什麼才算有用的貢獻。
這跟排名追蹤有什麼區別?排名追蹤告訴你自家頁面出現在結果清單的什麼位置。引用地圖告訴你一個回答是由哪些頁面拼出來的。有頁面排第一卻從沒被引用,也有頁面根本排不上名卻是回答的骨架。這個差距,就是這件事值得花半天的原因。
作者: Ethan Marlowe,Auspia 的 GEO 計量負責人,負責過 500 多個提示詞。他寫提示詞追蹤、引用報告、可見性儀表板,以及如何區分真實的 AI 可見性變化和執行之間的雜訊。