Dois verificadores de visibilidade em IA podem ler as mesmas respostas no mesmo dia e chegar a veredictos opostos. Um devolve a contagem de citações, o outro não devolve nada, porque a resposta nomeou sua marca e a recomendou sem linká-la uma única vez.
Em setembro de 2026, rodamos vinte prompts em três superfícies de IA e registramos, em cada resposta, dois sinais: a marca que a resposta nomeou no texto e o domínio que a resposta apresentou como fonte. Esses dois sinais não são dois ângulos de uma mesma medição. Eles divergem em pontos previsíveis, e são esses pontos a parte mais útil do relatório.
A versão curta: o Perplexity citou fontes em todos os prompts, o Gemini devolveu uma mediana de 47 fontes por resposta, e o ChatGPT não devolveu citação alguma em 12 dos 20 prompts, ainda assim nomeando fornecedores em 13 deles. A variação entre execuções numa mesma superfície é outra questão, e nós a medimos antes em variação de execução do rastreador de visibilidade em IA.
O que rodamos
Item | Configuração |
|---|---|
Prompts | Vinte perguntas que um comprador faria sobre ferramentas de visibilidade em IA |
Superfícies | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Busca na web | Ativada nas três superfícies |
Região e idioma | Estados Unidos, inglês |
Data | 12 de setembro de 2026 |
Respostas coletadas | 60 |
Custo da execução inteira | 1,444 dólar, ou 0,024 dólar por resposta |
Repetição | Rodamos de novo os mesmos cinco prompts para ver se o comportamento é estável |
O custo por resposta ficou entre 0,006 dólar no Perplexity e 0,037 dólar no Gemini. A superfície mais barata produziu a lista de fontes mais consistente, e a mais cara não foi a que devolveu mais fontes.
Os dois sinais, medidos separadamente
Capturamos cada resposta duas vezes: uma como texto e outra como a lista de fontes que a superfície anexou a esse texto.
Superfície | Anotações de fonte | Por resposta | Respostas sem citação | Domínios distintos por resposta |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | de 0 a 18, mediana 0 | 12 de 20 | de 0 a 10 |
Gemini 2.5 Flash | 989 | de 14 a 122, mediana 47 | 0 de 20 | de 3 a 23 |
Perplexity | 399 | de 19 a 20 | 0 de 20 | de 16 a 20 |
Essas três listas não são o mesmo tipo de objeto, e é aqui que o verificador erra primeiro.
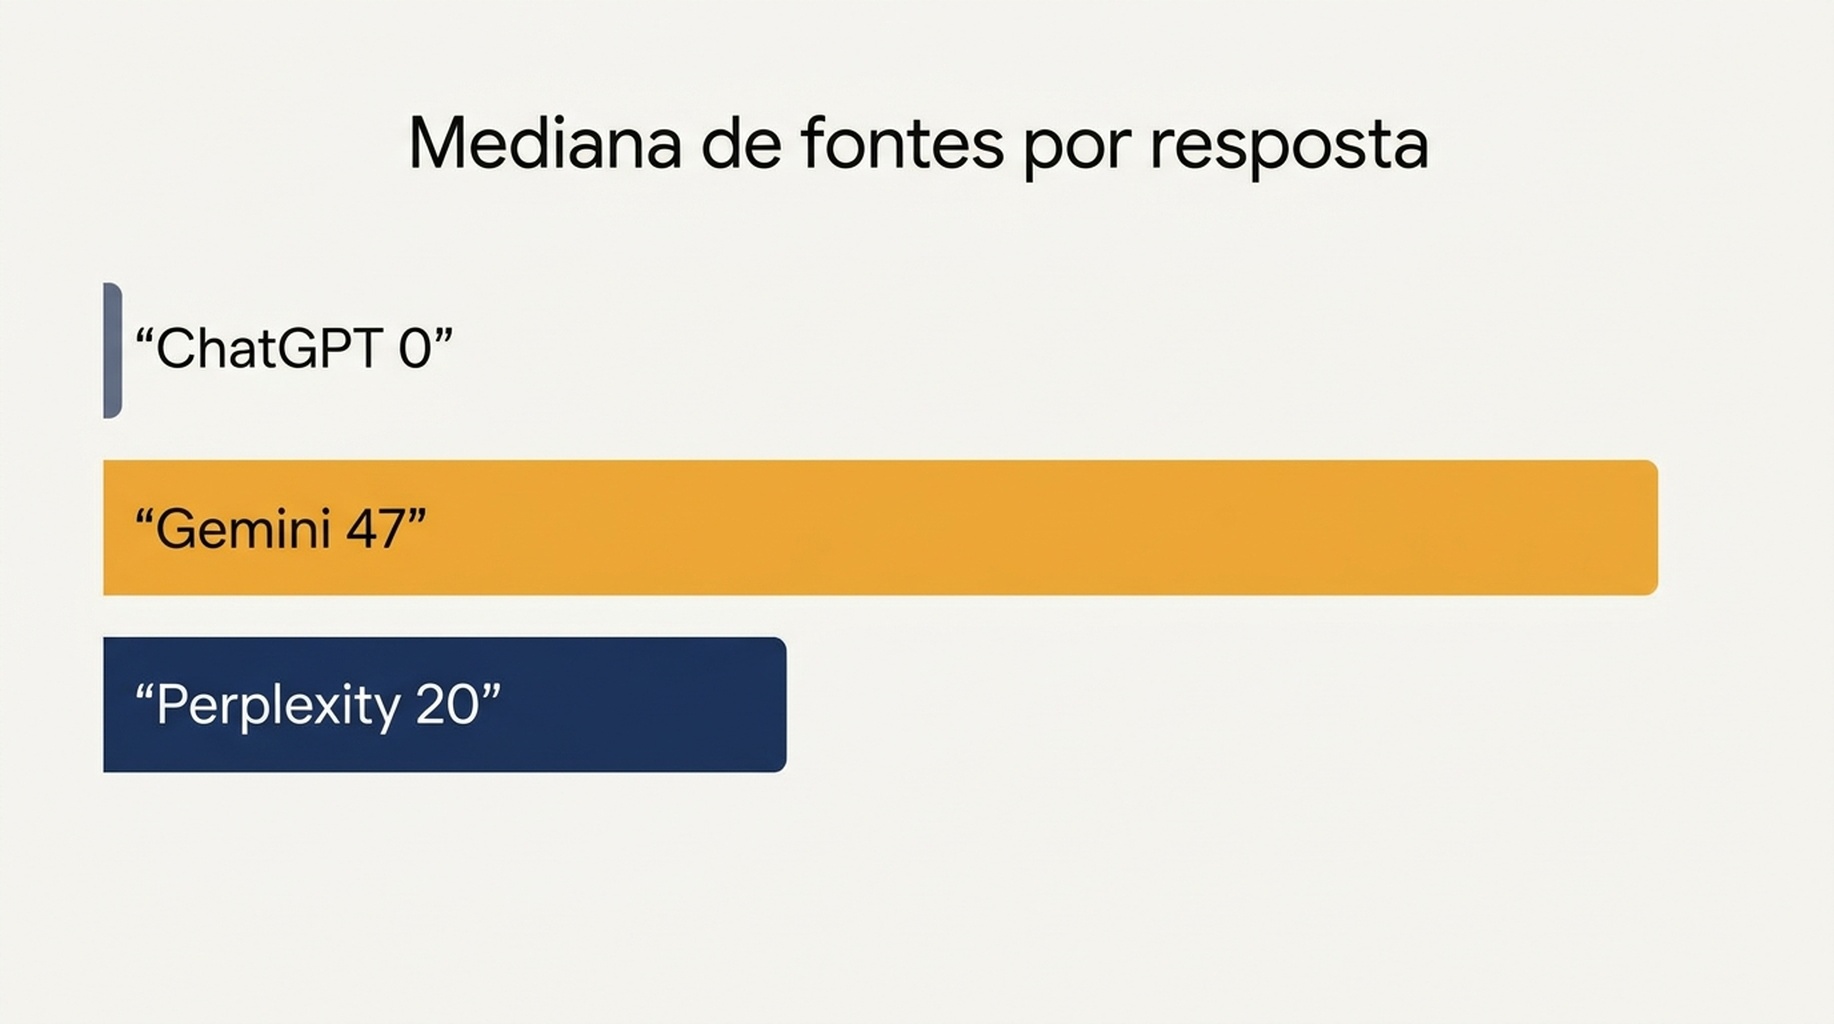
O Gemini anexa uma fonte a quase toda afirmação. A mesma página pode ocupar muitos lugares dentro de uma única resposta, e é por isso que os números são tão altos: ao longo de 20 respostas do Gemini, o domínio semrush.com ocupou 44 lugares, o maxaeo.ai vinte e seis, o google.com vinte e dois, o adobe.com vinte e um e o medium.com vinte. A contagem alta de anotações nessa superfície diz respeito a quão fino é o fatiamento do modelo, não a quão conhecida é a sua marca.
Já o Perplexity expõe um painel com teto. Ele devolveu exatamente vinte fontes em 19 dos 20 prompts e dezenove no vigésimo. Isso fixa o denominador: sua fatia numa resposta do Perplexity é sempre uma fatia de vinte, então conquistar um lugar significa que alguém perdeu um lugar em outro lugar.
O ChatGPT só devolve lista de fontes quando pesquisou. Ele disparou uma consulta de busca em 8 dos 20 prompts e não citou nada nos outros doze. Nesses doze, ainda assim respondeu à pergunta e ainda assim nomeou ferramentas. Um exemplo sem edição: ao ser perguntado sobre as melhores ferramentas para acompanhar menções de marca nos resultados de busca de IA, ele listou Brand24, Mention, BuzzSumo, Talkwalker e Google Alerts, sem nenhuma fonte anexada a qualquer uma delas. A checklist que usamos para auditar respostas do ChatGPT em busca desse modo de falha está em checklist de visibilidade no ChatGPT.
Nomeada sem ser citada
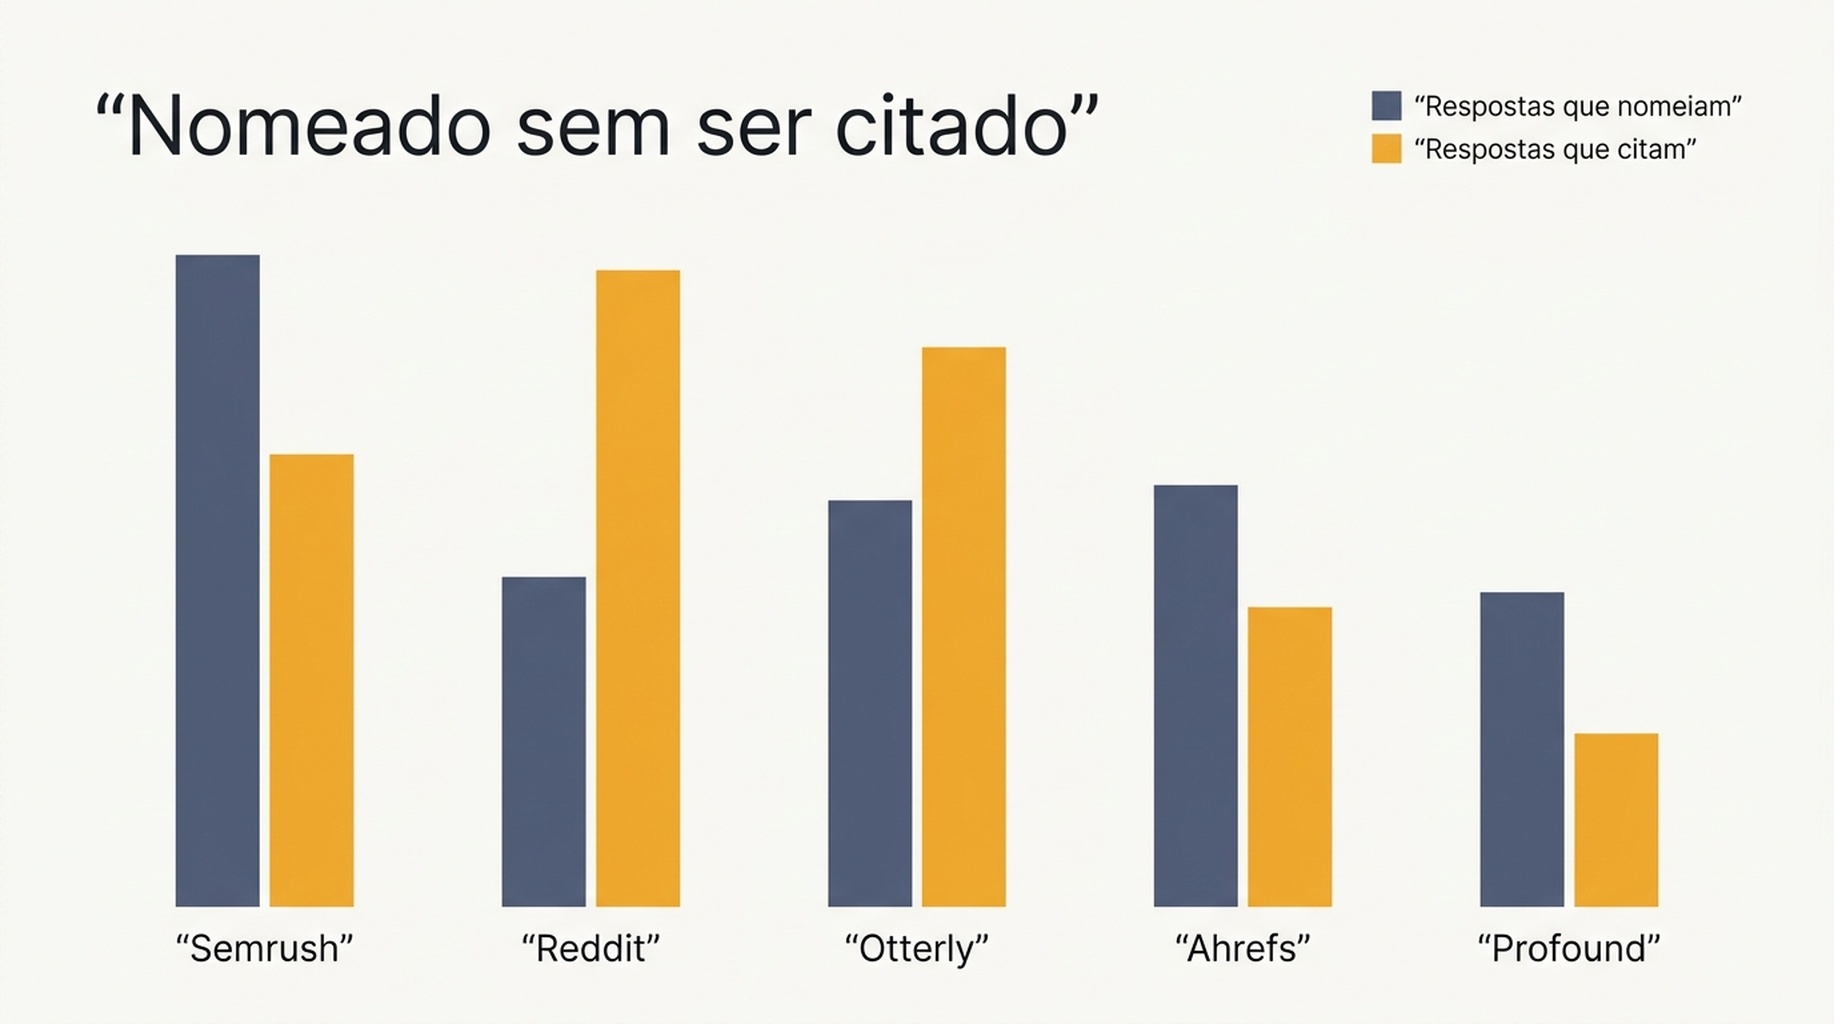
Em seguida contamos, para 27 marcas e veículos, em quantas das 60 respostas a marca foi nomeada no texto e em quantas o domínio dela foi citado como fonte. As duas colunas divergem nos dois sentidos ao mesmo tempo.
Marca | Respostas que a nomearam | Respostas que citaram o domínio |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
Há dois padrões nesta tabela. Peec AI, Otterly, Profound e ZipTie são recomendadas nas respostas muito mais vezes do que suas páginas são linkadas. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps e Menra são o oposto: suas páginas são arrastadas como fontes enquanto a resposta nunca nomeia a empresa. Um verificador que olha só para links julga o segundo grupo visível e o primeiro invisível. Um verificador que olha só para menções faz o contrário.
Ao longo das 60 respostas, as três superfícies juntas citaram 432 domínios distintos. O ChatGPT responde por 47 deles, ou 11 por cento, o Gemini por 184 (43 por cento) e o Perplexity por 285 (66 por cento). Seja qual for a superfície que você verificar, está olhando para uma amostra de um universo de fontes muito maior. Isso não inclui a própria superfície do Google, onde a presença é medida de outra forma, e explicamos isso no rastreador de AI Overview.
O que um verificador precisa registrar
Um verificador de visibilidade que devolve um único número está jogando fora três dos seus quatro campos. Estes são os quatro que vale manter.
Campo | Forma de registro | Por que isso muda o veredicto |
|---|---|---|
A superfície pesquisou | sim ou não | Uma resposta que não pesquisou não pode gerar citações, então o zero dela não é sinal de visibilidade |
A marca foi nomeada no texto da resposta | número de respostas | O único sinal que sobrevive numa resposta sem fundamentação |
O domínio está na lista de fontes | número de respostas | O sinal que a maioria das ferramentas reporta sozinho |
O denominador | número de respostas e número de lugares de fonte por resposta | Um painel com vinte lugares fixos e uma lista com 47 anotações não podem ser comparados como porcentagem |
A consequência prática é o zero falso. Nos nossos dados, 13 das 20 respostas do ChatGPT nomearam ao menos um fornecedor, enquanto só 8 de 20 citaram qualquer coisa, ou seja, cerca de um quarto das respostas dessa superfície vai reportar zero citações para uma marca que a mesma resposta nomeou e recomendou.
Como fazer isso sem enganar a si mesmo
O modo de falha quando você entrega esse trabalho a um agente não é um número errado, e sim um número confiante calculado a partir de um campo que nunca foi coletado.
- Capture a carga bruta antes de calcular qualquer coisa. Guarde o texto da resposta, a lista de fontes, o identificador do modelo e um valor booleano de se uma consulta de busca foi disparada. Métricas derivadas se constroem no código numa segunda etapa, não se colocam dentro do prompt de coleta.
- Faça o agente citar em vez de resumir. Uma rubrica do tipo "reporte quantas vezes a marca apareceu" produz prosa. Uma rubrica do tipo "devolva literalmente o texto da resposta e a lista de fontes" produz dados que você consegue conferir de novo.
- Rode o mesmo prompt outra vez antes de acreditar numa mudança. Repetimos cinco prompts e a decisão de pesquisar bateu em 5 de 5, ou seja, um salto repentino no número de citações é mais provavelmente versão de modelo ou edição de prompt do que ruído.
- Mantenha o identificador do modelo em cada linha. Os mesmos vinte prompts no mesmo endpoint via gpt-4o devolveram anotações de fonte em apenas 2 de 20, contra 8 de 20 no gpt-5.
- Reserve orçamento. A execução completa de 60 respostas custou 1,444 dólar, então, nesses preços, uma versão semanal da mesma checagem fica em cerca de 6 dólares por mês.
Limitações
- Um dia, uma região, inglês, três superfícies. As respostas variam de região para região.
- Uma versão de modelo por superfície. Mesmo nas nossas próprias execuções o comportamento se deslocou entre versões de modelo.
- A detecção de marcas é correspondência de texto pelo nome, então uma marca recomendada apenas pelo nome do produto pode passar batido.
- A busca na web foi ligada via API. Aplicativos de consumidor podem pesquisar mais do que essas execuções, ou menos.
- O custo cobre apenas a geração das respostas e não inclui tempo de armazenamento ou revisão.
Perguntas frequentes
Por que o ChatGPT reportou zero citações em 12 dos 20 prompts?
Porque respondeu a esses prompts sem pesquisar. Um modelo que nunca busca uma página não pode citá-la. Aquele zero descreve a execução, não a sua marca. Antes de ler um número de citações de qualquer superfície de chat, confirme primeiro se aquela superfície usou a web.
Uma menção tem valor se não houver link nenhum?
Numa resposta sem fundamentação, ela é o sinal inteiro, e é também o sinal que vem antes do link. Nos nossos dados, menção e link são conquistados a partir de fontes diferentes: a menção segue conteúdo comparativo e de review, e a citação segue páginas estruturadas para serem citadas.
Devo fundir menções e citações num único score de visibilidade?
Não. Como a tabela de marcas mostra, elas divergem sistematicamente nos dois sentidos, e um score fundido esconde qual dos dois se moveu. Reporte os dois como linhas separadas e deixe o leitor ver a lacuna.
Qual superfície devo verificar primeiro?
Se você quer um painel estável, barato e de largura fixa, escolha o Perplexity, porque o comprimento da lista dele não muda. Se você quer amplitude, escolha o Gemini, que alcançou 184 dos 432 domínios que vimos. O ChatGPT só com uma checagem de plausibilidade junto, senão um quinto das respostas dele será lido como marca invisível.
Visão da Auspia: reporte menções e citações como duas linhas separadas e registre se a superfície pesquisou antes de registrar qualquer outra coisa. Um score único de visibilidade esconde exatamente a lacuna que diz o que consertar em seguida, e o conserto mais barato nos nossos dados não foi adicionar conteúdo, e sim verificar uma superfície que realmente olhou para a web.
Autor: Adrian Cole