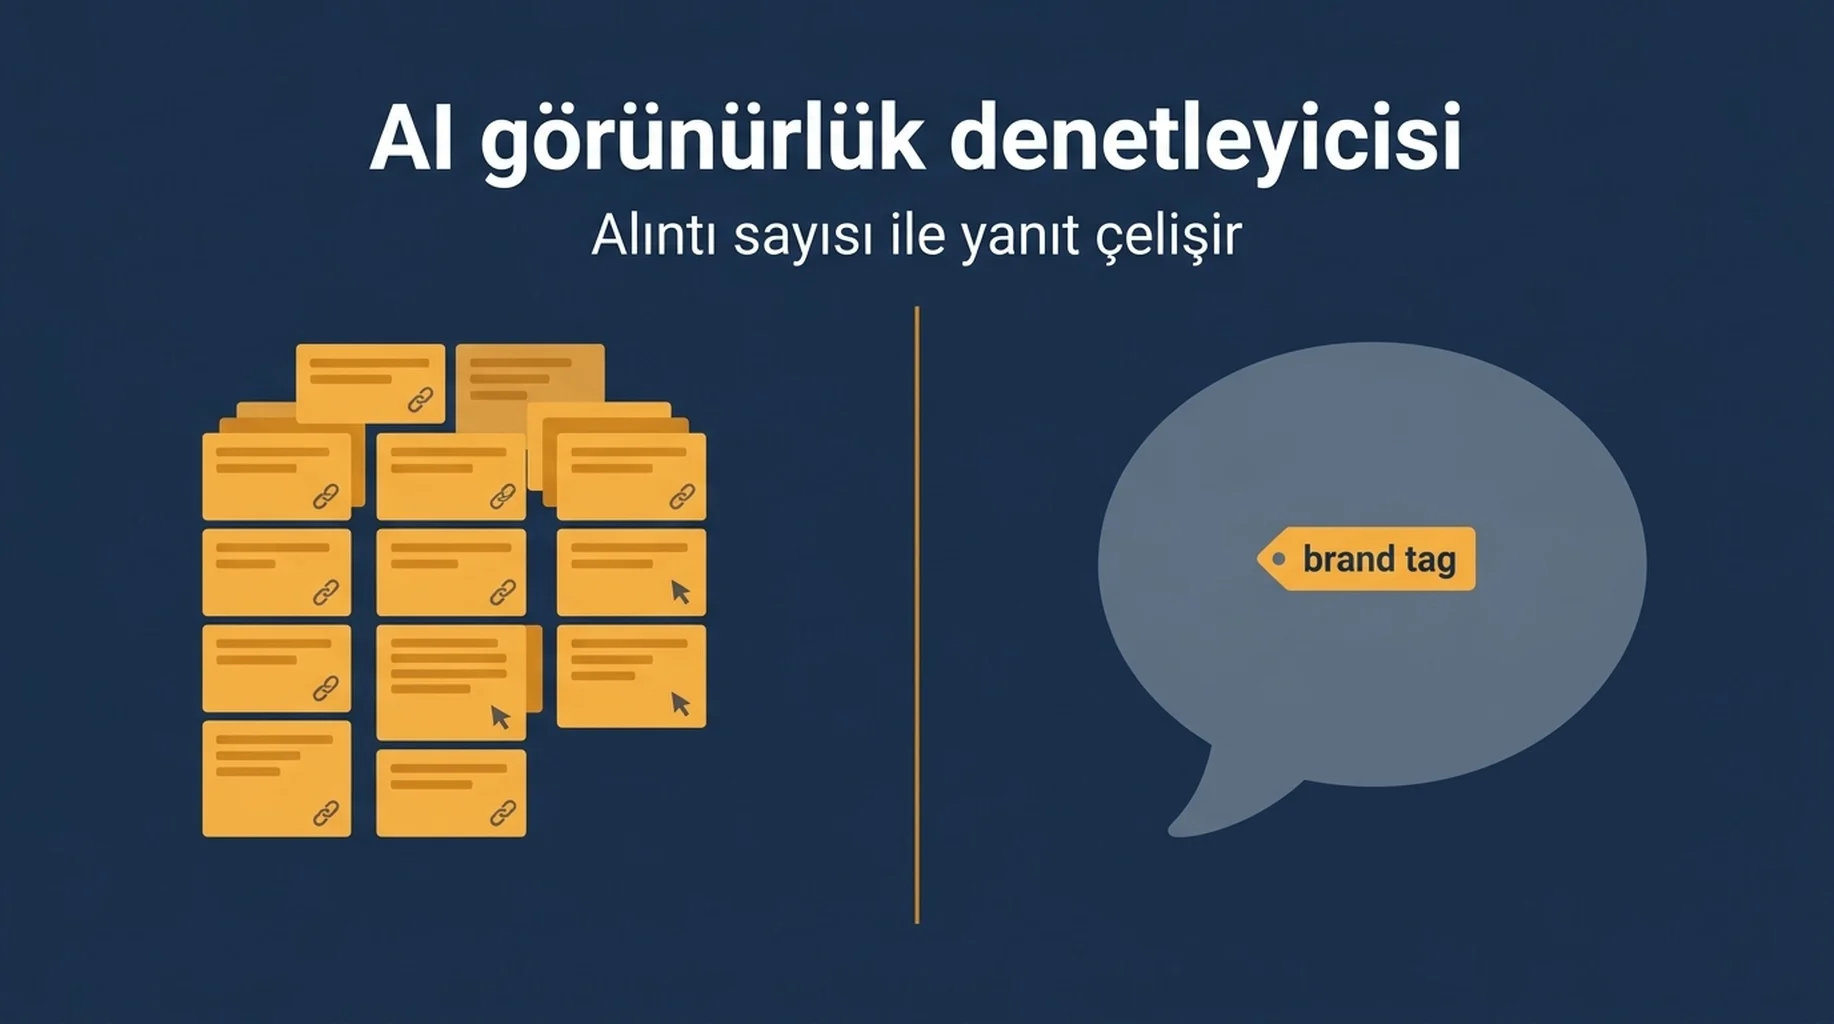
İki yapay zekâ görünürlük denetleyicisi aynı gün aynı yanıtları okuyup birbirine zıt kararlar verebilir. Biri alıntı sayısını döndürür, diğeri hiçbir şey döndürmez; çünkü yanıt markanızı adıyla anmış ve önermiş, ama ona bir kez bile bağlantı vermemiştir.
Eylül 2026'da yirmi istemi üç yapay zekâ yüzeyinde çalıştırdık ve her yanıtta iki sinyali kaydettik: yanıtın metin içinde adını andığı marka ve yanıtın kaynak olarak sunduğu alan adı. Bunlar tek bir ölçümün iki açısı değil. Öngörülebilir yerlerde ayrışıyorlar ve ayrıştıkları yerler raporun en faydalı kısmı.
Kısa hâliyle: Perplexity her istemde kaynak gösterdi, Gemini yanıt başına medyan 47 kaynak döndürdü, ChatGPT ise 20 istemin 12'sinde hiç alıntı döndürmedi, buna rağmen 13'ünde sağlayıcı adı verdi. Tek bir yüzeyde koşular arasındaki oynaklık ayrı bir konudur ve onu daha önce yapay zekâ görünürlük izleyicisinin koşu oynaklığı yazısında ölçtük.
Neyi çalıştırdık
Kalem | Ayar |
|---|---|
İstemler | Bir alıcının yapay zekâ görünürlük araçları hakkında soracağı yirmi soru |
Yüzeyler | ChatGPT (gpt-5-2025-08-07), Gemini (gemini-2.5-flash), Perplexity (sonar) |
Web araması | Üç yüzeyde de açık |
Bölge ve dil | Amerika Birleşik Devletleri, İngilizce |
Tarih | 12 Eylül 2026 |
Toplanan yanıtlar | 60 |
Tüm koşunun maliyeti | 1.444 dolar, yani yanıt başına 0,024 dolar |
Tekrar koşusu | Davranışın kararlı olup olmadığını görmek için aynı beş istemi yeniden çalıştırdık |
Yanıt başına maliyet Perplexity'de 0,006 dolardan Gemini'de 0,037 dolara kadar uzandı. En ucuz yüzey en tutarlı kaynak listesini üretti ve en pahalı yüzey en çok kaynak döndüren yüzey olmadı.
İki sinyali ayrı ayrı ölçmek
Her yanıtı iki kez yakaladık: bir kez metin olarak, bir kez de yüzeyin o metne eklediği kaynak listesi olarak.
Yüzey | Kaynak etiketi | Yanıt başına | Alıntısız yanıt | Yanıt başına farklı alan adı |
|---|---|---|---|---|
ChatGPT (gpt-5) | 90 | 0 ile 18 arası, medyan 0 | 20'nin 12'si | 0 ile 10 arası |
Gemini 2.5 Flash | 989 | 14 ile 122 arası, medyan 47 | 20'nin 0'ı | 3 ile 23 arası |
Perplexity | 399 | 19 ile 20 arası | 20'nin 0'ı | 16 ile 20 arası |
Bu üç liste aynı türden nesneler değil ve denetleyicinin ilk yanıldığı yer tam burası.
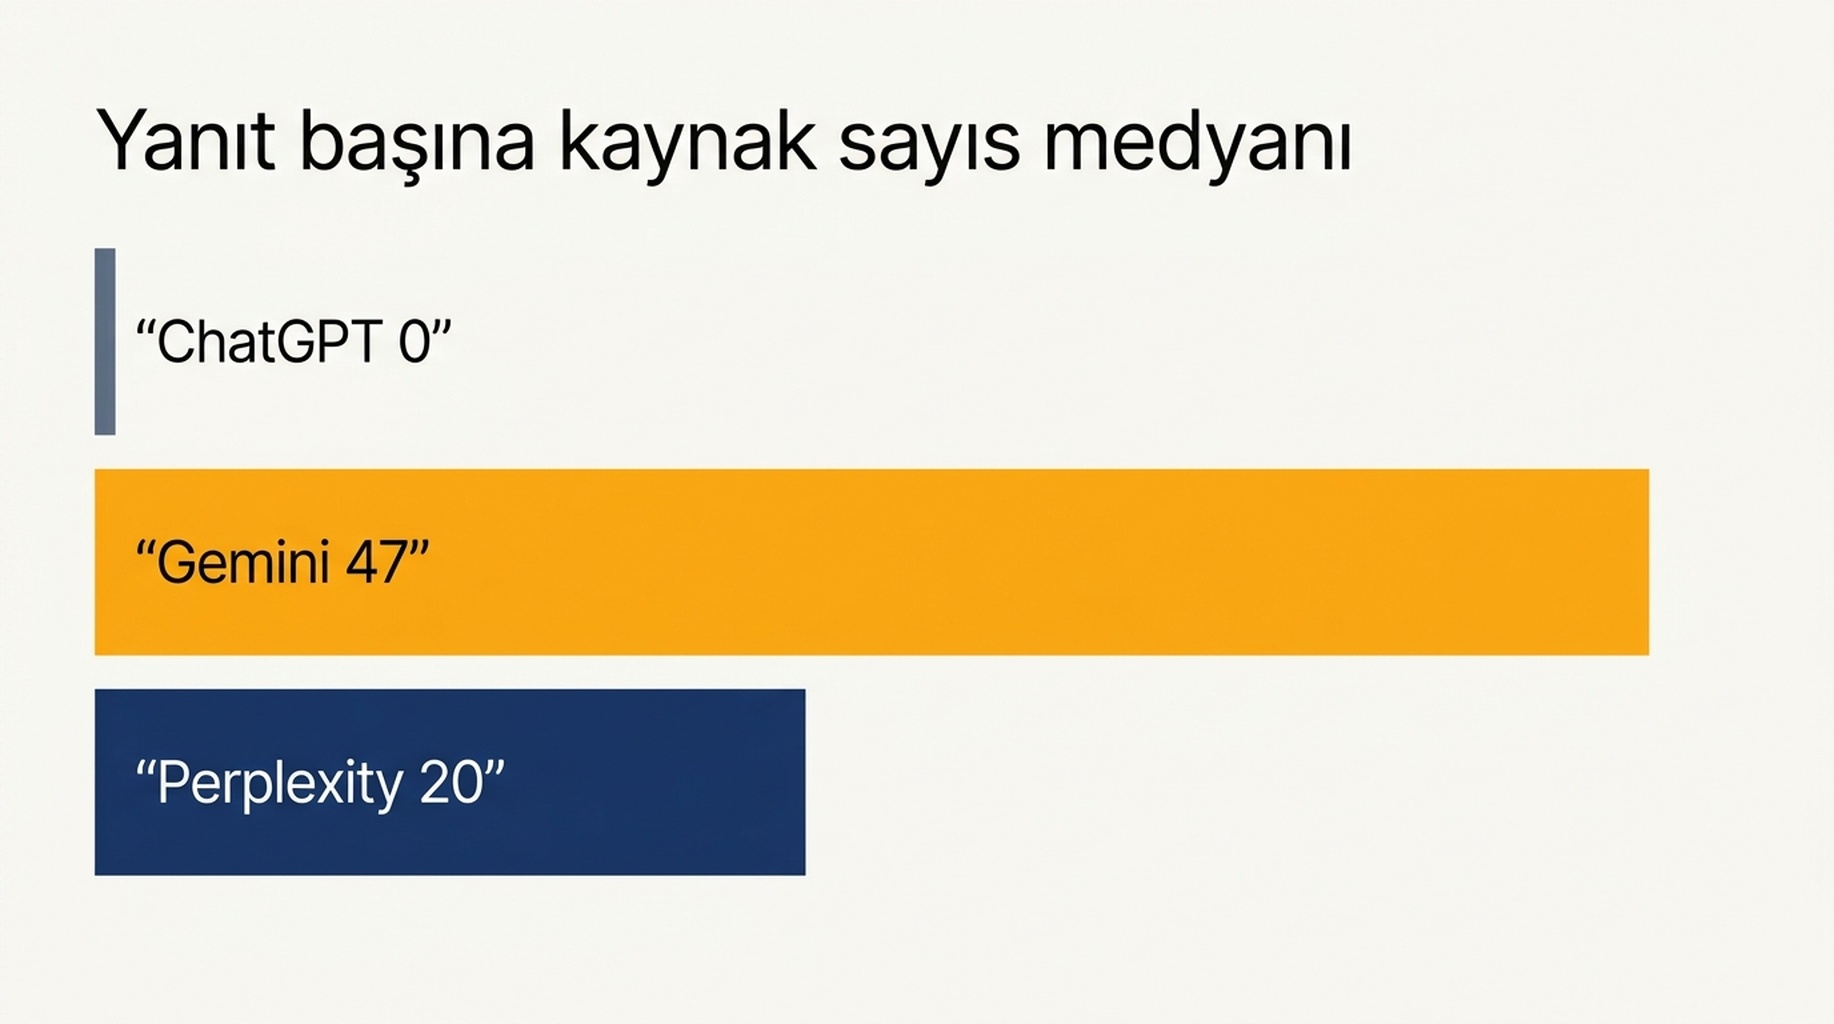
Gemini neredeyse her iddiaya bir kaynak ekliyor. Aynı sayfa tek bir yanıt içinde pek çok yer tutabiliyor ve sayıların bu kadar yüksek olmasının sebebi bu: 20 Gemini yanıtı boyunca semrush.com 44 yer, maxaeo.ai yirmi altı, google.com yirmi iki, adobe.com yirmi bir ve medium.com yirmi yer tuttu. Bu yüzeydeki yüksek etiket sayısı, modelin malzemeyi ne kadar ince ayrıştırdığını anlatır; markanızın ne kadar bilindiğini değil.
Perplexity ise tavanı olan bir panel sunuyor. 20 istemin 19'unda tam yirmi kaynak döndürdü, yirmincisinde on dokuz. Bu, paydayı sabitliyor: bir Perplexity yanıtındaki payınız her zaman yirmide bir pay, yani bir yer kazanmak, birinin başka yerde bir yer kaybetmesi demek.
ChatGPT ise yalnızca aradığı zaman kaynak listesi döndürüyor. 20 istemin 8'inde arama sorgusu gönderdi, kalan on ikisinde hiçbir şey alıntılamadı. O on ikide de soruyu yanıtladı ve araç adı verdi. Düzenlenmemiş bir örnek: yapay zekâ arama sonuçlarında marka anmalarını izlemek için en iyi araçlar sorulduğunda Brand24, Mention, BuzzSumo, Talkwalker ve Google Alerts sıraladı ve hiçbirine kaynak eklemedi. Bu arıza biçimi için ChatGPT yanıtlarını denetlerken kullandığımız kontrol listesi ChatGPT görünürlük kontrol listesi yazısında.
Alıntılanmadan adı anılmak
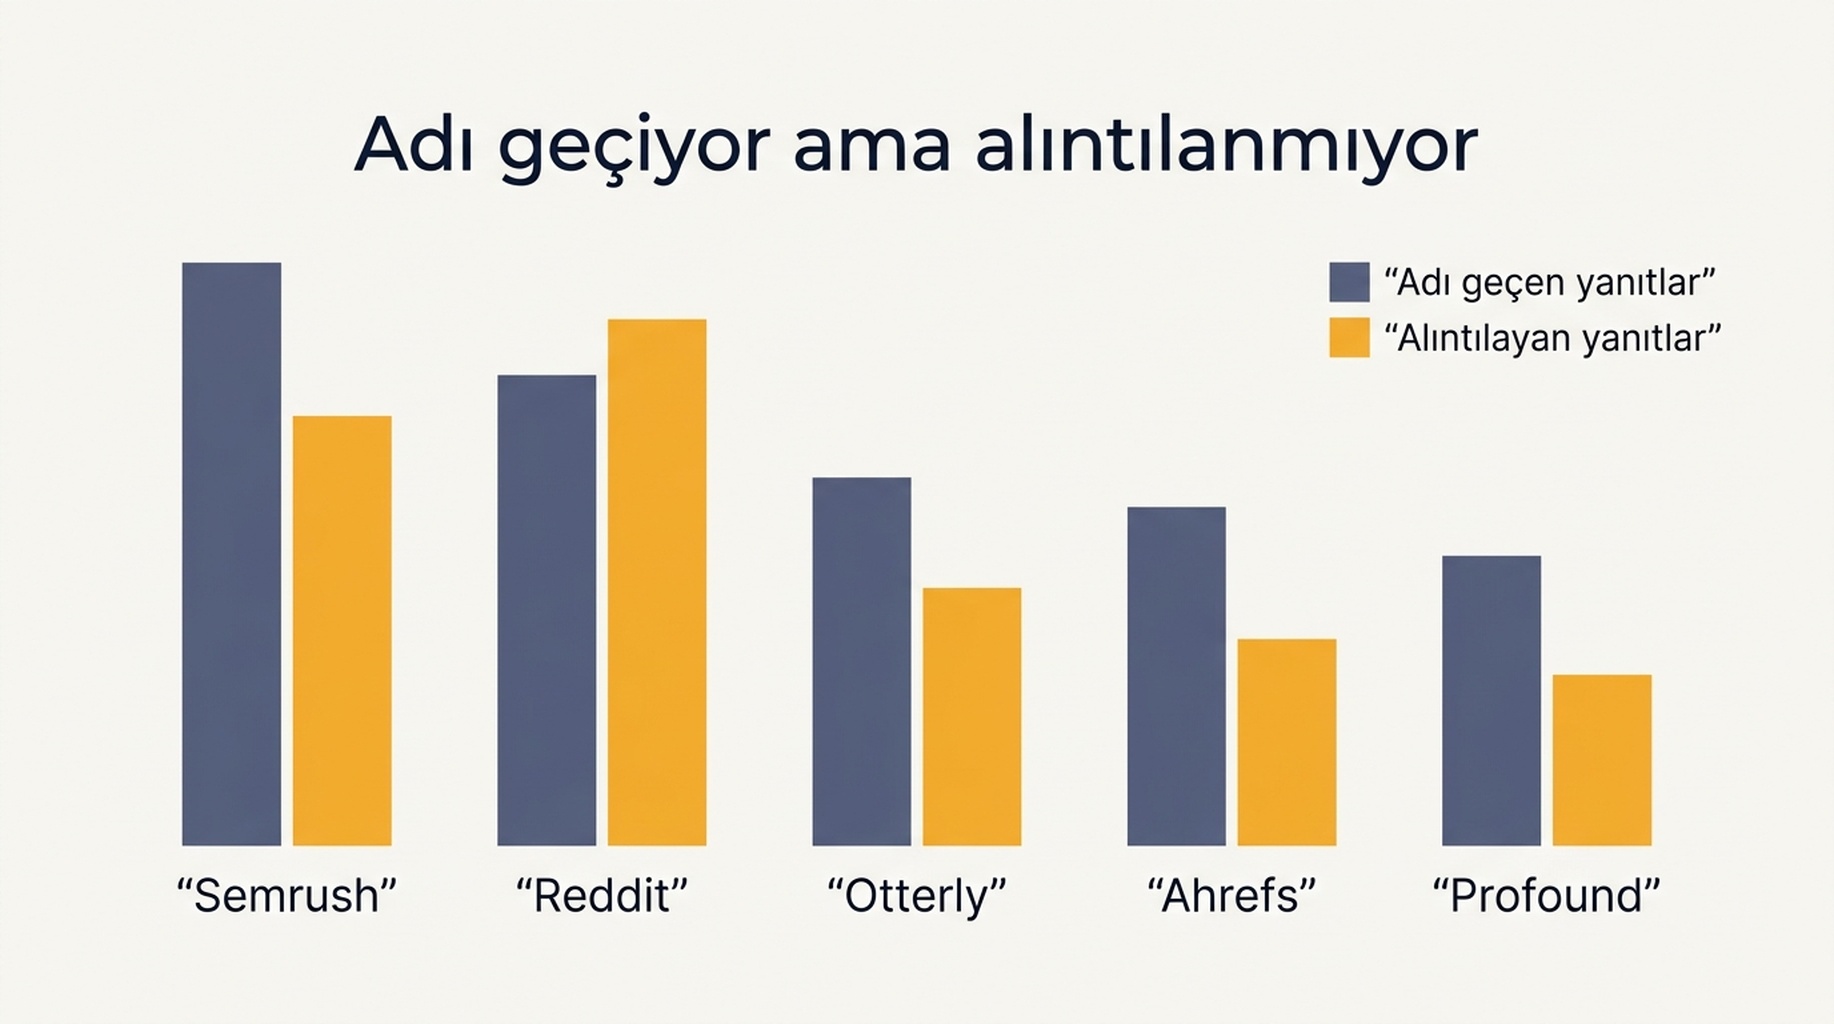
Ardından 27 marka ve yayın için, 60 yanıtın kaçında markanın metin içinde anıldığını ve kaçında alan adının kaynak olarak alıntılandığını saydık. İki sütun aynı anda iki yöne birden ayrışıyor.
Marka | Adını anan yanıt | Alan adını alıntılayan yanıt |
|---|---|---|
Semrush | 18 | 15 |
16 | 14 | |
Otterly | 14 | 6 |
Ahrefs | 13 | 16 |
Profound | 11 | 6 |
Peec AI | 11 | 2 |
Frase | 5 | 9 |
HubSpot | 5 | 8 |
ZipTie | 5 | 0 |
Siftly | 4 | 5 |
Keyword.com | 4 | 5 |
Nightwatch | 3 | 4 |
LLM Pulse | 2 | 6 |
Cognizo | 1 | 6 |
MaxAEO | 1 | 7 |
Searchable | 1 | 5 |
AirOps | 0 | 5 |
Menra | 0 | 4 |
Bu tabloda iki örüntü var. Peec AI, Otterly, Profound ve ZipTie, sayfalarına bağlantı verilme sıklığından çok daha fazla yanıtlarda öneriliyor. MaxAEO, Cognizo, LLM Pulse, Searchable, AirOps ve Menra ise tersi: sayfaları kaynak olarak içeri çekiliyor, ama yanıt şirket adını hiç anmıyor. Yalnızca bağlantılara bakan bir denetleyici ikinci grubu görünür, birinci grubu görünmez sayar. Yalnızca anmalara bakan bir denetleyici ise tersini yapar.
60 yanıtın tamamında üç yüzey birlikte 432 farklı alan adı alıntıladı. Bunun 47'si ChatGPT'ye, yani yüzde 11'ine, 184'ü Gemini'ye (yüzde 43) ve 285'i Perplexity'ye (yüzde 66) ait. Hangi yüzeyi denetlerseniz denetleyin, çok daha büyük bir kaynak evreninden bir örnek görüyorsunuz. Buna Google'ın kendi yüzeyi dâhil değil; oradaki varlık başka bir yolla ölçülüyor ve bunu AI Overview izleyicisi yazısında anlatıyoruz.
Bir denetleyicinin kaydetmesi gerekenler
Tek bir sayı döndüren bir görünürlük denetleyicisi, dört alanının üçünü atıyor. Saklamaya değer dört alan şunlar.
Alan | Kayıt biçimi | Kararı neden değiştirir |
|---|---|---|
Yüzey aradı mı | evet ya da hayır | Aramayan bir yanıt alıntı üretemez, dolayısıyla sıfırı görünürlük sinyali değildir |
Marka yanıt metninde anıldı mı | yanıt sayısı | Gerekçesiz bir yanıtta hayatta kalan tek sinyal |
Alan adı kaynak listesinde var mı | yanıt sayısı | Çoğu aracın tek başına bildirdiği sinyal |
Payda | yanıt sayısı ve yanıt başına kaynak yeri | Yirmi yeri sabitlenmiş bir panel ile 47 etiketli bir liste yüzde olarak karşılaştırılamaz |
İşin pratik sonucu sahte sıfır. Verimizde ChatGPT'nin 20 yanıtının 13'ü en az bir sağlayıcı adı verdi, ama yalnızca 20'nin 8'i herhangi bir şey alıntıladı; yani bu yüzeyin yanıtlarının yaklaşık dörtte biri, aynı yanıtın adını anıp önerdiği bir marka için sıfır alıntı bildirecek.
Kendini kandırmadan bunu nasıl yaparsın
Bu işi bir ajana verdiğinde arıza biçimi yanlış bir sayı değil, hiç toplanmamış bir alandan hesaplanmış kendinden emin bir sayıdır.
- Bir şey hesaplamadan önce ham yükü yakala. Yanıt metnini, kaynak listesini, model kimliğini ve arama sorgusunun gönderilip gönderilmediğini belirten bir doğru-yanlış değerini sakla. Türetilmiş ölçütler ikinci aşamada kod içinde kurulur, toplama isteminin içine konmaz.
- Ajana özetlettirme, alıntılat. "Marka kaç kez geçti bildir" ölçütü düzyazı üretir. "Yanıt metnini ve kaynak listesini harfi harfine döndür" ölçütü yeniden denetleyebileceğin veri üretir.
- Bir değişikliğe inanmadan önce aynı istemi yeniden çalıştır. Beş istemi tekrarladık ve arama kararı 5'te 5 uyuştu; yani alıntı sayısındaki ani sıçrama gürültüden çok bir model sürümü ya da istem düzenlemesidir.
- Model kimliğini her satırda tut. Aynı yirmi istem aynı uç noktada gpt-4o ile yalnızca 20'de 2 kaynak etiketi döndürdü; gpt-5 ile 20'de 8.
- Bütçe ayır. 60 yanıtlık tam koşu 1.444 dolara mal oldu; bu fiyatlarla aynı denetimin haftalık sürümü ayda yaklaşık 6 dolar eder.
Sınırlar
- Tek gün, tek bölge, İngilizce, üç yüzey. Yanıtlar bölgeden bölgeye değişiyor.
- Yüzey başına tek model sürümü. Kendi koşularımızda bile davranış model sürümleri arasında kaydı.
- Marka tespiti ada göre dize eşleştirmesi, yani yalnızca ürün adıyla önerilen bir marka gözden kaçabilir.
- Web araması API üzerinden açıldı. Tüketici uygulamaları bu koşulardan daha çok ya da daha az arayabilir.
- Maliyet yalnızca yanıt üretimini kapsıyor; saklama ya da gözden geçirme süresini içermiyor.
Sık sorulan sorular
ChatGPT 20 istemin 12'sinde neden sıfır alıntı bildirdi?
Çünkü o istemleri aramadan yanıtladı. Bir sayfayı hiç getirmeyen bir model onu alıntılayamaz. Yani o sıfır koşuyu anlatıyor, markanızı değil. Herhangi bir sohbet yüzeyinden alıntı sayısı okumadan önce, o yüzeyin gerçekten web kullanıp kullanmadığını denetle.
Bağlantı hiç yoksa adı anılmanın bir değeri var mı?
Gerekçesiz bir yanıtta sinyalin tamamı odur ve ayrıca bağlantıdan önce gelen sinyal de odur. Verimizde anma ve bağlantı farklı kaynaklardan kazanılıyor: anma karşılaştırma ve inceleme içeriğini izliyor, alıntı ise alıntılanmak üzere yapılandırılmış sayfaları.
Anmalarla alıntıları tek bir görünürlük puanında birleştirmeli miyim?
Hayır. Marka tablosunun gösterdiği gibi ikisi iki yönde de sistematik olarak ayrışıyor ve birleştirilmiş puan hangisinin kıpırdadığını saklıyor. İkisini iki ayrı çizgi olarak bildir ve aradaki farkı okuyucunun görmesini sağla.
Önce hangi yüzeyi denetlemeliyim?
Kararlı, ucuz ve genişliği sabit bir panel istiyorsan Perplexity'yi seç, çünkü liste uzunluğu değişmiyor. Genişlik istiyorsan Gemini'yi seç; gördüğümüz 432 alan adının 184'üne ulaştı. ChatGPT'yi ise yalnızca yanına bir tutarlılık kontrolü koyarak kullan, yoksa yanıtlarının beşte biri görünmez bir marka olarak okunur.
Auspia görüşü: anmaları ve alıntıları iki ayrı çizgi olarak bildir ve başka herhangi bir şeyi kaydetmeden önce yüzeyin arayıp aramadığını kaydet. Tek bir görünürlük puanı, sırada neyi düzelteceğini söyleyen o farkı tam olarak saklar; verimizdeki en ucuz düzeltme ise içerik eklemek değil, gerçekten web'e bakmış bir yüzeyi denetlemekti.
Yazan: Adrian Cole