สิ่งที่คุณจะได้หลังทำคู่มือนี้จบ
เมื่อจบคู่มือนี้ โดเมน Cloudflare ของคุณจะมีนโยบายที่ชัดเจนและตั้งใจกำหนดเองสำหรับสามหมวดหมู่ของทราฟฟิกบอท AI แยกจากกัน ได้แก่ ค้นหา (Search) เอเจนต์ (Agent) และการเทรน (Training) แทนที่จะเป็นค่าเริ่มต้นที่โดเมนของคุณได้รับมา คุณจะรู้แน่ชัดว่าบอทตัวใดได้รับอนุญาต ตัวใดถูกบล็อก และบล็อกบนหน้าใด พร้อมทั้งไฟล์ robots.txt และกฎการบังคับใช้ที่ edge จะสอดคล้องกันจริง
คู่มือนี้เหมาะกับใคร: ทุกคนที่ดูแลเว็บไซต์ซึ่งวิ่งผ่าน Cloudflare — สำนักข่าว เว็บการตลาดของ SaaS ร้านอีคอมเมิร์ซ บล็อก — และต้องการตัดสินใจเองว่าระบบ AI จะเทรน สรุป หรือเรียกดูเนื้อหาผ่านเอเจนต์ได้หรือไม่ แทนที่จะรับค่าที่แพลตฟอร์มตั้งไว้ให้
สิ่งที่ต้องมีก่อนเริ่ม:
- โดเมนที่พร็อกซีผ่าน Cloudflare (แพ็กเกจใดก็ได้รวมถึง Free โดยบางขั้นตอนในคู่มือนี้จำกัดเฉพาะแพ็กเกจแบบเสียเงิน ซึ่งจะระบุไว้)
- สิทธิ์เข้าแดชบอร์ดอย่างน้อยระดับที่แก้ไขการตั้งค่าความปลอดภัยของโดเมนได้
- เวลาประมาณ 20 ถึง 30 นาทีสำหรับตรวจสอบและตั้งค่า จากนั้นใช้เวลาไม่กี่นาทีต่อวันหรือต่อสัปดาห์ในการเฝ้าดู
นิยามของความสำเร็จ: การตั้งค่าความปลอดภัยของโซนคุณแสดงตัวเลือกที่คุณจงใจเลือก (ไม่ใช่ค่าเริ่มต้นที่ยังไม่ได้ตรวจ) สำหรับหมวดค้นหา เอเจนต์ และการเทรน; ไฟล์ /robots.txt ที่ให้บริการจริงสะท้อนตัวเลือกนั้น; และคุณยืนยันแล้วใน AI Crawl Control ว่าบอทที่ควรถูกบล็อกนั้นถูกบล็อกจริง
ทำไมเรื่องนี้เพิ่งกลายเป็นเรื่องสำคัญ: สิ่งที่เปลี่ยนไปเมื่อวันที่ 15 กันยายน
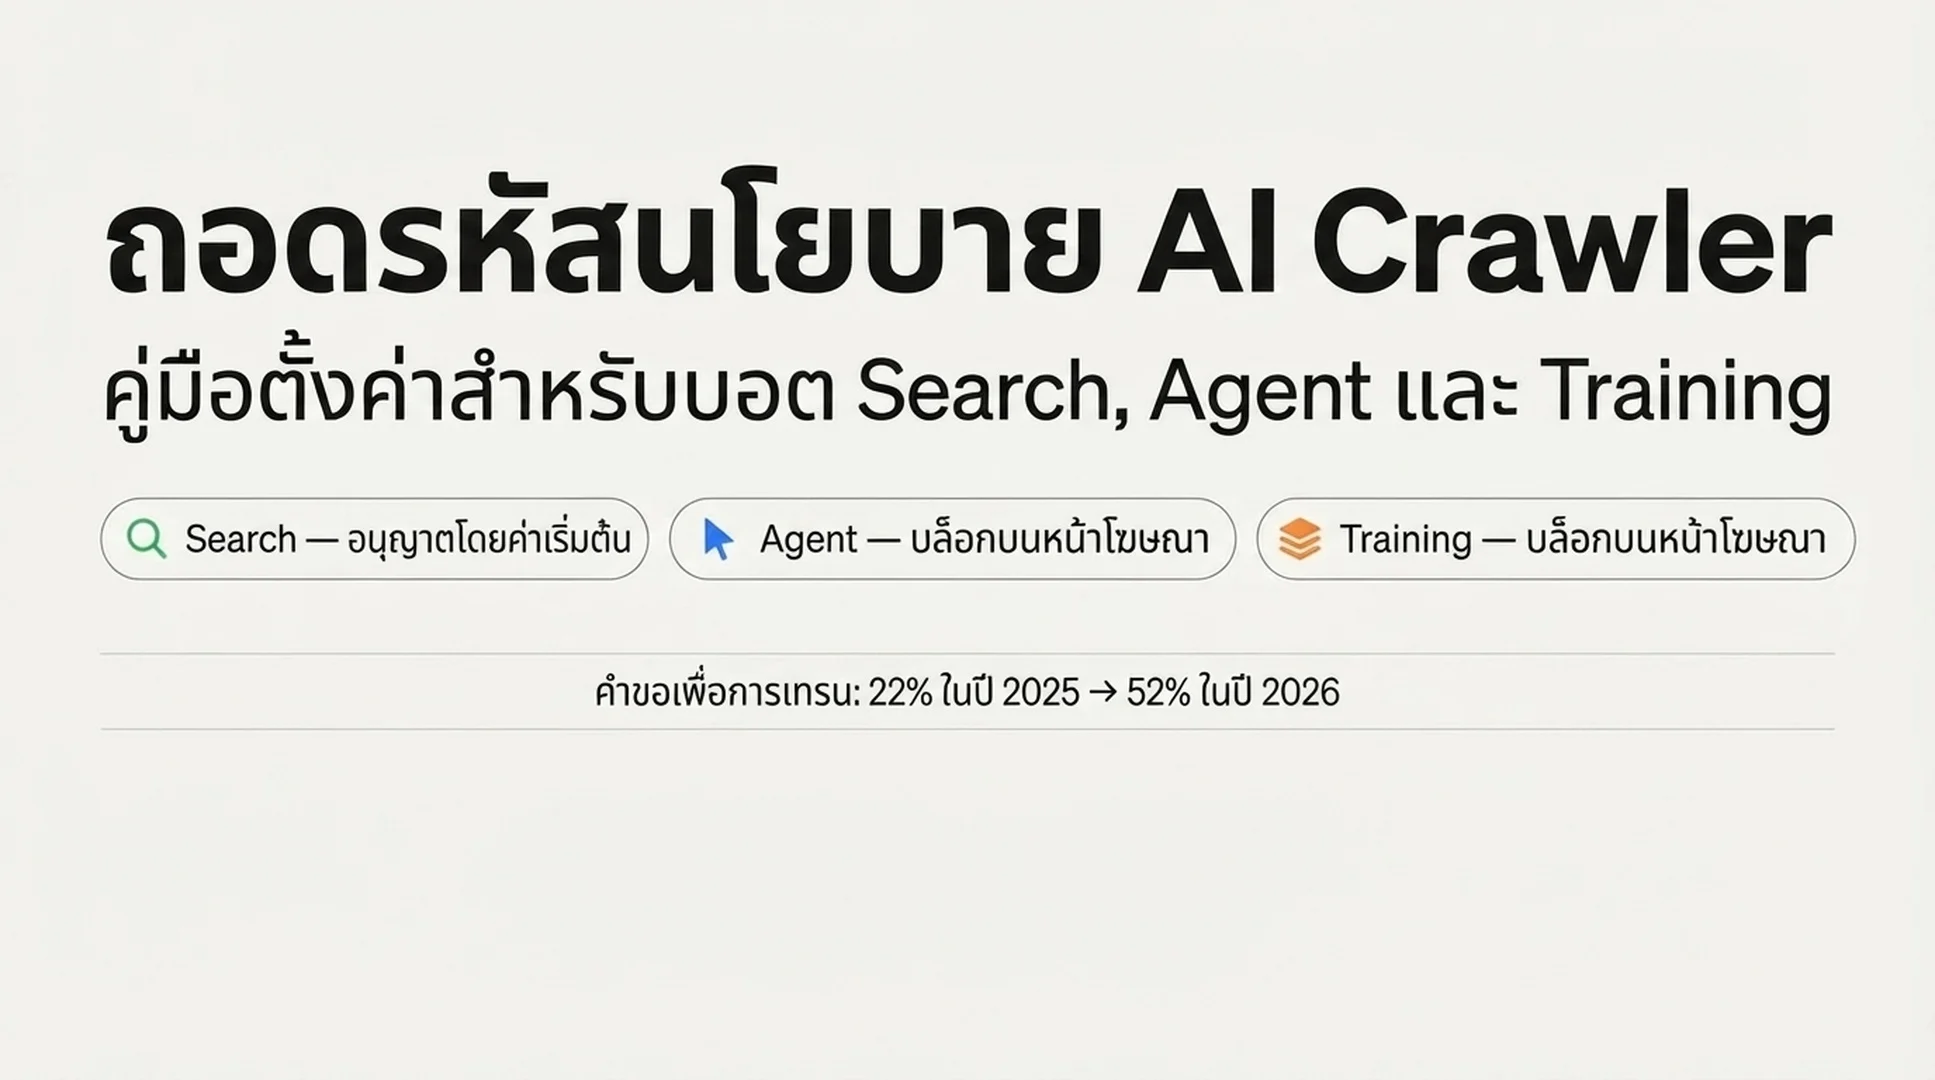
Cloudflare ค่อย ๆ สร้างชุดเครื่องมือควบคุมทราฟฟิก AI ขึ้นมาทีละขั้น เริ่มจากเพิ่ม Content Signals Policy ลงใน robots.txt เมื่อเดือนกันยายน 2025 และมาถึงการเปิดตัว "Content Independence Day" เมื่อวันที่ 1 กรกฎาคม 2026 ซึ่งเป็นครั้งแรกที่แยกพฤติกรรมบอท AI ออกเป็นสามหมวดหมู่ที่มีชื่อเรียก แทนสวิตช์หยาบ ๆ แบบ "เป็น AI หรือไม่เป็น AI" เพียงตัวเดียว:
- ค้นหา (Search) — การครอว์ลที่สร้างดัชนีค้นหา แล้วคืนลิงก์หรือข้อความตัดตอนสั้น ๆ กลับมา ภาษาของ Cloudflare คือทราฟฟิกประเภทนี้ควรนำการอ้างอิงมาสู่คุณ
- เอเจนต์ (Agent) — กิจกรรมอัตโนมัติที่กระทำการแทนคนแบบทันทีทันใด เช่น ผู้ช่วยแชทกำลังดึงหน้าเว็บ หรือเบราว์เซอร์เอเจนต์กำลังทำภารกิจให้เสร็จ
- การเทรน (Training) — การครอว์ลเพื่อฝึกหรือปรับแต่งโมเดล ซึ่งเนื้อหาของคุณถูกดูดซับถาวรเข้าไปในค่าน้ำหนักของโมเดล แทนที่จะคืนกลับมาเป็นลิงก์
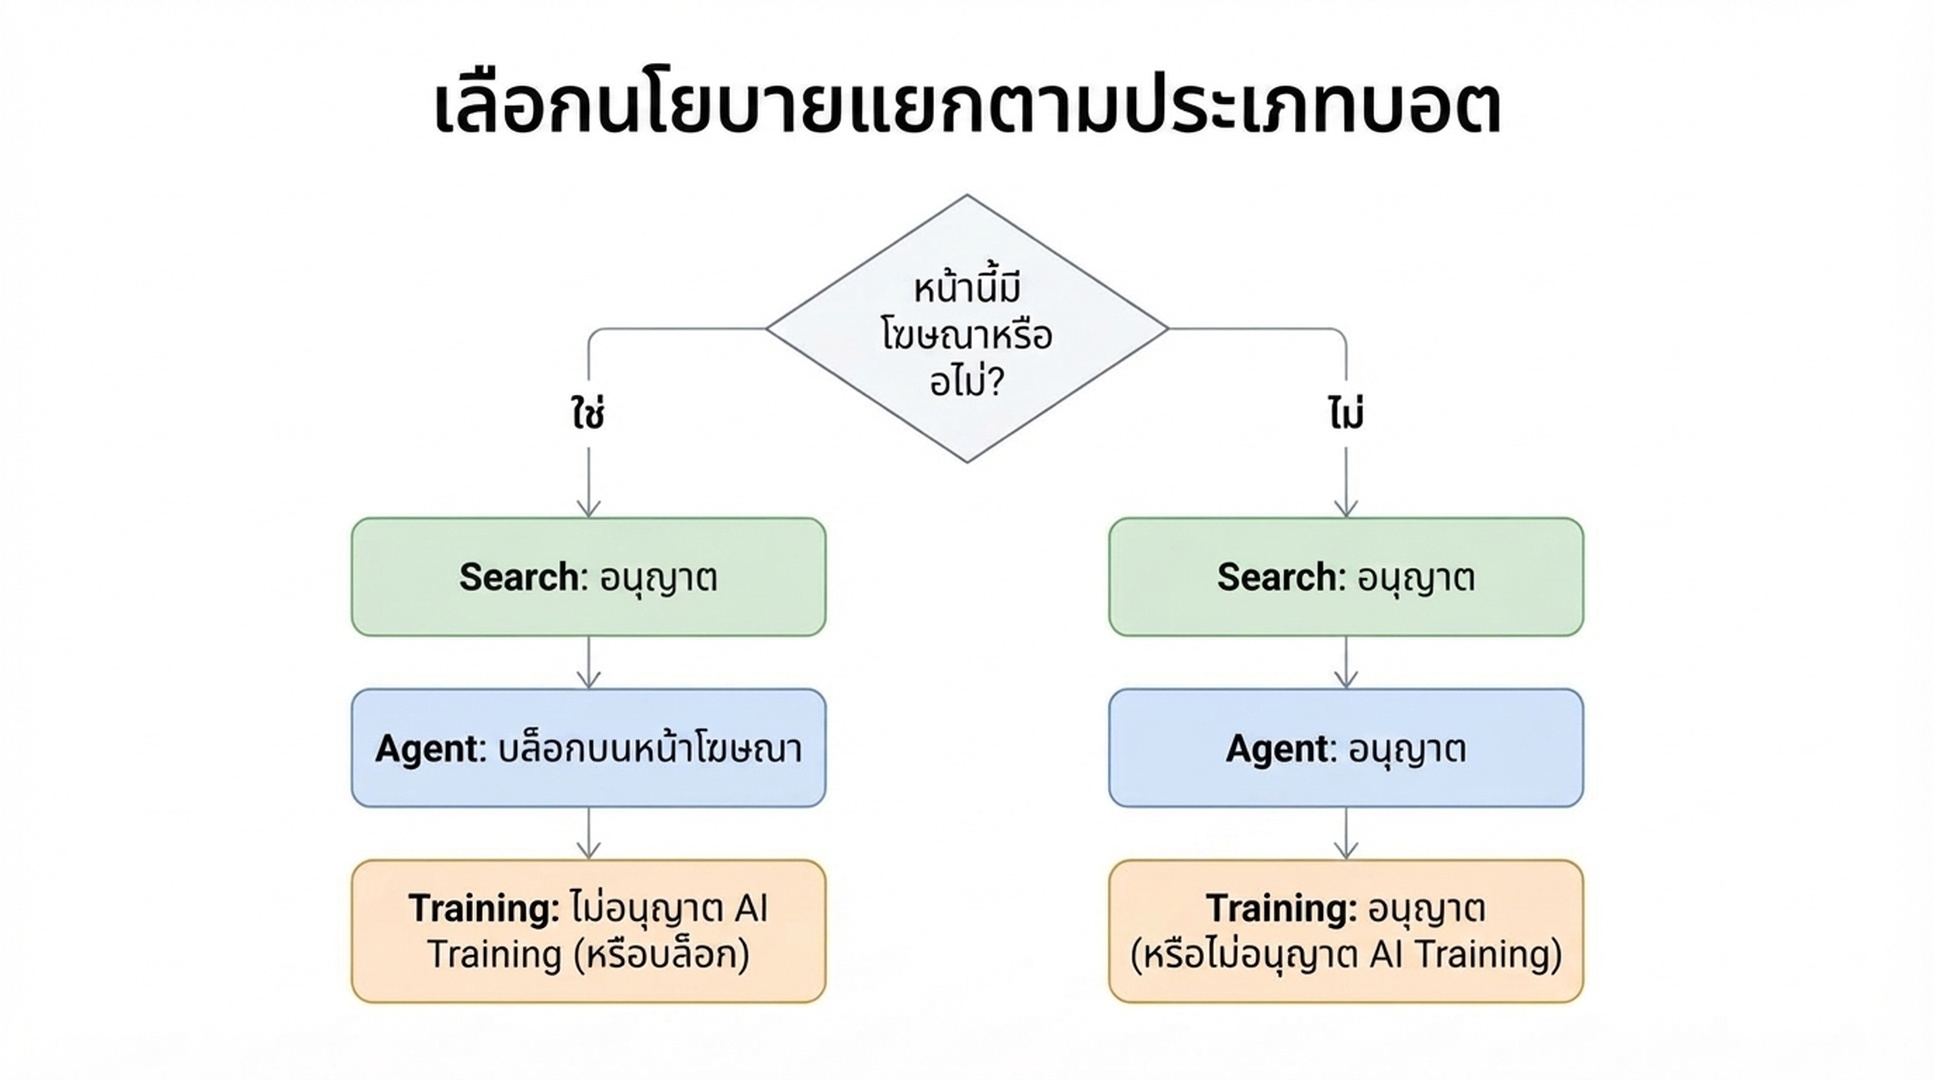
วันที่ 15 กันยายน 2026 Cloudflare เปลี่ยนสิ่งที่เกิดขึ้นโดยอัตโนมัติ สำหรับโดเมนใดก็ตามที่เข้าร่วม Cloudflare ในวันนั้นหรือหลังจากนั้น หากไซต์ถูกทำเครื่องหมายว่าสร้างรายได้จากโฆษณา ค่าเริ่มต้นจะเป็นดังนี้:
หมวดหมู่ | ค่าเริ่มต้นบนหน้าที่มีโฆษณา |
|---|---|
ค้นหา (Search) | อนุญาต |
เอเจนต์ (Agent) | บล็อกบนหน้าที่มีโฆษณา |
การเทรน (Training) | ไม่อนุญาตการเทรน AI (Disallow AI Training) |
โดเมนใหม่ที่ไม่ได้สร้างรายได้จากโฆษณาจะได้ค่าเริ่มต้นเป็นอนุญาตทั้งสามหมวด ลูกค้าเดิมไม่ได้ถูกสลับให้เงียบ ๆ — Cloudflare ให้ช่วงเวลาก่อนถึงวันที่ 15 เพื่อเลือกไม่เข้าร่วมผ่านแดชบอร์ด และกฎการย้ายข้อมูลจริงรายโดเมนก็ละเอียดกว่าค่าเริ่มต้นใหม่เพียงค่าเดียว (อธิบายไว้ด้านล่าง)
เหตุผลที่หน้าที่มีโฆษณาได้ค่าเริ่มต้นที่เข้มกว่า คือการมีโฆษณาบนหน้าเป็นสัญญาณว่าหน้านั้นตั้งใจให้มนุษย์ได้เห็น จากข้อมูลของ Cloudflare เอง เมื่อเดือนมิถุนายน 2026 ครอว์เลอร์แบบใช้งานผสม ซึ่งรวมการทำดัชนีค้นหา คำขอของเอเจนต์ และการเทรนไว้ใต้ user agent เดียวกัน คิดเป็น มากกว่า 36% ของทราฟฟิกครอว์เลอร์ที่ยืนยันตัวตนได้ ซึ่งเป็นหมวดหมู่เดี่ยวที่ใหญ่ที่สุด และสัดส่วนของการเทรน AI ในคำขอครอว์เลอร์ทั้งหมดบนเครือข่าย Cloudflare เพิ่มขึ้นจาก ราว 22% ในฤดูใบไม้ผลิ 2025 เป็น 52% ในเดือนมิถุนายน 2026 การเปลี่ยนแปลงครั้งนี้เล็งเป้าไปที่ทราฟฟิกกลุ่มนี้
ก่อนเริ่ม: สามเรื่องที่ต้องเข้าใจเกี่ยวกับหมวดหมู่
1. ครอว์เลอร์บางตัวใช้งานผสม และทำตัวต่างกันเมื่อถูกบล็อก กับเมื่อถูกห้ามเทรน Googlebot, Bingbot และ Applebot ทำงานสองหน้าที่ — ครอว์ลทั้งเพื่อการค้นหาและเพื่อการเทรนภายใต้ user agent เดียวกัน Cloudflare เรียก Apple, Google และ Microsoft ว่าผู้ให้บริการ "Accountable" (รับผิดชอบได้) เพราะเข้าเงื่อนไขสี่ข้อ คือ เคารพการตั้งค่าใน robots.txt ที่ขอให้งดเทรน มีช่องทางให้เลือกไม่ให้ AI สรุปเนื้อหา ให้ความโปร่งใสระดับ URL ว่าเนื้อหาใดถูกใช้เทรน และพิสูจน์ได้ว่าการงดเทรนไม่ทำให้คุณเสียการปรากฏในผลค้นหา
2. "ไม่อนุญาตการเทรน AI" กับการ "บล็อก" ไม่ใช่การตั้งค่าเดียวกัน และความต่างนี้คือประเด็นทั้งหมด ไม่อนุญาตการเทรน AI จะประกาศความต้องการแบบ Disallow ผ่าน robots.txt ไปยัง user agent ที่มีไว้เพื่อการเทรนโดยเฉพาะ (เช่น Google-Extended และ Applebot-Extended) ครอว์เลอร์แบบผสมที่รับผิดชอบได้จะอ่านความต้องการนี้ แล้วสมัครใจครอว์ลเพื่อการค้นหาต่อโดยข้ามการเทรนไป — การปรากฏในผลค้นหาของคุณจึงยังอยู่ ครอว์เลอร์เพื่อการเทรนรายอื่นที่ไม่ได้อยู่ในกลุ่มผู้ให้บริการที่รับผิดชอบได้จะถูกบล็อกที่ edge ทันที ซึ่งไม่กระทบการค้นหา เพราะผู้ให้บริการเหล่านั้นรันบอทสำหรับเทรนแยกต่างหาก ส่วนการบล็อกแบบธรรมดานั้น ตอนนี้บล็อกตัว Googlebot, Bingbot และ Applebot เองด้วย ซึ่งหมายความว่าเนื้อหาของคุณหายไปจากผลการค้นหาของพวกเขาด้วย ถ้าอยากให้การเทรนหายไปแต่การค้นหาอยู่ต่อ การตั้งค่าที่ถูกต้องคือ "ไม่อนุญาตการเทรน AI" ไม่ใช่ "บล็อก"
3. Bing ยังไม่เคารพการตั้งค่าการเทรนใน robots.txt ทุกวันนี้ทั้ง Applebot และ Googlebot ทำตามคำสั่ง Disallow ที่มีไว้เพื่อการเทรนโดยเฉพาะ ส่วน Microsoft ระบุว่ากำลังสร้างกลไกเทียบเท่าให้ Bingbot โดยตั้งเป้าไว้ต้นปี 2027 จนถึงตอนนั้น การเลือก "ไม่อนุญาตการเทรน AI" จะเขียนความต้องการของคุณลงใน robots.txt แต่พฤติกรรมการครอว์ลของ Bing เพื่อการเทรนจะไม่เปลี่ยนเพียงเพราะสัญญาณนี้ — เมตาแท็ก NOARCHIVE ของ Bing เองหรือเครื่องมือ Content Removal ยังเป็นช่องทางชั่วคราวหากเรื่องที่คุณกังวลคือการเทรนผ่าน Bing
ขั้นที่ 1: หาให้ออกว่าเว็บไซต์ของคุณไปอยู่ตรงไหนจริง ๆ
อย่าเดาว่าคุณรู้การตั้งค่าปัจจุบัน — ไปตรวจสอบ
สิ่งที่ต้องทำ: ในแดชบอร์ด Cloudflare เปิดโดเมนของคุณ ไปที่ Security → Settings แล้วหาตัวควบคุมนโยบายบอท AI (หน้าจอแบบสามหมวดหมู่ที่ใหม่กว่าได้แทนที่สวิตช์ "Block AI Bots" ตัวเดียวแบบเดิม แต่บัญชีที่ยังไม่ได้ย้ายข้อมูลอาจยังแสดงสวิตช์เก่า) แยกจากกัน ให้ดึง robots.txt ที่ให้บริการจริงผ่านเบราว์เซอร์หรือคำสั่ง curl https://yourdomain.com/robots.txt แล้วมองหาบล็อกที่ขึ้นต้นด้วยคอมเมนต์เครื่องหมายที่ Cloudflare จัดการ หรือจะเทียบกับ เครื่องมือตรวจ AI Crawler ใน robots.txt ของ Auspia ก็ได้ เพื่อดูว่ากฎปัจจุบันของคุณอ่านออกมาอย่างไรในสายตาครอว์เลอร์ AI
ผลลัพธ์ที่คาดหวัง: การตั้งค่าสามรายการ แยกรายการละหมวด คือค้นหา เอเจนต์ และการเทรน โดยแต่ละรายการเป็นอย่างใดอย่างหนึ่งใน อนุญาต / บล็อกบนหน้าที่มีโฆษณา / บล็อก (โดย "ไม่อนุญาตการเทรน AI" เป็นตัวเลือกที่สี่เฉพาะหมวดการเทรน) และ robots.txt ที่ให้บริการจริงควรแสดงส่วนที่ Cloudflare จัดการ ซึ่งระบุ user agent และบรรทัด Disallow / Content-Signal เจาะจง หาก Bot Preference Sync หรือ managed robots.txt เปิดใช้งานอยู่
การตรวจคุณภาพ: ยืนยันว่าการตั้งค่าทั้งสามตรงกับสิ่งที่คุณตั้งใจจริง ไม่ใช่สิ่งที่กลไกย้ายข้อมูลสันนิษฐานให้ ตรรกะการย้ายข้อมูลสำหรับลูกค้าเดิมที่ Cloudflare ระบุไว้คือ ถ้าคุณเคยเปิดสวิตช์ "Block AI" แบบเก่า คุณจะถูกย้ายไปเป็น การเทรน = ไม่อนุญาตการเทรน AI, ค้นหา ยังอนุญาต และ เอเจนต์ = บล็อกบนหน้าที่มีโฆษณา และถ้าคุณเคยตั้งการเทรนเองเป็น บล็อก หรือ บล็อกบนหน้าที่มีโฆษณา คุณจะถูกย้ายไปเป็น ไม่อนุญาตการเทรน AI เส้นทางการย้ายทั้งสองแบบตั้งสมมติฐานว่าคุณอยากเก็บการค้นหาไว้ ถ้าจริง ๆ คุณอยากให้ครอว์เลอร์แบบผสมหายไปทั้งหมดรวมถึงการค้นหา นั่นไม่ใช่สถานะปัจจุบันของคุณ และคุณต้องเลือก บล็อก อย่างชัดเจน
เส้นทางกู้คืน: หากการตั้งค่าความปลอดภัยแสดงเพียงสวิตช์ "Block AI Bots" เก่าตัวเดียวโดยไม่มีการแบ่งสามหมวด แปลว่าบัญชีของคุณยังไม่ได้ย้ายไปยังตัวควบคุมใหม่ ให้มองหา "Configure AI bot policies" ซึ่งเป็นหน้าจอการตั้งแยกและใหม่กว่า เพราะนั่นคือที่ที่ตัวควบคุมแบบละเอียดอยู่ร่วมกับสวิตช์เก่าระหว่างช่วงเปลี่ยนผ่าน และเป็นที่ที่อนาคตจะไปอยู่
ขั้นที่ 2: ตัดสินนโยบายแยกทีละหมวด ไม่ใช่คำตอบกว้าง ๆ คำตอบเดียว
นี่คือขั้นตัดสินใจจริง ไล่ทีละหมวด
การค้นหา แทบไม่มีใครบล็อก — Cloudflare ระบุว่าไม่ถึง 1% ของเว็บไซต์เลือกบล็อกบอทค้นหา — เพราะการเสียการปรากฏในผลค้นหาแทบไม่คุ้มกับอะไรเลย ตั้งเป็น อนุญาต เป็นค่าเริ่มต้น เว้นแต่คุณมีเหตุผลเฉพาะ (เช่น ไซต์ทดสอบ เอกสารเก็บถาวรหลังเพย์วอลล์) ที่ต้องการกันออกจากดัชนีค้นหา
เอเจนต์ พวกนี้คือบอทที่กำลังลงมือทำบางอย่างแทนคนแบบทันที — เช็กราคา ทำการจองให้เสร็จ ดึงข้อเท็จจริงหนึ่งอย่างเข้าสู่คำตอบแชท การบล็อกทราฟฟิกเอเจนต์บนหน้าที่มีรายได้หรือมีโฆษณาเป็นเหตุผลที่อยู่เบื้องหลังค่าเริ่มต้นใหม่ เพราะการเข้าชมของเอเจนต์ไม่ได้สร้างการเห็นโฆษณาแบบที่การเข้าชมของมนุษย์สร้าง หากโมเดลธุรกิจของคุณพึ่งพาความสนใจของมนุษย์นั้น (สื่อ ไซต์เนื้อหาที่มีโฆษณาแสดงผล) บล็อกบนหน้าที่มีโฆษณา เป็นจุดยืนที่ปกป้องได้ แต่ถ้าคุณอยากให้เอเจนต์ทำภารกิจบนเว็บไซต์ได้แม้บนหน้าที่มีโฆษณา เช่น เพราะทราฟฟิกจากเอเจนต์ยังแปลงเป็นยอดให้คุณได้อยู่ ให้เลือก อนุญาต
การเทรน การตัดสินใจจริงอยู่ตรงนี้ และก็ตรงนี้ที่ศัพท์ทำให้คนสับสน:
- เลือก ไม่อนุญาตการเทรน AI หากต้องการหยุดไม่ให้เนื้อหาถูกใช้ฝึกโมเดล แต่ยังคงการปรากฏตัวในผลิตภัณฑ์ค้นหาของ Google, Bing และ Apple (เมื่อคำนึงถึงการตามหลังของ Bing ในตอนนี้ ให้เข้าใจว่า "วันนี้ใช้ได้กับ Google และ Apple ส่วน Bing รออยู่") นี่คือทางสายกลางที่ Cloudflare แนะนำ และเป็นการตั้งที่ออกแบบมาเพื่อการแลกเปลี่ยนระหว่างการค้นหากับการเทรนโดยเฉพาะ
- เลือก บล็อก เฉพาะเมื่อคุณยอมแลกการครอว์ลเพื่อการค้นหาของ Googlebot, Bingbot และ Applebot ไปทั้งหมด เพื่อแลกกับการบล็อกพฤติกรรมโหมดเทรนของพวกมันด้วย ตอนนี้มันเป็นตัวเลือกที่เข้มงวดแล้ว เพราะนับจากวันที่ 15 กันยายน การบล็อกใช้กับครอว์เลอร์แบบผสมด้วย ซึ่งไม่เคยเป็นแบบนี้มาก่อน
- เลือก อนุญาต เฉพาะเมื่อคุณยอมรับอย่างตั้งใจว่าเนื้อหาจะถูกใช้ฝึกโมเดล AI เช่น เพราะอยากได้การปรากฏในคำตอบ AI ให้มากที่สุด และเห็นว่าการถูกใช้เทรนเป็นราคาที่ยอมรับได้
สิ่งที่ต้องทำ: ใน Security → Settings → Configure AI bot policies ตั้งทั้งสามดรอปดาวน์ตามการตัดสินใจของคุณ
ผลลัพธ์ที่คาดหวัง: แดชบอร์ดควรสะท้อนตัวเลือกที่ชัดเจนของคุณในแต่ละหมวด และ (ถ้าเปิด Bot Preference Sync) เริ่มเผยแพร่บล็อก robots.txt ที่สอดคล้องกันโดยอัตโนมัติ — โดยไม่ต้องแก้ไฟล์ด้วยมือ
การตรวจคุณภาพ: ทบทวนการตัดสินใจเรื่องการเทรนของคุณด้วยคำถามเดียวว่า "ฉันต้องการเก็บการปรากฏในผลค้นหาไว้หรือไม่" ถ้าใช่ นั่นคือ ไม่อนุญาตการเทรน AI ไม่ใช่ บล็อก ไม่ว่าคำว่า "บล็อก" จะฟังดูน่าดึงดูดแค่ไหนเมื่อต้องหยุดการเทรน AI
เส้นทางกู้คืน: ถ้าทราฟฟิกค้นหาตกลงหลังคุณเลือกการตั้งค่า ให้ตรวจว่าคุณเผลอเลือก บล็อก แทน ไม่อนุญาตการเทรน AI หรือไม่ — นี่คือความผิดพลาดที่ทำร้ายตัวเองบ่อยที่สุดในการตั้งค่านี้ เพราะชื่อเรียกทำให้ "บล็อก" ดูเหมือนตัวเลือกที่ "ทำมากกว่า" แต่สำหรับการเทรน มันทำสิ่งที่คุณอาจไม่ต้องการ คือพาการค้นหาหายไปด้วย
ขั้นที่ 3: เปิด Bot Preference Sync เพื่อให้ robots.txt ตรงกับการตั้งค่าของคุณ
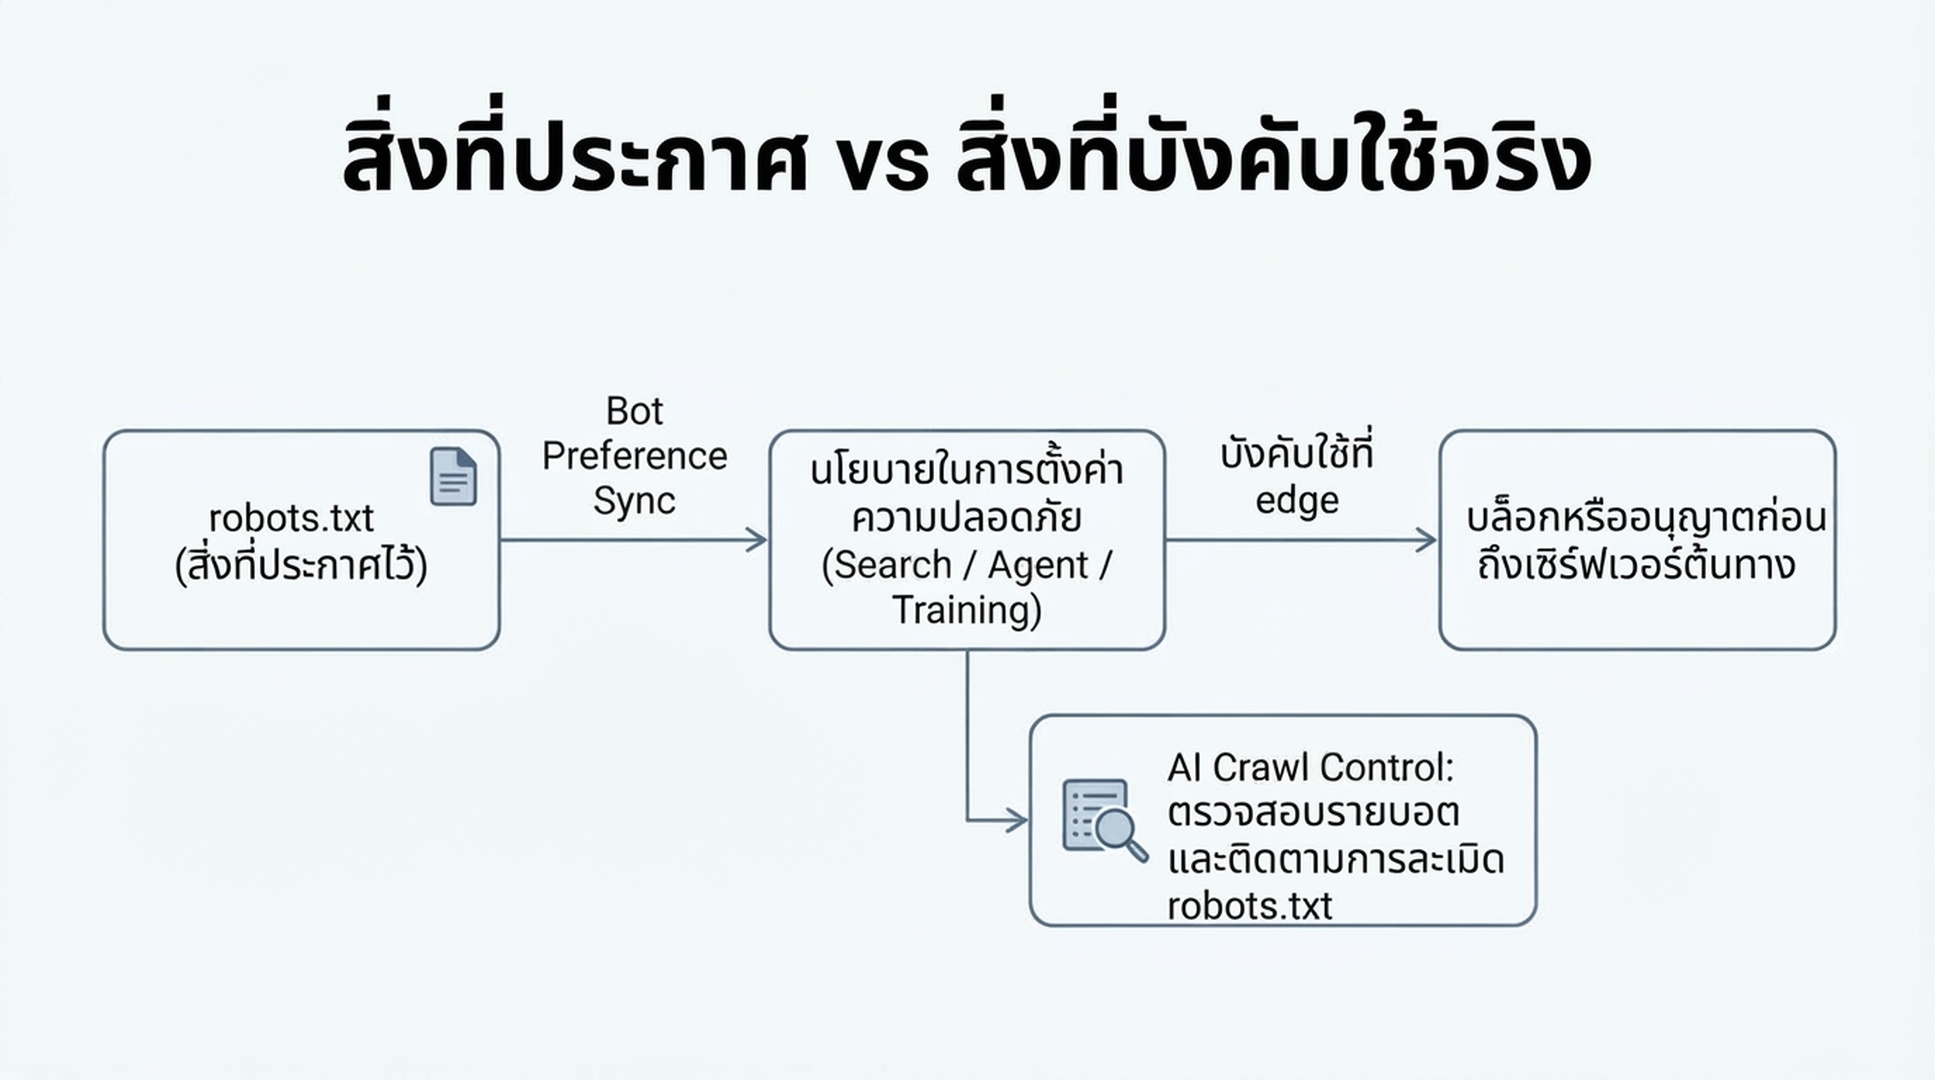
การตั้งค่าในแดชบอร์ดกับไฟล์ robots.txt เป็นสองระบบที่ต่างกัน และเมื่อทั้งสองไม่ตรงกัน ครอว์เลอร์บางตัวก็ใช้ช่องว่างนั้นเป็นข้ออ้างในการเพิกเฉยความต้องการของคุณ Bot Preference Sync ของ Cloudflare ปิดช่องว่างนี้โดยสร้าง robots.txt ของคุณขึ้นจากค่าความปลอดภัยที่คุณเลือกโดยตรง
สิ่งที่ต้องทำ: ในส่วนการตั้งค่านโยบายบอท AI เดียวกัน เปิด Bot Preference Sync (ลูกค้าใหม่เปิดไว้เป็นค่าเริ่มต้น ส่วนลูกค้าเดิมที่ใช้ฟีเจอร์ managed robots.txt แบบเก่าจะได้รับข้อความให้ตรวจและยืนยันระหว่างการย้ายข้อมูล)
ผลลัพธ์ที่คาดหวัง: Cloudflare จะเพิ่มบล็อกที่จัดการให้ไว้บนสุดของ robots.txt ของคุณ ล้อมด้วยคอมเมนต์ # BEGIN Cloudflare Bot Preference Sync / # END พร้อมระบุ user agent ที่ได้รับผลกระทบและกฎ Disallow ของแต่ละตัว โดยจะไม่ลบกฎที่คุณเขียนเองใน robots.txt — กฎเหล่านั้นจะอยู่ต่อใต้บล็อกที่จัดการให้
การตรวจคุณภาพ: ดึง /robots.txt อีกครั้งหลังเปิดใช้งาน และยืนยันว่าบล็อกที่จัดการให้ปรากฏขึ้นและตรงกับตัวเลือกจากขั้นที่ 2 เช่น ถ้าคุณตั้งการเทรนเป็น ไม่อนุญาตการเทรน AI คุณควรเห็น user agent ที่มีไว้เพื่อการเทรน (Google-Extended, Applebot-Extended) พร้อมกฎ Disallow ขณะที่ user agent ทั่วไปอย่าง Googlebot / Applebot / Bingbot ยังไม่ถูกบล็อกเพื่อการค้นหา
เส้นทางกู้คืน: หากคุณมีข้อตกลงพิเศษแบบครั้งเดียวกับผู้ให้บริการครอว์เลอร์รายใดรายหนึ่ง ซึ่งนโยบายระดับหมวดจะทำลายลง (เช่น สัญญาอนุญาตเนื้อหาแบบเสียค่าใช้จ่าย) ให้ปิด Bot Preference Sync แล้วแก้ robots.txt ของคุณเองด้วยมือ — สวิตช์หมวดหมู่ออกแบบมาสำหรับนโยบายระดับทั้งโซน ไม่ใช่สำหรับข้อยกเว้นรายผู้ให้บริการ
ขั้นที่ 4: ยืนยันว่านโยบายถูกบังคับใช้จริง ไม่ใช่แค่ถูกขอความร่วมมือ
robots.txt คือคำขอในทางเทคนิค มันไม่หยุดครอว์เลอร์ที่เพิกเฉยได้ นี่คือขั้นที่คนมักข้าม และเป็นขั้นที่บอกได้ว่าการตัดสินใจในขั้นที่ 2 ของคุณเป็นของจริงหรือเป็นแค่ทฤษฎี
สิ่งที่ต้องทำ: เปิด AI Crawl Control ของโซนคุณ (ใช้ได้ทุกแพ็กเกจรวมถึง Free — คุณภาพการตรวจจับดีขึ้นบนแพ็กเกจที่มี Bot Management แต่ความสามารถด้านการมองเห็นใช้ได้ทุกที่) ดูแท็บ Crawlers ซึ่งแสดงบอททั้งหมดที่เข้าถึงเว็บไซต์คุณ พร้อมคอลัมน์ Robots.txt violations
ผลลัพธ์ที่คาดหวัง: ตารางที่แสดงจำนวนคำขอและจำนวนการฝ่าฝืนของบอทแต่ละตัว ตัวเลขการฝ่าฝืนที่ไม่ใช่ศูนย์ของบอทที่คุณตั้งเป็นไม่อนุญาตหรือบล็อก หมายความว่าบอทนั้นกำลังเพิกเฉย robots.txt ของคุณอยู่
การตรวจคุณภาพ: สำหรับบอทที่แสดงการฝ่าฝืน ให้ดู "Most popular paths" (กรองเฉพาะพาธที่ถูกทำเครื่องหมาย) เพื่อดูว่าจริง ๆ แล้วมันกำลังร้องขอเนื้อหาที่คุณใส่ใจอยากปกป้องหรือไม่
เส้นทางกู้คืน: หากบอทเพิกเฉยความต้องการที่คุณประกาศ แค่ robots.txt จะไม่หยุดมัน ใช้การดำเนินการ "Enforce robots.txt rules" ใน AI Crawl Control (บางครั้งเรียกด้วยชื่อภายในว่า Robotcop) เพื่อแปลงกฎที่คุณประกาศให้เป็นกฎ WAF จริงที่บล็อกบอทที่ไม่ทำตามที่ edge ของ Cloudflare ก่อนที่มันจะไปถึงเซิร์ฟเวอร์ต้นทางของคุณ — ยกระดับจาก "ขอให้ทำตาม" ไปเป็น "บังคับให้ทำตาม" ขั้นนี้ใช้ WAF ดังนั้นความพร้อมใช้จึงขึ้นกับว่าแพ็กเกจของคุณเข้าถึง WAF ได้หรือไม่
ขั้นที่ 5: ตัดสินว่าจะบล็อกเปล่า ๆ หรือคิดเงินแทน
หากการตัดสินใจเรื่องการเทรนของคุณคือ "ไม่ให้เข้าถึงเพื่อการเทรน" คุณมีทางเลือกที่สองนอกจากการบล็อกทิ้งทั้งหมด นั่นคือคิดค่าบริการ
สิ่งที่ต้องทำ: หากสนใจ ให้สมัคร private beta ของ Pay Per Crawl จาก Cloudflare (ผ่านหน้าสมัครของ Cloudflare หรือผ่านผู้ดูแลบัญชีถ้าคุณเป็นลูกค้า Enterprise) เมื่อเปิดใช้ในระดับบัญชีแล้ว (Manage Account → Settings → Pay Per Crawl → ตั้ง Visibility ของโดเมนเป็น Visible) คุณกำหนดราคาคงที่ต่อหนึ่งคำขอสำหรับทั้งโซนได้ และเลือกได้เป็นรายครอว์เลอร์ว่าจะ อนุญาต (ฟรี) คิดค่าบริการ (ตามราคาของคุณ) หรือ บล็อก
ผลลัพธ์ที่คาดหวัง: เมื่อครอว์เลอร์ที่ยืนยันตัวตนผ่าน Web Bot Auth (คำขอที่ลงลายเซ็น Ed25519 เพื่อระบุตัวครอว์เลอร์) ร้องขอหน้าที่คุณตั้งเป็นคิดค่าบริการ มันจะได้รับ HTTP 402 Payment Required พร้อมเฮดเดอร์ crawler-price หากมันลองใหม่โดยตกลงจ่าย หรือแนบเฮดเดอร์ crawler-max-price ที่ครอบคลุมราคาของคุณมาตั้งแต่ต้น มันจะได้เนื้อหาไปพร้อมเฮดเดอร์ crawler-charged ที่ยืนยันยอดที่เรียกเก็บ Cloudflare ทำหน้าที่เป็น merchant of record และจัดการการชำระเงินให้
การตรวจคุณภาพ: กลไกนี้ทำงานเฉพาะกับครอว์เลอร์ที่ลงทะเบียนข้อมูลการชำระเงินกับ Cloudflare และรองรับขั้นตอนแบบ 402 เท่านั้น ไม่ใช่สวิตช์สากลที่ใช้ได้กับบอททุกตัว สำหรับรายอื่น ๆ การตั้งค่าคิดค่าบริการของคุณทำหน้าที่เป็นเหมือนการบล็อกในทางปฏิบัติ ซึ่ง Cloudflare ระบุว่ายังใช้เป็นสัญญาณว่าคุณเปิดรับความสัมพันธ์แบบเสียค่าใช้จ่ายในอนาคตได้
เส้นทางกู้คืน: ฟีเจอร์นี้ยังอยู่ในช่วง private beta หากคุณไม่ได้รับคัดเลือกหรือไม่อยากรอ ไม่อนุญาตการเทรน AI หรือ บล็อก ยังเป็นตัวเลือกที่ใช้ได้กับครอว์เลอร์กลุ่มเดียวกันในวันนี้
รับมือกับกรณียกเว้น: เมื่อผู้ให้บริการ AI รายหนึ่งขอเข้าถึง
คุณอาจได้รับการติดต่อเข้ามา — ข้อเสนอความร่วมมือ ข้อตกลงการอ้างอิง การเจรจาอนุญาต — จากบริษัท AI ที่ต้องการการเข้าถึงอย่างชัดเจนนอกเหนือจากนโยบายทั้งโซน
มีสองวิธีในการให้ข้อยกเว้นแคบ ๆ โดยไม่ต้องเปิดหมวดทั้งหมดกลับมา:
- เขียนทับเป็นรายครอว์เลอร์ใน Manage AI crawlers: เปลี่ยนแถวของบอทตัวนั้นจาก บล็อก/คิดค่าบริการ เป็น อนุญาต โดยแยกจากค่าการเทรนหรือเอเจนต์ระดับหมวดของคุณ
- แก้ robots.txt ด้วยมือโดยตรง: หากคุณปิด Bot Preference Sync ไปแล้ว (หรือวางข้อยกเว้นไว้นอกบล็อกที่จัดการให้) คุณสามารถเพิ่ม Allow เจาะจงสำหรับ user agent ตัวนั้นใต้ส่วนที่ Cloudflare จัดการได้
ไม่ว่าจะวิธีไหน ให้คงนโยบายหมวดระดับโซนไว้เป็นค่าตั้งต้น และถือว่าข้อยกเว้นที่ระบุชื่อเป็นเป็นการตัดสินใจที่จงใจและมีบันทึกไว้ — ไม่ใช่กลับกัน
ตรวจสอบผลลัพธ์ที่ได้
ไล่รายการตรวจสอบนี้เมื่อการตั้งค่ามีผลแล้ว:
- [ ] การตั้งค่าความปลอดภัยแสดงค่าที่ชัดเจนและจงใจสำหรับการค้นหา เอเจนต์ และการเทรน — ไม่ใช่ค่าเริ่มต้นที่ยังไม่ได้ตรวจ
- [ ]
/robots.txtบนโดเมนที่ให้บริการจริงแสดงบล็อกที่ Cloudflare จัดการ ซึ่งตรงกับการตั้งค่าเหล่านั้น - [ ] แท็บ Crawlers ใน AI Crawl Control แสดงบอทที่คุณคาดไว้ โดยมีการฝ่าฝืนเป็นศูนย์หรือใกล้ศูนย์สำหรับทุกอย่างที่คุณตั้งเป็นบล็อก/ไม่อนุญาต
- [ ] หากคุณเลือกไม่อนุญาตการเทรน AI คุณยืนยันแล้ว (ผ่าน Search Console / Bing Webmaster Tools หรือแค่เฝ้าดูทราฟฟิกออร์แกนิก) ว่าการครอว์ลเพื่อการค้นหาของ Googlebot / Applebot ยังดำเนินต่อไปตามปกติ
- [ ] หากคุณเปิดการบังคับใช้ robots.txt (Robotcop) กฎ WAF ที่ได้ถูกนำไปใช้และทำงานอยู่จริง ไม่ใช่แค่สร้างแล้วทิ้งไว้เป็นฉบับร่าง
- [ ] คุณบันทึกไว้ว่าเลือกการตั้งค่าใดและเพราะเหตุใด เพื่อให้การทบทวนครั้งต่อไปไม่ต้องเริ่มจากศูนย์
รักษาผลลัพธ์ให้อยู่ต่อ
นี่ไม่ใช่การตั้งค่าที่ทำแล้วลืมได้ ให้กลับมาทบทวนเป็นจังหวะเบา ๆ:
- รายเดือน: ดูแท็บ Metrics ใน AI Crawl Control เพื่อหาบอทใหม่ที่คุณยังไม่ได้ตัดสินนโยบาย และตรวจจำนวนการฝ่าฝืนซ้ำ
- เมื่อ Bing เปิดตัวการรองรับการตั้งค่าการเทรนสำหรับ Bingbot (Microsoft ระบุเป้าไว้ต้นปี 2027): ประเมินใหม่ว่าการตั้งค่าปัจจุบันของคุณยังให้ผลลัพธ์ที่ตั้งใจไว้หรือไม่ คือ เก็บการค้นหาไว้ บล็อกการเทรน เพราะนั่นคือจุดที่ Bing ตามทันพฤติกรรมปัจจุบันของ Google และ Apple
- ทุกครั้งที่สถานะการสร้างรายได้จากโฆษณาของคุณเปลี่ยน การเพิ่มหรือถอดโฆษณาแสดงผลเปลี่ยนว่าหน้าของคุณไปอยู่บนเส้นค่าเริ่มต้นใด และควรตรวจซ้ำว่าการตั้งค่าแบบชัดเจนของคุณยังสมเหตุสมผลภายใต้เงื่อนไขนั้น
คำถามที่พบบ่อย
การบล็อกครอว์เลอร์เพื่อการเทรนจะทำอันตรายอันดับ SEO ของฉันหรือไม่? ไม่ หากคุณใช้ไม่อนุญาตการเทรน AI แทนการบล็อก ไม่อนุญาตการเทรน AI ถูกออกแบบมาให้ครอว์เลอร์แบบผสมที่รับผิดชอบได้ (Google, Apple และในอนาคตคือ Bing) ครอว์ลเพื่อการค้นหาต่อโดยข้ามการเทรนไป ส่วนการบล็อกแบบธรรมดานั้นตอนนี้บล็อกพฤติกรรมการค้นหาของครอว์เลอร์เหล่านี้ด้วย ซึ่งจะทำร้ายการปรากฏของคุณในผลิตภัณฑ์ค้นหาของพวกเขา
ฉันเปิด "Block AI Bots" ไว้ก่อนวันที่ 15 กันยายน เกิดอะไรขึ้นกับการตั้งค่าของฉัน? Cloudflare ย้ายให้อัตโนมัติ โดย Block AI Bots แบบเก่ากลายเป็น การเทรน = ไม่อนุญาตการเทรน AI, ค้นหา = อนุญาต และ เอเจนต์ = บล็อกบนหน้าที่มีโฆษณา ให้ตรวจสอบด้วยขั้นที่ 1 ข้างต้นว่าผลลัพธ์จริงเป็นไปตามที่คาดหรือไม่ แทนที่จะสันนิษฐานว่าการย้ายข้อมูลตรงกับเจตนาของคุณ
มีอะไรใช้ได้บนแพ็กเกจ Free บ้าง? มี AI Crawl Control, การตั้งค่าหมวด ค้นหา/เอเจนต์/การเทรน และ Bot Preference Sync ใช้ได้ทุกแพ็กเกจรวมถึง Free รายละเอียดการบังคับใช้บางอย่างขึ้นกับแพ็กเกจ ตัวอย่างเช่น การบังคับใช้ robots.txt ทำงานผ่าน WAF และการตรวจจับบอทบนแพ็กเกจ Free พึ่งพาสตริง user agent มากกว่ารหัสตรวจจับ Bot Management ขั้นสูง
AI Crawl Control ต่างจากการตั้งค่าความปลอดภัยบอท AI อย่างไร? การตั้งค่าความปลอดภัยคือที่ที่คุณตัดสินนโยบาย (อนุญาต / บล็อกบนหน้าที่มีโฆษณา / บล็อก / ไม่อนุญาตการเทรน AI ต่อหมวด) ส่วน AI Crawl Control คือที่ที่คุณตรวจสอบสิ่งที่เกิดขึ้นจริง — จำนวนคำขอรายบอท การฝ่าฝืน robots.txt รายละเอียดระดับพาธ — และเป็นที่ที่คุณแปลงนโยบาย robots.txt ที่ประกาศไว้ให้เป็นกฎ WAF ที่บังคับใช้ได้
หลังตั้งค่าเหล่านี้ ฉันต้องแก้ robots.txt ด้วยมือไหม? ไม่ต้อง หากเปิด Bot Preference Sync เพราะมันจะเขียนและดูแลบล็อก robots.txt ที่เหมาะสมให้ตามการตั้งค่าในแดชบอร์ดของคุณ การแก้ด้วยมือจำเป็นเฉพาะเมื่อคุณต้องการข้อยกเว้นเฉพาะผู้ให้บริการรายหนึ่ง นอกเหนือจากหมวดที่จัดการให้
ผู้เขียน: Julian Mercer ผู้ปฏิบัติงานด้าน technical SEO ประสบการณ์ 14 ปีที่ Auspia เขาเขียนเกี่ยวกับความสามารถในการครอว์ล โครงสร้างข้อมูล การเรนเดอร์ และพื้นฐานทางเทคนิคที่ทำให้เนื้อหาอ่านได้โดย AI