ตัวติดตามการมองเห็นใน AI ฟังดูตรงไปตรงมา ถามคำถามหมวดหมู่กับผู้ช่วยสักสองสามข้อ บันทึกว่าแบรนด์ของคุณโผล่หรือไม่ แล้ววาดเป็นกราฟตามเวลา
ปัญหาอยู่ต้นน้ำจากการบันทึก สิ่งที่คุณวัดไม่นิ่ง ส่งพรอมป์เดียวกันไปยังโมเดลเดียวกันสองครั้ง แล้วคุณจะได้คำตอบสองชุดที่ทับซ้อนกันเพียงบางส่วน บันทึกอันใดอันหนึ่งเท่ากับคุณบันทึกตัวอย่างหนึ่งชิ้นจากทั้งการกระจาย แล้วนำเสนอมันเป็นข้อเท็จจริง
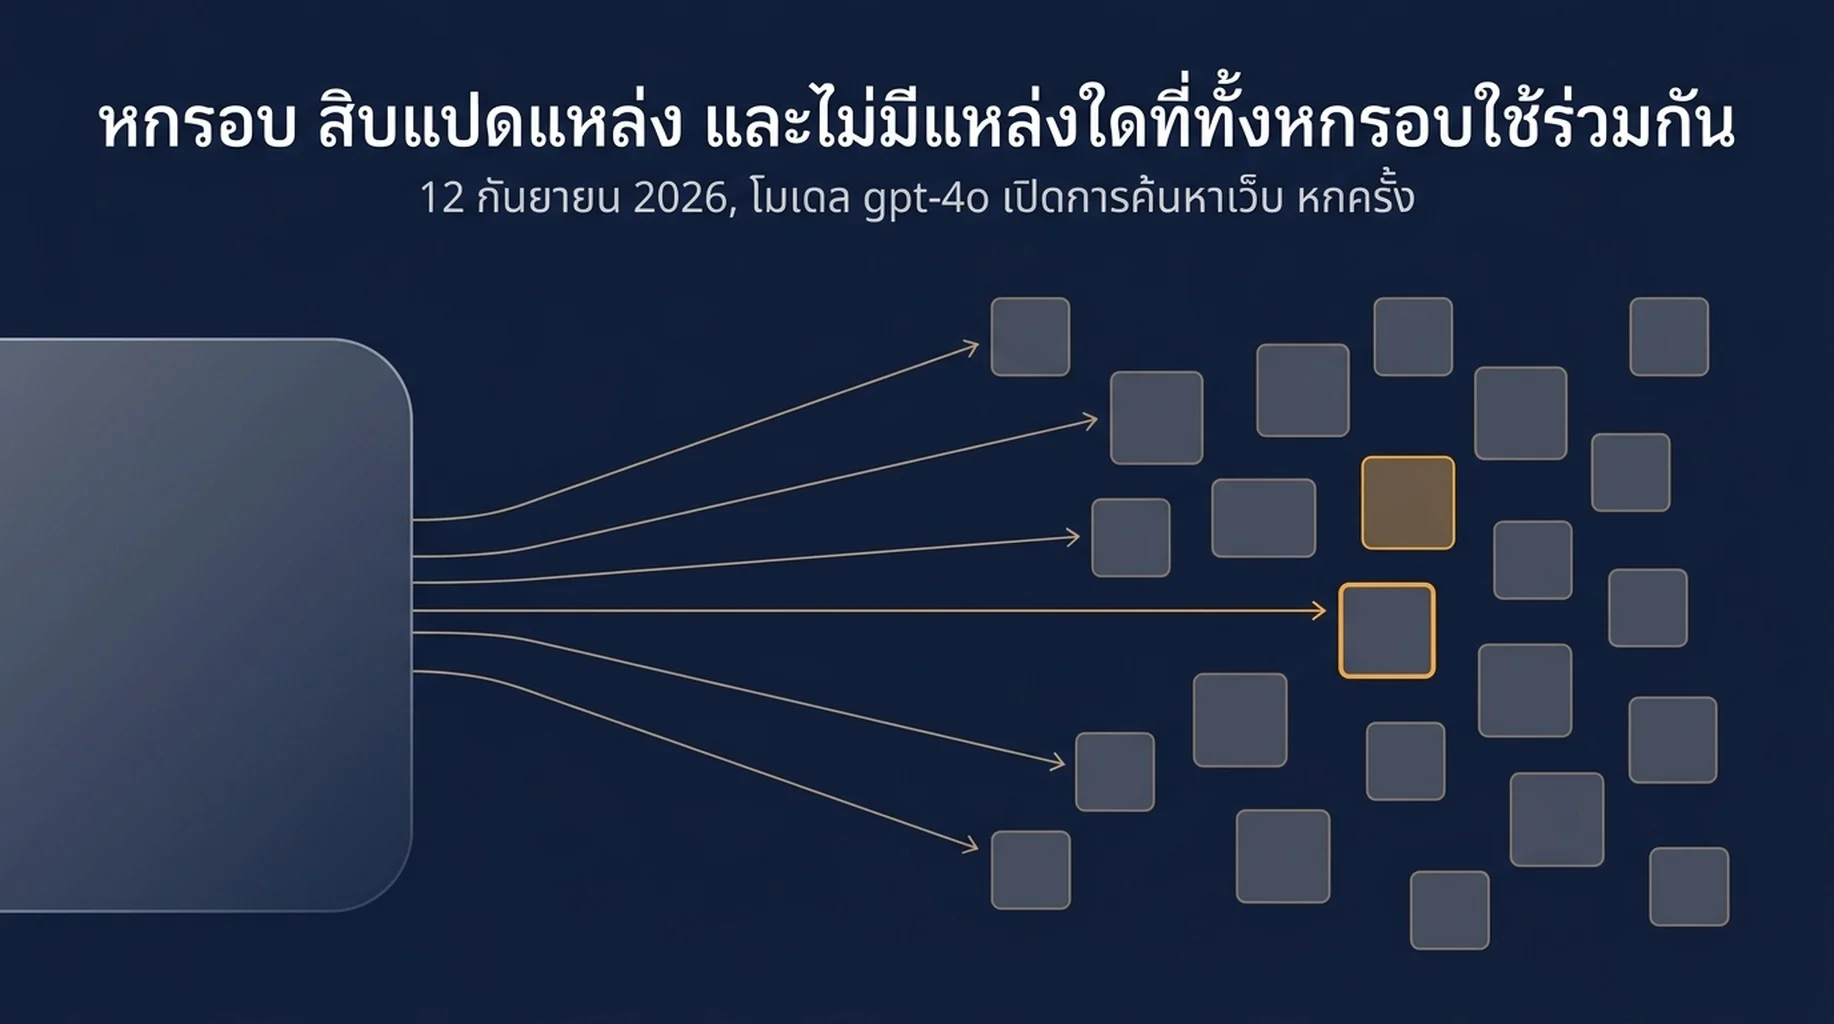
เราอยากรู้ว่าการกระจายกระจายตัวจริงแค่ไหน จึงไม่ได้ตั้งสมมติฐาน แต่ลงมือทดลอง เวอร์ชันสั้นคือ หกคำขอที่เหมือนกันทุกประการให้ผลลัพธ์เป็นแหล่งอ้างอิงสิบแปดแหล่ง และไม่มีแหล่งใดถูกอ้างถึงทั้งหกครั้ง
บทความนี้พูดถึงสิ่งที่เรารัน สิ่งที่ได้กลับมา และสี่ฟิลด์ที่ตัวติดตามการมองเห็นใน AI ต้องเก็บไว้ เพื่อให้ตัวเลขนั้นยังน่ามองในเดือนหน้า
สิ่งที่เรารัน
สองการทดลอง ทั้งคู่ใช้พรอมป์ที่ทีม SaaS จะใช้จริงในการสำรวจหมวดหมู่
การทดลองที่ 1: หนึ่งพรอมป์ หนึ่งโมเดล หกรอบ โมเดล gpt-4o เปิดการค้นหาเว็บ สหรัฐอเมริกา ภาษาอังกฤษ พรอมป์คือ "เครื่องมือติดตามอันดับที่ดีที่สุดสำหรับทีม SaaS ขนาดเล็กในปี 2026 มีอะไรบ้าง ช่วยแสดงรายการสั้น ๆ พร้อมแหล่งอ้างอิง" เป็นการเรียกสดแยกกันหกครั้ง รันต่อเนื่องกันในหน้าต่างเซสชันเดียวกัน
การทดลองที่ 2: สองโมเดล พรอมป์เดียวกัน อย่างละสามรอบ ส่งพรอมป์เดียวกันไปยัง Claude Sonnet 5 และ Gemini 3.8 Flash อย่างละสามครั้ง โดยไม่เปิดการค้นหาเว็บ เมื่อไม่มีการค้นหา สิ่งที่เราวัดคือผลิตภัณฑ์ที่โมเดลเอ่ยชื่อจากความรู้ของตัวเอง ซึ่งเป็นสัญญาณคนละอย่างกับแหล่งที่มันอ้างอิง
เรายังส่งพรอมป์ที่สองผ่านเส้นทางการค้นหาเว็บสี่ครั้ง เพื่อดูว่าพฤติกรรมการอ้างอิงสม่ำเสมอระหว่างประเภทคำถามหรือไม่: "ฉันจะติดตาม AI Overviews สำหรับเว็บไซต์ของตัวเองได้อย่างไร ช่วยยกวิธีที่จับต้องได้พร้อมแหล่งอ้างอิง"
หกรอบไม่ใช่ตัวอย่างขนาดใหญ่ และเราก็ปฏิบัติกับมันแบบนั้น มันพอจะบอกทิศทางและขนาดคร่าว ๆ ของความแปรปรวน และนั่นคือประเด็น
ผลลัพธ์ที่ 1: สิบแปดแหล่ง ไม่มีแหล่งใดที่ทั้งหกรอบใช้ร่วมกัน
การรันค้นหาเว็บทั้งหกรอบอ้างอิง URL ต่างกันรวม 18 รายการ นี่คือความถี่ที่แต่ละโดเมนปรากฏ
จำนวนครั้งที่ถูกอ้าง (จาก 6 รอบ) | โดเมน |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
ไม่มีโดเมนใดถูกอ้างอิงทั้งหกรอบ และไม่มี URL ใดถูกอ้างอิงทั้งหกรอบ
ตัวเลขที่สำคัญตรงนี้คือการทับซ้อนระหว่างรอบ เมื่อเทียบแต่ละคู่ของการรัน ค่าการทับซ้อนแบบ Jaccard เฉลี่ยของ URL ที่ถูกอ้างอิงอยู่ที่ 0.167 ในสองคู่จากสิบห้าคู่ การทับซ้อนเป็นศูนย์พอดี หมายความว่าสองคำตอบนั้นไม่ได้ใช้แหล่งร่วมกันเลย
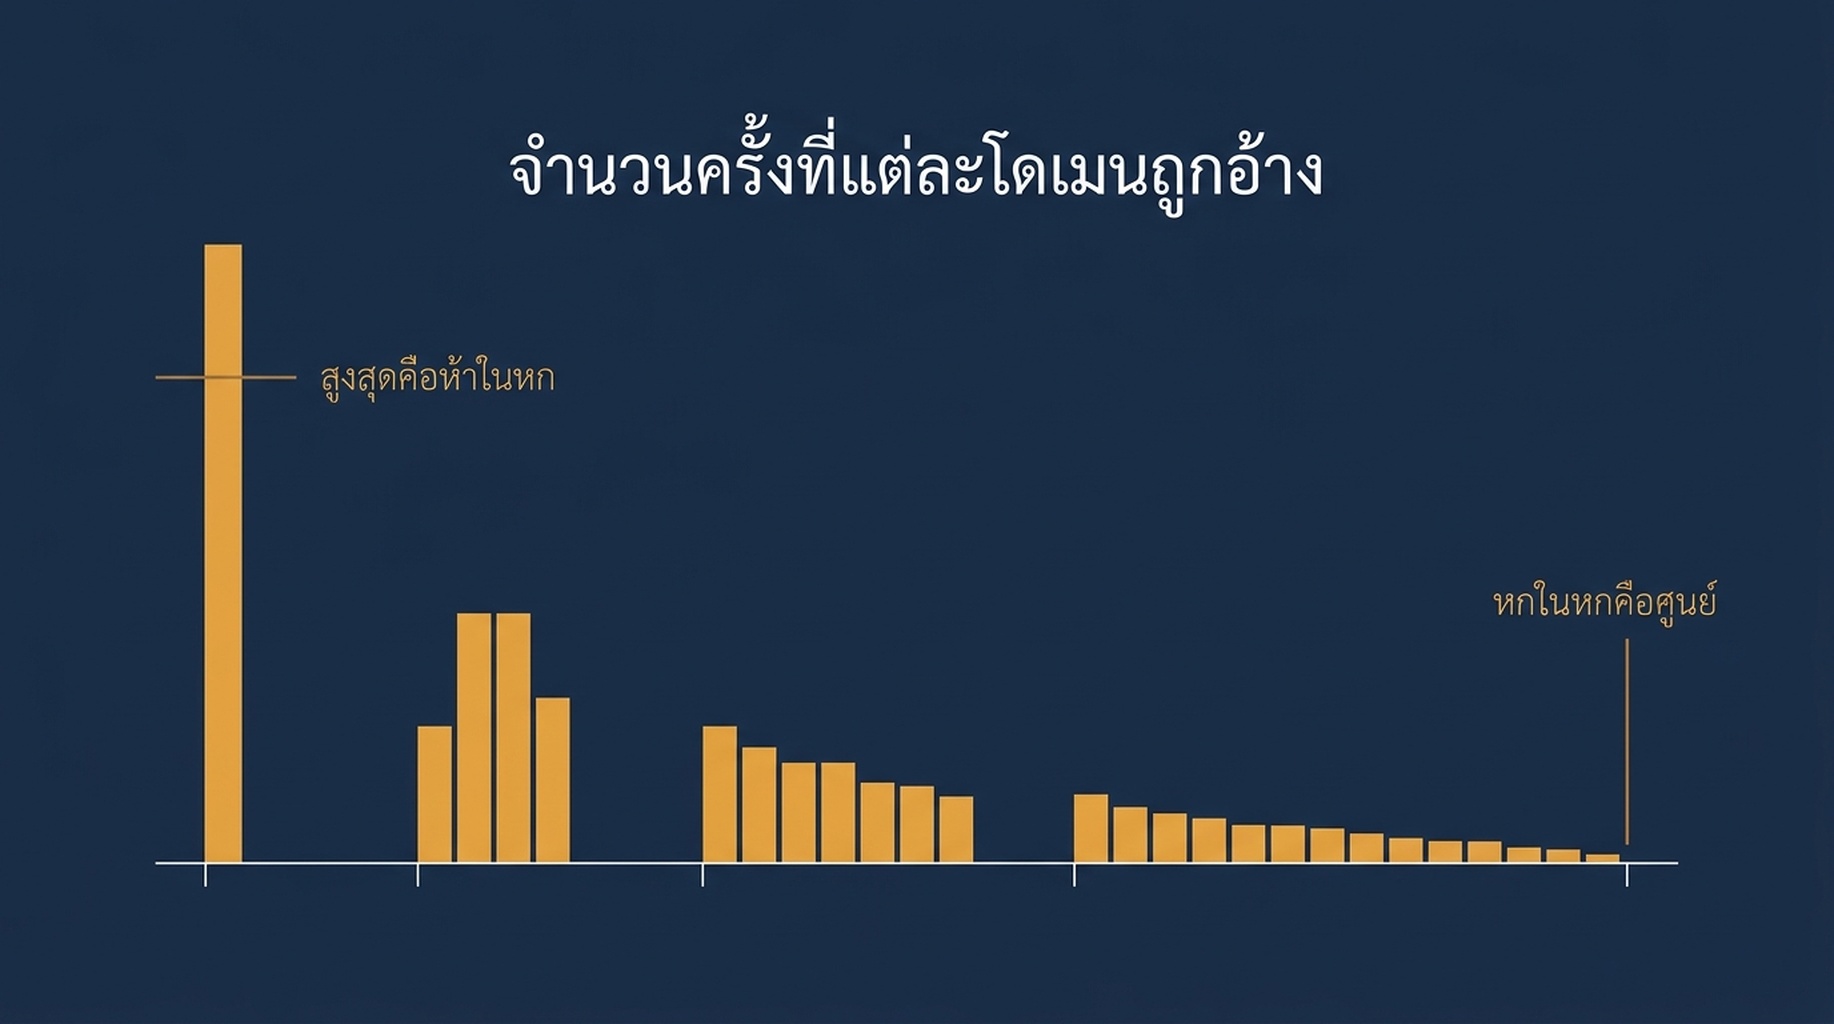
แหล่งที่ถูกอ้างในห้ารอบจากหกคือเพดานที่เราสังเกตเห็น ไม่มีอะไรถูกอ้างทุกครั้ง
ยังมีข้อค้นพบที่สองซ่อนอยู่ในตารางนั้น โดเมนที่โมเดลเอื้อมไปหยิบ ส่วนใหญ่ไม่ใช่เว็บไซต์เปรียบเทียบที่รู้จักดีในหมวดนี้ เก้าในสิบแปดโดเมนปรากฏเพียงครั้งเดียว และบางส่วนเป็นเว็บเล็กที่เนื้อหาอ่านดูเหมือนประกอบขึ้นมาเพื่อคำค้นนั้น ไม่ได้ดูเหมือนงานรายงาน สำหรับแบรนด์แล้วนี่เป็นดาบสองคม มันหมายความว่าช่องการอ้างอิงนั้นคว้ามาได้ง่ายกว่าอันดับ "เครื่องมือที่ดีที่สุด" แบบดั้งเดิม มันยังหมายความว่าช่องนั้นถูกจับจองโดยคนที่ทำหน้าที่ตรงกับรูปแบบคำค้นในรอบนั้น และจะถูกเติมใหม่ในรอบถัดไป
ผลลัพธ์ที่ 2: ตัวคำตอบเองก็เปลี่ยนขนาด
การอ้างอิงขยับ และความยาวคำตอบก็ขยับตาม
รอบ | โทเคนขาออก | ความยาวคำตอบ | ต้นทุนต่อรอบ |
|---|---|---|---|
1 | 505 | 2,153 ตัวอักษร | $0.0735 |
2 | 860 | 3,728 ตัวอักษร | $0.0770 |
3 | 1,108 | 4,746 ตัวอักษร | $0.0797 |
4 | 832 | 3,555 ตัวอักษร | $0.0765 |
5 | 870 | 3,547 ตัวอักษร | $0.0772 |
6 | 813 | 3,544 ตัวอักษร | $0.0768 |
ความยาวผลลัพธ์อยู่ในช่วง 505 ถึง 1,108 โทเคน ห่างกัน 603 โทเคน หรือราว 73 เปอร์เซ็นต์ของค่าเฉลี่ย คำตอบที่ยาวที่สุดยาวกว่าคำตอบที่สั้นที่สุดกว่าสองเท่า ห้ารอบจากหกตกลงในช่วงแคบพอสมควรระหว่าง 813 ถึง 1,108 โทเคน ส่วนหนึ่งหยุดเร็วที่ 505 และอ้างอิงเพียงห้าแหล่งแทนที่จะเป็นเก้าถึงสิบสี่แหล่ง
สำหรับการวัดแล้ว เรื่องนี้สำคัญอย่างเฉพาะเจาะจง ถ้าตัวติดตามของคุณจับว่า "แบรนด์ปรากฏในคำตอบหรือไม่ และอยู่ตำแหน่งไหน" รอบที่สั้นกว่าก็มีช่องให้ปรากฏน้อยกว่า ทีมที่สุ่มตัวอย่างสัปดาห์ละครั้งแล้วบังเอิญได้รอบสั้น จะบันทึกผลลัพธ์ที่แย่กว่าทีมที่ได้รอบยาว ทั้งที่บนเว็บไซต์ไม่มีอะไรเปลี่ยน
ผลลัพธ์ที่ 3: บางพรอมป์ไม่ได้รับการอ้างอิงเลย
พรอมป์ที่สอง เรื่องการติดตาม AI Overviews เดินผ่านเส้นทางการค้นหาเว็บเดียวกันสี่ครั้ง และคืนค่าศูนย์การอ้างอิงทุกครั้ง
รอบ | โทเคนขาออก | ความยาวคำตอบ | การอ้างอิง |
|---|---|---|---|
1 | 479 | 2,135 ตัวอักษร | 0 |
2 | 522 | 2,240 ตัวอักษร | 0 |
3 | 534 | 2,312 ตัวอักษร | 0 |
4 | 497 | 2,228 ตัวอักษร | 0 |
คำตอบนิ่งในเรื่องความยาว เปลี่ยนไปเพียง 8 เปอร์เซ็นต์ตลอดสี่รอบ แต่โมเดลตอบจากความรู้ของตัวเองโดยไม่เอ่ยชื่อแหล่งใด ทำให้คอลัมน์การอ้างอิงไม่มีอะไรให้บันทึก
ผลที่ตามมาคือการอ่านค่าของตัวติดตามที่เฉพาะเจาะจงและทำให้เข้าใจผิด แดชบอร์ดอัตราการถูกอ้างอิงจะแสดงศูนย์สำหรับคำถามนี้ และมันดูเหมือนความล้มเหลวด้านการมองเห็น มันไม่ใช่ นี่คือรูปแบบคำถามที่ไม่กระตุ้นให้ค้นหาแหล่งข้อมูล การอ่านที่ถูกต้องคือ "การอ้างอิงไม่เกี่ยวข้อง" และตัวติดตามที่ไม่สามารถแยกสิ่งนี้ออกจาก "ตรวจการอ้างอิงแล้วแต่คุณไม่ปรากฏ" จะทำให้คุณไล่ตามปัญหาที่ไม่มีอยู่จริง
ผลลัพธ์ที่ 4: การเปลี่ยนโมเดลคือการวัดอีกครั้ง ไม่ใช่การทำซ้ำ
เมื่อปิดการค้นหาเว็บ เราวัดว่าแต่ละโมเดลเอ่ยชื่อผลิตภัณฑ์ใด วิธีนี้แยกชุดคำแนะนำของโมเดลเองออกจากสิ่งที่ดัชนีค้นหาคืนมาในนาทีนั้น
Claude Sonnet 5 เอ่ยชื่อสินค้าสี่ถึงห้าชิ้นต่อรอบ ตลอดสามรอบมันเอ่ยชื่อสินค้าต่างกันหกชิ้น ได้แก่ AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat และ SerpWatcher สามชิ้นในนั้นปรากฏทั้งสามรอบ ได้แก่ AccuRanker, Ahrefs และ SEMrush ค่าการทับซ้อนเฉลี่ยแบบจับคู่ 0.587
Gemini 3.8 Flash เอ่ยชื่อสินค้าสองถึงห้าชิ้นต่อรอบ ตลอดสามรอบมันเอ่ยชื่อสินค้าต่างกันเจ็ดชิ้น ได้แก่ AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush และ Wincher มีเพียงชิ้นเดียวคือ SE Ranking ที่ปรากฏทั้งสามรอบ ค่าการทับซ้อนเฉลี่ยแบบจับคู่ 0.306
ระหว่างสองโมเดล มีสี่ผลิตภัณฑ์ที่ทั้งคู่เอ่ยถึง และห้าผลิตภัณฑ์ที่ฝ่ายเดียวเอ่ยถึง
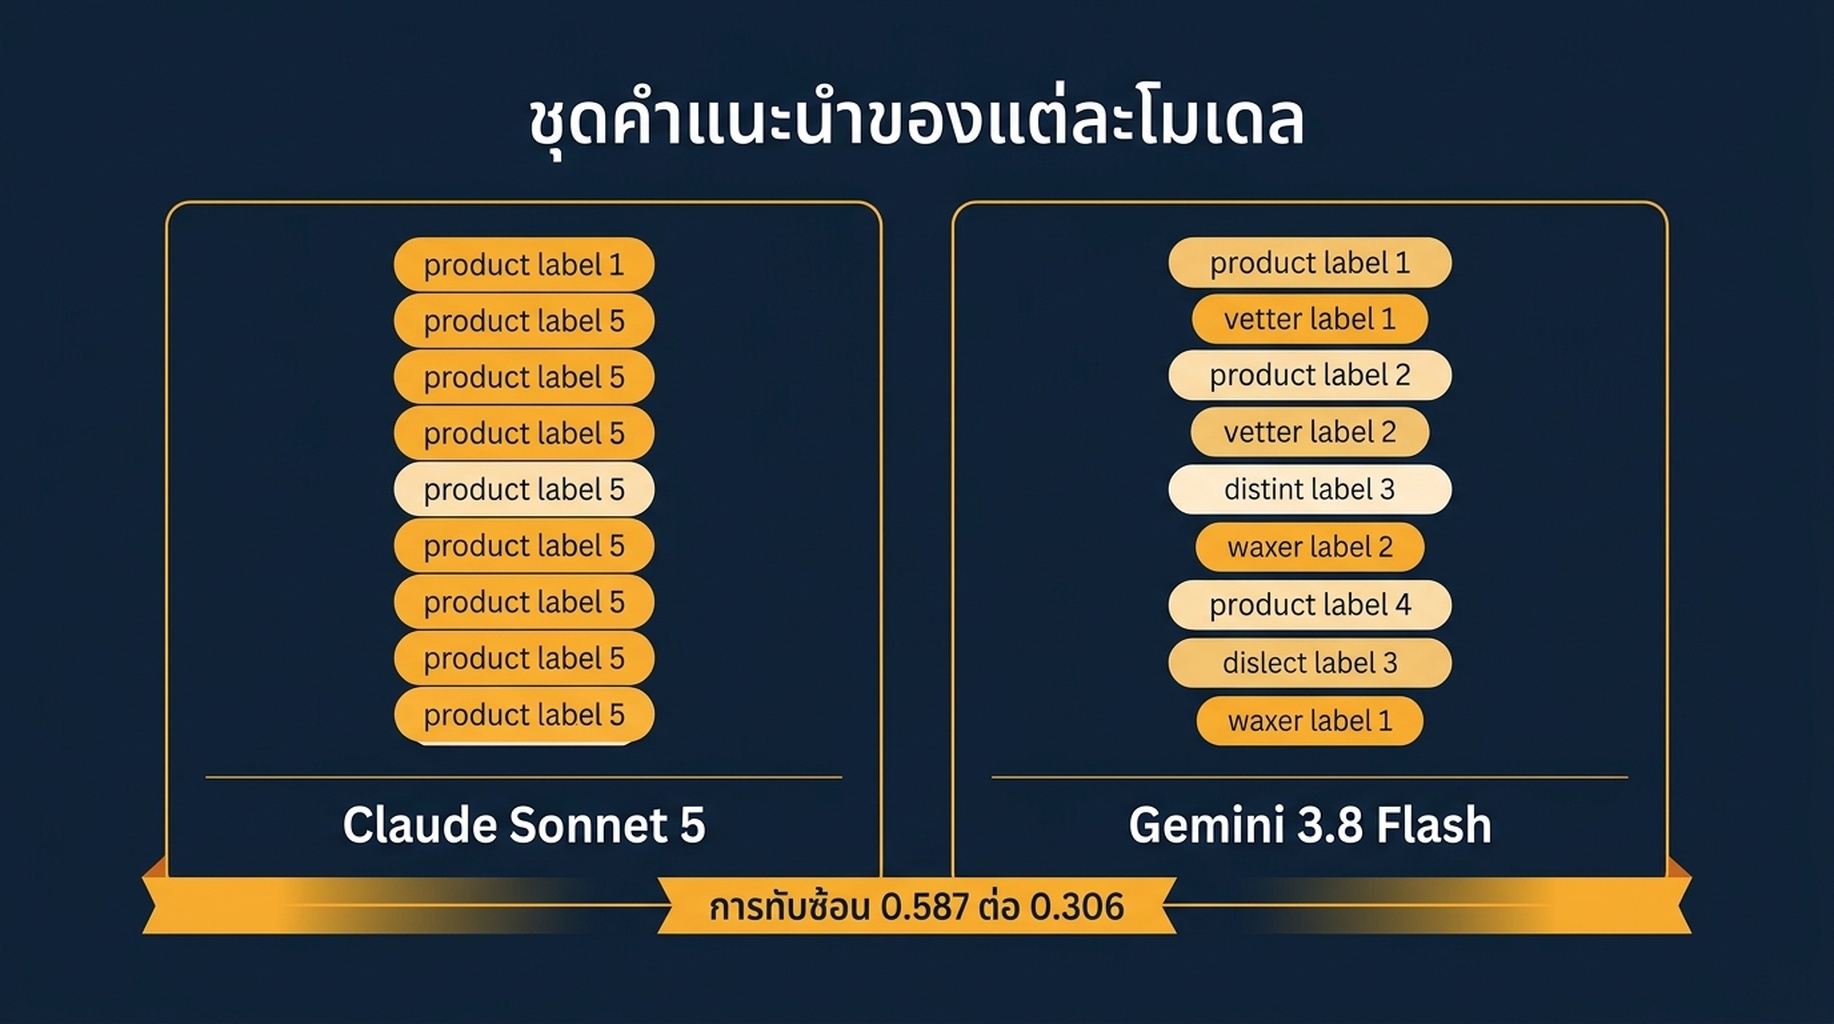
คำถามเดียวกันให้ชุดคำแนะนำที่ต่างกันบางส่วนในแต่ละโมเดลและแต่ละรอบ
ข้อสรุปในทางปฏิบัติคือ ถ้าคุณติดตาม "การมองเห็นใน AI" เป็นตัวเลขเดียว คุณกำลังเฉลี่ยข้ามแหล่งความแปรปรวนอิสระอย่างน้อยสองแหล่ง คือรอบและโมเดล แบรนด์ที่ปรากฏสม่ำเสมอในผู้ช่วยตัวหนึ่งและไม่ปรากฏในอีกตัวคือข้อค้นพบจริงที่ลงมือทำได้ ส่วนแบรนด์ที่ค่าที่วัดจากตัวอย่างเดียวขยับไปสองตำแหน่งคือสัญญาณรบกวน
ตัวติดตามการมองเห็นใน AI ควรบันทึกอะไร
สี่ฟิลด์เปลี่ยนภาพหน้าจอให้กลายเป็นการวัด
จำนวนรอบ ไม่ใช่ผลของรอบ เก็บทุกรอบและรายงานเป็นช่วง "ถูกอ้างใน 4 จาก 6 รอบ" คือข้อเท็จจริง "ถูกอ้าง ตำแหน่งที่ 3" คือความบังเอิญ หกรอบเป็นพื้นขั้นต่ำที่สมเหตุสมผลสำหรับโปรแกรมเล็ก ๆ สิบสองรอบดีกว่าถ้าพรอมป์นั้นสำคัญเชิงพาณิชย์
แยกฟิลด์การอ้างอิงออกจากฟิลด์การถูกเอ่ยถึง "โมเดลแนะนำเรา" กับ "โมเดลลิงก์มาที่เรา" เป็นผลลัพธ์คนละอย่างที่ต้องแก้คนละวิธี หกรอบของเราสร้างการอ้างอิง 18 รายการจาก URL ต่างกัน 18 รายการ ตัวติดตามที่บันทึกแต่การเอ่ยถึงแบรนด์จะจับความผันผวนนี้ไม่ได้เลย
สถานะช่องทางของคำตอบ บันทึกว่ารอบนั้นใช้การค้นหาเว็บหรือไม่ และบันทึกความยาวคำตอบ รอบที่อ้างอิงศูนย์กับรอบที่ถูกเอ่ยถึงศูนย์ดูเหมือนกันบนแดชบอร์ดแต่หมายความตรงกันข้าม
ข้อความพรอมป์แบบคำต่อคำ พร้อมเลขเวอร์ชัน ถ้อยคำของพรอมป์กำหนดว่าจะดึงแหล่งใดเข้ามา ถ้าพรอมป์เปลี่ยนระหว่างเดือน เส้นแนวโน้มก็ขาด จัดเวอร์ชันพรอมป์เหมือนที่คุณจัดเวอร์ชันสคริปต์ติดตาม
การสร้างลูปการรัน
การตรวจด้วยมือทนไม่ไหวเมื่อเจอกับปฏิทินหนึ่งครั้ง ลูปคือสคริปต์ที่รันพรอมป์ N ครั้ง เก็บคำตอบดิบทุกครั้งพร้อมการอ้างอิงของมัน แล้วเปรียบเทียบหน้าต่างปัจจุบันกับหน้าต่างก่อนหน้า
งานนี้เหมาะกับเอเจนต์ เพราะเป็นงานซ้ำ มีกฎกำกับ และต้องมีบันทึกเป็นลายลักษณ์อักษร ใน Claude Code หรือ Codex คำสั่งที่มีประโยชน์คือ ให้เก็บการรันดิบไว้บนดิสก์และห้ามเขียนทับ แล้วรายงานเป็นตารางสรุปแทนตัวเลขเดียว ถ้าคุณดึงข้อมูล Search Console และ Bing ผ่านเซิร์ฟเวอร์ MCP อยู่แล้ว เซสชันเดียวกันนั้นสามารถวางบันทึกการอ้างอิงไว้ข้างข้อมูลการแสดงผล และตรงนั้นเองที่ตัวเลขสองตัวเริ่มมีประโยชน์ด้วยกัน บันทึกของเราเกี่ยวกับสิ่งที่เซิร์ฟเวอร์เหล่านั้นเปิดเผยอยู่ในสี่เซิร์ฟเวอร์ SEO MCP ทำอะไรจริง ๆ ส่วนด้าน "การมีอยู่" ของปัญหาเดียวกันอยู่ในภาพรวม AI Overview สี่สิบคำค้นของเรา
กฎการออกแบบข้อหนึ่งสำคัญกว่าข้ออื่น ผลลัพธ์ของตัวติดตามต้องเป็นการกระจาย รายงานว่า "ถูกอ้างใน 4 จาก 6 รอบ" ไม่ใช่ "ถูกอ้าง" รายงานรายการแหล่ง ไม่ใช่แหล่งอันดับหนึ่ง แดชบอร์ดใดที่บีบหกรอบให้เหลือตัวเลขเดียวได้โยนข้อมูลชิ้นเดียวที่การรันเพิ่มเติมซื้อมาไปแล้ว
ถ้าเป้าหมายคือการเทียบกับคู่แข่งมากกว่าการเฝ้าติดตาม ลูปติดตามอันดับตามเวลาจะเป็นเครื่องมือที่เหมาะกว่า และข้อแลกเปลี่ยนระหว่างแหล่งข้อมูลอยู่ในสร้างตัวติดตามอันดับจากสองแหล่ง
ข้อจำกัดของตัวอย่างหกรอบ
ข้อสงวนตรงไปตรงมาสามข้อ
ตัวอย่างเล็ก หกรอบตีกรอบการกระจายได้เพียงหลวม ๆ มันยืนยันได้ว่าการทับซ้อนระหว่างรอบเป็นเพียงบางส่วนและคู่ที่ทับซ้อนเป็นศูนย์นั้นเกิดขึ้นจริง แต่มันไม่ได้ให้ช่วงความเชื่อมั่นสำหรับหมวดหมู่ของคุณ
ผลลัพธ์ผูกกับเวลา การรันเหล่านี้ทำเมื่อวันที่ 12 กันยายน 2026 กับโมเดลที่ใช้งานจริง ทั้งโมเดลและผลการค้นหาที่รองรับมันล้วนเปลี่ยน
โดเมนที่ถูกอ้างเป็นตัวอย่างจากพรอมป์เชิงพาณิชย์หนึ่งคำค้น รูปแบบคำถามที่ต่างออกไป เช่นคำถามเปรียบเทียบหรือคำถามวิธีการ จะให้รูปแบบการอ้างอิงที่ต่างออกไป วิธีที่ได้ผลคือรันดีไซน์เดียวกันกับสิบพรอมป์ที่มีคุณค่าทางพาณิชย์สูงสุดของคุณ แล้วบันทึกว่าหมวดหมู่ของคุณทำตัวอย่างไร
คำถามที่พบบ่อย
ต้องรันกี่รอบก่อนที่ตัวเลขการมองเห็นใน AI จะมีความหมาย หกรอบคือพื้นขั้นต่ำที่ใช้ได้จริงสำหรับพรอมป์เดียว และควรรายงานตัวเลขเป็นจำนวนนับจากจำนวนรอบทั้งหมด ไม่ใช่เป็นตำแหน่ง ถ้าพรอมป์นั้นขับเคลื่อนการตัดสินใจเรื่องรายได้ สิบสองรอบให้ค่าที่แน่นกว่าในราคาไม่กี่ดอลลาร์
นั่นหมายความว่าการติดตามการมองเห็นใน AI ไม่คุ้มทำหรือ มันหมายความว่าการติดตามจากตัวอย่างเดียวไม่คุ้ม ความแปรปรวนนั่นแหละคือข้อค้นพบ ตัวติดตามที่รายงานว่า "ถูกอ้างใน 4 จาก 6 รอบ แหล่งอ้างอิงเปลี่ยนไป 12 โดเมนตั้งแต่เดือนที่แล้ว" กำลังอธิบายระบบจริงที่คู่แข่งกำลังแข่งขันอยู่ในนั้น
ทำไมพรอมป์หนึ่งถึงคืนค่าศูนย์การอ้างอิง โมเดลตอบจากความรู้ของตัวเองแทนที่จะไปค้นหาแหล่งข้อมูล นั่นเป็นคุณสมบัติของคำถาม ไม่ใช่ความล้มเหลวของเว็บไซต์คุณ ให้ติดตามเป็น "ไม่เกี่ยวข้อง" ไม่ใช่ศูนย์
ควรติดตาม ChatGPT, Claude และ Gemini แยกกันไหม ควร ในการเปรียบเทียบสามรอบของเรา สองโมเดลทับซ้อนกันเพียงสี่จากเก้าผลิตภัณฑ์ที่ถูกเอ่ยชื่อ การเฉลี่ยจะกลบการตัดสินใจระดับโปรแกรมว่าจะปรับผู้ช่วยตัวไหนก่อน
ลดความแปรปรวนได้ไหมด้วยการลดอุณหภูมิของโมเดล ได้บางส่วน และควรลองกับพรอมป์ของคุณ แต่ชุดการอ้างอิงยังถูกขับเคลื่อนด้วยดัชนีค้นหา ซึ่งคุณควบคุมไม่ได้ จำนวนรอบคือคันโยกที่น่าเชื่อถือกว่า
มุมมองของ Auspia: ถ้าคุณกำลังสร้างการติดตามการมองเห็นใน AI ไตรมาสนี้ ให้สร้างบันทึกการรันก่อนแดชบอร์ด แดชบอร์ดคือทางเลือกในการแสดงผล บันทึกการรันคือการวัด เริ่มจากสิบพรอมป์ อย่างละหกรอบ เก็บแบบคำต่อคำ แล้วคุณจะเรียนรู้อะไรในหนึ่งสัปดาห์ได้มากกว่าที่การตรวจจากตัวอย่างเดียวทั้งปีจะบอกคุณ
ผู้เขียน: Ethan Marlowe, หัวหน้าการวัด GEO ครอบคลุมพรอมป์กว่า 500 รายการที่ Auspia เขียนเกี่ยวกับการติดตามพรอมป์ รายงานการอ้างอิง และแดชบอร์ดการมองเห็นที่ทนทานต่อวงจรการวัดจริง