สิ่งที่คุณจะได้หลังอ่านจบ
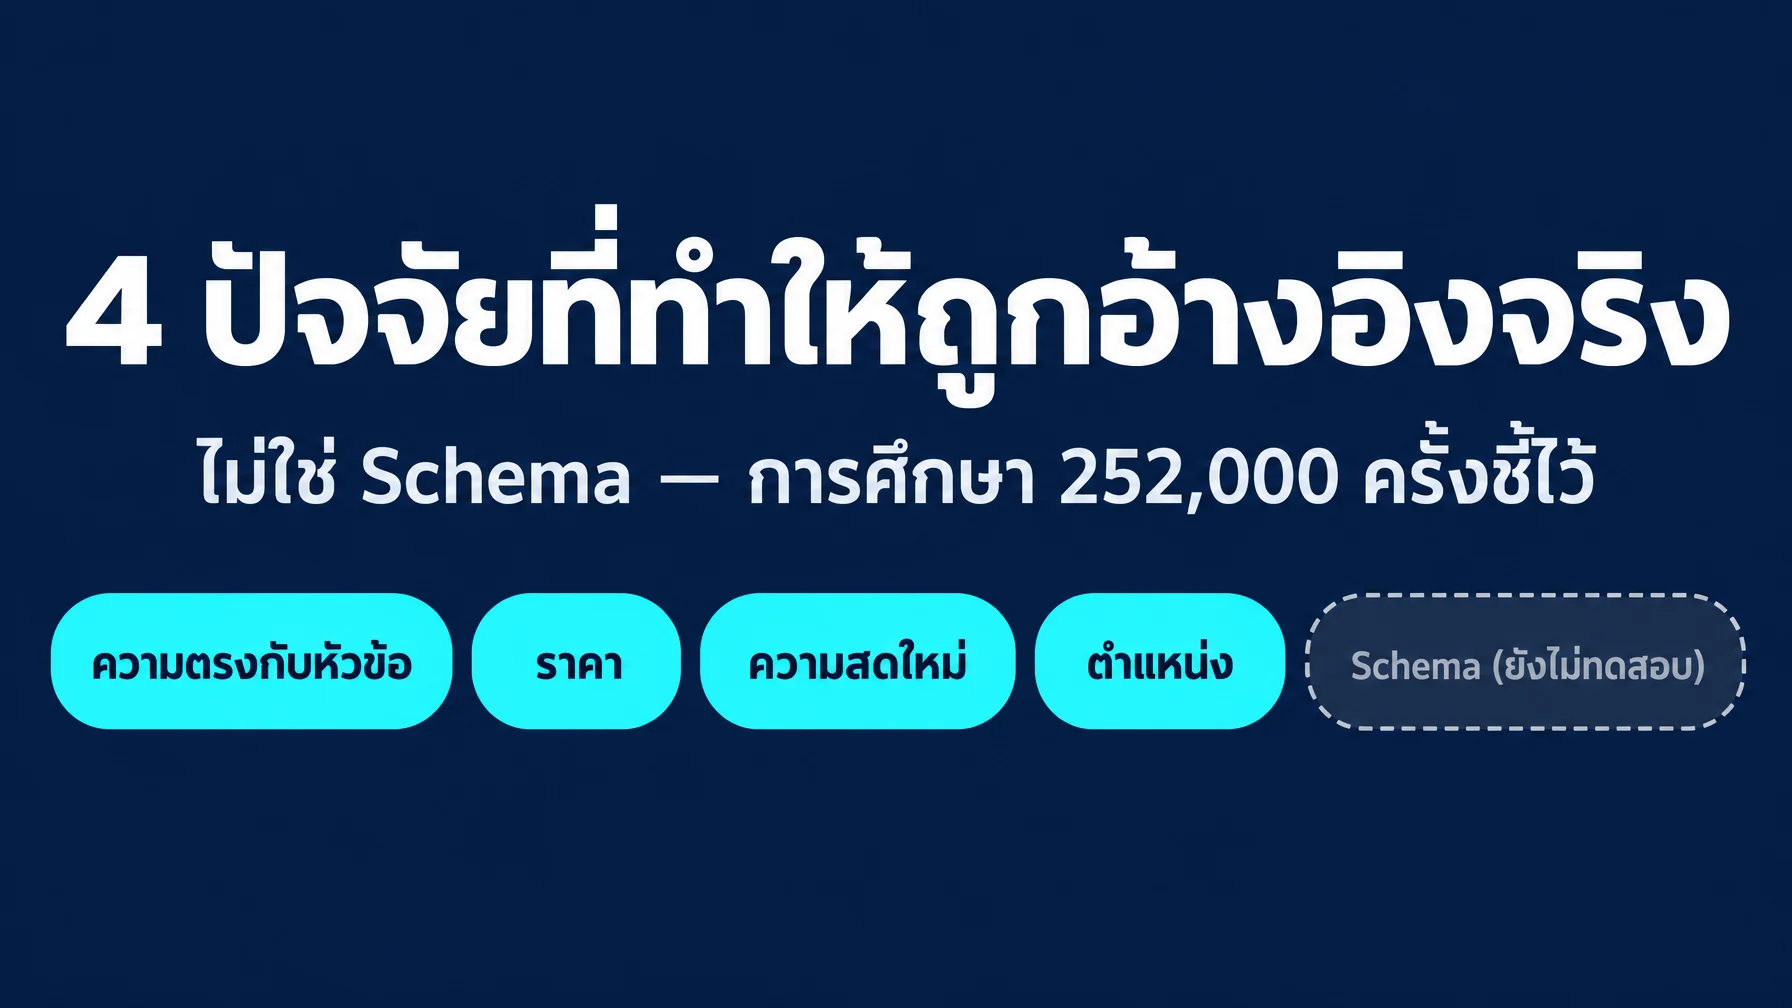
การตรวจหน้าเว็บระดับหน้า เทียบกับสี่ปัจจัยที่การศึกษาทดลองแบบมีกลุ่มควบคุมซึ่งรัน 252,000 ครั้งชี้ว่าเป็นตัวชี้ขาดของการถูกอ้างอิงโดย AI พร้อมลำดับการแก้ปัจจัยรองอีกเจ็ดข้อที่จะเริ่มได้ผลเมื่อสี่ข้อแรกเข้าที่แล้ว คุณจะเข้าใจด้วยว่าทำไมคำกล่าวอ้างที่แพร่หลายว่า "มาร์กอัป Schema ไม่มีผลต่อการอ้างอิงของ AI เลย" จึงไม่ใช่ข้อสรุปจริงของการศึกษาชิ้นนั้น พร้อมแหล่งอ้างอิง เพื่อคุณจะไม่เสียสปรินต์ไปกับการแก้อะไรที่ผิดจุด
เหมาะกับใคร: ทุกคนที่ดูแล SEO หรือ GEO ระดับหน้าเว็บ ให้กับเว็บไซต์ที่ต้องการถูกอ้างอิงใน ChatGPT, Gemini, Perplexity, Claude หรือคำตอบ AI ของ Google
เวลาที่ใช้: 30-45 นาทีต่อหนึ่งหน้า รวมการตรวจและรอบแก้ครั้งแรก
เสร็จเมื่อ: หน้าที่คุณตรวจผ่านด่านทั้งสี่ข้อ และคุณมีรายการปัจจัยรองที่ยังต้องแก้เป็นลายลักษณ์อักษร
ก่อนเริ่ม: เช็กลิสต์นี้ยึดอะไรเป็นฐาน และมันแก้ความเข้าใจผิดอะไร
มีโพสต์ที่วนอยู่ในวงการ SEO/GEO อ้างว่าการศึกษา SIGIR รันการทดลอง 252,000 ครั้งบน LLM หกตัว แล้วพบว่ามาร์กอัป Schema และ JSON-LD มี "ผลที่วัดได้เป็นศูนย์" ต่อการอ้างอิงของ AI ขณะที่ราคา ความสดใหม่ สเปก และความลึกขยับผลลัพธ์ได้แรง
การศึกษานั้นมีจริง จำนวนครั้งที่ทดลองก็ถูกต้อง ค่าอัตราส่วนอัตราต่อรองในโพสต์นั้นก็ใกล้เคียงตัวเลขจริง สิ่งที่ไม่สมเหตุสมผลมีอยู่อย่างเดียว คือการศึกษาชิ้นนั้นไม่เคยทดสอบมาร์กอัป Schema เลย ไม่ใช่ว่า Schema "วัดได้ศูนย์" แต่ Schema ไม่ได้อยู่ในรายการสิ่งที่ถูกวัดตั้งแต่แรก
งานวิจัยชิ้นนี้คือ "What Gets Cited: Competitive GEO in AI Answer Engines" (Vishwakarma, Kumar, Jamidar, Sprinklr; SIGIR '26, เมลเบิร์น) การออกแบบคือป้อนแหล่งข้อมูลผู้เข้าชิงสองแหล่งพอดีเข้าไปใน LLM หกตัว (Gemini-2.5-Flash, Claude-3.5-Sonnet, Kimi-K2-Thinking และ GPT-5 อีกสามรุ่น) โดยแต่ละคู่ต่างกันเพียงหนึ่งใน 18 ปัจจัยด้านเนื้อหา แล้วบันทึกว่าแหล่งใดถูกอ้างอิงก่อน ปัจจัยทั้ง 18 ครอบคลุมความตรงกับเนื้อหา ความครบถ้วน ความน่าเชื่อถือ ความอ่านง่าย สถานะการแข่งขัน และความสดใหม่ รูปแบบข้อมูลแบบมีโครงสร้างไม่ปรากฏในทั้ง 18 ข้อ ซึ่งยืนยันได้จากการเทียบกับตารางอนุกรมวิธานของงานวิจัยเองโดยตรง
ถ้าคุณอยากได้คำตอบจริงเรื่อง Schema คำตอบมาจากอีกแหล่งหนึ่ง คือการศึกษาทดลองแบบมีกลุ่มควบคุมของ Ahrefs เมื่อเดือนพฤษภาคม 2026 ที่เปรียบเทียบ 1,885 หน้าที่เพิ่ม JSON-LD เข้าไปกับหน้ากลุ่มควบคุมอีก 4,000 หน้า ผลคือไม่มีการเพิ่มขึ้นของการอ้างอิงอย่างมีความหมายบน Google AI Overviews (-4.6% ลดลงเล็กน้อยแต่มีนัยสำคัญทางสถิติ) Google AI Mode (+2.4% ไม่มีนัยสำคัญ) และ ChatGPT (+2.2% ไม่มีนัยสำคัญ) ส่วนการทดสอบอีกชิ้นของ searchVIU พบว่า ChatGPT, Claude, Perplexity, Gemini และ Google AI Mode ไม่อ่าน JSON-LD, Microdata ที่ซ่อนอยู่ หรือ RDFa ที่ซ่อนอยู่ ในระหว่างการค้นหาแบบเรียลไทม์เลย
แยกสองเรื่องนี้ให้ชัดก่อนลงมือตรวจ การศึกษา SIGIR บอกคุณว่าควรจัดลำดับความสำคัญอะไรบนหน้าเว็บ ส่วนการศึกษา Ahrefs บอกว่า Schema ไม่ใช่หนึ่งในลำดับความสำคัญเหล่านั้น ในแง่ปริมาณการอ้างอิงโดยเฉพาะ ถึงแม้มันยังมีผลในเรื่องผลการค้นหาแบบสมบูรณ์และความชัดเจนของเอนทิตีในบริบทอื่น
ขั้นที่ 1: ตรวจด่านทั้งสี่
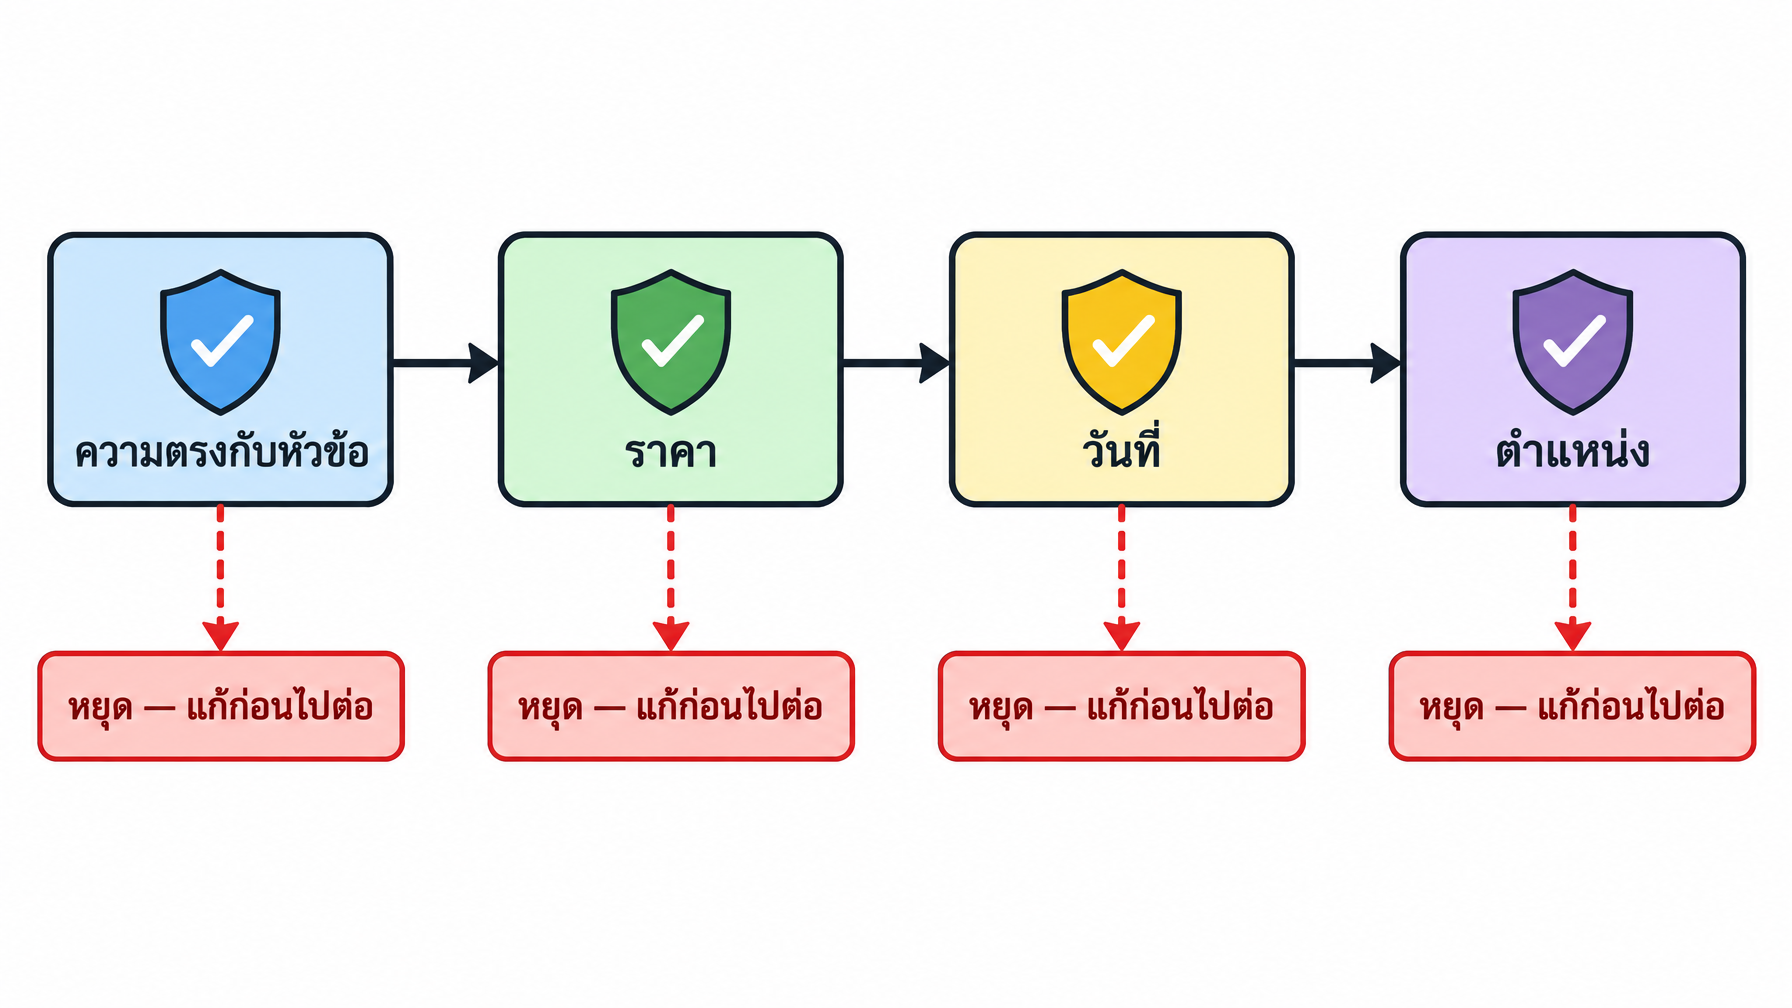
ตรวจหน้าเว็บของคุณเทียบกับสี่ปัจจัยนี้ การศึกษา SIGIR พบว่าทั้งสี่ข้อเป็นเอกฉันท์ในทั้งหกโมเดล โดยมีผลขนาดใหญ่มาก (อัตราส่วนอัตราต่อรองเกิน 100 ในโมเดลส่วนใหญ่) การล้มเหลวเพียงข้อเดียวสามารถลบล้างโอกาสถูกอ้างอิงได้ทั้งหมด ไม่ว่าส่วนที่เหลือของหน้าจะแข็งแรงแค่ไหน
ด่าน | สิ่งที่ตรวจ | ช่วงอัตราส่วนอัตราต่อรอง (จากหกโมเดลที่ทดสอบ) |
|---|---|---|
ความตรงกับหัวข้อ | หน้านี้ตอบคำค้นที่มันต้องการครองอันดับโดยตรงหรือไม่ ไม่ใช่ตอบหัวข้อที่ใกล้เคียง | ชี้ขาดใน 5 จาก 6 โมเดล |
ระบุราคา | มีราคาที่เป็นตัวเลขชัดเจนมองเห็นได้บนหน้า ไม่ได้ซ่อนอยู่หลัง "ติดต่อเรา" | 6.26 ถึงเกิน 10,000 |
วันที่ล่าสุด | มีวันที่เผยแพร่หรือวันที่ตรวจทานล่าสุดที่ปัจจุบันและถูกต้องหรือไม่ | 14.4 ถึงเกิน 10,000 |
ตำแหน่งในลิสต์ | หน้านี้มีแนวโน้มครองอันดับหนึ่งในบรรดาผู้เข้าชิงของคำค้นนั้น ไม่ใช่อันดับสอง | 1,795 ถึงเกิน 10,000 |
การลงมือทำ: เปิดหน้าเว็บวางข้างคำค้นเป้าหมาย อ่าน 150 คำแรกแล้วถามตัวเองว่าตอบคำค้นนั้นโดยตรงหรือไม่ ค้นหาราคาบนหน้า ถ้าต้องกรอกฟอร์มหรือโทรศัพท์ นั่นคือความล้มเหลว เทียบวันที่ที่แสดงกับเวลาที่เนื้อหาถูกอัปเดตจริงครั้งสุดท้าย ตรวจอันดับหรือส่วนแบ่งการอ้างอิงปัจจุบันของคุณสำหรับคำค้นนั้น
ผลลัพธ์ที่คาดหวัง: ผลผ่านหรือไม่ผ่านของทั้งสี่แถว
การตรวจคุณภาพ: ถ้าความตรงกับหัวข้อไม่ผ่าน ให้หยุดตรงนี้ ขั้นตอนถัดไปไม่มีข้อใดช่วยหน้าเว็บที่ตอบคำถามผิดได้
เส้นทางกู้คืน: ความล้มเหลวด้านราคาและวันที่แก้ได้ภายในวันเดียว (ขั้นที่ 2) ส่วนความล้มเหลวด้านตำแหน่งในลิสต์ไม่ใช่การแก้เนื้อหา มันหมายความว่าพื้นฐาน SEO ต้องได้รับการซ่อมก่อนที่หน้านี้จะแข่งขันเพื่อการอ้างอิงได้เลย และการขัดเกลาบนหน้าเว็บไม่สามารถทดแทนสิ่งนั้นได้
ขั้นที่ 2: แก้ด่านที่ล้มเหลวก่อน
ทำสิ่งนี้ก่อนแตะอย่างอื่น ทั้งหมดนี้คือรายการที่ได้ผลมากที่สุดและใช้แรงน้อยที่สุดในลิสต์นี้
ถ้าไม่มีราคา: ใส่ตัวเลขจริงเข้าไป ถ้าราคาแตกต่างกันไป ให้ประกาศราคาเริ่มต้นจริงหรือช่วงราคาที่ชัดเจนแทนการใช้แบบฟอร์มติดต่อ นี่เป็นหนึ่งในสี่ด่านของการศึกษา
ถ้าวันที่ไม่ใหม่หรือหายไป: อัปเดตวันที่เผยแพร่หรือวันที่ตรวจทานล่าสุด แต่ต้องหลังจากการแก้เนื้อหาจริงแล้วเท่านั้น การเปลี่ยนวันที่โดยไม่มีการอัปเดตจริงคือสัญญาณความสดใหม่ที่คุณยืนยันไม่ได้ถ้าใครมาตรวจ
ถ้าความตรงกับหัวข้ออ่อน: เขียน 150 คำแรกใหม่ให้ตอบโจทย์ของคำค้นนั้นโดยตรง ไม่ใช่หัวข้อที่เกี่ยวข้อง อย่าเอาบทนำใหม่ไปต่อกับโครงเดิม ให้เปลี่ยนไปเลย
การตรวจคุณภาพ: อ่านหน้าเว็บใหม่โดยสมมติว่าคุณคือคำค้นนั้น คนแปลกหน้าจะได้คำตอบที่เป็นรูปธรรมในย่อหน้าแรกไหม
เส้นทางกู้คืน: ถ้าประกาศราคาจริงไม่ได้ (ใบเสนอราคาเฉพาะ ดีลองค์กร) ให้ประกาศราคาเริ่มต้นที่เป็นตัวแทนหรือช่วงราคาทั่วไปแทนที่จะเว้นว่าง เพราะการศึกษาวัดภาวะล้มเหลวจาก "ไม่มีการกล่าวถึงราคา" ไม่ใช่ "ราคาแตกต่างกันไป"
ขั้นที่ 3: จัดการปัจจัยรองที่สร้างความแตกต่าง
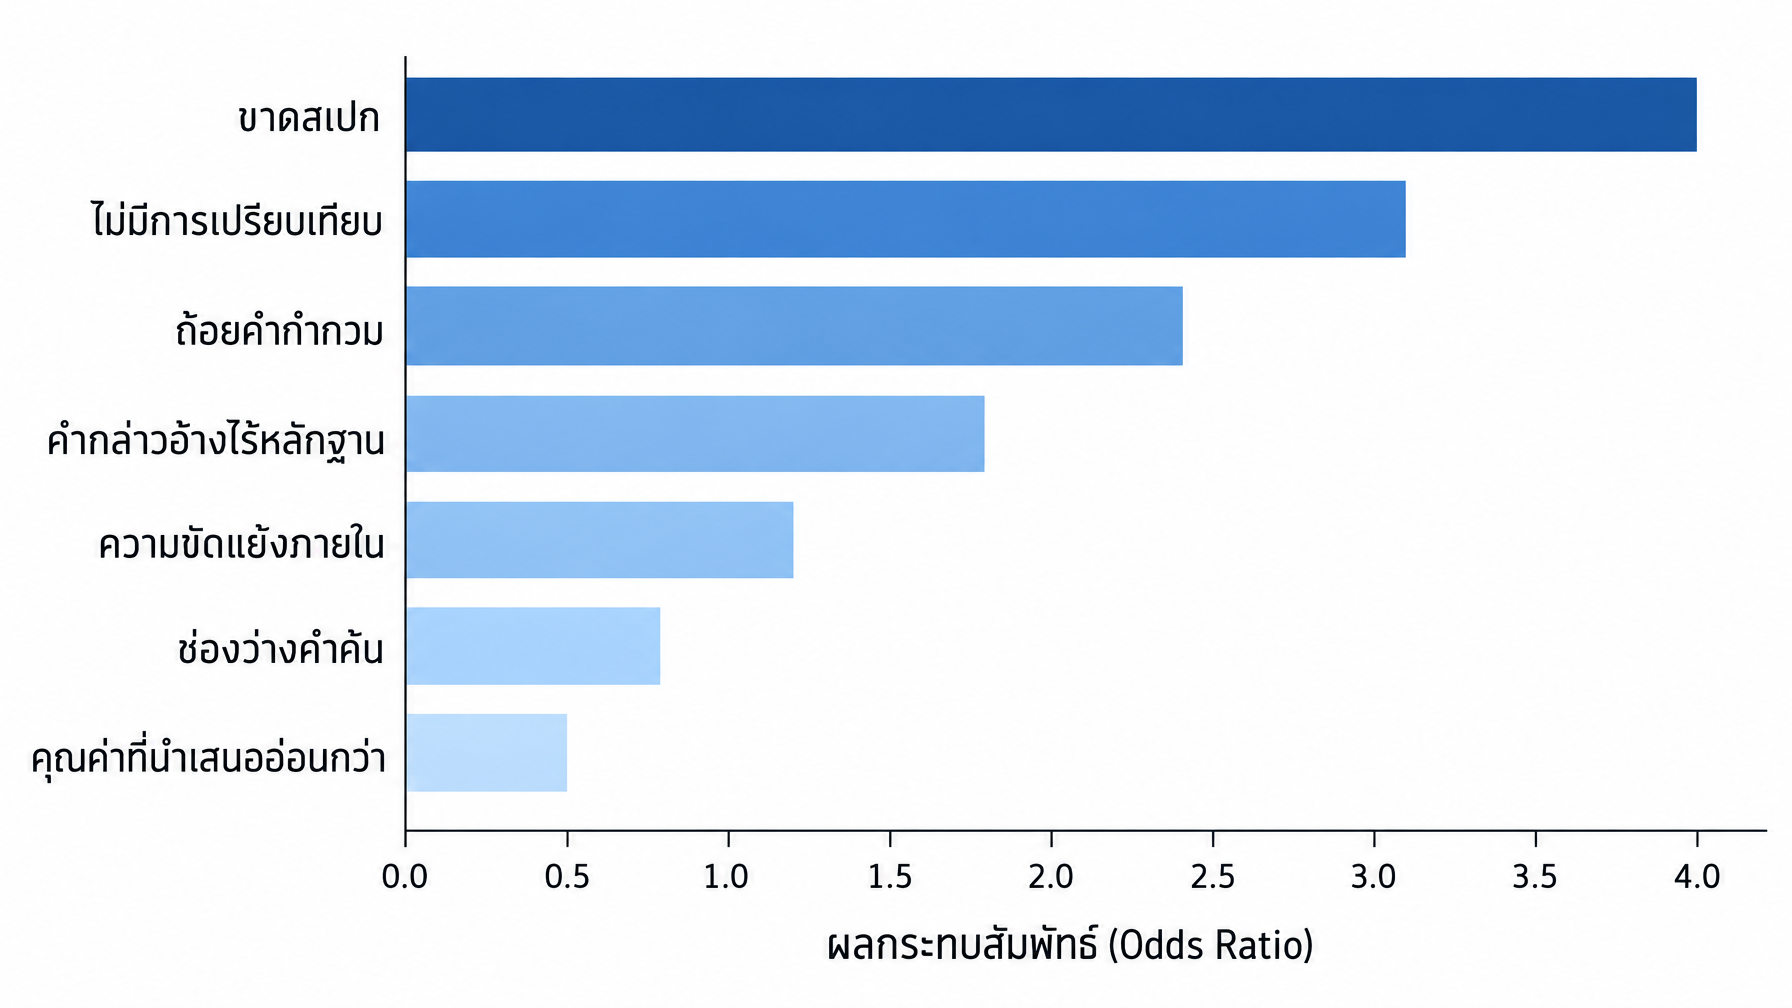
เมื่อด่านทั้งสี่ผ่านแล้ว ปัจจัยเจ็ดข้อต่อไปนี้จะสร้างความแตกต่างในระดับรอง โดยมีอัตราส่วนอัตราต่อรองราว 2 ถึง 243 ขึ้นอยู่กับโมเดล แก้ตามลำดับนี้
- ขาดสเปก เพิ่มสเปกทางเทคนิคที่ผู้ซื้อจะนำมาเปรียบเทียบจริง (ขนาด วัสดุ ความจุ ความเข้ากันได้) อัตราส่วนอัตราต่อรอง 8.63 ถึง 243 ตามโมเดล ซึ่งเป็นหนึ่งในผลระดับรองที่ใหญ่ที่สุด
- ไม่มีการเปรียบเทียบ เพิ่มการเปรียบเทียบตรง ๆ กับทางเลือกที่ระบุชื่ออย่างน้อยหนึ่งรายการ อัตราส่วนอัตราต่อรอง 1.61 ถึง 7.45
- ถ้อยคำกำกวม เปลี่ยน "อาจจะ" "น่าจะ" "เป็นไปได้" ให้เป็นข้อความที่ยืนยันตรงไปตรงมาซึ่งหน้าเว็บรองรับได้จริง
- คำกล่าวอ้างที่ไม่มีหลักฐาน แนบหลักฐานให้กับคำกล่าวอ้าง ทั้งผลการทดสอบ การรับรอง หรือระเบียบวิธีที่ระบุชื่อ
- ความขัดแย้งภายใน ตรวจว่าตัวเลขและคำกล่าวอ้างสอดคล้องกันตลอดทั้งหน้า เรื่องนี้ง่ายที่จะเกิดขึ้นระหว่างแก้ไขและง่ายที่จะมองข้ามตอนตรวจทาน
- ช่องว่างคำค้น ยืนยันว่าในหน้ามีคำที่คำค้นเป้าหมายใช้จริง ไม่ใช่แค่คำพ้องความหมาย
- คุณค่าที่นำเสนออ่อนกว่า ทำให้ข้ออ้างเรื่องประโยชน์เฉพาะของคุณคมชัดขึ้น เทียบกับสิ่งที่หน้าเว็บคู่แข่งเสนอ
การลงมือทำ: ไล่จากบนลงล่างตามลำดับ แล้วแก้ข้อที่เข้าเกณฑ์ ไม่ใช่ทุกหน้าจะมีปัญหาครบทั้งเจ็ดข้อ
ผลลัพธ์ที่คาดหวัง: หน้าเว็บที่ทุกคำกล่าวอ้างนั้นเฉพาะเจาะจง เปรียบเทียบได้ หรือมีหลักฐานรองรับ
การตรวจคุณภาพ: ผู้อ่านที่ตั้งข้อสงสัยจะเจอประโยคที่คลุมเครือหรือไร้หลักฐานเหลืออยู่แม้แต่ประโยคเดียวไหม
เส้นทางกู้คืน: ถ้าเวลาน้อย หยุดที่ข้อ 1 และ 2 (สเปกและการเปรียบเทียบ) ก็ได้ เพราะสองข้อนี้มีอัตราส่วนอัตราต่อรองสูงสุดในทั้งเจ็ดข้อ
ขั้นที่ 4: ข้ามการแก้แค่รูปแบบ
การศึกษาระบุชัดว่าไม่พบผลที่สม่ำเสมอจากการเปลี่ยนย่อหน้าเป็นหัวข้อย่อย การเพิ่มหัวข้อย่อยเพื่อให้อ่านง่าย หรือการจัดเรียงข้อมูลที่กระจัดกระจายใหม่ เพราะโมเดลที่ทดสอบตีความเนื้อหาโดยไม่ขึ้นกับโครงสร้างภาพ ถ้าหน้าของคุณผ่านการตรวจข้างต้นแล้ว อย่าใช้สปรินต์ไปกับการขัดเก่ารูปแบบโดยหวังว่าการอ้างอิงจะเพิ่มขึ้น จัดรูปแบบเพื่อผู้อ่านที่เป็นมนุษย์ ไม่ใช่เพื่อผลการอ้างอิงที่ข้อมูลไม่รองรับ
ขั้นที่ 5: ปล่อยให้ Schema อยู่ที่ที่มันควรอยู่
รักษามาร์กอัป Schema ให้ถูกต้องทางเทคนิค เพราะมันทำงานจริง ช่วยให้ Google และ Bing ตีความผลการค้นหาแบบสมบูรณ์ และทำให้ระบบค้นหาเข้าใจอย่างชัดเจนว่าหน้ากับเอนทิตีคืออะไร สิ่งที่มันไม่ได้ทำ ตามหลักฐานแบบมีกลุ่มควบคุมที่ดีที่สุดที่มีอยู่ คือไม่ได้ขยับโอกาสถูกอ้างอิงโดย AI อย่าเอางาน Schema ไปไว้ก่อนขั้นที่ 1-3 ด้วยเหตุผลว่ามันเป็นคันโยกของการอ้างอิง เพราะไม่มีการศึกษาแบบมีกลุ่มควบคุมใดสนับสนุนเรื่องนี้ และการศึกษาเดียวที่ถูกอ้างมาเพื่อสิ่งนี้ก็ไม่เคยทดสอบ Schema เลย ถ้าคุณอยากได้รายละเอียดว่าการศึกษา Schema ของ Ahrefs วัดอะไรจริง ๆ ดูได้ที่คู่มือ semantic SEO ปี 2026 ของเรา
ตรวจสอบผลลัพธ์ที่เสร็จแล้ว
รันการตรวจจากขั้นที่ 1 ซ้ำบนหน้าเว็บหลังการแก้ไข ด่านทั้งสี่ควรผ่านทั้งหมดแล้ว สุ่มตรวจปัจจัยรองสองถึงสามข้อจากขั้นที่ 3 ที่คุณแก้ไป ถ้าคุณเข้าถึงเครื่องมือติดตามการมองเห็นหรือการอ้างอิงใน AI ได้ เช่น AI Search Visibility Checker ให้บันทึกอัตราการถูกอ้างอิงปัจจุบันของหน้าสำหรับคำค้นเป้าหมายเป็นค่าฐานก่อนไปหน้าถัดไป เพื่อจะบอกได้ในภายหลังว่าการเปลี่ยนแปลงขยับอะไรหรือไม่
รักษาผลลัพธ์ไว้
ตรวจด่านวันที่ซ้ำทุกครั้งที่หน้าเว็บมีการอัปเดตที่มีนัยสำคัญ ไม่ใช่ตามปฏิทินที่กำหนดตายตัว สำหรับหน้าที่สูญเสียส่วนแบ่งการอ้างอิง ให้ตรวจใหม่โดยเริ่มจากด่านทั้งสี่ ก่อนจะสันนิษฐานว่าปัจจัยรองข้อใดข้อหนึ่งหลุด
คำถามที่พบบ่อย
การศึกษา SIGIR ทดสอบมาร์กอัป Schema หรือ JSON-LD ไหม ไม่ ทดสอบ อนุกรมวิธาน 18 ปัจจัยของมันครอบคลุมความตรงกับเนื้อหา ความครบถ้วน ความน่าเชื่อถือ ความอ่านง่าย สถานะการแข่งขัน ความสดใหม่ และตำแหน่งในลิสต์ รูปแบบข้อมูลแบบมีโครงสร้างไม่อยู่ในหมวดหมู่หรือปัจจัยที่ทดสอบเลย ซึ่งยืนยันได้จากการตรวจตารางอนุกรมวิธานของงานวิจัยโดยตรง
แล้วมาร์กอัป Schema ช่วยเรื่องการอ้างอิงโดย AI บ้างไหม หลักฐานแบบมีกลุ่มควบคุมที่ดีที่สุดที่มีอยู่ คือการศึกษาของ Ahrefs เดือนพฤษภาคม 2026 ที่เทียบ 1,885 หน้า กับกลุ่มควบคุมที่จับคู่ไว้ 4,000 หน้า พบว่าไม่มีการเพิ่มขึ้นของการอ้างอิงอย่างมีความหมายจากการเพิ่ม JSON-LD ทั้งบน Google AI Overviews, Google AI Mode และ ChatGPT ส่วนการทดสอบอีกชิ้นพบว่าโมเดล AI หลักหลายตัวไม่อ่านข้อมูลแบบมีโครงสร้างระหว่างการค้นหาแบบเรียลไทม์ นั่นไม่ได้ทำให้ Schema ไร้ค่าในบริบทอื่น มันแค่ไม่ใช่คันโยกของปริมาณการอ้างอิง
ตัวเลขเฉพาะเจาะจงในโพสต์ที่แพร่หลาย (6.3, 14, 4 ถึง 8.6) มาจากไหน มันคล้ายกับอัตราส่วนอัตราต่อรองจริงในตารางผลลัพธ์ของงานวิจัย SIGIR แต่ตัวเลขเหล่านั้นเป็นของปัจจัยด้านราคา ความสดใหม่ และสเปก/การเปรียบเทียบ ไม่ใช่ Schema งานวิจัยรายงานตัวเลขแยกตามโมเดล ไม่ได้รวมเป็นค่าเฉลี่ยเดียว และช่วงความต่างระหว่าง LLM หกตัวที่ทดสอบนั้นกว้างขวางทีเดียว
ถ้ามีเวลาแค่ชั่วโมงเดียว ควรแก้อะไรก่อน ด่านทั้งสี่ ได้แก่ ความตรงกับหัวข้อ ราคา วันที่ และตำแหน่งในลิสต์ การล้มเหลวข้อใดข้อหนึ่งลบล้างโอกาสถูกอ้างอิงได้ทั้งหมด ไม่ว่าบนหน้าจะมีอะไรอื่นอีก
ควรเลิกทำงาน Schema ไปเลยไหม ไม่ควร รักษาไว้ให้ถูกต้องเพื่อผลการค้นหาแบบสมบูรณ์และความชัดเจนของเอนทิตี เพียงแต่อย่าจัดงาน Schema ใหม่ให้สำคัญกว่าการแก้ด่านทั้งสี่ ถ้าปริมาณการอ้างอิงโดย AI คือเป้าหมายจริง
ผู้เขียน: Bennett Hayes, Applied GEO Analyst ประจำ Auspia ผู้รับผิดชอบการรีวิวการนำไปใช้กว่า 400 เคส Bennett เขียนเกี่ยวกับการลงมือทำ GEO ภาคปฏิบัติ การตรวจสอบ และบันทึกการนำไปใช้ที่อ้างอิงจากสิ่งที่การศึกษาแบบมีกลุ่มควบคุมวัดได้จริง