AI विज़िबिलिटी ट्रैकर सुनने में सीधा लगता है। आप असिस्टेंट से कुछ श्रेणी के सवाल पूछते हैं, नोट करते हैं कि आपका ब्रांड दिखा या नहीं, और उसे समय के साथ ग्राफ़ पर उतार देते हैं।
दिक्कत रिकॉर्डिंग से ऊपर की ओर है। जो आप माप रहे हैं, वह जगह पर टिकता नहीं। एक ही प्रॉम्प्ट एक ही मॉडल को दो बार भेजिए और आपको दो ऐसे जवाब मिलेंगे जो सिर्फ़ आंशिक रूप से ओवरलैप करते हैं। उनमें से एक रिकॉर्ड कर लीजिए और आपने किसी वितरण से निकाला गया एक नमूना रिकॉर्ड किया, फिर उसे तथ्य की तरह पेश कर दिया।
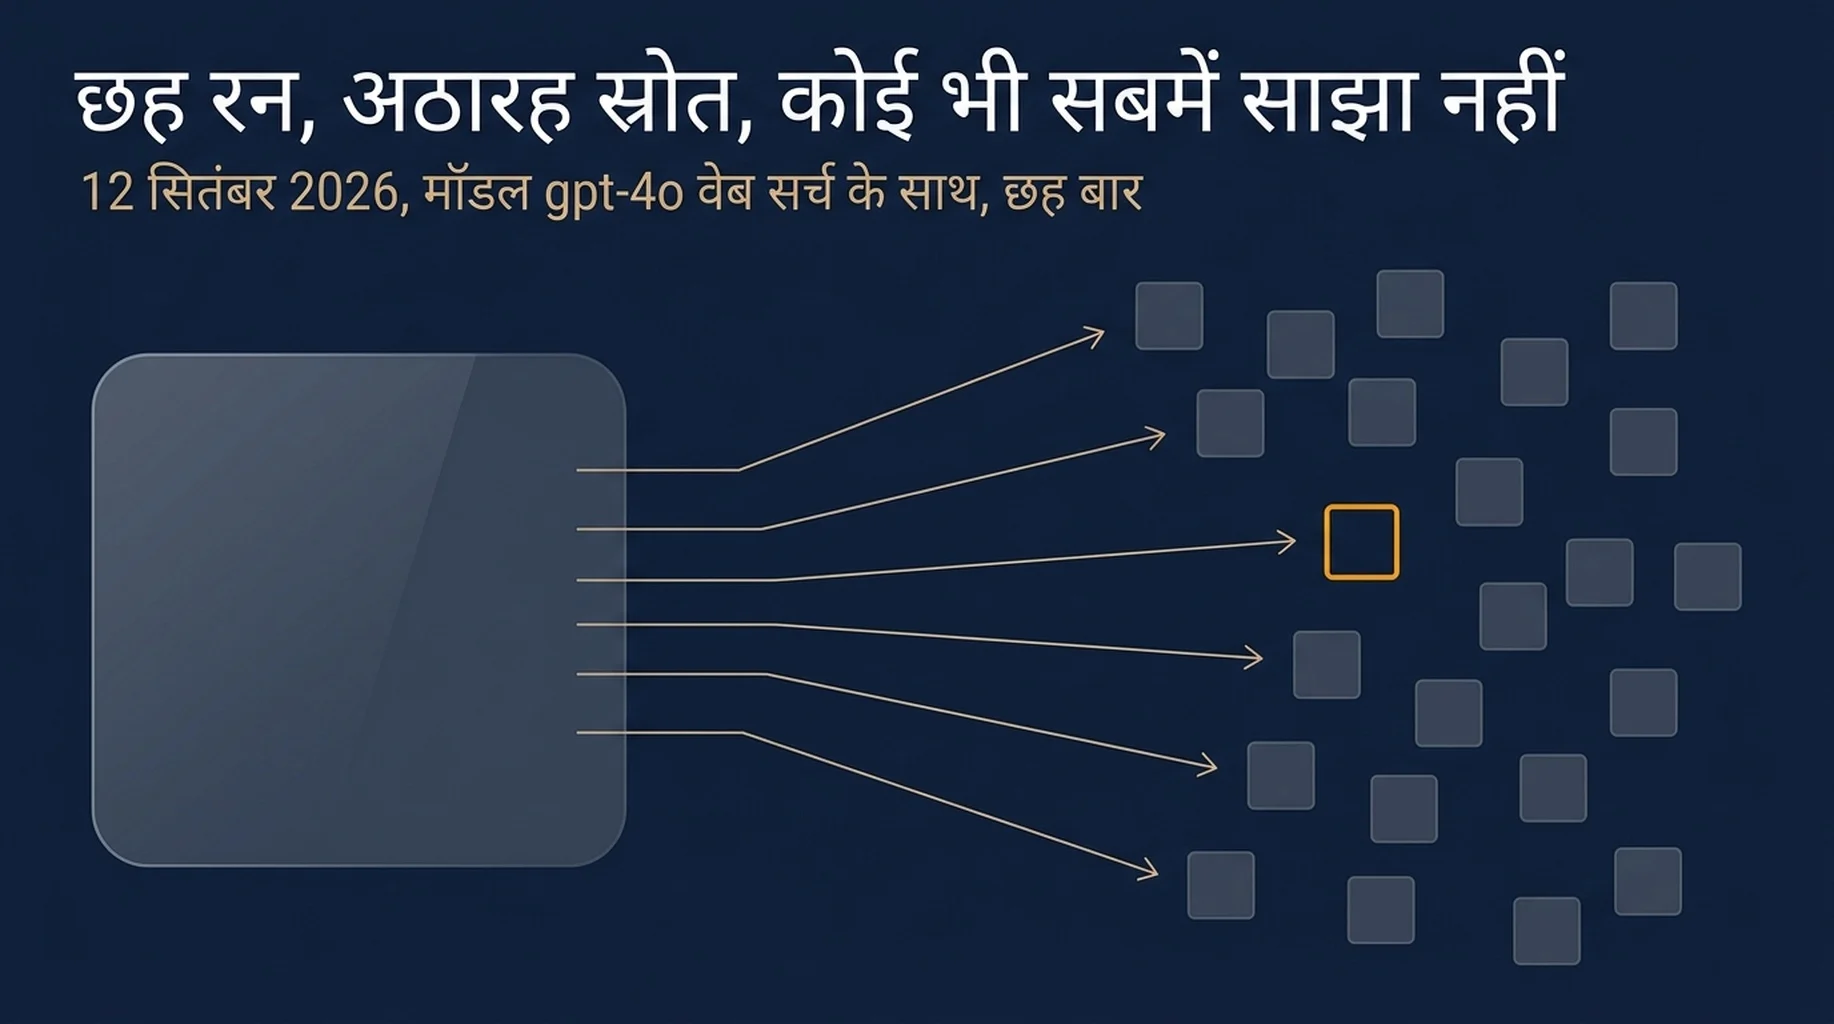
हम जानना चाहते थे कि यह फैलाव असल में कितना बड़ा है, इसलिए मान लेने के बजाय हमने प्रयोग चलाया। छोटी बात यह है: छह एक जैसे अनुरोधों से अठारह उद्धृत स्रोत निकले, और कोई भी स्रोत छहों में उद्धृत नहीं हुआ।
यह लेख इस बारे में है कि हमने क्या चलाया, क्या लौटा, और वे चार फ़ील्ड कौन-से हैं जो एक AI विज़िबिलिटी ट्रैकर को सहेजने ही चाहिए ताकि यह संख्या अगले महीने भी देखने लायक रहे।
हमने क्या चलाया
दो प्रयोग, दोनों ऐसे प्रॉम्प्ट पर जो कोई SaaS टीम श्रेणी की रिसर्च में सचमुच इस्तेमाल करेगी।
प्रयोग 1: एक प्रॉम्प्ट, एक मॉडल, छह रन। मॉडल gpt-4o, वेब सर्च चालू, संयुक्त राज्य, अंग्रेज़ी। प्रॉम्प्ट: "2026 में एक छोटी SaaS टीम के लिए सबसे अच्छे रैंक ट्रैकिंग टूल कौन-से हैं? स्रोतों के साथ एक छोटी सूची दीजिए।" छह अलग लाइव कॉल, उसी सत्र विंडो में एक के बाद एक चलाए गए।
प्रयोग 2: दो मॉडल, वही प्रॉम्प्ट, तीन-तीन रन। वही प्रॉम्प्ट Claude Sonnet 5 और Gemini 3.8 Flash को तीन-तीन बार भेजा गया, बिना वेब सर्च। बिना सर्च के हम यह मापते हैं कि मॉडल अपने ज्ञान से कौन-से उत्पाद गिनाता है, और यह इस बात से अलग संकेत है कि वह किन स्रोतों का हवाला देता है।
हमने दूसरा प्रॉम्प्ट भी उसी वेब सर्च रास्ते से चार बार भेजा, यह देखने के लिए कि सवाल के अलग-अलग प्रकारों में हवाले का व्यवहार एक-सा रहता है या नहीं: "मैं अपनी साइट के लिए AI Overviews को कैसे ट्रैक करूं? स्रोतों के साथ ठोस तरीके बताइए।"
छह रन कोई बड़ा नमूना नहीं है, और हम इसे वैसे ही मानते हैं। यह दिशा और फैलाव का मोटा परिमाण दिखाने के लिए काफ़ी है, और बात यही है।
नतीजा 1: अठारह स्रोत, छहों रनों में साझा शून्य
वेब सर्च के छह रनों ने मिलकर 18 अलग URL उद्धृत किए। हर डोमेन कितनी बार आया, यह रहा।
उद्धरणों की संख्या (6 रनों में से) | डोमेन |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
कोई डोमेन छहों रनों में उद्धृत नहीं हुआ। कोई URL छहों रनों में उद्धृत नहीं हुआ।
यहाँ असली संख्या रनों के बीच का ओवरलैप है। हर जोड़ी की तुलना करने पर, उद्धृत URL पर औसत Jaccard ओवरलैप 0.167 रहा। पंद्रह जोड़ियों में से दो में ओवरलैप बिल्कुल शून्य था, यानी वे दो जवाब कोई साझा स्रोत नहीं रखते थे।
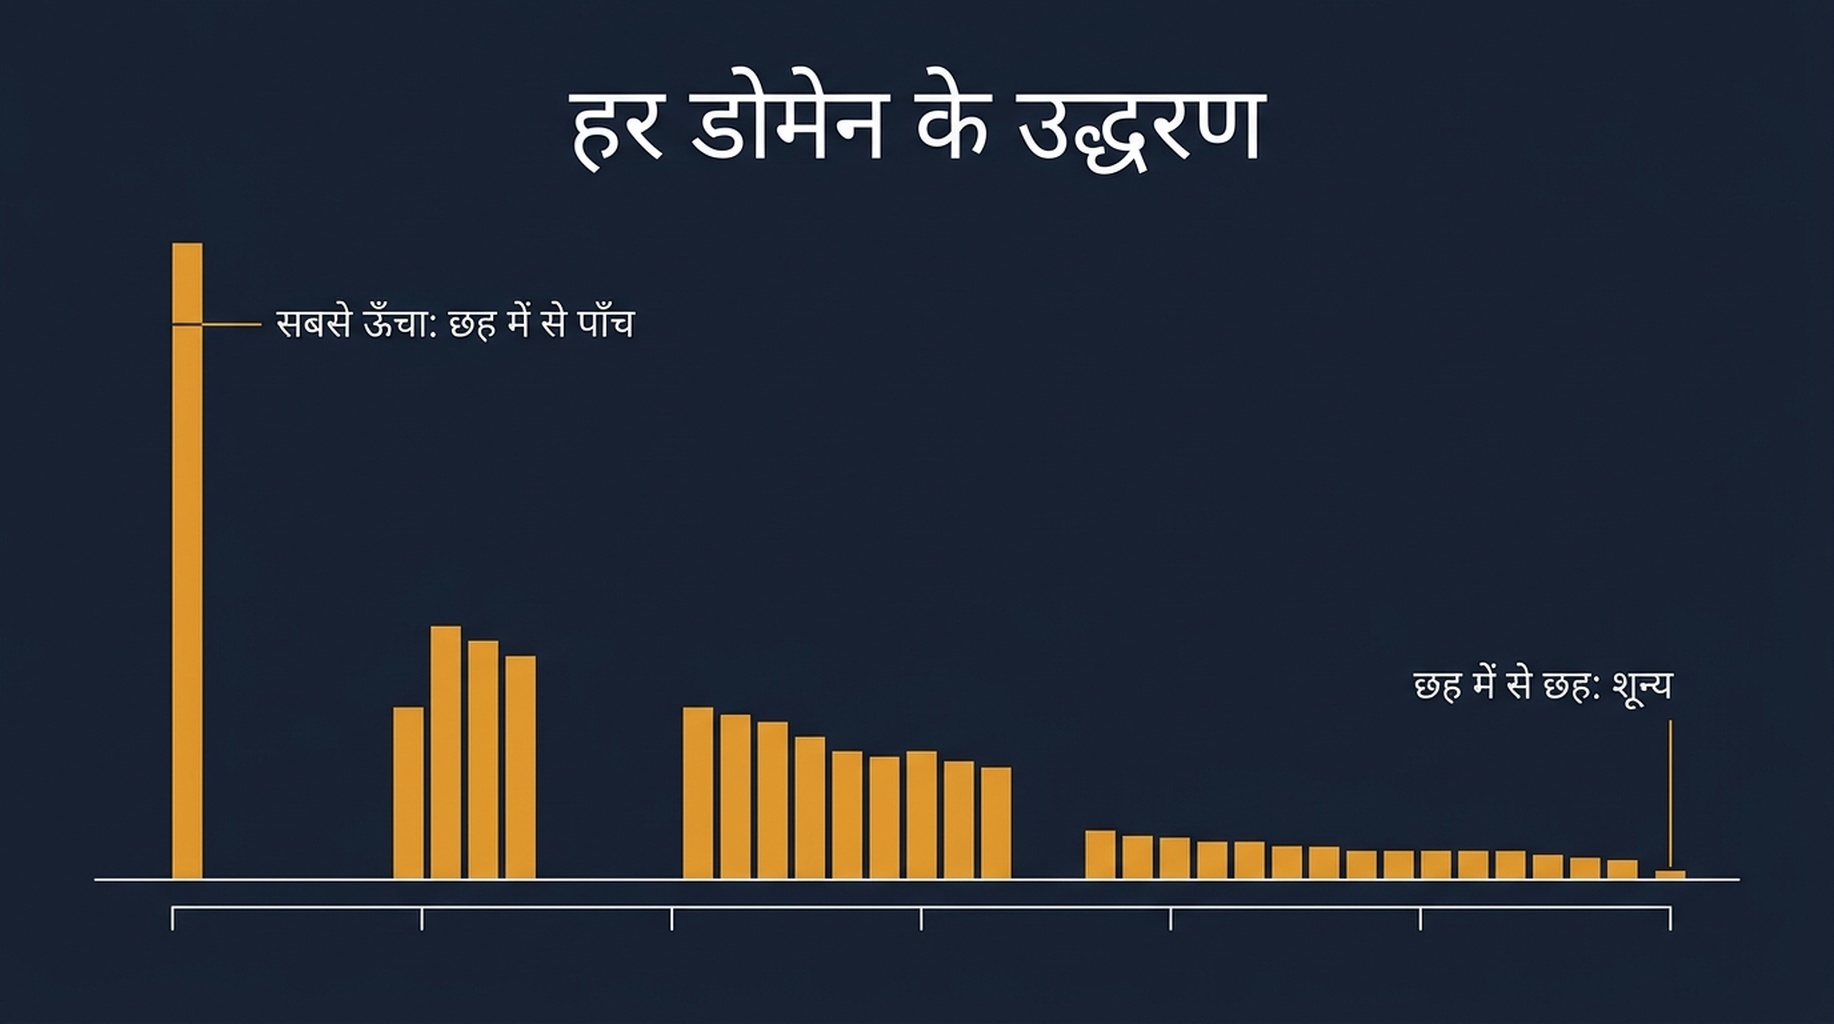
छह में से पाँच रनों में उद्धृत स्रोत वह सीमा है जो हमने देखी। हर बार कुछ भी उद्धृत नहीं हुआ।
उस तालिका में दूसरी खोज दबी हुई है। मॉडल ने जिन डोमेन तक हाथ बढ़ाया, वे ज़्यादातर इस श्रेणी की जानी-मानी तुलना साइटें नहीं हैं। अठारह में से नौ डोमेन ठीक एक बार आए, और कुछ छोटी साइटें हैं जिनका कंटेंट ऐसा पढ़ा जाता है जैसे उस क्वेरी के लिए जोड़ा गया हो, न कि रिपोर्टिंग का नतीजा हो। ब्रांड के लिए यह दोधारी तलवार है। इसका मतलब है कि उद्धरण की जगह पारंपरिक "सर्वश्रेष्ठ टूल" रैंकिंग से जीतना आसान है। इसका यह भी मतलब है कि वह जगह उस व्यक्ति ने भरी है जिसने उस रन में क्वेरी के स्वरूप से मेल खाता पेज बनाया था, और अगले रन में वह फिर भर दी जाएगी।
नतीजा 2: जवाब का आकार खुद बदलता है
उद्धरण खिसके, और जवाब की लंबाई भी साथ खिसकी।
रन | आउटपुट टोकन | जवाब की लंबाई | प्रति रन लागत |
|---|---|---|---|
1 | 505 | 2,153 अक्षर | $0.0735 |
2 | 860 | 3,728 अक्षर | $0.0770 |
3 | 1,108 | 4,746 अक्षर | $0.0797 |
4 | 832 | 3,555 अक्षर | $0.0765 |
5 | 870 | 3,547 अक्षर | $0.0772 |
6 | 813 | 3,544 अक्षर | $0.0768 |
आउटपुट की लंबाई 505 से 1,108 टोकन तक रही, यानी 603 टोकन का फैलाव, जो औसत का करीब 73 प्रतिशत है। सबसे लंबा जवाब सबसे छोटे से दोगुने से भी ज़्यादा था। छह में से पाँच रन 813 से 1,108 टोकन की काफ़ी संकरी पट्टी में पड़े; एक रन 505 पर जल्दी रुक गया और नौ से चौदह के बजाय पाँच स्रोत उद्धृत किए।
मापन के लिए यह एक ख़ास तरीके से मायने रखता है। अगर आपका ट्रैकर यह पकड़ता है कि "ब्रांड जवाब में आया या नहीं, और किस स्थान पर", तो छोटे रन में दिखने की जगहें कम होती हैं। जो टीम हफ़्ते में एक बार नमूना लेती है और संयोग से छोटा रन निकल आया, वह लंबा रन निकलने वाली टीम से खराब नतीजा दर्ज करेगी, जबकि साइट पर कुछ नहीं बदला।
नतीजा 3: कुछ प्रॉम्प्ट को कोई उद्धरण नहीं मिलता
AI Overviews ट्रैक करने वाला दूसरा प्रॉम्प्ट उसी वेब सर्च रास्ते से चार बार गया और हर बार शून्य उद्धरण लौटाया।
रन | आउटपुट टोकन | जवाब की लंबाई | उद्धरण |
|---|---|---|---|
1 | 479 | 2,135 अक्षर | 0 |
2 | 522 | 2,240 अक्षर | 0 |
3 | 534 | 2,312 अक्षर | 0 |
4 | 497 | 2,228 अक्षर | 0 |
जवाब लंबाई में स्थिर थे, चार रनों में सिर्फ़ 8 प्रतिशत बदले। लेकिन मॉडल ने अपने ज्ञान से जवाब दिया और कोई स्रोत नहीं बताया, इसलिए उद्धरण वाले कॉलम में लिखने को कुछ नहीं था।
इससे ट्रैकर की एक ख़ास और भ्रामक रीडिंग निकलती है। उद्धरण दर वाला डैशबोर्ड इस सवाल के लिए शून्य दिखाएगा, और यह विज़िबिलिटी की विफलता जैसा लगेगा। यह वह नहीं है। यह ऐसा सवाल का स्वरूप है जो स्रोत खोजने को नहीं भड़काता। सही रीडिंग है "उद्धरण लागू नहीं होता", और जो ट्रैकर इसे "उद्धरण जाँचा गया और आप मौजूद नहीं थे" से अलग नहीं कर पाता, वह आपको ऐसी समस्या के पीछे भेजेगा जो है ही नहीं।
नतीजा 4: मॉडल बदलना दूसरा मापन है, दोहराव नहीं
वेब सर्च बंद करके हमने मापा कि हर मॉडल कौन-से उत्पाद गिनाता है। यह मॉडल के अपने सुझाव-समूह को उस मिनट में सर्च इंडेक्स से लौटी हर चीज़ से अलग कर देता है।
Claude Sonnet 5 ने प्रति रन चार से पाँच उत्पाद गिनाए। तीन रनों में इसने छह अलग उत्पाद गिनाए: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat और SerpWatcher। इनमें से तीन तीनों रनों में आए: AccuRanker, Ahrefs और SEMrush। औसत जोड़ीवार ओवरलैप 0.587।
Gemini 3.8 Flash ने प्रति रन दो से पाँच उत्पाद गिनाए। तीन रनों में इसने सात अलग उत्पाद गिनाए: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush और Wincher। इनमें से सिर्फ़ एक, SE Ranking, तीनों रनों में आया। औसत जोड़ीवार ओवरलैप 0.306।
दोनों मॉडलों के बीच, चार उत्पाद दोनों ने गिनाए और पाँच सिर्फ़ एक ने।
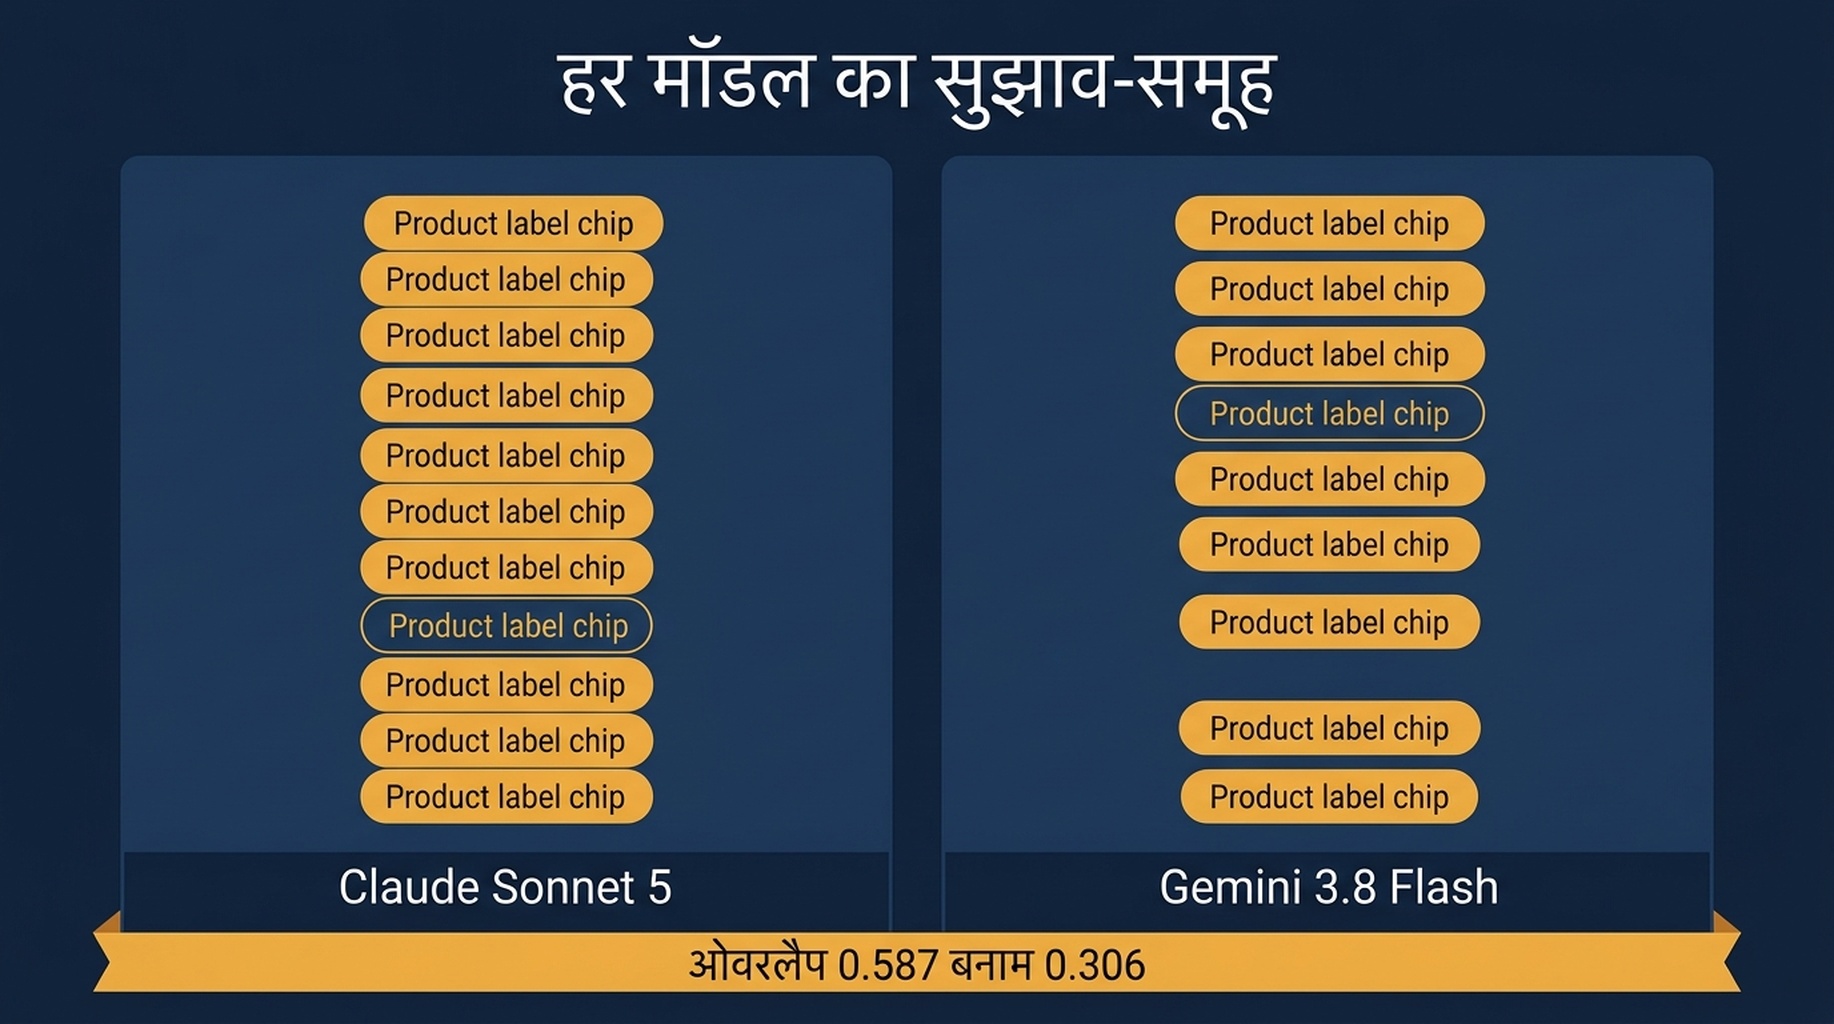
वही सवाल हर मॉडल पर और हर रन में आंशिक रूप से अलग सुझाव-समूह बनाता है।
व्यावहारिक नतीजा यह है: अगर आप "AI विज़िबिलिटी" को एक अकेली संख्या की तरह ट्रैक करते हैं, तो आप कम से कम दो स्वतंत्र भिन्नता-स्रोतों पर औसत निकाल रहे हैं, यानी रन और मॉडल। जो ब्रांड एक असिस्टेंट पर लगातार आता है और दूसरे पर नहीं आता, वह असली और अमल में लाने योग्य खोज है। जिस ब्रांड की अकेले-नमूने वाली माप दो स्थान खिसक गई, वह शोर है।
एक AI विज़िबिलिटी ट्रैकर को क्या रिकॉर्ड करना चाहिए
चार फ़ील्ड एक स्क्रीनशॉट को मापन में बदल देते हैं।
रन की संख्या, न कि रन का नतीजा। हर रन सहेजिए और दायरा बताइए। "6 में से 4 रनों में उद्धृत" एक तथ्य है। "उद्धृत, स्थान 3" एक संयोग है। छोटे कार्यक्रम के लिए छह रन ठोस न्यूनतम है; अगर प्रॉम्प्ट व्यावसायिक रूप से अहम है तो बारह बेहतर है।
उद्धरण वाला फ़ील्ड, ज़िक्र वाले फ़ील्ड से अलग। "मॉडल ने हमें सुझाया" और "मॉडल ने हमें लिंक किया" दो अलग नतीजे हैं, और इनका इलाज भी अलग है। हमारे छह रनों ने 18 अलग URL से 18 उद्धरण बनाए; जो ट्रैकर सिर्फ़ ब्रांड-ज़िक्र दर्ज करता है, वह इस उठापटक से कुछ भी नहीं पकड़ पाता।
जवाब के चैनल की स्थिति। दर्ज कीजिए कि उस रन ने वेब सर्च इस्तेमाल किया या नहीं, और जवाब की लंबाई दर्ज कीजिए। शून्य उद्धरण वाला रन और शून्य ज़िक्र वाला रन डैशबोर्ड पर एक जैसे दिखते हैं और उल्टा मतलब रखते हैं।
प्रॉम्प्ट का पाठ, शब्द-दर-शब्द, वर्ज़न नंबर के साथ। प्रॉम्प्ट की शब्दावली तय करती है कि कौन-से स्रोत खिंचकर आएंगे। अगर प्रॉम्प्ट महीनों के बीच बदल जाए, तो ट्रेंड लाइन टूट जाती है। प्रॉम्प्ट को वैसे ही वर्ज़न कीजिए जैसे आप ट्रैकिंग स्क्रिप्ट को करते हैं।
रन लूप बनाना
हाथ से जाँच कैलेंडर से एक मुलाक़ात भी नहीं झेल पाती। लूप एक स्क्रिप्ट है जो प्रॉम्प्ट को N बार चलाती है, हर कच्चा जवाब उसके उद्धरणों के साथ सहेजती है, और मौजूदा विंडो की तुलना पिछली से करती है।
यह एजेंट के लिए अच्छी तरह फिट बैठता है, क्योंकि काम दोहराव वाला है, नियमों में बँधा है, और लिखित रिकॉर्ड माँगता है। Claude Code या Codex में काम की बात यह निर्देश है कि कच्चे रन डिस्क पर रहने दीजिए और उन्हें कभी ओवरराइट न कीजिए, फिर एक अकेली संख्या के बजाय सारांश तालिका रिपोर्ट कीजिए। अगर आप पहले से MCP सर्वरों के ज़रिए Search Console और Bing डेटा खींच रहे हैं, तो वही सत्र उद्धरण लॉग को इंप्रेशन डेटा के बगल में रख सकता है, और दोनों संख्याएँ वहीं साथ उपयोगी होने लगती हैं। इन सर्वरों के बारे में हमारे नोट्स चार SEO MCP सर्वर असल में क्या करते हैं में हैं, और उसी समस्या का मौजूदगी वाला पक्ष चालीस क्वेरी का हमारा AI Overview स्नैपशॉट में है।
एक डिज़ाइन नियम बाक़ी सबसे ज़्यादा मायने रखता है: ट्रैकर का आउटपुट एक वितरण होना चाहिए। "4 में से 6 में उद्धृत" रिपोर्ट कीजिए, "उद्धृत" नहीं। स्रोतों की सूची रिपोर्ट कीजिए, पहला स्रोत नहीं। जो भी डैशबोर्ड छह रनों को एक संख्या में दबा देता है, उसने वह अकेली जानकारी फेंक दी है जो अतिरिक्त रनों ने ख़रीदी थी।
अगर मक़सद निगरानी नहीं बल्कि प्रतिस्पर्धी तुलना है, तो समय के साथ चलने वाला रैंक ट्रैकिंग लूप ज़्यादा उपयुक्त औज़ार है, और डेटा स्रोतों के बीच की अदला-बदली दो स्रोतों से रैंक ट्रैकर बनाना में है।
छह रन के नमूने की सीमाएँ
तीन ईमानदार चेतावनियाँ।
नमूना छोटा है। छह रन फैलाव को ढीले ढंग से ही सीमित करते हैं। वे यह स्थापित करते हैं कि रनों के बीच ओवरलैप आंशिक है और शून्य ओवरलैप वाली जोड़ियाँ होती हैं; वे आपकी श्रेणी के लिए विश्वास-अंतराल नहीं देते।
नतीजे समय से बँधे हैं। ये रन 12 सितंबर 2026 को उस समय चल रहे मॉडलों पर किए गए थे। मॉडल भी बदलते हैं और उनके नीचे के सर्च नतीजे भी।
उद्धृत डोमेन एक ही व्यावसायिक प्रॉम्प्ट का नमूना हैं। अलग सवाल-स्वरूप, जैसे तुलना वाला सवाल या तरीक़ा बताने वाला सवाल, अलग उद्धरण-पैटर्न बनाएगा। काम की चाल यह है कि वही डिज़ाइन अपने दस सबसे व्यावसायिक रूप से अहम प्रॉम्प्ट पर चलाइए और दर्ज कीजिए कि आपकी श्रेणी कैसा व्यवहार करती है।
अक्सर पूछे जाने वाले सवाल
AI विज़िबिलिटी की संख्या अर्थपूर्ण होने से पहले मुझे कितने रन चाहिए? एक अकेले प्रॉम्प्ट के लिए छह व्यावहारिक न्यूनतम है, और संख्या को स्थान के बजाय रनों की गिनती के रूप में रिपोर्ट करना चाहिए। अगर प्रॉम्प्ट राजस्व के फ़ैसले तय करता है, तो बारह रन कुछ डॉलर में ज़्यादा कसे हुए नतीजे देते हैं।
क्या इसका मतलब है कि AI विज़िबिलिटी ट्रैक करना बेकार है? इसका मतलब है कि अकेले नमूने से ट्रैक करना बेकार है। भिन्नता ही खोज है। जो ट्रैकर "6 में से 4 रनों में उद्धृत, स्रोत पिछले महीने से 12 डोमेन बदल गए" रिपोर्ट करता है, वह ऐसा असली सिस्टम बता रहा है जिसमें कोई प्रतिस्पर्धी दाँव लगा रहा है।
एक प्रॉम्प्ट शून्य उद्धरण क्यों लौटाया? मॉडल ने स्रोत खोजने के बजाय अपने ज्ञान से जवाब दिया। यह सवाल की ख़ूबी है, आपकी साइट की विफलता नहीं। इसे शून्य नहीं, "लागू नहीं" के रूप में ट्रैक कीजिए।
क्या मुझे ChatGPT, Claude और Gemini को अलग-अलग ट्रैक करना चाहिए? हाँ। हमारी तीन-रन वाली तुलना में दोनों मॉडल गिनाए गए नौ उत्पादों में से सिर्फ़ चार पर ओवरलैप करे। औसत निकालना इस कार्यक्रम-स्तरीय फ़ैसले को छिपा देता है कि पहले किस असिस्टेंट को बेहतर बनाना है।
क्या मॉडल का तापमान घटाकर भिन्नता कम की जा सकती है? कुछ हद तक, और अपने प्रॉम्प्ट पर जाँचने लायक है। लेकिन उद्धरण-समूह सर्च इंडेक्स से भी चलता है, और वह आपके हाथ में नहीं है। रनों की संख्या ज़्यादा भरोसेमंद लीवर है।
Auspia की राय: अगर आप इस तिमाही में AI विज़िबिलिटी ट्रैकिंग बना रहे हैं, तो डैशबोर्ड से पहले रन लॉग बनाइए। डैशबोर्ड दिखाने का चुनाव है। रन लॉग ही मापन है। दस प्रॉम्प्ट, हर एक के छह रन, शब्द-दर-शब्द सहेजे हुए, इससे शुरू कीजिए, और एक हफ़्ते में आप उससे ज़्यादा सीखेंगे जितना अकेले-नमूने की एक साल भर की जाँच बता सकती है।
लेखन: Ethan Marlowe, Auspia में 500 से अधिक प्रॉम्प्ट पर GEO मापन का नेतृत्व। प्रॉम्प्ट ट्रैकिंग, उद्धरण रिपोर्ट, और ऐसे विज़िबिलिटी डैशबोर्ड पर लिखते हैं जो असली मापन-चक्र से टकराकर टिके रहते हैं।