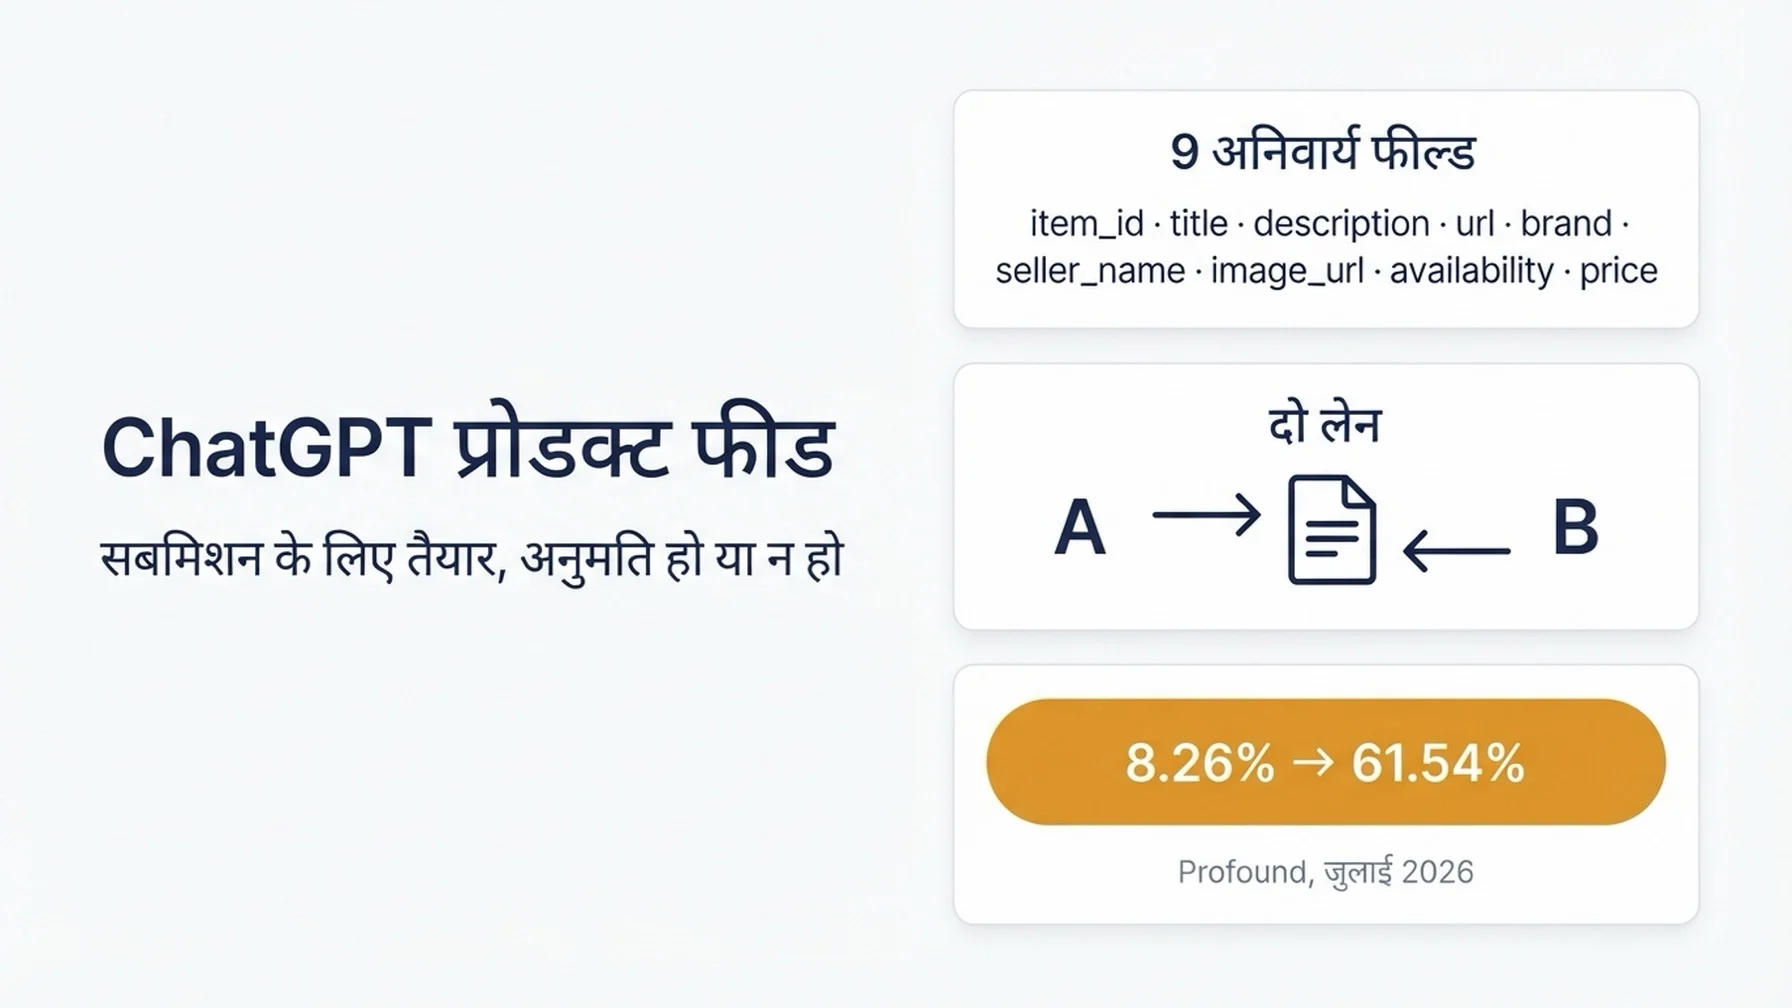
जुलाई 2026 में ChatGPT की शॉपिंग सिफ़ारिशों ने अपना मुख्य स्रोत बदल दिया। अगर आपका कैटलॉग डेटा उसके लिए तैयार नहीं है, तो प्रोडक्ट पेज का कोई भी ऑप्टिमाइज़ेशन इसकी भरपाई नहीं कर सकता। यह वर्कफ़्लो आपके कैटलॉग को सत्यापित और सबमिशन-तैयार स्थिति में लाता है, और यह तब भी काम करता है जब आप आज फ़ीड सबमिट नहीं कर सकते।
यह किसके लिए है | ईकॉमर्स SEO मैनेजर, फ़ीड मैनेजर और मर्चेंट ऑपरेशन्स के मालिक, जो लगभग 500 से 1,00,000 SKU तक के प्रोडक्ट डेटा के ज़िम्मेदार हैं |
नतीजा | एक सत्यापित प्रोडक्ट फ़ाइल जो सभी नौ अनिवार्य फ़ील्ड जाँच पास करती है, साथ में रुके हुए SKU की एक अपवाद सूची जिसमें हर SKU का ज़िम्मेदार व्यक्ति दर्ज है |
पूर्वापेक्षाएँ | कैटलॉग को CSV, TSV या JSONL के रूप में एक्सपोर्ट करने की क्षमता; एक स्टेजिंग डायरेक्टरी; |
एक्सेस की धारणा | हो सकता है आप आज फ़ीड सबमिट न कर सकें। OpenAI का फ़ीड प्रोग्राम प्रतिबंधित है, चेकआउट एक अलग से चालू की जाने वाली इंटीग्रेशन है, और मानक अपलोड इस समय अमेरिकी बाज़ार के लिए है। यह वर्कफ़्लो फ़ाइल दोनों हालत में बनाता है |
समय | 5,000 SKU से कम के कैटलॉग पर पहली बार करने में चार से छह घंटे। धीमा हिस्सा फ़ील्ड ऑडिट है, तकनीकी सेटअप नहीं |
पूर्णता की परिभाषा | हर पंक्ति नौ अनिवार्य-फ़ील्ड जाँच पास करती है, हर छोड़ा गया SKU नामित अपवाद सूची में बैठता है, OpenAI का सर्च क्रॉलर एक नमूना प्रोडक्ट URL फ़ेच करके उससे असली डेटा पढ़ पाता है, और यह रन सहेजे गए एक्सपोर्ट से दोबारा चलाया जा सकता है |
क्या बदला, और यह कौन-सा एक फ़ैसला थोपता है
OpenAI ने 9 जुलाई 2026 को अपने ChatGPT 5.6 मॉडल जारी किए। अगले ही दिन, मर्चेंट प्रोडक्ट फ़ीड से आने वाली ChatGPT शॉपिंग सिफ़ारिशों का हिस्सा, खुली वेब सर्च से आने वाले हिस्से की तुलना में, 8.26% से 61.54% पर पहुँच गया, Profound द्वारा प्रकाशित शोध के अनुसार, जिसने जुलाई 2026 में 17,57,723 ChatGPT शॉपिंग प्रॉम्प्ट ट्रैक किए। एक ही दिन में फ़ीड-आधारित रिट्रीवल अल्पसंख्यक स्रोत से प्रमुख स्रोत बन गया।
यह संख्या किसी तीसरे पक्ष का मापन है, OpenAI का खुलासा नहीं। OpenAI ने 10 जुलाई के बदलाव की पुष्टि नहीं की है और न ही रिट्रीवल का कोई बँटवारा प्रकाशित किया है, और इस लेख के अंत की सेक्शन बताती हैं कि डेटा क्या साबित करता है और क्या नहीं। दिशा को गंभीरता से लें और सटीकता को ढीले ढंग से।
यह दिशा एक ही बदलाव थोपती है: प्रोडक्ट डेटा को अब डेटा के रूप में सही होना है, केवल कंटेंट के रूप में नहीं। बिना GTIN चेक डिजिट वाला सुंदर लिखा प्रोडक्ट पेज, फ़ीड-आधारित अनुशंसक के लिए वह पंक्ति है जो वैलिडेशन में फेल हो गई।
नीचे सब कुछ एक वर्कफ़्लो है। इसका हर कदम तब भी करने लायक है जब 10 जुलाई के आँकड़े टिक भी न पाएँ, क्योंकि साफ़, पूरा और मशीन-पठनीय कैटलॉग हर उस शॉपिंग सतह के लिए उपयोगी है जिसकी आपको कभी परवाह होगी।
पता करें कि आप किस लेन में हैं
वर्कफ़्लो दो लेन में बँटता है, और शुरू करने से पहले अपनी लेन जानना ज़रूरी है, क्योंकि इससे बदलता है कि आपके लिए पूरा होने का मतलब क्या है। लेन A इनजेशन साबित कर सकती है। लेन B केवल तैयारी साबित कर सकती है। दोनों एक ही फ़ाइल बनाती हैं।
चार सवालों वाला एक्सेस टेस्ट
इनमें से हर सवाल का ईमानदारी से जवाब दें।
सवाल | क्या हाँ माना जाएगा | क्या नहीं |
|---|---|---|
क्या आपने OpenAI में रजिस्टर किया और फ़ीड एक्सेस का लिखित पुष्टिकरण पाया? | एक पुष्टिकरण जिसमें आपकी फ़ीड का नाम हो | "मैंने रुचि फ़ॉर्म भर दिया था" |
क्या आपका कैटलॉग अमेरिकी बाज़ार के लिए पात्र है? | मौजूदा मानक अपलोड दायरे के लिए पुष्टि | यह मान लेना कि यह आपके बाज़ार पर लागू है |
क्या आपके लिए चेकआउट इंटीग्रेशन अलग से चालू की गई है? | ऑनबोर्डिंग के दौरान स्पष्ट पुष्टि | खुद से कोई फ़्लैग चालू कर देना |
क्या आपने नमूना या पूरी फ़ाइल सबमिट की और उसकी पावती मिली? | आपके सबमिशन का ज़िक्र करता कोई जवाब | भेज देना और कोई जवाब न मिलना |
अगर किसी भी जवाब के पीछे ऐसी कोई चीज़ नहीं है जिसे आप इंगित कर सकें, तो आप लेन B में हैं। यही डिफ़ॉल्ट स्थिति है और यह असफलता की हालत नहीं है। दो ज़रूरी स्पष्टताएँ: पात्रता फ़्लैग चालू करने से चेकआउट ऑनबोर्डिंग पूरी नहीं होती, और रजिस्ट्रेशन केवल आपका मर्चेंट डिस्प्ले नाम देता है, बाकी फ़ीड नहीं।
लेन A: आपके पास पुष्ट फ़ीड एक्सेस है
आपको रजिस्ट्रेशन के अनुसार फ़ील्ड सूची और ऑनबोर्डिंग में पुष्ट सबमिशन चैनल मिलेगा। सबमिशन का तरीका खुद ऑनबोर्डिंग के दौरान तय होता है। प्रकाशित विक्रेता विवरणों में इस पर असहमति है कि यह SFTP है या अनुमत-सूची वाले एंडपॉइंट पर एन्क्रिप्टेड HTTPS पुश, इसलिए जब तक OpenAI यह न बताए कि आपके लिए कौन-सा लागू है, किसी भी विवरण के हिसाब से पाइपलाइन न बनाएँ।
लेन B: आपके पास नहीं है, और यह बर्बाद नहीं होता
आज बिना किसी अनुमति के तीन चीज़ें आपके लिए खुली हैं: क्रॉलर एक्सेस, प्रोडक्ट पेजों पर स्ट्रक्चर्ड डेटा और विवरण की गुणवत्ता, और सत्यापित फ़ाइल। इस लेख के बीच वाला कैटलॉग काम पूरी तरह बिना गेट का है। आप अभी फ़ाइल बनाते और जाँचते हैं, और जिस दिन एक्सेस आता है, आप ऐसी चीज़ सबमिट करते हैं जो पहले से पास होती है।
अगर आप Shopify पर हैं, तो प्रोडक्ट डेटा बिना किसी अतिरिक्त मर्चेंट-साइड काम के Shopify Catalog के ज़रिए ChatGPT तक पहुँचता है। सीधी फ़ीड ताज़गी के लिए और उन फ़ील्ड के लिए है जो डिफ़ॉल्ट नहीं ले जाता। एक चेतावनी: एक द्वितीयक स्रोत इस सिंडिकेशन को मार्च 2026 का बताता है और वह तारीख़ अपुष्ट है, इसलिए इसे बातचीत शुरू करने की बात मानें, न कि ऐसा तथ्य जिस पर योजना बने।
उस क्रॉलर के लिए दरवाज़ा खोलें जो आपके प्रोडक्ट पढ़ता है
यह पहला ऐसा कदम है जो दोनों लेन में तुरंत असर करता है, और यह आपके पास सबसे सस्ती जीत है।
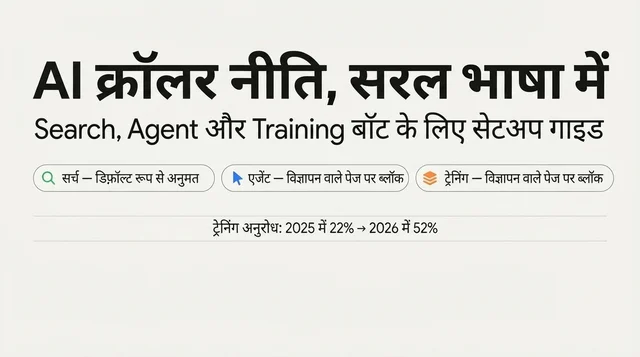
अपनी robots.txt खोलें और OpenAI के एजेंटों के निर्देश देखें। OAI-SearchBot वह है जो प्रोडक्ट दृश्यता के लिए मायने रखता है। अगर वह ब्लॉक है, तो आपका कंटेंट ChatGPT के प्रोडक्ट नतीजों में नहीं आएगा, चाहे आपकी फ़ीड कितनी भी साफ़ हो। इसका इस्तेमाल मॉडल ट्रेनिंग के लिए नहीं होता, इसलिए इसे ब्लॉक करना कुछ नहीं बचाता।
चार एजेंट नाम जिन पर साफ़ फ़ैसला लेना चाहिए:
एजेंट | यह क्या करता है | प्रोडक्ट दृश्यता पर असर |
|---|---|---|
| सर्च सतहों के लिए कंटेंट इंडेक्स करता है | इसे ब्लॉक करने से आपके प्रोडक्ट छिप जाते हैं, फ़ीड की गुणवत्ता चाहे जो हो |
| उन पेजों को फ़ेच करता है जिनके बारे में उपयोगकर्ता सीधे पूछता है | इसे ब्लॉक करने से लाइव पेज रीड टूट जाती है |
| ट्रेनिंग क्रॉलर | शॉपिंग दृश्यता से इसका कोई संबंध नहीं |
| एजेंट-आधारित ब्राउज़िंग | एजेंट से चलने वाले चेकआउट रास्तों पर असर डालता है |
यहाँ सबसे ज़रूरी गुणवत्ता जाँच `robots.txt` की नहीं है। वह यह है कि अनुमति मिलने के बाद क्रॉलर आकर असल में कुछ पढ़ पाता है या नहीं। क्रॉलर के यूज़र एजेंट के साथ एक प्रतिनिधि प्रोडक्ट URL फ़ेच करें और जवाब का बॉडी देखें। अगर आपको ऐसा ऐप शेल मिलता है जिसमें सर्वर से रेंडर हुआ टाइटल, क़ीमत, उपलब्धता या विवरण नहीं है, तो क्रॉल सफल होती है और कुछ काम का नहीं लौटाती। कई स्टोरफ़्रंट प्रोडक्ट डेटा केवल क्लाइंट साइड रेंडर करते हैं, और ऐसे स्टोर बिना फ़ीड वाली खोज के लिए अदृश्य रहते हैं, चाहे उनकी robots फ़ाइल कुछ भी कहे।
आप यह जाँच Auspia के OpenAI सर्च क्रॉलर सिम्युलेटर से चला सकते हैं, जो किसी सार्वजनिक पेज को OpenAI के क्रॉलर के रूप में फ़ेच करके दिखाता है कि वह क्या पढ़ पाता है।
रिकवरी रास्ता। अगर robots.txt आपके प्लेटफ़ॉर्म या एजेंसी के कब्ज़े में है, तो तारीख़ के साथ बदलाव का अनुरोध दर्ज करें और आगे बढ़ें। यह कदम रुकावट नहीं, आपके लेन B रिकॉर्ड का सबूत बन जाता है।
अपने प्रोडक्ट पेजों को मशीन-पठनीय बनाएँ
शॉपिंग सिफ़ारिशों तक पहुँचने का रास्ता केवल फ़ीड नहीं है, और लेन B वाले मर्चेंट के लिए यह इस समय उपलब्ध ही नहीं है। पेज पर मौजूद स्ट्रक्चर्ड डेटा है।
हर प्रोडक्ट टेम्पलेट में JSON-LD के रूप में Product स्ट्रक्चर्ड डेटा जोड़ें, और उसे उसी स्रोत से भरें जिससे आपका कैटलॉग एक्सपोर्ट बनता है। यही आख़िरी बात टीमें छोड़ देती हैं। अगर आपका स्कीमा थीम में हाथ से बनाए रखा जाता है और फ़ीड PIM से आती है, तो दोनों एक तिमाही के भीतर अलग हो जाएँगे, और क़ीमत व उपलब्धता के परस्पर विरोधी संकेत ग़ायब संकेतों से बुरे हैं।
कम से कम नाम, विवरण, इमेज, SKU, ब्रांड और क़ीमत, क़ीमत की करेंसी व उपलब्धता ले जाने वाला offers ब्लॉक शामिल करें। वही मान रखें जो आप फ़ीड में डालते। जहाँ आपके कैटलॉग में GTIN, कंडीशन, मटेरियल, रंग, साइज़ या माप हैं, वे भी जोड़ें, क्योंकि बातचीत वाली क्वेरी असल में इन्हीं एट्रिब्यूट का इस्तेमाल करती हैं।
गुणवत्ता जाँच। तीन प्रोडक्ट URL जाँचें, अपनी सबसे अलग-अलग श्रेणियों में से एक-एक, उसी रेंडरिंग रास्ते से जो क्रॉलर देखता है, न कि अपने लॉग-इन वाले ब्राउज़र से।
रिकवरी रास्ता। अगर आपका प्लेटफ़ॉर्म प्रोडक्ट टेम्पलेट में JSON-LD डालने नहीं देता, तो उसे टैग मैनेजर के ज़रिए head में रखें और तकनीकी कर्ज़ के रूप में दर्ज करें। यह काम करता है, यह नाज़ुक है, और इसे हटाने का ज़िम्मा किसी एक का होना चाहिए।
बातचीत वाली क्वेरी के लिए विवरण दोबारा लिखें
यह वह कदम है जहाँ SEO का अनुशासन आपको सक्रिय रूप से नुक़सान पहुँचाता है।
कैटलॉग विवरण आम तौर पर कीवर्ड कवरेज और शेल्फ पर दिखने के लिए लिखे जाते हैं: ब्रांड की आवाज़, कीवर्ड से भरा टाइटल, दावों की बुलेट सूची। बातचीत वाली शॉपिंग क्वेरी ऐसी बिल्कुल नहीं दिखती। कोई पूछता है, "खुले दफ़्तर के लिए 150 डॉलर से कम की शांत मैकेनिकल कीबोर्ड", और जो एट्रिब्यूट इस सवाल का जवाब देते हैं वे हैं शोर का स्तर, स्विच का प्रकार और फ़ॉर्म फ़ैक्टर। इन एट्रिब्यूट का मौजूद और तथ्यात्मक होना ज़रूरी है, तभी वे निकाले जा सकते हैं।
प्रोडक्ट विवरण को छोटी मानवीय शुरुआत के साथ तथ्यात्मक स्पेसिफिकेशन की तरह लिखें। पहले एक वाक्य में बताएँ कि प्रोडक्ट क्या है और किसके लिए है। फिर एट्रिब्यूट सीधे लिखें, बिना मार्केटिंग विशेषणों के। "वज़न: 780 ग्राम" "अविश्वसनीय रूप से हल्का निर्माण" से बेहतर है। अगर कोई दावा करें, तो उसे विशिष्ट और जाँचने लायक बनाएँ।
यहाँ ज़्यादा निवेश करने से पहले एक बात जान लें: OpenAI का शॉपिंग डॉक्युमेंटेशन कहता है कि ChatGPT सरलीकृत प्रोडक्ट टाइटल और विवरण बना सकता है। आपकी कॉपी सिफ़ारिश के लिए इनपुट है, गारंटीशुदा आउटपुट नहीं। साफ़, तथ्यात्मक स्रोत डेटा लिखें और मान लें कि सतह उसे दोबारा लिख सकती है।
गुणवत्ता जाँच। अपने दस सबसे ज़्यादा राजस्व वाले प्रोडक्ट लें और हर एक के लिए वे चार एट्रिब्यूट लिखें जो ख़रीदार को फ़ैसला लेने के लिए चाहिए। अगर विवरण में तीन से कम दिखते हैं, तो विवरण अपना काम नहीं कर रहा।
रिकवरी रास्ता। अगर आपके विवरण ऐसी सप्लायर फ़ीड से आते हैं जो आपके नियंत्रण में नहीं है, तो राजस्व के हिसाब से ऊपरी दसवाँ हिस्सा हाथ से दोबारा लिखें और बाक़ी को उसके पीछे चलने दें। अधूरा कवरेज रुके हुए प्रोजेक्ट से बेहतर है।
किसी भी पंक्ति को छूने से पहले फ़ील्ड कॉन्ट्रैक्ट बनाएँ
अब फ़ीड की बात। कुछ भी एक्सपोर्ट करने से पहले, एक बार लिख लें कि "सही" का मतलब क्या है। इससे ऑडिट बहस नहीं, एक यांत्रिक जाँच बन जाता है।
नौ अनिवार्य फ़ील्ड और हर एक कहाँ टूटती है
हर पंक्ति को ये नौ चाहिए। यह तालिका ही कॉन्ट्रैक्ट है।
फ़ील्ड | स्वीकार्य रूप | सबसे आम विफलता | परिणाम |
|---|---|---|---|
| हर आइटम या वेरिएंट के लिए स्थिर यूनिक स्ट्रिंग | वेरिएंट में दोबारा इस्तेमाल, या हर एक्सपोर्ट पर नया बन जाना | डुप्लिकेट और अनाथ पंक्तियाँ |
| सादा स्ट्रिंग, 150 अक्षर या कम रखें | बीच शब्द में कटाई, या क़ीमत लिए हुए टाइटल | पंक्ति अस्वीकृत या ग़लत मिलान |
| सादा टेक्स्ट, 5,000 अक्षर तक | CMS से छूटा हुआ HTML या markdown | पंक्ति अस्वीकृत |
| प्रोडक्ट पेज का URL | ट्रैकिंग पैरामीटर, या ऐसा URL जो रीडायरेक्ट करता है | पंक्ति कहीं नहीं पहुँचती |
| ब्रांड नाम की स्ट्रिंग | बिना ब्रांड वाले SKU पर पूरी तरह ग़ायब | पंक्ति अस्वीकृत |
| मर्चेंट नाम की स्ट्रिंग | पूरे कैटलॉग में असंगत वर्तनी | कमज़ोर मर्चेंट संकेत |
| इमेज का सीधा URL | प्लेसहोल्डर, या सेशन माँगता URL | बिना दृश्य वाली पंक्ति |
|
| आपकी आंतरिक स्टॉक शब्दावली की कोई कस्टम वैल्यू | पंक्ति अस्वीकृत |
|
| हज़ार का सेपरेटर, या बिना करेंसी की ख़ाली संख्या | पंक्ति अस्वीकृत |
दो प्रविष्टियाँ ख़ास ज़िक्र की हक़दार हैं, क्योंकि वे चुपचाप फेल होती हैं और साथ में पूरी प्रोडक्ट लाइन ले जाती हैं।
availability फ़ील्ड ठीक पाँच वैल्यू स्वीकार करती है। छोड़ी गई, ख़ाली या अनजानी वैल्यू पंक्ति को अस्वीकार कर देती है। अगर आपका प्लेटफ़ॉर्म IN STOCK या available या 1 एक्सपोर्ट करता है, तो इनमें से हर पंक्ति फेल होती है। अपनी आंतरिक शब्दावली को पाँच स्वीकार्य वैल्यू पर स्पष्ट रूप से मैप करें, और जो मैप न हो उसे डिफ़ॉल्ट unknown करने के बजाय मैन्युअल कतार में भेजें। unknown एक वैध वैल्यू है, पर यह एक जान-बूझकर ली गई स्थिति है, बाक़ी सब कुछ डालने की जगह नहीं।
price फ़ील्ड है amount, फिर एक स्पेस, फिर बड़े अक्षरों में करेंसी कोड। यानी 79.99 USD, न कि $79.99, न कि 79,99 USD, और न कि 7.999e1। कोई हज़ार सेपरेटर नहीं, कोई घातांक संकेतन नहीं।
वे नियम जो चुपचाप पंक्तियाँ अस्वीकार करते हैं
चार और बाधाएँ जिन्हें अपनी वैलिडेशन जाँचों में लिख लेना चाहिए:
GTIN. ठीक 8, 12, 13 या 14 अंक, जिनमें मान्य चेक डिजिट शामिल हो। ISBN-10 स्वीकार नहीं है। शुरुआती शून्य बनाए रखें, यानी कॉलम को हर जगह टेक्स्ट के रूप में रखें। यह पूरी स्पेक में सबसे आम चुपचाप तोड़ने वाली चीज़ है, क्योंकि स्प्रेडशीट और CSV एक्सपोर्ट डिफ़ॉल्ट रूप से शुरुआती शून्य हटा देते हैं।
सेल क़ीमत। शून्य से बड़ी और नियमित क़ीमत से सख़्ती से कम होनी चाहिए, उसी करेंसी में। नियमित क़ीमत के बराबर सेल क़ीमत, या ऐसी प्रोमो पंक्ति जिसमें नियमित क़ीमत ख़ाली छोड़ दी गई हो, फेल होती है।
टाइटल की लंबाई। 150 अक्षर या कम रखें। काटते समय शब्द की सीमा पर काटें।
तारीख़ वाले फ़ील्ड कुछ शेड्यूल नहीं करते। स्पेक साफ़ कहती है कि कॉन्ट्रैक्ट की तारीख़ें क़ीमत या उपलब्धता में बदलाव शेड्यूल नहीं करतीं। अगर आप चाहते हैं कि प्रोमो आधी रात को चालू हो, तो नई वैल्यू आपकी पाइपलाइन को पुश करनी होगी।
पात्रता फ़्लैग पर जान-बूझकर फ़ैसला करें
तीन फ़्लैग तय करते हैं कि वैलिडेशन के बाद पंक्ति का क्या होगा।
फ़्लैग | छोड़े जाने या ख़ाली होने पर डिफ़ॉल्ट | यह क्या करता है |
|---|---|---|
|
|
|
| सर्च पात्रता ज़रूरी |
|
| बंद | अलग विज्ञापन प्रोसेसिंग रास्ते को नियंत्रित करता है |
आप इन्हें enable_search, enable_checkout और is_eligible_ads के रूप में भी देख सकते हैं। ये उपनाम हैं, इसलिए पुरानी वर्तनी वाले टेम्पलेट को अलग फ़ील्ड न मानें।
व्यावहारिक सलाह: is_eligible_search को उस सिस्टम के साथ सिंक करें जिसे पहले से पता है कि कोई प्रोडक्ट बंद या दबा हुआ है। अगर आप अलग "चैनल से छिपाओ" सूची चलाते हैं और वह कभी फ़ीड तक नहीं पहुँचती, तो आप सिफ़ारिशों में पुरानी लिस्टिंग भेजते रहेंगे।
कौन-से वैकल्पिक समूह चालू करें, और किस क्रम में
वैकल्पिक फ़ील्ड लगभग पचास हैं। काम के हर घंटे पर मिलने वाले रिटर्न के हिसाब से क्रम, स्पेक के क्रम से नहीं:
- वेरिएंट (
group_id,listing_has_variations,variant_dict,offer_id,gtin,mpn)। अगर आप कपड़े, जूते, घर का सामान या साइज़ या रंग वाली कोई भी चीज़ बेचते हैं तो सबसे ऊँची प्राथमिकता। - आइटम जानकारी (
condition,product_category,material,color,size,gender,age_group, और माप व वज़न के फ़ील्ड)। यही बातचीत वाला मिलान काम कराती है। - मीडिया (
additional_image_urls)। - रिटर्न (
accepts_returns,return_deadline_in_days,return_policy)। - समीक्षाएँ (
review_count,star_rating), साथ में स्टोर स्तर केstore_review_countऔरstore_star_rating। - फ़ुलफ़िलमेंट, मर्चेंट और भू-स्थान (
shipping_price,shipping,seller_url,target_countries,store_country)। - सेटअप-निर्भर फ़ील्ड।
marketplace_seller,size_system,accepts_exchanges,is_digital, विज्ञापन की जोड़ी (is_ads_eligible,ads_metadata) और चेकआउट की जोड़ी (is_eligible_checkout,seller_privacy_policy,seller_tos) सभी के लिए ऑनबोर्डिंग में पुष्टि ज़रूरी है। ये स्वयं-सेवा नहीं हैं। इन्हें अपने पहले दौर से बाहर रखें।
गुणवत्ता जाँच। नौ अनिवार्य फ़ील्ड में से हर एक ऐसे कैटलॉग कॉलम पर मैप होनी चाहिए जो आपके कम से कम 95% SKU पर असली डेटा देता हो। इस सीमा से नीचे के फ़ील्ड मैपिंग का काम नहीं, स्रोत तय करने के फ़ैसले हैं।
रिकवरी रास्ता। अगर किसी अनिवार्य फ़ील्ड का कोई स्रोत ही नहीं है, जैसे बिना ब्रांड वाली रेंज पर brand, तो रुकें और फ़ाइल बनाने से पहले किसी बिज़नेस मालिक के साथ स्रोत का सवाल तय करें। फ़ॉर्मैट पर काम ग़ायब डेटा को ठीक नहीं कर सकता।
असल में आपको कौन-सा फ़ाइल फ़ॉर्मैट भेजने की अनुमति है
वही फ़ॉर्मैट इस्तेमाल करें जिसे OpenAI ऑनबोर्डिंग के दौरान आपकी रजिस्टर्ड फ़ीड के लिए पुष्ट करे। उसके अलावा एक Google-संगत रास्ता है जो UTF-8 टैब-डिलिमिटेड .txt या .tsv फ़ाइलें, या कॉमा-डिलिमिटेड .csv स्वीकार करता है, साथ में .txt.gz, .txt.gzip, .tsv.gz और .csv.gz के लिए gzip समर्थन।
JSON, स्प्रेडशीट, XML, RSS और Atom उस संगतता रास्ते पर समर्थित नहीं हैं। पूरे अपलोड के लिए एक ही फ़ॉर्मैट इस्तेमाल करें, पंक्ति-दर-पंक्ति फ़ॉर्मैट न मिलाएँ।
उन चार फ़ील्ड को सामान्य करें जो सबसे ज़्यादा पंक्तियाँ तोड़ती हैं
एक जमी हुई एक्सपोर्ट निकालें
एक बार एक्सपोर्ट करें, फ़ाइल पर टाइमस्टैम्प लगाएँ और उसका हैश निकालें। हर अगला कदम उसी जमी हुई फ़ाइल पर चलता है। दोहराव ही वह चीज़ है जो तीन हफ़्ते बाद ऑडिट को बचाव लायक बनाती है, जब कोई पूछता है कि कोई SKU क्यों ग़ायब है।
चार सामान्यीकरण
GTIN के शुरुआती शून्य। कॉलम को टेक्स्ट के रूप में एक्सपोर्ट करें, फिर जाँचें कि अंकों की संख्या 8, 12, 13 या 14 है, और चेक डिजिट सत्यापित करें। ज़्यादातर चुपचाप विफलताएँ यहीं रहती हैं।
क़ीमत का फ़ॉर्मैट। हज़ार सेपरेटर हटाएँ, दशमलव बिंदु रखें, घातांक संकेतन हटाएँ, और करेंसी कोड को अलग टोकन के रूप में जोड़ें। नतीजे को ऐसे रेगुलर एक्सप्रेशन से गुज़ारें जो केवल ^\d+\.\d{2} [A-Z]{3}$ स्वीकार करता हो, और बाक़ी को कतार में डालें।
उपलब्धता की मैपिंग। अपनी आंतरिक शब्दावली को पाँच स्वीकार्य वैल्यू पर स्पष्ट रूप से मैप करें। गिनें कि कितनी पंक्तियाँ हर बकेट में गिरती हैं और कितनी मैन्युअल समीक्षा तक पहुँचती हैं। मैन्युअल समीक्षा की ऊँची संख्या का मतलब है कि आपकी स्टॉक शब्दावली को मैपिंग तालिका चाहिए, यह नहीं कि आपकी फ़ीड टूटी है।
टाइटल और विवरण की सफ़ाई। टाइटल 150 अक्षरों पर शब्द की सीमा पर काटें। विवरण से मार्कअप हटाएँ और सादे टेक्स्ट के 5,000 अक्षरों पर सीमित करें।
गुणवत्ता जाँच। सामान्यीकृत फ़ाइल को नई स्प्रेडशीट में दोबारा आयात करें और पुष्टि करें कि GTIN कॉलम अब भी शुरुआती शून्य दिखाता है। यह उस "संख्या के रूप में एक्सपोर्ट" जाल को पकड़ता है जो बाक़ी सारी जाँचों से बच निकलता है।
रिकवरी रास्ता। अगर आपका फ़ीड प्लेटफ़ॉर्म या PIM ये सामान्यीकरण आपके लिए करता है, तो उसकी सफलता के संदेश पर भरोसा करने के बजाय उसके आउटपुट को इन्हीं जाँचों से सत्यापित करें।
हर पंक्ति का ऑडिट करें और अपवाद सूची रखें
अब पूरी फ़ाइल पर जाँचें चलाएँ। यही कदम कैटलॉग को काम की योजना में बदलता है।
वे नौ जाँचें जो आप बिना किसी वैलिडेटर के कर सकते हैं
हर पंक्ति के लिए: सभी नौ अनिवार्य फ़ील्ड मौजूद और ख़ाली नहीं; availability पाँच-मान वाले enum में; gtin के अंकों की संख्या और चेक डिजिट मान्य; price अमाउंट-और-करेंसी के रूप में; sale_price price से सख़्ती से कम और शून्य से बड़ी, उसी करेंसी में; title 150 अक्षरों पर या कम; description सादा टेक्स्ट, 5,000 अक्षरों पर या कम; url 200 लौटाता हो और प्रोडक्ट डेटा सर्वर साइड रेंडर करता हो; image_url प्लेसहोल्डर के बजाय असली इमेज पर पहुँचता हो।
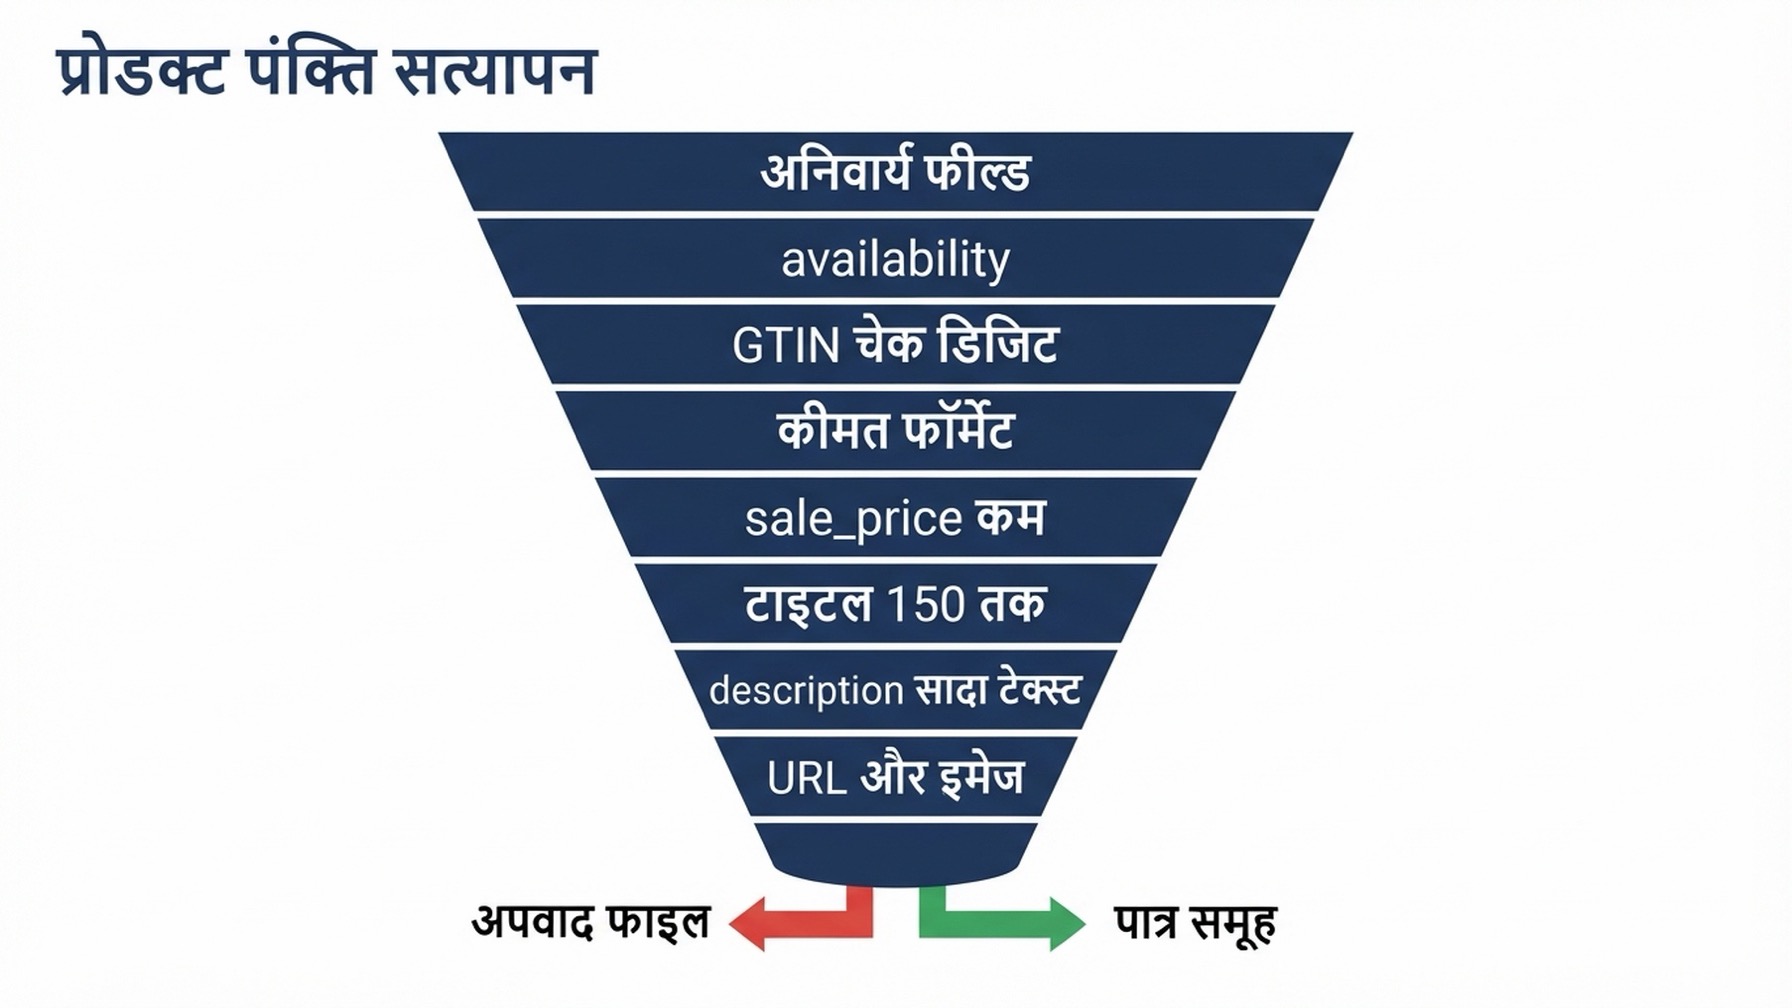
एक पंक्ति या तो हर गेट पार करती है या फेल हुए गेट के नाम के साथ अपवाद फ़ाइल में पहुँचती है। availability गेट सबसे ज़्यादा पंक्तियाँ अस्वीकार करता है, क्योंकि कस्टम स्टॉक शब्दावली ही कैटलॉग के फेल होने का सबसे आम तरीक़ा है।
बेहतरीन कैटलॉग नहीं, अपवाद फ़ाइल बनाएँ
दो कॉलम और एक ज़िम्मेदार व्यक्ति: item_id, रुकावट, और इसे कौन ठीक करेगा।
गुणवत्ता जाँच। ठीक-ठाक साफ़ कैटलॉग पर अपवाद फ़ाइल पंक्तियों के 10% से कम होनी चाहिए। अगर यह 30% से ऊपर है, तो समस्या ऊपर डेटा गवर्नेंस में है, और ईमानदार कदम फ़ाइल को पैबंद लगाने के बजाय स्रोत सिस्टम को ठीक करना है।
रिकवरी रास्ता। अगर कोई अनिवार्य फ़ील्ड बिखरे हुए SKU में नहीं, बल्कि पूरी श्रेणी में ग़ायब है, तो इसे बिज़नेस मालिक के साथ स्रोत का फ़ैसला मानें। ऑडिट बंद करने के लिए उन पंक्तियों को unknown न चिह्नित करें, क्योंकि unknown एक वैध वैल्यू है जिसका एक ख़ास मतलब है, और जाँच पास करने के लिए उसका इस्तेमाल अपने ही डेटा को गंदा करता है।
रिफ़्रेश पर एक ईमानदार बात: स्पेक कोई अपडेट कैडेंस नहीं बताती, और यह भी नहीं कहती कि फ़ीड पूरी स्नैपशॉट होती हैं या वृद्धिशील अपडेट। प्रकाशित विक्रेता विवरण दोनों पर पक्के दावे करते हैं, जो OpenAI के डॉक्युमेंटेशन में नहीं हैं। स्पेक हाँ यह बताती है कि मौजूदा क़ीमत भेजें, सेल शुरू या ख़त्म होने पर अपडेट करें, और किसी आइटम के बिक जाने या वापस आने पर उपलब्धता अपडेट करें। अपनी पाइपलाइन इन दो घटनाओं के आसपास बनाएँ और कैडेंस का सवाल ऑनबोर्डिंग में पुष्ट करें।
फ़ाइल को उसी तरह सत्यापित करें जैसे प्लेटफ़ॉर्म करेगा
ठीक वही बाइट्स दोबारा पार्स करें जो आप सबमिट करने वाले हैं, उसी फ़ॉर्मैट में जिसमें सबमिट करने वाले हैं, और अंदर आने वाली और बाहर जाने वाली पंक्तियाँ गिनें।
यह उस विफलता को पकड़ता है जिसे स्प्रेडशीट छिपा देती है। जो फ़ाइल Excel में साफ़ खुलती है, वह CSV के रूप में पार्स होने वाली वही फ़ाइल नहीं है, क्योंकि विवरण फ़ील्ड के भीतर बिना एस्केप किए गए डिलिमिटर और लाइन ब्रेक पार्सिंग तोड़ देते हैं, जबकि स्क्रीन पर सब ठीक दिखता रहता है।
गुणवत्ता जाँच। अंदर आने वाली पंक्तियाँ बाहर जाने वाली पंक्तियों के बराबर हों, और ऑटोमेटेड जाँचें आपके मैन्युअल ऑडिट से मेल खाएँ। दोनों में अंतर का मतलब है कि इनमें से एक ग़लत है, और आम तौर पर वह मैन्युअल दौर होता है।
रिकवरी रास्ता। एन्कोडिंग की विफलताएँ लगभग हमेशा UTF-8 में दोबारा एक्सपोर्ट करने से ठीक हो जाती हैं। कोटिंग की विफलताएँ लगभग हमेशा बिना एस्केप किए डिलिमिटर या विवरण में छूटे लाइन ब्रेक होती हैं।
अगर आपकी टीम के पास कोई कोडिंग एजेंट उपलब्ध है, तो यही एक जगह है जहाँ छोटी स्क्रिप्ट अपनी क़ीमत वसूल करती है, क्योंकि यह ऑडिट को तिमाही प्रोजेक्ट से दोबारा चलने वाली चीज़ बना देती है।
सत्यापित करें कि यह काम कर गया
आप क्या साबित कर सकते हैं यह आपकी लेन पर निर्भर है, और फ़र्क़ को धुँधला करने के बजाय सटीक रहना बेहतर है।
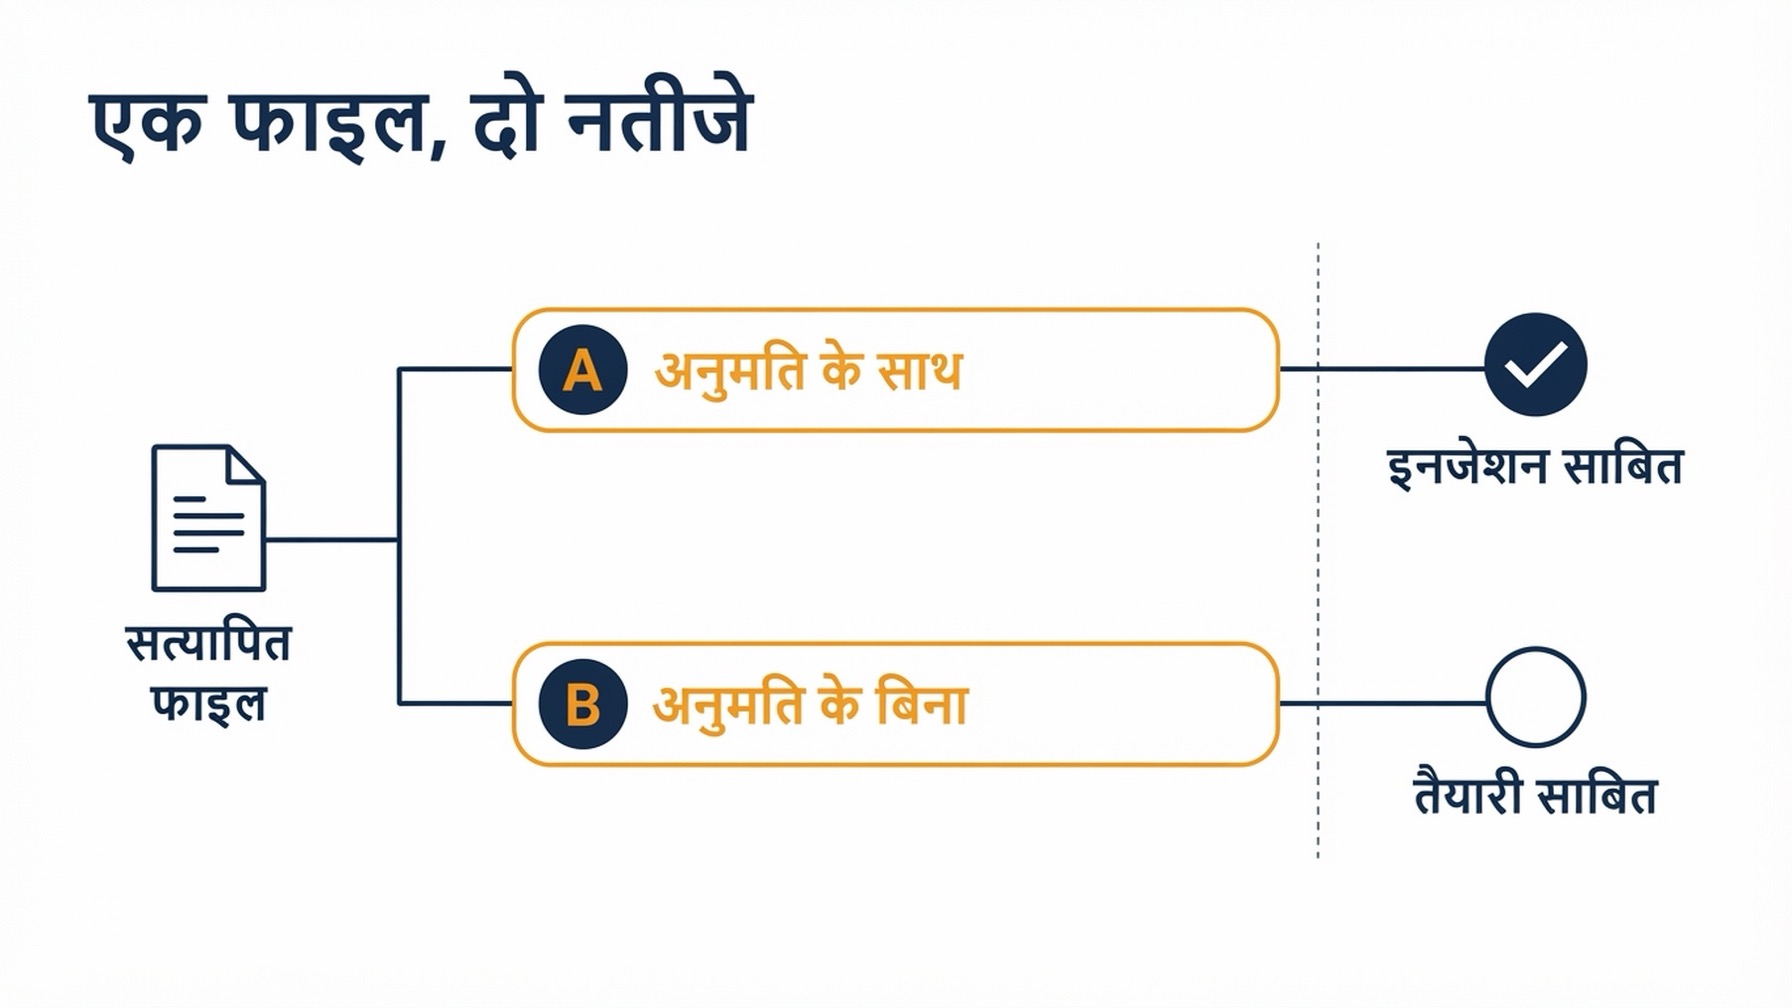
लेन A इनजेशन साबित कर सकती है। लेन B तैयारी साबित कर सकती है। न लेन और न शाखा फ़ाइल बदलती है, और एक्सेस मिलने से पहले उसे बनाने का मतलब यही है।
अगर आपके पास एक्सेस है (लेन A)
चार जाँचें। आपका सबमिशन स्वीकार हुआ। पंक्ति-स्तर की अस्वीकृति रिपोर्ट पढ़ी गई और हर अस्वीकृति सुलझाई या दर्ज की गई। कोई नमूना शॉपिंग प्रॉम्प्ट अब आपके प्रोडक्ट में से एक दिखाता है। आपके सर्वर लॉग दिखाते हैं कि रिट्रीवल एजेंट प्रोडक्ट URL फ़ेच कर रहा है।
अगर नहीं है (लेन B)
चार जाँचें। robots.txt फ़ेच OAI-SearchBot को एक प्रोडक्ट URL लौटाता है। उस URL का सर्वर-रेंडर किया गया फ़ेच टाइटल, क़ीमत, उपलब्धता और विवरण लिए होता है। नौ जाँचों वाला ऑडिट पास होता है। जमी हुई एक्सपोर्ट और जाँच का रन ऐसी जगह रखे हैं जहाँ से अगला व्यक्ति उन्हें दोबारा चला सके।
तैयारी एक असली, ग़लत साबित की जा सकने वाली नतीजा है। बस यह इनजेशन जैसी नतीजा नहीं है, और आपको इसे वैसे रिपोर्ट नहीं करना चाहिए जैसे वह हो।
अंत में मायने रखने वाली एक संख्या
ChatGPT से बाहर जाने वाले लिंक अपने आप utm_source=chatgpt.com ले जाते हैं। इससे आपकी अपनी एनालिटिक्स ही यह साबित करने का एकमात्र फ़र्स्ट-पार्टी सबूत बनती है कि क्लिक हुआ। फ़िल्टर अभी सेट करें, डेटा की ज़रूरत पड़ने से पहले।
साफ़ रहें कि यह क्या मापता है। यह क्लिक से आने वाली ट्रैफ़िक एट्रिब्यूशन है, दृश्यता का मीट्रिक नहीं। कोई प्रोडक्ट कई बार सुझाया जा सकता है और शून्य बार क्लिक हो सकता है, और जो प्रोडक्ट पात्र नहीं है वह कभी क्लिक हो ही नहीं सकता।
यह वर्कफ़्लो किस चीज़ को नियंत्रित नहीं करता
यह फ़ीड समूह के भीतर रैंकिंग को नियंत्रित नहीं करता। स्पेक एक पंक्ति कॉन्ट्रैक्ट तय करती है। वह कोई क्रम तय करने वाला नियम नहीं देती। हर फ़ील्ड जाँच पास करना प्रोडक्ट को रिट्रीव होने योग्य बनाता है। यह नहीं बताता कि दस अनुरूप पंक्तियों में से कौन दिखेगी। ऊपर जिस शोध का ज़िक्र है वह रिट्रीवल स्रोत मापता है, रिट्रीव किए गए समूह के भीतर की रैंकिंग नहीं।
10 जुलाई के आँकड़े प्रेक्षणात्मक हैं और एक ही विक्रेता से आते हैं। वे Profound के ट्रैक किए गए प्रॉम्प्ट पैनल का बखान करते हैं, असली ख़रीदार सेशन या ख़रीद यात्राओं का नहीं। OpenAI ने इस बदलाव की पुष्टि नहीं की है और रिट्रीवल का कोई बँटवारा प्रकाशित नहीं किया है। GPT-6 Astra की रोलआउट 3 सितंबर 2026 को शुरू हुई, जो उस शोध की बाद वाली मापन अवधि से टकराती है और एक असली भ्रमकारी कारक है।
संकेंद्रण के आँकड़े भी वही सीमाएँ लिए हैं। शीर्ष 10 स्टोर संदर्भों का 22.5% से 41.8% तक बढ़ना और अद्वितीय मर्चेंट का 13,524 से 10,607 तक गिरना, दोनों उसी पैनल से आते हैं। और यह निष्कर्ष कि 517 बदलते ग्राहकों में रिट्रीवल-स्रोत बदलावों ने दृश्यता की भिन्नता का 83% समझाया, पैनल के भीतर का एक व्याख्यात्मक हिस्सा है, न कि ऐसा कारण-संबंध गुणांक जिस पर योजना बनाई जाए।
विक्रेता ब्लॉगों में घूमते कुछ दावे स्पेक में नहीं हैं। इनमें से हर एक को सावधानी से लें:
दावा | स्रोत | स्थिति |
|---|---|---|
फ़ीड हर 15 मिनट में रिफ़्रेश होती हैं, रोज़ाना फ़ीड से 96 गुना ज़्यादा बार | विक्रेता ब्लॉग | OpenAI की स्पेक में नहीं है, जो कोई कैडेंस नहीं बताती |
फ़ीड पूरी स्नैपशॉट होती हैं, वृद्धिशील अपडेट नहीं | एक विक्रेता, जो किसी OpenAI डॉक्युमेंट का हवाला नहीं देता | अनसुलझा; ऑनबोर्डिंग में पुष्ट करें |
लगभग 100 प्रोडक्ट का नमूना ज़रूरी है | विक्रेता ब्लॉग | OpenAI का हेल्प टेक्स्ट शुरुआती नमूना या पूरी फ़ीड का ज़िक्र करता है, बिना किसी संख्या के |
सबमिशन SFTP से होता है | एक विक्रेता; दूसरा एन्क्रिप्टेड HTTPS पुश कहता है | स्रोत आपस में टकराते हैं; तरीक़ा ऑनबोर्डिंग के दौरान पुष्ट होता है |
| एक समेकित स्रोत | स्पेक की फ़ील्ड सूची में नहीं। स्पेक के रिव्यू फ़ील्ड हैं |
संरचित फ़ीड स्क्रैप किए डेटा से करीब दोगुना बेहतर कन्वर्ट करती हैं | बिना स्रोत वाला विक्रेता दावा | इसके हिसाब से योजना न बनाएँ |
यह नियंत्रित नहीं करता कि आपकी कॉपी कैसे रेंडर होती है। ChatGPT सरलीकृत प्रोडक्ट टाइटल और विवरण बना सकता है। और शॉपिंग नतीजे ChatGPT द्वारा स्वतंत्र रूप से चुने जाते हैं और विज्ञापन नहीं हैं, जो व्यावसायिक प्रभाव का सवाल है, रिट्रीवल स्रोत का नहीं। अगर आपको पेड प्लेसमेंट चाहिए, तो OpenAI प्रोडक्ट फ़ीड से बना एक अलग विज्ञापन रास्ता चलाता है। वह अलग वर्कफ़्लो है और यह लेख वह नहीं है।
अक्सर पूछे जाने वाले सवाल
क्या मैं आज ChatGPT को प्रोडक्ट फ़ीड सबमिट कर सकता हूँ?
माँगने पर नहीं। एक्सेस हर मर्चेंट के लिए अलग से पुष्ट होता है, चेकआउट के लिए अलग से चालू की गई इंटीग्रेशन चाहिए, और मानक अपलोड इस समय अमेरिका के लिए है। रजिस्ट्रेशन केवल आपका मर्चेंट डिस्प्ले नाम देता है, और आप लाइव अपलोड एक्सेस के बिना भी रजिस्टर्ड हो सकते हैं। अपनी स्थिति तय करने के लिए ऊपर दिया चार सवालों वाला एक्सेस टेस्ट चलाएँ।
फ़ीड कितनी बार रिफ़्रेश करनी चाहिए?
स्पेक कोई कैडेंस नहीं बताती। दो विक्रेता ब्लॉग पंद्रह मिनट का दावा करते हैं, और वह संख्या OpenAI के डॉक्युमेंटेशन में नहीं दिखती। व्यावहारिक जवाब यह है कि रिफ़्रेश अपनी क़ीमत और उपलब्धता की घटनाओं से चलाएँ, क्योंकि स्पेक साफ़ तौर पर इन्हीं दो चीज़ों को अद्यतन रखने को कहती है।
पूरी फ़ाइल भेजूँ या केवल बदली हुई पंक्तियाँ?
अनसुलझा। एक विक्रेता पूरी स्नैपशॉट का दावा करता है और उसके लिए किसी OpenAI डॉक्युमेंट का हवाला नहीं देता। किसी भी जवाब पर निर्भर पाइपलाइन बनाने से पहले इसे ऑनबोर्डिंग में पुष्ट करें।
क्या 100 प्रोडक्ट के नमूने की शर्त असली है?
OpenAI का हेल्प टेक्स्ट शुरुआती नमूना या पूरी फ़ीड सबमिशन का ज़िक्र करता है, बिना कोई संख्या जोड़े। 100 प्रोडक्ट का आँकड़ा विक्रेता ब्लॉगों से आता है। अगर आप नमूना तैयार करते हैं, तो उसे किसी ख़ास गिनती पर पहुँचने के बजाय हर वैकल्पिक-समूह के मामले को कवर करके प्रतिनिधि बनाएँ।
क्या अच्छी फ़ीड मेरे प्रोडक्ट को ChatGPT शॉपिंग नतीजों में ऊपर पहुँचा देगी?
उस मतलब में नहीं जो इस सवाल में आम तौर पर निहित होता है। फ़ीड प्रोडक्ट को पात्र और वर्णनीय बनाती है। रिट्रीव किए गए समूह के भीतर रैंकिंग प्रलेखित नहीं है, और सार्वजनिक शोध क्रम के बजाय रिट्रीवल स्रोत मापता है। फ़ील्ड अनुपालन को पूर्वशर्त मानें, लीवर नहीं।
अगर मैं Shopify पर बेचता हूँ तो क्या मुझे इसमें से कुछ चाहिए?
बुनियादी सिंडिकेशन के लिए नहीं, क्योंकि प्रोडक्ट डेटा बिना मर्चेंट-साइड काम के Shopify Catalog के ज़रिए ChatGPT तक पहुँचता है। सीधी फ़ीड ताज़गी के लिए और उन फ़ील्ड के लिए है जो डिफ़ॉल्ट नहीं ले जाता।
लेखक: Eva Laurent, Ecommerce Search Strategist for 10k+ Product Pages, Auspia। Eva ईकॉमर्स सर्च, प्रोडक्ट डिस्कवरी और यह कि प्रोडक्ट डेटा AI शॉपिंग सतहों तक कैसे पहुँचता है, इन विषयों पर लिखती हैं।