इस लेख के बाद आपके पास क्या होगा
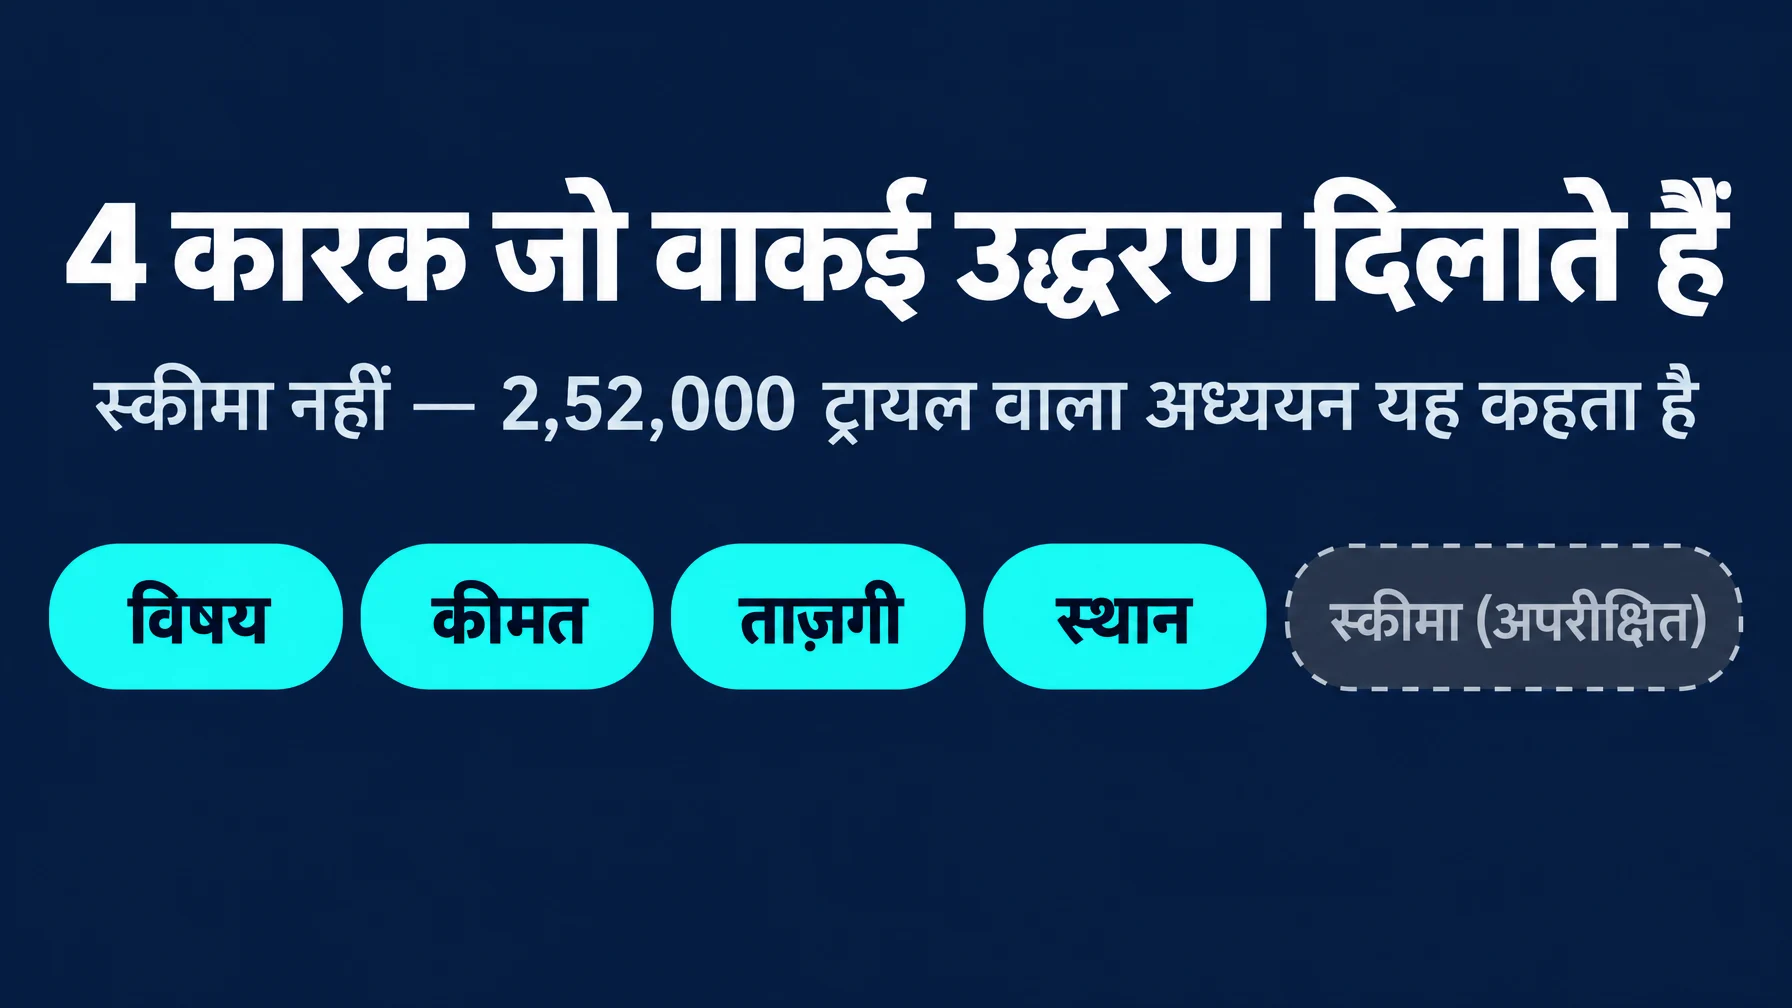
एक पेज-स्तरीय ऑडिट, उन चार कारकों के खिलाफ जिन्हें 2,52,000 ट्रायल वाले एक नियंत्रित अध्ययन ने AI उद्धरणों के लिए निर्णायक बताया, साथ ही उन सात द्वितीयक कारकों को ठीक करने का क्रम जो इन चारों के जमने के बाद ही असर दिखाते हैं। आप यह भी जानेंगे, स्रोतों के साथ, कि "स्कीमा मार्कअप का AI उद्धरणों पर कोई असर ही नहीं होता" वाला वायरल दावा उस अध्ययन का असली निष्कर्ष क्यों नहीं है — ताकि आप पूरा स्प्रिंट गलत चीज़ ठीक करने में न लगा दें।
किसके लिए: हर उस व्यक्ति के लिए जो किसी ऐसी वेबसाइट के लिए पेज-स्तर पर SEO या GEO संभालता है जिसे ChatGPT, Gemini, Perplexity, Claude या Google के AI जवाबों में उद्धृत होना है।
लगने वाला समय: प्रति पेज 30 से 45 मिनट, ऑडिट और सुधार के पहले दौर सहित।
काम पूरा तब: जब आपका जांचा गया पेज चारों गेटकीपर पास कर ले और आपके पास बाकी बचे द्वितीयक कारकों की लिखित सूची हो।
शुरू करने से पहले: यह चेकलिस्ट किस पर आधारित है और क्या सुधारती है
SEO/GEO के दायरे में एक पोस्ट घूम रहा है जिसमें दावा है कि एक SIGIR अध्ययन ने छह LLM पर 2,52,000 ट्रायल चलाए और पाया कि स्कीमा मार्कअप और JSON-LD का AI उद्धरणों पर "मापा गया असर शून्य" है, जबकि कीमत, ताज़गी, तकनीकी विवरण और गहराई नतीजे को ज़ोर से हिलाते हैं।
अध्ययन असली है। ट्रायल की संख्या सही है। उस पोस्ट में दिए ऑड्स अनुपात भी असली आंकड़ों के करीब हैं। एक ही बात टिकती नहीं: उस अध्ययन ने स्कीमा मार्कअप को कभी टेस्ट ही नहीं किया। बात यह नहीं कि स्कीमा "मापने पर शून्य निकला", बात यह है कि स्कीमा उन चीज़ों की सूची में ही नहीं था जो मापी गईं।
शोधपत्र का नाम "What Gets Cited: Competitive GEO in AI Answer Engines" (Vishwakarma, Kumar, Jamidar, Sprinklr; SIGIR '26, मेलबर्न) है। डिज़ाइन यह है कि छह LLM (Gemini-2.5-Flash, Claude-3.5-Sonnet, Kimi-K2-Thinking और GPT-5 के तीन वेरिएंट) में ठीक दो उम्मीदवार स्रोत डाले जाते हैं, हर जोड़ी 18 सामग्री कारकों में से ठीक एक पर अलग होती है, और दर्ज किया जाता है कि पहले किस स्रोत का उद्धरण आया। ये 18 कारक सामग्री मेल, पूर्णता, विश्वसनीयता, पठनीयता, प्रतिस्पर्धी स्थिति और ताज़गी को कवर करते हैं। संरचित डेटा का प्रारूप इन 18 में नहीं है — यह शोधपत्र की अपनी वर्गीकरण तालिका से सीधे मिलान करके पुष्ट है।
अगर आपको स्कीमा पर असली जवाब चाहिए, तो वह कहीं और से आता है: मई 2026 का Ahrefs नियंत्रित अध्ययन, जिसने JSON-LD जोड़े गए 1,885 पेजों की तुलना 4,000 मिलाए गए नियंत्रण पेजों से की। नतीजा यह था कि Google AI Overviews (−4.6%, छोटी पर सांख्यिकीय रूप से महत्वपूर्ण गिरावट), Google AI Mode (+2.4%, अमहत्वपूर्ण) और ChatGPT (+2.2%, अमहत्वपूर्ण) पर उद्धरणों में कोई अर्थपूर्ण बढ़त नहीं मिली। searchVIU के एक अलग टेस्ट ने पाया कि ChatGPT, Claude, Perplexity, Gemini और Google AI Mode रीयल-टाइम रिट्रीवल के दौरान JSON-LD, छिपा हुआ Microdata या छिपा हुआ RDFa पढ़ते ही नहीं।
ऑडिट शुरू करने से पहले इन दोनों बातों को अलग रखें: SIGIR अध्ययन बताता है कि पेज पर प्राथमिकता किसे दें। Ahrefs अध्ययन बताता है कि उद्धरण की मात्रा के मामले में स्कीमा उन प्राथमिकताओं में नहीं है, भले ही रिच रिज़ल्ट और एंटिटी स्पष्टता जैसी जगहों पर वह अब भी मायने रखता हो।
चरण 1: गेटकीपर ऑडिट चलाएं
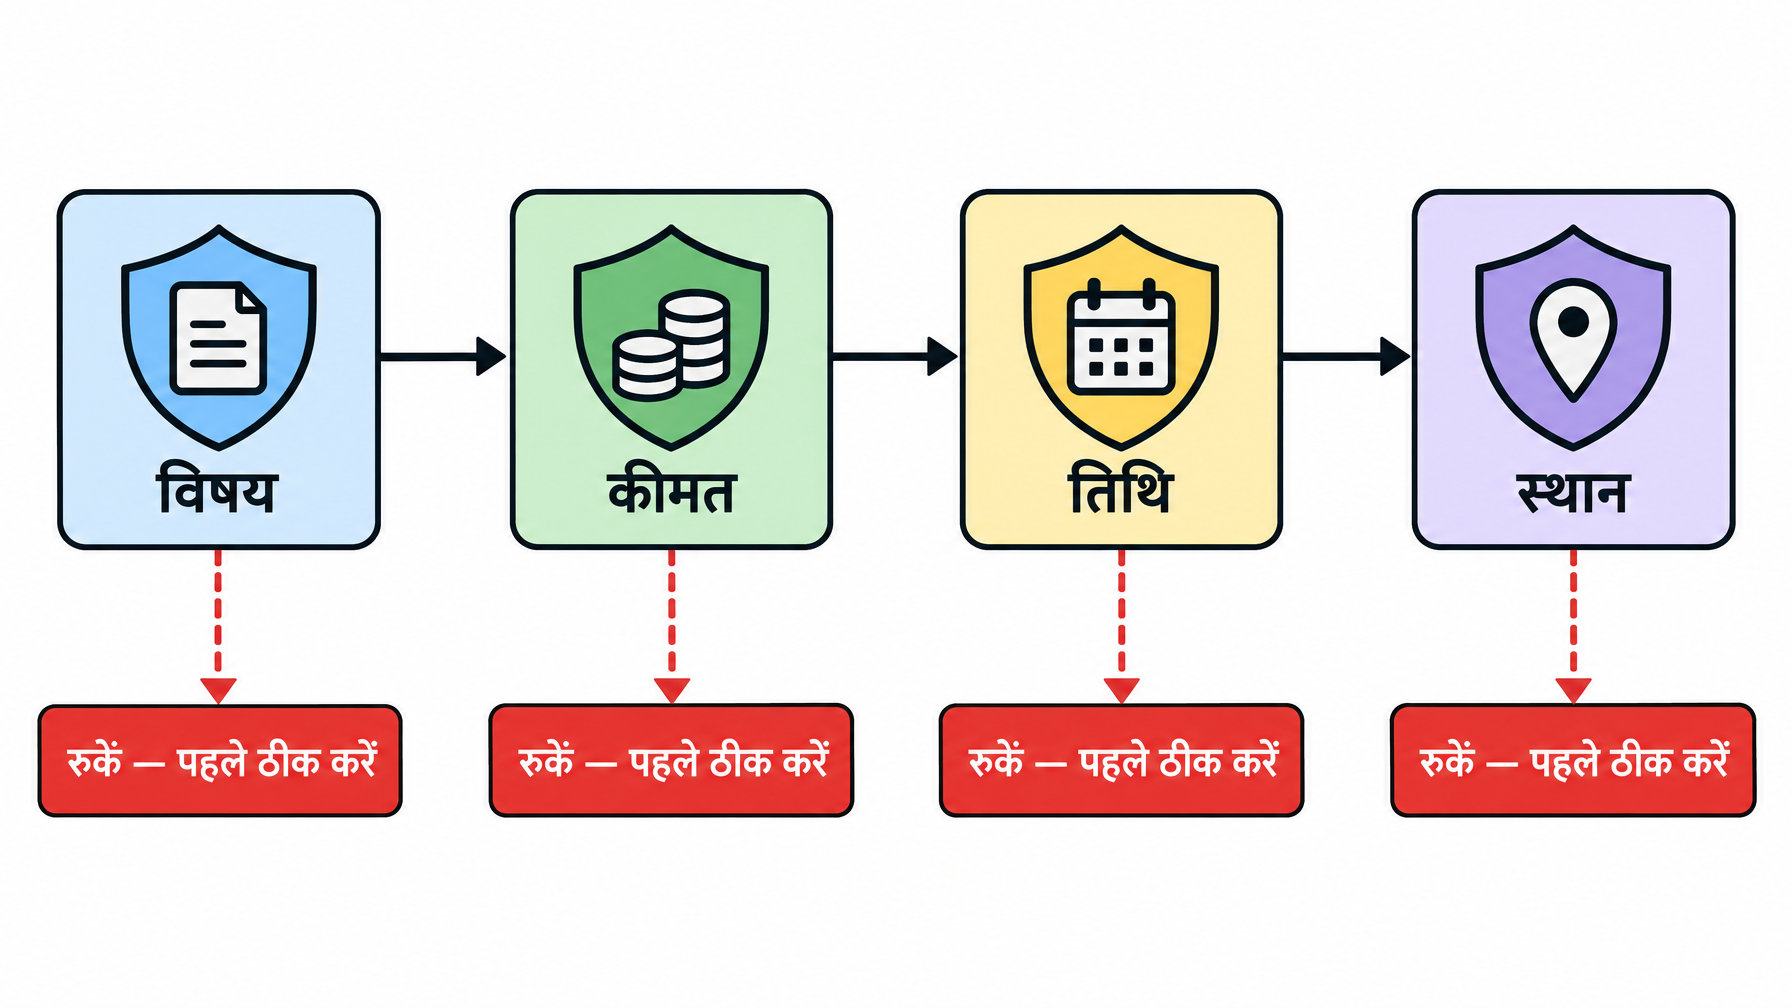
अपने पेज को इन चार कारकों पर जांचें। SIGIR अध्ययन ने पाया कि चारों छह मॉडलों पर एकमत थे, और असर बहुत बड़ा था (ज़्यादातर मॉडलों में ऑड्स अनुपात 100 से ऊपर)। इनमें से एक भी फेल हो जाए तो उद्धृत होने का मौका खत्म हो सकता है, चाहे पेज का बाकी हिस्सा कितना भी मज़बूत हो।
गेटकीपर | क्या जांचें | ऑड्स अनुपात की सीमा (छह जांचे गए मॉडल) |
|---|---|---|
विषय मेल | क्या पेज सीधे उसी क्वेरी का जवाब देता है जिसके लिए वह लड़ रहा है, किसी नज़दीकी विषय का नहीं? | छह में से पांच मॉडलों में निर्णायक |
कीमत बताई गई | क्या पेज पर ठोस कीमत दिखती है, "संपर्क करें" के पीछे छिपी नहीं? | 6.26 से 10,000 से ऊपर तक |
ताज़ा टाइमस्टैम्प | क्या मौजूदा और सही प्रकाशन या अंतिम समीक्षा तिथि दिखती है? | 14.4 से 10,000 से ऊपर तक |
सूची में स्थान | क्या यह पेज उस क्वेरी के उम्मीदवारों में दूसरे की जगह पहला स्थान लेने की ओर झुकता है? | 1,795 से 10,000 से ऊपर तक |
क्रिया: पेज को लक्ष्य क्वेरी के साथ खोलें। पहले 150 शब्द पढ़ें और पूछें कि क्या वे उस क्वेरी का सीधा जवाब देते हैं। पेज पर कीमत खोजें; अगर फॉर्म भरना या फोन करना पड़े, तो वह फेल है। दिखाई दे रही तिथि की तुलना उससे करें कि सामग्री असल में आखिरी बार कब अपडेट हुई थी। उस क्वेरी पर अपनी मौजूदा रैंकिंग या उद्धरण हिस्सेदारी देखें।
अपेक्षित नतीजा: चारों पंक्तियों के लिए पास या फेल।
गुणवत्ता जांच: अगर विषय मेल फेल हो, तो यहीं रुकें — आगे का कोई भी चरण ऐसे पेज को नहीं बचा सकता जो गलत सवाल का जवाब दे रहा है।
सुधार का रास्ता: कीमत और तिथि की विफलताएं उसी दिन ठीक हो जाती हैं (चरण 2)। सूची में स्थान की विफलता सामग्री की समस्या नहीं है; इसका मतलब है कि इस पेज के उद्धरण के लिए मुकाबला करने से पहले SEO की बुनियादी बातें ठीक करनी होंगी, और पेज के अंदर की कोई भी पॉलिश उसकी भरपाई नहीं कर सकती।
चरण 2: जो गेटकीपर फेल हुए हैं, पहले उन्हें ठीक करें
कुछ और छूने से पहले यह कर लें। पूरी सूची में सबसे ज़्यादा असर और सबसे कम मेहनत वाले यही मद हैं।
अगर कीमत नहीं है: असली आंकड़ा डालें। अगर कीमत बदलती रहती है, तो संपर्क फॉर्म की जगह असली शुरुआती कीमत या साफ़ रेंज प्रकाशित करें। यह अध्ययन के चार गेटकीपरों में से एक था।
अगर टाइमस्टैम्प पुराना है या गायब है: प्रकाशन या अंतिम समीक्षा तिथि अपडेट करें, लेकिन सामग्री सचमुच संशोधित करने के बाद ही। बिना असली अपडेट के तिथि बदलना ऐसा ताज़गी संकेत है जिसे कोई जांच ले तो आप साबित नहीं कर पाएंगे।
अगर विषय मेल कमज़ोर है: पहले 150 शब्द ऐसे फिर लिखें कि वे उस क्वेरी के काम का सीधा जवाब दें, किसी जुड़े विषय का नहीं। नई शुरुआत को पुराने ढांचे से जोड़ें नहीं — बदल दें।
गुणवत्ता जांच: पेज को ऐसे दोबारा पढ़ें मानो आप खुद वह क्वेरी हों। क्या कोई अजनबी पहले पैराग्राफ में ही ठोस जवाब पा लेता है?
सुधार का रास्ता: अगर असली कीमत प्रकाशित नहीं की जा सकती (कस्टम कोट, कॉर्पोरेट सौदे), तो खाली छोड़ने की जगह एक प्रतिनिधि शुरुआती कीमत या सामान्य रेंज प्रकाशित करें — अध्ययन ने विफलता की स्थिति "कीमत का ज़िक्र न होना" मापी थी, "कीमत बदलती रहना" नहीं।
चरण 3: द्वितीयक भेद कारकों पर काम करें
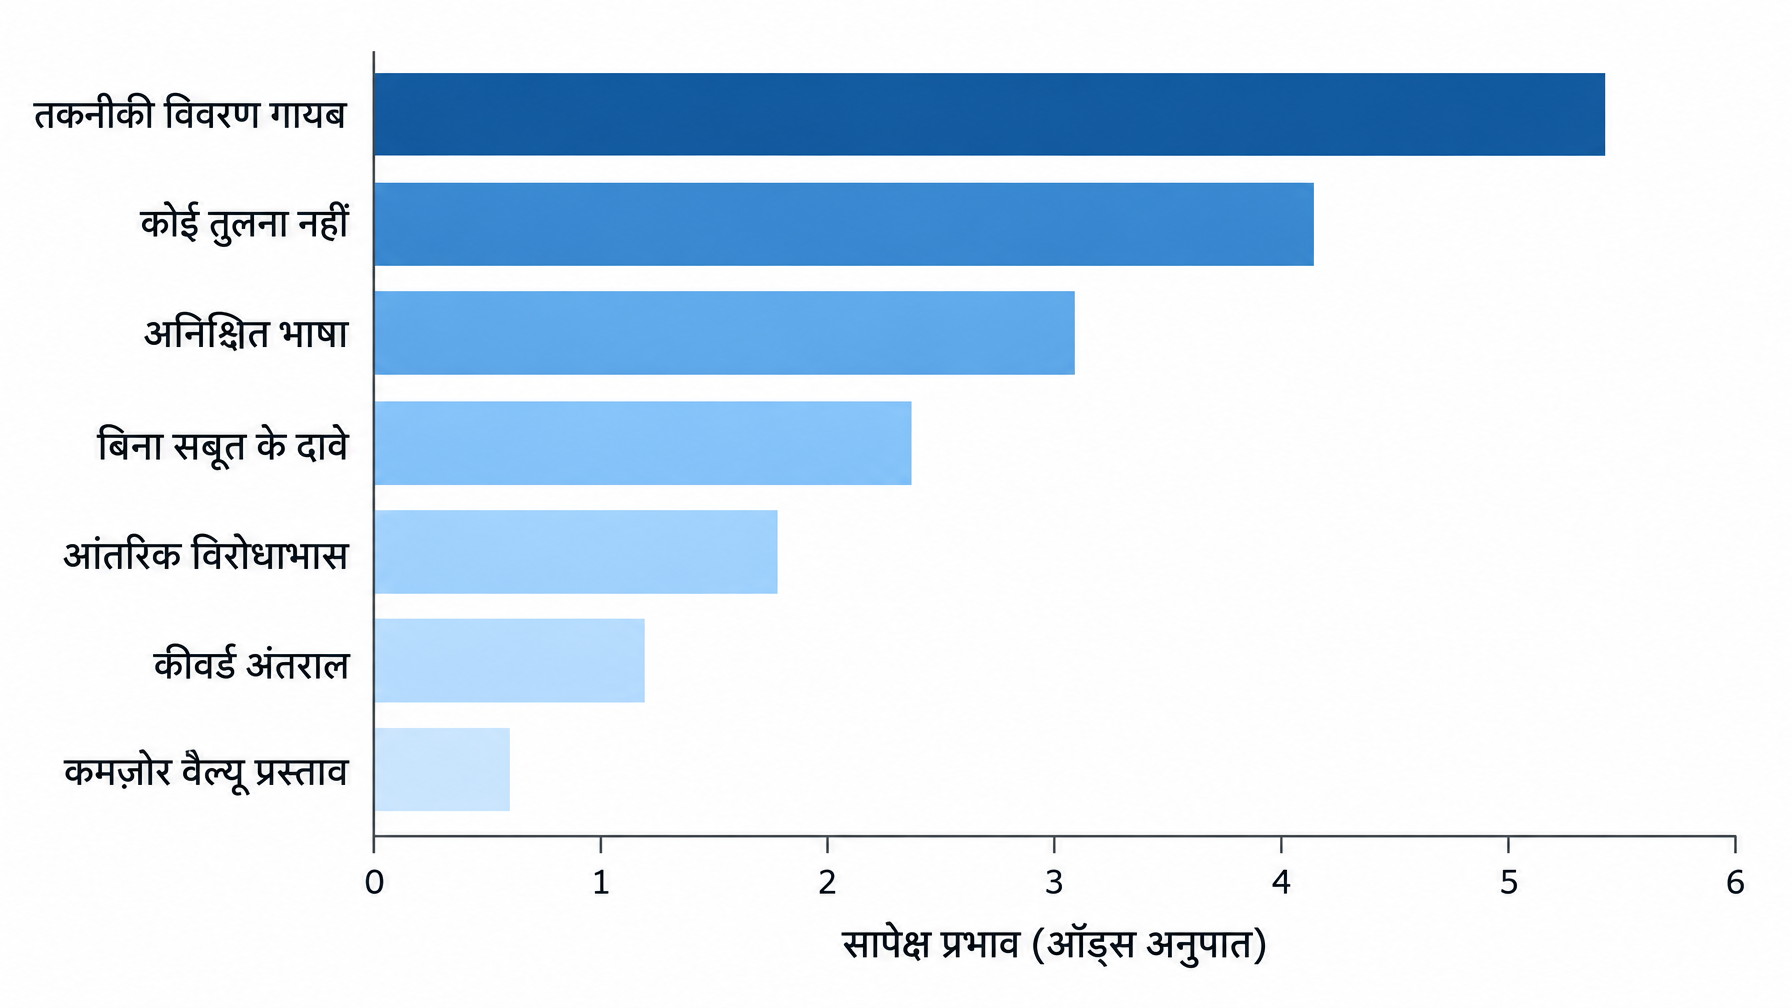
चारों गेटकीपर पास हो जाने पर, ये सात कारक द्वितीयक भेद देते हैं, मॉडल के हिसाब से ऑड्स अनुपात लगभग 2 से 243 तक। इन्हें इस क्रम में ठीक करें:
- तकनीकी विवरण गायब। वे तकनीकी विवरण जोड़ें जिनकी खरीदार सचमुच तुलना करेगा (माप, सामग्री, क्षमता, अनुकूलता)। मॉडल के हिसाब से ऑड्स अनुपात 8.63 से 243 — द्वितीयक असरों में सबसे बड़ा।
- कोई तुलना नहीं। कम से कम एक नामित विकल्प के साथ सीधी तुलना जोड़ें। ऑड्स अनुपात 1.61 से 7.45।
- अनिश्चित भाषा। "शायद", "हो सकता है", "संभवतः" को ऐसे सीधे कथनों से बदलें जिन्हें पेज सचमुच निभा सके।
- बिना सबूत के दावे। दावों के साथ प्रमाण जोड़ें: परीक्षण नतीजे, प्रमाणपत्र, नामित कार्यप्रणाली।
- आंतरिक विरोधाभास। जांचें कि एक ही पेज के हिस्सों के बीच आंकड़े और दावे मेल खाते हैं; संपादन के दौरान यह आसानी से घुसता है और समीक्षा में आसानी से छूट जाता है।
- कीवर्ड अंतराल। पक्का करें कि पेज पर लक्ष्य क्वेरी के ठोस शब्द मौजूद हैं, सिर्फ समानार्थी नहीं।
- कमज़ोर वैल्यू प्रस्ताव। प्रतिस्पर्धी पेज जो दे रहा है, उसके मुकाबले अपना ठोस फ़ायदे का दावा और पैना करें।
क्रिया: सूची को ऊपर से नीचे चलें और जो लागू हो उसे ठीक करें। हर पेज में सातों समस्याएं नहीं होंगी।
अपेक्षित नतीजा: ऐसा पेज जिसमें हर दावा ठोस, तुलनीय या प्रमाणित हो।
गुणवत्ता जांच: क्या कोई शक करने वाला पाठक पेज पर अभी भी एक भी धुंधला या बिना आधार वाला वाक्य पा लेता है?
सुधार का रास्ता: अगर समय कम है, तो मद 1 और 2 (तकनीकी विवरण और तुलनाएं) पर रुक जाएं — सातों में इन्हीं के ऑड्स अनुपात सबसे ऊंचे हैं।
चरण 4: सिर्फ फॉर्मेटिंग वाले बदलाव छोड़ दें
अध्ययन ने साफ़ दिखाया कि पैराग्राफ को बुलेट में बदलने, पढ़ने में आसानी के लिए उपशीर्षक जोड़ने, या बिखरी जानकारी को फिर से लगाने का कोई एक-सा असर नहीं मिला, क्योंकि जांचे गए मॉडलों ने सामग्री को दिखने वाले ढांचे से अलग, अपने आप समझा। अगर आपका पेज ऊपर की जांच पास कर चुका है, तो उद्धरण बढ़ने की उम्मीद में पूरा स्प्रिंट फॉर्मेटिंग की पॉलिश पर न लगाएं। फॉर्मेटिंग अपने असली पाठकों के लिए करें, ऐसे उद्धरण लाभ के लिए नहीं जिसे आंकड़े नहीं थामते।
चरण 5: स्कीमा को उसकी जगह पर रहने दें
स्कीमा मार्कअप को तकनीकी रूप से सही रखें, क्योंकि वह असली काम करता है: Google और Bing को रिच रिज़ल्ट समझने में मदद करता है और सर्च सिस्टम को साफ़ बताता है कि पेज और एंटिटी क्या हैं। जो वह नहीं करता, मौजूद सबसे अच्छे नियंत्रित प्रमाण के मुताबिक, वह यह है कि AI उद्धरण की संभावना नहीं हिलाता। स्कीमा के काम को चरण 1 से 3 के आगे इस सोच पर न रखें कि यह उद्धरण का लीवर है: कोई नियंत्रित अध्ययन इसे नहीं थामता, और इसके पक्ष में जिस एक अध्ययन का हवाला दिया जाता है, उसने स्कीमा टेस्ट ही नहीं किया। अगर आप जानना चाहें कि Ahrefs के स्कीमा अध्ययन ने असल में क्या मापा, तो हमारी 2026 सिमैंटिक SEO गाइड देखें।
तैयार नतीजे की जांच करें
सुधार के बाद पेज पर चरण 1 का ऑडिट दोबारा चलाएं। चारों गेटकीपर अब पास होने चाहिए। चरण 3 से जिन दो-तीन द्वितीयक कारकों को आपने ठीक किया, उनकी नमूना जांच करें। अगर आपके पास AI विज़िबिलिटी या उद्धरण ट्रैकिंग टूल है, जैसे AI Search Visibility Checker, तो अगले पेज पर जाने से पहले लक्ष्य क्वेरी पर पेज की मौजूदा उद्धरण हिस्सेदारी आधार रेखा के तौर पर दर्ज कर लें, ताकि बाद में बता सकें कि बदलावों ने कुछ हिलाया या नहीं।
नतीजा बनाए रखें
तिथि वाला गेटकीपर हर बार दोबारा जांचें जब पेज पर कोई असली अपडेट हो, किसी तय कैलेंडर पर नहीं। उद्धरण हिस्सेदारी खो चुके पेजों के लिए, यह मान लेने से पहले कि कोई द्वितीयक कारक फिसला है, चारों गेटकीपर से शुरू करके ऑडिट दोबारा करें।
अक्सर पूछे जाने वाले सवाल
क्या SIGIR अध्ययन ने स्कीमा मार्कअप या JSON-LD टेस्ट किया? नहीं। उसका 18 कारकों वाला वर्गीकरण सामग्री मेल, पूर्णता, विश्वसनीयता, पठनीयता, प्रतिस्पर्धी स्थिति, ताज़गी और सूची में स्थान को कवर करता है। संरचित डेटा का प्रारूप न श्रेणियों में है न जांचे गए कारकों में — यह शोधपत्र की वर्गीकरण तालिका सीधे पढ़कर पुष्ट है।
तो स्कीमा मार्कअप AI उद्धरणों में मदद करता है या नहीं? मौजूद सबसे अच्छा नियंत्रित प्रमाण — मई 2026 का Ahrefs अध्ययन, 1,885 पेज बनाम 4,000 मिलाए गए नियंत्रण — JSON-LD जोड़ने से Google AI Overviews, Google AI Mode या ChatGPT में कोई अर्थपूर्ण उद्धरण बढ़त नहीं मिली। एक और टेस्ट ने पाया कि कई बड़े AI मॉडल रीयल-टाइम रिट्रीवल के दौरान संरचित डेटा नहीं पढ़ते। इससे स्कीमा कहीं और बेकार नहीं हो जाता; वह बस उद्धरण की मात्रा का लीवर नहीं है।
वायरल पोस्ट के ठोस आंकड़े (6.3, 14, 4 से 8.6) कहां से आए? वे SIGIR शोधपत्र की नतीजा तालिका के असली ऑड्स अनुपात जैसे दिखते हैं, पर वे कीमत, ताज़गी और तकनीकी विवरण/तुलना वाले कारकों के हैं, स्कीमा के नहीं। शोधपत्र आंकड़े हर मॉडल के हिसाब से देता है, एक औसत के तौर पर नहीं, और छह जांचे गए LLM के बीच सीमाएं काफ़ी अलग हैं।
अगर मेरे पास सिर्फ एक घंटा हो, तो पहले क्या ठीक करूं? चारों गेटकीपर: विषय मेल, कीमत, टाइमस्टैम्प और सूची में स्थान। इनमें से कोई भी फेल होने पर पेज पर बाकी सब कुछ जो भी हो, उद्धरण का मौका खत्म हो सकता है।
क्या मुझे स्कीमा का काम पूरी तरह छोड़ देना चाहिए? नहीं। रिच रिज़ल्ट और एंटिटी स्पष्टता के लिए उसे सही बनाए रखें। बस अगर AI उद्धरण की मात्रा असली लक्ष्य है, तो स्कीमा का नया काम चारों गेटकीपर ठीक करने से ऊपर न रखें।
लेखक: Bennett Hayes, Auspia में Applied GEO Analyst, 400 से अधिक इम्प्लीमेंटेशन रिव्यू। Bennett व्यावहारिक GEO क्रियान्वयन, ऑडिट और इम्प्लीमेंटेशन नोट्स पर लिखते हैं, जो इस पर आधारित हैं कि नियंत्रित अध्ययनों ने असल में क्या मापा।