Một công cụ theo dõi khả năng hiển thị trên AI nghe có vẻ đơn giản. Bạn đặt vài câu hỏi về ngành cho trợ lý, ghi lại xem thương hiệu của mình có xuất hiện không, rồi vẽ nó lên biểu đồ theo thời gian.
Vấn đề nằm ở phía thượng nguồn của việc ghi chép. Thứ bạn đo không đứng yên. Gửi cùng một câu lệnh đến cùng một mô hình hai lần và bạn sẽ nhận được hai câu trả lời chỉ trùng nhau một phần. Ghi lại một trong hai nghĩa là bạn đã ghi lại một mẫu từ một phân phối, rồi trình bày nó như một sự thật.
Chúng tôi muốn biết độ phân tán đó thực sự lớn đến mức nào, nên đã chạy thí nghiệm thay vì giả định. Bản tóm tắt: sáu yêu cầu giống hệt nhau tạo ra mười tám nguồn được trích dẫn, và không có nguồn nào được trích dẫn trong cả sáu lần.
Bài viết này nói về những gì chúng tôi đã chạy, những gì quay trở lại, và bốn trường mà một công cụ theo dõi khả năng hiển thị trên AI phải lưu trữ để con số còn đáng nhìn lại vào tháng sau.
Chúng tôi đã chạy những gì
Hai thí nghiệm, cả hai đều dùng những câu lệnh mà một nhóm SaaS thực sự sẽ dùng khi nghiên cứu ngành.
Thí nghiệm 1: một câu lệnh, một mô hình, sáu lần chạy. Mô hình gpt-4o, bật tìm kiếm web, Hoa Kỳ, tiếng Anh. Câu lệnh: "Những công cụ theo dõi thứ hạng tốt nhất cho một nhóm SaaS nhỏ trong năm 2026 là gì? Cho một danh sách ngắn kèm nguồn." Sáu lệnh gọi trực tiếp riêng biệt, chạy tuần tự trong cùng một cửa sổ phiên.
Thí nghiệm 2: hai mô hình, cùng một câu lệnh, mỗi mô hình ba lần chạy. Cùng câu lệnh đó được gửi đến Claude Sonnet 5 và Gemini 3.8 Flash, mỗi mô hình ba lần, không bật tìm kiếm web. Không tìm kiếm, thứ chúng tôi đo là những sản phẩm mà mô hình kể ra từ kiến thức của chính nó, và đó là một tín hiệu khác với việc nó trích dẫn những nguồn nào.
Chúng tôi cũng gửi câu lệnh thứ hai theo cùng đường tìm kiếm web bốn lần, để xem hành vi trích dẫn có nhất quán giữa các dạng câu hỏi hay không: "Làm thế nào để tôi theo dõi AI Overviews cho trang web của mình? Cho những phương pháp cụ thể kèm nguồn."
Sáu lần chạy không phải một mẫu lớn, và chúng tôi đối xử với nó đúng như vậy. Nó đủ để cho thấy hướng và độ lớn thô của phương sai, và đó chính là điểm mấu chốt.
Kết quả 1: mười tám nguồn, không nguồn nào được cả sáu lần chạy chia sẻ
Sáu lần chạy có tìm kiếm web cộng lại đã trích dẫn 18 URL khác nhau. Đây là tần suất xuất hiện của từng tên miền.
Số lần được trích dẫn (trong 6 lần chạy) | Tên miền |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Không có tên miền nào được trích dẫn trong cả sáu lần chạy. Không có URL nào được trích dẫn trong cả sáu lần chạy.
Con số quan trọng ở đây là mức trùng lặp giữa các lần chạy. Khi so sánh từng cặp lần chạy, mức trùng lặp Jaccard trung bình trên các URL được trích dẫn là 0,167. Ở hai trong số mười lăm cặp, mức trùng lặp đúng bằng không, nghĩa là hai câu trả lời đó không chia sẻ nguồn nào.
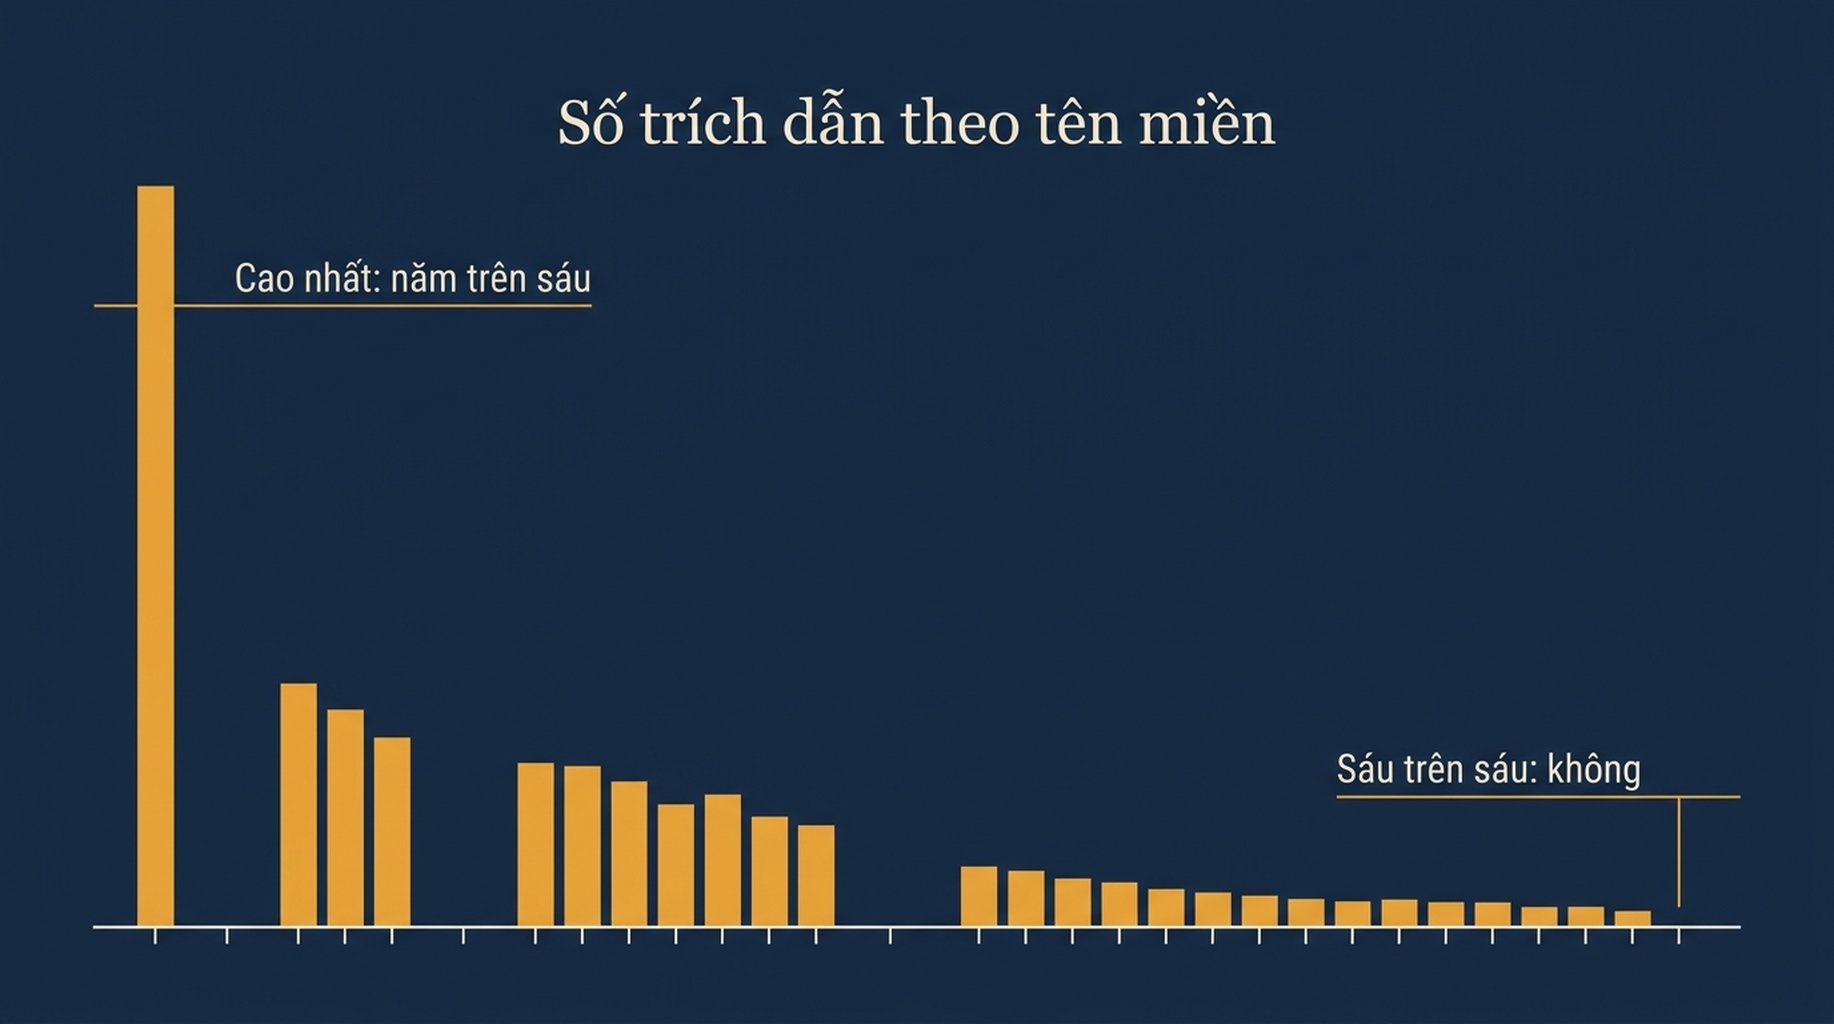
Một nguồn được trích dẫn trong năm trên sáu lần chạy là mức trần chúng tôi quan sát được. Không có gì được trích dẫn mọi lần.
Có một phát hiện thứ hai bị chôn trong bảng đó. Những tên miền mà mô hình với tay tới phần lớn không phải là các trang so sánh nổi tiếng trong ngành này. Chín trong mười tám tên miền xuất hiện đúng một lần, và một số là những trang nhỏ có nội dung đọc lên như thứ được lắp ghép cho truy vấn đó, chứ không phải như kết quả của một quá trình đưa tin. Với một thương hiệu, đây là con dao hai lưỡi. Nó nghĩa là vị trí trích dẫn dễ giành hơn thứ hạng "công cụ tốt nhất" truyền thống. Nó cũng nghĩa là vị trí đó đang bị chiếm bởi người đã tạo ra một trang khớp với hình dạng truy vấn trong lần chạy đó, và nó sẽ được lấp lại vào lần chạy tiếp theo.
Kết quả 2: bản thân câu trả lời thay đổi kích thước
Các trích dẫn dịch chuyển, và độ dài câu trả lời cũng dịch chuyển theo.
Lần chạy | Token đầu ra | Độ dài câu trả lời | Chi phí mỗi lần chạy |
|---|---|---|---|
1 | 505 | 2.153 ký tự | $0,0735 |
2 | 860 | 3.728 ký tự | $0,0770 |
3 | 1.108 | 4.746 ký tự | $0,0797 |
4 | 832 | 3.555 ký tự | $0,0765 |
5 | 870 | 3.547 ký tự | $0,0772 |
6 | 813 | 3.544 ký tự | $0,0768 |
Độ dài đầu ra dao động từ 505 đến 1.108 token, khoảng cách 603 token, tức khoảng 73 phần trăm của mức trung bình. Câu trả lời dài nhất dài hơn gấp đôi câu ngắn nhất. Năm trong sáu lần chạy rơi vào một dải khá hẹp từ 813 đến 1.108 token; một lần chạy dừng sớm ở 505 và chỉ trích dẫn năm nguồn thay vì chín đến mười bốn.
Với việc đo lường, điều này quan trọng theo một cách cụ thể. Nếu công cụ theo dõi của bạn ghi lại "thương hiệu có xuất hiện trong câu trả lời không, và ở vị trí thứ mấy", thì một lần chạy ngắn có ít chỗ để xuất hiện hơn. Một nhóm lấy mẫu mỗi tuần một lần và tình cờ rút trúng một lần chạy ngắn sẽ ghi lại kết quả tệ hơn một nhóm rút trúng lần chạy dài, mà không có gì thay đổi trên trang web.
Kết quả 3: một số câu lệnh không nhận được trích dẫn nào
Câu lệnh thứ hai, về việc theo dõi AI Overviews, đi qua cùng đường tìm kiếm web bốn lần và trả về không trích dẫn nào ở mọi lần.
Lần chạy | Token đầu ra | Độ dài câu trả lời | Trích dẫn |
|---|---|---|---|
1 | 479 | 2.135 ký tự | 0 |
2 | 522 | 2.240 ký tự | 0 |
3 | 534 | 2.312 ký tự | 0 |
4 | 497 | 2.228 ký tự | 0 |
Các câu trả lời ổn định về độ dài, chỉ thay đổi 8 phần trăm qua bốn lần chạy. Nhưng mô hình đã trả lời từ kiến thức của chính nó và không kể tên nguồn nào, nên không có gì để ghi vào cột trích dẫn.
Từ đó nảy sinh một cách đọc công cụ theo dõi vừa cụ thể vừa gây hiểu nhầm. Bảng điều khiển tỷ lệ trích dẫn sẽ hiển thị số không cho câu hỏi này, và nó trông như một thất bại về khả năng hiển thị. Không phải vậy. Đây là một dạng câu hỏi không kích hoạt việc tìm nguồn. Cách đọc đúng là "trích dẫn không áp dụng", và một công cụ theo dõi không phân biệt được điều đó với "đã kiểm tra trích dẫn và bạn vắng mặt" sẽ khiến bạn đuổi theo một vấn đề không tồn tại.
Kết quả 4: đổi mô hình là một phép đo khác, không phải một lần lặp lại
Với tìm kiếm web tắt, chúng tôi đo những sản phẩm mà mỗi mô hình kể tên. Điều này tách tập hợp gợi ý của chính mô hình khỏi mọi thứ mà chỉ mục tìm kiếm trả về trong phút đó.
Claude Sonnet 5 kể tên bốn đến năm sản phẩm mỗi lần chạy. Qua ba lần chạy, nó kể tên sáu sản phẩm khác nhau: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat và SerpWatcher. Ba trong số đó xuất hiện trong cả ba lần chạy: AccuRanker, Ahrefs và SEMrush. Mức trùng lặp trung bình theo cặp là 0,587.
Gemini 3.8 Flash kể tên hai đến năm sản phẩm mỗi lần chạy. Qua ba lần chạy, nó kể tên bảy sản phẩm khác nhau: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush và Wincher. Chỉ một trong số đó, SE Ranking, xuất hiện trong cả ba lần chạy. Mức trùng lặp trung bình theo cặp là 0,306.
Giữa hai mô hình, bốn sản phẩm được cả hai kể tên và năm sản phẩm chỉ được một bên kể tên.
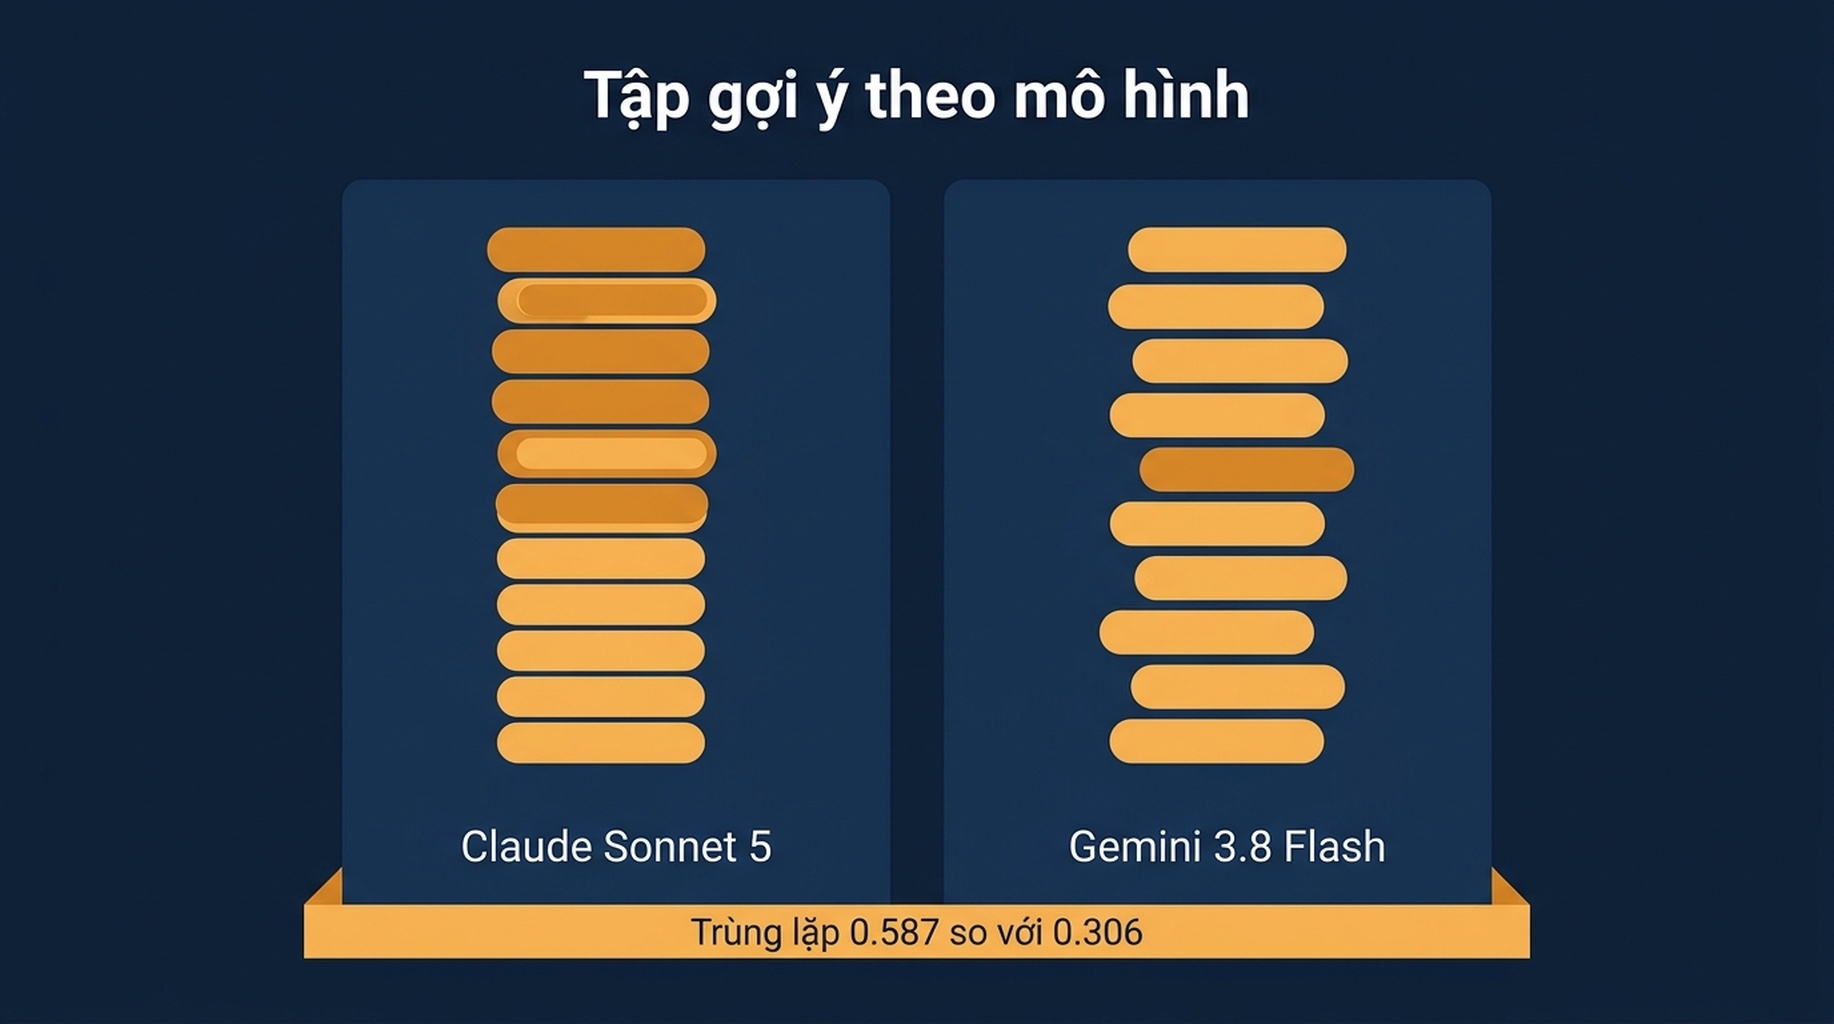
Cùng một câu hỏi tạo ra một tập hợp gợi ý khác nhau một phần ở mỗi mô hình và mỗi lần chạy.
Hệ quả thực tế: nếu bạn theo dõi "khả năng hiển thị trên AI" như một con số duy nhất, bạn đang lấy trung bình qua ít nhất hai nguồn phương sai độc lập, đó là lần chạy và mô hình. Một thương hiệu xuất hiện ổn định ở một trợ lý và không xuất hiện ở trợ lý khác là một phát hiện thật và có thể hành động được. Một thương hiệu mà phép đo từ một mẫu duy nhất dịch chuyển hai vị trí là nhiễu.
Công cụ theo dõi khả năng hiển thị trên AI nên ghi lại gì
Bốn trường biến một ảnh chụp màn hình thành một phép đo.
Số lần chạy, không phải kết quả của một lần chạy. Lưu mọi lần chạy và báo cáo khoảng. "Được trích dẫn trong 4 trên 6 lần chạy" là một sự thật. "Được trích dẫn, vị trí 3" là một sự trùng hợp. Sáu lần chạy là mức sàn hợp lý cho một chương trình nhỏ; mười hai lần tốt hơn nếu câu lệnh đó quan trọng về mặt thương mại.
Tách trường trích dẫn khỏi trường nhắc đến. "Mô hình đề xuất chúng tôi" và "mô hình liên kết đến chúng tôi" là hai kết quả khác nhau với hai cách khắc phục khác nhau. Sáu lần chạy của chúng tôi tạo ra 18 trích dẫn từ 18 URL khác nhau; một công cụ theo dõi chỉ ghi nhắc đến thương hiệu sẽ không bắt được gì từ sự biến động đó.
Trạng thái kênh của câu trả lời. Ghi lại xem lần chạy đó có dùng tìm kiếm web hay không, và ghi lại độ dài câu trả lời. Một lần chạy không trích dẫn và một lần chạy không nhắc đến trông giống hệt nhau trên bảng điều khiển nhưng mang ý nghĩa ngược nhau.
Nguyên văn câu lệnh, kèm số phiên bản. Cách diễn đạt câu lệnh quyết định những nguồn nào được kéo vào. Nếu câu lệnh thay đổi giữa các tháng, đường xu hướng sẽ đứt. Hãy đánh phiên bản cho câu lệnh như bạn đánh phiên bản cho script theo dõi.
Xây dựng vòng lặp chạy
Kiểm tra thủ công không sống nổi qua một lần chạm mặt với cuốn lịch. Vòng lặp là một script chạy câu lệnh N lần, lưu mọi phản hồi thô cùng các trích dẫn của nó, rồi so sánh cửa sổ hiện tại với cửa sổ trước đó.
Việc này hợp với một tác nhân vì công việc lặp đi lặp lại, bị ràng buộc bởi quy tắc và cần một bản ghi bằng văn bản. Trong Claude Code hoặc Codex, chỉ dẫn hữu ích là để nguyên các lần chạy thô trên đĩa và không bao giờ ghi đè chúng, rồi báo cáo một bảng tóm tắt thay vì một con số duy nhất. Nếu bạn đã kéo dữ liệu Search Console và Bing qua các máy chủ MCP, cùng một phiên có thể giữ nhật ký trích dẫn bên cạnh dữ liệu hiển thị, và đó là nơi hai con số bắt đầu hữu ích khi đặt cạnh nhau. Ghi chú của chúng tôi về những gì các máy chủ đó phơi ra nằm ở bốn máy chủ SEO MCP thực sự làm gì, và mặt "hiện diện" của cùng vấn đề nằm ở ảnh chụp AI Overview bốn mươi truy vấn của chúng tôi.
Một quy tắc thiết kế quan trọng hơn những quy tắc còn lại: đầu ra của công cụ theo dõi phải là một phân phối. Hãy báo cáo "được trích dẫn trong 4 trên 6", không phải "được trích dẫn". Hãy báo cáo danh sách nguồn, không phải nguồn số một. Bất kỳ bảng điều khiển nào nén sáu lần chạy thành một con số đều đã vứt đi thông tin duy nhất mà những lần chạy thêm đã mua được.
Nếu mục tiêu là so sánh đối thủ chứ không phải giám sát, thì một vòng lặp theo dõi thứ hạng theo thời gian là công cụ phù hợp hơn, và những đánh đổi giữa các nguồn dữ liệu nằm ở xây dựng công cụ theo dõi thứ hạng từ hai nguồn.
Giới hạn của một mẫu sáu lần chạy
Ba lưu ý trung thực.
Mẫu nhỏ. Sáu lần chạy chỉ đóng khung độ phân tán một cách lỏng lẻo. Chúng xác lập rằng mức trùng lặp giữa các lần chạy là một phần và rằng những cặp không trùng lặp vẫn xảy ra; chúng không cho bạn khoảng tin cậy cho ngành của mình.
Kết quả gắn với thời điểm. Những lần chạy này được thực hiện vào ngày 12 tháng 9 năm 2026 trên các mô hình đang hoạt động. Cả mô hình lẫn kết quả tìm kiếm bên dưới chúng đều thay đổi.
Các tên miền được trích dẫn là mẫu từ một câu lệnh thương mại duy nhất. Một dạng câu hỏi khác, ví dụ câu hỏi so sánh hoặc câu hỏi cách làm, sẽ tạo ra một kiểu trích dẫn khác. Nước đi hữu ích là chạy đúng thiết kế đó trên mười câu lệnh quan trọng nhất về mặt thương mại của bạn và ghi lại xem ngành của bạn hành xử thế nào.
Câu hỏi thường gặp
Tôi cần bao nhiêu lần chạy trước khi con số khả năng hiển thị trên AI có ý nghĩa? Sáu là mức sàn thực tế cho một câu lệnh, và con số nên được báo cáo như một phép đếm trên số lần chạy chứ không phải như một vị trí. Nếu câu lệnh đó dẫn dắt các quyết định doanh thu, mười hai lần chạy cho một kết quả đọc sát hơn với chi phí vài đô la.
Điều đó có nghĩa là theo dõi khả năng hiển thị trên AI không đáng làm? Nó có nghĩa là theo dõi bằng một mẫu duy nhất thì không đáng. Chính phương sai là phát hiện. Một công cụ theo dõi báo cáo "được trích dẫn trong 4 trên 6 lần chạy, các nguồn đã thay đổi 12 tên miền kể từ tháng trước" đang mô tả một hệ thống thật mà một đối thủ đang tranh giành trong đó.
Vì sao một câu lệnh trả về không trích dẫn nào? Mô hình trả lời từ kiến thức của chính nó thay vì đi tìm nguồn. Đó là thuộc tính của câu hỏi, không phải thất bại của trang web bạn. Hãy theo dõi nó như "không áp dụng", không phải như số không.
Tôi có nên theo dõi ChatGPT, Claude và Gemini riêng biệt không? Có. Trong so sánh ba lần chạy của chúng tôi, hai mô hình chỉ trùng nhau ở bốn trong chín sản phẩm được kể tên. Việc lấy trung bình sẽ che mất một quyết định ở cấp chương trình về việc tối ưu trợ lý nào trước.
Có thể giảm phương sai bằng cách hạ nhiệt độ của mô hình không? Một phần, và đáng để thử trên câu lệnh của bạn. Nhưng tập hợp trích dẫn còn bị điều khiển bởi chỉ mục tìm kiếm, và thứ đó bạn không kiểm soát được. Số lần chạy là đòn bẩy đáng tin hơn.
Góc nhìn của Auspia: nếu quý này bạn xây dựng việc theo dõi khả năng hiển thị trên AI, hãy xây nhật ký chạy trước bảng điều khiển. Bảng điều khiển là một lựa chọn hiển thị. Nhật ký chạy mới là phép đo. Hãy bắt đầu với mười câu lệnh, mỗi câu sáu lần chạy, lưu nguyên văn, và trong một tuần bạn sẽ học được nhiều hơn những gì một năm kiểm tra bằng mẫu duy nhất có thể nói với bạn.
Tác giả: Ethan Marlowe, phụ trách đo lường GEO trên hơn 500 câu lệnh tại Auspia. Viết về theo dõi câu lệnh, báo cáo trích dẫn và những bảng điều khiển khả năng hiển thị trụ được qua một chu kỳ đo lường thực tế.