Quy tắc Google vừa viết ra
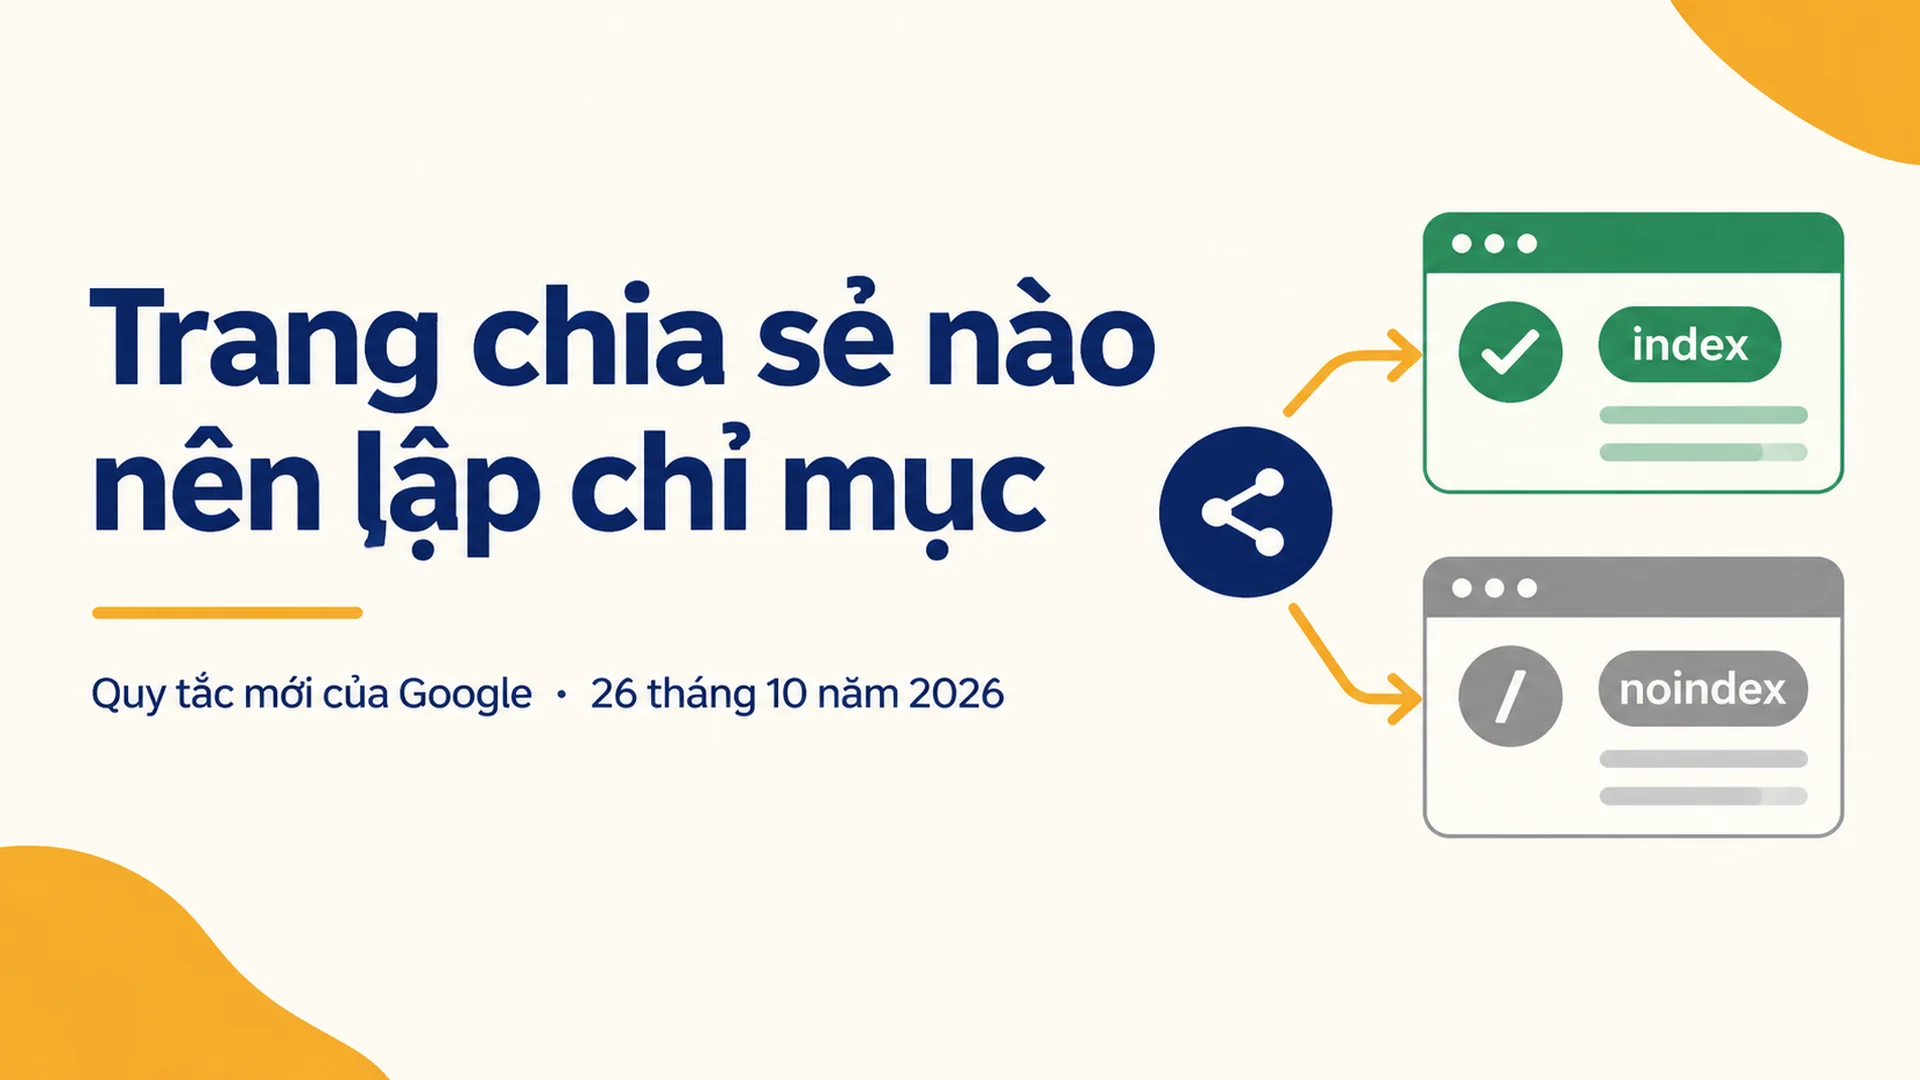
Ngày 26 tháng 10 năm 2026, Google thêm vào hướng dẫn về cách ngăn spam do người dùng tạo một mục dài hai đoạn. Đây là phần ngắn nhất của trang và có lẽ là phần sẽ thay đổi nhiều lộ trình sản phẩm nhất, vì nó đặt ra một câu hỏi mà hầu hết đội ngũ chưa từng đưa lên slide: URL này có nên nằm trong chỉ mục của Google hay không?
Mục này có tiêu đề "Only index content meant for Search" — chỉ lập chỉ mục nội dung được tạo ra cho Tìm kiếm. Dịch ra thì như sau:
Nếu dịch vụ của bạn cho phép người dùng tạo trang chia sẻ, kết quả được tạo tự động hoặc công cụ tương tác, hãy cân nhắc xem nội dung đó được tạo ra để công cụ tìm kiếm tìm thấy, hay chỉ để một người cụ thể mở trực tiếp từ liên kết.
Khi các trang được tạo ra để chia sẻ trực tiếp, cộng tác hoặc dùng cho mục đích thực tế chứ không phải để được khám phá trong tìm kiếm công khai, hãy áp dụng noindex theo mặc định (qua thẻ meta robots hoặc tiêu đề HTTP X-Robots-Tag) hoặc chặn thu thập dữ liệu trong robots.txt theo mặc định.
Nhật ký thay đổi của Google cùng ngày nói rõ ý định: hướng dẫn được cập nhật với "hướng dẫn về cách chặn lập chỉ mục nội dung được chia sẻ qua liên kết và cách theo dõi hành vi lạm dụng trong Search Console", để các nền tảng có thể "giữ những trang do người dùng tạo không dành cho Tìm kiếm ra khỏi chỉ mục và phát hiện spam sớm hơn".
Chỉ có thế. Không có thao tác thủ công mới, không có thông báo về hệ thống xếp hạng, không có danh sách hình phạt. Chỉ có một khuyến nghị về giá trị mặc định — và gần như mọi sự cố lập chỉ mục đều sinh ra từ giá trị mặc định.
Dành cho ai. Dành cho các đội phát hành bất kỳ URL nào người dùng có thể tạo: liên kết chia sẻ, cuộc trò chuyện đã lưu, bảng điều khiển công khai, bản xem trước mô hình, bản dựng ứng dụng, báo cáo được tạo, chủ đề diễn đàn, trang hồ sơ, trang đánh giá, trang tin đăng.
Bạn nhận được gì. Một phán quyết cho từng tuyến đường theo từng loại URL được tạo, cơ chế kiểm soát thực sự gỡ trang khỏi chỉ mục, và một quy tắc giám sát bắt được đúng mô hình lạm dụng mà Google mô tả.
Thời gian. Từ 45 đến 90 phút cho lượt đầu tiên ở một sản phẩm. Một ngày nếu bạn có nhiều trình tạo URL và không có bản kiểm kê tuyến đường.
"Xong" trông như thế nào. Mỗi tuyến đường được tạo đều được đánh dấu index, noindex hoặc riêng tư. Các tuyến noindex trả chỉ thị từ máy chủ, không phải sau khi JavaScript chạy. Search Console hiển thị các URL đó là bị loại trừ do noindex, chứ không phải "Đã lập chỉ mục nhưng bị chặn bởi robots.txt".
Điều gì đã thay đổi và điều gì chỉ trông như mới
Có bốn thay đổi đáng kể. Phần còn lại của trang không nhúc nhích, kể cả hướng dẫn tháng 12 năm 2025 vẫn còn hiệu lực.
Google đã thay đổi gì | Nội dung thực tế | Vì sao điều này quan trọng với bạn |
|---|---|---|
Phạm vi hướng dẫn | Giờ nêu các nền tảng lưu trữ và "các công cụ cho phép người dùng xuất bản trang chia sẻ, nội dung được tạo hoặc ứng dụng web" | Theo nghĩa đen, điều này bao trùm bản xuất trò chuyện AI, trang hiện vật, trình tạo ứng dụng và công cụ no-code, chứ không chỉ diễn đàn và bình luận |
Đơn vị lạm dụng | Kẻ spam có thể tạo "số lượng lớn trang hoặc trang web" | Google nói về quy mô, không phải sự tinh vi. Một tài khoản bị lạm dụng có thể tạo ra hàng nghìn URL |
Mục mới | "Only index content meant for Search" | Tuyên bố rõ nhất cho đến nay rằng noindex là giá trị mặc định hợp lý cho nội dung chỉ tiếp cận qua liên kết |
Giám sát | Xác minh trang web hoặc tên miền phụ trong Search Console, theo dõi các đợt tăng trên biểu đồ Lập chỉ mục trang và Hiệu suất tìm kiếm, cảnh báo khi "một vài người dùng" tạo ra "phần lớn URL có thể lập chỉ mục" | Sự phình to của chỉ mục giờ có phương pháp phát hiện được đặt tên — và thường chính điều này đi trước một dạng thực thi nào đó |
Điều không thay đổi: noindex cho bài đăng của người dùng mới cho đến khi họ có uy tín, và nofollow hoặc ugc trên liên kết trong nội dung không đáng tin. Nếu bạn đã làm cả hai, bạn đang đi trước bản cập nhật này.
Cần nói thẳng, vì phản ứng trên X đi trước tài liệu: đây là hướng dẫn dành cho nền tảng về kho URL của chính họ. Chúng không tạo ra vi phạm mới cho một trang marketing thông thường và không thay đổi thứ hạng của bất kỳ trang nào. Chúng thay đổi việc gì nên nằm trong chỉ mục.
Một mẩu bối cảnh giải thích thời điểm. Cuối tháng 7 năm 2026, liên kết chia sẻ và trang hiện vật của Claude bắt đầu xuất hiện trong chỉ mục Google, và các bài viết thời đó mô tả hồ sơ y tế, khóa API cùng những tài liệu riêng tư khác bị lộ công khai trước khi Anthropic bịt lỗ hổng trong vài ngày. Cũng những bài đó nhắc tới URL ứng dụng công khai trên các trình tạo như Replit và Lovable. Google hiếm khi viết một mục hướng dẫn mới chỉ vì giả thuyết. Chuyện này đã xảy ra rồi.
Câu hỏi quyết định mọi URL được tạo
Bài kiểm tra của Google gói gọn trong một câu, và có thể áp dụng mà không cần đoán ý định: nội dung này được tạo ra để công cụ tìm kiếm tìm thấy, hay chỉ để một người có liên kết mở nó?
Trên thực tế, bốn tín hiệu trả lời. Hãy đánh giá tuyến đường, không phải từng trang đơn lẻ.
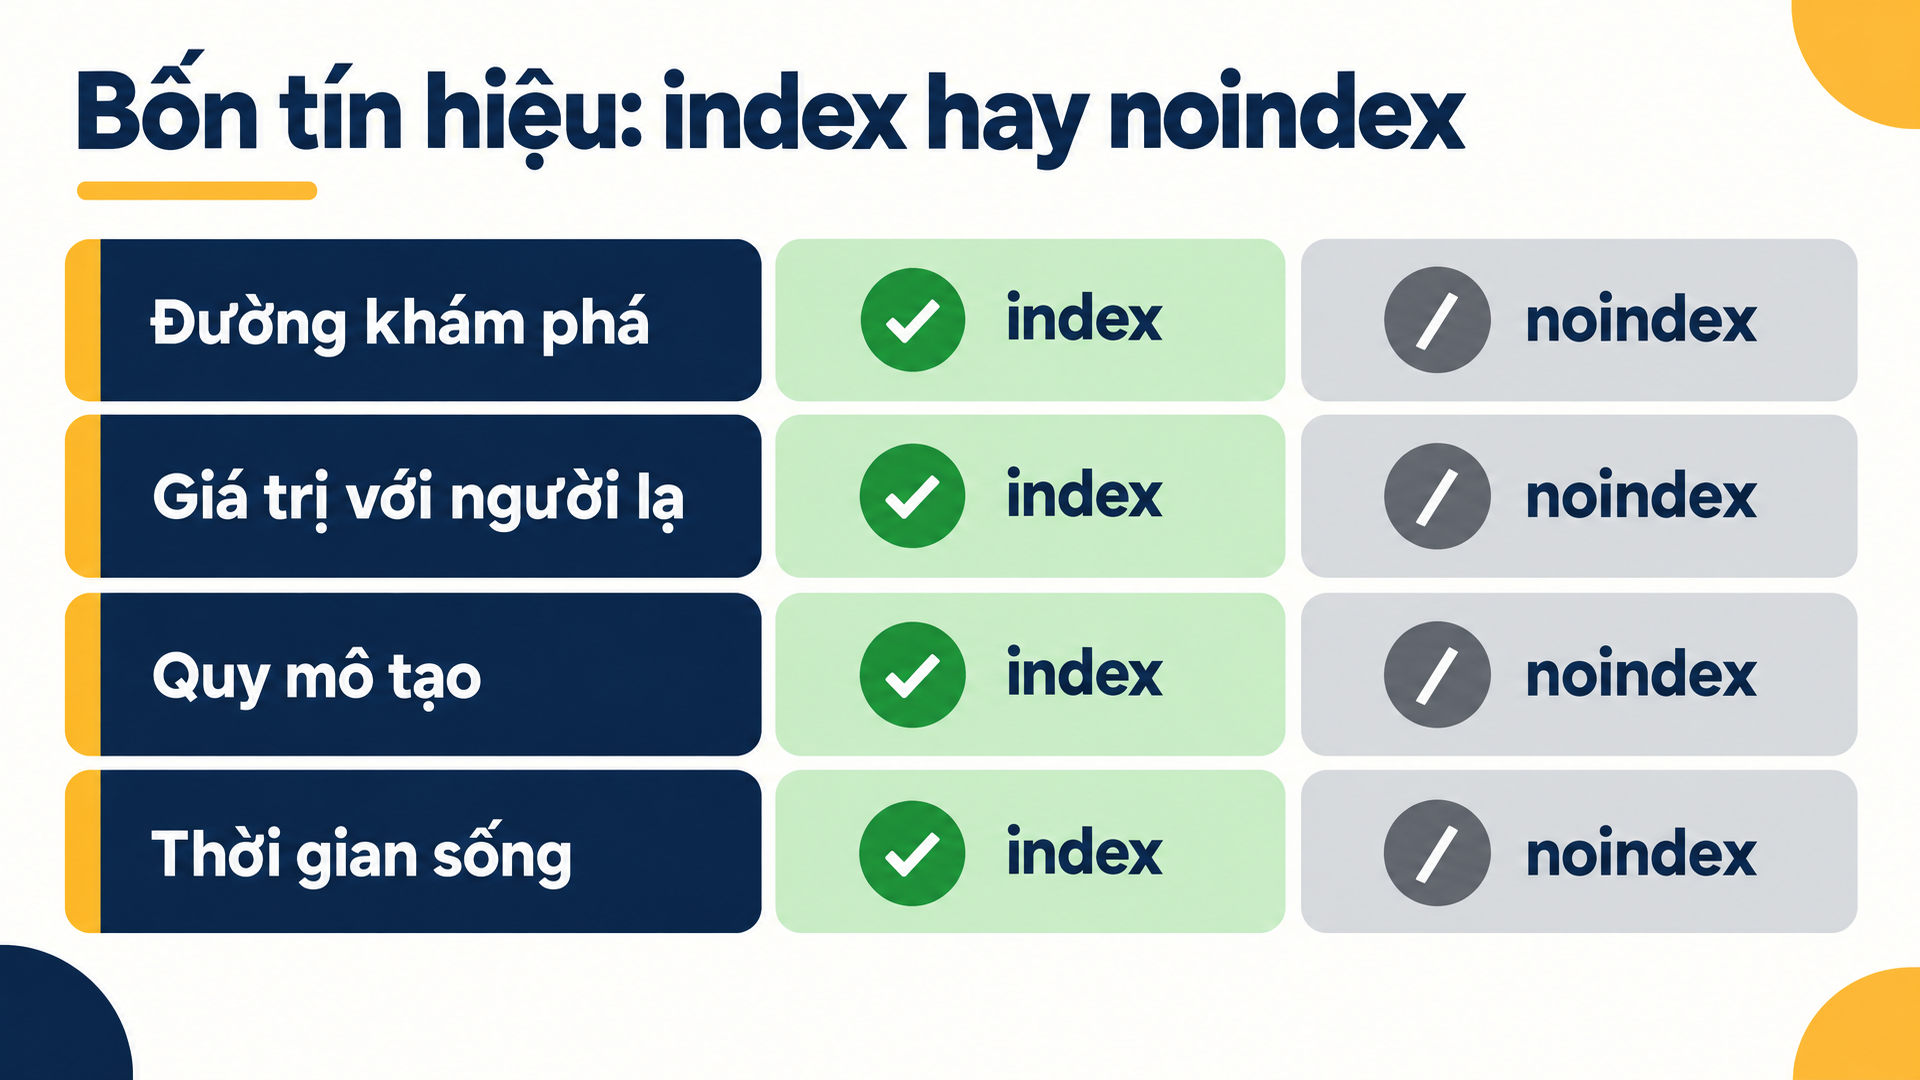
Tín hiệu | Nghiêng về index | Nghiêng về noindex |
|---|---|---|
Đường khám phá | Liên kết từ thư viện công khai, sitemap, trang danh mục hoặc hồ sơ | Chỉ tiếp cận qua liên kết đã sao chép hoặc nút "chia sẻ" |
Giá trị với người lạ | Hữu ích mà không cần biết tác giả | Chỉ có nghĩa với tác giả, đội của họ hoặc người nhận |
Quy mô tạo | Một trang mỗi chủ đề hoặc một bộ được tuyển chọn | Hàng nghìn URL từ một tài khoản, phần lớn gần như giống nhau |
Thời gian sống | Vẫn chính xác trong nhiều tháng | Chớp nhoáng: cuộc trò chuyện, bản dựng, bản nháp, bản xuất tạm |
Ba trên bốn nghiêng về noindex — phán quyết rõ ràng. Kết quả lẫn lộn thường có nghĩa tuyến đường cần được tách: một thư viện công khai đáng lập chỉ mục và các kết quả riêng lẻ bên dưới thì không. Cách tách này là câu trả lời đúng phổ biến nhất và cũng là bước bị bỏ qua nhiều nhất, vì nó cần hai mẫu thay vì một cờ.
Một bài kiểm tra từ chối hữu ích: nếu một người lạ thấy URL này trong kết quả tìm kiếm mà không có ngữ cảnh, tiêu đề và đoạn trích có nghĩa với họ không? "Trò chuyện với Sam, 24 thg 10" — không. "Mẫu hóa đơn cho nhà thiết kế tự do" — có. Việc từ chối không nói về chất lượng. Nó nói về việc trang được tạo ra để được tìm thấy hay để được gửi đi.
Chọn cơ chế kiểm soát thực sự gỡ URL
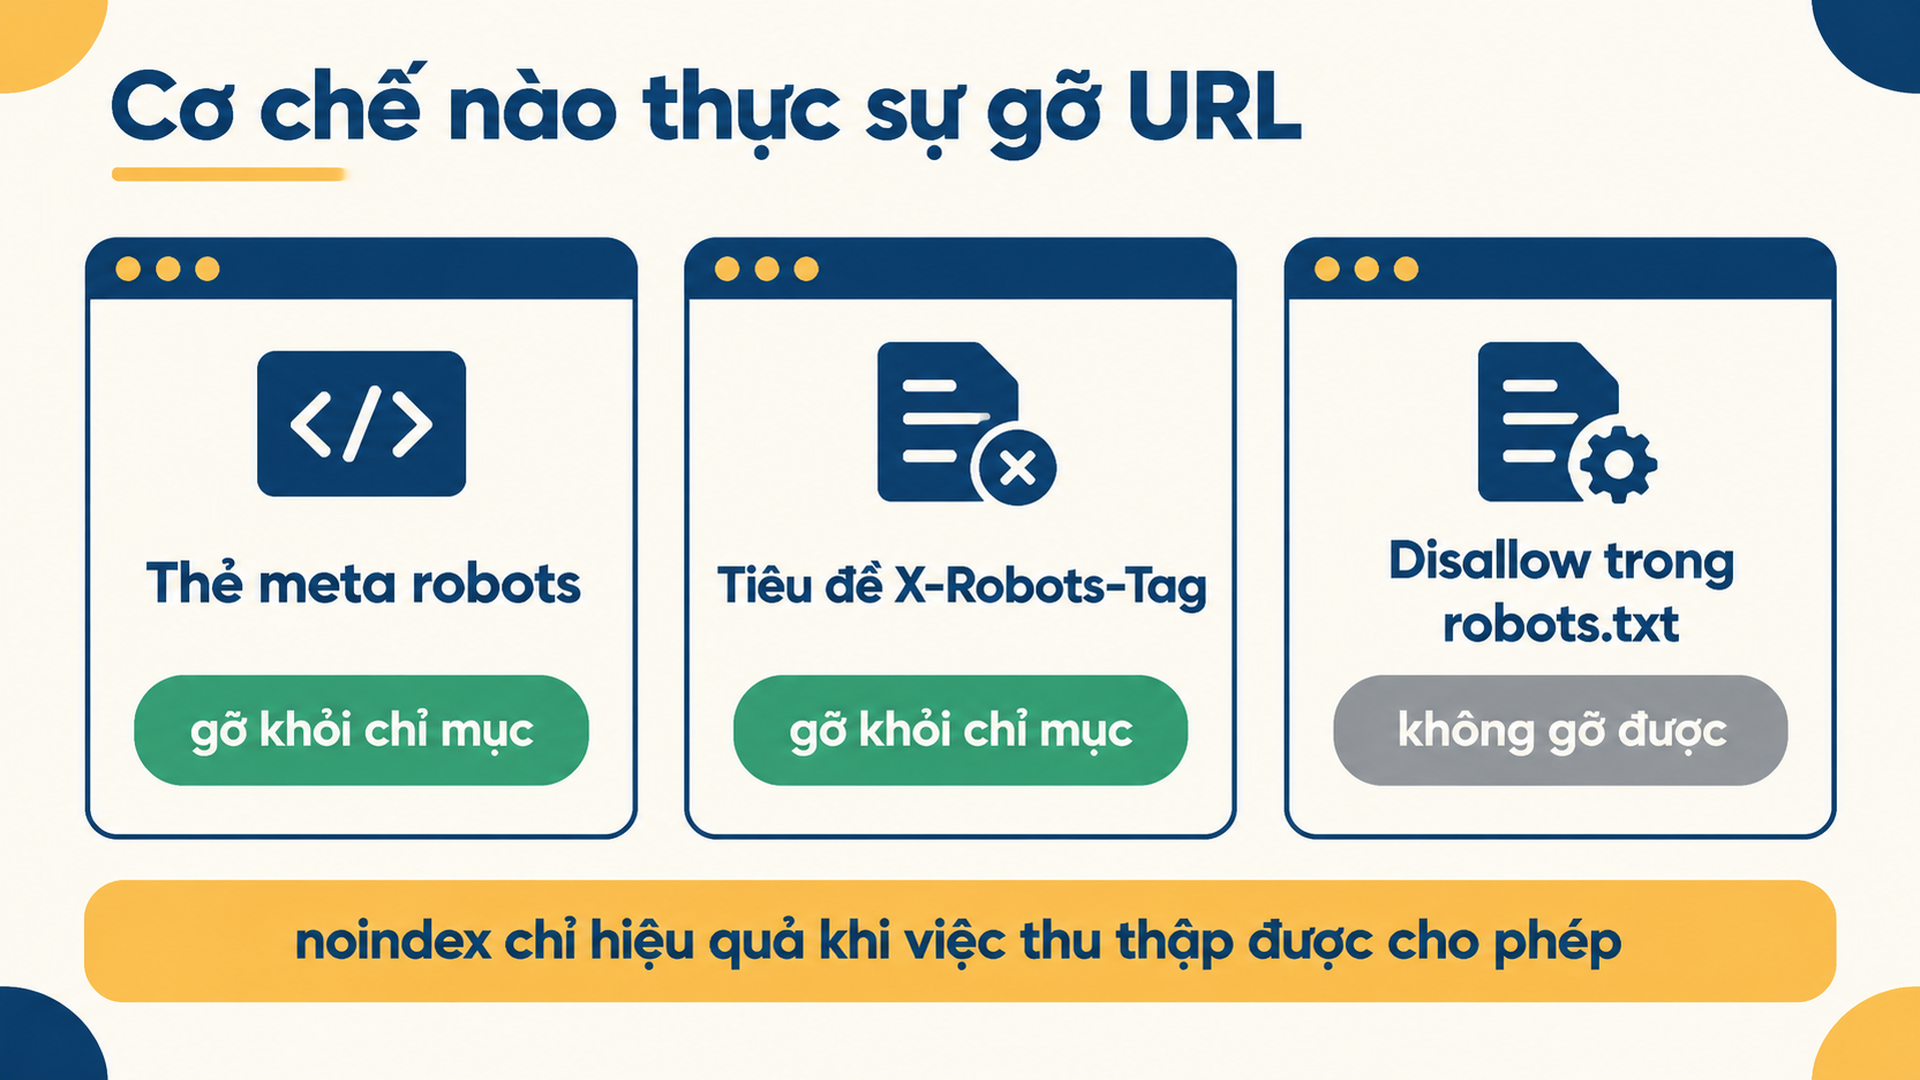
Đây chính là chỗ có thể nghe theo hướng dẫn mới một cách nguyên văn và vẫn thất bại. Google đưa ra hai lựa chọn trong cùng một câu, và chúng không tương đương.
robots.txt kiểm soát việc thu thập dữ liệu. Nó không gỡ URL khỏi chỉ mục, và Google tự nói vậy trong phần giới thiệu về robots.txt: một trang bị chặn ở đó "vẫn có thể được lập chỉ mục nếu các trang khác liên kết tới nó" — và khi đó URL, thậm chí cả văn bản liên kết, có thể xuất hiện trong kết quả mà không có mô tả.
noindex kiểm soát việc lập chỉ mục, nhưng chỉ khi Google thu thập được trang và đọc được chỉ thị. Tài liệu của Google về noindex rất rõ: để quy tắc hoạt động, trang không được bị chặn trong robots.txt, nếu không "trình thu thập sẽ không bao giờ thấy quy tắc noindex".
Ghép hai sự thật lại — và thứ tự bắt đầu có ý nghĩa.
Cơ chế | Gỡ URL khỏi chỉ mục | Thất bại ở đâu | Dùng cho |
|---|---|---|---|
Tiêu đề phản hồi | Có, sau khi Google thu thập và đọc | Bất cứ gì bị chặn trong robots.txt hoặc nằm sau đăng nhập | Phản hồi không phải HTML (PDF, JSON, hình ảnh) và quy tắc ở edge hoặc CDN cho nhiều tuyến đường |
| Có, sau khi Google thu thập và đọc | Thẻ do JavaScript chèn sau khi tải; trang bị chặn trong robots.txt | Trang chia sẻ HTML được render phía máy chủ |
Disallow trong | Không | URL có liên kết có thể nằm lại trong chỉ mục mà không có đoạn trích | Giảm tải thu thập dữ liệu, không phải để bảo mật |
Đăng nhập hoặc URL có chữ ký | Có, bằng cách chặn truy cập | Đòi hỏi trang thực sự riêng tư | Mọi thứ chứa dữ liệu của người khác |
410 sau khi hết hạn | Có, theo thời gian | Chậm hơn 404; không có tác dụng khi URL còn phản hồi | Bản chia sẻ và bản dựng tạm thời |
Một lối tắt nên tránh: X-Robots-Tag: none không phải giá trị trung tính. Google coi đó là noindex cộng nofollow. Đôi khi đúng là thứ bạn muốn, nhưng các đội thường sao chép nó từ cấu hình proxy mà không biết.
Lối tắt thứ hai nên tránh: thẻ canonical. Canonical là gợi ý. Nếu trang không nên có trong chỉ mục, hãy viết noindex.
Bước 1: Kiểm kê các tuyến đường tạo ra URL
Không thể phân loại thứ không có trong danh sách, và hầu hết đội đánh giá thấp con số vì họ nghĩ theo tính năng chứ không theo mẫu tuyến đường.
Mở router hoặc bản đồ URL và liệt kê mọi đoạn động. Những nghi phạm quen thuộc trông như sau:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Sau đó đối chiếu với những gì Google đã biết, vì mã nguồn và chỉ mục sẽ lệch nhau.
Từ sitemap. Tải xuống và đếm:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Lệnh thứ hai cho biểu đồ tần suất gần đúng theo tiền tố đường dẫn. Nếu một tuyến đường được tạo có mặt trong sitemap của bạn, đó đã là lỗi: sitemap là danh sách các trang bạn yêu cầu Google lập chỉ mục.
Từ Search Console. Mở báo cáo Lập chỉ mục trang, lọc theo tiền tố URL cho từng tuyến đường ứng viên và ghi lại các con số. Đây là nguồn duy nhất cho biết Google thực sự đã làm gì với những URL đó.
Từ log máy chủ. Nhóm yêu cầu của Googlebot theo tiền tố:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Kết quả mong đợi. Danh sách mẫu tuyến đường kèm số lượng URL, lấy từ ít nhất hai nguồn.
Kiểm tra chất lượng. Mọi tuyến đường có thể trả 200 cho người ngoài đội phải có trong danh sách. Nếu các con số từ sitemap và Search Console lệch nhau hơn vài phần trăm ở cùng một tiền tố, hãy tìm hiểu lý do trước khi thay đổi bất cứ điều gì.
Nếu không tìm thấy gì. Có thể bạn có router phía máy khách. Hãy tìm định nghĩa tuyến đường ở frontend chứ không phải backend, và xem tab mạng trên một liên kết chia sẻ thật.
Bước 2: Phân loại từng tuyến đường trong bảng, không phải trong cuộc họp
Ghi phán quyết ở nơi có người đọc. Mỗi mẫu tuyến đường một dòng là đủ.
Tuyến đường | Ai tạo | Đường khám phá | Giá trị với người lạ | Phán quyết | Cơ chế | Người phụ trách |
|---|---|---|---|---|---|---|
| Mọi người dùng | Chỉ liên kết | Không | noindex | Tiêu đề | Nền tảng |
| Tuyển chọn | Liên kết nội bộ, sitemap | Cao | index | Không | Nội dung |
| Mọi người dùng | Liên kết từ hồ sơ | Thấp khi chưa hoạt động | noindex cho đến khi có uy tín | Meta | Tin cậy và an toàn |
| Mọi người dùng | Chỉ liên kết | Không | noindex | Tiêu đề | Nền tảng |
| Biên tập viên | Sitemap | Cao | index | Không | Nội dung |
Bảng chỉ hiệu quả khi ba điều đúng.
Mỗi dòng một người chịu trách nhiệm. Quyền sở hữu mơ hồ là lý do các tuyến đường được tạo vẫn nằm trong chỉ mục suốt nhiều năm.
Ghi cơ chế cạnh phán quyết, không phải sau đó. "noindex" không phải quyết định cho đến khi ai đó biết đó là tiêu đề, thay đổi mẫu hay quy tắc CDN.
Ghi lại ngoại lệ. Nếu một tuyến đường cần noindex nhưng một tập con nhỏ nên công khai, hãy ghi điều kiện của tập con đó ngay bây giờ. Cắt bỏ nó sau nửa năm chính là con đường khiến quy tắc noindex cuối cùng bị gỡ toàn bộ, một cách lặng lẽ.
Bước 3: Triển khai cơ chế ở cấp mẫu
Các bản sửa từng trang không sống sót qua lần triển khai tiếp theo. Hãy áp dụng cơ chế ở nơi tuyến đường được render.
Với trang HTML, đặt thẻ trong head được render phía máy chủ. Trong Next.js App Router đó là metadata; trong Astro là head của layout; trong Rails hay Django là mẫu layout. Cú pháp chính xác ít quan trọng hơn vị trí: nó phải nằm trong HTML mà Google nhận được, không phải được thêm bởi hiệu ứng phía máy khách.
<meta name="robots" content="noindex">Với mọi thứ không phải HTML, không có thẻ meta, nên dùng tiêu đề:
X-Robots-Tag: noindexĐiều này bao gồm bản xuất PDF, phản hồi JSON, hình ảnh được tạo và tệp CSV tải về. Nếu các tệp này được phục vụ từ CDN, đặt tiêu đề ở edge để các tuyến mới thừa hưởng quy tắc.
Với cả một họ tuyến đường, quy tắc middleware thường sạch hơn là chạm vào từng mẫu:
// Ví dụ Express: noindex cho mọi URL chia sẻ được tạo
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Kết quả mong đợi. Một lần triển khai trong đó mọi tuyến đường được đánh dấu noindex đều trả chỉ thị ngay trong byte đầu tiên cho yêu cầu ẩn danh.
Kiểm tra chất lượng. Chạy curl -sI trên một URL đã xuất bản. Bạn phải thấy x-robots-tag: noindex trong tiêu đề phản hồi, và curl -s phải cho thấy thẻ meta trong mã nguồn trước khi bất kỳ script nào chạy.
Đường phục hồi. Nếu thẻ chỉ xuất hiện sau khi JavaScript chạy, hãy chuyển nó sang render phía máy chủ. Nếu framework không render thẻ head cho mọi tuyến đường, dùng tiêu đề. Đừng xuất bản noindex do JS chèn và đừng cho rằng nó hoạt động: Google mô tả hành vi của noindex được render là không xác định.
Có hai thứ nữa thuộc cùng pull request. Gỡ các tuyến noindex khỏi sitemap, vì gửi đi một URL bạn không muốn lập chỉ mục là mâu thuẫn mà Google sẽ giải quyết theo hướng có lợi cho họ. Và thêm quy tắc hết hạn: khi một liên kết chia sẻ chết, trả 410 thay vì giữ trang ở 200 với trạng thái rỗng.
Bước 4: Kiểm tra xem Googlebot có thấy chỉ thị không
Không điều gì ở trên được xác minh cho đến khi bạn kiểm tra theo cách Google kiểm tra.
Trước tiên xem tiêu đề phản hồi:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagSau đó mã nguồn HTML, trước khi bất kỳ script nào chạy:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Cuối cùng chắc chắn rằng robots.txt không chặn đường dẫn. Nếu có, Google sẽ không bao giờ thu thập trang và không bao giờ đọc chỉ thị:
curl -s https://example.com/robots.txtSearch Console là bài kiểm tra cuối cùng. Yêu cầu kiểm tra URL trong công cụ Kiểm tra URL và đọc phán quyết.
Kết quả đúng là "URL không được lập chỉ mục: bị loại trừ bởi thẻ 'noindex'". Kết quả cho thấy bạn đã sập bẫy là "Đã lập chỉ mục nhưng bị chặn bởi robots.txt": Google có URL, không đọc được chỉ thị và có thể vẫn hiển thị nó. Nếu thấy điều này, hãy gỡ quy tắc khỏi robots.txt và để noindex làm việc.
Bạn cũng có thể lấy trang theo cách Googlebot nhìn thấy bằng trình mô phỏng trình thu thập. Cách này nhanh hơn chờ lần thu thập mới khi bạn kiểm tra hai mươi tuyến đường: Googlebot Spider Simulator.
Kết quả mong đợi. Mỗi tuyến noindex hiển thị trạng thái bị loại trừ do noindex trong vài ngày sau lần thu thập tiếp theo. Các tuyến được tạo sau thay đổi không nên xuất hiện trong chỉ mục chút nào.
Đường phục hồi. Nếu URL vẫn được lập chỉ mục sau hai tuần, hãy kiểm tra xem Google có thu thập được nó không, trang có trả 200 cho Googlebot không, và liệu thẻ canonical hay hreflang nào đó có đang đẩy công cụ tìm kiếm đi nơi khác. Chỉ dùng công cụ Gỡ bỏ như biện pháp chặn tạm trong lúc sửa nguyên nhân; nó không thay thế chỉ thị.
Khi trang chia sẻ chính là kênh tăng trưởng
Một số trang được tạo thực sự nên được lập chỉ mục, và noindex tất cả là tự bắn vào chân mình. Đây là những trường hợp nên bảo vệ:
Mẫu | Vì sao đáng lập chỉ mục | Chốt an toàn |
|---|---|---|
Thư viện mẫu công khai | Người dùng đăng thiết kế, người khác dùng lại; kết quả độc nhất và bền | Kiểm duyệt các bài gửi mới |
Trình tạo có trang trưng bày công khai | Kết quả thật kèm nhãn "built with" là kênh phân phối | Giữ mẫu trưng bày tách khỏi trang marketing |
Tài liệu mọc ra từ chủ đề người dùng | Câu hỏi lặp lại xứng đáng có câu trả lời thường trực, đã biên tập | Lập chỉ mục câu trả lời được tuyển chọn, không phải cuộc trò chuyện thô |
Nếu bạn thuộc một trong các nhóm này, hướng dẫn cũ của Google vẫn còn hiệu lực và là đòn bẩy tốt nhất: noindex trên nội dung người dùng chưa có uy tín, rồi mở khi tài khoản đã có lịch sử. Cách này chống spam bền mà không từ bỏ vòng tương tác, và chính là mẫu mà hướng dẫn khuyến nghị trước bản cập nhật này.
Bài kiểm tra cho cả ba thì giống nhau. Nếu trang nhận hiển thị trong Hiệu suất tìm kiếm cho những truy vấn mà người lạ sẽ gõ, nó thuộc về chỉ mục. Nếu hiển thị chỉ đến từ chuỗi URL của chính nó và không từ đâu khác, nó không thuộc.
Còn một hiệu ứng bậc hai đáng gọi tên. URL chia sẻ công khai từ lâu là bề mặt đặt liên kết giá rẻ: tạo một trang trên nền tảng có tên miền mạnh, trỏ liên kết về site của bạn, lặp lại trên hai mươi tài sản. Patrick Stox đếm được hơn 20 liên kết từ các nền tảng khác nhau trong cùng một chủ đề. Nếu các nền tảng tuân theo hướng dẫn, bề mặt đó sẽ hẹp lại. Nếu không, Google giờ có một tài liệu để dẫn ra vào lần tới khi họ quyết định những trang đó là spam.
Bước 5: Đo mô hình mà Google mô tả
Phần giám sát là mảnh mà hầu hết đội sẽ bỏ qua, và cũng chính là mảnh bắt được sự cố thật trước khi nó thành thao tác thủ công.
Bốn kiểm tra, mỗi cái kèm nơi cần nhìn.
Tài sản trong Search Console. Xác minh trang web hoặc tên miền phụ để cảnh báo về thao tác thủ công và bảo mật đến qua email. Nếu bạn vận hành nền tảng có tên miền phụ cho từng khách thuê, hãy xác minh tên miền cha và ít nhất một mẫu tên miền con; cảnh báo không đến đâu không phải là giám sát.
Xu hướng lập chỉ mục trang. Ghi lại mốc cơ sở số URL được lập chỉ mục cho từng tuyến đường được tạo hôm nay và theo dõi các bước nhảy, không phải nhiễu. Số URL được lập chỉ mục tăng gấp đôi trong một tuần trên tuyến lẽ ra phải tĩnh là một tín hiệu.
Bất thường trong Hiệu suất tìm kiếm. Lọc theo truy vấn không liên quan đến sản phẩm. Trang spam thu hút truy vấn spam rất lâu trước khi ai đó phàn nàn.
Tỷ lệ tạo so với lập chỉ mục. Đây là chỉ số Google gọi tên mà gần như không ai đo: một tài khoản tạo được bao nhiêu URL có thể lập chỉ mục mỗi ngày và bao nhiêu phần trăm URL mới kiểu đó đến từ 1% tài khoản sung mãn nhất. Ngưỡng cảnh báo ở mức 3 lần trung vị bảy ngày gần nhất cho mỗi tài khoản là tùy ý nhưng hiệu quả; hãy chỉnh theo lưu lượng của bạn.
Cùng tỷ lệ đó cũng dùng được làm rào chắn sản phẩm. Nếu một tính năng cho phép người dùng tạo một nghìn URL có thể lập chỉ mục mỗi ngày, thì đó là tính năng làm phình chỉ mục, kể cả khi chưa ai lạm dụng.
Bản cập nhật thực sự đang nói điều gì
Bỏ lớp từ ngữ đi — và Google đang tranh luận về một đề xuất.
Hai mươi năm chính sách spam mô tả các trang: mỏng, sao chép, ngụy trang, nhồi từ khóa. Những hạng mục đó giả định có một con người hoặc một script quyết định tạo trang, và Google quyết định xem trang có xứng đáng được xếp hạng không. Kết quả được tạo phá vỡ mô hình đó. Một quyết định sản phẩm có thể tạo ra một triệu URL, tất cả đều độc nhất về kỹ thuật, tất cả đều trả 200 về kỹ thuật, phần lớn vô giá trị với những người không tạo ra chúng. Google không thể đánh giá từng cái và đã thôi giả vờ là có thể.
Phản ứng chia thành hai phe. Phe đầu đọc đây là phát súng cảnh cáo: Marie Haynes hỏi liệu có thao tác thủ công mới cho công cụ AI và trình tạo ứng dụng không, còn Lily Ray coi mục này là dấu hiệu về những gì Google đang chống trả ở quy mô lớn, nêu tên hiện vật Claude, trang chia sẻ ChatGPT và bài đăng mạng xã hội. Phe thứ hai nhún vai. Các đội cẩn thận đã đặt noindex cho báo cáo do người dùng tạo từ nhiều năm, vài câu trả lời lập luận, và trang do chính Google tạo ra là vấn đề lớn hơn. Cả hai cách đọc đều có thể đúng. Điều khiến hướng dẫn có trọng lượng không phải là lời khuyên mới, mà là nó giờ được ghi ở nơi có thể dẫn ra khi thực thi chính sách.
Vì thế hướng dẫn đẩy quyết định lên cao hơn trong chuỗi. Các nền tảng được kỳ vọng đưa ra quyết định ở cấp mẫu: hạng URL nào thuộc về chỉ mục. Đó là câu hỏi quản trị, không phải SEO, và đó là lý do lời khuyên nằm trong hướng dẫn về spam chứ không phải tài liệu về lập chỉ mục.
Với tìm kiếm AI, cùng logic chạy theo cả hai hướng. Các tính năng AI của Google lấy từ chỉ mục Google, nên chỉ thị noindex gỡ trang khỏi cả kho lẫn liên kết xanh. Nếu một trang được tạo đang nhận trích dẫn trong AI Overviews, hãy chuẩn bị tinh thần là điều đó dừng lại. Với liên kết chia sẻ, thường là đúng; với trang mẫu, là sai. Các trình thu thập AI khác có quy tắc riêng, nên hãy quyết định riêng xem cho phép cái nào thu thập những trang này.
Kết luận thực tế là một câu có thể mang tới buổi đánh giá thiết kế: mọi URL người dùng có thể tạo hoặc là bề mặt sản phẩm, hoặc là một nghĩa vụ với chỉ mục, và mẫu quyết định đó là cái nào.
Câu hỏi thường gặp
Điều này có áp dụng cho một trang marketing thông thường không?
Không, nếu trang của bạn không tạo URL từ dữ liệu người dùng nhập. Trang marketing xuất bản một tập trang mà một con người đã quyết định là nên tồn tại — ngược lại với vấn đề mà hướng dẫn mô tả. Dòng về quy mô nêu các nền tảng lưu trữ và công cụ cho phép người dùng xuất bản trang chia sẻ, nội dung được tạo hoặc ứng dụng web. Nếu bạn có bình luận, diễn đàn hoặc hồ sơ thành viên, hướng dẫn cũ áp dụng: nofollow hoặc ugc trên liên kết từ tài khoản không đáng tin, và noindex cho người dùng mới cho đến khi họ xây dựng uy tín.
Dùng robots.txt hay thẻ meta noindex?
noindex, và chỉ một trong hai cho mỗi tuyến đường. Câu của Google liệt kê cả hai lựa chọn, nhưng chúng làm những việc khác nhau. Disallow trong robots.txt chặn thu thập dữ liệu, và một URL bị chặn nhưng có liên kết từ bên ngoài có thể nằm lại trong kết quả mà không có đoạn trích. noindex chỉ hoạt động khi Google thu thập được trang và đọc được nó. Trên thực tế, điều đó có nghĩa là thẻ meta hoặc tiêu đề phản hồi, và không bao giờ là quy tắc robots.txt trên cùng đường dẫn đó.
Tôi có mất lưu lượng nếu đặt noindex cho trang chia sẻ không?
Hãy kiểm tra tuyến đường trước khi quyết định, không phải sau. Nếu trang chỉ nhận hiển thị từ chuỗi URL của chính nó, nó không mang lưu lượng tìm kiếm tự nhiên và gỡ nó không mất gì. Mẫu gây mất lưu lượng là xóa luôn cả thư viện công khai cùng với mọi thứ bên trong. Để thư viện được lập chỉ mục, đặt noindex cho phần bên dưới, và theo dõi hiệu suất tìm kiếm cho truy vấn về thư viện trước và sau.
Công cụ tìm kiếm AI có tôn trọng noindex không?
Các tính năng AI của Google thì có, vì AI Overviews và AI Mode lấy từ cùng chỉ mục, nên chỉ thị gỡ trang khỏi cả liên kết xanh lẫn câu trả lời AI. Các trình thu thập AI khác là quyết định riêng. Hành vi của nhà cung cấp khác nhau và thay đổi không kèm nhật ký thay đổi, nên hãy đọc tài liệu của từng trình thu thập và lấy trang bằng user agent của nó, thay vì cho rằng một chỉ thị bao trùm tất cả.
Tác giả: Grace Miller, chuyên viên phân tích rủi ro AI Search tại Auspia. Theo dõi hơn 200 thay đổi chính sách. Viết về quy tắc nền tảng, rủi ro nội dung và tối ưu hóa có tính đến chính sách.