Google'ın yeni yazıya döktüğü kural
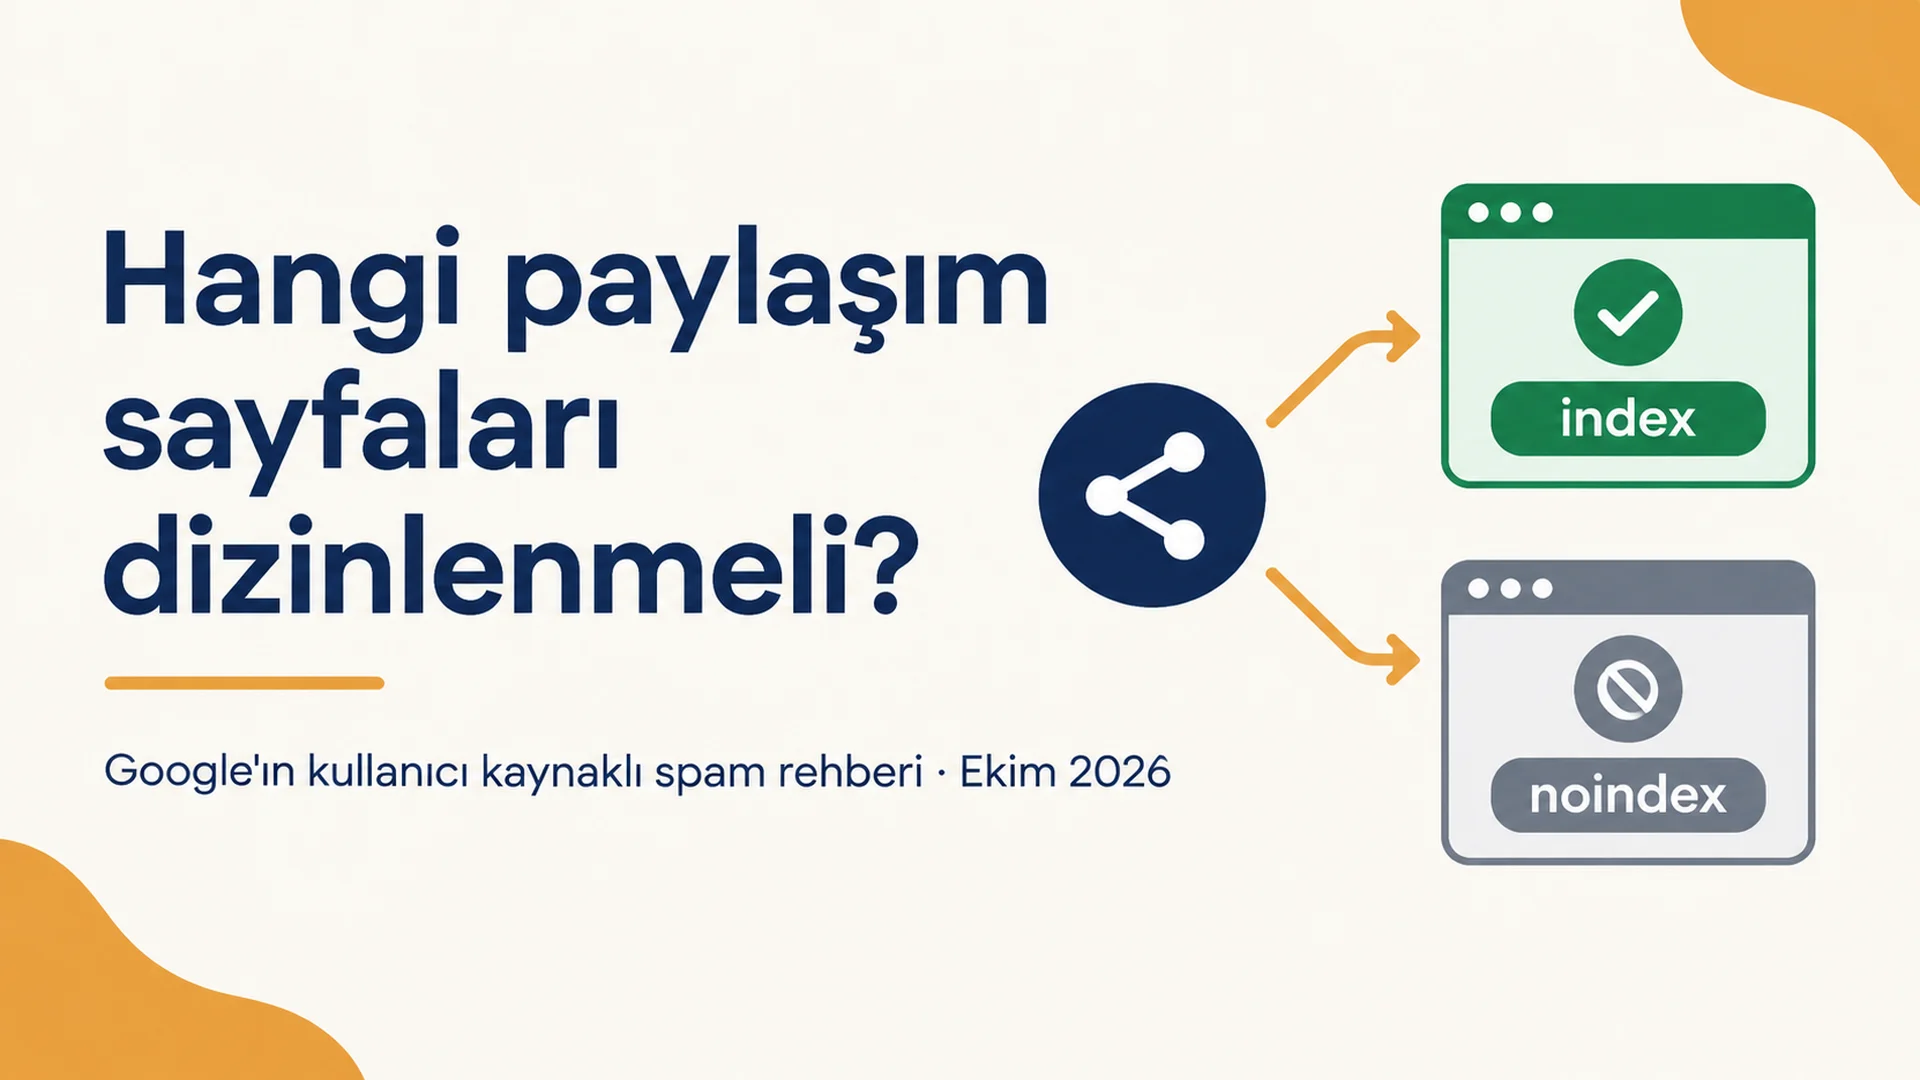
26 Ekim 2026'da Google, kullanıcı kaynaklı spamdan nasıl kaçınılacağına dair rehberine iki paragraflık bir bölüm ekledi. Sayfanın en kısa kısmı ve muhtemelen en çok ürün yol haritasını değiştirecek olanı, çünkü çoğu ekibin hiçbir sunuma koymadığı bir soruyu soruyor: bu URL Google dizininde olmalı mı?
Bölümün başlığı "Only index content meant for Search" — yalnızca Arama için üretilmiş içeriği dizine ekle. Çevirdiğimizde şunu söylüyor:
Hizmetiniz kullanıcıların paylaşılabilir sayfalar, üretilmiş çıktılar veya etkileşimli araçlar oluşturmasına izin veriyorsa, bu içeriğin arama motorları tarafından bulunmak için mi, yoksa yalnızca bağlantıya sahip kişi tarafından doğrudan açılmak için mi üretildiğini düşünün.
Sayfalar doğrudan paylaşım, iş birliği veya kullanışlılık amacıyla oluşturuluyorsa ve kamusal aramada keşfedilmek için değilse, noindex kuralını varsayılan olarak uygulayın (bir robots meta etiketi veya X-Robots-Tag HTTP başlığıyla) ya da robots.txt içinde taramayı varsayılan olarak engelleyin.
Aynı günkü Google değişiklik günlüğü niyeti daha net anlatıyor: rehber, platformların "Arama için tasarlanmamış kullanıcı üretimi sayfaları dizin dışında tutabilmesi ve spamı daha erken tespit edebilmesi" için "bağlantıyla paylaşılan içeriğin dizinlenmesinin nasıl engelleneceği ve Search Console'da kötüye kullanımın nasıl izleneceğine dair yönergelerle" güncellendi.
Hepsi bu. Yeni bir manuel işlem yok, sıralama sistemi duyurusu yok, ceza listesi yok. Olan şey bir varsayılan değer önerisi — ve dizin kazalarının neredeyse tamamı varsayılan değerlerden çıkar.
Kimler için. Kullanıcının üretebileceği her türlü URL'yi yayına alan ekipler için: paylaşım bağlantıları, kaydedilmiş sohbetler, herkese açık panolar, model önizlemeleri, uygulama derlemeleri, üretilmiş raporlar, forum başlıkları, profil sayfaları, inceleme sayfaları, ilan sayfaları.
Elinizde ne kalır. Üretilen her URL türü için rota başına bir karar, sayfayı gerçekten dizinden çıkaran kontrol ve Google'ın tarif ettiği kötüye kullanım desenini yakalayan bir izleme kuralı.
Süre. Bir üründe ilk tur için 45 ile 90 dakika. Birden fazla URL üreticiniz varsa ve rota envanteriniz yoksa bir gün.
"Bitti" neye benzer. Üretilen her rota index, noindex veya özel olarak işaretlenmiş. noindex rotaları direktifi sunucudan döndürüyor, JavaScript çalıştıktan sonra değil. Search Console bu URL'leri "Dizinlenmiş, ancak robots.txt tarafından engellenmiş" olarak değil, noindex nedeniyle hariç tutulmuş olarak gösteriyor.
Neyin değiştiği ve neyin yalnızca yeni göründüğü
Önemli olan dört değişiklik var. Sayfanın geri kalanı yerinden oynamadı, Aralık 2025 yönergeleri de dahil; onlar hâlâ geçerli.
Google neyi değiştirdi | Gerçek metin | Sizin için neden önemli |
|---|---|---|
Rehberin kapsamı | Artık barındırma platformlarını "ve kullanıcıların paylaşılan sayfalar, üretilmiş içerik veya web uygulamaları yayımlamasına izin veren araçları" adlandırıyor | Harfiyen okunduğunda bu, yalnızca forumları ve yorumları değil, yapay zekâ sohbet dışa aktarımlarını, yapıt sayfalarını, uygulama oluşturucuları ve kod yazmadan araçları da kapsıyor |
Kötüye kullanımın birimi | Spam yapanlar "çok sayıda sayfa veya site" oluşturabiliyor | Google zekâdan değil hacimden bahsediyor. Tek bir kötüye kullanım hesabı binlerce URL basabilir |
Yeni bölüm | "Only index content meant for Search" | noindex'in yalnızca bağlantıyla erişilebilen içerik için makul bir varsayılan olduğuna dair bugüne kadarki en net ifade |
İzleme | Sitenin veya alt alan adının Search Console'da doğrulanması, Sayfa dizine ekleme ve Arama performansı'ndaki sıçramaların izlenmesi, "az sayıda kullanıcı" "dizinlenebilir URL'lerin büyük bölümünü" ürettiğinde uyarı verilmesi | Dizin şişmesi artık adlandırılmış bir tespit yöntemine sahip — ve genelde bir inceleme biçiminden önce gelen şey budur |
Değişmeyenler: yeni kullanıcıların gönderilerinde itibar kazanana kadar noindex, güvenilmez içerikteki bağlantılarda nofollow veya ugc. İkisini de yapıyorsanız bu güncellemenin önündesiniz.
Açıkça söylemek gerek, çünkü X'teki tepki belgeden önce koştu: bunlar platformlara kendi URL stokları hakkında verilen yönergeler. Sıradan bir pazarlama sitesi için yeni bir ihlal yaratmıyor ve hiçbir sayfanın sıralamasını değiştirmiyor. Dizinde ne olması gerektiğini değiştiriyor.
Zamanlamayı açıklayan bir başka bağlam parçası var. Temmuz 2026'nın sonunda Claude'un paylaşım bağlantıları ve yapıt sayfaları Google dizininde göründü ve o dönemdeki haberler, Anthropic açığı birkaç gün içinde kapatmadan önce açıkta kalan tıbbi kayıtları, API anahtarlarını ve başka özel materyalleri anlatıyordu. Aynı haberler Replit ve Lovable gibi oluşturucularda herkese açık uygulama URL'lerine de işaret etti. Google bir hipotez için nadiren yeni bir bölüm yazar. Bu olay zaten yaşanmıştı.
Her üretilmiş URL'yi belirleyen soru
Google'ın testi tek cümleye sığıyor ve niyet tahmin etmeden uygulanabiliyor: bu içerik arama motorları tarafından bulunmak için mi yapıldı, yoksa yalnızca bağlantıya sahip kişinin açması için mi?
Pratikte dört sinyal yanıt veriyor. Tek tek sayfayı değil, rotayı değerlendirin.
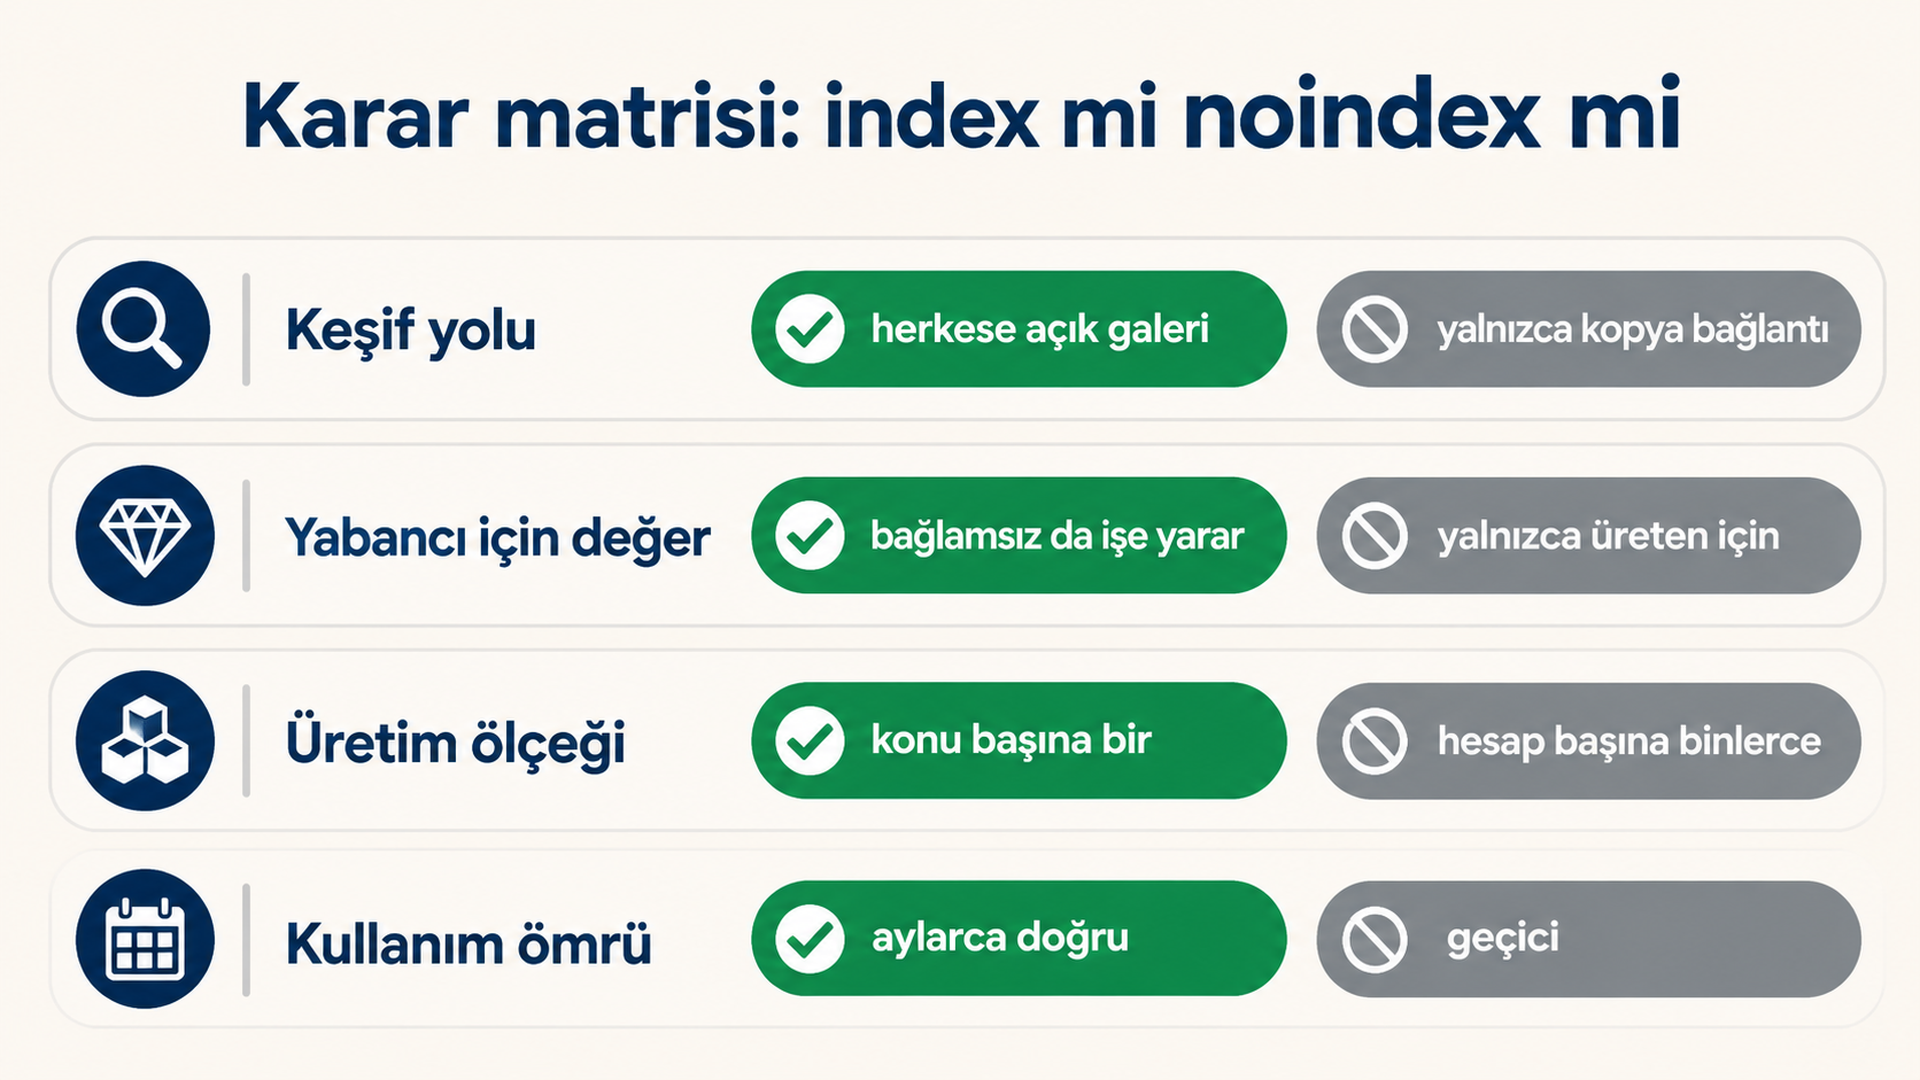
Sinyal | index yönünde | noindex yönünde |
|---|---|---|
Keşif yolu | Herkese açık galeri, site haritası, kategori sayfası veya profilden bağlantılı | Yalnızca kopyalanmış bir bağlantıdan veya paylaş düğmesinden ulaşılabilir |
Yabancı için değer | Oluşturanı tanımadan da işe yarıyor | Yalnızca oluşturan, ekibi veya alıcı için anlamlı |
Üretim ölçeği | Konu başına bir sayfa ya da küratörlü bir küme | Tek hesaptan binlerce URL, çoğu neredeyse kopya |
Kullanım ömrü | Aylarca doğru kalıyor | Geçici: bir sohbet, bir derleme, bir taslak, bir geçici dışa aktarım |
Dördün üçü noindex diyorsa karar nettir. Karışık sonuç genellikle rotanın bölünmesi gerektiği anlamına gelir: dizinlenebilir tek bir kamusal galeri ve altında dizinlenmeyecek tekil çıktılar. Bu bölünme en sık rastlanan doğru yanıt ve aynı zamanda en sık atlanan yanıt, çünkü tek bir bayrak yerine iki şablon gerektiriyor.
İşe yarar bir ret testi: bir yabancı bu URL'yi bağlamsız bir arama sonucunda görse başlık ve açıklama anlamlı olur muydu? "Sam ile sohbet, 24 Eki" olmaz. "Serbest çalışan tasarımcılar için fatura şablonu" olur. Ret, kaliteyle ilgili değil. Sayfanın bulunmak için mi yoksa gönderilmek için mi yapıldığıyla ilgili.
URL'yi gerçekten kaldıran bir kontrol seçin
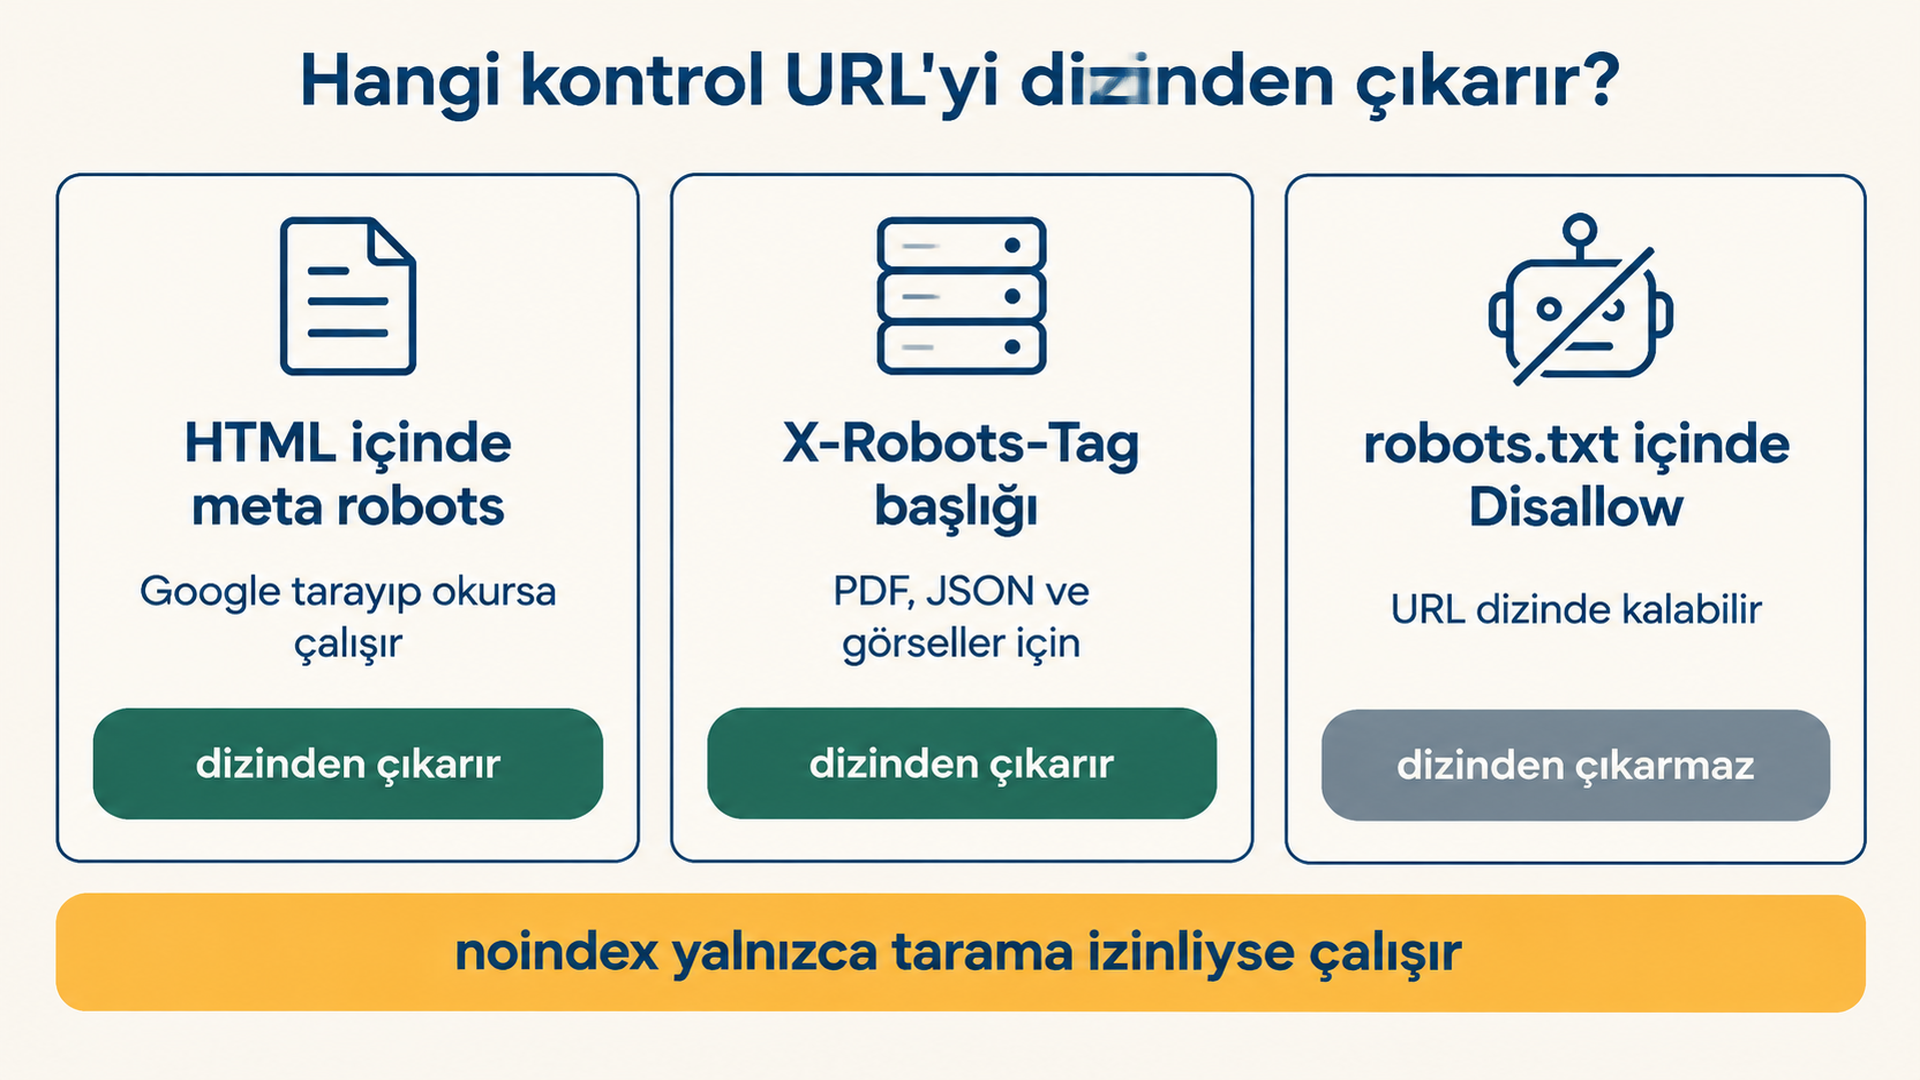
Burada yeni yönergeyi harfiyen uygulayıp yine de başarısız olmak mümkün. Google aynı cümlede iki seçenek sunuyor ve ikisi eşdeğer değil.
robots.txt taramayı denetler. Bir URL'yi dizinden çıkarmaz ve Google bunu robots.txt girişinde kendisi söylüyor: orada engellenen bir sayfa "başka sitelerden gelen bağlantılar varsa yine de dizinlenmiş kalabilir" — ve bu durumda URL ile muhtemelen bağlantı metni, açıklama olmadan sonuçlarda görünebilir.
noindex dizinlemeyi denetler, ama yalnızca Google sayfayı tarayıp direktifi okuyabiliyorsa. Google'ın noindex belgeleri net: kuralın işlemesi için sayfa robots.txt tarafından engellenmemiş olmalı, çünkü engellenirse "tarayıcı noindex kuralını asla görmez".
İki gerçeği birleştirin, sıralama önemli hale gelir.
Kontrol | URL'yi dizinden çıkarır | Nerede başarısız olur | Ne için kullanılır |
|---|---|---|---|
| Evet, Google tarayıp okuduktan sonra | robots.txt tarafından engellenen veya oturum açmanın arkasındaki her şey | HTML dışı yanıtlar (PDF, JSON, görseller) ve çok sayıda rota için edge veya CDN kuralları |
HTML head içindeki | Evet, Google tarayıp okuduktan sonra | Yükleme sonrası JavaScript ile eklenen etiketler; robots.txt tarafından engellenen sayfalar | Sunucuda oluşturulan HTML paylaşım sayfaları |
| Hayır | Bağlantılı bir URL açıklamasız dizinlenmiş kalabilir | Tarama yükünü azaltmak, gizlilik değil |
Oturum açma veya imzalı URL | Evet, erişimi engelleyerek | Sayfanın gerçekten özel olmasını gerektirir | Başka insanların verisini içeren her şey |
Süre bitiminde 410 | Evet, zamanla | 404'ten yavaş; URL hâlâ yanıt verdikçe etkisiz | Geçici paylaşımlar ve derlemeler |
Kaçınılması gereken bir kısayol: X-Robots-Tag: none nötr bir değer değil. Google bunu noindex artı nofollow olarak değerlendiriyor. Bazen tam istediğiniz şeydir ama ekipler bunu bilmeden bir proxy yapılandırmasından kopyalar.
Kaçınılması gereken ikinci kısayol: canonical etiketleri. Canonical bir ipucudur. Sayfa dizinde olmamalıysa noindex yazın.
Adım 1: URL üreten rotaları envanterleyin
Listede olmayan şey sınıflandırılamaz ve çoğu ekip sayıyı olduğundan az tahmin eder, çünkü rotalarla değil özelliklerle düşünür.
Yönlendiriciyi veya URL haritasını açın ve her dinamik segmenti listeleyin. Her zamanki şüpheliler şöyle görünür:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Sonra Google'ın hâlihazırda bildikleriyle karşılaştırın, çünkü kod ile dizin birbirini tutmayacak.
Site haritasından. İndirip sayın:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
İkinci komut yol öneki başına kaba bir histogram verir. Bir üretilmiş rota site haritanızda görünüyorsa bu başlı başına bir hata: site haritası, Google'dan dizinlemesini istediğiniz sayfaların listesidir.
Search Console'dan. Sayfa dizine ekleme raporunu açın, her aday rota için URL önekiyle filtreleyin ve sayıları not edin. Google'ın o URL'lere gerçekte ne yaptığını söyleyen tek kaynak budur.
Sunucu günlüklerinden. Googlebot isteklerini öneke göre gruplayın:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Beklenen çıktı. Her birinin yanında URL sayısı bulunan bir rota deseni listesi, en az iki kaynaktan.
Kalite kontrolü. Ekip dışındaki bir ziyaretçiye 200 döndürebilen her rota listede olmalı. Site haritası ve Search Console sayıları aynı önekte birkaç puandan fazla ayrışıyorsa, bir şey değiştirmeden önce nedenini bulun.
Hiçbir şey bulamıyorsanız. Muhtemelen istemci tarafı yönlendiriciniz var. Rota tanımlarını arka uçta değil ön uçta arayın ve gerçek bir paylaşım bağlantısında ağ sekmesine bakın.
Adım 2: her rotayı toplantıda değil tabloda sınıflandırın
Kararı birinin yeniden bakabileceği yere yazın. Rota deseni başına bir satır yeter.
Rota | Kim oluşturur | Keşif yolu | Yabancı için değer | Karar | Kontrol | Sorumlu |
|---|---|---|---|---|---|---|
| Her kullanıcı | Yalnızca bağlantı | Yok | noindex | Başlık | Platform |
| Küratörlük | İç bağlantılar, site haritası | Yüksek | index | Yok | İçerik |
| Her kullanıcı | Profil bağlantıları | Etkinleşene kadar düşük | itibar kazanana kadar noindex | Meta | Güven ve emniyet |
| Her kullanıcı | Yalnızca bağlantı | Yok | noindex | Başlık | Platform |
| Editörler | Site haritası | Yüksek | index | Yok | İçerik |
Tablo ancak üç şey doğruysa işe yarar.
Satır başına bir sorumlu. Belirsiz sahiplik, üretilmiş rotaların yıllarca dizinlenebilir kalmasının nedenidir.
Kontrolü kararın yanına yazın, sonrasına değil. "noindex", birinin bunun başlık mı, şablon değişikliği mi, CDN kuralı mı olduğunu bilmesine kadar bir karar değildir.
İstisnayı kaydedin. Bir rota noindex ama küçük bir alt küme herkese açık olmalıysa, o alt kümenin koşulunu şimdi yazın. Altı ay sonra kesit almak, bir noindex kuralının sessizce tamamen kaldırılmasının yoludur.
Adım 3: kontrolü şablon düzeyinde uygulayın
Sayfa sayfa düzeltmeler sonraki dağıtımı görmez. Kontrolü rotanın oluşturulduğu yere uygulayın.
HTML sayfalar için etiketi sunucuda oluşturulan head içine koyun. Next.js App Router'da bunlar metadata; Astro'da layout head'i; Rails veya Django'da layout şablonu. Tam sözdizimi yerinden daha az önemli: Google'ın aldığı HTML'in içinde olmalı, istemci tarafı bir etkiyle eklenmemeli.
<meta name="robots" content="noindex">HTML olmayan her şey için meta etiket yoktur, başlığı kullanın:
X-Robots-Tag: noindexBu, PDF dışa aktarımlarını, JSON yanıtlarını, üretilmiş görselleri ve CSV indirmelerini kapsar. Bu dosyalar bir CDN'den sunuluyorsa başlığı uçta tanımlayın ki yeni rotalar kuralı miras alsın.
Bir rota ailesinin tamamı için her şablona dokunmaktan çoğu zaman bir ara katman kuralı daha temizdir:
// Express örneği: üretilen tüm paylaşım URL'lerinde noindex
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Beklenen çıktı. noindex olarak işaretlenen her rotanın anonim isteklerde direktifi ilk baytta döndürdüğü bir dağıtım.
Kalite kontrolü. Yayındaki URL'ye curl -sI çalıştırın. Yanıt başlıklarında x-robots-tag: noindex görmelisiniz ve curl -s meta etiketi kaynak kodda, herhangi bir betik çalışmadan önce göstermelidir.
Kurtarma yolu. Etiket yalnızca JavaScript çalıştıktan sonra görünüyorsa sunucu tarafı oluşturmaya taşıyın. Çatı rota başına head etiketi oluşturamıyorsa başlığı kullanın. JS ile enjekte edilen bir noindex'i yayına alıp çalıştığını varsaymayın: Google, oluşturulmuş noindex'in davranışını belirsiz olarak tanımlıyor.
Aynı çekme isteğine iki şey daha aittir. noindex rotalarını site haritasından çıkarın, çünkü dizinlenmesini istemediğiniz bir URL'yi göndermek, Google'ın kendi lehine çözdüğü bir çelişkidir. Ve bir süre bitimi kuralı ekleyin: bir paylaşım bağlantısı öldüğünde boş durumlu 200 sayfasını tutmak yerine 410 döndürün.
Adım 4: Googlebot'un direktifi görebildiğini doğrulayın
Yukarıdakilerin hiçbiri, siz Google'ın kontrol ettiği gibi kontrol edene kadar doğrulanmış sayılmaz.
Önce yanıt başlıklarına bakın:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagSonra başlangıç HTML'ine, herhangi bir betik çalışma fırsatı bulmadan:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Son olarak robots.txt'nin yolu engellemediğinden emin olun. Engelliyorsa Google sayfayı hiç taramaz ve direktifi hiç okumaz:
curl -s https://example.com/robots.txtSearch Console son kontroldür. URL Denetimi'nde URL denetimi isteyin ve kararı okuyun.
Doğru sonuç "Sayfa dizine eklenmedi: 'noindex' etiketiyle hariç tutuldu"dur. Tuzağa düştüğünüzü gösteren sonuç "Dizinlendi, ancak robots.txt tarafından engellendi"dir — Google URL'ye sahiptir, direktifi okuyamaz ve göstermeye devam edebilir. Bu görünüyorsa robots.txt kuralını kaldırın ve işi noindex'e bırakın.
Sayfayı Googlebot'un gördüğü gibi bir tarayıcı simülatörüyle de alabilirsiniz; yirmi rota kontrol ederken yeni tarama beklemekten hızlıdır: Googlebot Spider Simulator.
Beklenen çıktı. Her noindex rota, bir sonraki taramadan birkaç gün sonra noindex nedeniyle hariç tutuldu durumunu gösterir. Değişiklikten sonra oluşturulan rotalar dizinde hiç görünmemeli.
Kurtarma yolu. Bir URL iki hafta sonra hâlâ dizinlenmişse Google'ın onu tarayabildiğini, sayfanın Googlebot'a 200 döndürdüğünü ve hiçbir canonical veya hreflang etiketinin arama motorlarını başka yere yönlendirmediğini kontrol edin. Kaldırmalar aracını yalnızca nedeni düzeltirken geçici engel olarak kullanın; direktifin yerini tutmaz.
Paylaşım sayfası büyüme kanalı olduğunda
Bazı üretilmiş sayfalar dizinlenmelidir ve her şeye noindex koymak kendi ayağına sıkmak olur. İşte korunmaya değer olanlar:
Desen | Neden dizine layık | Korkuluk |
|---|---|---|
Herkese açık şablon galerileri | Kullanıcılar bir tasarım yayımlar, başkaları yeniden kullanır; çıktı benzersiz ve kalıcıdır | Yeni gönderimleri denetle |
Herkese açık vitrin sayfaları olan oluşturucular | "bu araçla yapıldı" kredili gerçek bir sonuç dağıtım kanalıdır | Vitrin şablonunu pazarlama sayfasından ayrı tut |
Kullanıcı başlıklarından büyüyen belgeler | Tekrar eden bir soru kalıcı ve düzenlenmiş bir yanıtı hak eder | Ham konuşmayı değil, küratörlü yanıtı dizinle |
Bu kategorilerden birindeyseniz Google'ın daha eski yönergesi hâlâ geçerli ve en iyi kaldıraç: itibarsız kullanıcıların içeriğinde noindex, sonra hesabın geçmişi olduğunda açma. Bu, edinim döngüsünü bırakmadan spama direnç verir ve rehberin bu güncellemeden önce önerdiği desendir.
Test üçü için de aynı. Sayfa, bir yabancının yazacağı sorgularda Arama performansı'nda gösterim kazanıyorsa dizine aittir. Yalnızca kendi URL dizesinde gösterim kazanıp başka bir şey kazanmıyorsa ait değildir.
Adlandırılması gereken ikinci dereceden bir etki var. Herkese açık paylaşım URL'leri yıllarca ucuz bir bağlantı yüzeyi oldu: güçlü alan adına sahip bir platformda sayfa aç, kendi sitene bağlantı göster, yirmi mülkte tekrarla. Patrick Stox aynı başlıkta farklı platformlardan 20'den fazla bağlantı saydı. Platformlar yönergeye uyarsa bu yüzey küçülür. Uymazsa Google'ın, o sayfaların spam olduğuna karar verdiği bir sonraki seferde alıntılayacağı bir belgesi artık var.
Adım 5: Google'ın tarif ettiği deseni ölçümleyin
İzleme bölümü, güncellemenin çoğu ekibin atlayacağı kısmı — ve tam da gerçek bir olayı manuel işleme dönüşmeden yakalayan kısmı.
Dört kontrol, her biri bakılacak bir yerle.
Search Console mülkü. Manuel işlem ve güvenlik uyarılarının e-postayla gelmesi için siteyi veya alt alan adını doğrulayın. Kiracı başına alt alan adı olan bir platform işletiyorsanız ana alan adını ve çocuklardan en az bir örneği doğrulayın; hiçbir yere ulaşmayan uyarı izleme değildir.
Sayfa dizine ekleme eğilimi. Bugün üretilmiş rota başına dizinlenmiş URL taban çizgisini belirleyin ve gürültüyü değil basamaklı değişimleri izleyin. Statik olması gereken bir rotada bir haftada dizinlenmiş URL sayısının ikiye katlanması sinyaldir.
Arama performansı anormallikleri. Ürünle ilgisiz sorgulara göre filtreleyin. Spam sayfalar, biri şikâyet etmeden çok önce spam sorguları çeker.
Üretim/dizinleme oranı. Google'ın adlandırdığı ve neredeyse kimsenin ölçmediği metrik bu: tek bir hesap günde kaç dizinlenebilir URL üretebiliyor ve yeni dizinlenebilir URL'lerin ne kadarı en üretken %1'lik hesap diliminden geliyor. Bir hesap için son yedi günün medyanının 3 katında bir ilk uyarı keyfî ama işe yarar; trafiğinize göre ayarlayın.
Aynı oran ürün korkuluğu olarak da işe yarar. Bir özellik kullanıcının günde bin dizinlenebilir URL üretmesine izin veriyorsa, kimse henüz kötüye kullanmıyor olsa bile o bir dizin şişirme özelliğidir.
Güncelleme aslında ne söylüyor
İfadeyi çıkarın, Google arz hakkında tartışıyor.
Yirmi yıl boyunca spam politikası sayfaları tarif etti: ince, kazınmış, gizlenmiş, anahtar kelimeyle doldurulmuş. Bu kategoriler bir insanın ya da betiğin sayfa üretmeye karar verdiğini ve Google'ın sıralamayı hak edip etmediğine karar verdiğini varsayar. Üretilmiş çıktılar bu modeli kırar. Tek bir ürün kararı, hepsi teknik olarak benzersiz, hepsi teknik olarak 200, çoğu onu üretmeyen için değersiz bir milyon URL yaratabilir. Google bunları tek tek değerlendiremez ve yapabildiğini varsaymayı bıraktı.
Tepki iki kampa ayrıldı. İlki uyarı atışı olarak okudu: Marie Haynes yapay zekâ araçları ve uygulama oluşturucular için yeni manuel işlemler gelir mi diye sordu ve Lily Ray bölümü Google'ın büyük ölçekte hâlihazırda neyle mücadele ettiğinin işareti saydı; Claude yapıtlarını, ChatGPT paylaşım sayfalarını ve sosyal medya gönderilerini örnek gösterdi. İkincisi omuz silkti. Dikkatli ekipler kullanıcı üretimi raporları yıllardır noindex'e koyuyor, diye savundu birkaç yanıt, ve Google'ın kendi üretilmiş sayfaları daha büyük sorun. İki okuma da doğru olabilir. Yönergeyi önemli kılan tavsiyenin yeni olması değil, artık politika uygulanırken başvurulabilecek bir yerde yazılı olması.
Yani yönerge kararı zincirin yukarısına taşıyor. Platformların şablon düzeyinde bir URL sınıfının dizine ait olup olmadığına karar vermesi bekleniyor. Bu bir yönetişim meselesi, SEO meselesi değil; tavsiyenin dizinleme belgelerinde değil spam rehberinde olmasının nedeni de bu.
Yapay zekâ araması için aynı mantık iki yönde de çalışır. Google'ın yapay zekâ özellikleri Google dizininden beslenir, dolayısıyla noindex direktifi sayfayı hem havuzdan hem mavi bağlantılardan çıkarır. Üretilmiş bir sayfa AI Overviews'ta alıntı kazanıyorsa durmasını bekleyin. Bu genelde bir paylaşım bağlantısı için doğru, bir şablon sayfası için yanlıştır. Diğer yapay zekâ tarayıcıları kendi kurallarını izler, o sayfaları hangilerinin taramasına izin vereceğinize ayrıca karar verin.
Pratik ders, tasarım incelemesine taşınabilecek tek cümle: kullanıcının üretebileceği her URL ya bir ürün yüzeyidir ya bir dizin yükümlülüğüdür ve hangisi olduğuna şablon karar verir.
Sık sorulan sorular
Bu, sıradan bir pazarlama sitesi için geçerli mi?
Hayır, siteniz kullanıcı girdisinden URL üretmiyorsa geçerli değil. Bir pazarlama sitesi, birinin var olması gerektiğine karar verdiği sayfalar kümesi yayımlar; bu, rehberin tarif ettiği sorunun tam tersidir. Kapsam satırı barındırma platformlarını ve kullanıcıların paylaşılan sayfalar, üretilmiş içerik veya web uygulamaları yayımlamasına izin veren araçları adlandırıyor. Yorumlarınız, forumunuz veya üye profilleriniz varsa daha eski yönerge geçerli: güvenilmez hesapların bağlantılarında nofollow veya ugc, yeni kullanıcılar için itibar kazanana kadar noindex.
robots.txt mi yoksa noindex etiketi mi kullanmalıyım?
noindex, ve rota başına yalnızca biri. Google'ın cümlesi iki seçeneği listeliyor ama farklı işler yapıyorlar. robots.txt'deki bir Disallow taramayı engeller ve engellenmiş ama başka yerden bağlantı verilmiş bir URL açıklamasız olarak sonuçlarda kalabilir. noindex yalnızca Google sayfayı tarayıp okuyabildiğinde işler. Pratikte bu bir meta etiket veya yanıt başlığı demektir ve aynı yolda asla bir robots.txt kuralı değildir.
Paylaşım sayfalarını noindex yapmak trafik kaybettirir mi?
Rotayı karar vermeden önce, sonra değil, kontrol edin. Bir sayfa yalnızca kendi URL dizesinde gösterim kazanıyorsa organik trafik getirmiyordur ve kaldırmak bir şeye mal olmaz. Trafik kaybettiren desen, herkese açık bir galeriyi içindeki çıktılarla birlikte devirmektir. Galeriyi dizinlenebilir tutun, arkasındakine noindex koyun ve galeri sorgularının arama performansını öncesi ve sonrasıyla izleyin.
Yapay zekâ arama motorları noindex'e uyuyor mu?
Google'ın yapay zekâ özellikleri uyuyor, çünkü AI Overviews ve AI Mode aynı dizinden besleniyor, dolayısıyla direktif sayfayı hem mavi bağlantılardan hem yapay zekâ yanıtlarından çıkarıyor. Diğer yapay zekâ tarayıcıları ayrı bir karardır. Sağlayıcı davranışı değişiyor ve değişiklik günlüğü olmadan değişiyor; her tarayıcının belgelerini okuyun ve tek bir direktifin hepsini kapsadığını varsaymak yerine sayfayı o tarayıcının user agent'ıyla çekin.
Yazar: Grace Miller, Auspia'da AI Search risk analisti. 200'den fazla politika değişikliğini izliyor. Platform kuralları, içerik riski ve politika bilinci yüksek optimizasyon üzerine yazıyor.