Yapay zekâ görünürlük takipçisi kulağa basit geliyor. Asistana birkaç kategori sorusu sorarsınız, markanızın çıkıp çıkmadığını not edersiniz ve bunu zaman içinde grafiğe dökersiniz.
Sorun kaydın daha yukarısında. Ölçtüğünüz şey yerinde durmuyor. Aynı istemi aynı modele iki kez gönderin, kısmen örtüşen iki yanıt alırsınız. Birini kaydedin ve bir dağılımdan çekilmiş tek bir örnekliği kaydedip onu olgu olarak sunmuş olursunuz.
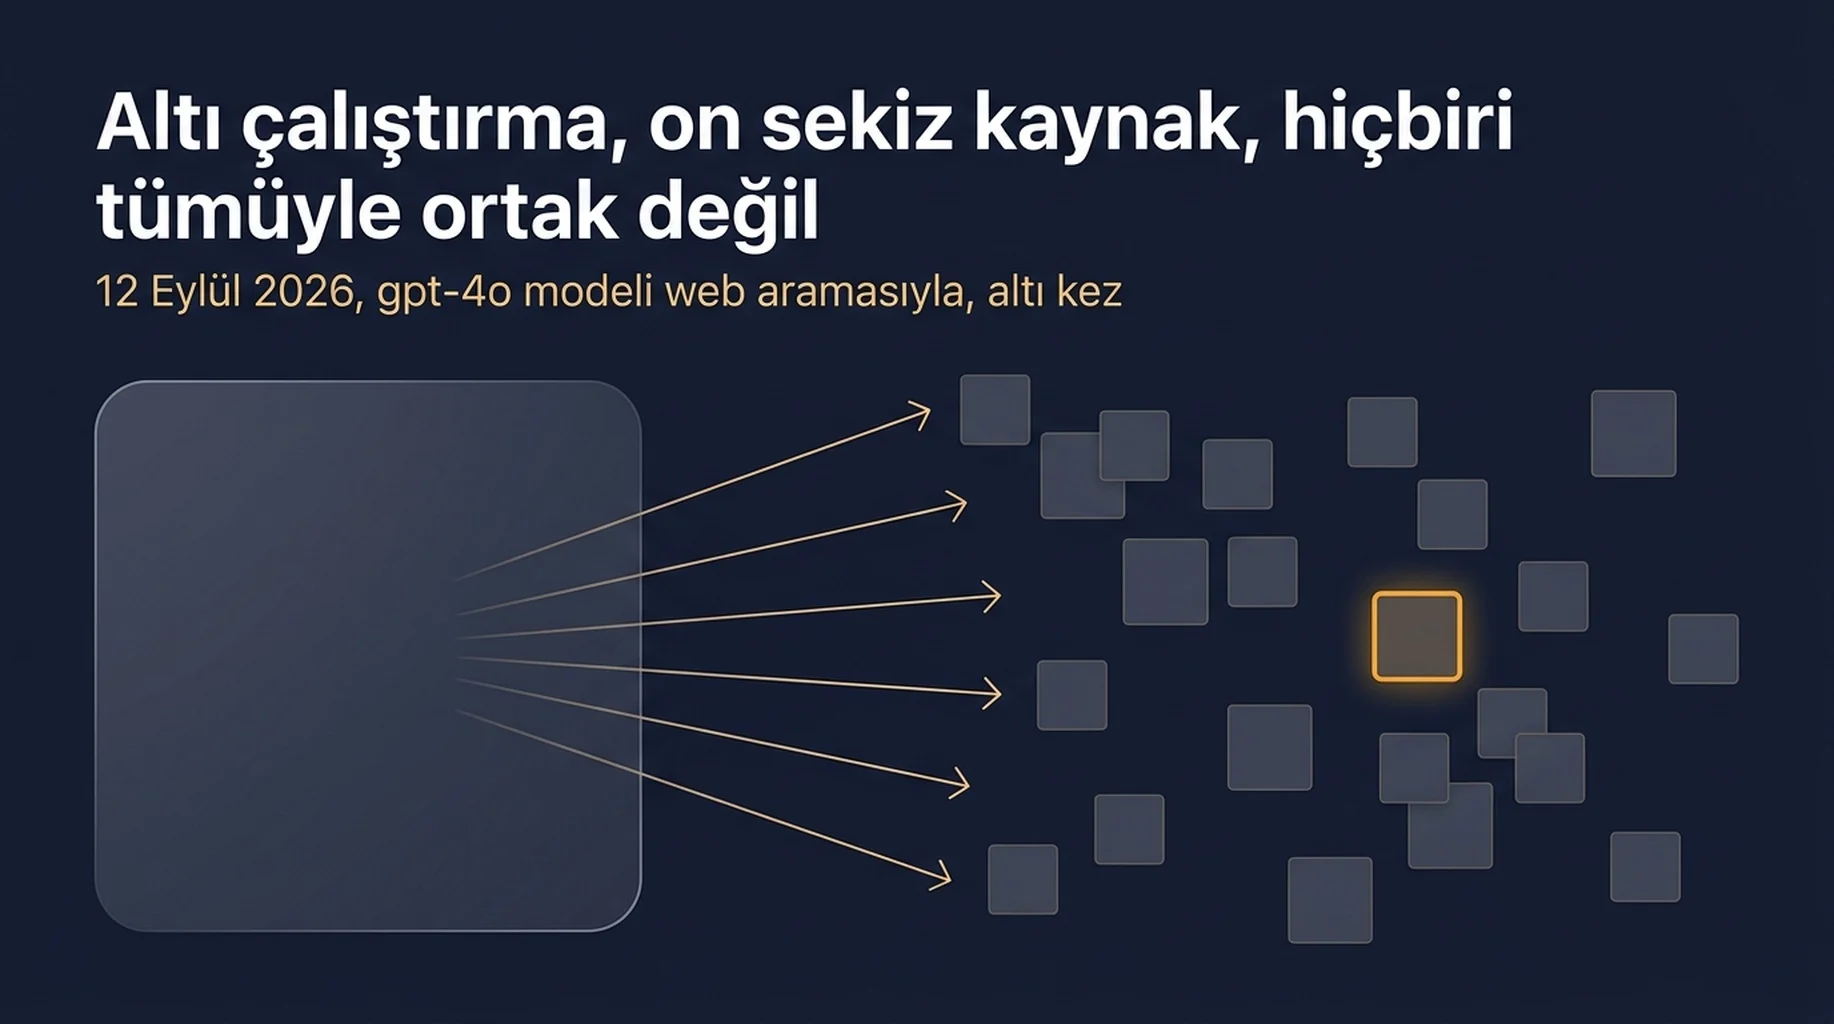
Bu saçılmanın gerçekte ne kadar büyük olduğunu bilmek istedik, bu yüzden varsaymak yerine deneyi çalıştırdık. Kısa hâli: birbirinin aynısı altı istek on sekiz atıf kaynağı üretti ve hiçbir kaynak altı çalıştırmanın tamamında atıf almadı.
Bu makale neyi çalıştırdığımızı, neyin geri döndüğünü ve bir yapay zekâ görünürlük takipçisinin, sayının gelecek ay da bakmaya değer olması için saklaması gereken dört alanı ele alıyor.
Neyi çalıştırdık
İki deney; ikisi de bir SaaS ekibinin kategori araştırmasında gerçekten kullanacağı istemlerle.
Deney 1: tek istem, tek model, altı çalıştırma. Model gpt-4o, web araması açık, Amerika Birleşik Devletleri, İngilizce. İstem: "2026'da küçük bir SaaS ekibi için en iyi sıralama takip araçları hangileri? Kaynaklarıyla birlikte kısa bir liste ver." Aynı oturum penceresinde art arda yürütülen altı ayrı canlı çağrı.
Deney 2: iki model, aynı istem, üçer çalıştırma. Aynı istem Claude Sonnet 5 ve Gemini 3.8 Flash'a üçer kez, web araması olmadan gönderildi. Aramasız ölçtüğümüz şey, modelin kendi bilgisinden hangi ürünleri saydığıdır ve bu, hangi kaynakları atıfladığından ayrı bir sinyaldir.
İkinci bir istemi de aynı web araması yolundan dört kez gönderdik; soru türleri arasında atıf davranışının tutarlı olup olmadığını görmek için: "Sitem için AI Overviews'ı nasıl takip ederim? Kaynaklarıyla birlikte somut yöntemler ver."
Altı çalıştırma büyük bir örneklem değil ve biz de öyle davranıyoruz. Yönü ve varyasyonun kaba büyüklük mertebesini göstermeye yetiyor, mesele de bu.
Sonuç 1: on sekiz kaynak, altı çalıştırmanın paylaştığı sıfır
Altı web araması çalıştırması toplamda 18 farklı URL'ye atıf yaptı. Her alan adının kaç kez göründüğü şöyle.
Atıf sayısı (6 çalıştırma içinden) | Alan adları |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Hiçbir alan adı altı çalıştırmanın tamamında atıf almadı. Hiçbir URL altı çalıştırmanın tamamında atıf almadı.
Burada önemli olan sayı çalıştırmalar arası örtüşme. Her çalıştırma çifti karşılaştırıldığında, atıf alan URL'ler üzerindeki ortalama Jaccard örtüşmesi 0,167 oldu. On beş çiftin ikisinde örtüşme tam olarak sıfırdı; yani o iki yanıt hiçbir kaynağı paylaşmadı.
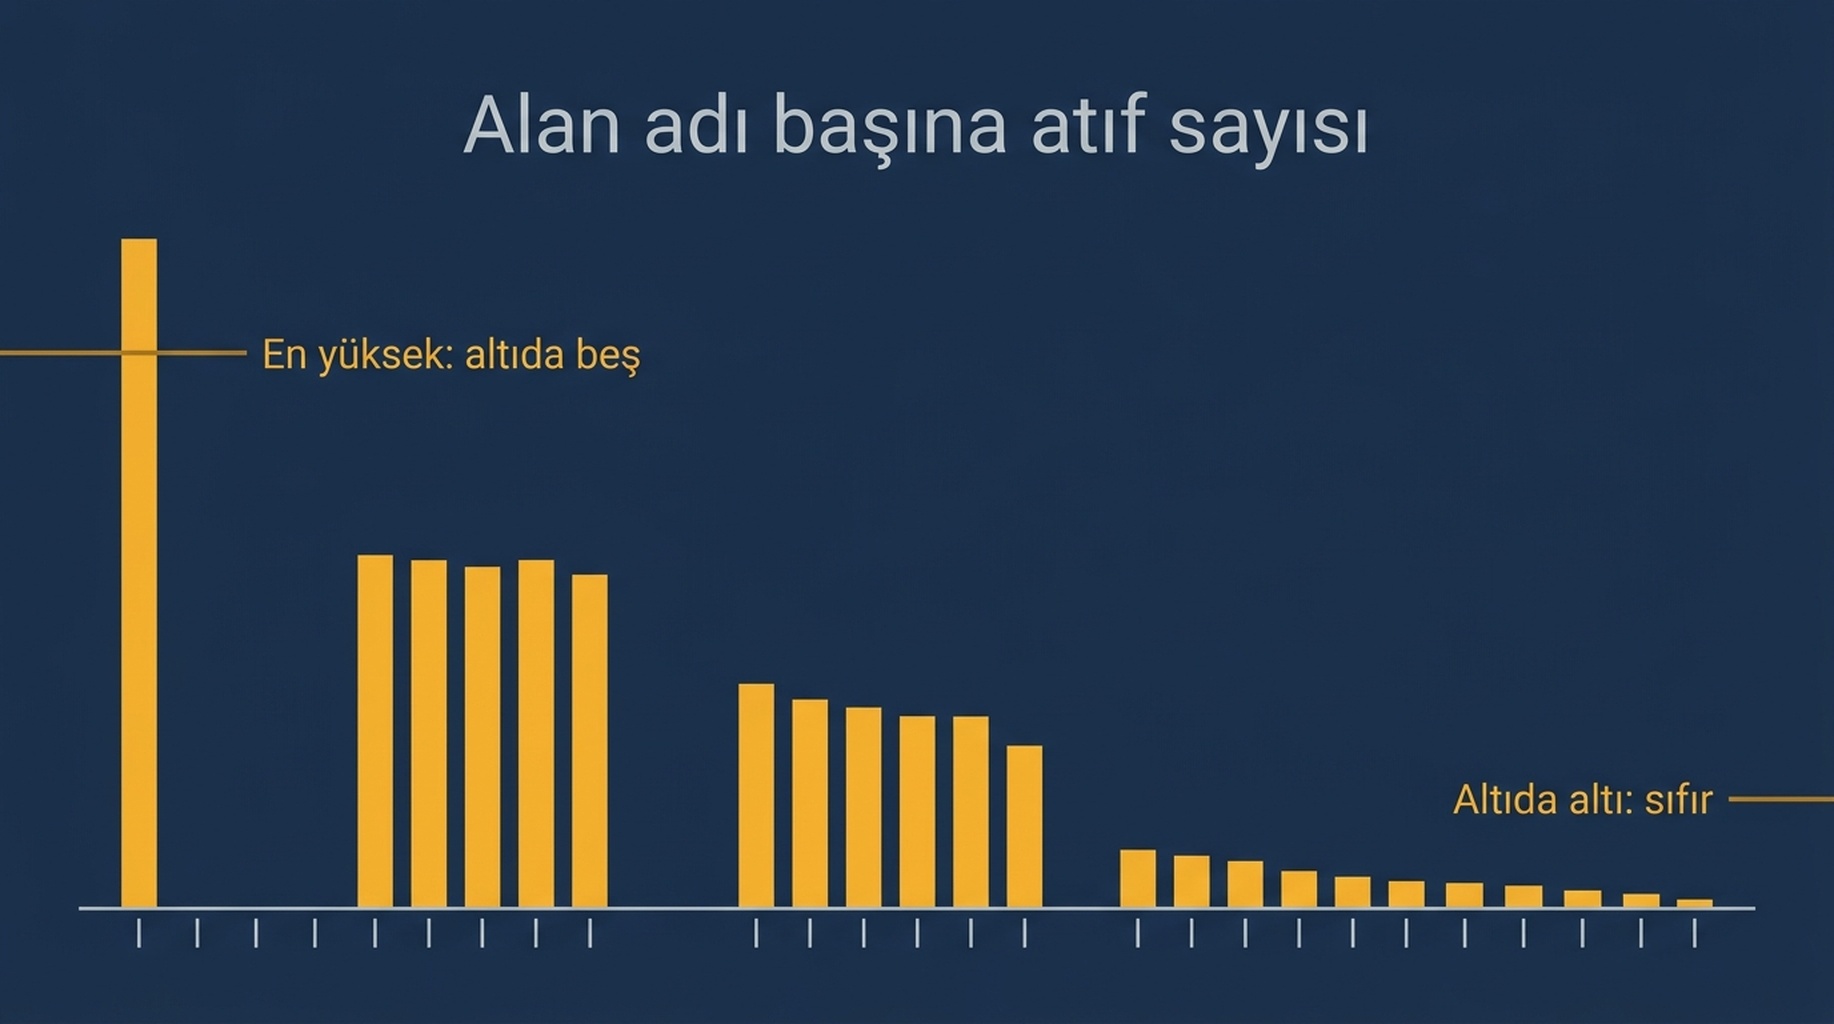
Altı çalıştırmanın beşinde atıf alan bir kaynak, gözlemlediğimiz tavan. Hiçbir şey her seferinde atıf almadı.
O tabloda ikinci bir bulgu gömülü. Modelin uzandığı alan adları çoğunlukla kategorinin bilinen karşılaştırma siteleri değil. On sekiz alan adının dokuzu tam olarak bir kez göründü ve bazıları, içeriği habercilik ürünü gibi değil de o sorgu için bir araya getirilmiş gibi okunan küçük siteler. Bir marka için bu iki ucu keskin bir kılıç. Atıf yuvasının geleneksel "en iyi araçlar" sıralamasından daha kolay kazanıldığı anlamına geliyor. Aynı zamanda o yuvanın, o çalıştırmada sorgunun biçimine uyan sayfayı üreten kişi tarafından doldurulduğu ve bir sonraki çalıştırmada yeniden doldurulacağı anlamına da geliyor.
Sonuç 2: yanıtın kendisi boyut değiştiriyor
Atıflar hareket etti, yanıt uzunluğu da onlarla birlikte hareket etti.
Çalıştırma | Çıktı token sayısı | Yanıt uzunluğu | Çalıştırma maliyeti |
|---|---|---|---|
1 | 505 | 2.153 karakter | $0,0735 |
2 | 860 | 3.728 karakter | $0,0770 |
3 | 1.108 | 4.746 karakter | $0,0797 |
4 | 832 | 3.555 karakter | $0,0765 |
5 | 870 | 3.547 karakter | $0,0772 |
6 | 813 | 3.544 karakter | $0,0768 |
Çıktı uzunluğu 505 ile 1.108 token arasında değişti; 603 tokenlık bir aralık, ortalamanın yaklaşık yüzde 73'ü. En uzun yanıt en kısanın iki katından fazlaydı. Altı çalıştırmanın beşi 813 ile 1.108 token arasındaki oldukça dar bir şeride düştü; bir çalıştırma 505'te erken durdu ve dokuz ile on dört yerine beş kaynağa atıf yaptı.
Ölçüm açısından bu belirli bir şekilde önemli. Takipçiniz "marka yanıtta görünüyor mu ve kaçıncı sırada" yakalıyorsa, kısa bir çalıştırmada görünebilecek daha az yuva vardır. Haftada bir kez örnek alıp tesadüfen kısa bir çalıştırma çeken bir ekip, siteste hiçbir şey değişmediği hâlde uzun bir çalıştırma çeken ekipten daha kötü bir sonuç kaydeder.
Sonuç 3: bazı istemler hiç atıf almıyor
AI Overviews'ı takip etmeyle ilgili ikinci istem aynı web araması yolundan dört kez geçti ve her çalıştırmada sıfır atıfla döndü.
Çalıştırma | Çıktı token sayısı | Yanıt uzunluğu | Atıf sayısı |
|---|---|---|---|
1 | 479 | 2.135 karakter | 0 |
2 | 522 | 2.240 karakter | 0 |
3 | 534 | 2.312 karakter | 0 |
4 | 497 | 2.228 karakter | 0 |
Yanıtlar uzunluk bakımından istikrarlıydı, dört çalıştırma boyunca yalnızca yüzde 8 değişti. Ama model kendi bilgisinden yanıtladı ve hiçbir kaynak adı vermedi, dolayısıyla atıf sütununa yazılacak bir şey yoktu.
Buradan takipçinin belirli ve yanıltıcı bir okuması çıkıyor. Atıf oranı panosu bu soru için sıfır gösterecek ve bu bir görünürlük başarısızlığı gibi görünecek. Değil. Bu, kaynak aramasını tetiklemeyen bir soru biçimi. Doğru okuma "atıf uygulanamaz" ve bunu "atıf kontrol edildi ve yoktunuz"dan ayırt edemeyen bir takipçi, sizi var olmayan bir sorunun peşine düşürür.
Sonuç 4: model değiştirmek tekrar değil, başka bir ölçümdür
Web araması kapalıyken her modelin hangi ürünleri saydığını ölçtük. Bu, modelin kendi öneri kümesini, o dakikada arama dizininin döndürdüğü her şeyden yalıtır.
Claude Sonnet 5 çalıştırma başına dört ile beş ürün saydı. Üç çalıştırma boyunca altı farklı ürün saydı: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat ve SerpWatcher. Bunlardan üçü her üç çalıştırmada da göründü: AccuRanker, Ahrefs ve SEMrush. Ortalama ikili örtüşme 0,587.
Gemini 3.8 Flash çalıştırma başına iki ile beş ürün saydı. Üç çalıştırma boyunca yedi farklı ürün saydı: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush ve Wincher. Bunlardan yalnızca biri, SE Ranking, her üç çalıştırmada da göründü. Ortalama ikili örtüşme 0,306.
İki model arasında dört ürün her ikisi tarafından, beş ürün ise yalnızca biri tarafından anıldı.
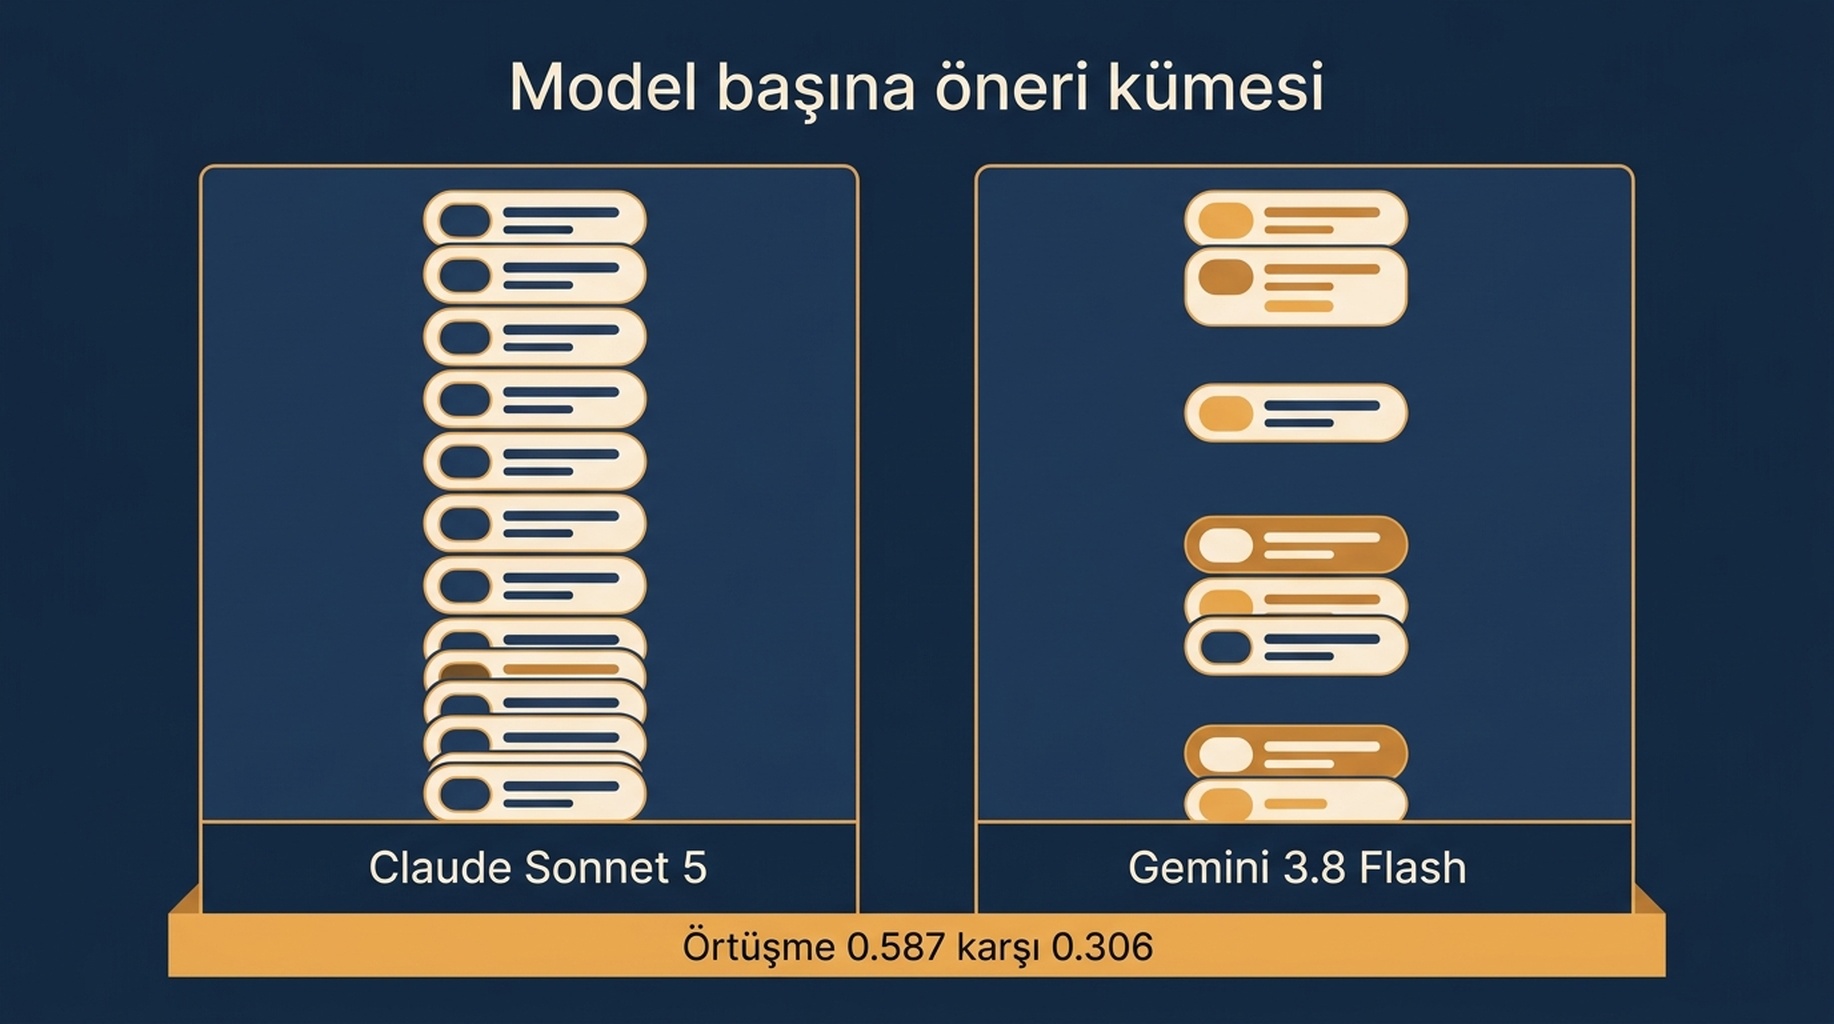
Aynı soru, her modelde ve her çalıştırmada kısmen farklı bir öneri kümesi üretiyor.
Pratik sonuç şu: "Yapay zekâ görünürlüğünü" tek bir sayı olarak takip ediyorsanız, en az iki bağımsız varyasyon kaynağı üzerinden ortalama alıyorsunuz: çalıştırma ve model. Bir asistanda tutarlı biçimde çıkıp diğerinde çıkmayan bir marka, gerçek ve eyleme geçirilebilir bir bulgudur. Tek örnekli ölçümü iki sıra kayan bir marka ise gürültüdür.
Bir yapay zekâ görünürlük takipçisi ne kaydetmeli
Dört alan, bir ekran görüntüsünü ölçüme dönüştürür.
Çalıştırma sonucu değil, çalıştırma sayısı. Her çalıştırmayı saklayın ve aralığı bildirin. "6 çalıştırmanın 4'ünde atıf aldı" bir olgudur. "Atıf aldı, 3. sırada" bir rastlantıdır. Küçük bir program için altı çalıştırma makul bir alt sınırdır; istem ticari olarak önemliyse on iki daha iyidir.
Atıf alanını anılma alanından ayrı tutun. "Model bizi önerdi" ile "model bize bağlantı verdi" farklı sonuçlardır ve düzeltmeleri de farklıdır. Bizim altı çalıştırmamız 18 farklı URL'den 18 atıf üretti; yalnızca marka anılması kaydeden bir takipçi bu çalkantıdan hiçbir şey yakalayamazdı.
Yanıt kanalının durumu. Çalıştırmanın web araması kullanıp kullanmadığını ve yanıt uzunluğunu kaydedin. Sıfır atıflı bir çalıştırma ile sıfır anılmalı bir çalıştırma panoda aynı görünür ve zıt anlama gelir.
İstem metnini kelimesi kelimesine, sürüm numarasıyla birlikte. İstemin ifadesi hangi kaynakların çekileceğini belirler. İstem aylar arasında değişirse trend çizgisi kopar. İstemi, takip betiğini sürümlediğiniz gibi sürümleyin.
Çalıştırma döngüsünü kurmak
Elle kontrol, takvimle tek bir karşılaşmayı atlatamaz. Döngü, bir istemi N kez çalıştıran, her ham yanıtı atıflarıyla birlikte saklayan ve mevcut pencereyi bir öncekiyle karşılaştıran bir betiktir.
Bu iş bir ajan için uygundur; çünkü tekrarlıdır, kurallara bağlıdır ve yazılı kayıt gerektirir. Claude Code veya Codex'te işe yarayan talimat, ham çalıştırmaları diskte bırakıp asla üzerine yazmamak ve ardından tek bir sayı yerine özet bir tablo bildirmektir. Search Console ve Bing verilerini zaten MCP sunucuları üzerinden çekiyorsanız, aynı oturum atıf günlüğünü gösterim verisinin yanında tutabilir ve iki sayının birlikte işe yaramaya başladığı yer tam orasıdır. Bu sunucuların neleri açığa çıkardığına dair notlarımız dört SEO MCP sunucusu gerçekte ne yapar yazısında, aynı sorunun varlık tarafı ise kırk sorguluk AI Overview anlık görüntümüz yazısında.
Bir tasarım kuralı diğerlerinden daha önemli: takipçinin çıktısı bir dağılım olmalı. "Atıf aldı" değil, "6 çalıştırmanın 4'ünde atıf aldı" bildirin. Birinci kaynağı değil, kaynak listesini bildirin. Altı çalıştırmayı tek bir sayıya sıkıştıran her pano, fazladan çalıştırmaların satın aldığı tek bilgiyi atmış olur.
Amaç izleme değil de rakip karşılaştırmasıysa, zaman içinde ilerleyen bir sıralama takip döngüsü daha uygun bir araçtır ve veri kaynakları arasındaki ödünleşimler iki kaynaktan sıralama takipçisi kurmak yazısındadır.
Altı çalıştırmalık bir örneklemin sınırları
Üç dürüst çekince.
Örneklem küçük. Altı çalıştırma saçılmayı ancak gevşek biçimde çerçeveler. Çalıştırmalar arası örtüşmenin kısmi olduğunu ve sıfır örtüşmeli çiftlerin gerçekleştiğini ortaya koyar; kategoriniz için bir güven aralığı vermez.
Sonuçlar zamana bağlı. Bu çalıştırmalar 12 Eylül 2026'da canlı modeller üzerinde yapıldı. Hem modeller hem de altlarındaki arama sonuçları değişir.
Atıf alan alan adları tek bir ticari istemin örneklemidir. Karşılaştırma sorusu veya nasıl yapılır sorusu gibi farklı bir soru biçimi farklı bir atıf deseni üretecektir. İşe yarayan hamle, aynı tasarımı ticari olarak en önemli on isteminizde çalıştırıp kategorinizin nasıl davrandığını kaydetmektir.
Sık sorulan sorular
Yapay zekâ görünürlük sayısı anlamlı olmadan önce kaç çalıştırma gerekir? Tek bir istem için altı, pratik alt sınırdır ve sayı sıralama olarak değil, çalıştırma sayısı içinden bir sayım olarak bildirilmelidir. İstem gelir kararlarını yönlendiriyorsa, on iki çalıştırma birkaç dolara daha sıkı bir okuma verir.
Bu, yapay zekâ görünürlüğünü takip etmenin değersiz olduğu anlamına mı gelir? Tek örnekli takibin değersiz olduğu anlamına gelir. Bulgu, varyasyonun kendisidir. "6 çalıştırmanın 4'ünde atıf aldı, kaynaklar geçen aydan bu yana 12 alan adı değişti" diye bildiren bir takipçi, bir rakibin içinde yarıştığı gerçek sistemi tarif ediyor.
Bir istem neden sıfır atıfla döndü? Model kaynak aramak yerine kendi bilgisinden yanıtladı. Bu sorunun bir özelliği, sitenizin başarısızlığı değil. Sıfır olarak değil, uygulanamaz olarak takip edin.
ChatGPT, Claude ve Gemini'yi ayrı ayrı takip etmeli miyim? Evet. Üç çalıştırmalık karşılaştırmamızda iki model, anılan dokuz ürünün yalnızca dördünde örtüştü. Ortalama almak, hangi asistanın önce optimize edileceğine dair program düzeyindeki kararı gizler.
Model sıcaklığını düşürerek varyasyon azaltılabilir mi? Kısmen, ve kendi istemlerinizde denemeye değer. Ama atıf kümesi arama dizini tarafından da hareket ettirilir ve onu siz kontrol etmiyorsunuz. Daha güvenilir kaldıraç çalıştırma sayısıdır.
Auspia görüşü: Bu çeyrekte yapay zekâ görünürlük takibini kuruyorsanız, panodan önce çalıştırma günlüğünü kurun. Pano bir görüntüleme tercihidir. Çalıştırma günlüğü ise ölçümün kendisidir. On istemle, her biri altı çalıştırmayla, kelimesi kelimesine saklanmış olarak başlayın; bir haftada, tek örnekli kontrolün bir yılda söyleyeceğinden fazlasını öğrenirsiniz.
Yazan: Ethan Marlowe, Auspia'da 500'den fazla istemi kapsayan GEO ölçümünün liderliği. İstem takibi, atıf raporları ve gerçek bir ölçüm döngüsüyle temas etmeye dayanan görünürlük panoları üzerine yazıyor.