Что вы получите в результате
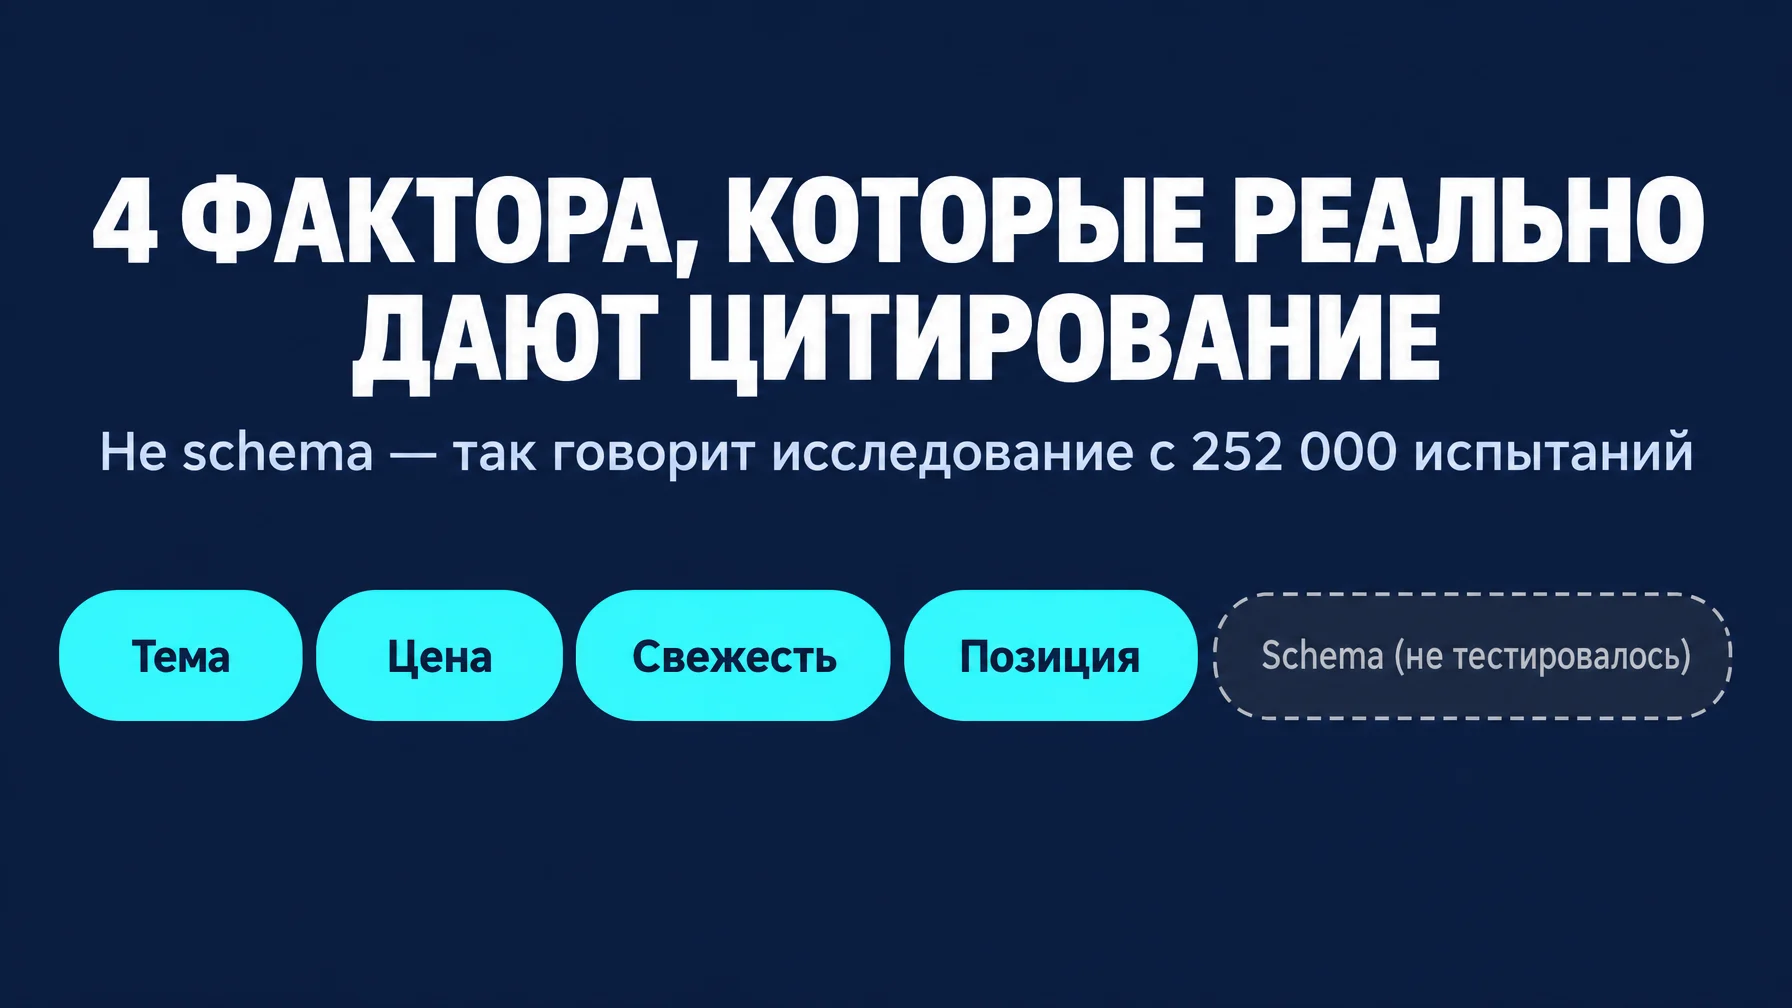
Постраничный аудит по четырём факторам, которые контролируемое исследование с 252 000 испытаний признало решающими для цитирования в AI, а также порядок исправления семи вторичных факторов, которые начинают работать после того, как эти четыре на месте. Вы также узнаете со ссылками на источники, почему популярное утверждение «разметка schema никак не влияет на цитирование в AI» не является реальным выводом того исследования, и не потратите спринт на исправление не того.
Для кого это: для всех, кто отвечает за SEO или GEO на уровне страниц для сайта, который хочет попадать в цитирование в ChatGPT, Gemini, Perplexity, Claude или в AI-ответах Google.
Требуемое время: 30–45 минут на страницу, включая аудит и первый проход исправлений.
Готово, когда: проверяемая страница проходит все четыре ключевых фильтра, а у вас на руках список вторичных факторов, над которыми ещё нужно поработать.
Перед началом: на чём основан этот чек-лист и что он исправляет
В кругах SEO/GEO ходит пост, в котором утверждается, что исследование SIGIR провело 252 000 испытаний на шести LLM и выяснило, что schema и JSON-LD дают «нулевой измеренный эффект» на цитирование в AI, тогда как цена, свежесть, характеристики и глубина сильно двигают результат.
Исследование реально. Число испытаний верное. Отношения шансов в том посте близки к настоящим цифрам. Не выдерживает проверки одно: это исследование никогда не тестировало разметку schema. Дело не в том, что schema «показала ноль», — schema вообще не было в списке того, что измеряли.
Статья называется "What Gets Cited: Competitive GEO in AI Answer Engines" (Vishwakarma, Kumar, Jamidar, Sprinklr; SIGIR '26, Мельбурн). Дизайн: в шесть LLM (Gemini-2.5-Flash, Claude-3.5-Sonnet, Kimi-K2-Thinking и три варианта GPT-5) подаются ровно два источника-кандидата, каждая пара отличается ровно по одному из 18 факторов контента, и фиксируется, какой источник процитирован первым. Эти 18 факторов охватывают соответствие контенту, полноту, достоверность, читаемость, конкурентную позицию и свежесть. Формат структурированных данных отсутствует среди всех 18 — это подтверждено прямой сверкой с таблицей таксономии из самой статьи.
Если вам нужен настоящий ответ по schema, он приходит из другого источника: контролируемое исследование Ahrefs от мая 2026 года, в котором 1 885 страниц с добавленным JSON-LD сравнивались с 4 000 контрольными страницами. Результат: значимого роста цитирования нет ни в Google AI Overviews (−4.6%, небольшое, но статистически значимое снижение), ни в Google AI Mode (+2.4%, незначимо), ни в ChatGPT (+2.2%, незначимо). Отдельный тест searchVIU показал, что ChatGPT, Claude, Perplexity, Gemini и Google AI Mode вообще не читают JSON-LD, скрытую Microdata или скрытую RDFa во время живого поиска.
Держите оба факта врозь, приступая к аудиту: исследование SIGIR говорит, что приоритизировать на странице. Исследование Ahrefs говорит, что schema не относится к числу этих приоритетов именно в части объёма цитирования, хотя по-прежнему важна для расширенных результатов и ясности сущностей в других местах.
Шаг 1: проведите аудит по ключевым фильтрам
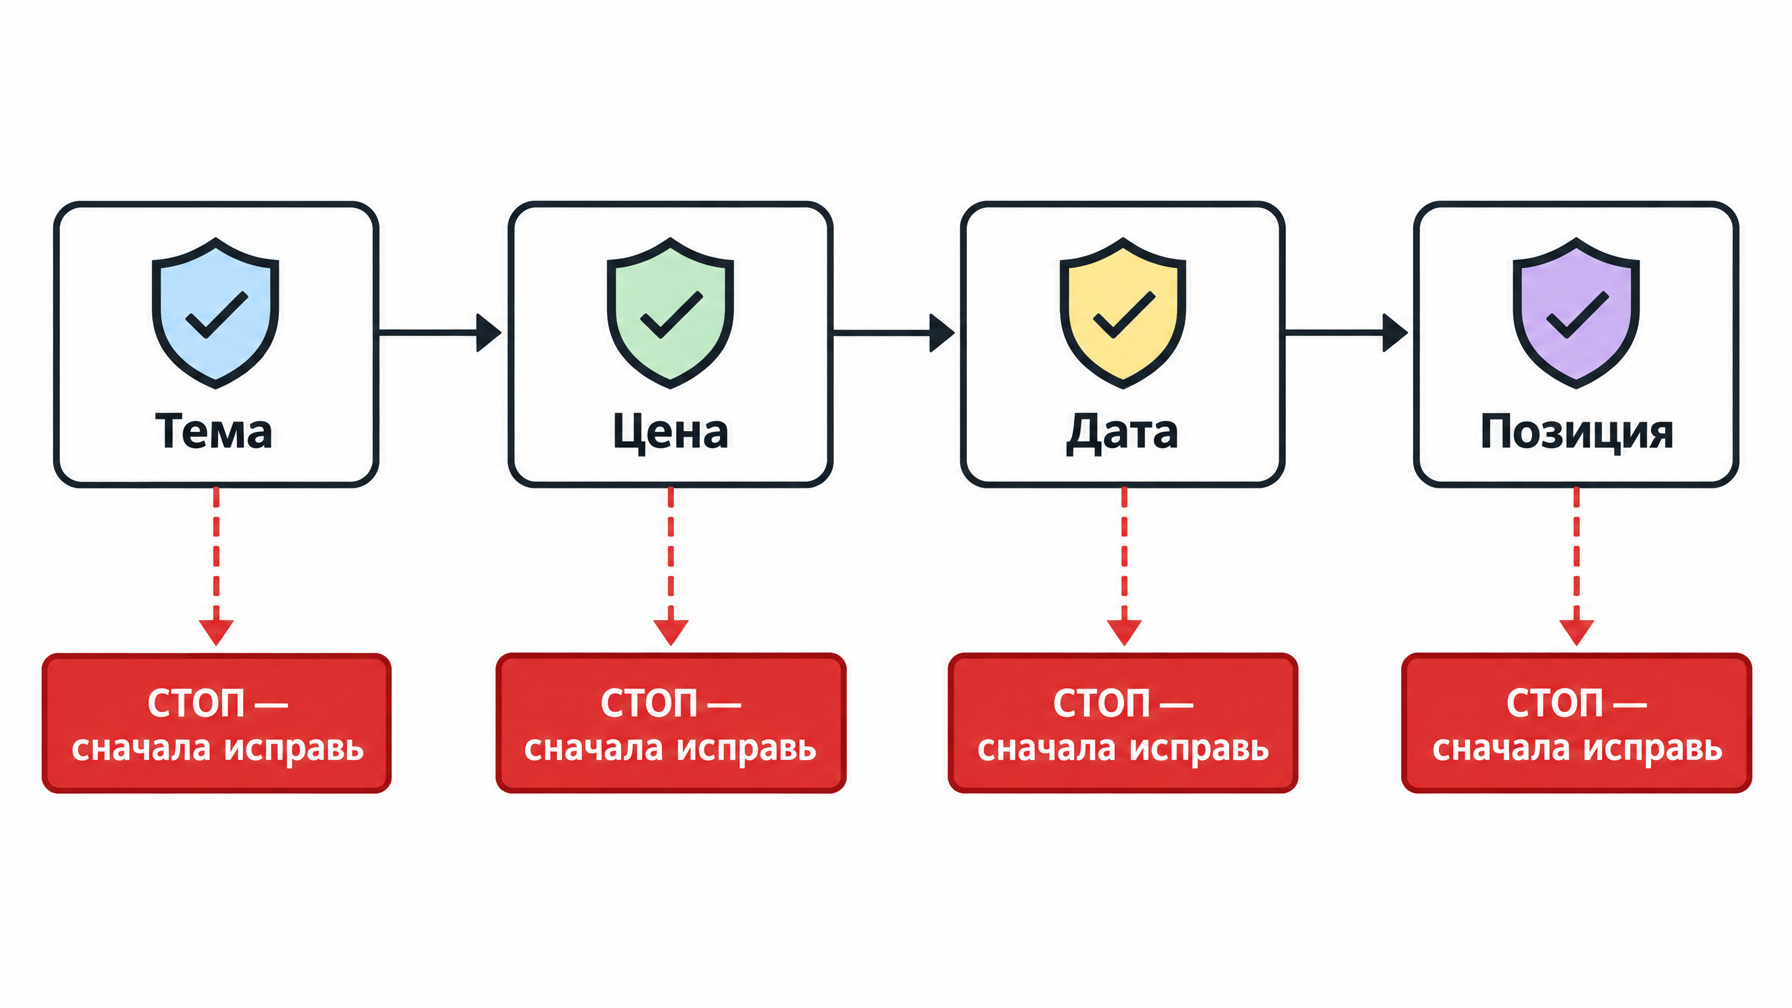
Проверьте свою страницу по этим четырём факторам. В исследовании SIGIR все четыре оказались единогласными на всех шести моделях, с очень большими эффектами (отношение шансов выше 100 в большинстве моделей). Провал любого одного может обнулить шансы на цитирование независимо от того, насколько сильна остальная часть страницы.
Фильтр | Что проверяем | Диапазон отношения шансов (по шести моделям) |
|---|---|---|
Соответствие теме | Отвечает ли страница напрямую на запрос, под который её продвигают, а не на смежную тему? | Фактически решающий в 5 из 6 моделей |
Указана цена | Видна ли на странице конкретная цена, а не спрятана за «Свяжитесь с нами»? | От 6,26 до более 10 000 |
Свежая дата | Видна ли актуальная и точная дата публикации или последней проверки? | От 14,4 до более 10 000 |
Позиция в списке | Склонна ли эта страница занимать первое место среди кандидатов по запросу, а не второе? | От 1 795 до более 10 000 |
Действие: откройте страницу рядом с целевым запросом. Прочитайте первые 150 слов и спросите себя, отвечают ли они на запрос напрямую. Найдите цену на странице; если для этого нужна форма или звонок — это провал. Сверьте видимую дату с тем, когда контент действительно обновляли в последний раз. Проверьте свою текущую позицию или долю цитирования по этому запросу.
Ожидаемый результат: пройдено или провалено по каждой из четырёх строк.
Проверка качества: если провалено соответствие теме, остановитесь здесь — ни один следующий шаг не спасёт страницу, которая отвечает не на тот вопрос.
Путь восстановления: провалы по цене и дате исправляются в тот же день (шаг 2). Провал по позиции в списке — это не проблема контента; это значит, что базовые основы SEO нужно подтянуть прежде, чем страница вообще сможет конкурировать за цитирование, и никакая полировка на странице этого не заменит.
Шаг 2: сначала исправьте провалы по фильтрам
Сделайте это, прежде чем трогать что-либо ещё. Это пункты с наибольшим рычагом и наименьшими усилиями во всём списке.
Если нет цены: добавьте фактическую цифру. Если цена варьируется, опубликуйте реальную начальную цену или понятный диапазон вместо формы обратной связи. Это был один из четырёх ключевых фильтров в исследовании.
Если дата устарела или отсутствует: обновите дату публикации или последней проверки, но только после того, как вы действительно переработали контент. Смена даты без реального обновления — это сигнал свежести, который вы не сможете подтвердить, если кто-то проверит.
Если соответствие теме слабое: перепишите первые 150 слов так, чтобы они отвечали на задачу запроса напрямую, а не на родственную тему. Не прикручивайте новое вступление к старой структуре — замените его.
Проверка качества: перечитайте страницу так, как будто вы и есть этот запрос. Получит ли посторонний человек конкретный ответ в первом абзаце?
Путь восстановления: если реальную цену опубликовать нельзя (индивидуальные расчёты, корпоративные сделки), опубликуйте репрезентативную начальную цену или типичный диапазон вместо пустого места — исследование измеряло как состояние провала именно «цена не упомянута», а не «цена варьируется».
Шаг 3: пройдитесь по вторичным факторам дифференциации
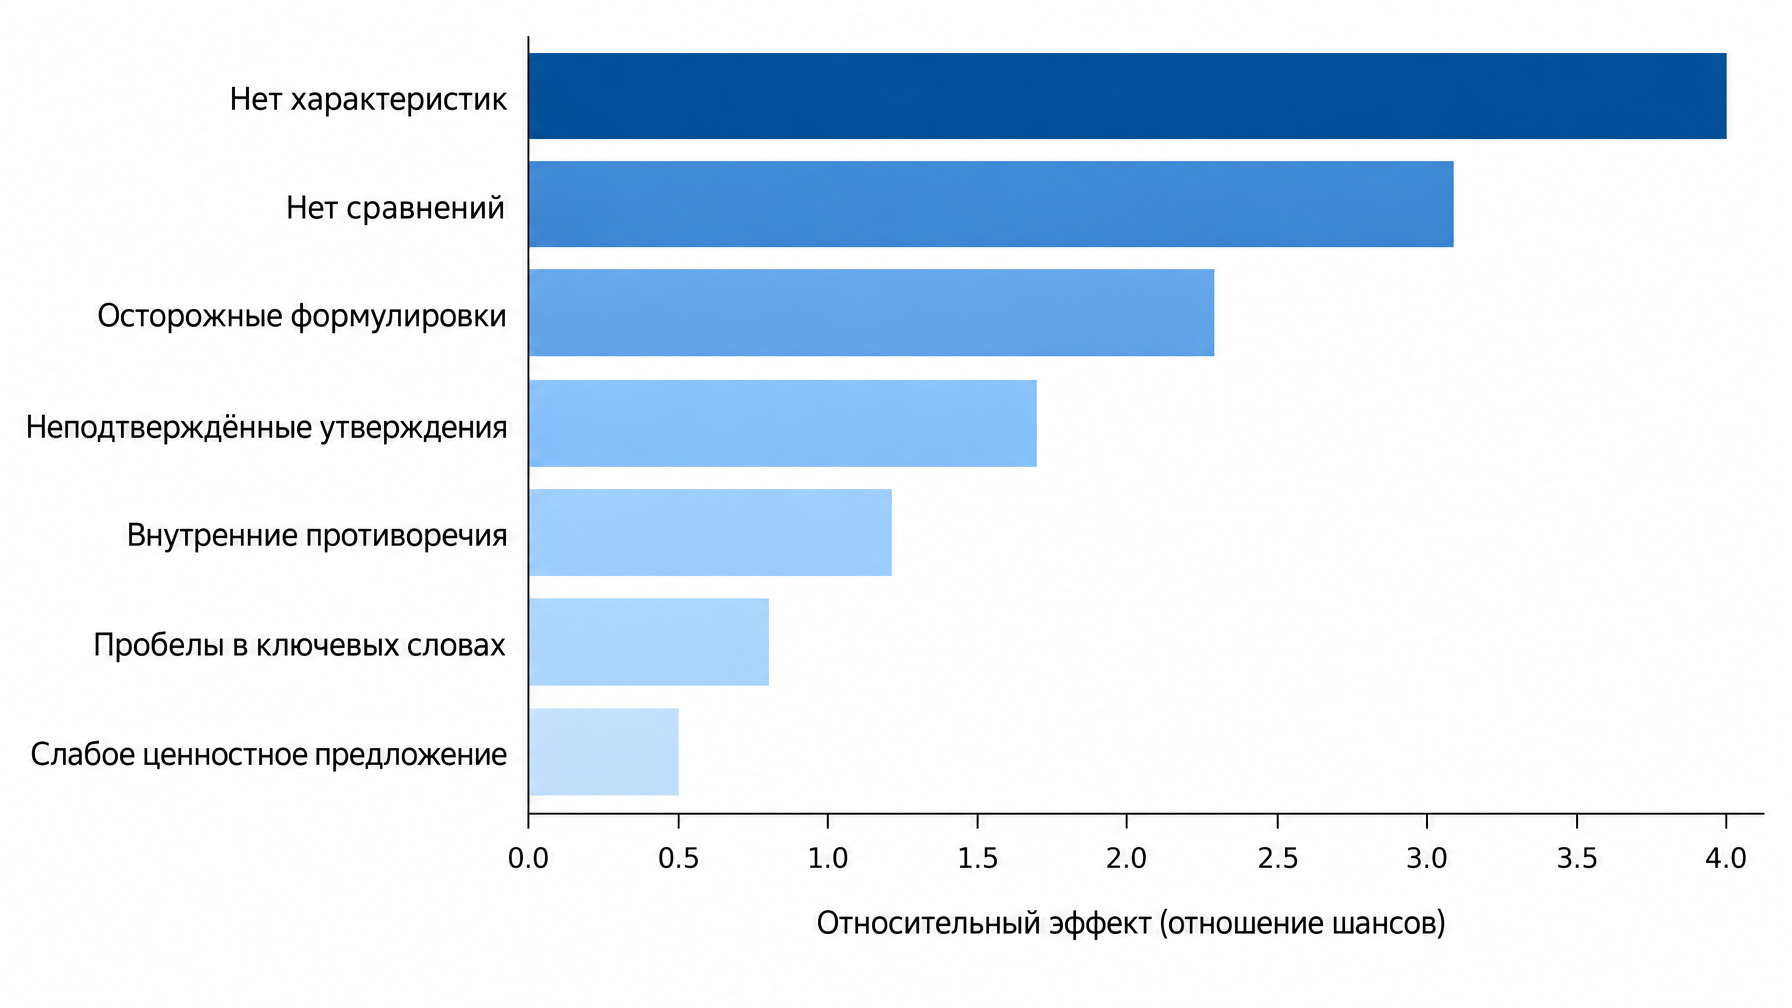
Когда четыре ключевых фильтра пройдены, эти семь факторов дают вторичную дифференциацию, с отношениями шансов примерно от 2 до 243 в зависимости от модели. Исправляйте их в таком порядке:
- Отсутствие характеристик. Добавьте технические характеристики, которые покупатель действительно будет сравнивать (габариты, материалы, ёмкость, совместимость). Отношение шансов от 8,63 до 243 по моделям — один из крупнейших вторичных эффектов.
- Нет сравнений. Добавьте прямое сравнение хотя бы с одной названной альтернативой. Отношение шансов от 1,61 до 7,45.
- Осторожные формулировки. Замените «возможно», «может быть», «вероятно» на прямые уверенные утверждения, которые страница действительно может подкрепить.
- Неподтверждённые утверждения. Приложите к утверждениям доказательства: результаты тестов, сертификаты, названную методологию.
- Внутренние противоречия. Проверьте, что цифры и утверждения согласуются между разделами одной и той же страницы; это легко внести при правках и легко пропустить при вычитке.
- Пробелы в ключевых словах. Убедитесь, что на странице действительно есть конкретные формулировки целевого запроса, а не только синонимы.
- Более слабое ценностное предложение. Отточите конкретное утверждение о выгоде на фоне того, что предлагает конкурирующая страница.
Действие: идите по списку по порядку и исправляйте то, что применимо. Не у каждой страницы будут все семь проблем.
Ожидаемый результат: страница, где каждое утверждение либо конкретно, либо сравнительно, либо подкреплено доказательствами.
Проверка качества: найдёт ли скептически настроенный читатель на странице хотя бы одно расплывчатое или ничем не подкреплённое предложение?
Путь восстановления: если времени мало, остановитесь после пунктов 1 и 2 (характеристики и сравнения) — у них самые большие отношения шансов из семи.
Шаг 4: пропустите изменения только по оформлению
Исследование прямо показало, что от преобразования абзацев в маркированные списки, добавления подзаголовков для удобства чтения и переорганизации разрозненной информации нет устойчивого эффекта, потому что протестированные модели разбирали контент независимо от визуальной структуры. Если ваша страница проходит проверки выше, не тратьте спринт на полировку оформления в ожидании роста цитирования. Оформляйте для своих живых читателей, а не ради прироста цитирования, который данные не поддерживают.
Шаг 5: оставьте schema там, где ей место
Поддерживайте разметку schema технически корректной, потому что она делает реальную работу: помогает Google и Bing разбирать расширенные результаты и даёт поисковым системам однозначное понимание того, чем является страница и сущность. Чего она не делает, согласно лучшим доступным контролируемым данным, — так это не двигает шансы на цитирование в AI. Не ставьте работу над schema впереди шагов 1–3 исходя из идеи, что это рычаг цитирования: ни одно контролируемое исследование это не поддерживает, а единственное исследование, на которое ссылаются в защиту этой идеи, schema вообще не тестировало. Если хотите полный разбор того, что на самом деле измеряло исследование Ahrefs про schema, смотрите наш гид по семантическому SEO 2026 года.
Проверьте готовый результат
Перезапустите аудит из шага 1 на странице после исправлений. Все четыре фильтра теперь должны быть пройдены. Выборочно проверьте два-три вторичных фактора из шага 3, которые вы исправили. Если у вас есть доступ к инструменту видимости в AI или отслеживания цитирования, например к AI Search Visibility Checker, зафиксируйте текущую долю цитирования страницы по целевому запросу как базовую отметку перед переходом к следующей странице, чтобы позже понять, сдвинули ли изменения хоть что-то.
Поддерживайте результат
Перепроверяйте фильтр по дате каждый раз, когда на странице происходит содержательное обновление, а не по фиксированному календарю. Страницы, потерявшие долю цитирования, заново проверяйте начиная с четырёх ключевых фильтров, прежде чем предполагать, что просел какой-то вторичный фактор.
Частые вопросы
Исследование SIGIR тестировало разметку schema или JSON-LD? Нет. Его таксономия из 18 факторов охватывает соответствие контенту, полноту, достоверность, читаемость, конкурентную позицию, свежесть и позицию в списке. Формата структурированных данных нет ни среди категорий, ни среди протестированных факторов — это подтверждено прямой проверкой таблицы таксономии из статьи.
Помогает ли разметка schema цитированию в AI вообще? Лучшие доступные контролируемые данные — исследование Ahrefs от мая 2026 года, где 1 885 страниц сравнивались с 4 000 подобранными контрольными, — не обнаружили значимого роста цитирования от добавления JSON-LD ни в Google AI Overviews, ни в Google AI Mode, ни в ChatGPT. Отдельный тест показал, что несколько крупных AI-моделей не читают структурированные данные во время живого поиска. Это не делает schema бесполезной в других местах; она просто не является рычагом объёма цитирования.
Откуда взялись конкретные цифры из вирусного поста (6,3; 14; 4–8,6)? Они похожи на реальные отношения шансов из таблицы результатов статьи SIGIR, но принадлежат факторам цены, свежести и характеристик/сравнений, а не schema. Статья приводит цифры по каждой модели, а не как одно усреднённое значение, и диапазоны существенно различаются между шестью протестированными LLM.
Что исправлять первым, если у меня всего час? Четыре ключевых фильтра: соответствие теме, цена, дата и позиция в списке. Провал любого из них может обнулить шансы на цитирование независимо от всего остального на странице.
Стоит ли полностью отказаться от работы над schema? Нет. Держите её корректной ради расширенных результатов и ясности сущностей. Просто не ставьте новую работу над schema выше исправления ключевых фильтров, если реальная цель — объём цитирования в AI.
Автор: Bennett Hayes, Applied GEO Analyst в Auspia, более 400 проведённых разборов внедрений. Bennett пишет о практическом внедрении GEO, аудитах и заметках по реализации, основанных на том, что контролируемые исследования действительно измеряли.