Что вы получите в итоге
К концу этого руководства в вашей зоне Cloudflare появится явная и осознанная политика для трёх отдельных категорий трафика ИИ-ботов — поисковых (Search), агентных (Agent) и обучающих (Training) — вместо того значения по умолчанию, которое досталось вашему домену. Вы будете точно знать, какие краулеры разрешены, какие заблокированы и на каких страницах, а ваш файл robots.txt и правило принудительного применения на периферии будут действительно согласованы между собой.
Для кого это: для всех, кто управляет сайтом, проксируемым через Cloudflare — издателей, маркетинговых сайтов SaaS, интернет-магазинов, блогов — и хочет сам решать, могут ли системы ИИ обучаться на его контенте, суммировать его или просматривать его через агентов, вместо того чтобы наследовать настройку платформы.
Что понадобится:
- Домен, проксируемый через Cloudflare (любой тариф, включая бесплатный; некоторые шаги ниже доступны только на платных тарифах, и это отмечено)
- Доступ к панели управления как минимум с правом менять настройки безопасности на уровне домена
- 20–30 минут на аудит и настройку; затем несколько минут в день или в неделю на мониторинг
Критерий готовности: в настройках безопасности вашей зоны выставлен осознанный выбор (а не значение по умолчанию) для поиска, агентов и обучения; ваш рабочий /robots.txt отражает этот выбор; и вы убедились в AI Crawl Control, что боты, которые должны были быть заблокированы, действительно блокируются.
Почему это вдруг стало важно: что изменилось 15 сентября
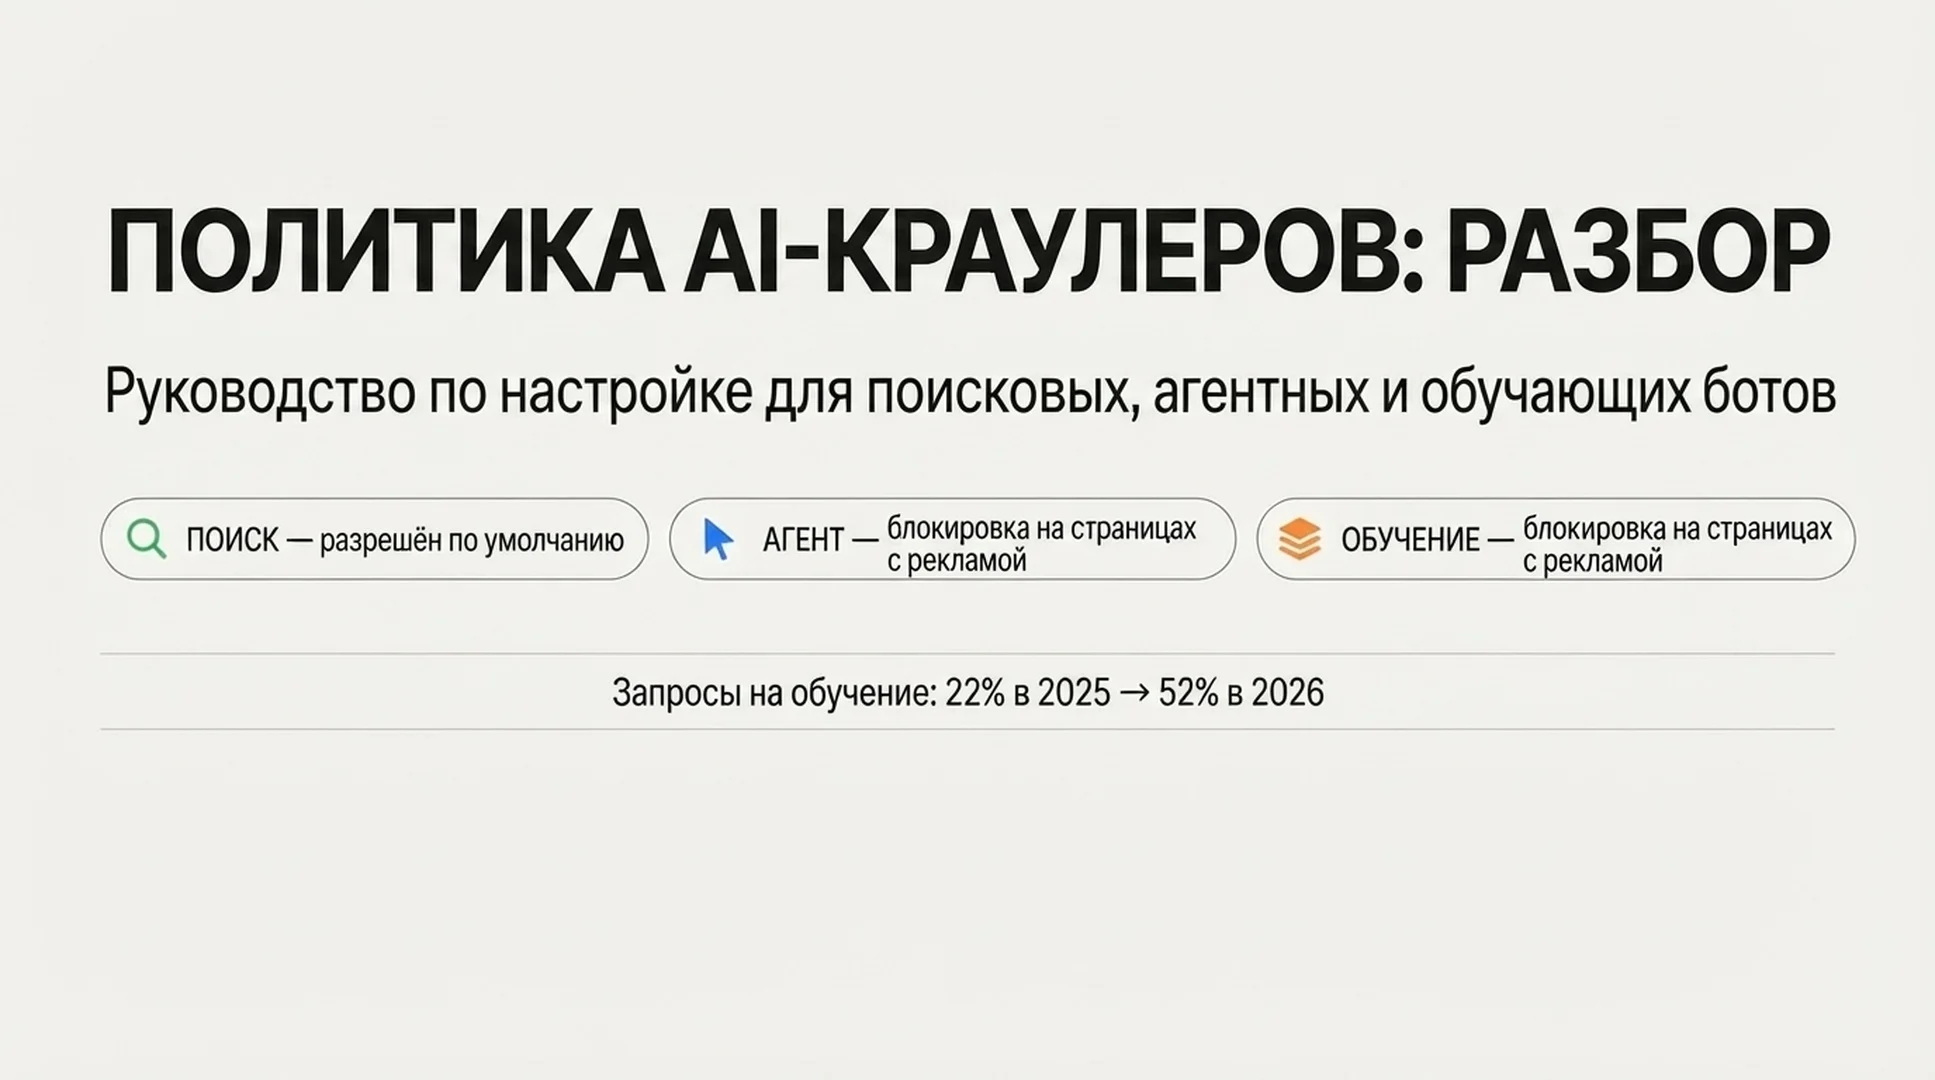
Cloudflare выстраивала средства управления ИИ-трафиком поэтапно: начиная с добавления Content Signals Policy в robots.txt в сентябре 2025 года и заканчивая запуском «Content Independence Day» 1 июля 2026 года, который впервые разделил поведение ИИ-ботов на три именованные категории вместо одного грубого переключателя «ИИ или не ИИ»:
- Поиск (Search) — сканирование, которое строит поисковый индекс и позже возвращает ссылки или короткие фрагменты. Формулировка Cloudflare: это тот трафик, который должен приносить вам переходы.
- Агент (Agent) — автоматизированная активность в реальном времени, действующая от имени человека прямо сейчас: например, чат-ассистент запрашивает страницу или браузерный агент выполняет задачу.
- Обучение (Training) — сканирование для обучения или дообучения модели, при котором ваш контент навсегда поглощается весами модели, а не возвращается к вам ссылкой.
15 сентября 2026 года Cloudflare изменила то, что происходит автоматически. Для любого домена, подключающегося к Cloudflare в эту дату или позже, если сайт помечен как монетизируемый рекламой, конфигурация по умолчанию становится такой:
Категория | По умолчанию на страницах с рекламой |
|---|---|
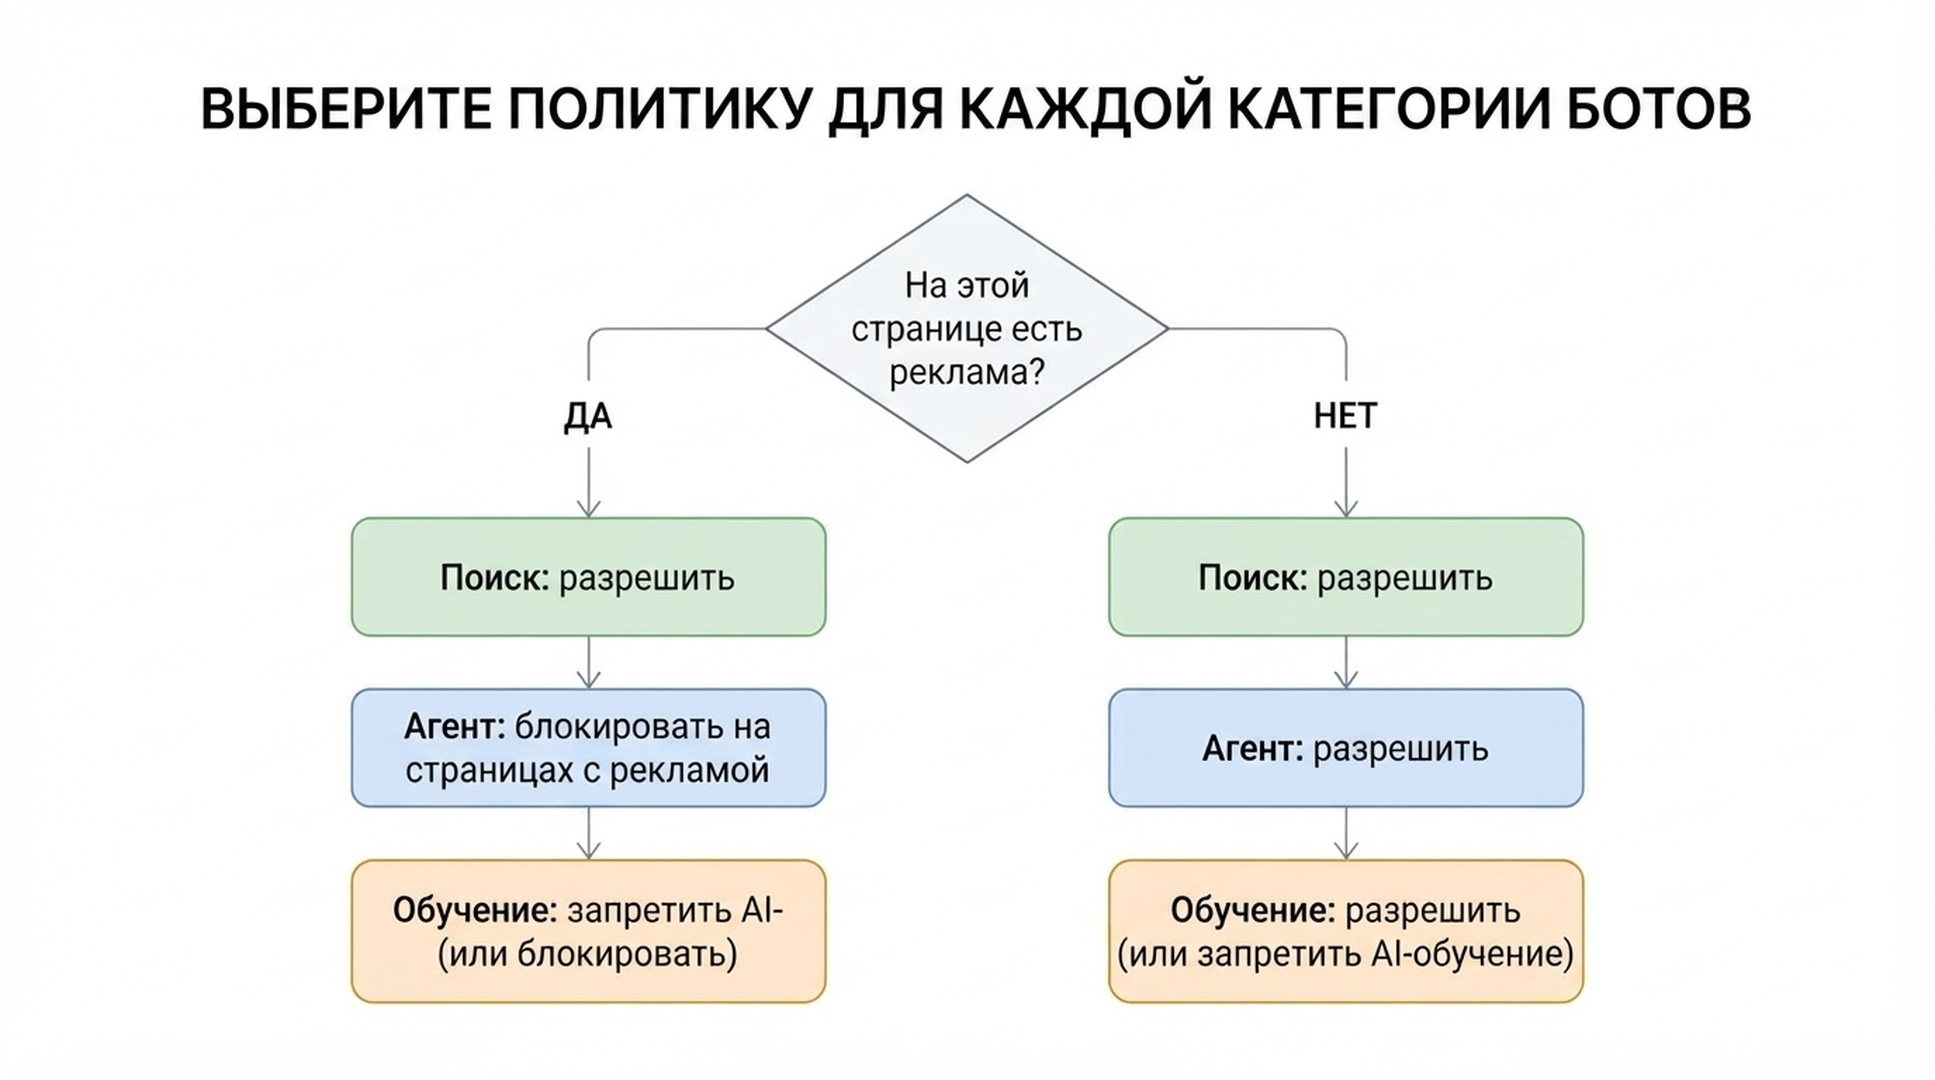
Поиск (Search) | Разрешить |
Агент (Agent) | Блокировать на страницах с рекламой |
Обучение (Training) | Запретить обучение ИИ (Disallow AI Training) |
Новые домены без рекламной монетизации по умолчанию получают «Разрешить» во всех трёх категориях. Существующих клиентов никто молча не переключал — Cloudflare дала окно до 15-го числа, чтобы отказаться через панель управления, а фактические правила миграции для каждого домена оказались подробнее, чем одно новое значение по умолчанию (разбираем ниже).
Причина, по которой страницы с рекламой получают более строгое значение по умолчанию, в том, что реклама на странице — это сигнал, что её предполагалось показать человеку. По собственным данным Cloudflare, в июне 2026 года краулеры смешанного назначения — те, что совмещают поисковую индексацию, агентные запросы и обучение под одним user agent, — составили более 36% проверенного трафика краулеров, самую крупную категорию. А доля обучения ИИ в общем числе запросов краулеров в сети Cloudflare выросла примерно с 22% весной 2025 года до 52% в июне 2026-го. Именно на этот трафик и нацелено изменение.
Перед началом: три вещи, которые нужно понять про категории
1. Часть краулеров «смешанного назначения» и ведёт себя по-разному при блокировке и при запрете обучения. Googlebot, Bingbot и Applebot выполняют двойную работу — они сканируют и для поиска, и для обучения под одним user agent. Cloudflare называет Apple, Google и Microsoft «Accountable» (подотчётными) операторами, потому что они выполняют четыре условия: уважают предпочтение в robots.txt об отказе от обучения, предлагают способ отказаться от ИИ-пересказов, дают видимость на уровне URL того, что использовалось для обучения, и могут показать, что отказ от обучения не вредит вашему присутствию в поиске.
2. «Запретить обучение ИИ» и «Блокировать» — это не одна и та же настройка, и разница между ними и есть суть. Запрет обучения ИИ публикует в robots.txt предпочтение Disallow, адресованное пользовательским агентам, предназначенным для обучения (таким как Google-Extended и Applebot-Extended). Подотчётные краулеры смешанного назначения читают это предпочтение и добровольно продолжают сканировать для поиска, пропуская обучение, — так ваше присутствие в поиске сохраняется. Все остальные обучающие краулеры, не являющиеся подотчётными, блокируются на периферии сразу, но это не затрагивает поиск, поскольку такие операторы запускают отдельные боты только для обучения. Обычная же блокировка теперь также блокирует сами Googlebot, Bingbot и Applebot — то есть ваш контент исчезает и из их результатов поиска. Если вы хотите убрать обучение, но сохранить поиск, нужная настройка — «Запретить обучение ИИ», а не «Блокировать».
3. Bing пока не соблюдает настройку обучения в robots.txt. Applebot и Googlebot сегодня соблюдают директиву Disallow, предназначенную для обучения. Microsoft заявила, что создаёт аналогичный механизм для Bingbot с целевым сроком в начале 2027 года. До этого выбор «Запретить обучение ИИ» пропишет предпочтение в вашем robots.txt, но поведение сканирования Bing ради обучения от одного этого сигнала не изменится — метатег NOARCHIVE самого Bing или его инструмент Content Removal остаются временными рычагами, если вас беспокоит именно обучение через Bing.
Шаг 1: Выясните, где на самом деле оказался ваш сайт
Не предполагайте, что знаете текущую настройку, — проверьте её.
Действие: в панели Cloudflare откройте домен, перейдите в Security → Settings и найдите элементы управления политикой ИИ-ботов (новый интерфейс с тремя категориями заменил старый единый переключатель «Block AI Bots», однако в аккаунтах, ещё не прошедших миграцию, может отображаться старый переключатель). Отдельно запросите рабочий robots.txt в браузере или командой curl https://yourdomain.com/robots.txt и поищите блок, начинающийся с комментария-маркера, управляемого Cloudflare; можно также сверить с проверкой ИИ-краулеров в robots.txt от Auspia, чтобы увидеть, как ваши текущие правила читаются ИИ-краулерами.
Ожидаемый результат: три настройки — по одной для поиска, агентов и обучения, — каждая в одном из значений: разрешить / блокировать на страницах с рекламой / блокировать («Запретить обучение ИИ» — четвёртый вариант, доступный только для обучения). Рабочий robots.txt должен показывать управляемый Cloudflare раздел со списком конкретных user agent и строк Disallow / Content-Signal, если Bot Preference Sync или управляемый robots.txt включены.
Проверка качества: убедитесь, что все три настройки соответствуют тому, что вы действительно имеете в виду, а не тому, что за вас предположила миграция. Заявленная логика миграции Cloudflare для существующих клиентов: если вы ранее включали старый переключатель «Block AI», вас перевели в состояние обучение = запретить обучение ИИ, поиск остался на «разрешить», агент установлен в «блокировать на страницах с рекламой». Если вы ранее ставили само обучение на «блокировать» или «блокировать на страницах с рекламой», вас перевели в «запретить обучение ИИ». Оба пути миграции исходят из того, что вы хотели сохранить поиск. Если же вы хотели убрать краулеры смешанного назначения полностью, включая поиск, то сейчас у вас не это, и нужно явно выбрать «блокировать».
Путь восстановления: если в настройках безопасности виден только один старый переключатель «Block AI Bots» без разбивки на три категории, значит аккаунт ещё не мигрировал на новые элементы управления. Ищите «Configure AI bot policies» — отдельную, более новую поверхность настроек; именно там в дальнейшем живут детальные элементы управления, рядом со старым переключателем на время перехода.
Шаг 2: Определите политику отдельно для каждой категории, а не одним общим ответом
Это и есть собственно шаг принятия решения. Пройдите по каждой категории отдельно.
Поиск. Его почти никто не блокирует — Cloudflare сообщает, что меньше 1% сайтов выбирают блокировку поисковых ботов, — потому что терять видимость в поиске почти никогда не стоит того. По умолчанию ставьте разрешить, если у вас нет конкретной причины (например, тестовый стенд, архив за платной подпиской) держать сайт вне поисковых индексов.
Агент. Это боты, действующие в реальном времени от имени человека, который прямо сейчас пытается что-то сделать на вашем сайте: проверить цену, завершить бронирование, вытащить факт в ответ чата. Блокировка агентного трафика на монетизируемых и рекламных страницах — обоснование нового значения по умолчанию: визит агента не создаёт того рекламного показа, который создал бы визит человека. Если ваша бизнес-модель зависит от этого человеческого внимания (медиа, контентные сайты с медийной рекламой), блокировать на страницах с рекламой — защитимая позиция. Если же вы предпочитаете, чтобы агенты могли выполнять задачи на вашем сайте даже на рекламных страницах — например, потому что агентный трафик у вас всё равно конвертируется, — выберите разрешить.
Обучение. Здесь и находится настоящее решение, и здесь же терминология путает людей:
- Выберите запретить обучение ИИ, если хотите остановить использование вашего контента для обучения моделей, сохранив присутствие в поисковых продуктах Google, Bing и Apple (с учётом текущего отставания Bing понимайте это как «сегодня сохранено для Google и Apple, отложено для Bing»). Это рекомендованный Cloudflare средний путь, созданный специально для компромисса между поиском и обучением.
- Выбирайте блокировать, только если готовы полностью потерять поисковое сканирование от Googlebot, Bingbot и Applebot как цену за блокировку их поведения в режиме обучения. Теперь это строгий вариант: с 15 сентября блокировка применяется и к краулерам смешанного назначения, чего раньше не было.
- Выбирайте разрешить, только если осознанно согласны на то, что ваш контент обучает ИИ-модели, например потому что хотите максимальной заметности в ИИ-ответах и считаете обучение приемлемой платой за это.
Действие: в Security → Settings → Configure AI bot policies выставьте каждый из трёх списков в соответствии с вашим решением.
Ожидаемый результат: панель управления должна отражать ваш явный выбор по каждой категории и (если включён Bot Preference Sync) начать автоматически публиковать соответствующий блок robots.txt — без ручного редактирования файла.
Проверка качества: перечитайте своё решение по обучению, сверив с одной фразой: «Хочу ли я сохранить видимость в поиске или мне всё равно?» Если сохранить — это «запретить обучение ИИ», а не «блокировать», как бы соблазнительно ни звучало слово «блокировать» для остановки обучения ИИ.
Путь восстановления: если вы выбрали настройку, а поисковый трафик позже упал, проверьте, не выбрали ли вы случайно «блокировать» вместо «запретить обучение ИИ». Это самая частая ошибка, которую здесь совершают против себя: из-за названия «блокировать» звучит как вариант, который «делает больше», но именно для обучения он делает то, чего вы, возможно, не хотите, — лишает и поиска.
Шаг 3: Включите Bot Preference Sync, чтобы robots.txt соответствовал вашим настройкам
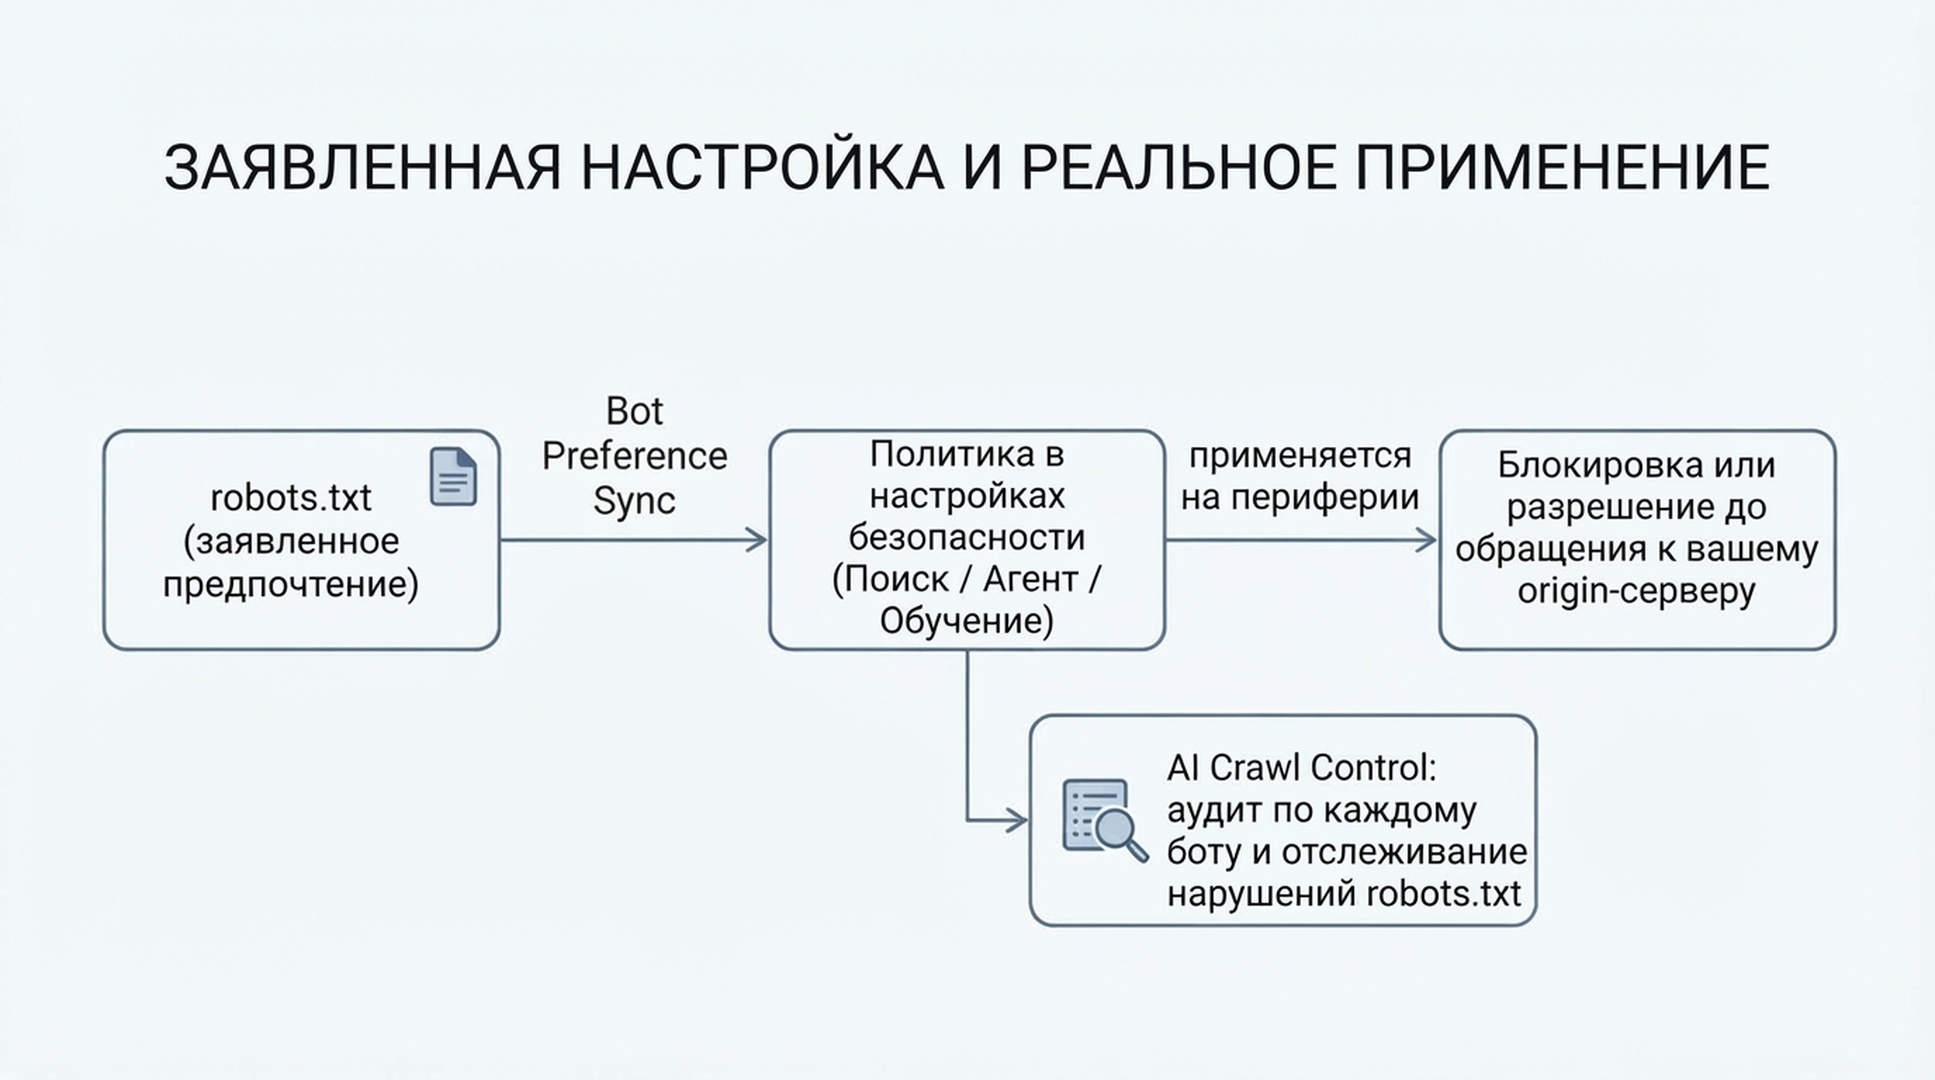
Настройка в панели управления и файл robots.txt — это две разные системы, и когда они расходятся, некоторые краулеры используют это расхождение как повод проигнорировать ваше предпочтение. Bot Preference Sync от Cloudflare закрывает этот разрыв, формируя ваш robots.txt напрямую из выбранных настроек безопасности.
Действие: в той же области настроек политики ИИ-ботов включите Bot Preference Sync (для новых клиентов он включён по умолчанию; существующим клиентам, использующим более старую функцию управляемого robots.txt, при миграции предложат проверить и подтвердить).
Ожидаемый результат: Cloudflare добавляет управляемый блок в начало вашего robots.txt, обёрнутый комментариями # BEGIN Cloudflare Bot Preference Sync / # END, со списком затронутых пользовательских агентов и их правил Disallow — при этом ни одно из ваших собственных правил в robots.txt не удаляется, они остаются ниже управляемого блока.
Проверка качества: запросите /robots.txt снова после включения и убедитесь, что управляемый блок появился и совпадает с выбором из шага 2. Например, если вы поставили обучению «запретить обучение ИИ», вы должны увидеть пользовательских агентов, предназначенных для обучения (Google-Extended, Applebot-Extended), с правилами Disallow, тогда как универсальные Googlebot / Applebot / Bingbot останутся незаблокированными для поиска.
Путь восстановления: если у вас есть разовая особая договорённость с конкретным оператором краулера, которую сломает политика уровня категории (скажем, платное лицензионное соглашение на контент), отключите Bot Preference Sync и правьте свой robots.txt вручную: переключатели категорий рассчитаны на политику для всей зоны, а не на исключения для отдельных операторов.
Шаг 4: Убедитесь, что политика действительно применяется, а не просто запрашивается
robots.txt — это просьба. Технически она не мешает краулеру её проигнорировать. Этот шаг люди пропускают, а именно он показывает, реально ли ваше решение из шага 2 или оно осталось теорией.
Действие: откройте AI Crawl Control для вашей зоны (доступно на всех тарифах, включая бесплатный — качество обнаружения выше на тарифах с Bot Management, но возможности видимости работают везде). Посмотрите вкладку Crawlers: там перечислены все боты, дошедшие до вашего сайта, вместе со столбцом Robots.txt violations.
Ожидаемый результат: таблица ботов с числом запросов и числом нарушений по каждому боту. Ненулевое число нарушений у бота, которому вы поставили «запретить» или «блокировать», означает, что этот бот сейчас игнорирует ваш robots.txt.
Проверка качества: для любого бота с нарушениями посмотрите в «Most popular paths» — с фильтром по отмеченным путям, — что именно он запрашивает, и решите, задевает ли он контент, который вам действительно важно защищать.
Путь восстановления: если бот игнорирует заявленное предпочтение, один robots.txt его не остановит. Используйте действие «Enforce robots.txt rules» в AI Crawl Control (иногда называемое по внутреннему имени Robotcop), чтобы преобразовать заявленные правила в реальное правило WAF, которое блокирует несоблюдающего бота на периферии Cloudflare до того, как он дойдёт до вашего origin-сервера. Так вы переходите от просьбы о соблюдении к его принудительному обеспечению. Этот шаг использует WAF, поэтому доступность зависит от наличия WAF на вашем тарифе.
Шаг 5: Решите, монетизировать ли доступ вместо простой блокировки
Если ваше решение по обучению было «без доступа к обучению», у вас есть второй вариант помимо сплошной блокировки: брать за это плату.
Действие: если интересно, запишитесь в закрытую бету Pay Per Crawl от Cloudflare (через страницу регистрации Cloudflare или через вашего менеджера, если вы клиент Enterprise). После включения на уровне аккаунта (Manage Account → Settings → Pay Per Crawl → установите для своего домена Visibility в значение Visible) вы можете задать единую фиксированную цену за запрос для всей зоны и для каждого краулера выбрать: разрешить (бесплатно), взимать плату (по вашей цене) или блокировать.
Ожидаемый результат: когда краулер, аутентифицирующийся через Web Bot Auth (запрос с подписью Ed25519, идентифицирующей краулера), запрашивает страницу, для которой вы установили «взимать плату», он получает ответ HTTP 402 Payment Required с заголовком crawler-price; если он повторит запрос, согласившись платить, или заранее приложит заголовок crawler-max-price, покрывающий вашу цену, он получит контент с заголовком crawler-charged, подтверждающим списанную сумму. Cloudflare выступает как merchant of record и проводит расчёты.
Проверка качества: это работает только против краулеров, которые зарегистрировали платёжные данные в Cloudflare и поддерживают сценарий с 402, — это не универсальный переключатель против всех ботов. Для всех остальных ваша настройка «взимать плату» фактически ведёт себя как блокировка; Cloudflare отмечает, что это всё равно может служить сигналом о вашей готовности к платным отношениям в будущем.
Путь восстановления: функция находится в закрытой бете; если вас не приняли или вы не хотите ждать, «запретить обучение ИИ» или «блокировать» остаются доступными вариантами для тех же краулеров сегодня.
Работа с исключением: что делать, если конкретный ИИ-оператор просит доступ
Вам может поступить входящий запрос — партнёрство, соглашение о цитировании, разговор о лицензировании — от ИИ-компании, желающей явного доступа вопреки политике всей зоны.
Есть два способа дать узкое исключение, не открывая заново всю категорию:
- Переопределение для конкретного краулера в Manage AI crawlers: переведите строку этого бота из «блокировать/взимать плату» в «разрешить», независимо от вашей настройки обучения или агентов на уровне категории.
- Правка robots.txt вручную: если вы отключили Bot Preference Sync (или размещаете исключение вне управляемого блока), можно добавить точечное Allow для этого одного пользовательского агента ниже управляемого Cloudflare раздела.
В любом случае оставляйте политику категорий для всей зоны значением по умолчанию, а именованные исключения считайте осознанными задокументированными решениями — а не наоборот.
Проверьте готовый результат
Пройдите по этому контрольному списку, когда конфигурация вступит в силу:
- [ ] В настройках безопасности для поиска, агентов и обучения выставлены явные, осознанные значения, а не непроверенные значения по умолчанию
- [ ] В
/robots.txtна рабочем домене виден управляемый Cloudflare блок, соответствующий этим настройкам - [ ] На вкладке Crawlers в AI Crawl Control видны ожидаемые боты, а нарушения у всего, что вы поставили на «блокировать/запретить», равны нулю или близки к нему
- [ ] Если вы выбрали «запретить обучение ИИ», вы убедились (через Search Console / Bing Webmaster Tools или просто наблюдая за органическим трафиком), что поисковое сканирование от Googlebot / Applebot продолжается как обычно
- [ ] Если вы включили принудительное применение robots.txt (Robotcop), полученное правило WAF развёрнуто и активно, а не просто создано и оставлено черновиком
- [ ] Вы задокументировали, какую настройку выбрали и почему, чтобы будущий пересмотр не начинался с нуля
Поддерживайте результат
Это не конфигурация «настроил и забыл». Возвращайтесь к ней в лёгком режиме:
- Раз в месяц: проверяйте вкладку Metrics в AI Crawl Control на предмет новых ботов, для которых вы не определили политику, и перепроверяйте число нарушений.
- Когда Bing выпустит поддержку настройки обучения для Bingbot (по словам Microsoft, цель — начало 2027 года), переоцените, даёт ли ваша текущая конфигурация всё ещё тот результат, который вы задумывали: поиск сохранён, обучение заблокировано. Это как раз момент, когда Bing догонит текущее поведение Google и Apple.
- Всякий раз, когда меняется ваш статус рекламной монетизации — добавление или удаление медийной рекламы меняет то, под какое значение по умолчанию попадают ваши страницы, и стоит заново убедиться, что ваши явные настройки всё ещё осмысленны в этих условиях.
Частые вопросы
Блокировка обучающих краулеров навредит моим позициям в SEO? Нет, если вы используете «запретить обучение ИИ», а не «блокировать». Запрет обучения ИИ создан специально для того, чтобы подотчётные краулеры смешанного назначения (Google, Apple, а со временем Bing) продолжали сканировать для поиска, пропуская обучение. Обычная же блокировка теперь блокирует и поисковое поведение этих самых краулеров, что навредит вашей видимости в их поисковых продуктах.
У меня уже был включён «Block AI Bots» до 15 сентября. Что стало с моей настройкой? Cloudflare перенесла её автоматически: старый Block AI Bots стал обучением = запретить обучение ИИ, поиск = разрешить, агент = блокировать на страницах с рекламой. Проверьте по шагу 1 выше, что это действительно применилось как ожидалось, вместо того чтобы предполагать, что миграция совпала с вашими намерениями.
Что-то из этого доступно на бесплатном тарифе? Да. AI Crawl Control, настройки категорий «поиск/агент/обучение» и Bot Preference Sync доступны на всех тарифах, включая бесплатный. Часть деталей применения зависит от тарифа: например, принудительное применение robots.txt работает через WAF, а обнаружение ботов на бесплатном тарифе опирается на строки user agent, а не на более продвинутый идентификатор обнаружения Bot Management.
В чём разница между AI Crawl Control и настройками безопасности для ИИ-ботов? Настройки безопасности — это место, где вы задаёте политику (разрешить / блокировать на страницах с рекламой / блокировать / запретить обучение ИИ по каждой категории). AI Crawl Control — это место, где вы проводите аудит того, что происходит на самом деле: число запросов по каждому боту, нарушения robots.txt, детализация по путям, — и где можно преобразовать заявленную политику robots.txt в применяемое правило WAF.
Нужно ли мне вручную править robots.txt после настройки этих параметров? Нет, если включён Bot Preference Sync: он сам записывает и поддерживает нужный блок robots.txt на основе ваших настроек в панели. Ручная правка нужна только для пользовательских исключений для отдельных операторов вне управляемых категорий.
Автор: Julian Mercer, технический SEO-специалист с 14-летним опытом в Auspia. Пишет о сканируемости, разметке, рендеринге и технических основах контента, читаемого ИИ.