Трекер видимости в ИИ звучит просто. Задаёте ассистенту несколько отраслевых вопросов, отмечаете, появился ли ваш бренд, и рисуете график по времени.
Проблема находится выше по потоку от записи. То, что вы измеряете, не стоит на месте. Отправьте один и тот же запрос одной и той же модели дважды — и получите два ответа, которые пересекаются лишь частично. Запишите один из них, и вы запишете одну выборку из распределения, а затем подадите её как факт.
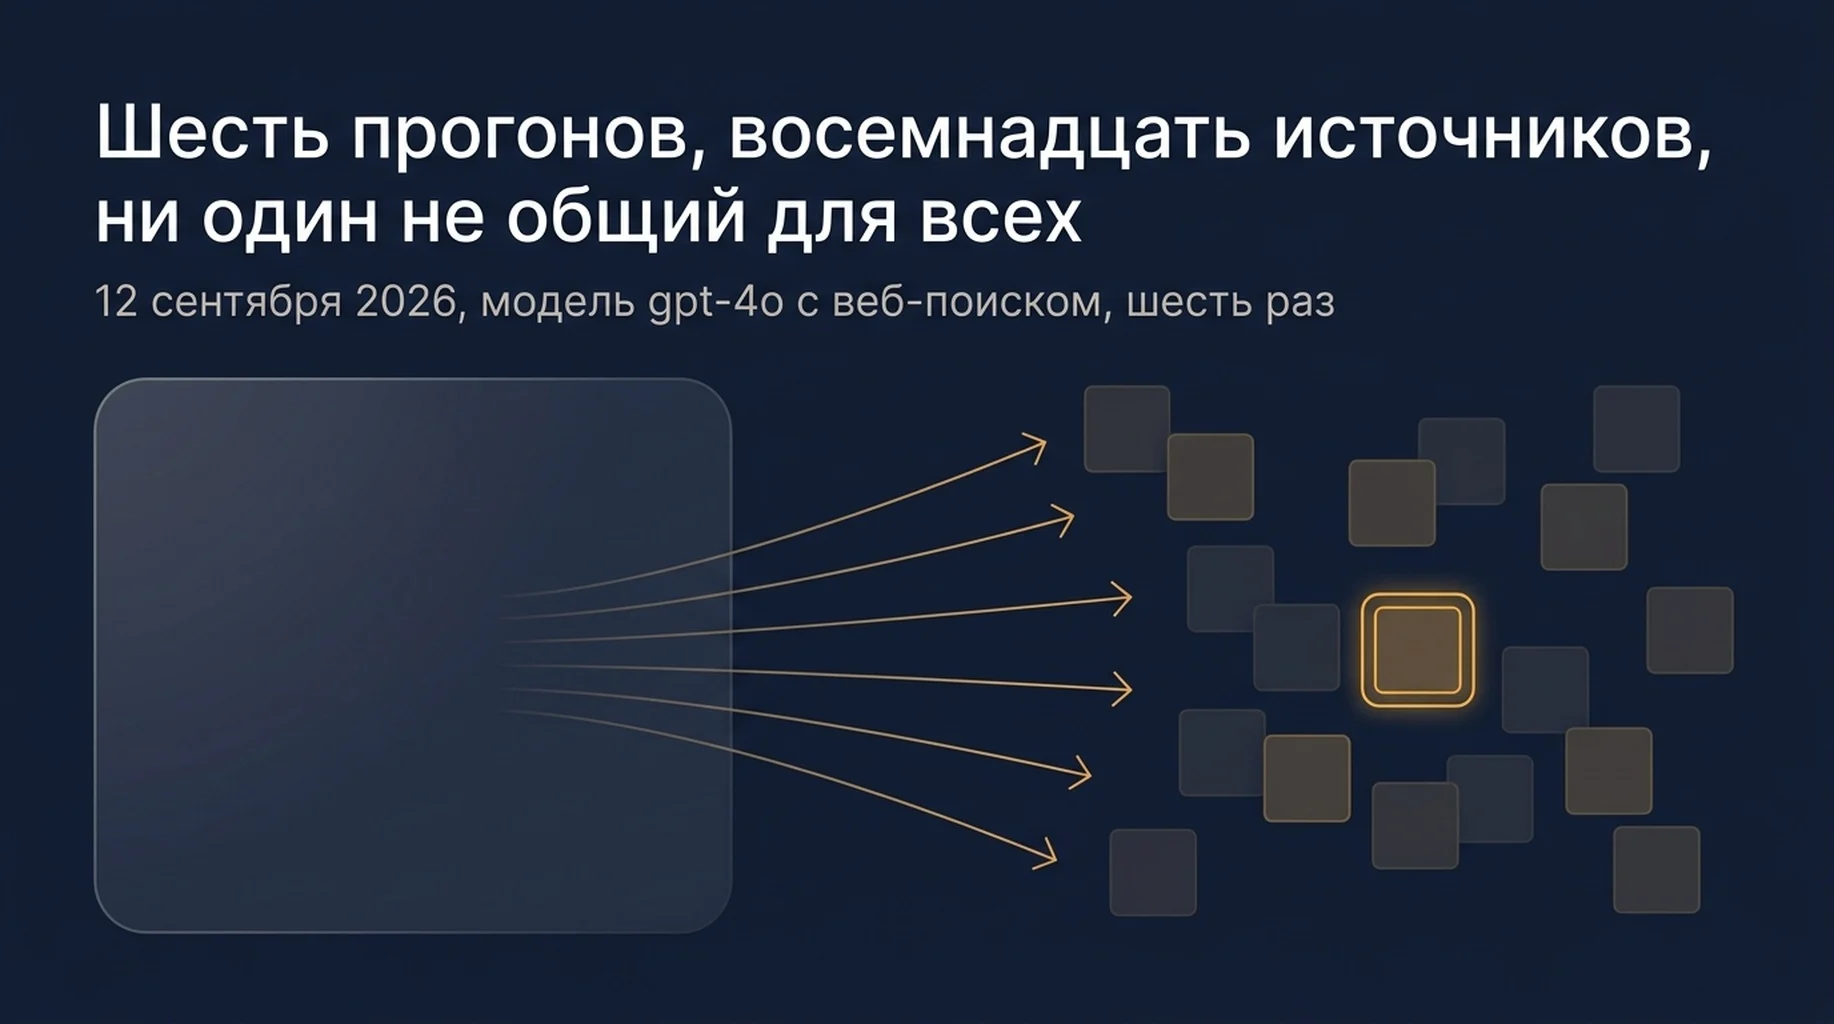
Мы хотели узнать, насколько велик разброс на самом деле, поэтому провели эксперимент, а не предположили. Короткая версия: шесть идентичных запросов дали восемнадцать процитированных источников, и ни один источник не был процитирован во всех шести.
Эта статья о том, что мы запускали, что получили, и о четырёх полях, которые трекер видимости в ИИ обязан хранить, чтобы цифра стоила взгляда и в следующем месяце.
Что мы запускали
Два эксперимента, оба на запросах, которые команда SaaS действительно использовала бы для изучения категории.
Эксперимент 1: один запрос, одна модель, шесть прогонов. Модель gpt-4o, веб-поиск включён, США, английский. Запрос: «Какие инструменты отслеживания позиций лучше всего подходят небольшой SaaS-команде в 2026 году? Дайте короткий список с источниками». Шесть отдельных живых вызовов, выполненных подряд в одном окне сессии.
Эксперимент 2: две модели, тот же запрос, по три прогона. Тот же запрос отправлен в Claude Sonnet 5 и Gemini 3.8 Flash, по три раза каждой, без веб-поиска. Без поиска мы измеряем, какие продукты модель называет из собственных знаний, а это отдельный сигнал от того, какие источники она цитирует.
Мы также отправили второй запрос по тому же пути веб-поиска четыре раза, чтобы понять, одинаково ли ведёт себя цитирование на разных типах вопросов: «Как отслеживать AI Overviews для своего сайта? Дайте конкретные методы с источниками».
Шесть прогонов — не большая выборка, и мы относимся к ней соответственно. Её достаточно, чтобы показать направление и примерный масштаб разброса, и в этом весь смысл.
Результат 1: восемнадцать источников, ноль общих для всех шести прогонов
Шесть прогонов с веб-поиском вместе процитировали 18 разных URL. Вот как часто встречался каждый домен.
Число цитирований (из 6 прогонов) | Домены |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Ни один домен не был процитирован во всех шести прогонах. Ни один URL не был процитирован во всех шести прогонах.
Важная цифра здесь — пересечение между прогонами. При сравнении каждой пары прогонов среднее пересечение Жаккара по процитированным URL составило 0,167. В двух парах из пятнадцати пересечение было ровно нулевым, то есть те два ответа не разделили ни одного источника.
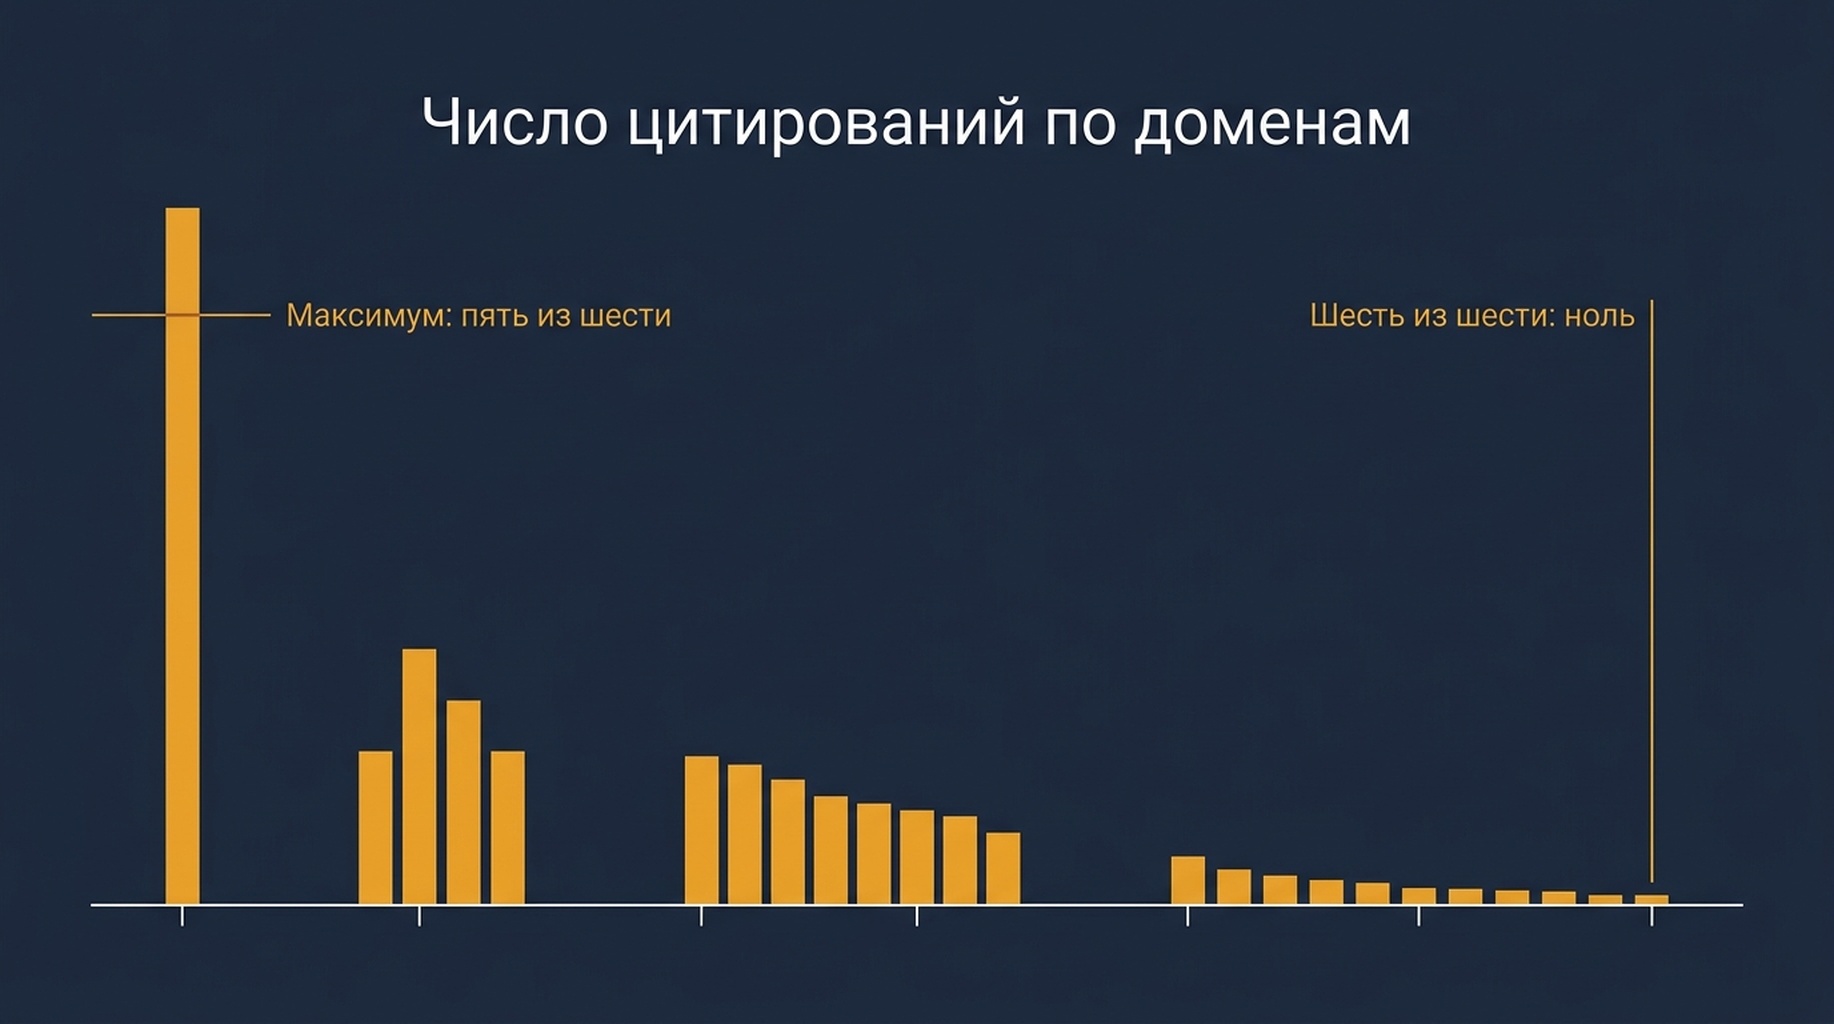
Источник, процитированный в пяти прогонах из шести, — это потолок, который мы наблюдали. Ничего не было процитировано каждый раз.
В той таблице спрятана вторая находка. Домены, до которых модель дотянулась, в большинстве своём не известные в этой категории сайты-сравнения. Девять из восемнадцати доменов появились ровно один раз, и некоторые из них — небольшие сайты, содержание которых читается как собранное под запрос, а не как результат репортажа. Для бренда это палка о двух концах. Это значит, что слот цитирования отвоевать легче, чем место в традиционном рейтинге «лучших инструментов». Это также значит, что слот занимает тот, кто сделал страницу, подошедшую под форму запроса в том прогоне, и в следующем прогоне он заполнится заново.
Результат 2: сам ответ меняет размер
Цитаты двигались, и длина ответа двигалась вместе с ними.
Прогон | Выходных токенов | Длина ответа | Стоимость прогона |
|---|---|---|---|
1 | 505 | 2 153 символа | $0,0735 |
2 | 860 | 3 728 символов | $0,0770 |
3 | 1 108 | 4 746 символов | $0,0797 |
4 | 832 | 3 555 символов | $0,0765 |
5 | 870 | 3 547 символов | $0,0772 |
6 | 813 | 3 544 символа | $0,0768 |
Длина вывода колебалась от 505 до 1 108 токенов, разброс 603 токена — около 73 процентов от среднего. Самый длинный ответ более чем вдвое превышал самый короткий. Пять прогонов из шести попали в довольно узкую полосу от 813 до 1 108 токенов; один прогон остановился рано на 505 и процитировал пять источников вместо девяти-четырнадцати.
Для измерения это важно вполне конкретно. Если ваш трекер фиксирует «появился ли бренд в ответе и на какой позиции», то у короткого прогона меньше мест, где можно появиться. Команда, которая берёт выборку раз в неделю и случайно вытянула короткий прогон, запишет худший результат, чем команда, вытянувшая длинный прогон, — при том что на сайте ничего не изменилось.
Результат 3: некоторые запросы вообще не получают цитирований
Второй запрос, про отслеживание AI Overviews, прошёл тем же путём веб-поиска четыре раза и вернул ноль цитирований в каждом прогоне.
Прогон | Выходных токенов | Длина ответа | Цитирований |
|---|---|---|---|
1 | 479 | 2 135 символов | 0 |
2 | 522 | 2 240 символов | 0 |
3 | 534 | 2 312 символов | 0 |
4 | 497 | 2 228 символов | 0 |
Ответы были стабильны по длине и менялись лишь на 8 процентов за четыре прогона. Но модель отвечала из собственных знаний и не назвала ни одного источника, так что записывать в столбец цитирований было нечего.
Отсюда возникает конкретное и вводящее в заблуждение показание трекера. Панель доли цитирований покажет по этому вопросу ноль, и это выглядит как провал видимости. Это не так. Это форма вопроса, которая не запускает поиск источников. Правильное показание — «цитирование неприменимо», и трекер, который не может отличить это от «цитирование проверено, и вас не было», отправит вас гоняться за проблемой, которой не существует.
Результат 4: смена модели — это другое измерение, а не повтор
С выключенным веб-поиском мы измерили, какие продукты называет каждая модель. Это изолирует собственный набор рекомендаций модели от всего, что вернул индекс поиска в ту минуту.
Claude Sonnet 5 называл от четырёх до пяти продуктов за прогон. За три прогона он назвал шесть разных продуктов: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat и SerpWatcher. Три из них появились во всех трёх прогонах: AccuRanker, Ahrefs и SEMrush. Среднее попарное пересечение — 0,587.
Gemini 3.8 Flash называл от двух до пяти продуктов за прогон. За три прогона он назвал семь разных продуктов: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush и Wincher. Только один из них, SE Ranking, появился во всех трёх прогонах. Среднее попарное пересечение — 0,306.
Между двумя моделями четыре продукта были названы обеими, а пять — только одной.
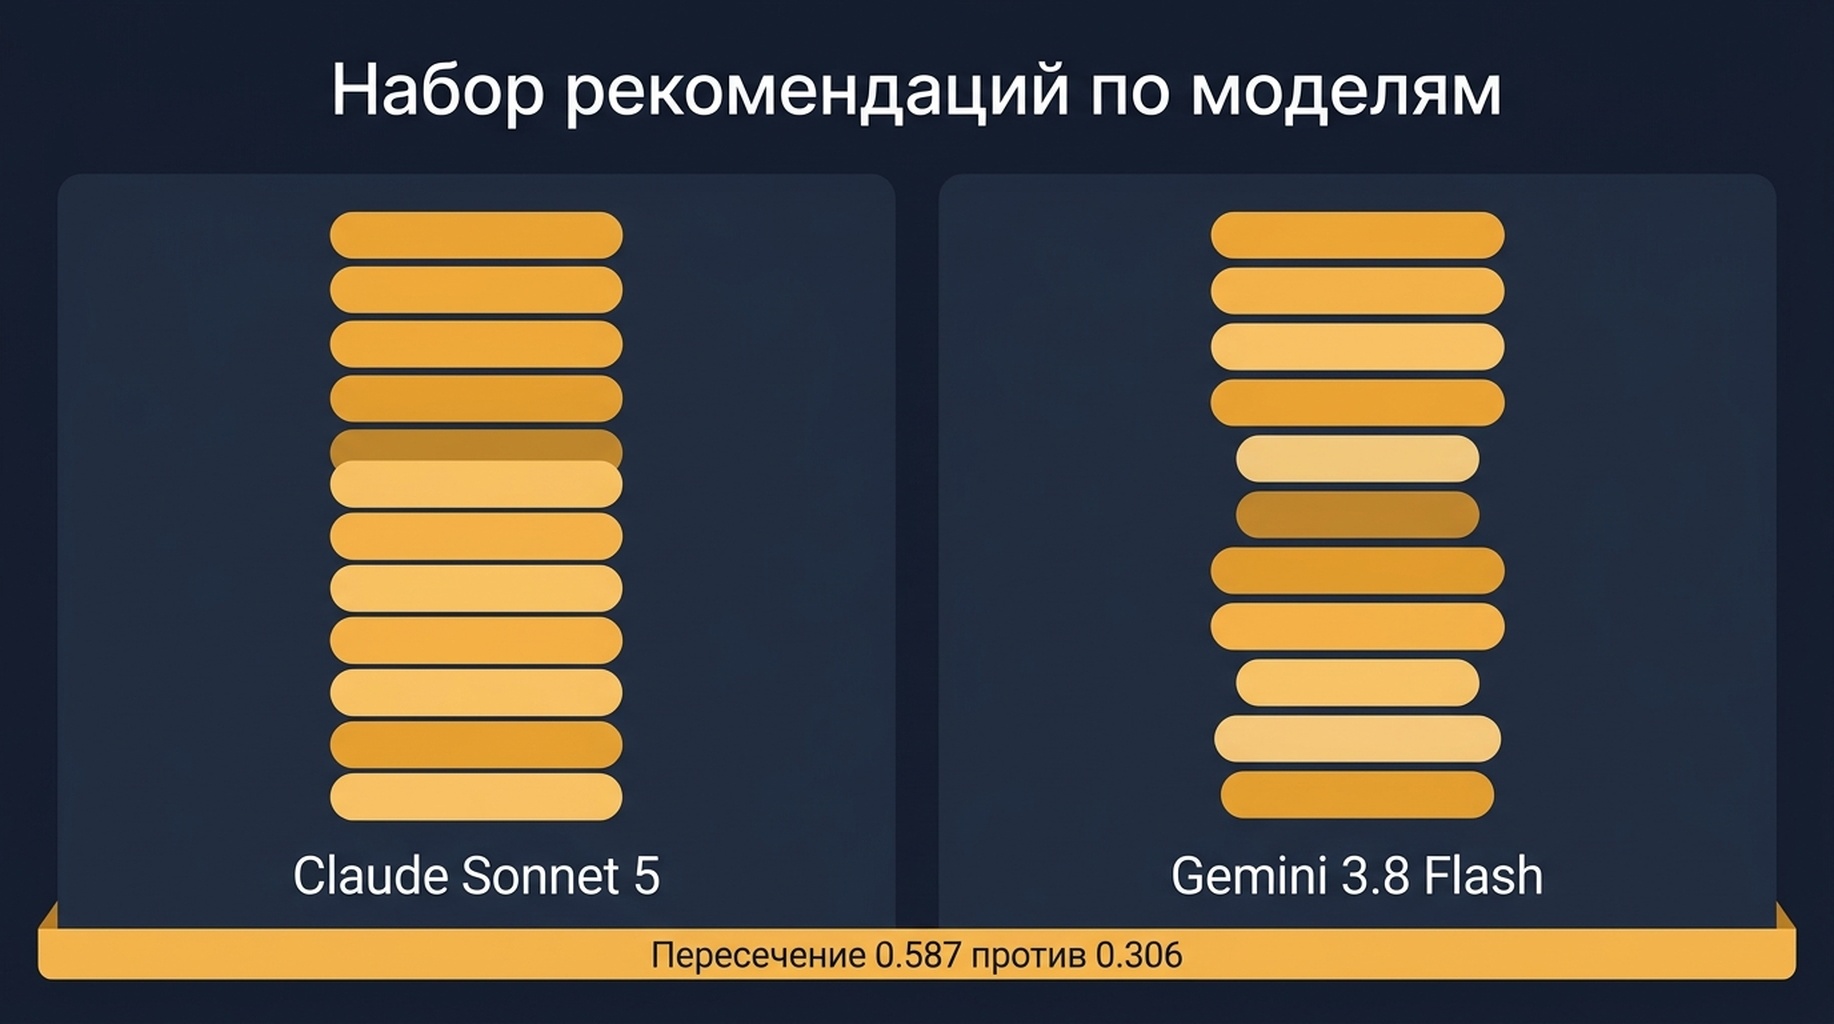
Один и тот же вопрос даёт частично разный набор рекомендаций на каждой модели и в каждом прогоне.
Практический вывод: если вы отслеживаете «видимость в ИИ» как одно число, вы усредняете как минимум по двум независимым источникам разброса — прогону и модели. Бренд, который стабильно появляется у одного ассистента и не появляется у другого, — это настоящая находка, под которую можно что-то предпринять. Бренд, чьё измерение по одной выборке сдвинулось на две позиции, — это шум.
Что должен записывать трекер видимости в ИИ
Четыре поля превращают скриншот в измерение.
Число прогонов, а не результат прогона. Храните каждый прогон и сообщайте диапазон. «Процитирован в 4 прогонах из 6» — это факт. «Процитирован, позиция 3» — это случайность. Шесть прогонов — разумный минимум для небольшой программы; двенадцать лучше, если запрос коммерчески важен.
Поле цитирования отдельно от поля упоминания. «Модель рекомендовала нас» и «модель сослалась на нас» — разные результаты с разными способами починки. Наши шесть прогонов дали 18 цитирований из 18 разных URL; трекер, который записывает только упоминания бренда, не поймал бы из этой чехарды ничего.
Состояние канала ответа. Записывайте, использовал ли прогон веб-поиск вообще, и длину ответа. Прогон с нулём цитирований и прогон с нулём упоминаний выглядят на панели одинаково и означают противоположное.
Текст запроса дословно, с номером версии. Формулировка запроса определяет, какие источники подтягиваются. Если запрос меняется от месяца к месяцу, линия тренда рвётся. Версионируйте запрос так же, как версионируете скрипт отслеживания.
Как построить цикл прогонов
Ручная проверка не выдерживает одного столкновения с календарём. Цикл — это скрипт, который прогоняет запрос N раз, сохраняет каждый сырой ответ вместе с его цитированиями и сравнивает текущее окно с предыдущим.
Это хорошо подходит агенту, потому что работа повторяющаяся, ограничена правилами и требует письменного журнала. В Claude Code или Codex полезная инструкция — оставлять сырые прогоны на диске и никогда их не перезаписывать, а затем отчитываться сводной таблицей, а не одним числом. Если вы уже тянете данные Search Console и Bing через серверы MCP, та же сессия может держать журнал цитирований рядом с данными показов — и именно там две цифры начинают быть полезны вместе. Наши заметки о том, что эти серверы раскрывают, — в разборе что на самом деле делают четыре сервера SEO MCP, а сторона присутствия той же проблемы — в нашем снимке AI Overview по сорока запросам.
Одно правило дизайна важнее остальных: вывод трекера должен быть распределением. Сообщайте «процитирован в 4 из 6», а не «процитирован». Сообщайте список источников, а не источник номер один. Любая панель, которая сжимает шесть прогонов в одно число, выбросила единственную информацию, которую купили дополнительные прогоны.
Если цель — сравнение с конкурентами, а не мониторинг, то лучше подойдёт цикл отслеживания позиций во времени, а компромиссы между источниками данных разобраны в как собрать трекер позиций из двух источников.
Ограничения выборки из шести прогонов
Три честные оговорки.
Выборка мала. Шесть прогонов очерчивают разброс лишь грубо. Они устанавливают, что пересечение между прогонами частичное и что пары с нулевым пересечением случаются; доверительного интервала для вашей категории они не дают.
Результаты привязаны ко времени. Эти прогоны были сделаны 12 сентября 2026 года против живых моделей. И модели, и результаты поиска под ними меняются.
Процитированные домены — это выборка по одному коммерческому запросу. Другая форма вопроса, например сравнительный вопрос или вопрос «как сделать», даст другой паттерн цитирования. Полезный ход — прогнать тот же дизайн по десяти вашим самым коммерчески важным запросам и записать, как ведёт себя ваша категория.
Частые вопросы
Сколько прогонов нужно, прежде чем цифра видимости в ИИ станет осмысленной? Шесть — практический минимум для одного запроса, и число следует сообщать как количество из общего числа прогонов, а не как позицию. Если запрос определяет решения о выручке, двенадцать прогонов дадут более плотное показание за несколько долларов.
Значит ли это, что отслеживать видимость в ИИ не стоит? Это значит, что не стоит отслеживать по одной выборке. Разброс и есть находка. Трекер, который сообщает «процитирован в 4 из 6 прогонов, источники сместились на 12 доменов с прошлого месяца», описывает реальную систему, в которой соревнуется конкурент.
Почему один запрос вернул ноль цитирований? Модель ответила из собственных знаний вместо поиска источников. Это свойство вопроса, а не провал вашего сайта. Отслеживайте это как неприменимое, а не как ноль.
Стоит ли отслеживать ChatGPT, Claude и Gemini по отдельности? Да. В нашем сравнении по три прогона две модели пересеклись лишь в четырёх из девяти названных продуктов. Усреднение скрывает решение на уровне программы о том, какого ассистента оптимизировать первым.
Можно ли уменьшить разброс, понизив температуру модели? Частично, и это стоит проверить на своих запросах. Но на набор цитат влияет ещё и поисковый индекс, а им вы не управляете. Число прогонов — более надёжный рычаг.
Взгляд Auspia: если вы в этом квартале строите отслеживание видимости в ИИ, сначала постройте журнал прогонов, а потом панель. Панель — это выбор отображения. Журнал прогонов — это измерение. Начните с десяти запросов, по шесть прогонов каждый, с дословным хранением — и за неделю узнаете больше, чем расскажет целый год проверок по одной выборке.
Автор: Ethan Marlowe, руководство измерением GEO на более чем 500 запросами в Auspia. Пишет об отслеживании запросов, отчётах о цитировании и панелях видимости, которые выдерживают столкновение с реальным циклом измерений.