Um rastreador de visibilidade em IA parece simples. Você faz algumas perguntas de categoria a um assistente, anota se a sua marca apareceu e desenha isso num gráfico ao longo do tempo.
O problema está a montante do registro. Aquilo que você mede não fica parado. Envie o mesmo prompt ao mesmo modelo duas vezes e você recebe duas respostas que se sobrepõem apenas em parte. Registre uma delas e você registrou uma amostra de uma distribuição, para depois apresentá-la como fato.
Queríamos saber o tamanho real dessa dispersão, então rodamos o experimento em vez de supor. A versão curta: seis solicitações idênticas retornaram dezoito fontes citadas, e nenhuma fonte foi citada nas seis.
Este artigo trata do que rodamos, do que voltou e dos quatro campos que um rastreador de visibilidade em IA precisa armazenar para que o número valha uma segunda olhada no mês que vem.
O que rodamos
Dois experimentos, ambos com prompts que uma equipe de SaaS realmente usaria numa pesquisa de categoria.
Experimento 1: um prompt, um modelo, seis execuções. O modelo gpt-4o, busca na web ativada, Estados Unidos, inglês. O prompt: "Quais são as melhores ferramentas de monitoramento de posição para uma equipe de SaaS pequena em 2026? Dê uma lista curta com fontes." Seis chamadas ao vivo separadas, executadas em sequência na mesma janela de sessão.
Experimento 2: dois modelos, o mesmo prompt, três execuções cada. O mesmo prompt foi enviado ao Claude Sonnet 5 e ao Gemini 3.8 Flash, três vezes cada, sem busca na web. Sem busca, medimos quais produtos o modelo cita de próprio conhecimento, o que é um sinal separado de quais fontes ele cita.
Também enviamos um segundo prompt pelo mesmo caminho de busca na web quatro vezes, para ver se o comportamento de citação é consistente entre tipos de pergunta: "Como faço para monitorar os AI Overviews do meu site? Dê métodos concretos com fontes."
Seis execuções não são uma amostra grande, e tratamos assim. Elas bastam para mostrar a direção e a ordem de grandeza aproximada da variação, e é esse o ponto.
Resultado 1: dezoito fontes, zero compartilhadas pelas seis execuções
As seis execuções de busca na web citaram, somadas, 18 URLs diferentes. Veja com que frequência cada domínio apareceu.
Número de citações (de 6 execuções) | Domínios |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Nenhum domínio foi citado nas seis execuções. Nenhuma URL foi citada nas seis execuções.
O número que importa aqui é a sobreposição entre execuções. Comparando cada par de execuções, a sobreposição de Jaccard média nas URLs citadas foi de 0,167. Em dois dos quinze pares a sobreposição foi exatamente zero, ou seja, aquelas duas respostas não compartilharam nenhuma fonte.
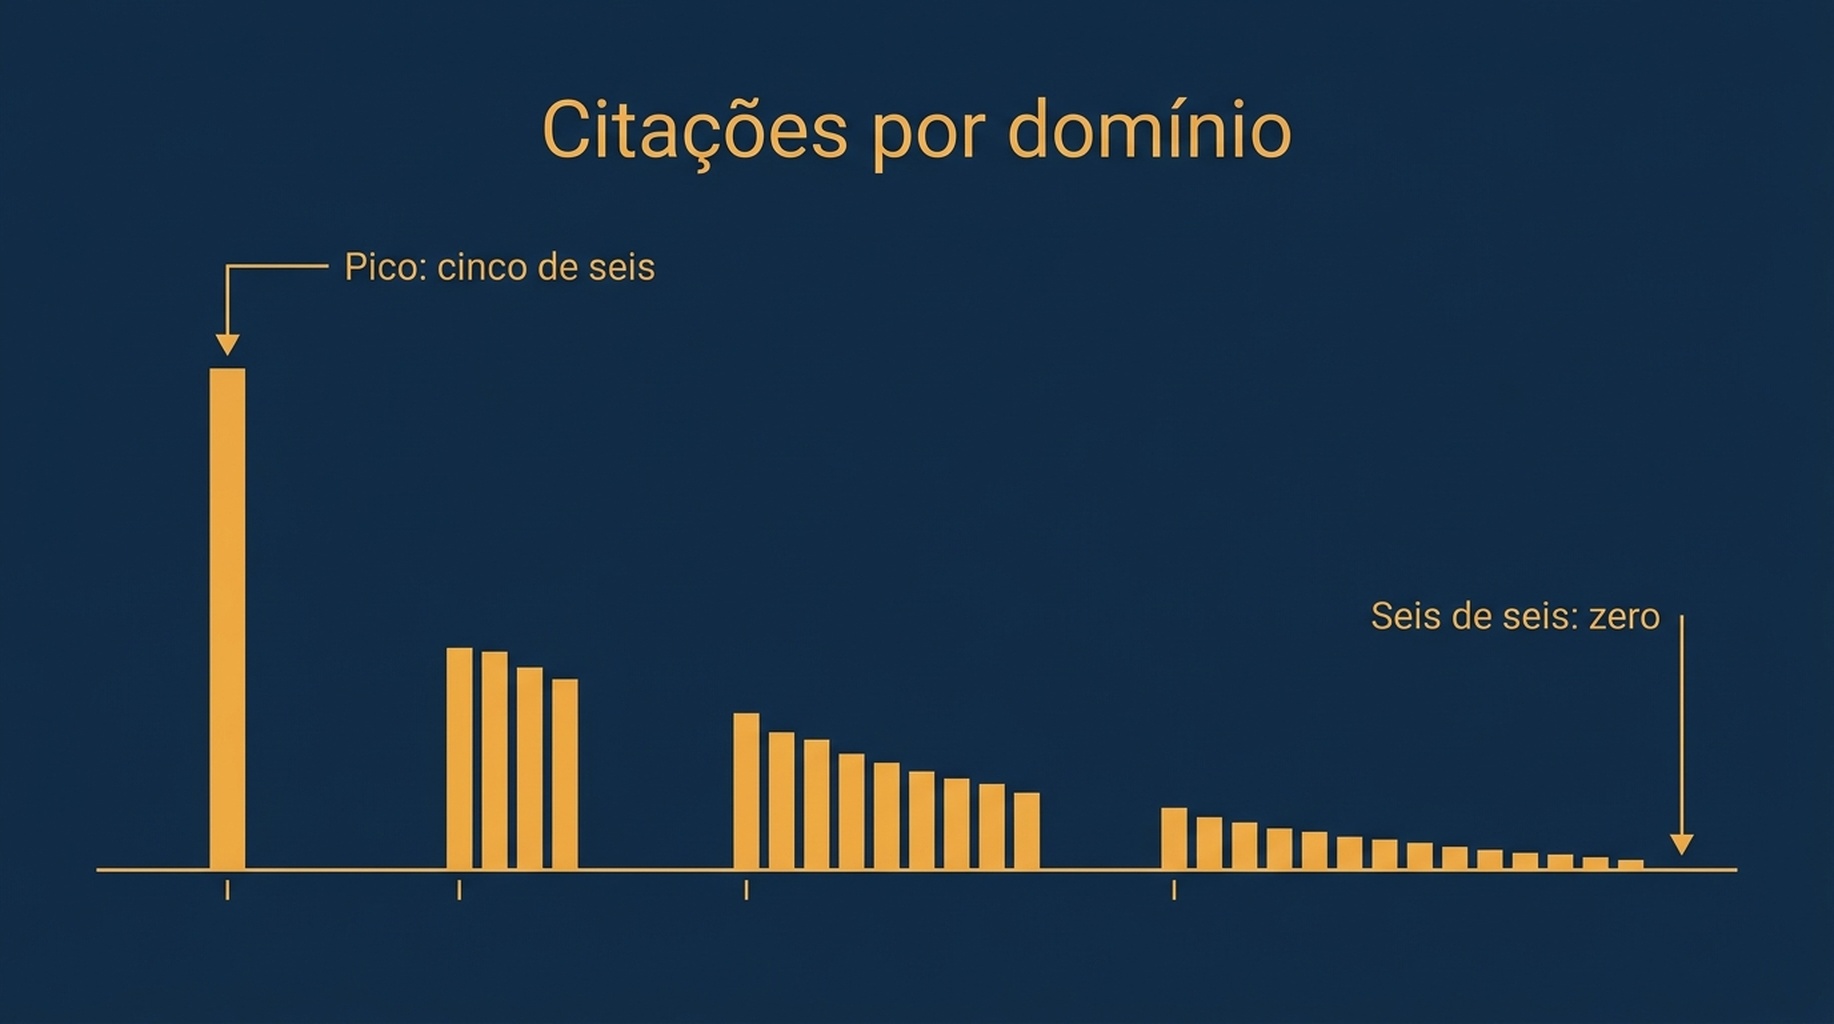
Uma fonte citada em cinco das seis execuções é o teto que observamos. Nada foi citado todas as vezes.
Há um segundo achado enterrado naquela tabela. Os domínios que o modelo alcançou, na maioria, não são os sites de comparação conhecidos da categoria. Nove dos dezoito domínios apareceram exatamente uma vez, e alguns são sites pequenos cujo conteúdo se lê como algo montado para aquela consulta, e não como algo apurado. Para uma marca, isso é uma faca de dois gumes. Significa que a vaga de citação é mais fácil de conquistar do que um ranking tradicional de "melhores ferramentas". Significa também que a vaga está ocupada por quem produziu uma página que se encaixou no formato da consulta naquela execução, e que ela será preenchida de novo na execução seguinte.
Resultado 2: a própria resposta muda de tamanho
As citações se moveram, e o comprimento da resposta se moveu junto.
Execução | Tokens de saída | Comprimento da resposta | Custo da execução |
|---|---|---|---|
1 | 505 | 2.153 caracteres | $0,0735 |
2 | 860 | 3.728 caracteres | $0,0770 |
3 | 1.108 | 4.746 caracteres | $0,0797 |
4 | 832 | 3.555 caracteres | $0,0765 |
5 | 870 | 3.547 caracteres | $0,0772 |
6 | 813 | 3.544 caracteres | $0,0768 |
O comprimento da saída variou de 505 a 1.108 tokens, uma amplitude de 603 tokens, cerca de 73 por cento da média. A resposta mais longa tinha mais que o dobro da mais curta. Cinco das seis execuções ficaram numa faixa bem estreita, entre 813 e 1.108 tokens; uma execução parou cedo, em 505, e citou cinco fontes em vez de nove a catorze.
Para a medição, isso importa de forma específica. Se o seu rastreador captura "a marca aparece na resposta e em que posição", uma execução curta tem menos vagas onde aparecer. Uma equipe que amostra uma vez por semana e por acaso tirou uma execução curta vai registrar um resultado pior do que uma equipe que tirou uma execução longa, sem que nada tenha mudado no site.
Resultado 3: alguns prompts não recebem citação nenhuma
O segundo prompt, sobre monitorar AI Overviews, passou pelo mesmo caminho de busca na web quatro vezes e voltou com zero citações em todas elas.
Execução | Tokens de saída | Comprimento da resposta | Citações |
|---|---|---|---|
1 | 479 | 2.135 caracteres | 0 |
2 | 522 | 2.240 caracteres | 0 |
3 | 534 | 2.312 caracteres | 0 |
4 | 497 | 2.228 caracteres | 0 |
As respostas foram estáveis em comprimento, variando apenas 8 por cento ao longo das quatro execuções. Mas o modelo respondeu com conhecimento próprio e não nomeou nenhuma fonte, então não havia o que registrar na coluna de citações.
Daí sai uma leitura específica e enganosa do rastreador. Um painel de taxa de citação vai mostrar zero para essa pergunta, e isso parece uma falha de visibilidade. Não é. É um formato de pergunta que não dispara busca por fontes. A leitura correta é "citação não se aplica", e um rastreador que não consegue distinguir isso de "a citação foi verificada e você estava ausente" vai fazer você correr atrás de um problema que não existe.
Resultado 4: trocar de modelo é outra medição, não uma repetição
Com a busca na web desligada, medimos quais produtos cada modelo nomeia. Isso isola o conjunto de recomendações do próprio modelo de tudo o que o índice de busca devolveu naquele minuto.
O Claude Sonnet 5 nomeou de quatro a cinco produtos por execução. Ao longo de três execuções, nomeou seis produtos diferentes: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat e SerpWatcher. Três deles apareceram nas três execuções: AccuRanker, Ahrefs e SEMrush. Sobreposição média par a par de 0,587.
O Gemini 3.8 Flash nomeou de dois a cinco produtos por execução. Ao longo de três execuções, nomeou sete produtos diferentes: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush e Wincher. Apenas um deles, o SE Ranking, apareceu nas três execuções. Sobreposição média par a par de 0,306.
Entre os dois modelos, quatro produtos foram nomeados por ambos e cinco foram nomeados por apenas um.
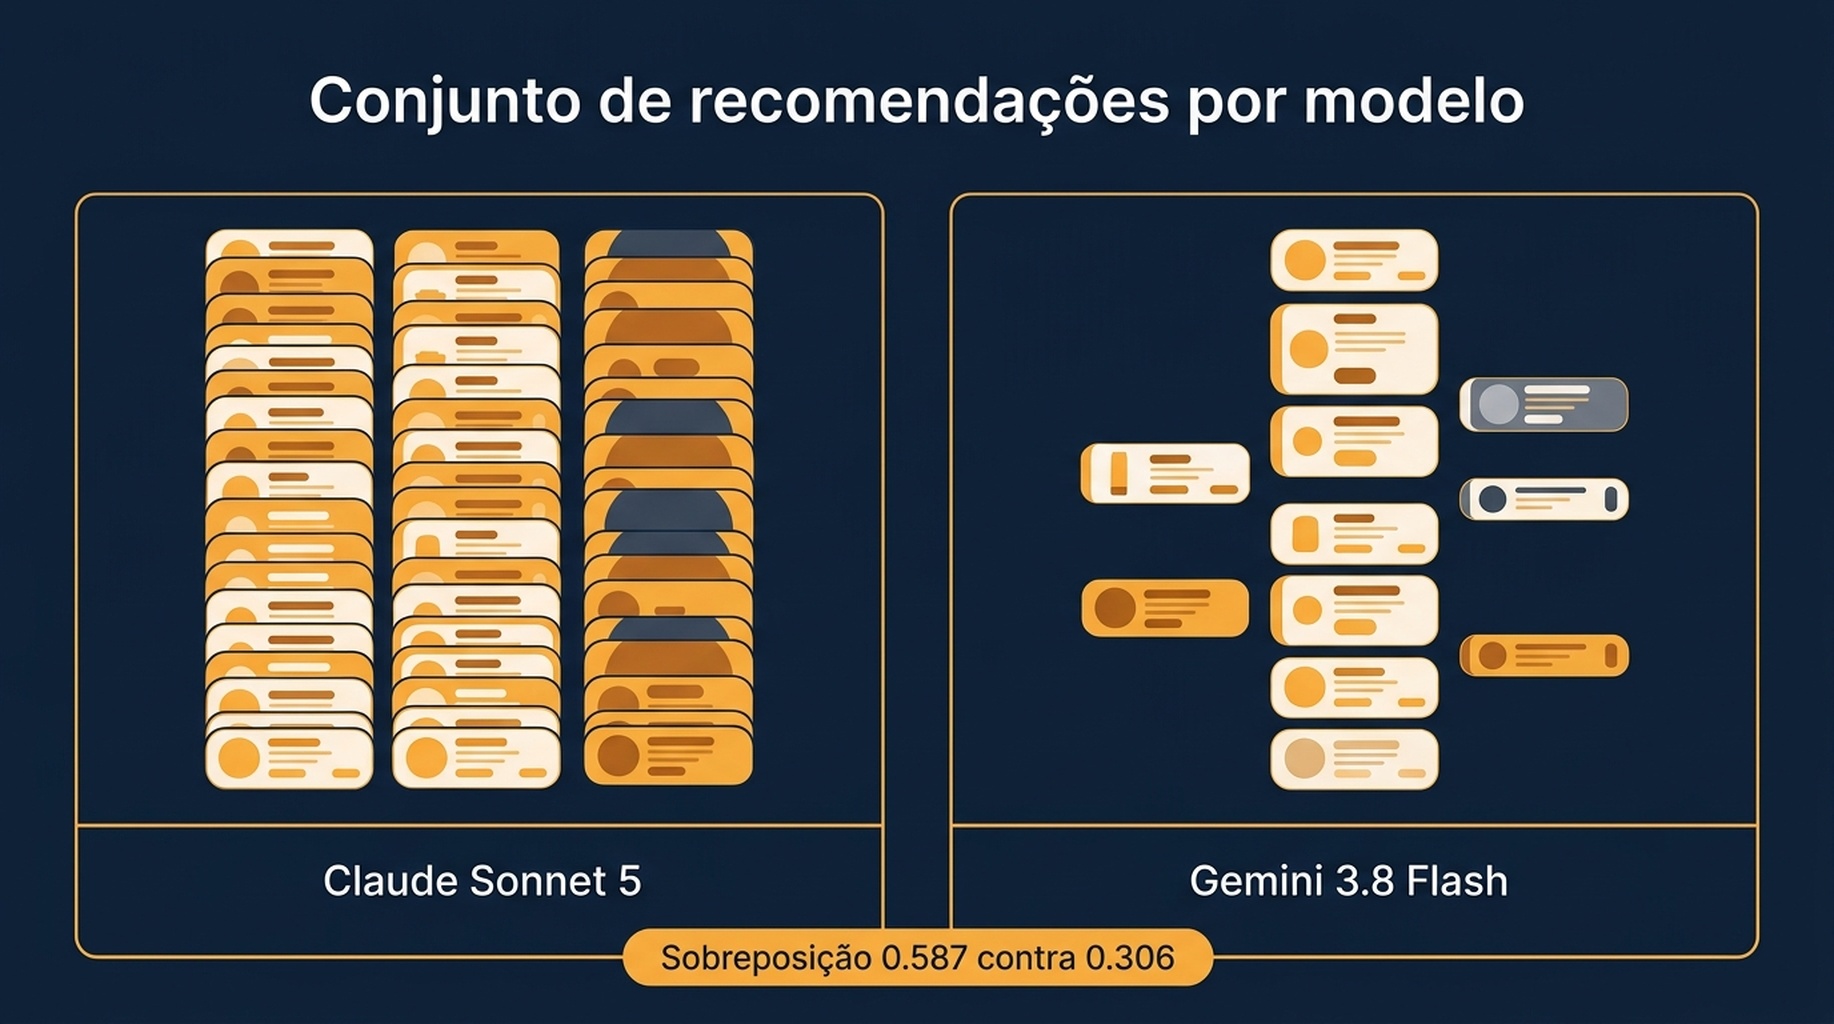
A mesma pergunta produz um conjunto de recomendações parcialmente diferente em cada modelo e em cada execução.
A consequência prática: se você rastreia "visibilidade em IA" como um número único, está tirando a média de pelo menos duas fontes independentes de variação, a execução e o modelo. Uma marca que aparece de forma consistente em um assistente e não aparece em outro é um achado real e acionável. Uma marca cuja medição de amostra única se moveu duas posições é ruído.
O que um rastreador de visibilidade em IA deve registrar
Quatro campos transformam uma captura de tela em uma medição.
O número de execuções, não o resultado da execução. Armazene cada execução e informe o intervalo. "Citado em 4 de 6 execuções" é um fato. "Citado, posição 3" é coincidência. Seis execuções é um piso razoável para um programa pequeno; doze é melhor se o prompt for comercialmente importante.
O campo de citação separado do campo de menção. "O modelo nos recomendou" e "o modelo linkou para nós" são resultados diferentes, com correções diferentes. Nossas seis execuções geraram 18 citações de 18 URLs diferentes; um rastreador que registra apenas menções à marca não teria capturado nada dessa movimentação.
O estado do canal de resposta. Registre se a execução usou busca na web e registre o comprimento da resposta. Uma execução com zero citações e uma execução com zero menções parecem idênticas no painel e significam o oposto.
O texto do prompt, palavra por palavra, com número de versão. A redação do prompt determina quais fontes são puxadas. Se o prompt mudar entre meses, a linha de tendência quebra. Versione o prompt como você versiona um script de monitoramento.
Construindo o ciclo de execução
A verificação manual não sobrevive a um encontro com o calendário. O ciclo é um script que roda um prompt N vezes, armazena cada resposta bruta com suas citações e compara a janela atual com a anterior.
Isso cai bem para um agente, porque o trabalho é repetitivo, limitado por regras e precisa de registro escrito. No Claude Code ou no Codex, a instrução útil é manter as execuções brutas no disco, nunca sobrescrevê-las, e então reportar uma tabela-resumo em vez de um número único. Se você já puxa dados do Search Console e do Bing por servidores MCP, a mesma sessão pode manter o log de citações ao lado dos dados de impressões, e é aí que os dois números começam a ser úteis juntos. Nossas notas sobre o que esses servidores expõem estão em o que quatro servidores de SEO MCP realmente fazem, e o lado da presença do mesmo problema está em nosso instantâneo de AI Overview com quarenta consultas.
Uma regra de projeto importa mais que as outras: a saída do rastreador deve ser uma distribuição. Informe "citado em 4 de 6", não "citado". Informe a lista de fontes, não a fonte número um. Qualquer painel que comprima seis execuções em um número jogou fora justamente a informação que as execuções extras compraram.
Se o objetivo for comparação com concorrentes e não monitoramento, um ciclo de acompanhamento de posições ao longo do tempo é a ferramenta mais adequada, e os trade-offs entre fontes de dados estão em construindo um rastreador de posições com duas fontes.
Limites de uma amostra de seis execuções
Três ressalvas honestas.
A amostra é pequena. Seis execuções delimitam a dispersão de forma frouxa. Elas estabelecem que a sobreposição entre execuções é parcial e que pares com sobreposição zero acontecem; não dão um intervalo de confiança para a sua categoria.
Os resultados são presos ao tempo. Estas execuções foram feitas em 12 de setembro de 2026 contra modelos ao vivo. Tanto os modelos quanto os resultados de busca por baixo deles mudam.
Os domínios citados são uma amostra de um único prompt comercial. Um formato de pergunta diferente, como uma pergunta de comparação ou uma pergunta de "como fazer", vai produzir um padrão de citação diferente. O movimento útil é rodar o mesmo desenho nos seus dez prompts comercialmente mais importantes e registrar como a sua categoria se comporta.
Perguntas frequentes
Quantas execuções eu preciso antes que o número de visibilidade em IA faça sentido? Seis é o piso prático para um único prompt, e o número deve ser informado como uma contagem de execuções, não como uma posição. Se o prompt orienta decisões de receita, doze execuções dão uma leitura mais estreita por alguns dólares.
Isso significa que rastrear visibilidade em IA não vale a pena? Significa que rastrear com amostra única não vale. A variação é o achado. Um rastreador que informa "citado em 4 de 6 execuções, as fontes mudaram em 12 domínios desde o mês passado" está descrevendo um sistema real no qual um concorrente está disputando espaço.
Por que um prompt voltou com zero citações? O modelo respondeu com conhecimento próprio em vez de fazer uma busca por fontes. Isso é uma propriedade da pergunta, não uma falha do seu site. Rastreie como não aplicável, não como zero.
Devo rastrear ChatGPT, Claude e Gemini separadamente? Sim. Na nossa comparação de três execuções, os dois modelos coincidiram em apenas quatro dos nove produtos nomeados. Tirar a média esconde uma decisão de nível de programa sobre qual assistente otimizar primeiro.
Dá para reduzir a variação baixando a temperatura do modelo? Em parte, e vale testar nos seus prompts. Mas o conjunto de citações também é movido pelo índice de busca, e esse você não controla. O número de execuções é a alavanca mais confiável.
Visão da Auspia: se você vai construir rastreamento de visibilidade em IA neste trimestre, construa o log de execuções antes do painel. O painel é uma escolha de exibição. O log de execuções é a medição. Comece com dez prompts, seis execuções cada, armazenados palavra por palavra, e você vai aprender em uma semana mais do que um ano inteiro de verificação de amostra única lhe diria.
Autor: Ethan Marlowe, liderança de medição de GEO em mais de 500 prompts na Auspia. Escreve sobre monitoramento de prompts, relatórios de citação e painéis de visibilidade que sobrevivem ao contato com um ciclo real de medição.