A regra que o Google acabou de escrever
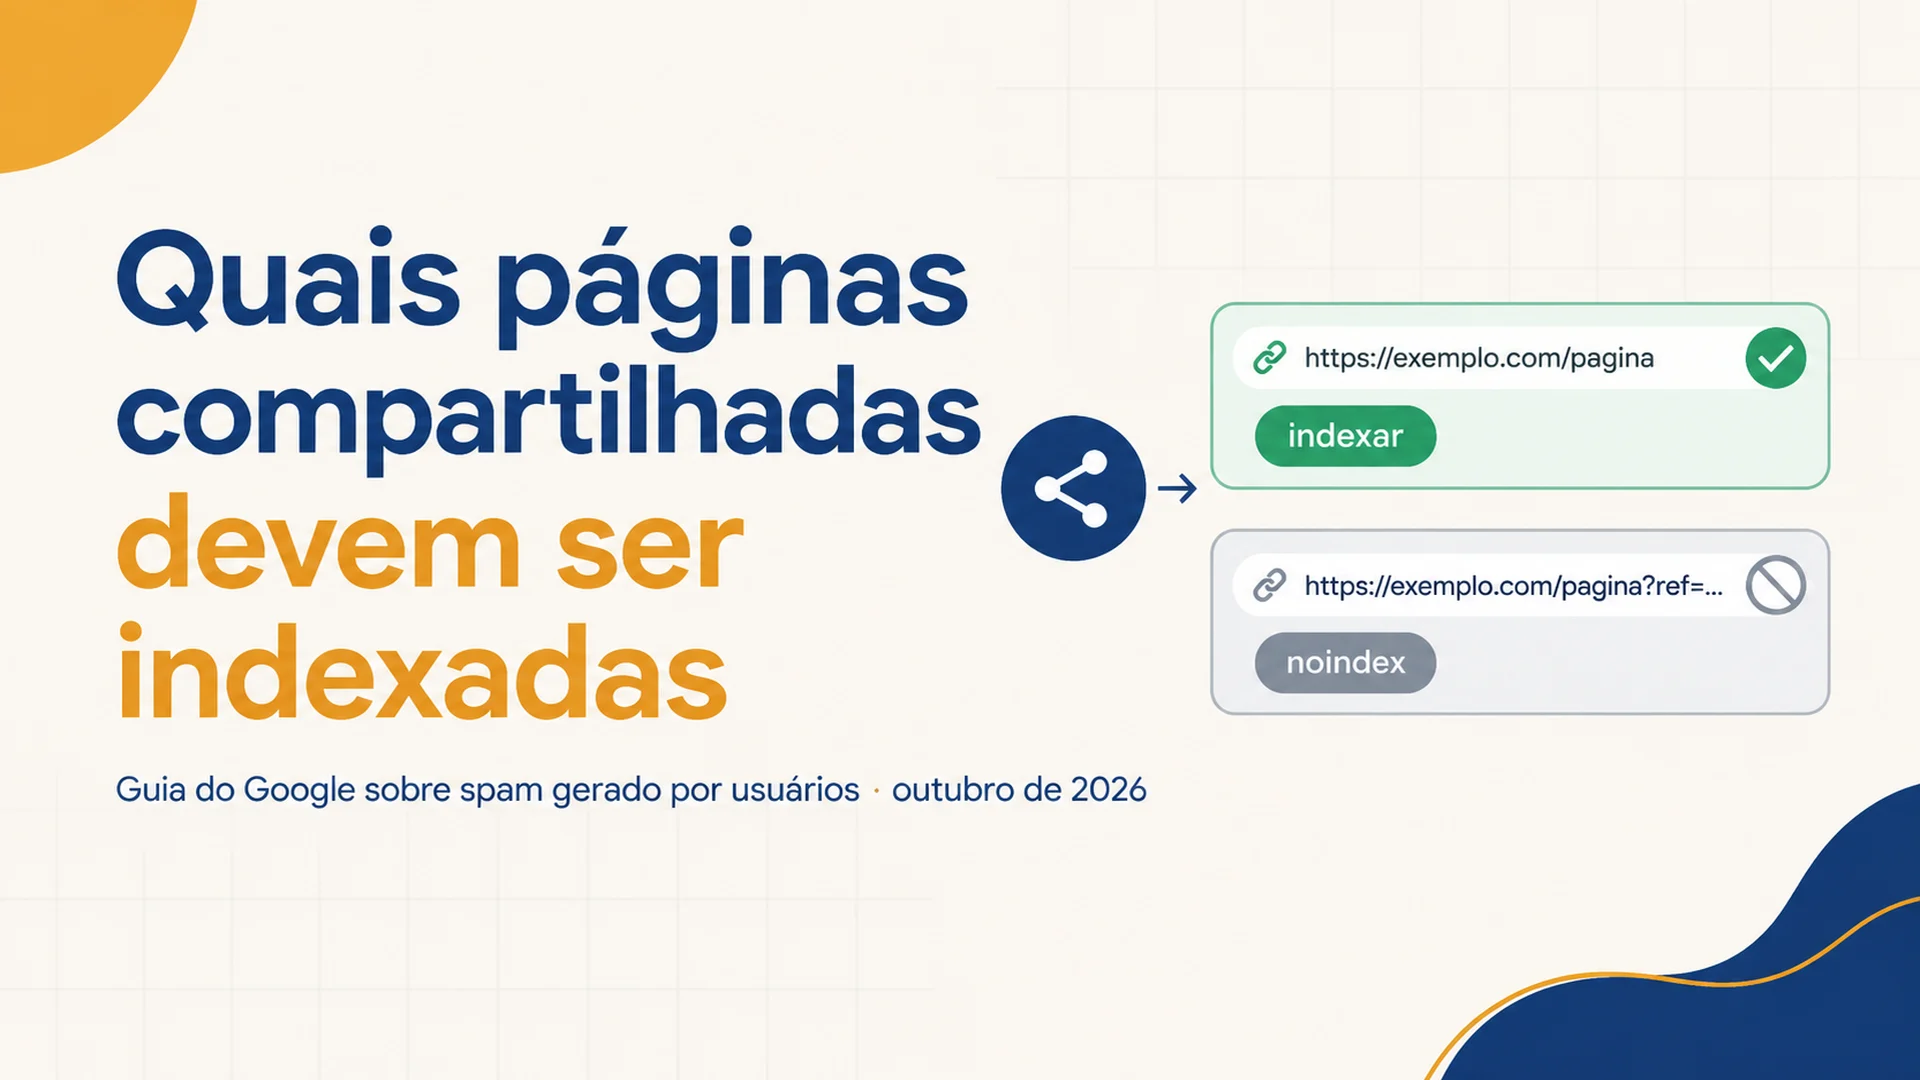
Em 26 de outubro de 2026, o Google adicionou uma seção de dois parágrafos ao seu guia sobre como evitar spam gerado por usuários. É a parte mais curta da página e provavelmente a que vai mudar mais roteiros de produto, porque faz uma pergunta que a maioria das equipes nunca colocou num slide: este URL deveria estar no índice do Google?
A seção se chama "Only index content meant for Search" — indexe apenas conteúdo destinado à busca. Segue na íntegra:
Se o seu serviço permite que usuários criem páginas compartilháveis, saídas geradas ou ferramentas interativas, considere se esse conteúdo foi feito para ser encontrado por mecanismos de busca ou apenas acessado diretamente por quem tem o link.
Quando as páginas são criadas para compartilhamento direto, colaboração ou utilidade, e não para descoberta em busca pública, aplique a regra noindex (com uma meta tag robots ou o cabeçalho HTTP X-Robots-Tag) ou bloqueie o rastreamento no robots.txt por padrão.
O changelog do Google do mesmo dia é mais direto quanto à intenção: o guia foi atualizado com "orientações sobre como bloquear a indexação de conteúdo compartilhado por link e como monitorar abusos no Search Console", para que as plataformas possam "manter fora do índice as páginas criadas por usuários que não se destinam à Busca e detectar spam mais cedo".
É isso. Nenhuma nova ação manual, nenhum anúncio de sistema de ranking, nenhuma lista de penalidades. O que foi recomendado é um padrão — e é dos padrões que vêm a maioria dos acidentes de indexação.
Para quem é isto. Equipes que colocam no ar qualquer URL que um usuário possa gerar: links de compartilhamento, chats salvos, dashboards públicos, prévias de modelos, builds de aplicativos, relatórios gerados, tópicos de fórum, páginas de perfil, páginas de avaliação, páginas de anúncio.
Com o que você termina. Um veredito por rota para cada tipo de URL gerada, o controle que de fato remove a página do índice e uma regra de monitoramento que pega o padrão de abuso descrito pelo Google.
Tempo. De 45 a 90 minutos para uma primeira passagem em um produto. Um dia se você tiver vários geradores de URL e nenhum inventário de rotas.
Pronto se parece com isto. Toda rota gerada marcada como index, noindex ou private. As rotas noindex devolvem a diretiva no servidor, não depois do JavaScript rodar. O Search Console mostra essas URLs como excluídas por noindex, e não como "Indexada, embora bloqueada pelo robots.txt".
O que mudou, e o que só parece novo
Quatro edições importam. O resto da página não mudou, incluindo as orientações de dezembro de 2025, que continuam valendo.
O que o Google mudou | O texto real | Por que importa para você |
|---|---|---|
Escopo do guia | Agora nomeia plataformas de hospedagem "e ferramentas que permitem aos usuários publicar páginas compartilhadas, conteúdo gerado ou web apps" | Lido ao pé da letra, isso cobre exportações de chat com IA, páginas de artefato, construtores de app e ferramentas no-code, não apenas fóruns e comentários |
Unidade do abuso | Spammers podem criar "grande quantidade de páginas ou sites" | O Google fala de volume, não de esperteza. Uma conta abusiva pode cunhar milhares de URLs |
Seção nova | "Only index content meant for Search" | A declaração mais clara até hoje de que noindex é um padrão razoável para conteúdo acessível só por link |
Monitoramento | Verificar o site ou subdomínio no Search Console, acompanhar picos em Indexação de páginas e Desempenho na pesquisa, alertar quando "poucos usuários" produzem "grande parte das URLs indexáveis" | O inchaço de índice ganhou um método de detecção com nome — e normalmente é isso que precede a forma de revisão |
O que não mudou: noindex em publicações de usuários novos até que eles conquistem reputação, e nofollow ou ugc em links dentro de conteúdo não confiável. Se você já faz as duas coisas, está à frente desta atualização.
Vale dizer com clareza, porque a reação no X correu na frente do documento: são orientações para plataformas sobre o próprio estoque de URLs. Não criam uma violação nova para um site de marketing comum e não mudam o ranking de nenhuma página. Mudam o que deveria existir no índice.
Mais um pedaço de contexto explica o timing. No fim de julho de 2026, links de compartilhamento e páginas de artefato do Claude apareceram no índice do Google, e as reportagens da época descreveram prontuários médicos, chaves de API e outros materiais privados expostos antes de a Anthropic fechar a brecha em poucos dias. A mesma cobertura apontou URLs públicas de apps em construtores como Replit e Lovable. O Google raramente escreve uma seção nova para uma hipótese. Esta já tinha acontecido.
A pergunta que decide cada URL gerada
O teste do Google está em uma frase, e dá para aplicá-lo sem adivinhar intenção: este conteúdo foi feito para ser encontrado por mecanismos de busca, ou apenas acessado por quem tem o link?
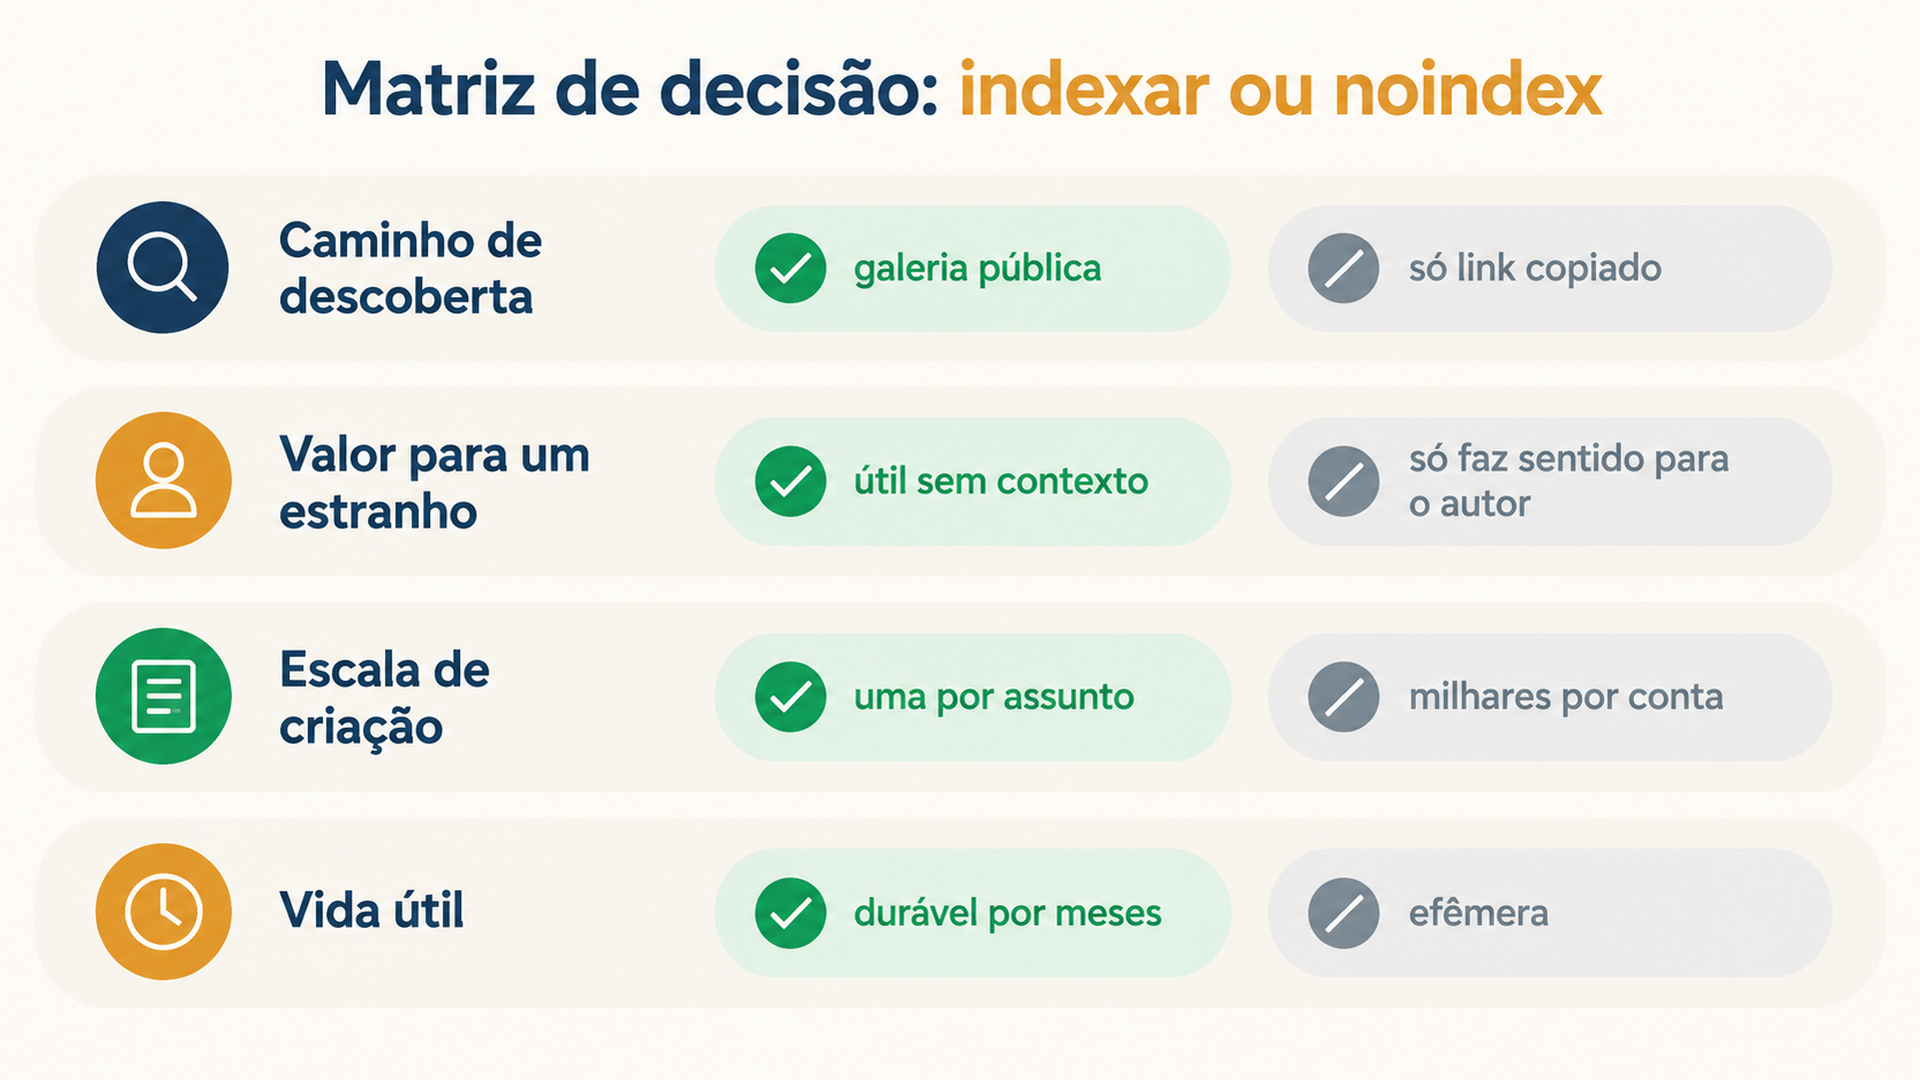
Na prática, quatro sinais respondem. Avalie a rota, não a página individual.
Sinal | Aponta para indexar | Aponta para noindex |
|---|---|---|
Caminho de descoberta | Linkado de uma galeria pública, sitemap, página de categoria ou perfil | Alcançável só por um link copiado ou botão de compartilhar |
Valor para um estranho | Útil sem conhecer quem criou | Só faz sentido para o criador, seu time ou o destinatário |
Oferta | Uma página por assunto, ou um conjunto curado | Milhares de URLs de uma conta, em sua maioria quase duplicadas |
Vida útil | Continua precisa por meses | Efêmera: um chat, um build, um rascunho, uma exportação temporária |
Três de quatro apontando para noindex é um veredito claro. Resultado misto normalmente significa que a rota precisa ser dividida: uma galeria pública indexável mais as saídas individuais, que não são. Essa divisão é a resposta correta mais comum e também a que mais se pula, porque exige dois templates em vez de uma flag.
Um teste de recusa útil: se um estranho visse este URL num resultado de busca sem contexto, título e snippet fariam sentido? "Conversa com Sam, 24 de out" reprova. "Modelo de nota fiscal para designers freelancers" passa. A reprovação não é sobre qualidade. É sobre a página ter sido feita para ser encontrada ou feita para ser enviada.
Escolha um controle que realmente remove a URL
Aqui é onde dá para seguir a nova orientação ao pé da letra e ainda assim falhar. O Google oferece duas opções na mesma frase, e elas não são equivalentes.
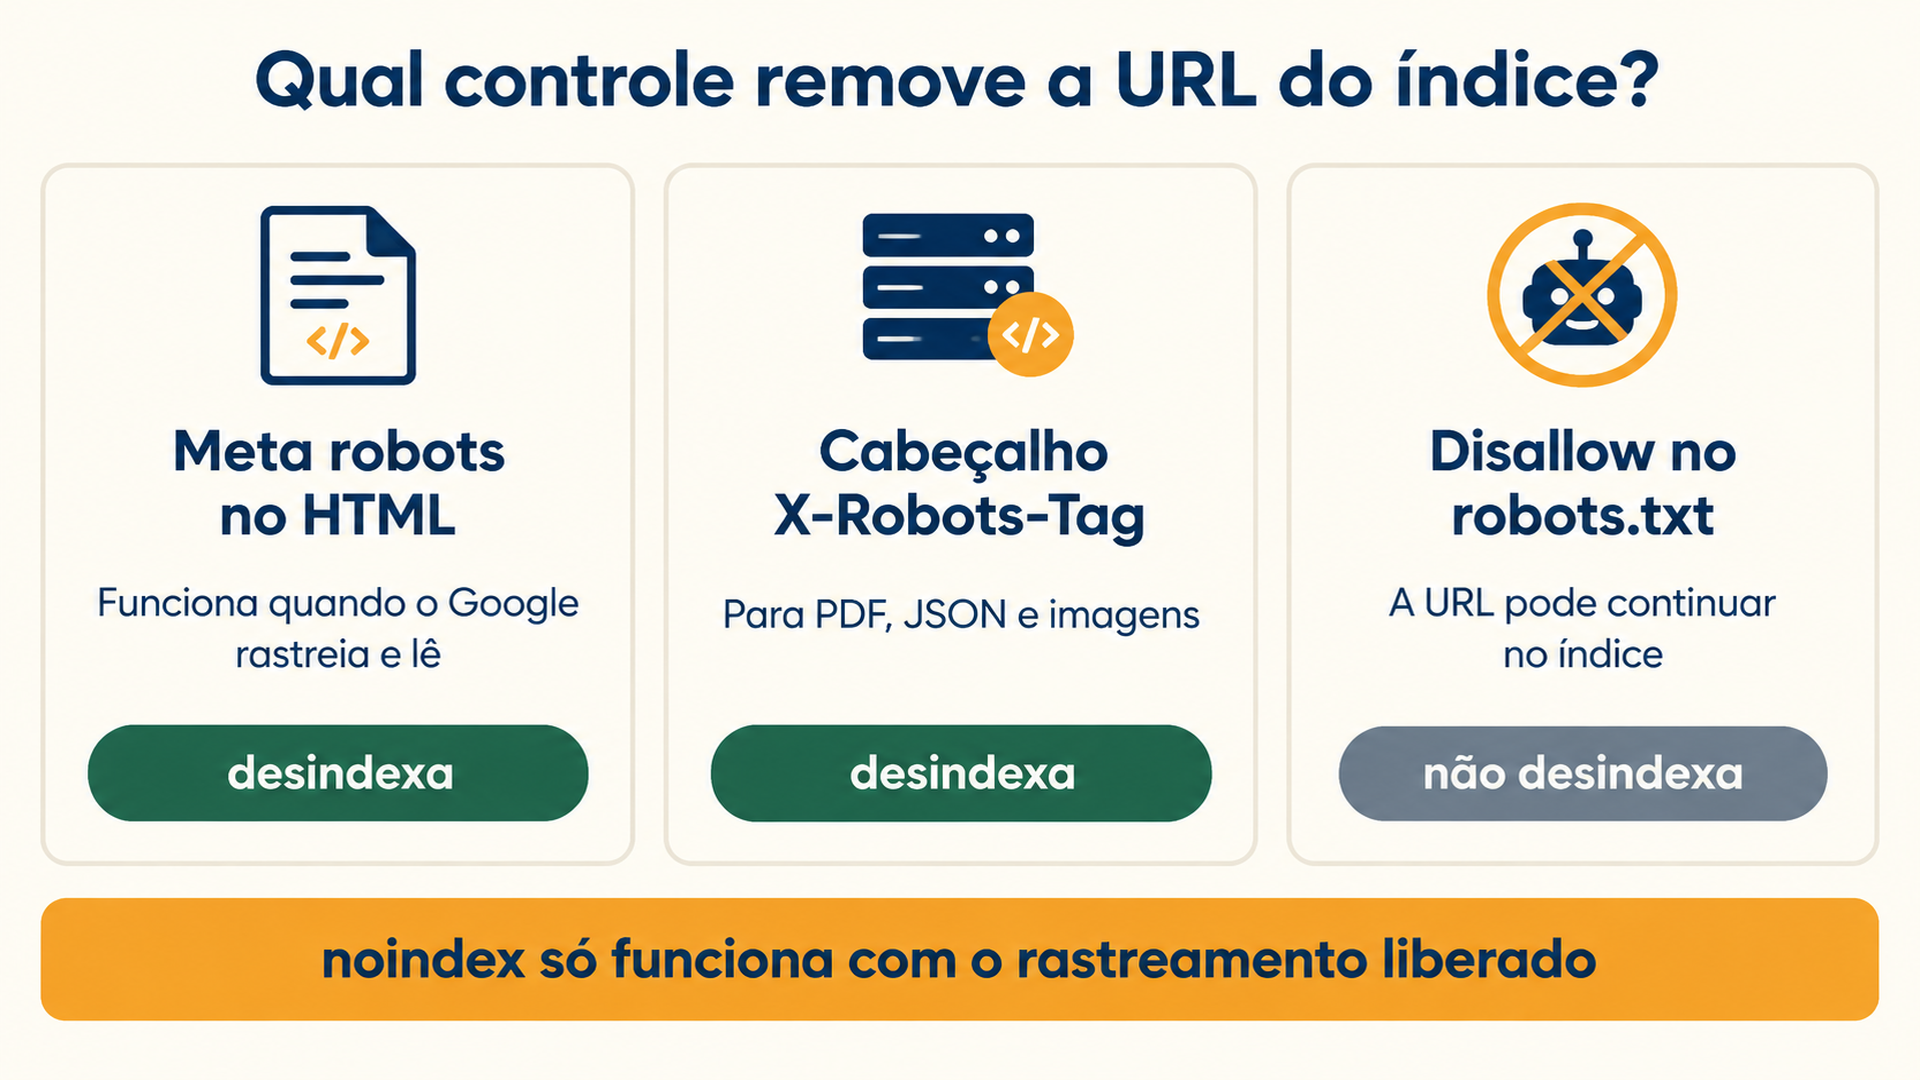
O robots.txt controla rastreamento. Ele não remove uma URL do índice, e o próprio Google diz isso na introdução do robots.txt: uma página bloqueada ali "pode continuar indexada se houver links de outros sites apontando para ela" — e, nesse caso, a URL e possivelmente o texto âncora podem aparecer nos resultados sem descrição.
O noindex controla indexação, mas só se o Google conseguir buscar a página e ler a diretiva. A documentação de noindex do Google é explícita: para a regra funcionar, a página não pode estar bloqueada pelo robots.txt, porque senão "o rastreador nunca verá a regra noindex".
Junte os dois fatos e a ordem passa a importar.
Controle | Remove a URL do índice | Onde falha | Use para |
|---|---|---|---|
Cabeçalho de resposta | Sim, depois que o Google rastreia e lê | Qualquer coisa bloqueada pelo robots.txt ou atrás de login | Respostas não HTML (PDF, JSON, imagens) e regras de edge ou CDN para muitas rotas |
| Sim, depois que o Google rastreia e lê | Tags injetadas por JavaScript após o carregamento; páginas bloqueadas pelo robots.txt | Páginas de compartilhamento em HTML renderizado no servidor |
Disallow no | Não | Uma URL linkada pode continuar indexada sem snippet | Reduzir carga de rastreamento, não privacidade |
Login ou URL assinada | Sim, ao impedir o acesso | Exige que a página seja de fato privada | Tudo que contenha dados de outras pessoas |
410 após expiração | Sim, com o tempo | Mais lento que o 404; não faz nada enquanto a URL ainda resolve | Compartilhamentos e builds efêmeros |
Um atalho a evitar: X-Robots-Tag: none não é um valor neutro. O Google trata como noindex mais nofollow. Às vezes é o que você quer, mas equipes copiam isso de uma configuração de proxy sem saber.
Segundo atalho a evitar: tags canonical. Canonical é uma dica. Se a página não deveria estar no índice, escreva noindex.
Passo 1: inventarie as rotas que criam URLs
Não dá para classificar o que não foi listado, e a maioria das equipes subestima a contagem porque pensa em funcionalidades, não em padrões de rota.
Abra o router, ou o mapa de URLs, e liste todo segmento dinâmico. Os suspeitos de sempre se parecem com isto:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Depois confirme contra o que o Google já sabe, porque o código e o índice vão discordar.
Pelo sitemap. Baixe e conte:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
O segundo comando dá um histograma aproximado por prefixo de caminho. Se uma rota gerada aparece no seu sitemap, isso já é um bug: sitemap é uma lista de páginas que você está pedindo ao Google para indexar.
Pelo Search Console. Abra o relatório de Indexação de páginas, filtre por prefixo de URL para cada rota candidata e anote os números. É a única fonte que diz o que o Google realmente fez com essas URLs.
Pelos logs do servidor. Agrupe requisições do Googlebot por prefixo:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Saída esperada. Uma lista de padrões de rota com a contagem de URLs ao lado de cada um, vinda de pelo menos duas fontes.
Checagem de qualidade. Toda rota que pode devolver 200 para um visitante que não seja da equipe deve estar na lista. Se a contagem do sitemap e a do Search Console divergirem mais de alguns por cento no mesmo prefixo, descubra por quê antes de mudar qualquer coisa.
Se não encontrar nada. Provavelmente você tem um router client-side. Procure as definições de rota no frontend em vez do backend e olhe a aba de rede em um link de compartilhamento real.
Passo 2: classifique cada rota numa tabela, não numa reunião
Escreva o veredito onde ele possa ser revisado. Uma linha por padrão de rota basta.
Rota | Criada por | Caminho de descoberta | Valor para estranho | Veredito | Controle | Responsável |
|---|---|---|---|---|---|---|
| Qualquer usuário | Só link | Nenhum | noindex | Cabeçalho | Plataforma |
| Curadoria | Links internos, sitemap | Alto | index | Nenhum | Conteúdo |
| Qualquer usuário | Links de perfil | Baixo até ficar ativo | noindex até ter reputação | Meta | Confiança e segurança |
| Qualquer usuário | Só link | Nenhum | noindex | Cabeçalho | Plataforma |
| Editores | Sitemap | Alto | index | Nenhum | Conteúdo |
A tabela só funciona se três coisas forem verdade.
Um responsável por linha. Dono ambíguo é a razão pela qual rotas geradas ficam indexáveis por anos.
Escreva o controle ao lado do veredito, não depois. "Noindex" não é decisão até alguém saber se isso significa cabeçalho, mudança de template ou regra de CDN.
Registre a exceção. Se uma rota é noindex mas um subconjunto pequeno deveria ser público, escreva a condição desse subconjunto agora. Fazer o recorte seis meses depois é como uma regra de noindex acaba sendo removida inteira, em silêncio.
Passo 3: entregue o controle no nível do template
Correções página a página não sobrevivem ao próximo deploy. Aplique o controle onde a rota é renderizada.
Para páginas HTML, coloque a tag no head renderizado no servidor. No App Router do Next.js isso são as metadata; no Astro, o head do layout; no Rails ou Django, o template de layout. A sintaxe exata importa menos que o lugar: precisa estar no HTML que o Google recebe, não adicionada por um efeito no cliente.
<meta name="robots" content="noindex">Para tudo que não é HTML, não existe meta tag, então use o cabeçalho:
X-Robots-Tag: noindexIsso cobre exportações em PDF, respostas JSON, imagens geradas e downloads CSV. Se esses arquivos são servidos por CDN, defina o cabeçalho na borda para que rotas novas herdem a regra.
Para uma família inteira de rotas, uma regra de middleware costuma ser mais limpa do que mexer em cada template:
// Exemplo em Express: noindex em todo URL de compartilhamento gerado
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Saída esperada. Um deploy em que toda rota marcada como noindex devolve a diretiva no primeiro byte, para requisições anônimas.
Checagem de qualidade. Rode curl -sI na URL publicada. Você deve ver x-robots-tag: noindex nos cabeçalhos de resposta, e curl -s deve mostrar a meta tag no código-fonte, antes de qualquer script rodar.
Caminho de recuperação. Se a tag só aparece depois que o JavaScript executa, mova para a renderização no servidor. Se o framework não renderiza head tags por rota, use o cabeçalho. Não publique um noindex injetado por JS e assuma que funciona: o Google descreve o comportamento do noindex renderizado como não bem definido.
Mais duas coisas pertencem ao mesmo pull request. Remova rotas noindex do sitemap, porque enviar uma URL que você não quer indexada é uma contradição que o Google resolve a favor dele. E adicione uma regra de expiração: quando um link de compartilhamento morre, devolva 410 em vez de manter uma página 200 com estado vazio.
Passo 4: verifique se o Googlebot consegue ver a diretiva
Tudo acima não está verificado até você checar do jeito que o Google checa.
Veja primeiro os cabeçalhos de resposta:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagDepois veja o HTML inicial, antes de qualquer script ter chance de rodar:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Por fim, confirme que o robots.txt não bloqueia o caminho. Se bloquear, o Google nunca busca a página e nunca lê a diretiva:
curl -s https://example.com/robots.txtO Search Console é a checagem final. Peça a inspeção da URL em Inspeção de URL e leia o veredito.
O resultado correto é "Página não indexada: Excluída pela tag 'noindex'". O resultado que indica que você caiu na armadilha é "Indexada, embora bloqueada pelo robots.txt" — o Google tem a URL, não consegue ler a diretiva e pode continuar exibindo. Se aparecer isso, remova a regra do robots.txt e deixe o noindex fazer o trabalho.
Você também pode buscar a página como o Googlebot a vê com um simulador de rastreador, o que é mais rápido do que esperar um novo rastreamento quando você está checando vinte rotas: Googlebot Spider Simulator.
Saída esperada. Toda rota noindex mostrando o estado de exclusão por noindex em poucos dias após o próximo rastreamento. Rotas criadas depois da mudança não devem aparecer no índice de jeito nenhum.
Caminho de recuperação. Se uma URL continua indexada depois de duas semanas, verifique se o Google consegue buscá-la, se a página devolve 200 para o Googlebot e se alguma tag canonical ou hreflang aponta os mecanismos de busca para outro lugar. Use a ferramenta de Remoções apenas como bloqueio temporário enquanto corrige a causa; ela não substitui a diretiva.
Quando a página compartilhada é o canal de crescimento
Algumas páginas geradas devem ser indexadas, e noindex em tudo seria um tiro no pé. Estas são as que valem proteger:
Padrão | Por que merece o índice | Guarda-corpo |
|---|---|---|
Galerias públicas de modelos | Usuários publicam um design, outros reaproveitam; a saída é única e durável | Moderar envios novos |
Construtores com páginas públicas de vitrine | Um resultado real com crédito "built with" é canal de distribuição | Manter o template de vitrine separado da página de marketing |
Documentação que cresce a partir de tópicos de usuários | Uma pergunta recorrente merece uma resposta permanente e editada | Indexar a resposta curada, não a conversa crua |
Se você está numa dessas categorias, a orientação mais antiga do Google continua valendo e é a alavanca melhor: noindex em conteúdo de usuários sem reputação e, depois, liberar quando a conta tiver histórico. Isso dá resistência a spam sem abandonar o loop de aquisição, e é o padrão que o guia recomendava antes desta atualização.
O teste para os três é o mesmo. Se a página ganha impressões em Desempenho na pesquisa para consultas que um estranho digitaria, ela pertence ao índice. Se ganha impressões só pela própria string de URL e nada mais, não pertence.
Há um efeito de segunda ordem que vale nomear. URLs públicas de compartilhamento foram, por anos, uma superfície barata de links: criar uma página numa plataforma com domínio forte, apontar um link para o próprio site, repetir em vinte propriedades. Patrick Stox contou mais de 20 links de plataformas diferentes na mesma thread. Se as plataformas seguirem a orientação, essa superfície encolhe. Se não seguirem, o Google agora tem um documento para citar na próxima vez que decidir que aquelas páginas são spam.
Passo 5: instrumente o padrão que o Google descreveu
A seção de monitoramento é a parte da atualização que a maioria das equipes vai pular, e é justamente a que pega um incidente real antes de ele virar ação manual.
Quatro checagens, cada uma com um lugar para olhar.
Propriedade no Search Console. Verifique o site ou subdomínio para que alertas de ação manual e de segurança cheguem por e-mail. Se você opera uma plataforma com subdomínios por locatário, verifique o pai e ao menos uma amostra dos filhos; um alerta que não chega a lugar nenhum não é monitoramento.
Tendência de indexação de páginas. Estabeleça hoje a linha de base de URLs indexadas por rota gerada e acompanhe mudanças em degrau, não ruído. Dobrar o número de URLs indexadas numa semana em uma rota que deveria ser estática é o sinal.
Anomalias em desempenho na pesquisa. Filtre por consultas sem relação com o produto. Páginas de spam atraem consultas de spam muito antes de alguém reclamar.
Razão entre criação e indexação. Esta é a métrica que o Google nomeia e que quase ninguém acompanha: quantas URLs indexáveis uma única conta consegue produzir por dia, e que fatia das novas URLs indexáveis vem do 1% de contas no topo. Um alerta inicial em 3 vezes a mediana dos últimos sete dias para uma conta é arbitrário, mas funciona; ajuste com o seu tráfego.
A mesma razão serve como guarda-corpo de produto. Se uma funcionalidade permite que um usuário gere mil URLs indexáveis por dia, ela é uma funcionalidade de inchaço de índice, mesmo que ninguém abuse dela ainda.
O que a atualização realmente está dizendo
Tire a redação e o Google está argumentando sobre oferta.
Por vinte anos, a política de spam descreveu páginas: rasas, raspadas, camufladas, empilhadas de palavras-chave. Essas categorias pressupõem que um humano ou um script decide produzir uma página e o Google decide se ela merece ranquear. Saídas geradas quebram esse modelo. Uma decisão de produto pode criar um milhão de URLs, todas tecnicamente únicas, todas tecnicamente 200, a maioria sem valor para quem não as criou. O Google não consegue avaliá-las uma a uma e parou de fingir que consegue.
A reação se dividiu em dois campos. O primeiro leu como tiro de aviso: Marie Haynes perguntou se viriam novas ações manuais para ferramentas de IA e construtores de app, e Lily Ray tratou a seção como sinal do que o Google já combate em escala, citando artefatos do Claude, páginas de compartilhamento do ChatGPT e posts em redes sociais. O segundo deu de ombros. Equipes cuidadosas põem relatórios gerados por usuários em noindex há anos, argumentaram várias respostas, e as páginas geradas do próprio Google são o problema maior. As duas leituras podem ser verdadeiras. O que torna a orientação relevante não é o conselho ser novo, mas ele agora estar escrito em algum lugar para onde a aplicação da política pode apontar.
Então a orientação move a decisão para cima na cadeia. Plataformas passam a ser esperadas a decidir, no nível do template, se uma classe de URLs pertence ao índice. É uma questão de governança, não de SEO, e é por isso que o conselho está no guia de spam e não na documentação de indexação.
Para a busca com IA, a mesma lógica vale nas duas direções. Os recursos de IA do Google puxam do índice do Google, então uma diretiva noindex remove a página tanto do pool quanto dos links azuis. Se uma página gerada vinha ganhando citações em AI Overviews, espere que parem. Isso costuma estar certo para um link de compartilhamento e errado para uma página de modelo. Outros rastreadores de IA seguem regras próprias, então decida separadamente quais deles você quer que possam buscar essas páginas.
O aprendizado prático é uma frase que dá para colocar numa revisão de design: toda URL que um usuário pode criar é uma superfície de produto ou um passivo de índice, e o template decide qual.
Perguntas frequentes
Isso se aplica a um site de marketing comum?
Não, a menos que seu site gere URLs a partir de entrada do usuário. Um site de marketing publica um conjunto de páginas que uma pessoa decidiu que deveriam existir, o oposto do problema que o guia descreve. A linha de escopo nomeia plataformas de hospedagem e ferramentas que permitem aos usuários publicar páginas compartilhadas, conteúdo gerado ou web apps. Se você tem comentários, fórum ou perfis de membros, vale a orientação antiga: nofollow ou ugc em links de contas não confiáveis e noindex para usuários novos até construírem reputação.
Devo usar robots.txt ou uma tag noindex?
Noindex, e apenas um dos dois em cada rota. A frase do Google lista as duas opções, mas elas fazem coisas diferentes. Um Disallow no robots.txt para o rastreamento, e uma URL bloqueada mas linkada de outro lugar pode continuar nos resultados sem snippet. O noindex só funciona quando o Google consegue buscar a página e ler. Na prática isso significa uma meta tag ou um cabeçalho de resposta, e nunca uma regra de robots.txt no mesmo caminho.
Colocar páginas compartilhadas em noindex vai me custar tráfego?
Verifique a rota antes de decidir, não depois. Se uma página ganha impressões só pela própria string de URL, ela não entrega tráfego orgânico e removê-la não custa nada. O padrão que perde tráfego é derrubar uma galeria pública junto com as saídas que estão dentro dela. Mantenha a galeria indexável, ponha noindex no que está atrás dela e acompanhe o desempenho de pesquisa das consultas da galeria antes e depois.
Mecanismos de busca com IA respeitam noindex?
Os recursos de IA do Google respeitam, porque AI Overviews e AI Mode puxam do mesmo índice, então a diretiva remove a página tanto dos links azuis quanto das respostas de IA. Outros rastreadores de IA são uma decisão separada. O comportamento dos fornecedores varia e muda sem changelog, então leia a documentação de cada rastreador e busque a página com o user agent dele em vez de supor que uma diretiva cobre todos.
Autor: Grace Miller, analista de risco de AI Search na Auspia. Acompanha mais de 200 mudanças de política. Escreve sobre regras de plataforma, risco de conteúdo e otimização com consciência de política.