La regola che Google ha appena messo per iscritto
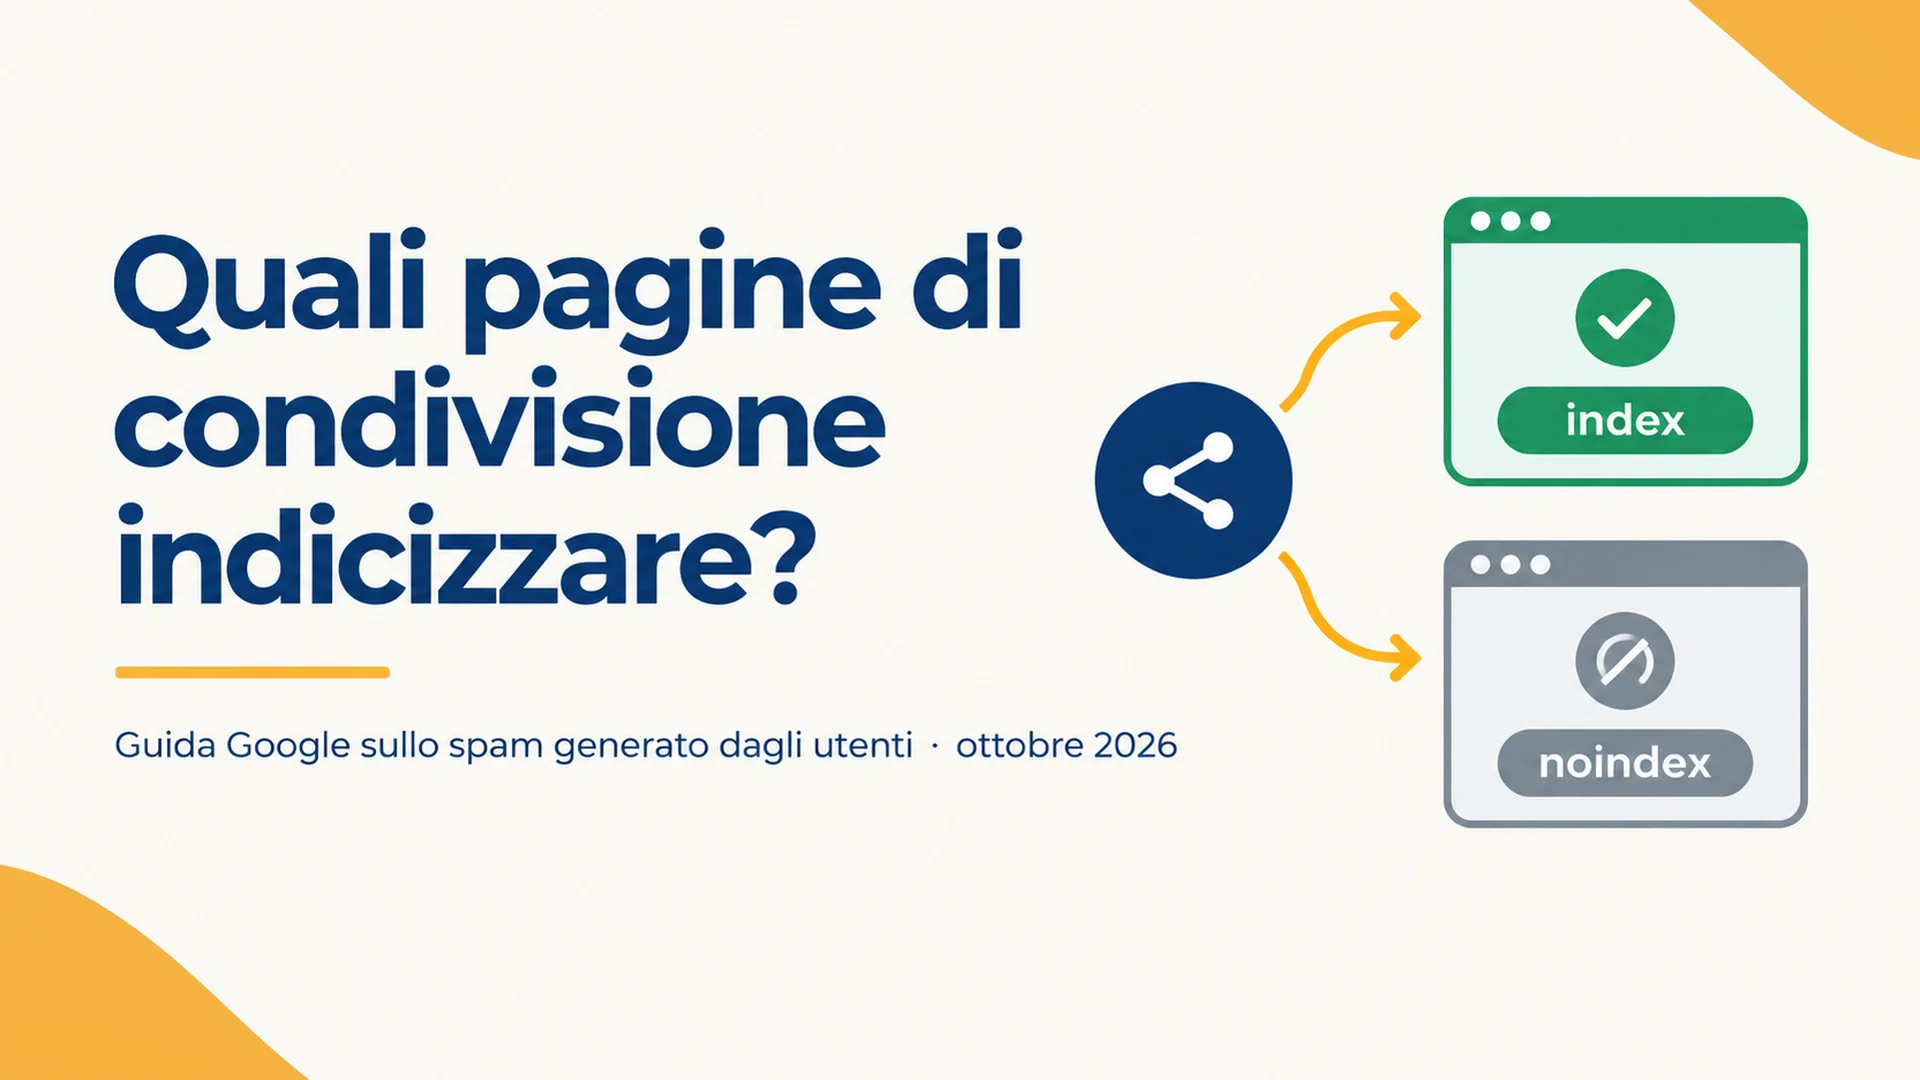
Il 26 ottobre 2026 Google ha aggiunto una sezione di due paragrafi alla sua guida su come evitare lo spam generato dagli utenti. È la parte più breve della pagina e probabilmente quella che cambierà più roadmap di prodotto, perché pone una domanda che la maggior parte dei team non ha mai messo su una slide: questa URL deve stare nell'indice di Google?
La sezione si intitola "Only index content meant for Search", indicizza solo i contenuti destinati alla Ricerca. Tradotta, dice questo:
Se il tuo servizio consente agli utenti di creare pagine condivisibili, risultati generati o strumenti interattivi, chiediti se questi contenuti sono pensati per essere trovati dai motori di ricerca o solo per essere aperti direttamente da chi possiede il link.
Quando le pagine vengono create per la condivisione diretta, la collaborazione o l'utilità, e non per essere scoperte in una ricerca pubblica, applica la regola noindex per impostazione predefinita (con un meta tag robots o l'header HTTP X-Robots-Tag) oppure blocca la scansione nel robots.txt.
Il changelog di Google dello stesso giorno è più esplicito sulle intenzioni: la guida è stata aggiornata con "indicazioni su come bloccare l'indicizzazione dei contenuti condivisi tramite link e su come monitorare gli abusi in Search Console", così che le piattaforme possano "tenere fuori dall'indice le pagine create dagli utenti che non sono destinate alla Ricerca e rilevare lo spam prima".
Tutto qui. Nessuna nuova azione manuale, nessun annuncio di un sistema di ranking, nessun elenco di penalità. Quello che c'è è una raccomandazione su un valore predefinito, e quasi tutti gli incidenti di indicizzazione nascono dai valori predefiniti.
A chi serve. Ai team che pubblicano qualunque URL che un utente possa generare: link di condivisione, chat salvate, dashboard pubbliche, anteprime di modelli, build di applicazioni, report generati, thread di forum, pagine profilo, pagine di recensioni, pagine di annunci.
Cosa ottieni. Un verdetto per rotta per ogni tipo di URL generata, il controllo che rimuove davvero la pagina dall'indice e una regola di monitoraggio che intercetta il pattern di abuso descritto da Google.
Tempo. Da 45 a 90 minuti per un primo passaggio su un prodotto. Un giorno se hai più generatori di URL e nessun inventario delle rotte.
Com'è fatto "finito". Ogni rotta generata è marcata index, noindex o privata. Le rotte noindex restituiscono la direttiva dal server, non dopo l'esecuzione di JavaScript. Search Console mostra quegli URL come esclusi per noindex, non come "Indicizzata, ma bloccata da robots.txt".
Cosa è cambiato e cosa sembra solo nuovo
Contano quattro modifiche. Il resto della pagina non si è mosso, comprese le indicazioni di dicembre 2025, che restano valide.
Cosa ha cambiato Google | Il testo reale | Perché conta per te |
|---|---|---|
Ambito della guida | Ora nomina le piattaforme di hosting "e gli strumenti che consentono agli utenti di pubblicare pagine condivise, contenuti generati o applicazioni web" | Alla lettera, questo copre esportazioni di chat IA, pagine di artefatti, costruttori di app e strumenti no-code, non solo forum e commenti |
Unità dell'abuso | Gli spammer possono creare "una grande quantità di pagine o siti" | Google parla di volume, non di astuzia. Un account abusivo può coniare migliaia di URL |
Sezione nuova | "Only index content meant for Search" | È l'affermazione più chiara finora che noindex è un valore predefinito ragionevole per contenuti raggiungibili solo tramite link |
Monitoraggio | Verificare sito o sottodominio in Search Console, seguire picchi in Indicizzazione pagine e Rendimento su Search, avvisare quando "pochi utenti" producono "gran parte degli URL indicizzabili" | Il gonfiamento dell'indice ha ora un metodo di rilevamento con un nome — e di solito è ciò che precede una qualche forma di revisione |
Cosa non è cambiato: noindex sui post degli utenti nuovi finché non si guadagnano una reputazione, e nofollow o ugc sui link dentro contenuti inaffidabili. Se fai già entrambe le cose, sei avanti rispetto a questo aggiornamento.
Va detto chiaramente, perché la reazione su X ha preceduto il documento: queste sono indicazioni per le piattaforme sul proprio stock di URL. Non creano una violazione nuova per un normale sito di marketing e non cambiano il ranking di nessuna pagina. Cambiano cosa dovrebbe esistere nell'indice.
Un altro pezzo di contesto spiega il momento. Alla fine di luglio 2026, i link di condivisione e le pagine di artefatti di Claude sono comparsi nell'indice di Google, e i resoconti dell'epoca descrivevano cartelle cliniche, chiavi API e altro materiale privato esposto prima che Anthropic chiudesse la falla in pochi giorni. La stessa copertura segnalava URL pubbliche di app presso costruttori come Replit e Lovable. Google raramente scrive una sezione nuova per un'ipotesi. Questa si era già verificata.
La domanda che decide ogni URL generata
Il test di Google sta in una frase e si può applicare senza indovinare le intenzioni: questo contenuto è pensato per essere trovato dai motori di ricerca, o solo per essere aperto da chi ha il link?
In pratica rispondono quattro segnali. Valuta la rotta, non la singola pagina.
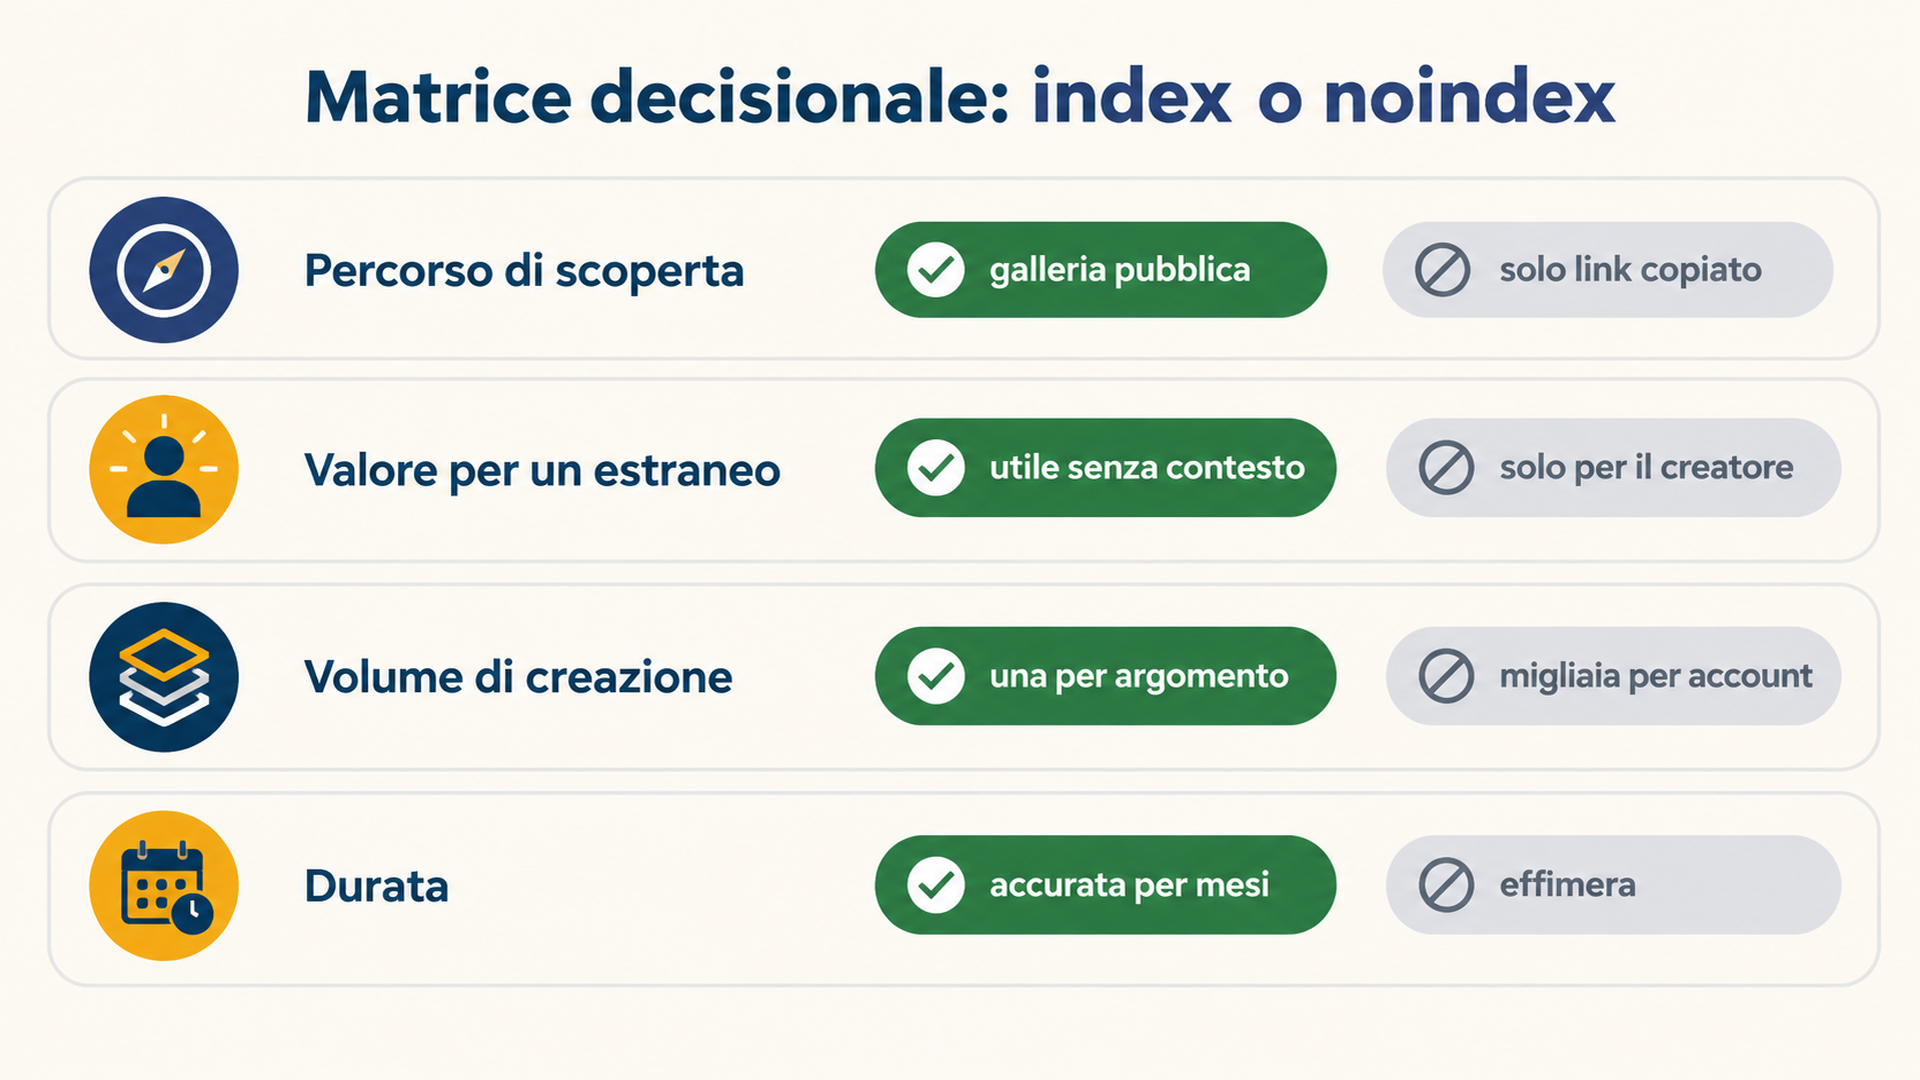
Segnale | Spinge verso index | Spinge verso noindex |
|---|---|---|
Percorso di scoperta | Collegata da una galleria pubblica, una sitemap, una pagina di categoria o un profilo | Raggiungibile solo tramite un link copiato o un pulsante di condivisione |
Valore per un estraneo | Utile senza conoscere chi l'ha creata | Ha senso solo per il creatore, il suo team o il destinatario |
Volume di creazione | Una pagina per argomento, o un insieme curato | Migliaia di URL da un singolo account, per lo più quasi duplicate |
Durata | Resta accurata per mesi | Effimera: una chat, una build, una bozza, un'esportazione temporanea |
Tre segnali su quattro verso noindex sono un verdetto netto. Un risultato misto di solito significa che la rotta va divisa: una galleria pubblica indicizzabile e, sotto, gli output individuali che non lo sono. Quella divisione è la risposta corretta più comune ed è anche la più saltata, perché richiede due template invece di un flag.
Un test di rifiuto utile: se un estraneo vedesse questa URL in un risultato di ricerca senza contesto, titolo e snippet avrebbero senso? "Chat con Sam, 24 ott" no. "Modello di fattura per designer freelance" sì. Il rifiuto non riguarda la qualità. Riguarda se la pagina è stata fatta per essere trovata o fatta per essere inviata.
Scegli un controllo che tolga davvero l'URL
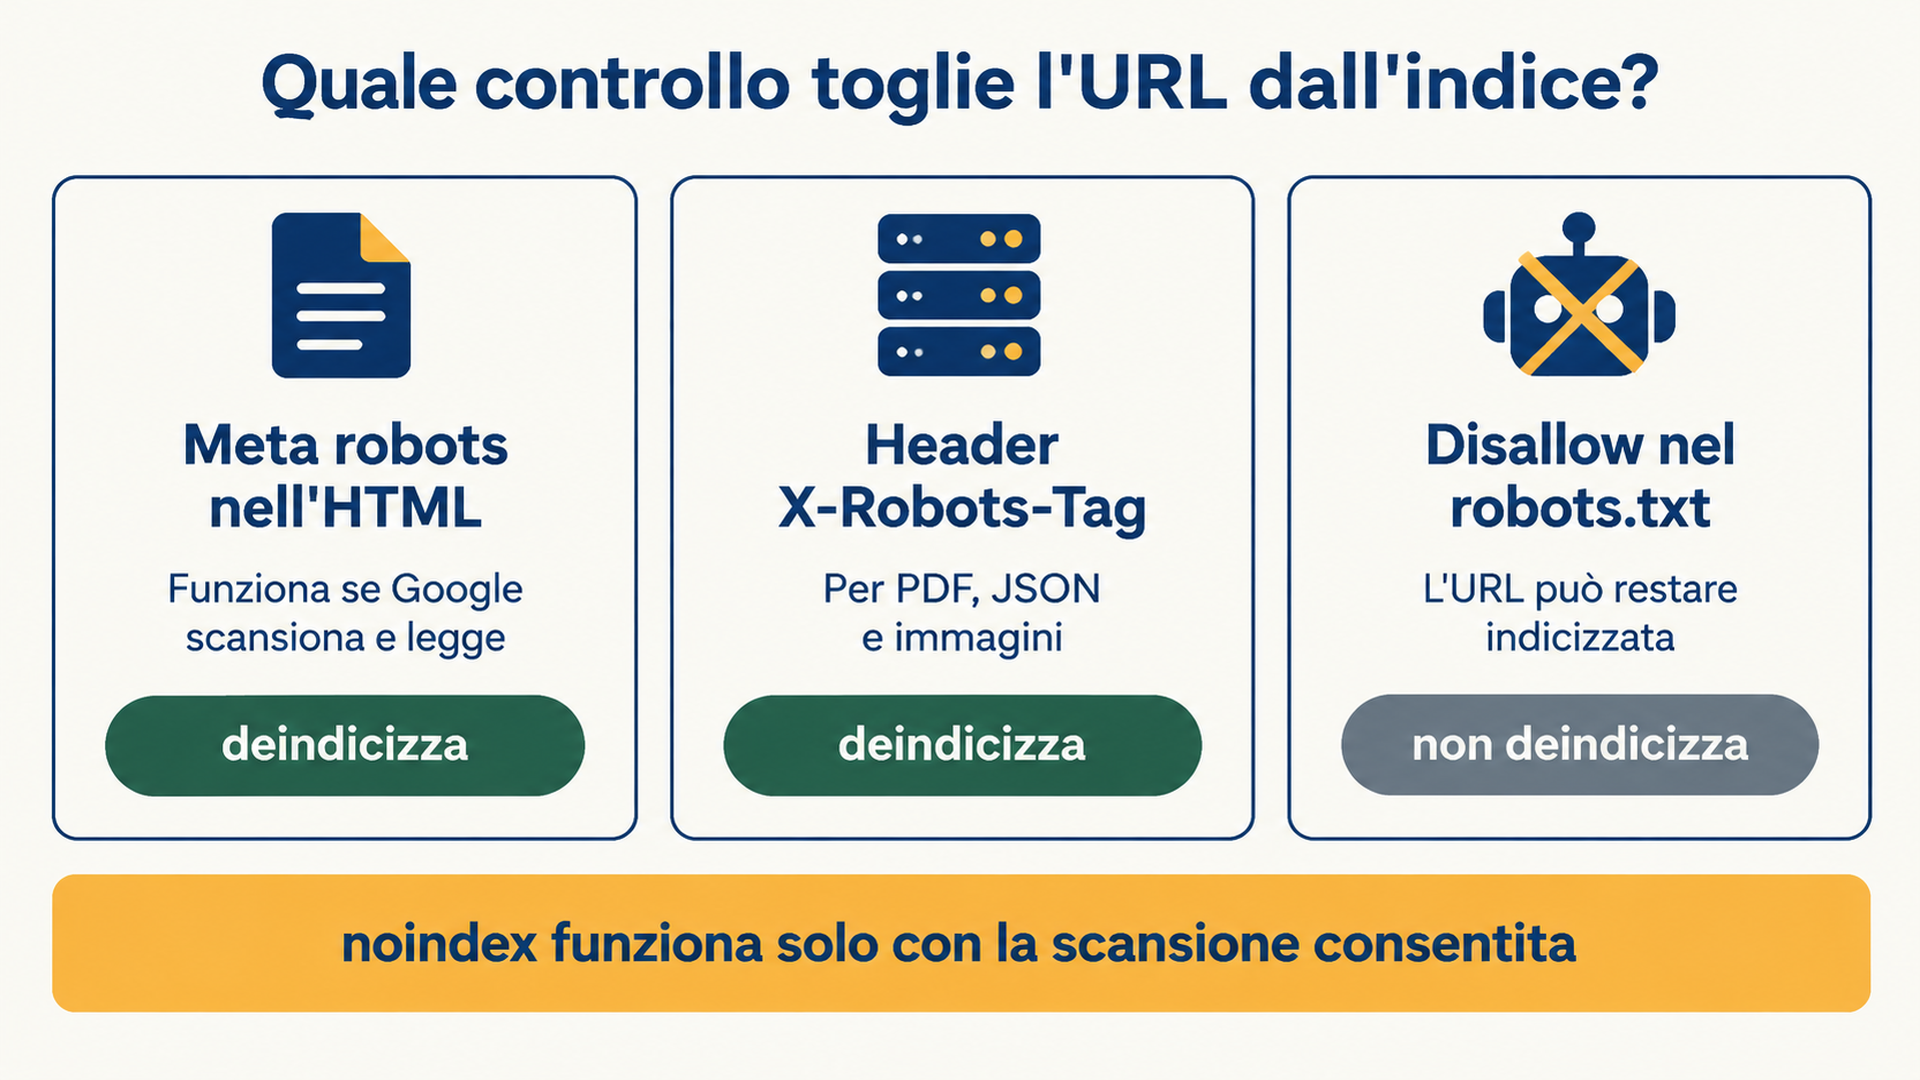
Qui è dove si può seguire alla lettera la nuova indicazione e fallire comunque. Google offre due opzioni nella stessa frase, e non sono equivalenti.
Il robots.txt controlla la scansione. Non rimuove un URL dall'indice, e Google lo dice stesso nell'introduzione al robots.txt: una pagina bloccata lì "può restare indicizzata se ci sono link da altri siti che puntano a essa" — e in quel caso l'URL e forse il testo dell'ancora possono comparire nei risultati senza descrizione.
Il noindex controlla l'indicizzazione, ma solo se Google riesce a scansionare la pagina e leggere la direttiva. La documentazione noindex di Google è esplicita: perché la regola funzioni, la pagina non deve essere bloccata dal robots.txt, altrimenti "il crawler non vedrà mai la regola noindex".
Metti insieme i due fatti e l'ordine diventa determinante.
Controllo | Toglie l'URL dall'indice | Dove fallisce | Da usare per |
|---|---|---|---|
Header di risposta | Sì, dopo che Google scansiona e legge | Qualunque cosa bloccata dal robots.txt o dietro un login | Risposte non HTML (PDF, JSON, immagini) e regole edge o CDN per molte rotte |
| Sì, dopo che Google scansiona e legge | Tag iniettati da JavaScript dopo il caricamento; pagine bloccate dal robots.txt | Pagine di condivisione HTML renderizzate lato server |
Disallow nel | No | Un URL collegato può restare indicizzato senza snippet | Ridurre il carico di scansione, non la privacy |
Login o URL firmata | Sì, impedendo l'accesso | Richiede che la pagina sia davvero privata | Tutto ciò che contiene dati di altre persone |
410 dopo la scadenza | Sì, col tempo | Più lento del 404; non fa nulla finché l'URL risponde ancora | Condivisioni e build effimere |
Una scorciatoia da evitare: X-Robots-Tag: none non è un valore neutro. Google lo tratta come noindex più nofollow. A volte è quello che vuoi, ma i team lo copiano da una configurazione di proxy senza saperlo.
Seconda scorciatoia da evitare: i tag canonical. Il canonical è un suggerimento. Se la pagina non deve stare nell'indice, scrivi noindex.
Passo 1: inventaria le rotte che generano URL
Non si può classificare ciò che non è in elenco, e la maggior parte dei team sottostima il conteggio perché pensa per funzionalità invece che per pattern di rotta.
Apri il router, o la mappa degli URL, ed elenca ogni segmento dinamico. I soliti sospetti hanno questo aspetto:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Poi confronta con quello che Google già sa, perché codice e indice saranno in disaccordo.
Dalla sitemap. Scarica e conta:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Il secondo comando produce un istogramma approssimativo per prefisso di percorso. Se una rotta generata compare nella tua sitemap, è già un bug: la sitemap è un elenco di pagine che stai chiedendo a Google di indicizzare.
Da Search Console. Apri il report Indicizzazione pagine, filtra per prefisso URL per ogni rotta candidata e annota i numeri. È l'unica fonte che dice cosa ha realmente fatto Google con quegli URL.
Dai log del server. Raggruppa le richieste di Googlebot per prefisso:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Output atteso. Un elenco di pattern di rotta con accanto il numero di URL, ricavato da almeno due fonti.
Controllo di qualità. Ogni rotta che può restituire un 200 a un visitatore esterno al team deve essere nell'elenco. Se i conteggi di sitemap e Search Console divergono di più di qualche punto percentuale sullo stesso prefisso, scopri perché prima di cambiare qualcosa.
Se non trovi nulla. Probabilmente hai un router lato client. Cerca le definizioni delle rotte nel frontend invece che nel backend e guarda la scheda di rete su un link di condivisione reale.
Passo 2: classifica ogni rotta in una tabella, non in una riunione
Scrivi il verdetto dove qualcuno può rivederlo. Basta una riga per pattern di rotta.
Rotta | Creata da | Percorso di scoperta | Valore per un estraneo | Verdetto | Controllo | Responsabile |
|---|---|---|---|---|---|---|
| Qualunque utente | Solo link | Nessuno | noindex | Header | Piattaforma |
| Curatela | Link interni, sitemap | Alto | index | Nessuno | Contenuti |
| Qualunque utente | Link di profilo | Basso finché inattivo | noindex finché non ha reputazione | Meta | Trust and safety |
| Qualunque utente | Solo link | Nessuno | noindex | Header | Piattaforma |
| Redazione | Sitemap | Alto | index | Nessuno | Contenuti |
La tabella funziona solo se tre cose sono vere.
Una persona responsabile per riga. Una proprietà ambigua è il motivo per cui le rotte generate restano indicizzabili per anni.
Scrivi il controllo accanto al verdetto, non dopo. "noindex" non è una decisione finché qualcuno non sa se significa un header, una modifica al template o una regola CDN.
Annota l'eccezione. Se una rotta è noindex ma un piccolo sottoinsieme dovrebbe essere pubblico, scrivi ora la condizione di quel sottoinsieme. Ritagliarlo sei mesi dopo è come una regola noindex finisce per essere rimossa del tutto, in silenzio.
Passo 3: applica il controllo a livello di template
Le correzioni pagina per pagina non sopravvivono al deploy successivo. Applica il controllo dove viene renderizzata la rotta.
Per le pagine HTML, metti il tag nell'head renderizzato lato server. Nell'App Router di Next.js sono i metadata; in Astro, l'head del layout; in Rails o Django, il template di layout. La sintassi esatta conta meno del posto: deve stare nell'HTML che Google riceve, non essere aggiunta da un effetto lato client.
<meta name="robots" content="noindex">Per tutto ciò che non è HTML, non esiste un meta tag, quindi usa l'header:
X-Robots-Tag: noindexQuesto copre esportazioni PDF, risposte JSON, immagini generate e download CSV. Se quei file sono serviti da una CDN, imposta l'header all'edge così le nuove rotte ereditano la regola.
Per un'intera famiglia di rotte, una regola middleware è spesso più pulita che toccare ogni template:
// Esempio Express: noindex su tutte le URL di condivisione generate
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Output atteso. Un deploy in cui ogni rotta marcata noindex restituisce la direttiva al primo byte, per le richieste anonime.
Controllo di qualità. Esegui curl -sI sull'URL pubblicata. Dovresti vedere x-robots-tag: noindex negli header di risposta, e curl -s dovrebbe mostrare il meta tag nel codice sorgente, prima che qualsiasi script venga eseguito.
Via di recupero. Se il tag compare solo dopo l'esecuzione di JavaScript, spostalo nel rendering lato server. Se il framework non renderizza head tag per rotta, usa l'header. Non pubblicare un noindex iniettato via JS dando per scontato che funzioni: Google descrive il comportamento del noindex renderizzato come poco definito.
Altre due cose appartengono alla stessa pull request. Togli le rotte noindex dalla sitemap, perché inviare un URL che non vuoi indicizzato è una contraddizione che Google risolve a suo favore. E aggiungi una regola di scadenza: quando un link di condivisione muore, restituisci 410 invece di tenere una pagina 200 con lo stato vuoto.
Passo 4: verifica che Googlebot possa vedere la direttiva
Niente di quanto sopra è verificato finché non lo controlli come lo controlla Google.
Guarda prima gli header di risposta:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagPoi l'HTML iniziale, prima che uno script abbia la possibilità di girare:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Infine, assicurati che il robots.txt non blocchi il percorso. Se lo blocca, Google non scansiona mai la pagina e non legge mai la direttiva:
curl -s https://example.com/robots.txtSearch Console è il controllo finale. Chiedi l'ispezione dell'URL in Ispezione URL e leggi il verdetto.
Il risultato corretto è "Pagina non indicizzata: Esclusa dal tag 'noindex'". Il risultato che segnala che sei caduto nella trappola è "Indicizzata, ma bloccata da robots.txt": Google ha l'URL, non riesce a leggere la direttiva e può continuare a mostrarla. Se compare questo, rimuovi la regola dal robots.txt e lascia che il noindex faccia il suo lavoro.
Puoi anche recuperare la pagina come la vede Googlebot con un simulatore di crawler, più veloce che aspettare una nuova scansione quando stai controllando venti rotte: Googlebot Spider Simulator.
Output atteso. Ogni rotta noindex mostra lo stato di esclusione per noindex pochi giorni dopo la scansione successiva. Le rotte create dopo la modifica non dovrebbero comparire affatto nell'indice.
Via di recupero. Se un URL è ancora indicizzato dopo due settimane, verifica che Google possa scansionarlo, che la pagina restituisca 200 a Googlebot e che nessun tag canonical o hreflang stia mandando i motori di ricerca altrove. Usa lo strumento Rimozioni solo come blocco temporaneo mentre correggi la causa; non sostituisce la direttiva.
Quando la pagina condivisa è il canale di crescita
Alcune pagine generate devono essere indicizzate, e mettere noindex su tutto sarebbe uno sparo nel piede. Queste sono quelle che vale la pena proteggere:
Pattern | Perché merita l'indice | Guardrail |
|---|---|---|
Gallerie pubbliche di template | Gli utenti pubblicano un design, altri lo riusano; l'output è unico e duraturo | Moderare i nuovi invii |
Costruttori con pagine vetrina pubbliche | Un risultato reale con credito "built with" è un canale distributivo | Tenere il template vetrina separato dalla pagina marketing |
Documentazione che cresce da thread di utenti | Una domanda ricorrente merita una risposta permanente e curata | Indicizzare la risposta curata, non la conversazione grezza |
Se sei in una di queste categorie, l'indicazione più vecchia di Google resta valida ed è la leva migliore: noindex sui contenuti di utenti senza reputazione, poi apri quando l'account ha uno storico. Questo dà resistenza allo spam senza abbandonare il ciclo di acquisizione, ed è il pattern che la guida raccomandava prima di questo aggiornamento.
Il test è lo stesso per tutte e tre. Se la pagina guadagna impressioni in Rendimento su Search per query che un estraneo digiterebbe, appartiene all'indice. Se guadagna impressioni solo sulla propria stringa URL e nient'altro, non appartiene.
C'è un effetto di secondo ordine da nominare. Gli URL pubblici di condivisione sono stati per anni una superficie di link a buon mercato: creare una pagina su una piattaforma con dominio forte, puntare un link al proprio sito, ripetere su venti proprietà. Patrick Stox ha contato più di 20 link da piattaforme diverse nello stesso thread. Se le piattaforme seguono l'indicazione, quella superficie si restringe. Se non la seguono, Google ora ha un documento da citare la prossima volta che deciderà che quelle pagine sono spam.
Passo 5: strumenta il pattern descritto da Google
La sezione sul monitoraggio è la parte dell'aggiornamento che la maggior parte dei team salterà, ed è proprio quella che intercetta un incidente reale prima che diventi un'azione manuale.
Quattro controlli, ciascuno con un posto dove guardare.
Proprietà in Search Console. Verifica sito o sottodominio perché gli avvisi di azioni manuali e sicurezza arrivino via email. Se gestisci una piattaforma con sottodomini per tenant, verifica il genitore e almeno un campione dei figli; un avviso che non arriva da nessuna parte non è monitoraggio.
Andamento dell'indicizzazione pagine. Stabilisci oggi la baseline di URL indicizzate per rotta generata e osserva i cambiamenti a gradini, non il rumore. Raddoppiare il numero di URL indicizzate in una settimana su una rotta che dovrebbe essere statica è il segnale.
Anomalie in Rendimento su Search. Filtra per query senza relazione col prodotto. Le pagine spam attirano query spam molto prima che qualcuno si lamenti.
Rapporto tra creazione e indicizzazione. È la metrica che Google nomina e che quasi nessuno misura: quante URL indicizzabili può produrre un singolo account al giorno, e quale quota delle nuove URL indicizzabili arriva dall'1% degli account più attivi. Un avviso iniziale a 3 volte la mediana degli ultimi sette giorni per un account è arbitrario, ma funziona; taralo sul tuo traffico.
Lo stesso rapporto serve come guardrail di prodotto. Se una funzionalità consente a un utente di generare mille URL indicizzabili al giorno, è una funzionalità di gonfiamento dell'indice, anche se nessuno ne abusa ancora.
Cosa sta davvero dicendo l'aggiornamento
Togli la formulazione e Google sta discutendo di offerta.
Per vent'anni la policy antispam ha descritto pagine: sottili, raschiate, camuffate, imbottite di parole chiave. Quelle categorie presuppongono che un umano o uno script decida di produrre una pagina e Google decida se merita di posizionarsi. Gli output generati rompono quel modello. Una decisione di prodotto può creare un milione di URL, tutte tecnicamente uniche, tutte tecnicamente 200, la maggior parte senza valore per chi non le ha create. Google non può valutarle una per una e ha smesso di fingere di poterlo fare.
La reazione si è divisa in due campi. Il primo l'ha letta come un colpo di avvertimento: Marie Haynes si è chiesta se arriveranno nuove azioni manuali per strumenti IA e costruttori di app, e Lily Ray ha trattato la sezione come segnale di ciò che Google già combatte su larga scala, citando artefatti di Claude, pagine di condivisione di ChatGPT e post sui social. Il secondo ha alzato le spalle. I team attenti mettono i report generati dagli utenti in noindex da anni, hanno argomentato diverse risposte, e le pagine generate di Google stesso sono il problema più grande. Le due letture possono essere entrambe vere. Ciò che rende rilevante l'indicazione non è che il consiglio sia nuovo, ma che ora sia scritto da qualche parte a cui l'applicazione della policy può appellarsi.
Quindi l'indicazione sposta la decisione più a monte. Ci si aspetta che le piattaforme decidano, a livello di template, se una classe di URL appartiene all'indice. È una questione di governance, non di SEO, ed è per questo che il consiglio sta nella guida antispam e non nella documentazione sull'indicizzazione.
Per la ricerca IA vale la stessa logica in entrambe le direzioni. Le funzioni IA di Google pescano dall'indice di Google, quindi una direttiva noindex toglie la pagina sia dal bacino sia dai link blu. Se una pagina generata stava guadagnando citazioni negli AI Overviews, aspettati che si fermino. Di solito è giusto per un link di condivisione e sbagliato per una pagina di template. Gli altri crawler IA seguono regole proprie, quindi decidi separatamente quali vuoi che possano scansionare quelle pagine.
La lezione pratica è una frase da portare in una revisione di design: ogni URL che un utente può creare o è una superficie di prodotto o è una passività di indice, e il template decide quale.
Domande frequenti
Si applica a un normale sito di marketing?
No, a meno che il tuo sito non generi URL da input dell'utente. Un sito di marketing pubblica un insieme di pagine che una persona ha deciso dovessero esistere, l'opposto del problema descritto dalla guida. La riga di ambito nomina le piattaforme di hosting e gli strumenti che consentono agli utenti di pubblicare pagine condivise, contenuti generati o applicazioni web. Se hai commenti, forum o profili dei membri, vale l'indicazione più vecchia: nofollow o ugc sui link degli account inaffidabili e noindex per gli utenti nuovi finché non costruiscono reputazione.
Devo usare il robots.txt o un tag noindex?
noindex, e uno solo dei due per rotta. La frase di Google elenca entrambe le opzioni, ma fanno cose diverse. Un Disallow nel robots.txt blocca la scansione, e un URL bloccato ma collegato da altrove può restare nei risultati senza snippet. Il noindex funziona solo quando Google riesce a scansionare la pagina e a leggerla. In pratica questo significa un meta tag o un header di risposta, e mai una regola robots.txt sullo stesso percorso.
Mettere le pagine di condivisione in noindex mi costerà traffico?
Controlla la rotta prima di decidere, non dopo. Se una pagina guadagna impressioni solo sulla propria stringa URL, non sta portando traffico organico e rimuoverla non costa nulla. Il pattern che perde traffico è abbattere una galleria pubblica insieme agli output che contiene. Mantieni la galleria indicizzabile, metti noindex su ciò che sta dietro e segui il rendimento su Search delle query della galleria prima e dopo.
I motori di ricerca IA rispettano noindex?
Le funzioni IA di Google sì, perché AI Overviews e AI Mode pescano dallo stesso indice, quindi la direttiva toglie la pagina sia dai link blu sia dalle risposte IA. Gli altri crawler IA sono una decisione separata. Il comportamento dei fornitori varia e cambia senza changelog, quindi leggi la documentazione di ciascun crawler e recupera la pagina con il suo user agent invece di dare per scontato che una direttiva li copra tutti.
Autrice: Grace Miller, analista del rischio AI Search in Auspia. Segue oltre 200 cambiamenti di policy. Scrive di regole di piattaforma, rischio dei contenuti e ottimizzazione consapevole delle policy.