Un tracker di visibilità AI sembra lineare. Fai qualche domanda di categoria a un assistente, annoti se il tuo brand è comparso e disegni il tutto su un asse temporale.
Il problema sta a monte della registrazione. Quello che misuri non sta fermo. Invia lo stesso prompt allo stesso modello due volte e otterrai due risposte che si sovrappongono solo in parte. Registrane una e avrai registrato un campione di una distribuzione, per poi presentarlo come un fatto.
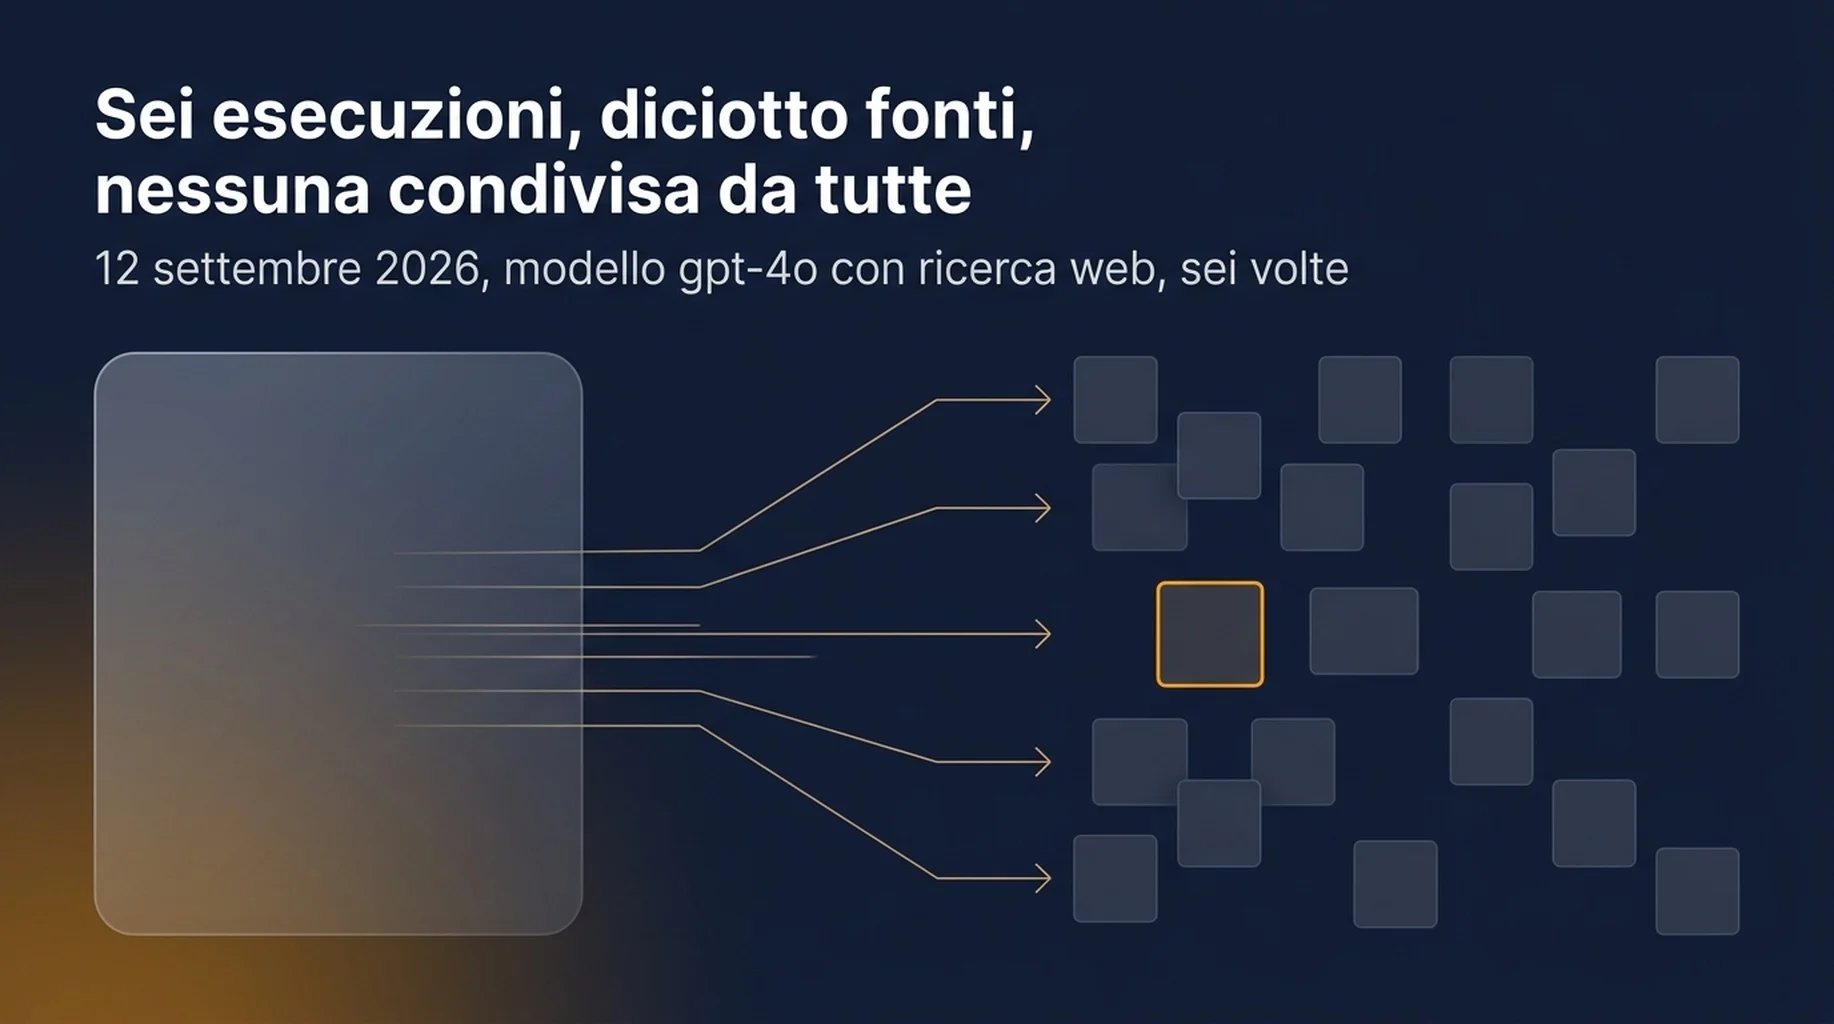
Volevamo sapere quanto è grande davvero questa dispersione, così abbiamo fatto l'esperimento invece di darlo per scontato. La versione breve: sei richieste identiche hanno prodotto diciotto fonti citate, e nessuna fonte è stata citata in tutte e sei.
Questo articolo parla di cosa abbiamo eseguito, di cosa è tornato indietro e dei quattro campi che un tracker di visibilità AI deve memorizzare perché il numero valga un secondo sguardo il mese prossimo.
Cosa abbiamo eseguito
Due esperimenti, entrambi con prompt che un team SaaS userebbe davvero in una ricerca di categoria.
Esperimento 1: un prompt, un modello, sei esecuzioni. Il modello gpt-4o, ricerca web attiva, Stati Uniti, inglese. Il prompt: "Quali sono i migliori strumenti di monitoraggio delle posizioni per un piccolo team SaaS nel 2026? Fornisci un elenco breve con le fonti." Sei chiamate live separate, eseguite in sequenza nella stessa finestra di sessione.
Esperimento 2: due modelli, lo stesso prompt, tre esecuzioni ciascuno. Lo stesso prompt è stato inviato a Claude Sonnet 5 e a Gemini 3.8 Flash, tre volte ciascuno, senza ricerca web. Senza ricerca misuriamo quali prodotti il modello nomina dalla propria conoscenza, che è un segnale diverso da quali fonti cita.
Abbiamo anche inviato un secondo prompt lungo lo stesso percorso di ricerca web quattro volte, per vedere se il comportamento di citazione è coerente tra tipi di domanda: "Come faccio a monitorare gli AI Overviews del mio sito? Fornisci metodi concreti con le fonti."
Sei esecuzioni non sono un campione ampio, e le trattiamo come tale. Bastano a mostrare la direzione e l'ordine di grandezza approssimativo della variazione, e questo è il punto.
Risultato 1: diciotto fonti, zero condivise da tutte e sei le esecuzioni
Le sei esecuzioni con ricerca web hanno citato, insieme, 18 URL diversi. Ecco con che frequenza è comparso ciascun dominio.
Numero di citazioni (su 6 esecuzioni) | Domini |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Nessun dominio è stato citato in tutte e sei le esecuzioni. Nessun URL è stato citato in tutte e sei le esecuzioni.
Il numero che conta qui è la sovrapposizione tra esecuzioni. Confrontando ogni coppia di esecuzioni, la sovrapposizione media di Jaccard sugli URL citati è stata 0,167. In due delle quindici coppie la sovrapposizione era esattamente zero, cioè quelle due risposte non condividevano alcuna fonte.
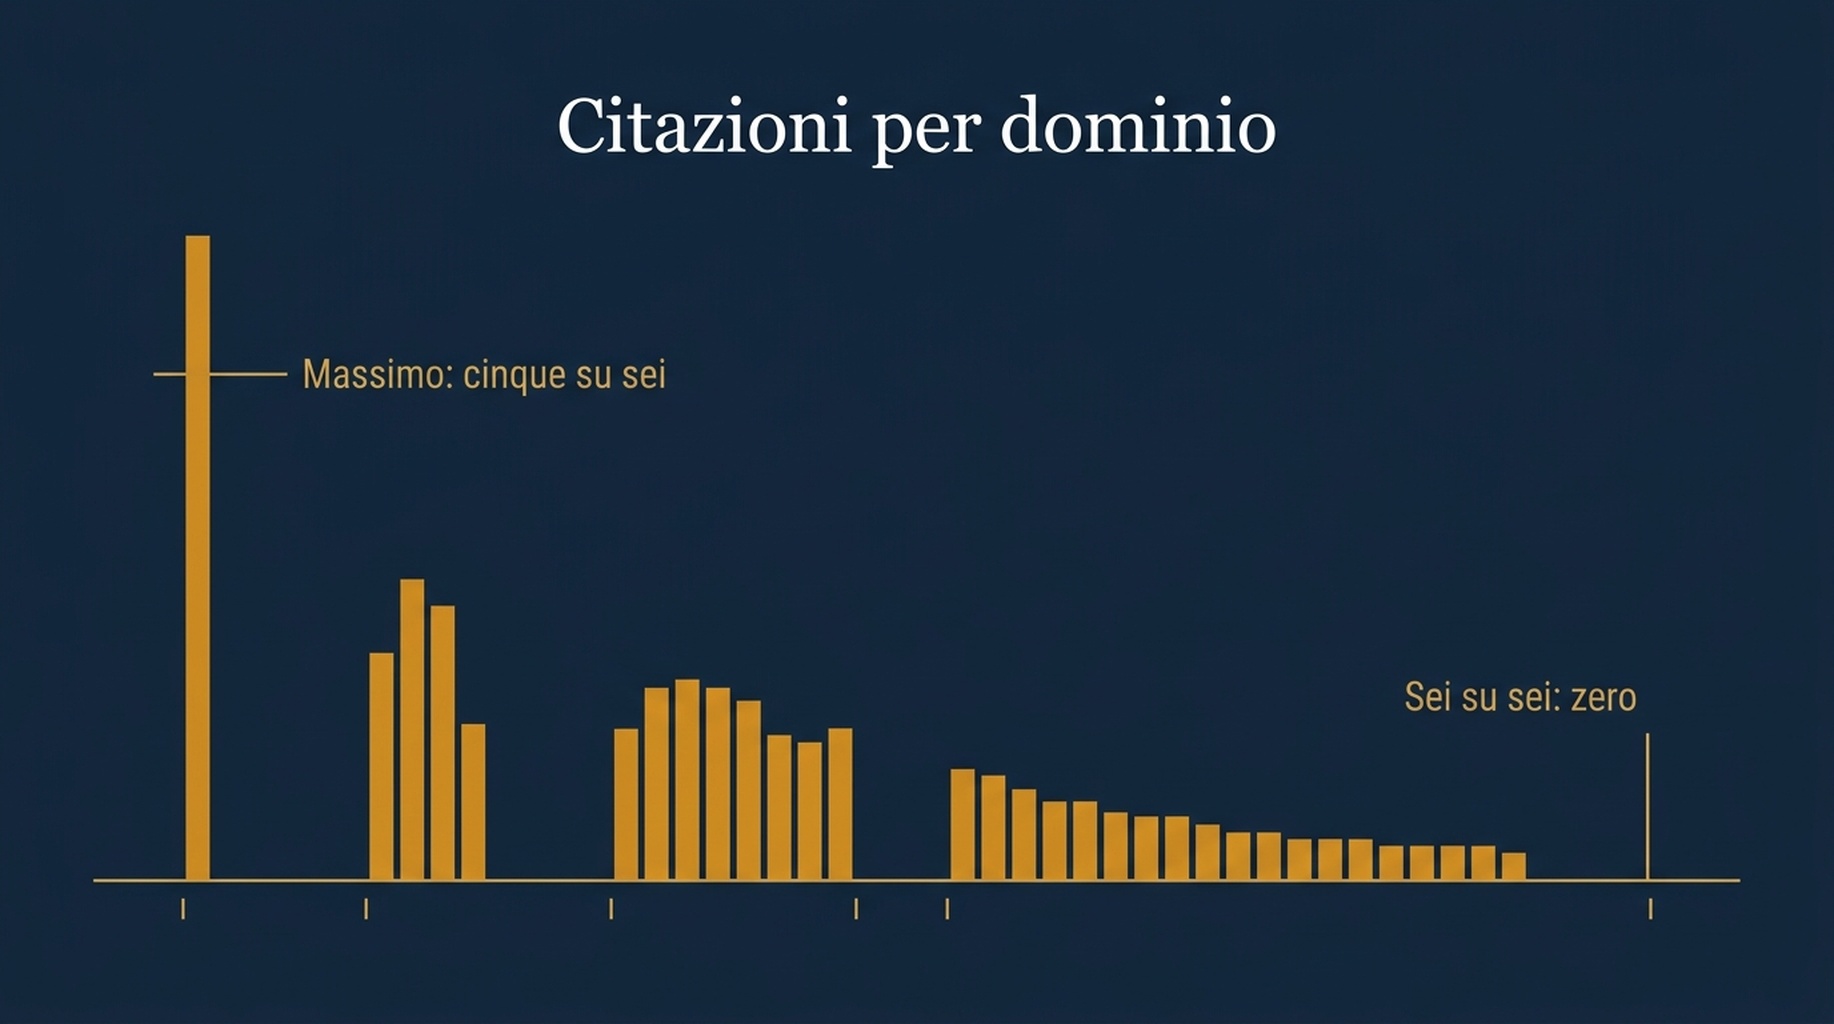
Una fonte citata in cinque esecuzioni su sei è il tetto che abbiamo osservato. Nulla è stato citato ogni volta.
In quella tabella è sepolto un secondo risultato. I domini verso cui il modello ha allungato la mano, in gran parte, non sono i siti di confronto noti della categoria. Nove dei diciotto domini sono comparsi esattamente una volta, e alcuni sono siti piccoli il cui contenuto si legge come qualcosa messo insieme per quella query, non come il frutto di un'inchiesta. Per un brand è un'arma a doppio taglio. Significa che lo slot di citazione è più facile da conquistare di una classifica tradizionale dei "migliori strumenti". Significa anche che lo slot è occupato da chi ha prodotto una pagina che combaciava con la forma della query in quell'esecuzione, e che verrà riempito di nuovo all'esecuzione successiva.
Risultato 2: la risposta stessa cambia dimensione
Le citazioni si sono mosse, e la lunghezza della risposta si è mossa con loro.
Esecuzione | Token in uscita | Lunghezza della risposta | Costo dell'esecuzione |
|---|---|---|---|
1 | 505 | 2.153 caratteri | $0,0735 |
2 | 860 | 3.728 caratteri | $0,0770 |
3 | 1.108 | 4.746 caratteri | $0,0797 |
4 | 832 | 3.555 caratteri | $0,0765 |
5 | 870 | 3.547 caratteri | $0,0772 |
6 | 813 | 3.544 caratteri | $0,0768 |
La lunghezza dell'output è andata da 505 a 1.108 token, un'ampiezza di 603 token, circa il 73 per cento della media. La risposta più lunga era più del doppio della più corta. Cinque delle sei esecuzioni sono cadute in una fascia abbastanza stretta, tra 813 e 1.108 token; una si è fermata presto a 505 e ha citato cinque fonti invece di nove-quattordici.
Per la misurazione questo conta in modo specifico. Se il tuo tracker cattura "il brand compare nella risposta e in quale posizione", un'esecuzione corta ha meno slot in cui comparire. Un team che campiona una volta a settimana e per caso ha pescato un'esecuzione corta registrerà un risultato peggiore di un team che ha pescato un'esecuzione lunga, senza che nulla sia cambiato sul sito.
Risultato 3: alcuni prompt non ricevono alcuna citazione
Il secondo prompt, sul monitoraggio degli AI Overviews, è passato lungo lo stesso percorso di ricerca web quattro volte ed è tornato con zero citazioni ogni volta.
Esecuzione | Token in uscita | Lunghezza della risposta | Citazioni |
|---|---|---|---|
1 | 479 | 2.135 caratteri | 0 |
2 | 522 | 2.240 caratteri | 0 |
3 | 534 | 2.312 caratteri | 0 |
4 | 497 | 2.228 caratteri | 0 |
Le risposte erano stabili in lunghezza, variando solo dell'8 per cento nelle quattro esecuzioni. Ma il modello ha risposto dalla propria conoscenza e non ha nominato alcuna fonte, quindi non c'era nulla da registrare nella colonna delle citazioni.
Da qui nasce una lettura del tracker specifica e fuorviante. Una dashboard del tasso di citazione mostrerà zero per questa domanda, e sembra un fallimento di visibilità. Non lo è. È una forma di domanda che non innesca la ricerca delle fonti. La lettura corretta è "citazione non applicabile", e un tracker che non riesce a distinguerla da "citazione verificata ed eri assente" ti manderà a inseguire un problema che non esiste.
Risultato 4: cambiare modello è un'altra misurazione, non una ripetizione
Con la ricerca web disattivata abbiamo misurato quali prodotti nomina ciascun modello. Questo isola l'insieme di raccomandazioni del modello stesso da tutto ciò che l'indice di ricerca ha restituito in quel minuto.
Claude Sonnet 5 ha nominato da quattro a cinque prodotti per esecuzione. Su tre esecuzioni ha nominato sei prodotti diversi: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat e SerpWatcher. Tre di essi sono comparsi in tutte e tre le esecuzioni: AccuRanker, Ahrefs e SEMrush. Sovrapposizione media a coppie 0,587.
Gemini 3.8 Flash ha nominato da due a cinque prodotti per esecuzione. Su tre esecuzioni ha nominato sette prodotti diversi: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush e Wincher. Solo uno di essi, SE Ranking, è comparso in tutte e tre le esecuzioni. Sovrapposizione media a coppie 0,306.
Tra i due modelli, quattro prodotti sono stati nominati da entrambi e cinque da uno solo.
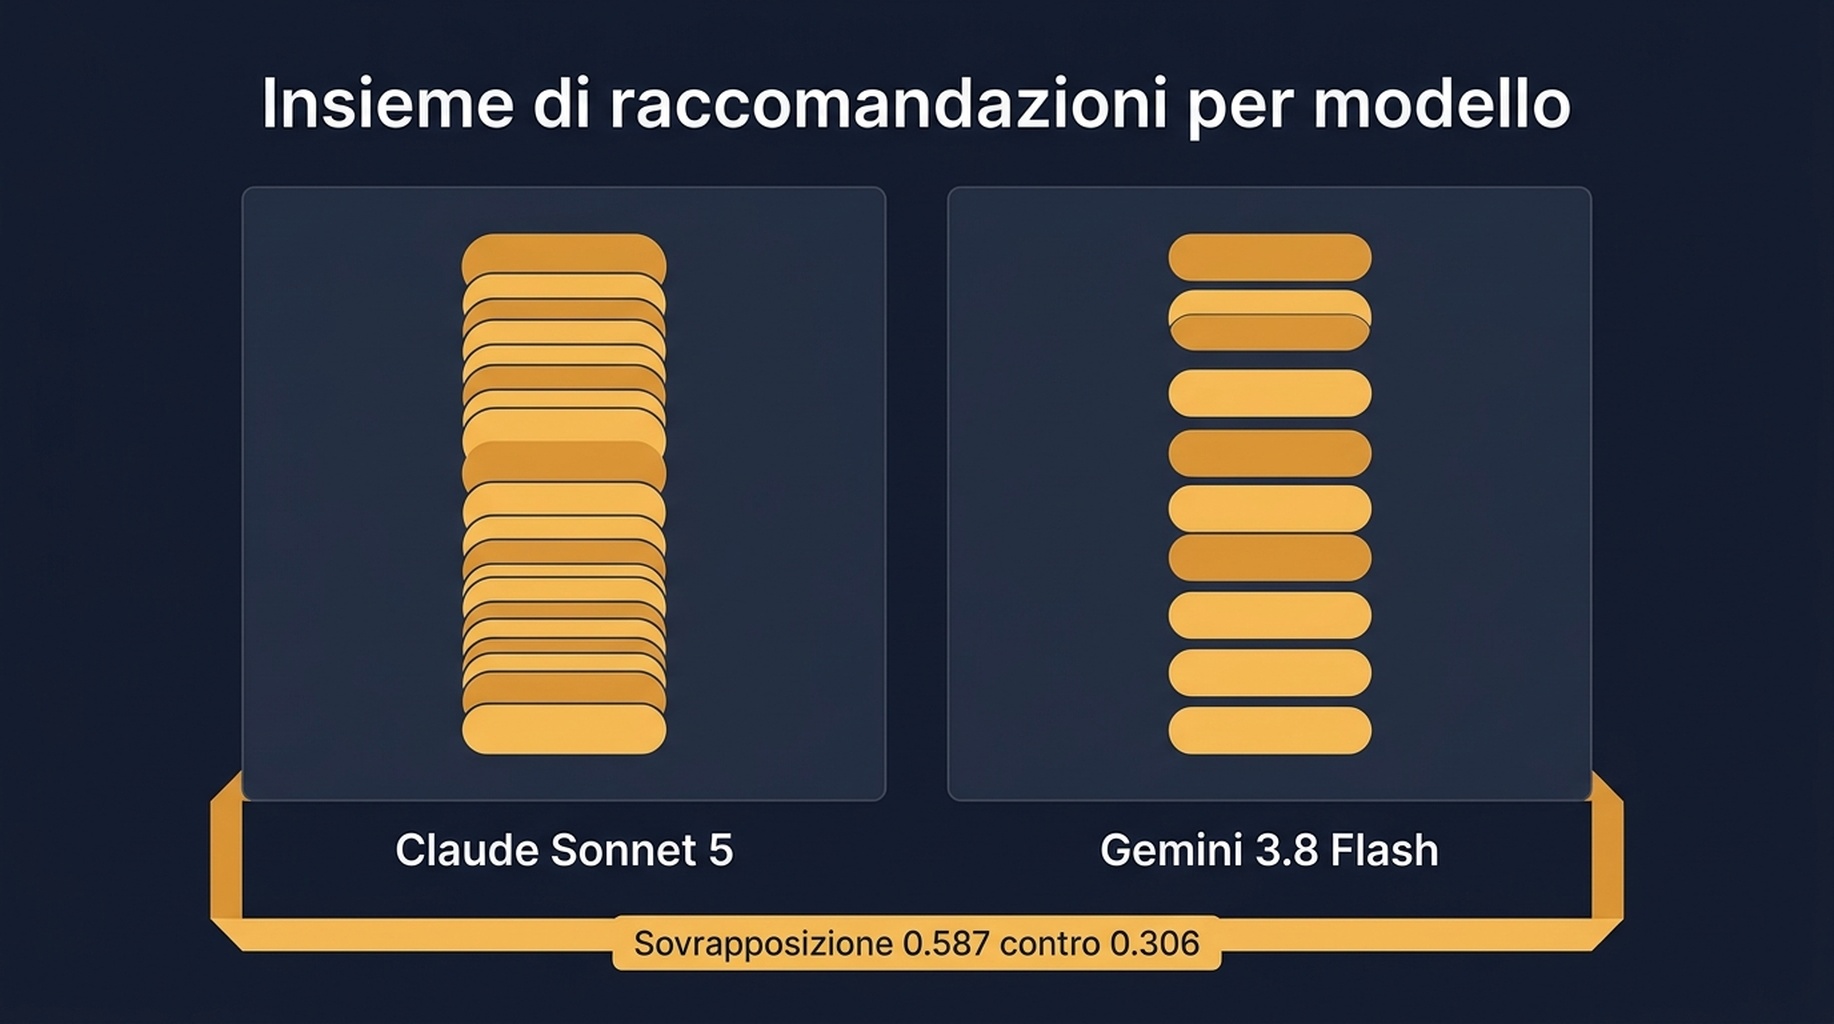
La stessa domanda produce un insieme di raccomandazioni in parte diverso su ogni modello e a ogni esecuzione.
La conseguenza pratica: se monitori la "visibilità AI" come un numero unico, stai facendo la media su almeno due fonti indipendenti di variazione, cioè l'esecuzione e il modello. Un brand che compare stabilmente su un assistente e non compare su un altro è un risultato reale e attuabile. Un brand la cui misurazione su un singolo campione si è spostata di due posizioni è rumore.
Cosa dovrebbe registrare un tracker di visibilità AI
Quattro campi trasformano uno screenshot in una misurazione.
Il numero di esecuzioni, non il risultato dell'esecuzione. Memorizza ogni esecuzione e riporta l'intervallo. "Citato in 4 esecuzioni su 6" è un fatto. "Citato, posizione 3" è una coincidenza. Sei esecuzioni sono un limite inferiore ragionevole per un programma piccolo; dodici sono meglio se il prompt ha importanza commerciale.
Il campo della citazione separato dal campo della menzione. "Il modello ci ha raccomandati" e "il modello ha linkato noi" sono due risultati diversi, con due rimedi diversi. Le nostre sei esecuzioni hanno prodotto 18 citazioni da 18 URL diversi; un tracker che registra solo menzioni di brand non avrebbe catturato nulla di quel movimento.
Lo stato del canale di risposta. Registra se l'esecuzione ha usato la ricerca web e registra la lunghezza della risposta. Un'esecuzione con zero citazioni e un'esecuzione con zero menzioni appaiono identiche in dashboard e significano l'opposto.
Il testo del prompt parola per parola, con il numero di versione. La formulazione del prompt determina quali fonti vengono tirate dentro. Se il prompt cambia tra un mese e l'altro, la linea di tendenza si spezza. Versiona il prompt come versioni uno script di monitoraggio.
Costruire il ciclo di esecuzione
La verifica manuale non sopravvive a un incontro con il calendario. Il ciclo è uno script che esegue un prompt N volte, memorizza ogni risposta grezza con le sue citazioni e confronta la finestra attuale con quella precedente.
Questo si adatta bene a un agente, perché il lavoro è ripetitivo, vincolato da regole e richiede un registro scritto. In Claude Code o Codex, l'istruzione utile è lasciare le esecuzioni grezze su disco e non sovrascriverle mai, poi riportare una tabella di sintesi invece di un numero unico. Se stai già recuperando dati di Search Console e Bing tramite server MCP, la stessa sessione può tenere il registro delle citazioni accanto ai dati di impression, ed è lì che i due numeri iniziano a essere utili insieme. Le nostre note su cosa espongono quei server sono in cosa fanno davvero quattro server SEO MCP, e il lato presenza dello stesso problema è in il nostro snapshot AI Overview su quaranta query.
Una regola di progettazione conta più delle altre: l'output del tracker deve essere una distribuzione. Riporta "citato in 4 su 6", non "citato". Riporta l'elenco delle fonti, non la fonte numero uno. Qualsiasi dashboard che comprime sei esecuzioni in un numero ha buttato via l'unica informazione che le esecuzioni extra avevano comprato.
Se l'obiettivo è il confronto con i concorrenti e non il monitoraggio, un ciclo di monitoraggio delle posizioni nel tempo è lo strumento più adatto, e i compromessi tra fonti di dati sono in costruire un tracker di posizioni da due fonti.
Limiti di un campione di sei esecuzioni
Tre avvertenze oneste.
Il campione è piccolo. Sei esecuzioni inquadrano la dispersione solo in modo lasco. Stabiliscono che la sovrapposizione tra esecuzioni è parziale e che coppie a sovrapposizione zero accadono; non ti danno un intervallo di confidenza per la tua categoria.
I risultati sono legati al momento. Queste esecuzioni sono state fatte il 12 settembre 2026 su modelli in produzione. Sia i modelli sia i risultati di ricerca sotto di essi cambiano.
I domini citati sono un campione di un singolo prompt commerciale. Una forma di domanda diversa, come una domanda di confronto o una domanda di tipo pratico, produrrà uno schema di citazione diverso. La mossa utile è eseguire lo stesso disegno sui tuoi dieci prompt commercialmente più importanti e registrare come si comporta la tua categoria.
Domande frequenti
Quante esecuzioni servono prima che il numero di visibilità AI abbia senso? Sei è il limite inferiore pratico per un singolo prompt, e il numero va riportato come conteggio sulle esecuzioni, non come posizione. Se il prompt guida decisioni di ricavo, dodici esecuzioni danno una lettura più stretta per pochi dollari.
Questo significa che monitorare la visibilità AI non vale la pena? Significa che il monitoraggio su un singolo campione non vale. La variazione è il risultato. Un tracker che riporta "citato in 4 su 6 esecuzioni, le fonti sono cambiate di 12 domini dallo scorso mese" sta descrivendo un sistema reale in cui un concorrente si sta giocando lo spazio.
Perché un prompt è tornato con zero citazioni? Il modello ha risposto dalla propria conoscenza invece di cercare le fonti. È una proprietà della domanda, non un fallimento del tuo sito. Monitorala come non applicabile, non come zero.
Dovrei monitorare ChatGPT, Claude e Gemini separatamente? Sì. Nel nostro confronto su tre esecuzioni, i due modelli si sovrapponevano solo su quattro dei nove prodotti nominati. Fare la media nasconde una decisione a livello di programma su quale assistente ottimizzare per primo.
Si può ridurre la variazione abbassando la temperatura del modello? In parte, e vale la pena provarlo sui tuoi prompt. Ma l'insieme delle citazioni è mosso anche dall'indice di ricerca, e quello non lo controlli. Il numero di esecuzioni è la leva più affidabile.
Vista Auspia: se questo trimestre costruisci il monitoraggio della visibilità AI, costruisci il registro delle esecuzioni prima della dashboard. La dashboard è una scelta di resa. Il registro delle esecuzioni è la misurazione. Parti da dieci prompt, sei esecuzioni ciascuno, memorizzati parola per parola, e in una settimana imparerai più di quanto ti direbbe un anno intero di verifiche su un singolo campione.
Scritto da: Ethan Marlowe, guida della misurazione GEO su oltre 500 prompt in Auspia. Scrive di monitoraggio dei prompt, report di citazione e dashboard di visibilità che sopravvivono al contatto con un ciclo di misurazione reale.