Un outil de suivi de la visibilité dans l'IA semble simple. On pose quelques questions de catégorie à un assistant, on note si sa marque est apparue, et on trace cela dans le temps.
Le problème se situe en amont de l'enregistrement. Ce que vous mesurez ne tient pas en place. Envoyez le même prompt au même modèle deux fois et vous obtenez deux réponses qui ne se recoupent que partiellement. Enregistrez l'une des deux et vous avez enregistré un échantillon d'une distribution, avant de le présenter comme un fait.
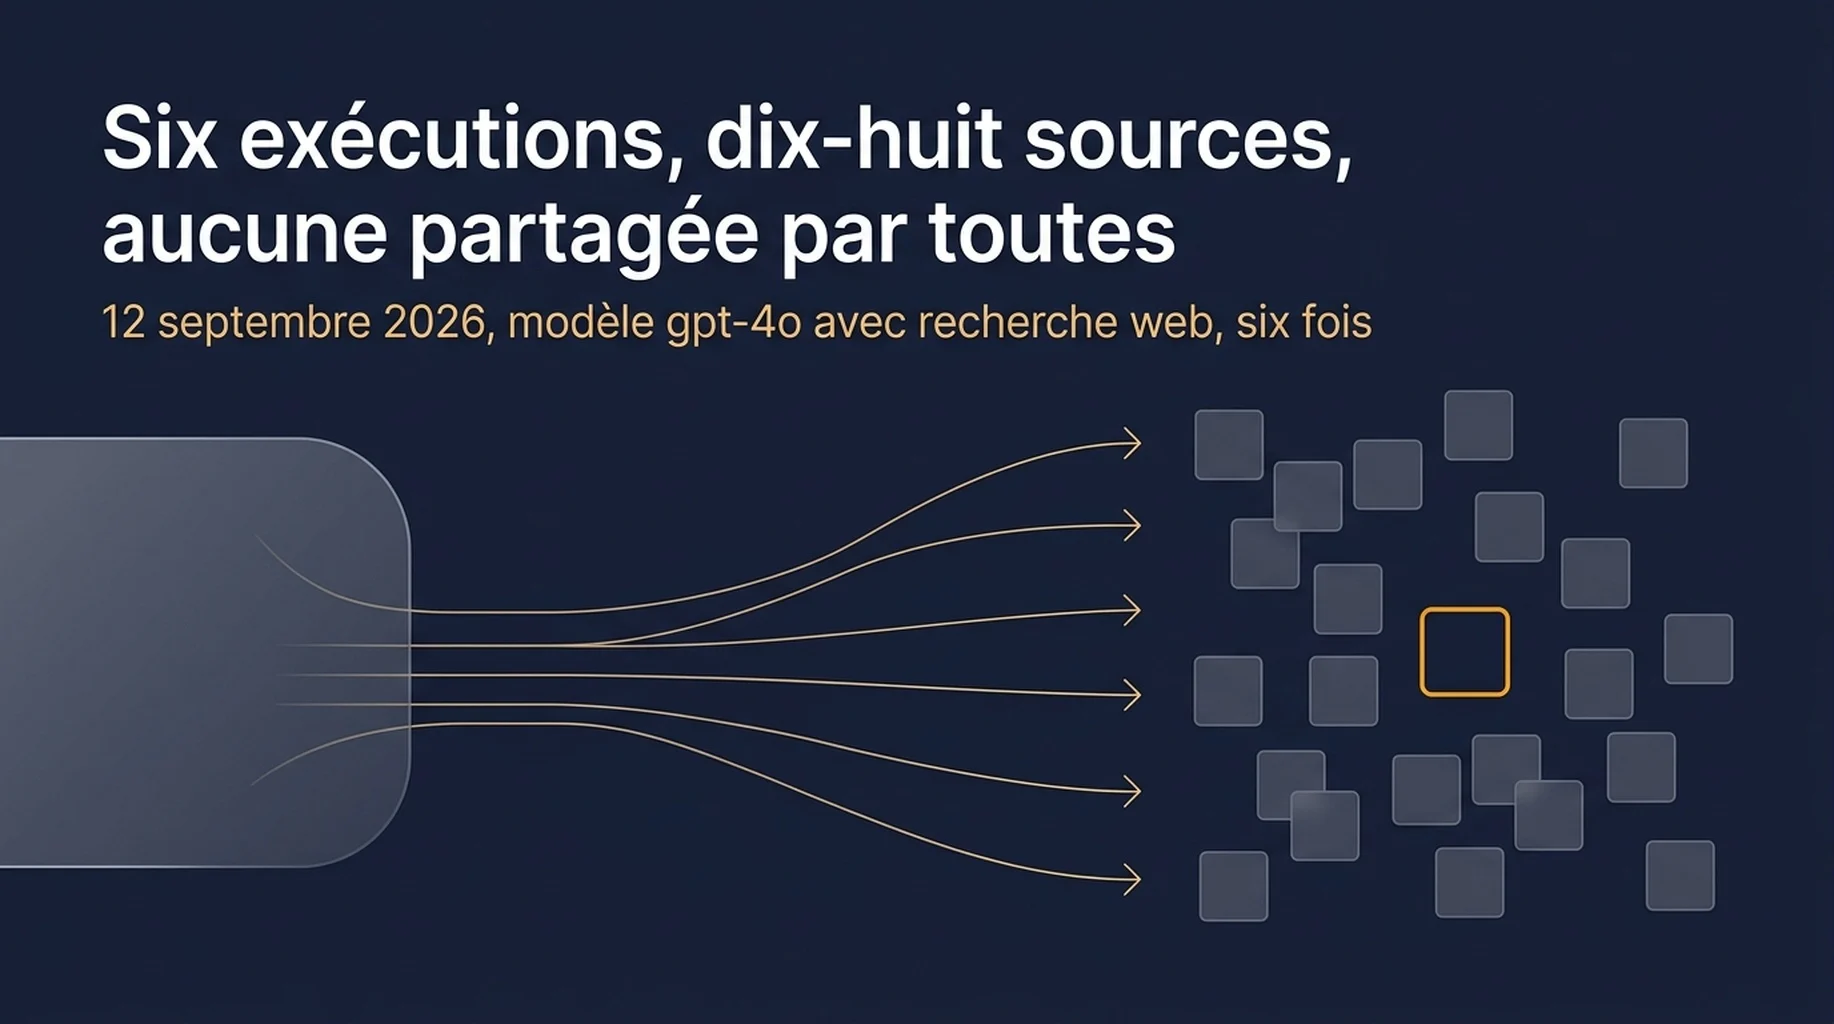
Nous voulions savoir quelle est réellement l'ampleur de cette dispersion, alors nous avons mené l'expérience au lieu de la supposer. La version courte : six requêtes identiques ont produit dix-huit sources citées, et aucune source n'a été citée dans les six.
Cet article porte sur ce que nous avons lancé, sur ce qui est revenu, et sur les quatre champs qu'un outil de suivi de la visibilité dans l'IA doit stocker pour que le chiffre mérite un second regard le mois prochain.
Ce que nous avons lancé
Deux expériences, toutes deux sur des prompts qu'une équipe SaaS utiliserait réellement pour une étude de catégorie.
Expérience 1 : un prompt, un modèle, six exécutions. Le modèle gpt-4o, recherche web activée, États-Unis, anglais. Le prompt : « Quels sont les meilleurs outils de suivi de position pour une petite équipe SaaS en 2026 ? Donne une liste courte avec les sources. » Six appels en direct distincts, exécutés à la suite dans la même fenêtre de session.
Expérience 2 : deux modèles, le même prompt, trois exécutions chacun. Le même prompt a été envoyé à Claude Sonnet 5 et à Gemini 3.8 Flash, trois fois chacun, sans recherche web. Sans recherche, nous mesurons quels produits le modèle nomme de sa propre connaissance, ce qui est un signal distinct de celui des sources qu'il cite.
Nous avons aussi envoyé un second prompt par le même chemin de recherche web, quatre fois, pour voir si le comportement de citation est cohérent d'un type de question à l'autre : « Comment suivre les AI Overviews de mon site ? Donne des méthodes concrètes avec les sources. »
Six exécutions ne constituent pas un grand échantillon, et nous les traitons comme tel. Elles suffisent à montrer la direction et l'ordre de grandeur approximatif de la variation, et c'est là tout l'intérêt.
Résultat 1 : dix-huit sources, zéro partagée par les six exécutions
Les six exécutions avec recherche web ont cité, au total, 18 URL différentes. Voici la fréquence d'apparition de chaque domaine.
Nombre de citations (sur 6 exécutions) | Domaines |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Aucun domaine n'a été cité dans les six exécutions. Aucune URL n'a été citée dans les six exécutions.
Le chiffre qui compte ici est le recoupement entre exécutions. En comparant chaque paire d'exécutions, le recoupement de Jaccard moyen sur les URL citées était de 0,167. Dans deux des quinze paires, le recoupement était exactement nul, c'est-à-dire que ces deux réponses ne partageaient aucune source.
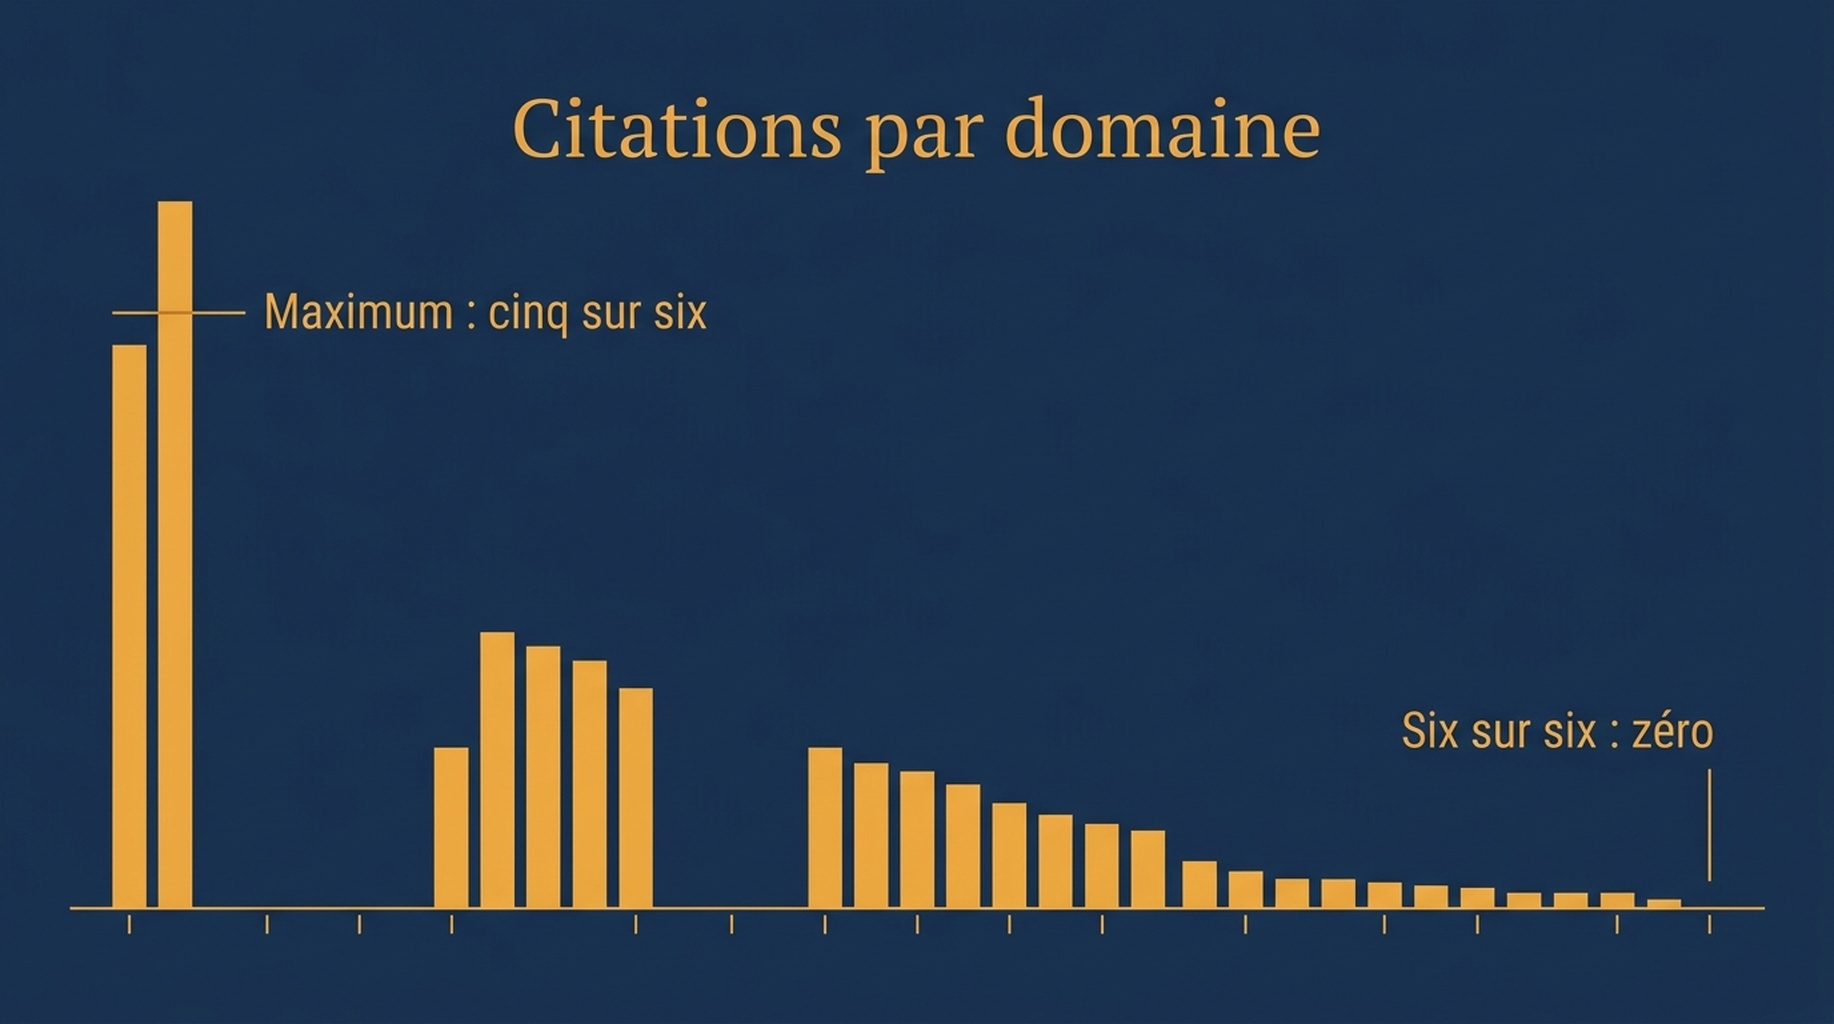
Une source citée dans cinq des six exécutions est le plafond que nous avons observé. Rien n'a été cité à chaque fois.
Un second constat est enfoui dans ce tableau. Les domaines que le modèle est allé chercher ne sont, pour la plupart, pas les sites comparatifs connus de la catégorie. Neuf des dix-huit domaines sont apparus exactement une fois, et certains sont de petits sites dont le contenu se lit comme quelque chose d'assemblé pour cette requête, et non comme le fruit d'une enquête. Pour une marque, c'est une arme à double tranchant. Cela signifie que la place de citation est plus facile à gagner qu'un classement traditionnel des « meilleurs outils ». Cela signifie aussi que la place est occupée par celui qui a produit une page correspondant à la forme de la requête lors de cette exécution, et qu'elle sera remplie à nouveau à l'exécution suivante.
Résultat 2 : la réponse elle-même change de taille
Les citations ont bougé, et la longueur de la réponse a bougé avec elles.
Exécution | Tokens en sortie | Longueur de la réponse | Coût de l'exécution |
|---|---|---|---|
1 | 505 | 2 153 caractères | $0,0735 |
2 | 860 | 3 728 caractères | $0,0770 |
3 | 1 108 | 4 746 caractères | $0,0797 |
4 | 832 | 3 555 caractères | $0,0765 |
5 | 870 | 3 547 caractères | $0,0772 |
6 | 813 | 3 544 caractères | $0,0768 |
La longueur de sortie allait de 505 à 1 108 tokens, un écart de 603 tokens, soit environ 73 pour cent de la moyenne. La réponse la plus longue faisait plus du double de la plus courte. Cinq des six exécutions tombaient dans une fourchette assez étroite, entre 813 et 1 108 tokens ; une exécution s'est arrêtée tôt à 505 et a cité cinq sources au lieu de neuf à quatorze.
Pour la mesure, cela compte d'une manière précise. Si votre outil capture « la marque apparaît-elle dans la réponse, et à quelle position », une exécution courte offre moins de places où apparaître. Une équipe qui échantillonne une fois par semaine et qui est tombée par hasard sur une exécution courte enregistrera un résultat moins bon qu'une équipe tombée sur une exécution longue, sans que rien n'ait changé sur le site.
Résultat 3 : certains prompts ne reçoivent aucune citation
Le second prompt, sur le suivi des AI Overviews, est passé par le même chemin de recherche web quatre fois et est revenu avec zéro citation à chaque fois.
Exécution | Tokens en sortie | Longueur de la réponse | Citations |
|---|---|---|---|
1 | 479 | 2 135 caractères | 0 |
2 | 522 | 2 240 caractères | 0 |
3 | 534 | 2 312 caractères | 0 |
4 | 497 | 2 228 caractères | 0 |
Les réponses étaient stables en longueur, ne variant que de 8 pour cent sur les quatre exécutions. Mais le modèle a répondu de sa propre connaissance et n'a nommé aucune source, il n'y avait donc rien à enregistrer dans la colonne des citations.
Il en découle une lecture précise et trompeuse de l'outil. Un tableau de bord du taux de citation affichera zéro pour cette question, et cela ressemble à un échec de visibilité. Ce n'en est pas un. C'est une forme de question qui ne déclenche pas de recherche de sources. La lecture correcte est « citation non applicable », et un outil incapable de distinguer cela de « citation vérifiée et vous étiez absent » vous enverra courir après un problème qui n'existe pas.
Résultat 4 : changer de modèle est une autre mesure, pas une répétition
Recherche web désactivée, nous avons mesuré quels produits chaque modèle nomme. Cela isole l'ensemble de recommandations du modèle lui-même de tout ce que l'index de recherche a renvoyé cette minute-là.
Claude Sonnet 5 a nommé quatre à cinq produits par exécution. Sur trois exécutions, il a nommé six produits différents : AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat et SerpWatcher. Trois d'entre eux sont apparus dans les trois exécutions : AccuRanker, Ahrefs et SEMrush. Recoupement moyen par paires de 0,587.
Gemini 3.8 Flash a nommé deux à cinq produits par exécution. Sur trois exécutions, il a nommé sept produits différents : AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush et Wincher. Un seul d'entre eux, SE Ranking, est apparu dans les trois exécutions. Recoupement moyen par paires de 0,306.
Entre les deux modèles, quatre produits ont été nommés par les deux et cinq par un seul.
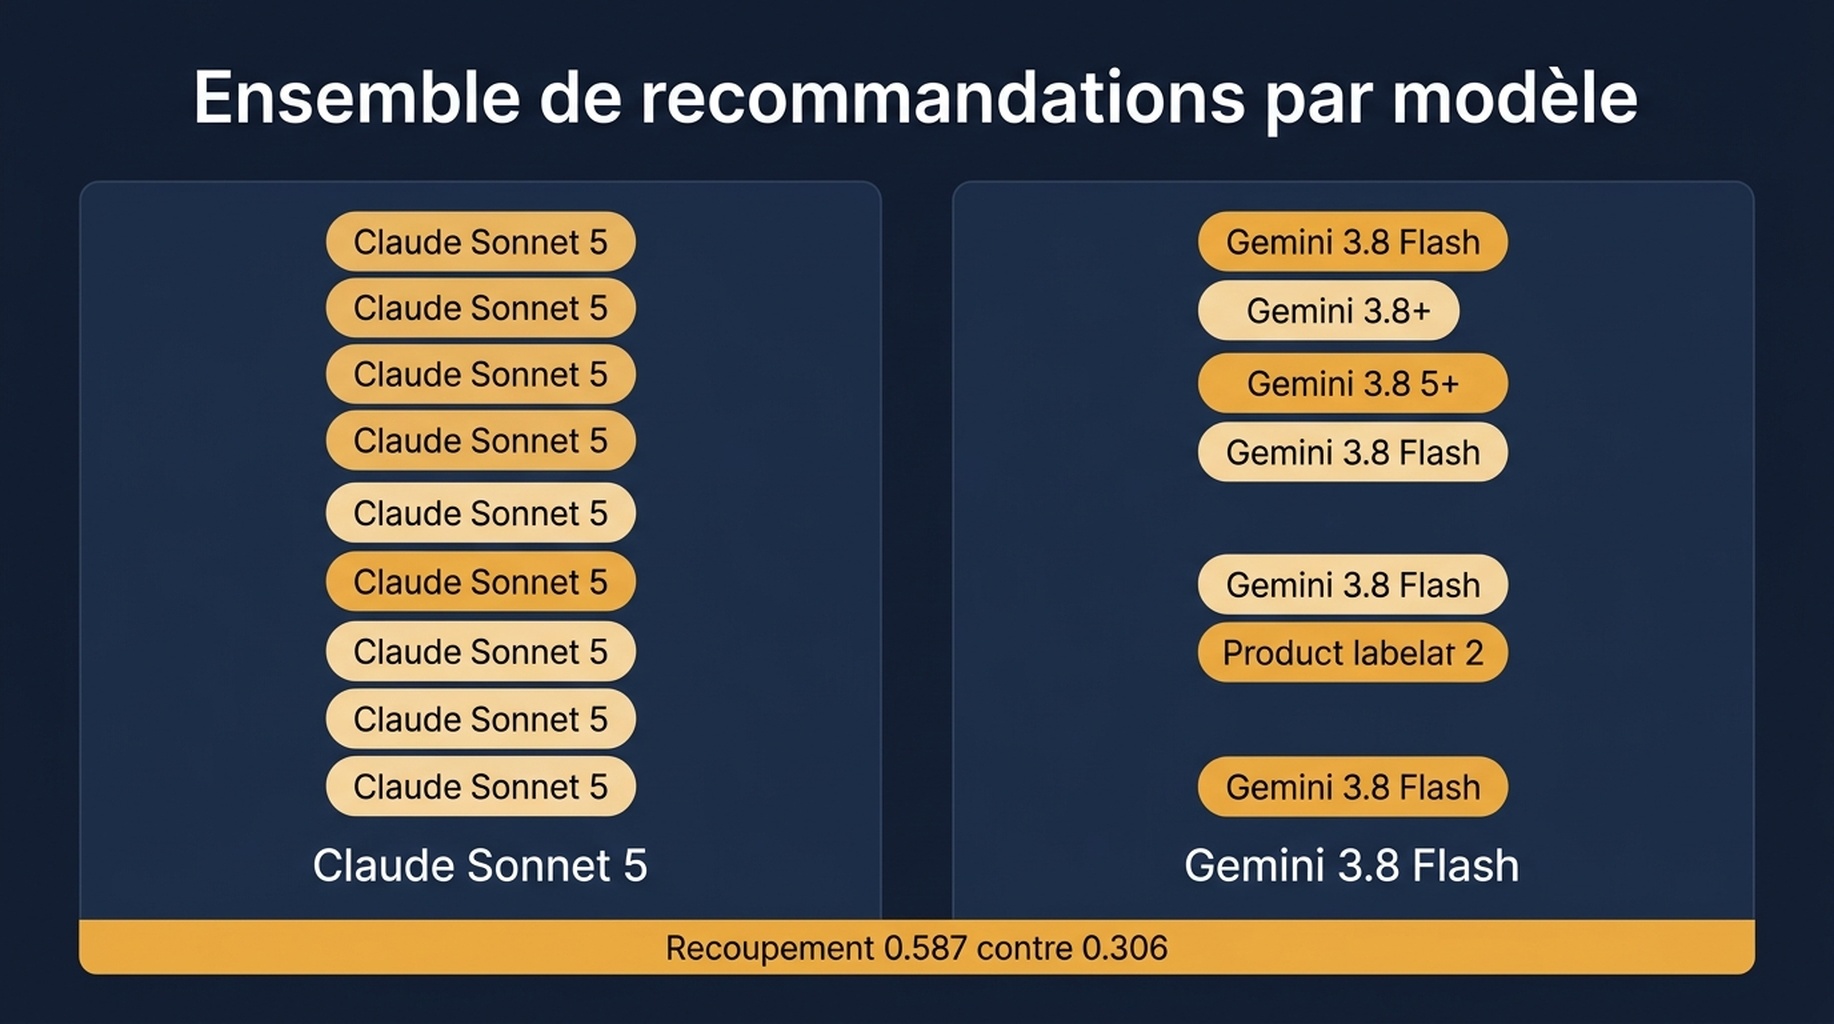
La même question produit un ensemble de recommandations partiellement différent sur chaque modèle et à chaque exécution.
La conséquence pratique : si vous suivez la « visibilité dans l'IA » comme un chiffre unique, vous faites la moyenne sur au moins deux sources indépendantes de variation, à savoir l'exécution et le modèle. Une marque qui apparaît régulièrement chez un assistant et pas chez un autre est un constat réel et actionnable. Une marque dont la mesure sur un seul échantillon a bougé de deux places est du bruit.
Ce qu'un outil de suivi de la visibilité dans l'IA doit enregistrer
Quatre champs transforment une capture d'écran en une mesure.
Le nombre d'exécutions, pas le résultat d'une exécution. Stockez chaque exécution et rendez compte de l'intervalle. « Cité dans 4 exécutions sur 6 » est un fait. « Cité, position 3 » est une coïncidence. Six exécutions constituent un plancher raisonnable pour un petit programme ; douze valent mieux si le prompt a une importance commerciale.
Le champ de citation séparé du champ de mention. « Le modèle nous a recommandés » et « le modèle a fait un lien vers nous » sont deux résultats différents, avec deux corrections différentes. Nos six exécutions ont produit 18 citations issues de 18 URL différentes ; un outil qui n'enregistre que les mentions de marque n'aurait rien capté de cette valse.
L'état du canal de réponse. Enregistrez si l'exécution a utilisé la recherche web, et enregistrez la longueur de la réponse. Une exécution à zéro citation et une exécution à zéro mention se ressemblent à l'identique sur un tableau de bord et signifient l'inverse.
Le texte du prompt, mot pour mot, avec un numéro de version. La formulation du prompt détermine quelles sources sont tirées. Si le prompt change d'un mois à l'autre, la courbe de tendance casse. Versionnez le prompt comme vous versionnez un script de suivi.
Construire la boucle d'exécution
La vérification manuelle ne survit pas à une rencontre avec un calendrier. La boucle est un script qui exécute un prompt N fois, stocke chaque réponse brute avec ses citations, puis compare la fenêtre courante à la précédente.
Cela convient bien à un agent, parce que le travail est répétitif, encadré par des règles et nécessite une trace écrite. Dans Claude Code ou Codex, la consigne utile est de laisser les exécutions brutes sur le disque et de ne jamais les écraser, puis de rendre compte d'un tableau de synthèse plutôt que d'un chiffre unique. Si vous récupérez déjà les données Search Console et Bing via des serveurs MCP, la même session peut tenir le journal des citations à côté des données d'impressions, et c'est là que les deux chiffres commencent à être utiles ensemble. Nos notes sur ce que ces serveurs exposent se trouvent dans ce que font réellement quatre serveurs SEO MCP, et le versant présence du même problème se trouve dans notre instantané AI Overview sur quarante requêtes.
Une règle de conception compte plus que les autres : la sortie de l'outil doit être une distribution. Rendez compte de « cité dans 4 sur 6 », pas de « cité ». Rendez compte de la liste des sources, pas de la source numéro un. Tout tableau de bord qui comprime six exécutions en un seul chiffre a jeté la seule information que les exécutions supplémentaires avaient achetée.
Si l'objectif est la comparaison concurrentielle plutôt que la surveillance, une boucle de suivi de position dans le temps est l'outil plus adapté, et les compromis entre sources de données se trouvent dans construire un outil de suivi de position à partir de deux sources.
Limites d'un échantillon de six exécutions
Trois réserves honnêtes.
L'échantillon est petit. Six exécutions ne délimitent la dispersion que de façon lâche. Elles établissent que le recoupement entre exécutions est partiel et que des paires à recoupement nul se produisent ; elles ne donnent pas d'intervalle de confiance pour votre catégorie.
Les résultats sont liés au moment. Ces exécutions ont été faites le 12 septembre 2026 face à des modèles en production. Les modèles comme les résultats de recherche en dessous changent.
Les domaines cités sont un échantillon d'un seul prompt commercial. Une autre forme de question, comme une question de comparaison ou une question de méthode, produira un schéma de citation différent. Le geste utile est de lancer le même dispositif sur vos dix prompts les plus importants commercialement et de noter comment votre catégorie se comporte.
Questions fréquentes
Combien d'exécutions me faut-il avant que le chiffre de visibilité dans l'IA ait un sens ? Six est le plancher pratique pour un prompt unique, et le chiffre doit être rapporté comme un décompte sur le nombre d'exécutions, pas comme une position. Si le prompt guide des décisions de chiffre d'affaires, douze exécutions donnent une lecture plus serrée pour quelques dollars.
Cela signifie-t-il que suivre la visibilité dans l'IA ne vaut pas la peine ? Cela signifie que le suivi sur un seul échantillon ne vaut rien. La variation est le constat. Un outil qui rapporte « cité dans 4 exécutions sur 6, les sources ont changé de 12 domaines depuis le mois dernier » décrit un système réel dans lequel un concurrent se dispute la place.
Pourquoi un prompt est-il revenu avec zéro citation ? Le modèle a répondu de sa propre connaissance au lieu de rechercher des sources. C'est une propriété de la question, pas une défaillance de votre site. Suivez-la comme non applicable, pas comme zéro.
Faut-il suivre ChatGPT, Claude et Gemini séparément ? Oui. Dans notre comparaison sur trois exécutions, les deux modèles ne se recoupaient que sur quatre des neuf produits nommés. Faire la moyenne masque une décision au niveau du programme : quel assistant optimiser en premier.
Peut-on réduire la variation en baissant la température du modèle ? En partie, et cela vaut la peine d'être testé sur vos prompts. Mais l'ensemble des citations est aussi mû par l'index de recherche, et celui-là vous ne le contrôlez pas. Le nombre d'exécutions est le levier le plus fiable.
Vue d'Auspia : si vous construisez un suivi de la visibilité dans l'IA ce trimestre, construisez le journal des exécutions avant le tableau de bord. Le tableau de bord est un choix d'affichage. Le journal des exécutions est la mesure. Commencez par dix prompts, six exécutions chacun, stockés mot pour mot, et vous apprendrez en une semaine plus qu'une année entière de vérification sur un seul échantillon ne vous dira.
Rédaction : Ethan Marlowe, responsable de la mesure GEO sur plus de 500 prompts chez Auspia. Écrit sur le suivi des prompts, les rapports de citation et les tableaux de bord de visibilité qui survivent au contact d'un vrai cycle de mesure.