Ce que vous obtiendrez au final
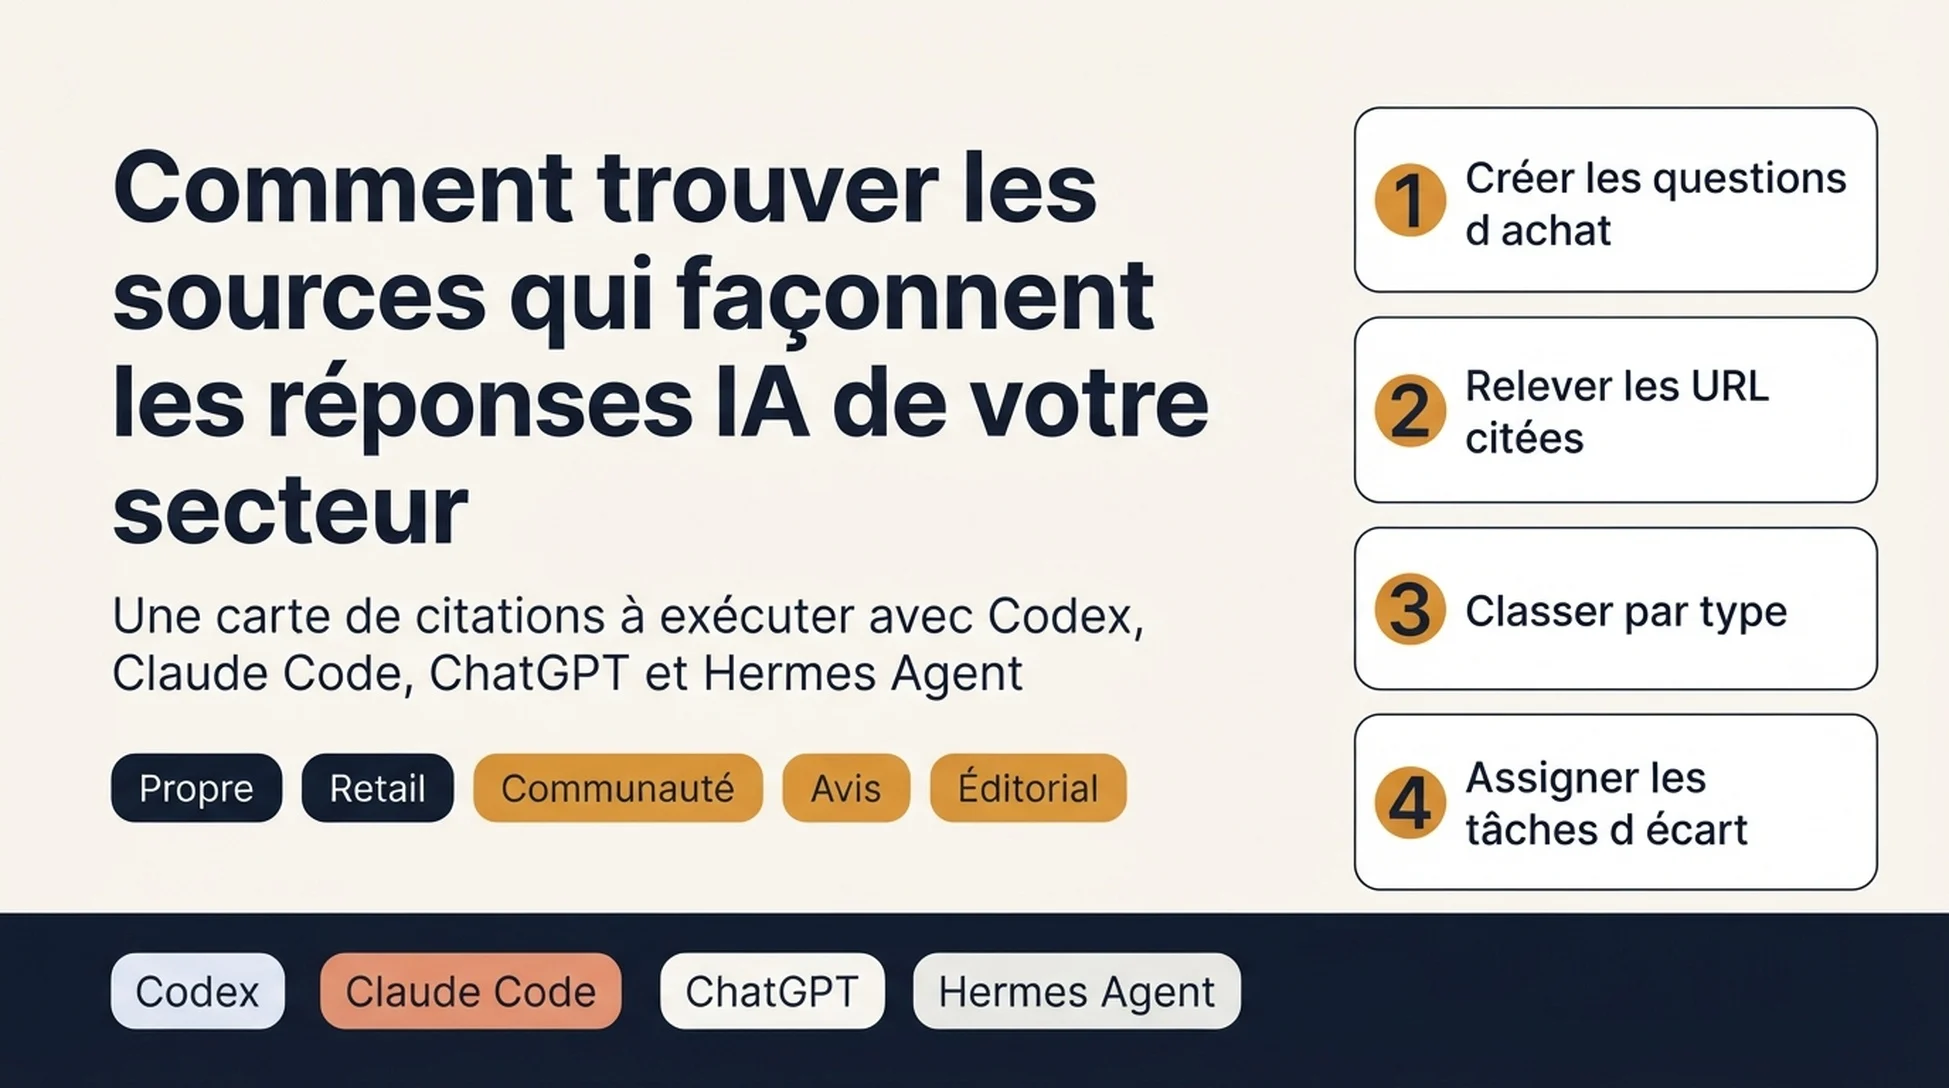
Une carte de citations est un relevé des pages qu'un moteur d'IA a réellement mobilisées pour répondre aux questions de vos acheteurs. Pas si votre marque est apparue dans la réponse. Mais de quelles sources cette réponse a été assemblée.
J'ai fait tourner cet exercice sur assez de catégories pour savoir que le premier résultat est souvent humiliant. Les équipes partent du principe que leur propre site porte ces réponses. C'est rarement le cas. Dans une catégorie B2B, les pages de l'éditeur lui-même représentaient une part infime, tandis qu'un site d'avis que personne n'avait revendiqué faisait l'essentiel du travail.
C'est tout l'intérêt de la démarche. Vous arrêtez de deviner et vous commencez à regarder les vraies pages.
À la fin de ce parcours, vous aurez :
- 10 à 20 vraies questions d'achat pour une catégorie de produit ou de service, formulées comme un client les poserait
- Chaque question exécutée dans les moteurs d'IA que vos acheteurs utilisent réellement, avec les sources citées relevées et datées
- Ces sources classées par type, pour voir d'où viennent les réponses de votre catégorie
- Une courte liste de pages où un concurrent est cité et vous non, chacune assortie d'une prochaine étape légitime
- Des responsables et une date de révision, pour que la carte ne pourrisse pas dans un dossier partagé
Pour qui : un responsable SEO, GEO ou contenu en interne, ou un stratège d'agence qui peut recommander un travail même si quelqu'un d'autre l'exécute. Aucun outil payant n'est nécessaire, même si cela aide à grande échelle.
Prérequis : un navigateur, un tableur et un accès en lecture à votre propre site. Pour les versions avec agent, une installation fonctionnelle de l'agent choisi, plus un dossier vers lequel le pointer.
Temps : environ deux heures pour la première passe sur une catégorie. Environ 45 minutes de ce total consistent à lancer des prompts et à copier des sources. Ces 45 minutes sont précisément la partie qui vaut la peine d'être confiée à un agent, et le reste est la partie qui exige votre jugement.
Ce que « terminé » signifie : vous pouvez nommer les trois ou quatre types de sources qui portent les réponses de votre catégorie, pointer des pages précises où vous êtes absent et un concurrent présent, et confier à quelqu'un une tâche avec une URL attachée. Si vous n'avez qu'une liste de domaines et le vague sentiment que Reddit compte, ce n'est pas terminé.
Le point de vue d'Auspia : la plupart des équipes foncent vers « il nous faut plus de mentions de marque » parce qu'elles n'ont jamais regardé de quoi la réponse était réellement composée. La carte transforme cette intuition floue en une page sur laquelle on peut agir.
Avant de commencer : les deux décisions qui déterminent tout
Deux choix déterminent ce que le reste produit. Les deux sont faciles à rater et les deux sont pénibles à défaire ensuite.
Choisissez une catégorie, pas toute votre activité. Une entreprise qui vend du logiciel et exploite aussi une activité de services a deux écosystèmes de sources distincts. Cartographier les deux en même temps produit une moyenne qui ne décrit ni l'un ni l'autre. Prenez la catégorie où l'enjeu de revenu est le plus fort et remettez le reste au trimestre suivant.
Choisissez les moteurs délibérément. Google AI Overview, ChatGPT, Perplexity et Gemini ne puisent pas dans le même réservoir. Une source qui a perdu de l'importance dans un moteur peut continuer à compter dans un autre. Lancez-en au moins deux. Si vous ne savez pas lesquels, demandez à l'équipe commerciale quelle interface les clients mentionnent, ou regardez votre trafic de référence venant de domaines d'IA.
Tracez une limite dès maintenant. C'est un exercice d'observation, pas de preuve. Vous relevez ce qu'un moteur a renvoyé un jour donné. Les réponses varient d'une exécution à l'autre, donc une observation isolée est un point de données, pas une tendance. Datez tout, sinon le fichier entier devient inutilisable au bout d'un mois.
Étape 1 : construire le jeu de questions
Écrivez 10 à 20 questions qu'un client poserait au moment de choisir. Pas des mots-clés. Des questions, dans les mots du client.
C'est l'étape que les gens bâclent, et c'est celle qui décide si le reste vaut la peine. Un jeu de questions construit à partir d'exportations de mots-clés produit une carte de la façon dont les gens cherchent. Un jeu construit à partir de notes d'appels commerciaux produit une carte de la façon dont les gens achètent. Ce ne sont pas les mêmes listes.
Matériaux utilisables :
- Les questions pré-achat les plus fréquentes reçues par votre équipe commerciale
- Les tickets de support des 30 premiers jours après l'achat
- Le bloc « autres questions » de vos requêtes commerciales principales
- Votre propre recherche de mots-clés, réécrite sous forme de questions
- Les recherches comparatives de concurrents que font vos acheteurs
Mélangez les formes de questions, car chacune attire des sources différentes.
Forme de la question | Exemple | Sources que cela fait souvent remonter |
|---|---|---|
Adéquation de catégorie | « Que doit regarder une PME logistique en choisissant un outil de tournées ? » | Listes éditoriales, sites d'avis |
Comparaison directe | « Outil A ou outil B pour une équipe de 20 personnes ? » | Pages comparatives, fils de communauté |
Risque et objection | « L'outil A est-il vraiment assez sûr pour des données de santé ? » | Forums, analyses de conformité, documentation de l'éditeur |
Prix et valeur | « Combien coûte réellement l'outil A par siège ? » | Pages de tarifs, fils de communauté, sites d'avis |
Mise en œuvre | « Combien de temps prend la migration depuis l'outil B ? » | Documentation, tutoriels YouTube, forums |
Résultat attendu : un tableur avec une ligne par question, une colonne pour la forme de la question et une colonne pour le moteur dans lequel vous l'exécuterez.
Contrôle qualité : relisez la liste et demandez-vous si un vrai acheteur taperait chaque question. Si une question n'a de sens que pour quelqu'un qui connaît déjà la taxonomie de votre produit, réécrivez-la. Dix questions qu'un acheteur poserait vraiment valent mieux que cinquante qui ressemblent à une exportation de mots-clés.
Voie de secours : si vous n'arrivez pas à dix questions, c'est un problème de recherche, pas de cartographie. Sortez les 20 dernières notes d'appels commerciaux ou les 50 derniers tickets de support et extrayez-en des questions avant de continuer.
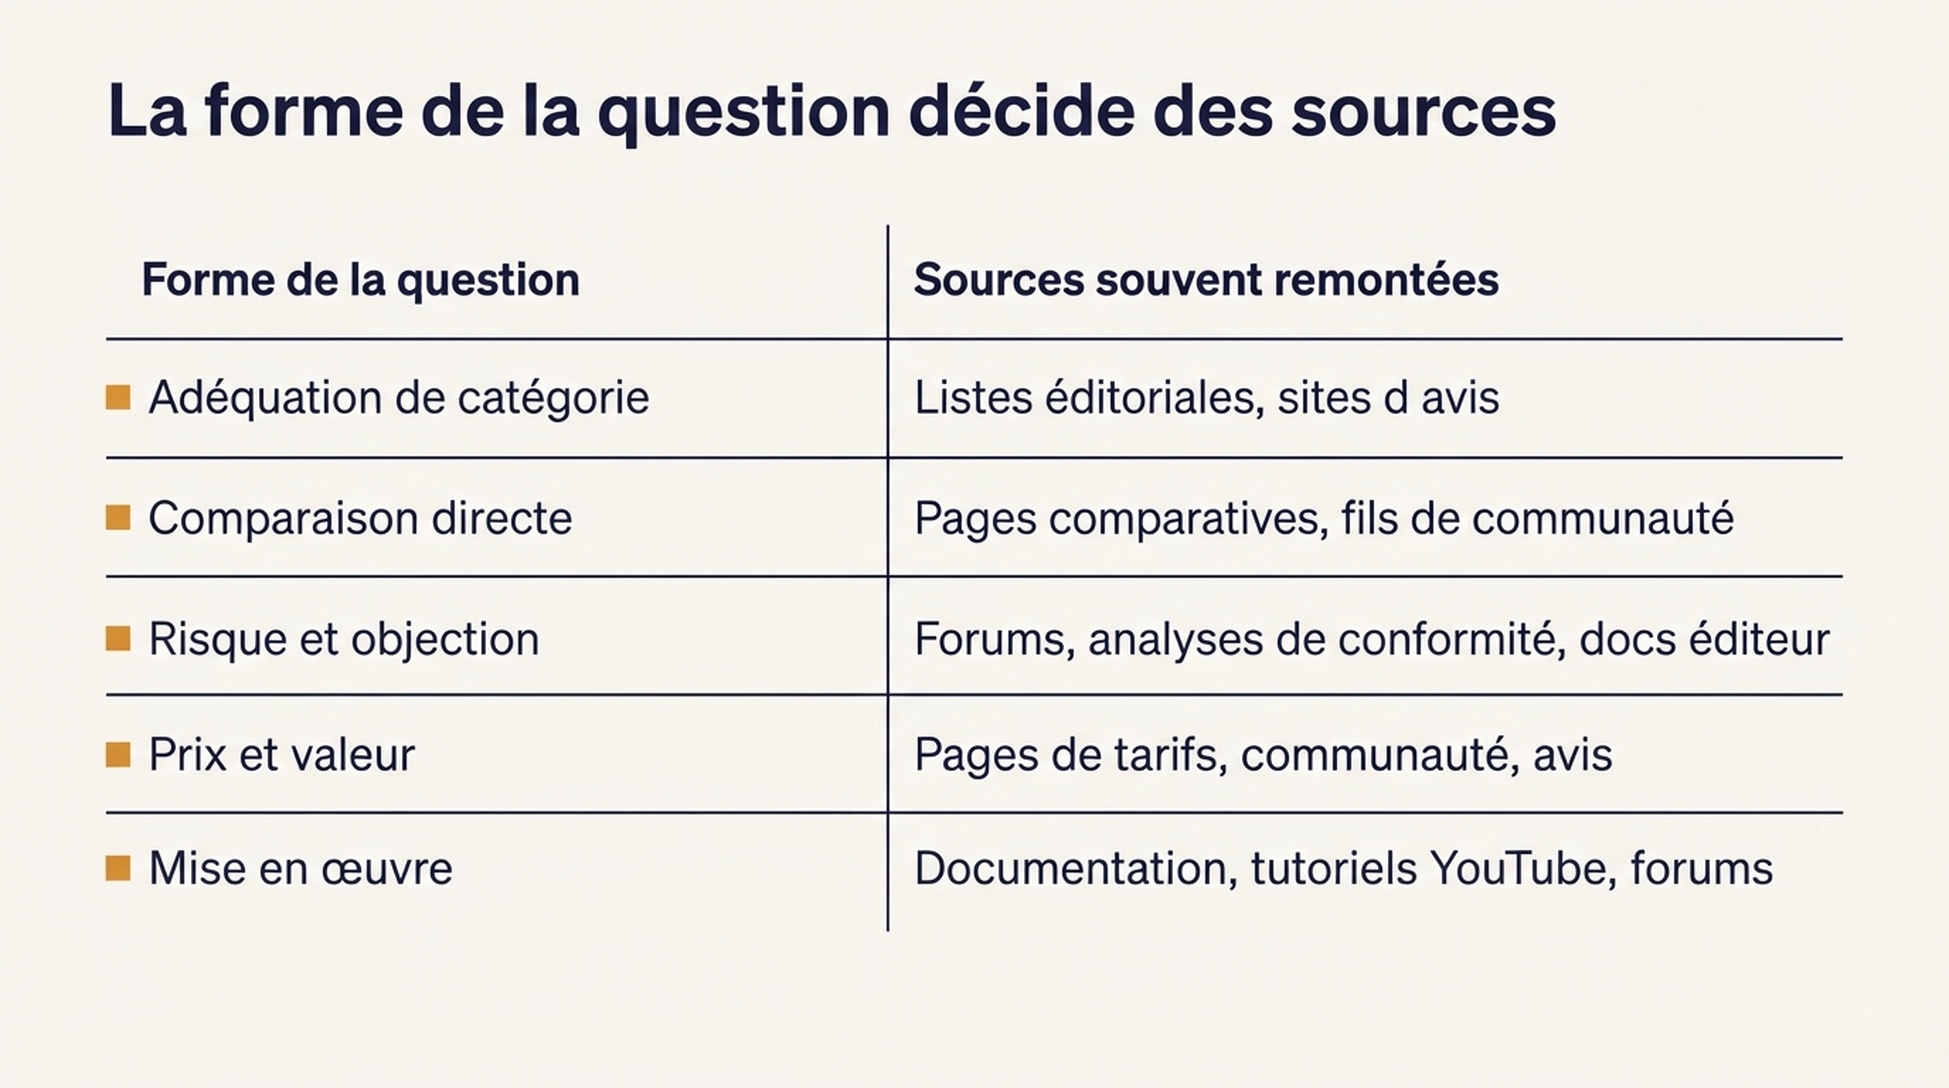
La forme de la question est la variable cachée. Une question de comparaison directe et une question de risque sur le même produit ne renvoient pas les mêmes sources.
Étape 2 : lancer les questions et relever les sources
C'est le cœur mécanique, et c'est là que le travail manuel s'effondre. Faites cinq questions à la main pour comprendre à quoi le résultat doit ressembler. Ensuite, automatisez le reste.
Pour chaque question, dans chaque moteur :
- Ouvrez une nouvelle conversation. Le contexte précédent modifie ce que le moteur va chercher.
- Posez la question exactement comme vous l'avez écrite.
- Ouvrez le panneau de citations ou la liste des sources. Dans la plupart des moteurs, c'est une petite icône près de la réponse, pas une liste visible.
- Relevez chaque URL citée, ainsi que le domaine et le type de source.
- Notez la date, le moteur et si la réponse a cité quoi que ce soit.
Relevez selon cette structure :
Champ | Pourquoi c'est important |
|---|---|
ID de question | Relie chaque observation à la question d'achat |
Moteur | Permet plus tard de séparer les motifs par moteur |
Date et heure | Les réponses dérivent ; une ligne non datée est inutilisable un mois plus tard |
URL citée | La page réelle, pas seulement le domaine |
Domaine | Pour regrouper et compter les fréquences |
Type de source | propre, retail/place de marché, communauté, annuaire d'avis, éditorial |
Concurrent présent | Oui/non, et lequel |
Notre marque présente | Dans la réponse, dans les sources, dans les deux, ou dans aucune |
La dernière ligne mérite qu'on s'y arrête. Une marque peut être nommée dans la réponse sans qu'aucune de ses pages ne soit citée. Elle peut aussi être citée sans être nommée de façon visible. Ce sont deux signaux distincts, et si vous ne suivez que « est-ce qu'on est apparu ? », vous lirez mal les deux. J'ai vu des équipes célébrer une mention provenant d'une page qui argumentait contre elles.
Résultat attendu : un long tableau, une ligne par source citée, par question et par moteur.
Contrôle qualité : sur au moins trois lignes, cliquez et confirmez que la page citée soutient réellement l'affirmation pour laquelle elle a été citée. Les moteurs citent parfois une page qui mentionne le sujet sans répondre à la question. Ces lignes sont du bruit et doivent être signalées.
Voie de secours : si un moteur ne renvoie aucune citation pour une question, c'est une découverte, pas un échec. Notez zéro source et passez à la suite. Les questions auxquelles on répond sans récupération sont des questions que votre propre contenu ne peut pas influencer.
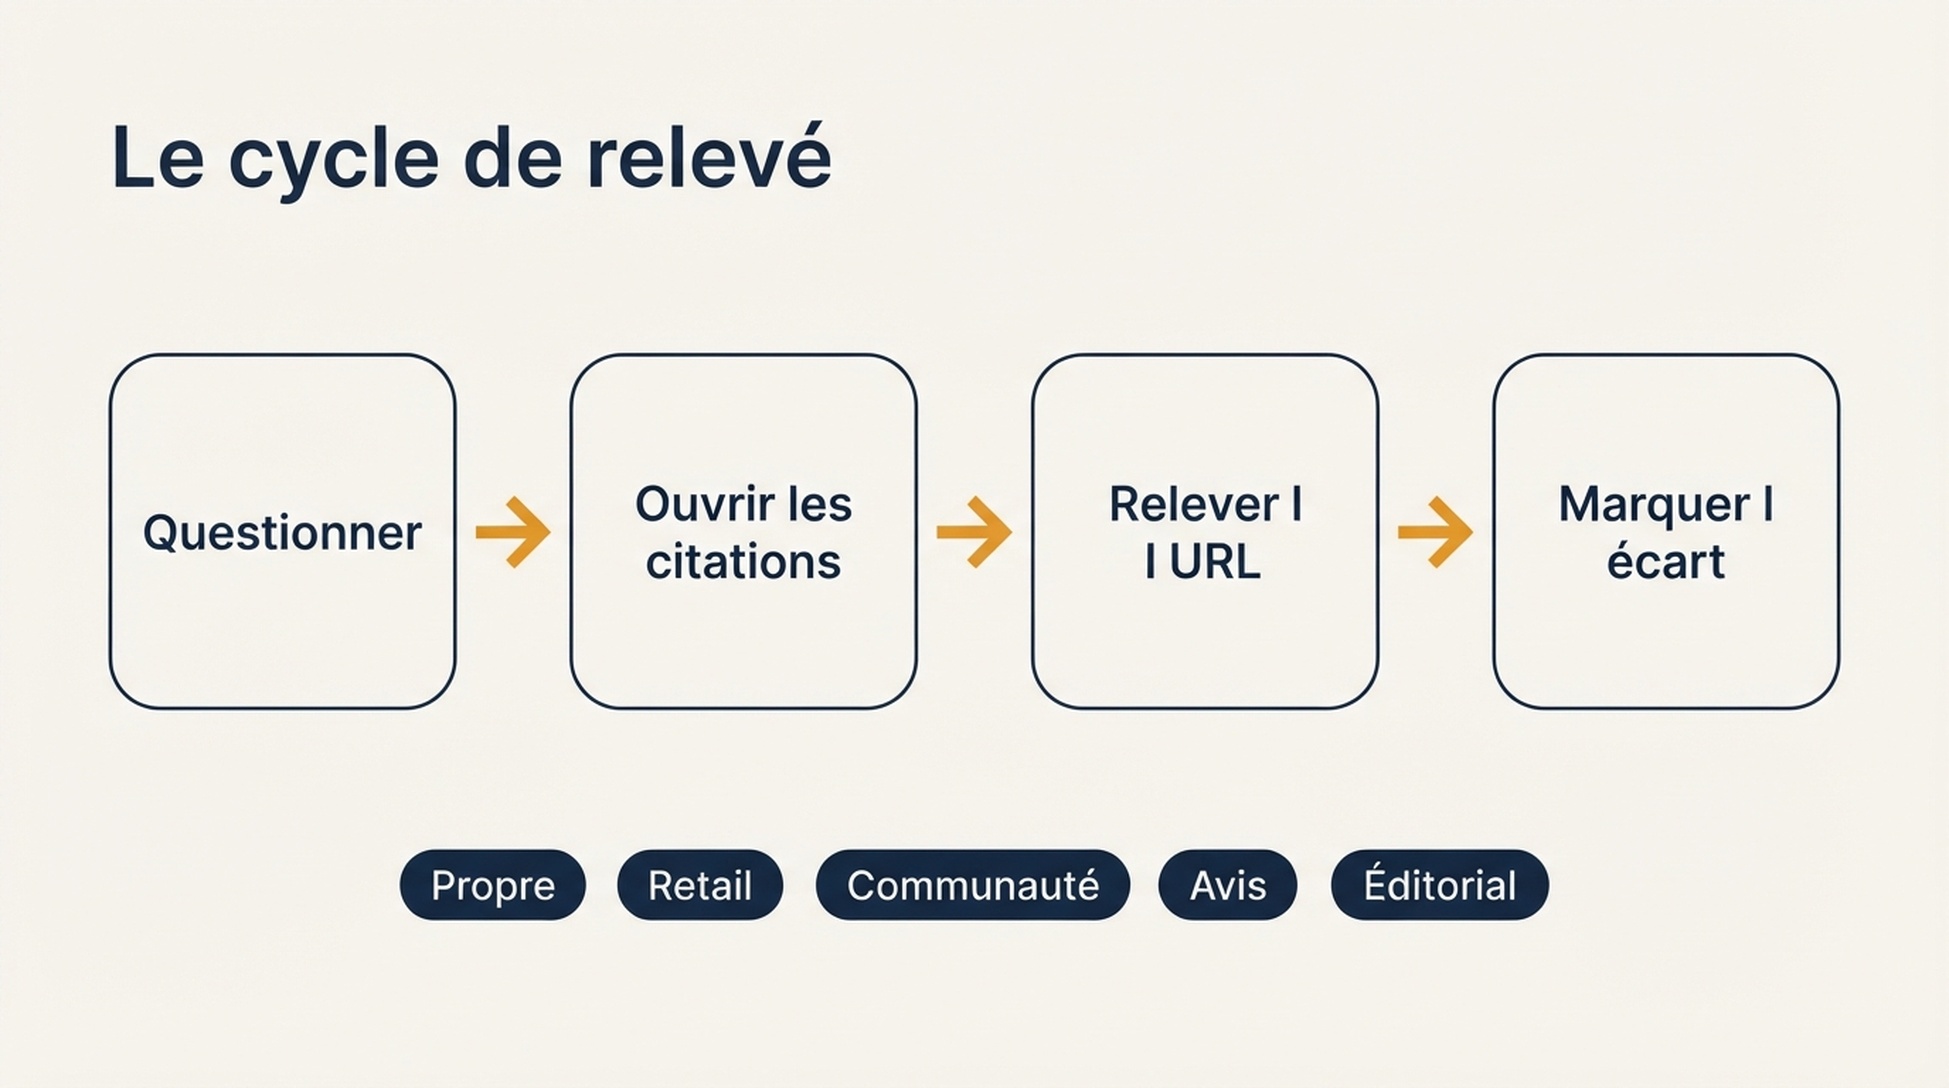
Le cycle est simple et fastidieux. C'est exactement cette combinaison qui en fait un bon candidat pour un agent.
Étape 3 : classer les sources par type
Compressez maintenant le long tableau en une image de votre catégorie. Classez chaque URL citée dans l'un de cinq seaux :
- Propre : votre site, ou celui d'un concurrent
- Retail et place de marché : fiches produit, pages de comparaison de prix, boutiques d'applications
- Communauté et UGC : Reddit, YouTube, Quora, forums, fils Discord indexés
- Annuaires d'avis et plateformes B2B : G2, Capterra, Clutch, Trustpilot, annuaires sectoriels
- Éditorial indépendant et référence : presse spécialisée, actualités, Wikipédia, analyses d'analystes, blogs indépendants
Comptez par seau et par moteur, et vous avez votre carte de citations.
Ce que vous cherchez n'est pas un chiffre unique. C'est la forme. Certaines catégories sont portées presque entièrement par des fils de communauté et la presse spécialisée, et le site propre de la marque ne pèse presque rien. D'autres sont dominées par les fiches produit, parce que la fiche elle-même contient la réponse. Ce mélange dépend de ce que demandent les acheteurs, pas de la qualité du site de quiconque. C'est difficile à accepter quand on a passé deux ans sur son site.
Résultat attendu : un petit tableau, une ligne par type de source, une colonne par moteur, indiquant la part des sources citées.
Contrôle qualité : si un seau concentre plus de 70 % de vos citations, vérifiez cinq URL à l'intérieur pour confirmer qu'elles sont bien de ce type. Un agrégateur à fort trafic peut se faire passer pour une source éditoriale alors qu'il s'agit en réalité d'un annuaire.
Voie de secours : si les comptages semblent aléatoires, vous avez probablement mélangé des formes de questions et masqué le motif. Séparez le tableau par forme de question et regardez à nouveau. Les questions de prix et de risque ont souvent des profils de sources complètement différents.
Étape 4 : trouver les écarts où un concurrent est cité et vous non
Filtrez le long tableau pour ne garder que les lignes où un concurrent apparaît et où votre marque n'apparaît pas. Cette liste filtrée est votre liste de travail. Elle est bien plus utile qu'un mandat général du type « il nous faut plus de mentions », parce que chaque ligne porte déjà une URL et une question client. Confiez-la à quelqu'un le lundi, il peut commencer.
Pour chaque ligne, ouvrez la page citée et répondez à trois questions :
- Notre produit a-t-il réellement sa place sur cette page ?
- Si oui, que manque-t-il : une fiche que nous n'avons jamais revendiquée, une comparaison où nous sommes absents, un fil où personne ne nous a mentionnés, un avis que nous n'avons jamais demandé ?
- Quelle est la plus petite action légitime qui nous y mettrait ?
La troisième question est celle où la discipline compte. L'action varie selon le seau. Se tromper ici, c'est finir avec un SEO qui envoie des cold emails à des journalistes à propos d'un fil Reddit.
Type de source | Action légitime | Ce qu'il ne faut pas faire |
|---|---|---|
Annuaire d'avis | Revendiquer et compléter la fiche, demander des avis aux clients | Acheter des avis ou en semer de faux |
Fil de communauté | Répondre honnêtement en tant qu'employé identifié, en déclarant son rattachement | Faire de l'astroturfing, ou lâcher un lien sans contribution |
Éditorial | Proposer un angle réellement utile que le média n'a pas traité | Envoyer le même communiqué à 200 domaines |
Place de marché ou fiche retail | Corriger les spécifications, les images et la description pour que les faits soient récupérables | Bourrer la fiche de mots-clés |
Page propre | Restructurer pour que le fait précis soit facile à trouver et à citer | Ajouter un bloc FAQ qui ne répond à rien |
Résultat attendu : une liste filtrée et priorisée. Classez par fréquence d'apparition de la source dans votre jeu de questions, pas par le prestige apparent du domaine. Un fil de forum cité dans six de vos vingt questions passe avant une publication spécialisée citée une fois, et il est aussi beaucoup plus facile à traiter.
Contrôle qualité : pour chaque ligne conservée, confirmez que vous pouvez énoncer la question client à laquelle elle correspond. Sinon, supprimez la ligne. Les pages citées pour des questions que personne dans votre pipeline ne pose ne font que distraire.
Voie de secours : si la liste filtrée reste énorme, vous n'avez pas filtré assez fort. Limitez la première passe à dix lignes, classées par fréquence de citation, et traitez-les avant de rouvrir la liste complète.
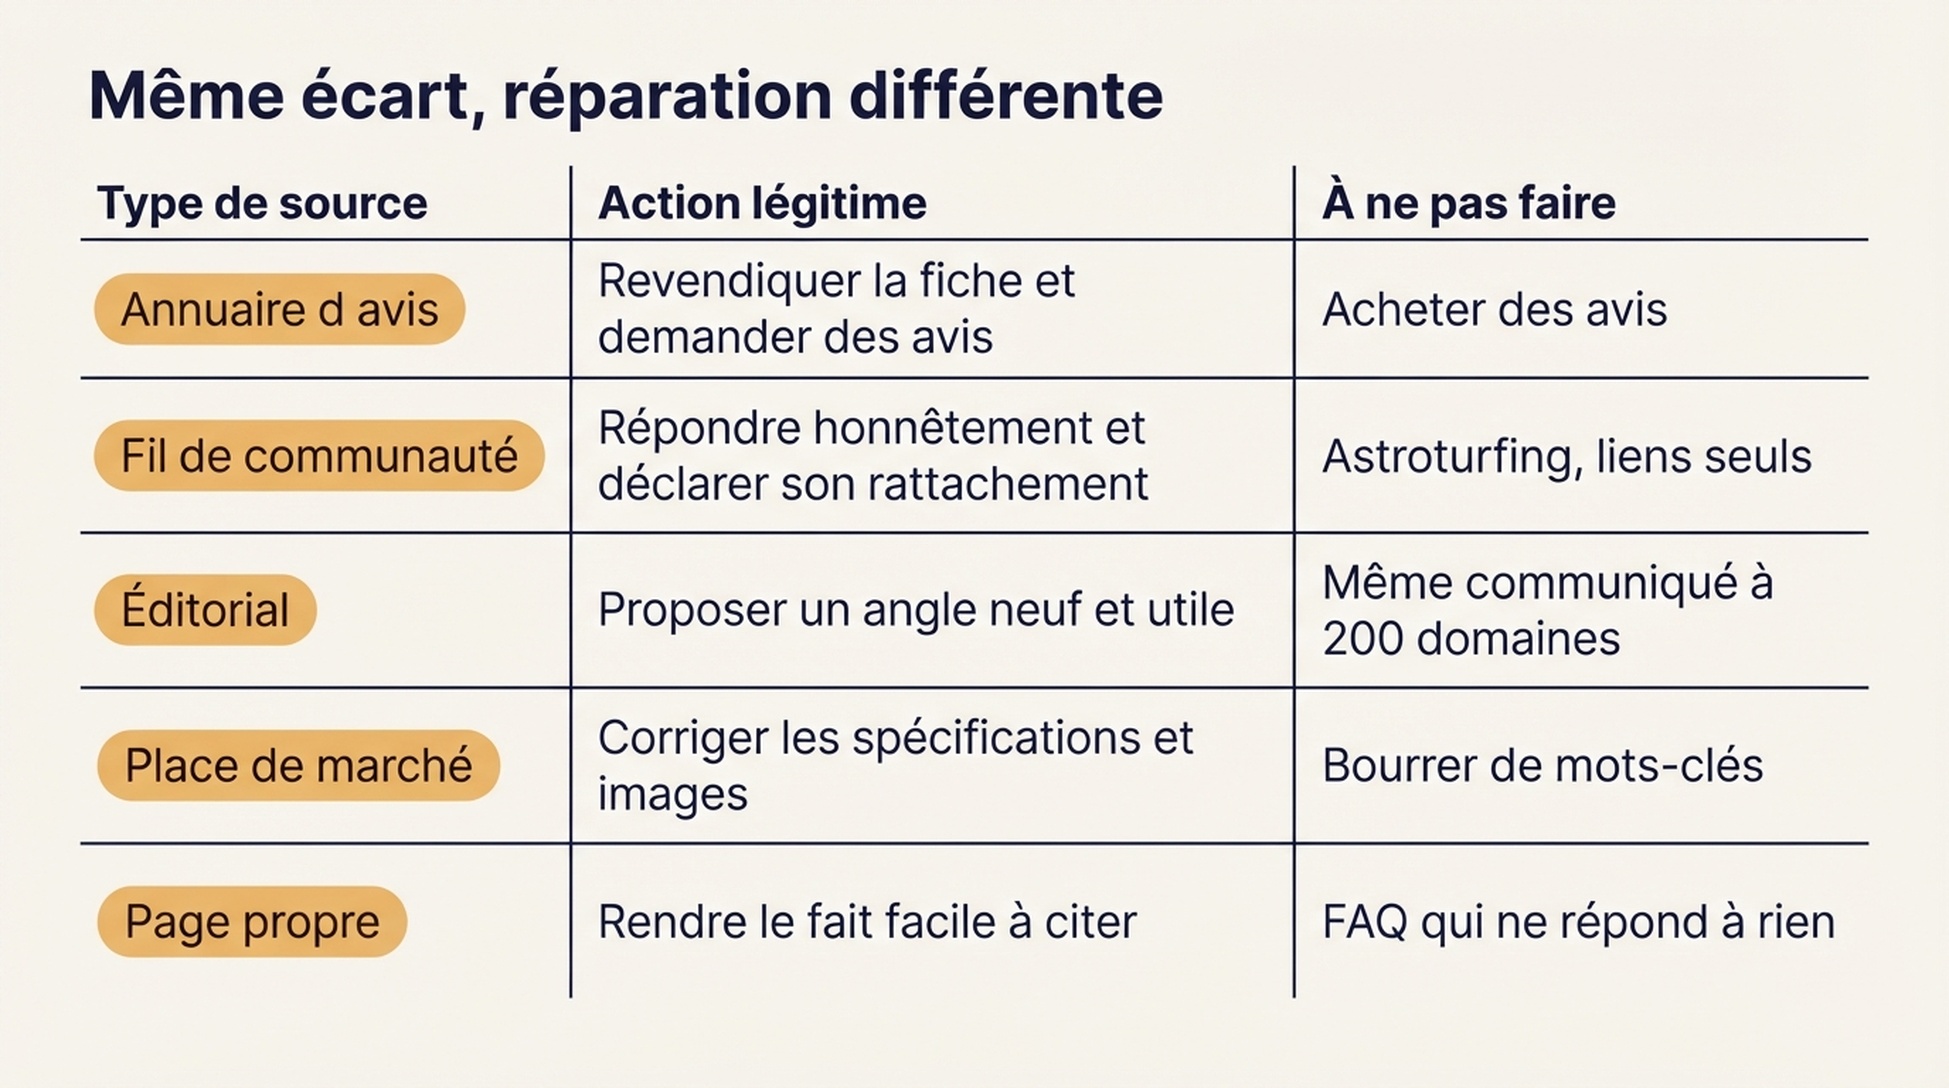
Même écart, réparation différente. Traiter chaque citation manquante comme un problème d'outreach, c'est ainsi que les équipes finissent par vendre un fil Reddit à un rédacteur.
Étape 5 : confier la moitié mécanique à un agent
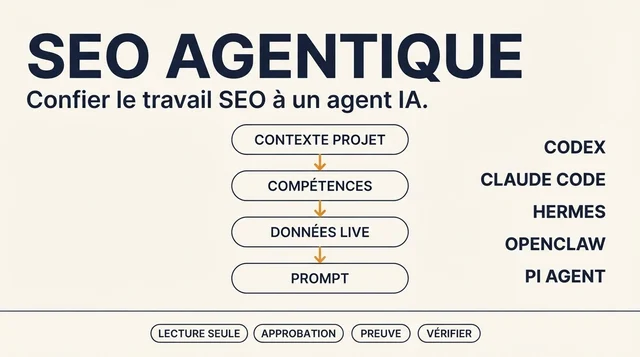
Les étapes 2 et 3 sont celles qui prennent le plus de temps et exigent le moins de jugement. C'est la définition même d'un travail qui vaut la peine d'être délégué. Le jeu de questions et la priorisation restent à une personne, car ce sont les deux endroits où une erreur de jugement fait tomber tout l'exercice.
Les quatre agents ci-dessous peuvent exécuter la même méthode. Ce qui change, c'est où vit la méthode et comment le résultat revient. Choisissez là-dessus, pas sur le modèle qui a gagné un benchmark ce mois-ci.
Codex
Idéal quand vous voulez que la carte vive dans un dépôt et produise un livrable révisé à chaque exécution. Si votre site est déjà dans git, c'est la voie la moins frictionnelle.
Montez un dossier de projet avec un répertoire citation-map/, un questions.csv contenant votre jeu de questions, et un SKILL.md qui énonce la méthode : quels moteurs vérifier, quels champs relever, comment classer une source et à quoi doit ressembler le fichier de sortie. Gardez un fichier par exécution, nommé par date, pour accumuler de l'historique plutôt que d'écraser.
Demandez à Codex d'exécuter les questions, d'ajouter des lignes au fichier de l'exécution en cours et de produire un tableau récapitulatif de la part des sources par moteur. Comme la sortie est un fichier dans un dépôt, vous obtenez un diff que vous pouvez réviser avant que quoi que ce soit ne soit considéré comme définitif. Cette étape de révision est le point clé : vous vérifiez les classements, vous ne refaites pas le relevé.
Une règle doit figurer dans le SKILL.md quoi qu'il arrive : l'agent relève ce qu'il a observé et n'infère pas une citation qu'il n'a pas vue. Inventer des sources est le mode de défaillance le plus dommageable de ce flux. Une règle écrite plus un contrôle par échantillon de trois lignes en arrête la majeure partie, et les trois lignes vérifiées doivent changer à chaque exécution.
Claude Code
Idéal quand la méthode doit être lue au regard d'une politique écrite explicite, et quand vous voulez réviser les pages relevées avec un contexte long.
Placez la méthode dans un CLAUDE.md ou un skill de projet, avec vos définitions de types de sources et le schéma de sortie exact. Pointez Claude Code vers le dossier d'exécution et demandez-lui de classer chaque URL citée, puis de signaler toute ligne où le contenu de la page ne soutient pas réellement la citation.
Le second travail est celui qui vaut la peine d'être payé. Lire 200 pages citées et juger si chacune répond vraiment à la question est pénible pour une personne et raisonnable pour un agent doté d'un standard écrit. Demandez un indicateur de confiance par ligne et ne révisez vous-même que les lignes à faible confiance.
ChatGPT
Idéal quand vous voulez le coût de mise en place le plus bas et que le travail tient en une seule session plutôt qu'en une exécution récurrente.
Collez la méthode comme instruction personnalisée ou comme prompt de projet enregistré, joignez votre liste de questions et traitez par lots de moteurs. Demandez la sortie sous forme de tableau avec exactement les colonnes de l'étape 2, pour qu'elle se colle directement dans votre tableur.
Le piège, c'est que ChatGPT est aussi l'une des surfaces que vous mesurez. Si vous cartographiez les citations de ChatGPT lui-même, faites-le dans une session propre sans votre méthode chargée, sinon vous contaminez l'observation. Utilisez une session pour relever et une autre pour organiser.
Hermes Agent
Idéal quand vous voulez que la méthode persiste comme skill et s'améliore au fil des exécutions sans que vous ayez à la réexpliquer.
Installez la méthode de la carte de citations comme skill Hermes avec le jeu de questions et le schéma de sortie, puis exécutez-la selon une cadence ; le mensuel est généralement le bon rythme. Comme le skill et sa mémoire persistent, les corrections faites le premier mois passent au deuxième. Si l'agent a mal classé un annuaire comme source éditoriale, vous corrigez la règle une fois.
Le prix à payer, c'est que la mémoire persistante demande une révision périodique. Toutes les quelques exécutions, lisez le fichier du skill et vérifiez que les corrections accumulées décrivent encore la méthode que vous voulez, et non un tas d'exceptions ponctuelles que personne ne sait expliquer.
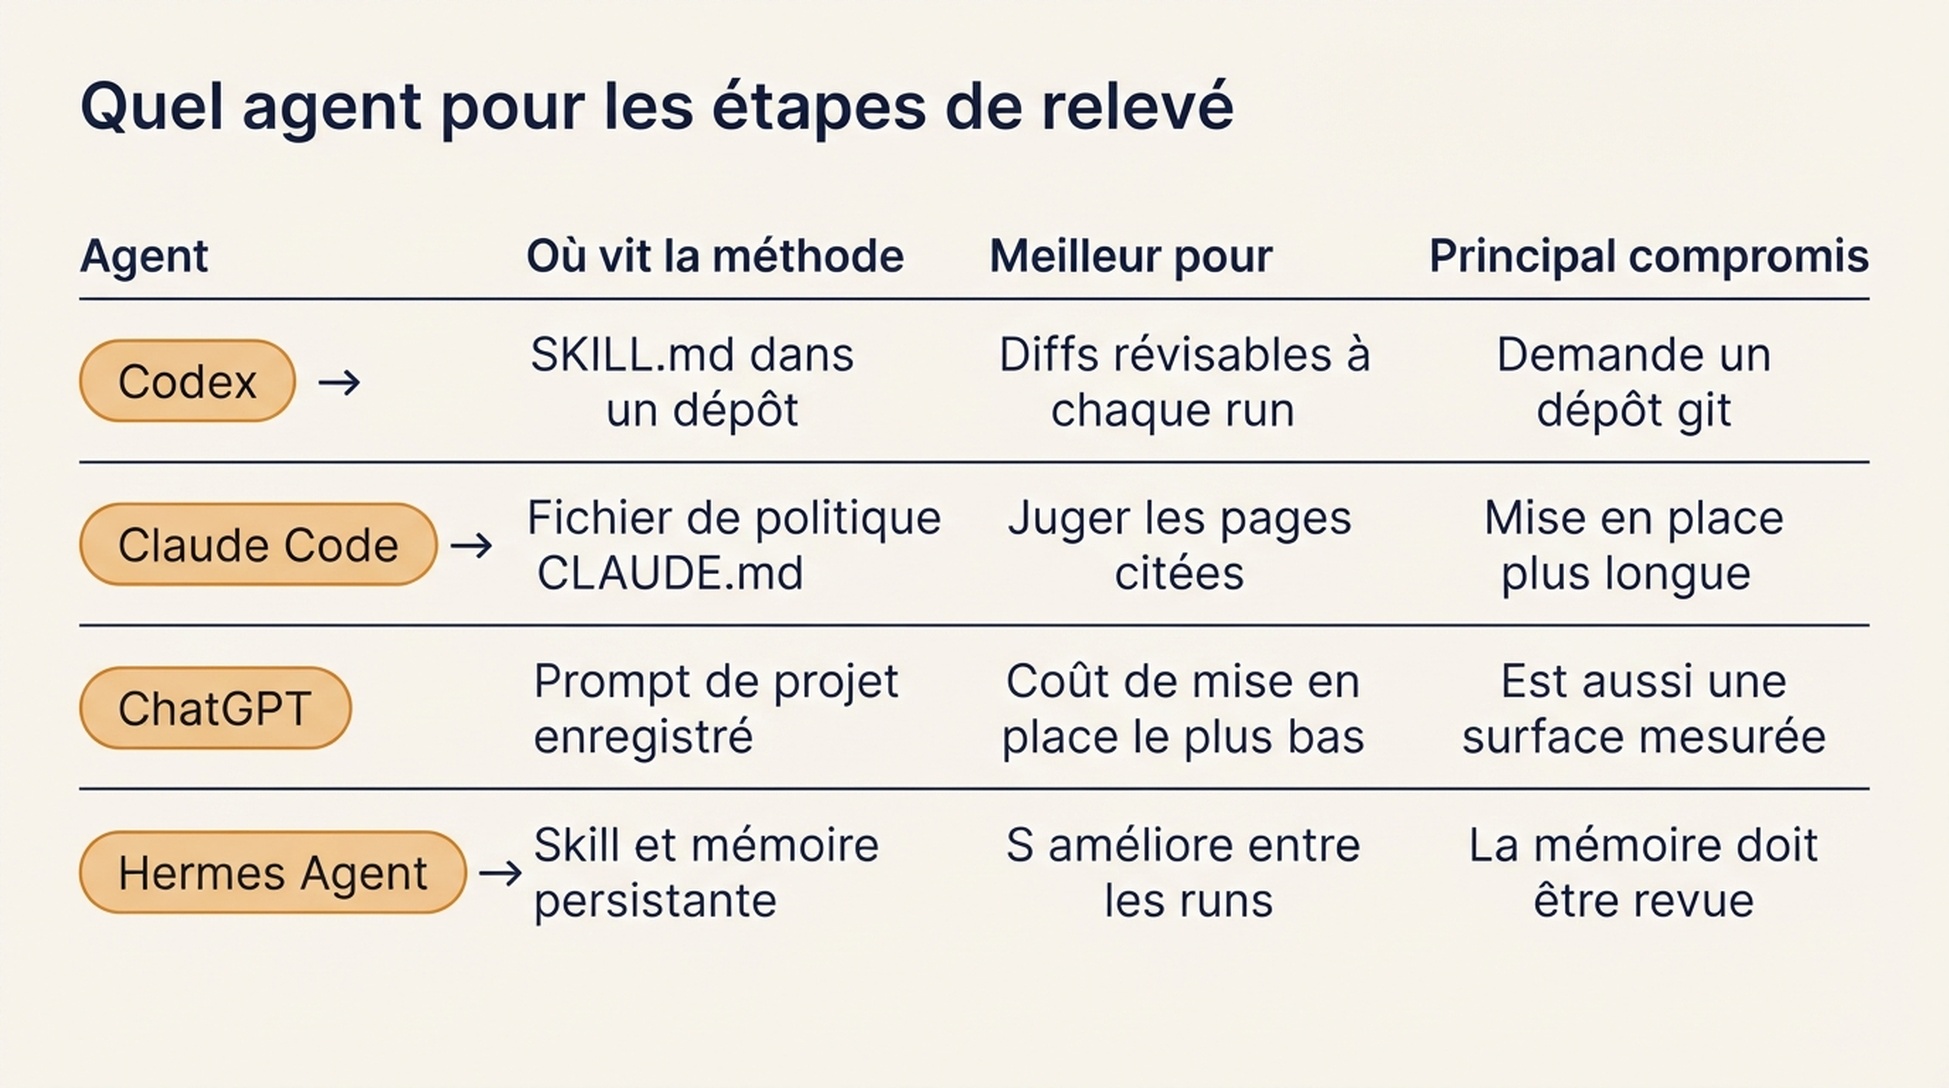
Les quatre exécutent les mêmes cinq étapes. Choisissez selon l'endroit où la méthode doit vivre, pas selon le modèle qui obtient le meilleur score dans un benchmark.
Étape 6 : vérifier la carte avant d'agir dessus
N'attribuez pas de travail à partir d'une carte non vérifiée. Lancez d'abord ce contrôle. Cinq minutes ici économisent un trimestre d'efforts mal orientés.
- Relancez trois questions une semaine plus tard. Si le mélange de sources change complètement, votre jeu de questions est trop volatil ou votre échantillon est trop petit. Notez la variation au lieu de traiter la première passe comme une vérité absolue. Une certaine variation est normale ; un renouvellement total est un avertissement.
- Confirmez le moteur, pas seulement la réponse. Une source qui apparaît dans Perplexity peut être absente de ChatGPT pour la même question. Gardez les colonnes par moteur séparées dans le récapitulatif ; un total agrégé masque exactement le signal dont vous avez besoin.
- Vérifiez aussi vos propres citations. Si votre marque est citée, ouvrez la page. Parfois le moteur cite une page où vous êtes mentionné de façon critique, ou une page que vous ne contrôlez pas. C'est une information utile, pas une victoire.
- Confirmez la date sur chaque ligne. Une carte de citations non datée ne se compare à rien ensuite.
- Vérifiez le nombre de sources. Si une question a renvoyé 40 sources et les autres trois, vérifiez si vous avez relevé un panneau « associés » plutôt que les citations réelles.
Ce que « terminé » signifie : vous pouvez remettre à un collègue le tableau récapitulatif et une liste de travail filtrée, et il peut agir sans vous demander ce que signifie une ligne.
Maintenir la carte
Lancez la passe complète chaque trimestre sur le même jeu de questions, et une passe légère chaque mois sur les cinq questions à la plus forte valeur commerciale. Conservez les anciennes exécutions. Le signal intéressant est rarement l'instantané. C'est la dérive : un type de source qui croît discrètement, ou un concurrent qui commence à apparaître dans un seau où il était absent.
Revoyez le jeu de questions deux fois par an. Les questions d'achat évoluent avec votre produit et votre marché, et un jeu obsolète produit la carte d'une catégorie que vous ne vendez plus.
Une chose à laquelle résister : transformer cela en tableau de bord. Le résultat est une liste de travail avec des responsables et des URL. Si personne n'a de tâche à la fin, la carte n'a pas fait son travail.
FAQ
Faut-il un outil payant de visibilité IA pour faire cela ? Non. La version manuelle fonctionne pour une catégorie et prend une demi-journée. Les outils valent leur coût quand vous suivez de nombreuses catégories ou marchés, ou quand vous voulez des courbes historiques sans tenir le tableur vous-même.
Combien de questions suffisent ? 10 à 20 par catégorie. En dessous de dix, vous ne distinguez pas un motif d'une coïncidence. Au-delà de vingt en première passe, vous ne terminerez pas l'analyse, qui est la partie qui produit la liste de travail.
Faut-il inclure les questions où nous apparaissons déjà ? Oui. Savoir quelles sources vous portent est aussi utile que savoir lesquelles vous manquent, et cela vous dit quoi protéger quand vous modifiez votre contenu.
Et si le moteur donne une réponse différente à chaque fois ? C'est normal et cela vaut la peine d'être noté. Lancez la même question trois fois et notez la variation. Si le jeu de sources est complètement différent à chaque fois, traitez cette question comme peu fiable et donnez-lui moins de poids dans la priorisation.
Puis-je simplement utiliser la liste de sources du moteur sans ouvrir les pages ? Pour le relevé initial, oui. Pour les lignes sur lesquelles vous allez agir, non. Vous devez lire la page pour juger si votre marque y a réellement sa place et ce que serait une contribution utile.
En quoi est-ce différent du suivi de position ? Le suivi de position vous dit où vos pages apparaissent dans une liste de résultats. Une carte de citations vous dit de quelles pages une réponse a été assemblée. Une page peut être première et n'être jamais citée, et une page qui ne se classe nulle part peut être la colonne vertébrale d'une réponse. C'est cet écart qui justifie d'y consacrer une demi-journée.
Auteur : Ethan Marlowe, responsable de la mesure GEO chez Auspia, plus de 500 prompts analysés. Il écrit sur le suivi des prompts, le reporting des citations, les tableaux de bord de visibilité et la manière de distinguer un vrai changement de visibilité IA du bruit entre les exécutions.