La plupart des équipes qui disent « faire du SEO agentique » collent en réalité un long prompt dans une fenêtre de chat. La première fois, ça marche. Le problème arrive à la deuxième : la structure de la sortie change, les données ont une semaine de retard, et personne ne sait dire si les chiffres ont bougé ou si le prompt a dérivé.
La version qui tient se distingue sur un seul point : la méthode vit dans un fichier, pas dans votre message. Vous écrivez la procédure une fois, vous la confiez à un agent, et ensuite les mêmes vérifications s'exécutent à chaque passage, que vous ayez pensé à les demander ou non.
C'est toute l'idée. Ce qui suit explique comment la mettre en place, quel agent convient à quelle tâche, et où ça casse en silence.
Ce que change réellement l'« agentique »
Il y a trois choses que l'on peut automatiser, et ce ne sont pas la même chose.
Automatisation de workflow | SEO assisté par IA | SEO agentique | |
|---|---|---|---|
Qui choisit les étapes | Vous, à l'avance | Vous, à chaque conversation | Vous, une fois, dans une méthode écrite |
D'où viennent les données | Intégrations préconfigurées | Ce que vous collez | L'agent les récupère |
Face à une entrée imprévue | Ça casse | Cela dépend de votre formulation | Suit une règle ou escalade |
Cohérence d'un passage à l'autre | Parfaite et rigide | Faible | Élevée, et pourtant adaptable |
Idéal pour | Les tâches massives et invariables | L'exploration et les questions ponctuelles | L'analyse récurrente qui demande du jugement |
La différence pratique se voit dans ce que vous cessez de faire. Dans un workflow de chat, vous réexpliquez le site, l'audience, les règles de priorité et le format de sortie à chaque fois. Chaque réexplication est une occasion d'en oublier une. Dans un workflow agentique, tout cela vit dans des fichiers que l'agent lit à chaque exécution, et votre prompt se réduit à une ligne : lance le contrôle de dégradation de contenu de septembre.
Cela a aussi un coût. Si la tâche est vraiment différente à chaque fois, il n'y a pas de méthode à écrire, et la mettre en place est une charge sans retour. Vérifier le code de statut de 50 000 URL est un travail de script, pas d'agent. La ligne de partage tient à deux questions : la tâche se répète-t-elle, et demande-t-elle du jugement ? Si oui aux deux, l<|placeholdermmspan0442|> agentique gagne. Si l'une des deux manque, laissez tomber.
Les quatre couches et leur rôle
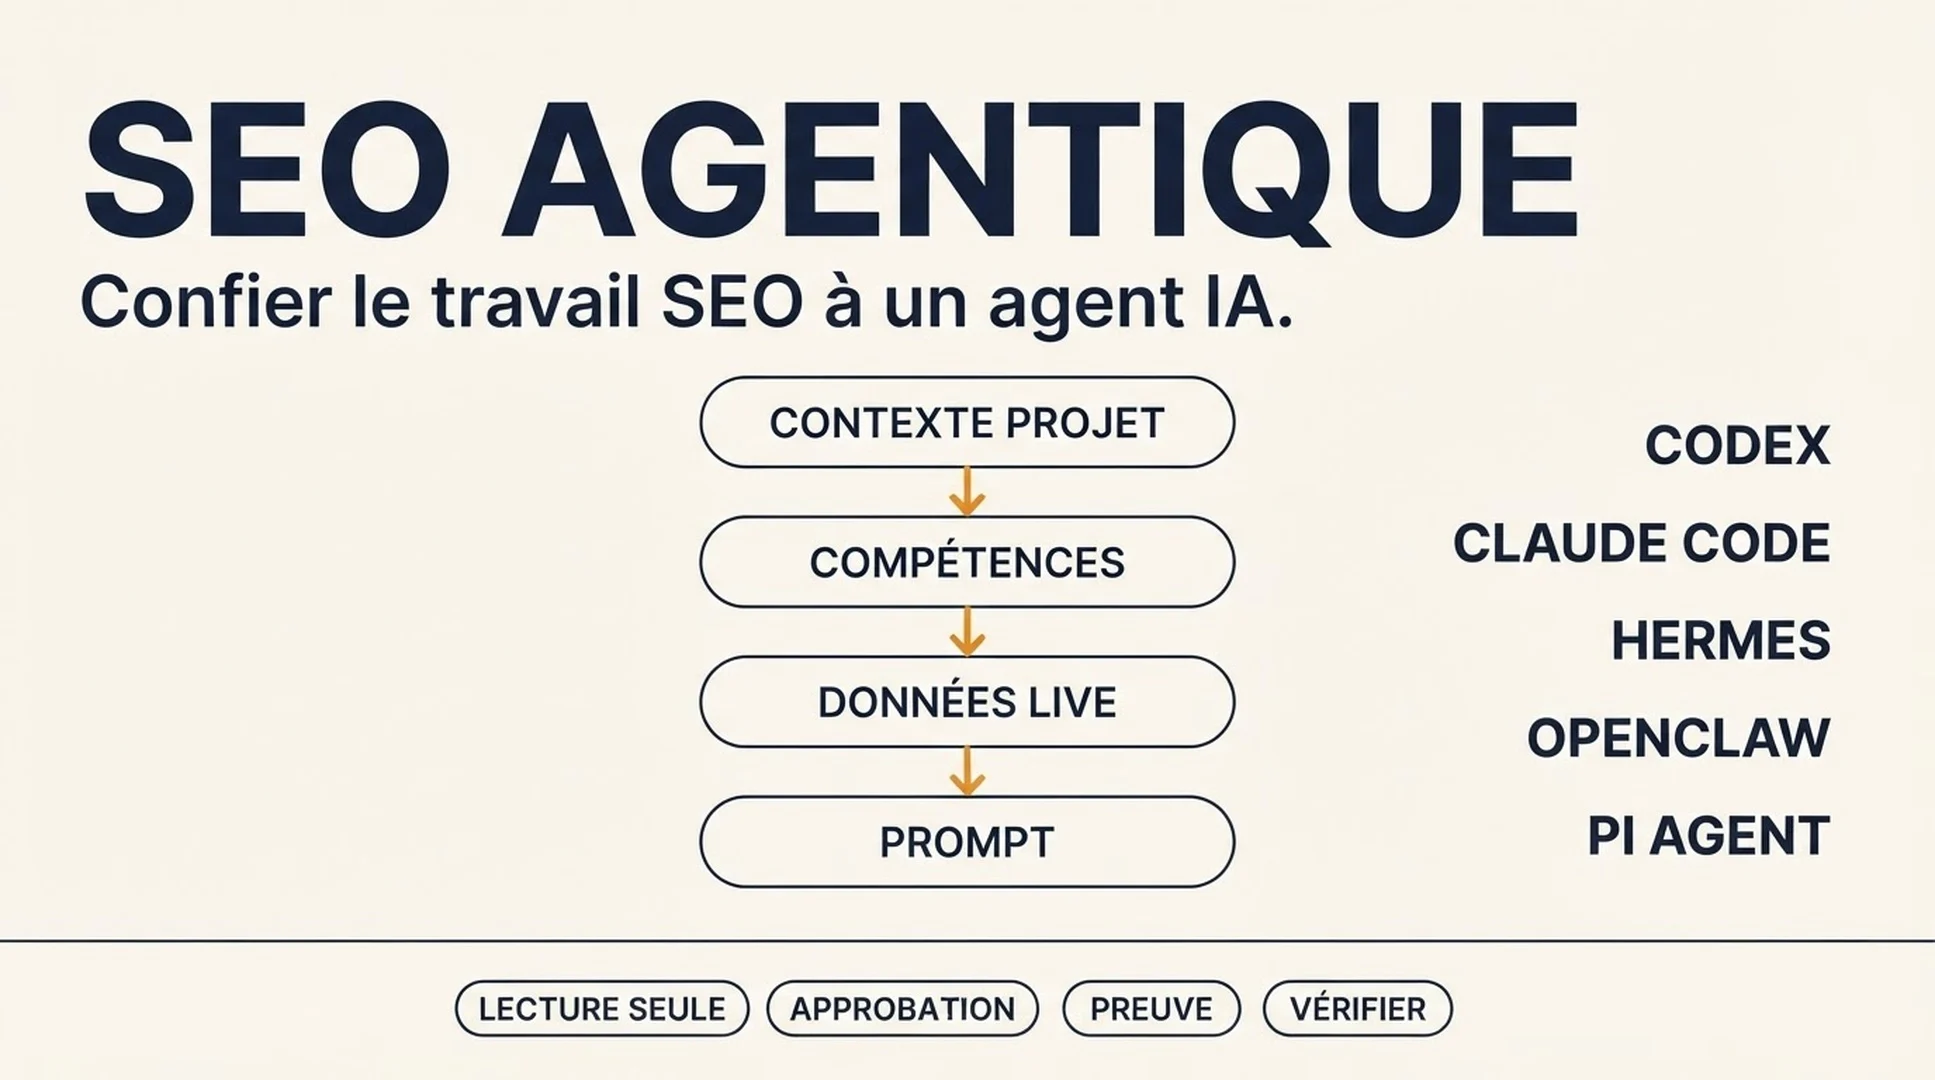
Toute configuration de SEO agentique qui survit comporte les mêmes quatre pièces. Enlevez-en une et vous obtenez un type d'échec prévisible.
Le contexte projet. Un dossier qui contient ce qui ne change pas : le site, les marchés servis, qui achète et pourquoi, ce qui compte comme conversion, qui sont les vrais concurrents, les règles éditoriales. C'est ce qui empêche l'agent d'écrire des conseils génériques pour une activité qu'il ne comprend pas. Sautez cette couche et vous obtenez une sortie assurée, plausible et inutile.
Les compétences. Des procédures écrites. Chacune indique quand l'utiliser, de quelles données elle a besoin, l'ordre des étapes, les règles de notation, le format de sortie, et quelles actions exigent votre approbation. C'est cette couche qui rend le workflow reproductible, et c'est celle que la plupart des équipes sautent.
L'accès aux données en direct. Des connexions qui permettent à l'agent de récupérer lui-même les chiffres actuels au lieu d'attendre que vous exportiez et colliez. Search Console pour votre propre performance. Un outil d'analytics pour le comportement. Une source de positions ou de SERP pour ce que vous ne voyez pas sur votre propre domaine. Un crawler ou une connexion au CMS pour les faits au niveau de la page. Sans cette couche, vous avez un excellent analyste qui travaille sur le tableau du mois dernier.
Le prompt. La tâche en cours, rien de plus. Si votre prompt transporte du contexte ou de la méthode, ils appartiennent aux première et deuxième couches.
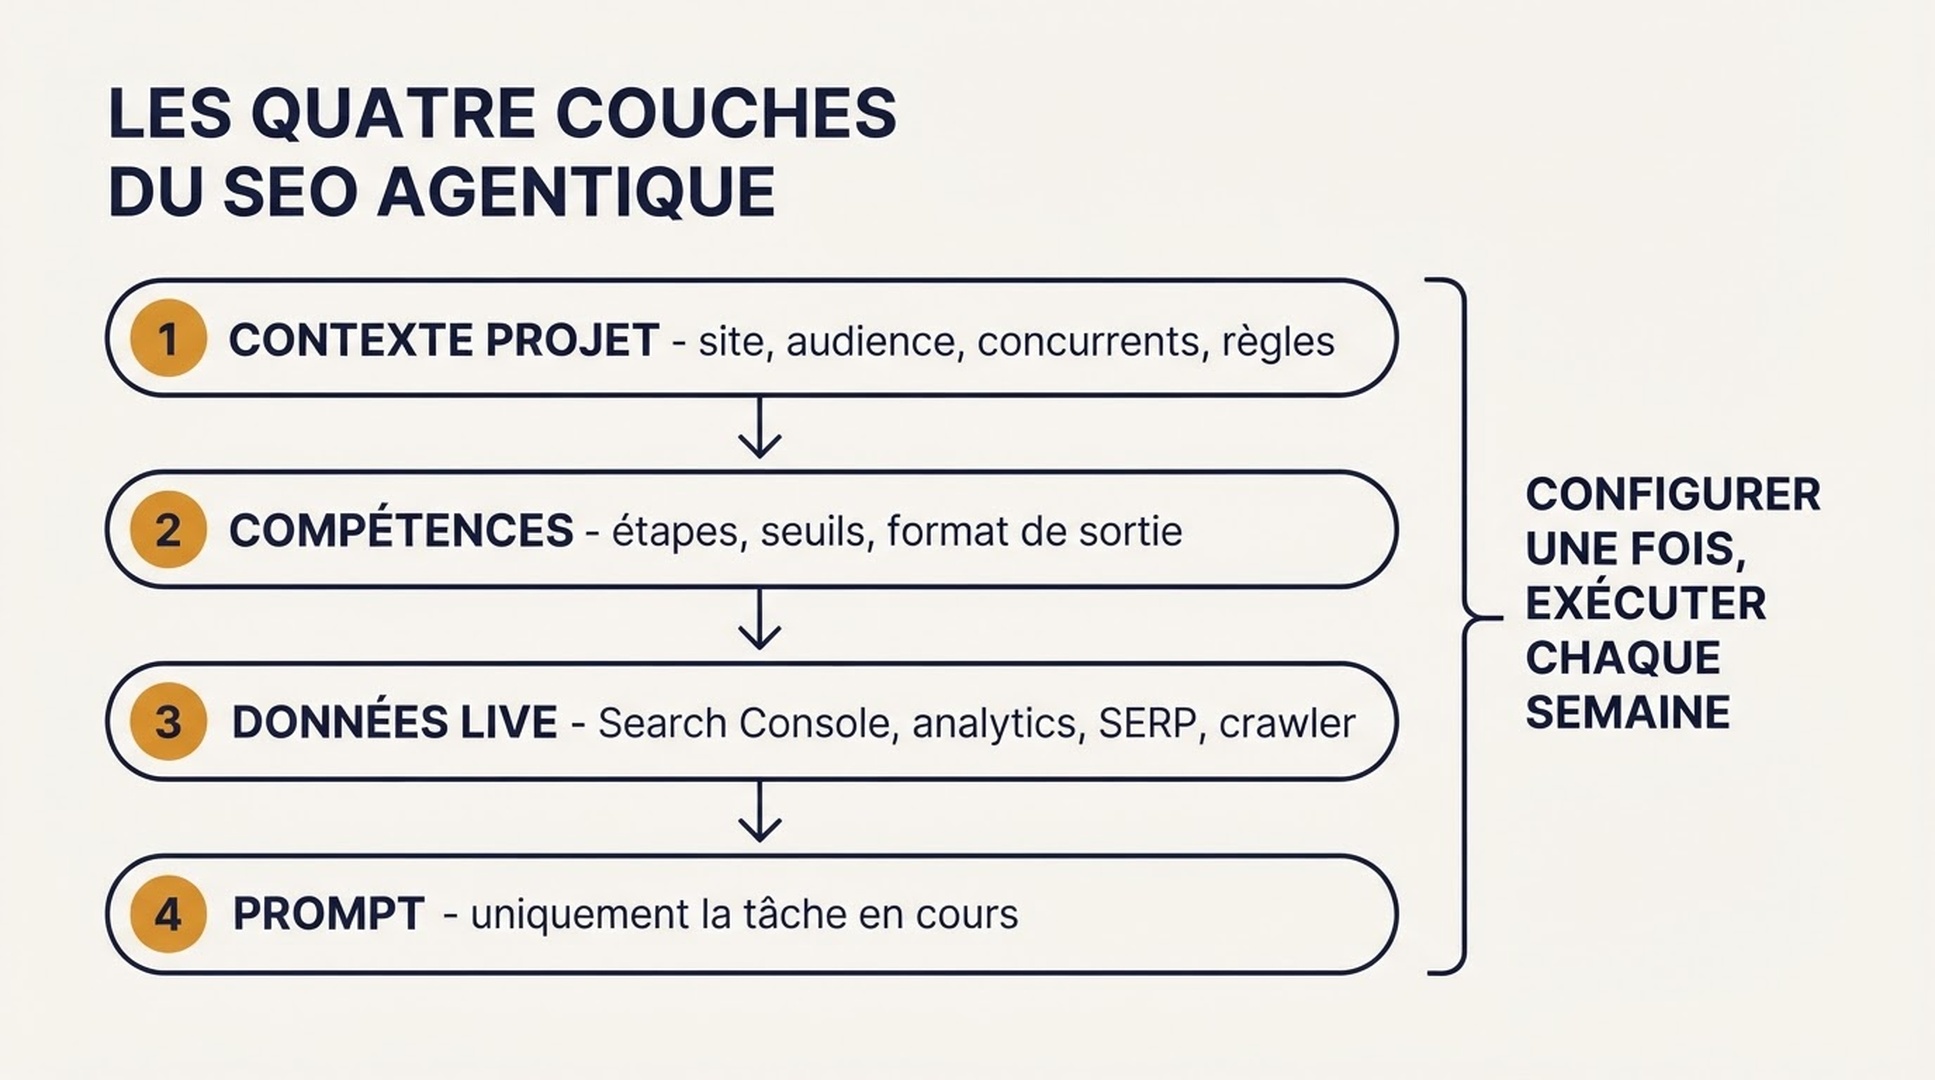
Configurez les quatre couches une fois, et l'exécution hebdomadaire tient en une ligne. Quand le résultat est mauvais, vérifiez quelle couche a échoué avant de réécrire le prompt.
Le point de vue d'Auspia : le modèle en quatre couches est l'idée la plus utile de cette catégorie, et c'est aussi l'endroit où la plupart des équipes s'arrêtent trop tôt. Elles créent le dossier de contexte, sautent les compétences, et finissent avec un chatbot bien informé. Le produit, c'est la compétence. Tout le reste est de la plomberie.
Quel agent pour quelle tâche
C'est la question qu'on nous pose le plus, et la réponse honnête est que les différences comptent moins que la configuration. Tout ce qui figure ici vient à bout de la plupart des tâches SEO si l'on insiste assez. Ce qui les sépare, c'est l'endroit où chacun est le moins maladroit, et cela décide si vous l'utilisez encore en semaine trois.
Agent | Le plus fort pour | Modèle d'accès | Première tâche SEO pertinente |
|---|---|---|---|
Codex | Le travail sur dépôt, les exécutions planifiées, les modifications relues | Fichiers locaux, terminal, git, automatisation | Stocker les instantanés hebdomadaires dans un dépôt et ouvrir une pull request avec le rapport |
Claude Code | La revue de contexte long face à une politique écrite explicite | Terminal, fichier de mémoire du projet, connecteurs MCP | Lire les exports Search Console et le code de la page, puis rendre un verdict documenté |
Hermes Agent | Les compétences répétables avec mémoire entre les sessions | Agent open source avec système de compétences et mémoire persistante | Installer une compétence et exécuter le même workflow à la même cadence |
OpenClaw | La collecte de preuves navigateur sous permissions strictes | Le navigateur d'abord, les fichiers locaux ensuite | Capturer ce que la recherche renvoie réellement sur mobile, puis s'arrêter |
Pi Agent | Rester petit et prévisible pendant des mois | Cœur minimal, compétences Markdown comme point d'extension | Exécuter une procédure étroite et lisible là où vous voulez auditer tout ce qu'il peut faire |
Deux réserves. Cette catégorie change chaque mois, alors vérifiez les limites et les tarifs actuels dans la documentation officielle de chaque éditeur avant d'y engager une équipe. Et ce tableau est un point de départ, pas un plafond.
Pour chacun, nous avons un guide d'initiation sûr : Codex, Claude Code, Hermes Agent et OpenClaw. Les quatre suivent la même forme : d'abord la lecture seule, une modification approuvée à la fois, vérifier avant de livrer.
La règle de choix pratique dépend de l'endroit où vit déjà votre travail. Si le site est dans un dépôt git et que les modifications de page sont des modifications de code, commencez par Codex ou Claude Code. Si le travail consiste surtout en exports, conversations et jugement, commencez par un agent à base de compétences. Si vous devez voir ce que renvoie un vrai navigateur, il vous faut un accès navigateur et une limite de permissions stricte. Si vous voulez la plus petite surface possible, lisible d'un bout à l'autre en une seule fois, le cœur minimal de Pi Agent est conçu exactement pour cela, et le prix à payer est que tout ce dont vous avez besoin vit dans une compétence que vous ajoutez vous-même.
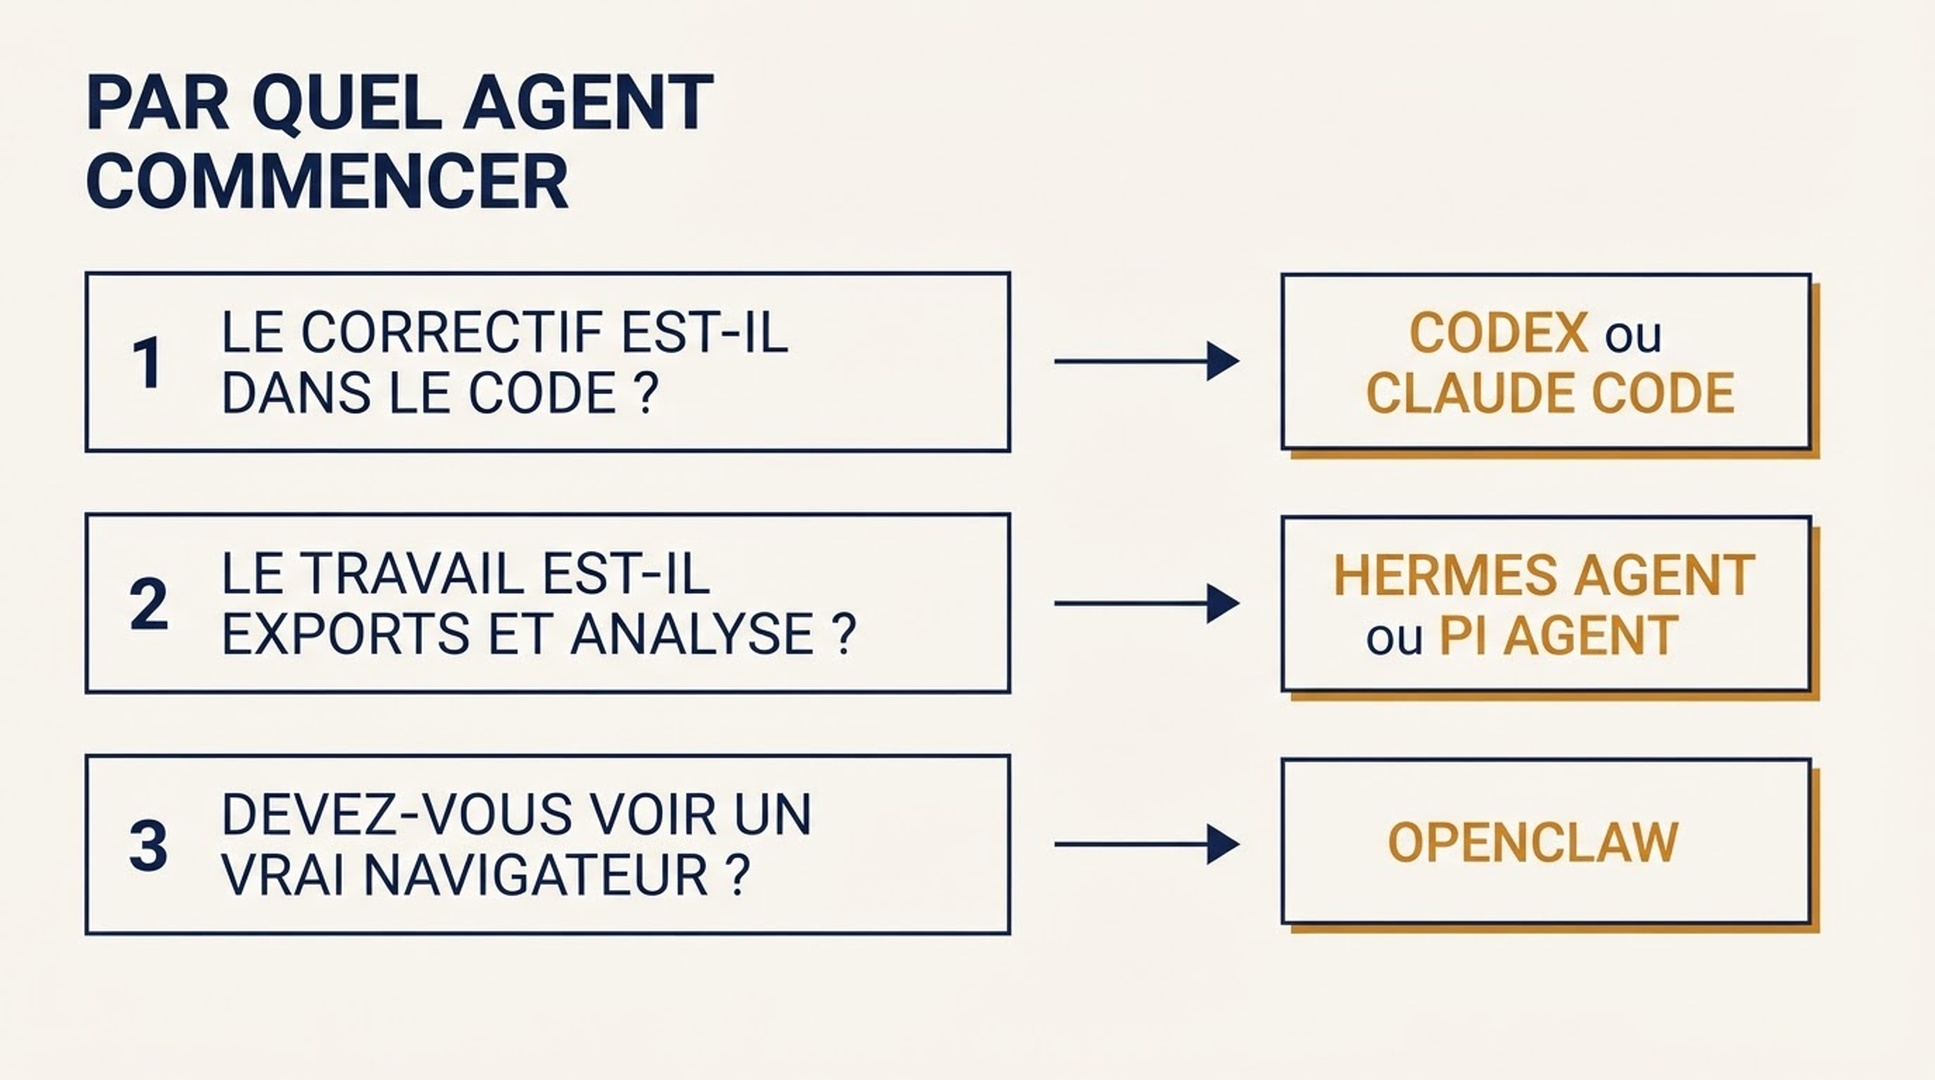
Trois questions réduisent cinq agents à un seul. Répondez-y avant de comparer les listes de fonctionnalités.
Les tâches à déléguer en premier
Ne commencez pas par la plus intéressante. Commencez par l'ennuyeuse, qui se répète selon un calendrier et produit quelque chose que quelqu'un lit. Ce sont celles qui s'amortissent le plus vite.
Le tri de la dégradation de contenu. Prenez la performance d'une période sur l'autre, écartez tout ce qui passe sous le seuil de matérialité, vérifiez l'indexation avant toute autre chose, puis regardez les positions, la demande, les liens et la cannibalisation. Vous obtenez un tableau d'URL avec les clics perdus, la cause probable, la preuve, et une action principale et une de repli. Une page qui a perdu des positions a besoin d'être réécrite. Une page qui a perdu de la demande n'a besoin de rien. Une page qui a perdu son canonical se répare en cinq minutes. Les équipes confondent ces trois cas en permanence, et la confusion coûte cher.
Le tri des problèmes techniques. Regroupez les problèmes par cause racine plutôt que par type, reliez les URL concernées au trafic et aux positions, notez l'impact face à l'effort, et vérifiez les premiers points sur des pages réelles avant d'écrire la liste des correctifs. La valeur tient à ce regroupement. Dix lignes de « redirection temporaire » ont généralement une seule cause racine, et réparer un gabarit vaut mieux que réparer dix URL.
Les mouvements concurrentiels. Isolez les pages et les mots-clés derrière une variation de trafic, séparez le marque et le non-marque, et confrontez chaque changement à un facteur nommé : contenu nouveau, positions améliorées, saisonnalité, migration ou artefact de données. La réponse, ce sont le facteur et le niveau de confiance. Un grand nombre à faible confiance est une raison de regarder de plus près, pas de réagir.
Le maillage interne et les pages orphelines. Construisez un vivier de candidates à partir des pages qui se positionnent déjà ou gagnent des liens, trouvez les passages directement liés à chaque destination, et appliquez un test de valeur pour le lecteur : quelqu'un au milieu de cette phrase aurait-il vraiment envie d'y aller ? La moitié structurelle du résultat vaut souvent plus que les liens eux-mêmes. Découvrir que la deuxième plus grande page n'a aucun lien interne pointant vers elle est un correctif de cinq minutes à l'effet disproportionné.
La cartographie des écarts de citation. Regroupez les prompts par thème et par étape d'achat, trouvez les domaines et les pages les plus cités, séparez les types de sources, et lisez les pages citées pour déduire ce qui obtiendrait réellement une mention. Attendez-vous à ce qu'une bonne partie du résultat soit des sources où la bonne réponse est de ne contacter personne. Les forums et les propriétés détenues par des concurrents ne sont pas des cibles d'outreach.
Le contrôle de régression après mise en production. Comparez un crawl d'avant et un crawl d'après avec des réglages identiques, confirmez qu'ils sont comparables avant de différencier quoi que ce soit, puis classez chaque écart comme attendu, attendu mais mal implémenté, ou non planifié. C'est cette classification qui rend le rapport utilisable. Sans elle, il ne reste qu'un mur d'écarts et aucune décision.
Pour les plus fréquentes, nous avons des guides plus détaillés : rapports de positions hebdomadaires, surveillance quotidienne, travail sur le profil de liens, et conception d'alertes qui ne vous noient pas.
Commencez par une compétence, pas par un département
L'échec le plus courant consiste à monter huit compétences, sept connexions et un planificateur avant d'avoir exécuté quoi que ce soit une seule fois. Ensuite rien ne fonctionne, et on ne sait pas laquelle des seize pièces est en cause.
Faites plutôt dans cet ordre.
Choisissez une tâche au résultat visible. La plus rapide à valider est le tri des problèmes techniques, parce que vous pouvez le pointer sur un crawl que vous avez déjà et juger le résultat en quelques minutes. La dégradation de contenu est la deuxième plus simple si vous avez de l'historique dans Search Console.
Écrivez la compétence avant de connecter quoi que ce soit. Le fichier de compétence doit tenir sur une page et répondre à six questions : quand l'utiliser, de quelles données elle a besoin, l'ordre des étapes, les règles de notation ou de seuil, le format de sortie, et quelles actions demandent une approbation. Si ça ne tient pas sur une page, la tâche n'est pas encore définie assez clairement pour être automatisée.
Connectez une seule source de données. Celle dont la compétence a réellement besoin. Les connecteurs que vous n'utilisez pas ne font qu'élargir la surface sans apporter de valeur.
Exécutez-la en lecture seule et vérifiez la sortie à la main. Prenez deux constats et vérifiez-les vous-même contre les données sources. Si l'explication de l'agent ne correspond pas à ce que vous voyez, le problème est dans la compétence, pas dans le modèle.
Ajoutez la porte d'approbation avant d'ajouter la deuxième compétence. Toute action d'écriture (publier, rediriger, supprimer, modifier du code, fusionner, envoyer à l'extérieur) doit s'arrêter et attendre. Installez cette habitude pendant que l'enjeu n'est qu'une seule compétence.
Les garde-fous qui évitent la casse
Voici les règles que nous mettrions dans les instructions du projet dès le premier jour. Elles sont ennuyeuses à dessein, et c'est tout l'intérêt.
- Gardez les outils de production en lecture seule jusqu'à ce que vous approuviez une action d'écriture.
- Exigez un plan avant le début de tout workflow en plusieurs étapes.
- Obtenez les preuves via les outils connectés plutôt que de vous fier à des suppositions.
- Suivez la compétence concernée quand elle existe, au lieu d'improviser.
- En cas d'échec d'un appel d'outil, réessayez une fois, puis remontez l'erreur au lieu de la contourner.
- Exigez que chaque constat justifie sa preuve en une phrase.
- Séparez les constats confirmés des hypothèses, directement dans la sortie.
- Signalez les données manquantes et les conclusions à faible confiance au lieu de combler le vide.
- Arrêtez-vous quand le workflow dépasse une limite convenue d'URL, de lignes ou d'unités d'API.
- Demandez une approbation avant de publier, rediriger, supprimer, modifier du code, fusionner ou envoyer quoi que ce soit à l'extérieur.
Deux d'entre elles font plus de travail que le reste. Séparer les constats confirmés des hypothèses rend la sortie assez fiable pour agir dessus. La limite de dépense empêche une boucle mal configurée de brûler le budget d'API en une nuit.
Où ça casse
Des données de conversion trop minces. Un moteur de décision de portefeuille de contenu qui classe chaque URL en conserver, mettre à jour, consolider, rediriger, supprimer ou examiner a besoin de données de conversion pour trancher. Si le suivi n'est pas correctement configuré, il renverra beaucoup de zéros, et le rapport est inutilisable tant que ce n'est pas corrigé. L'agent a fait son travail. L'entrée était mauvaise.
Le jugement structurel. Un agent peut trouver quatre choses qu'un brief humain a manquées, dont un mot-clé qui déclenche un type de résultat complètement différent et n'a donc rien à faire sur cette page. Mais il ne peut pas décider comment structurer l'article. Cette décision reste à une personne, et prétendre le contraire produit un contenu qui se lit comme s'il avait été assemblé à partir de pièces.
Les erreurs d'explication silencieuses. Les agents échouent bruyamment à l'étape des données et silencieusement à celle de l'explication. Un export manquant lève une erreur. Une cause erronée affirmée avec assurance, non. C'est pourquoi la règle de la preuve par constat compte plus qu'il n'y paraît.
Les lacunes d'outillage que vous n'avez pas prévues. Certaines données ne sont tout simplement pas accessibles via un connecteur. Un connecteur de données de positions peut être incapable de créer un projet de crawl, de lancer un crawl ou d'exporter l'ensemble complet des URL explorées. Concevez le workflow autour de ce que la connexion peut réellement renvoyer, sinon la compétence se bloque à mi-chemin.
Vérifiez le résultat avant de faire confiance à la boucle
Lancez ce contrôle les trois premières fois, puis une fois par mois.
- Choisissez deux constats au hasard et vérifiez-les à la main contre les données sources.
- Confirmez que l'agent a cité une source et une date pour chaque affirmation qui dépend de données.
- Vérifiez qu'au moins un constat est étiqueté comme peu fiable. Un agent sûr de tout ne discrimine pas.
- Confirmez que la forme de la sortie correspond au passage précédent. Si elle a dérivé, le fichier de<|placeholdermmspan0442|> compétence a changé ou l'agent a cessé de le suivre.
- Confirmez que rien n'a été écrit, publié ou envoyé sans qu'une porte d'approbation se déclenche.
Si les cinq passent trois fois de suite, vous avez un workflow. Si l'un échoue, réparez la couche qui l'a causé plutôt que de réécrire le prompt.
Questions fréquentes
Qu'est-ce que le SEO agentique ? Le SEO agentique consiste à confier un workflow SEO défini à un agent d'IA qui récupère lui-même ses données, suit une méthode écrite et renvoie une analyse de forme identique à chaque exécution. Le trait décisif n'est pas l'autonomie, c'est la reproductibilité : la méthode vit hors de la conversation, donc les mêmes vérifications s'appliquent que vous ayez pensé à les demander ou non.
En quoi diffère-t-il du SEO assisté par IA ? La différence tient à qui décide de la suite. Dans le SEO assisté par IA, vous choisissez les étapes à chaque conversation et collez les données. Dans le SEO agentique, vous définissez la méthode une fois, l'agent récupère ses propres données et, face à une entrée imprévue, suit une règle écrite. L'automatisation de workflow est une troisième chose : une cohérence parfaite sans adaptabilité.
Ai-je besoin d'un agent de programmation ? Non. Des agents comme Codex et Claude Code conviennent mieux quand le correctif est une modification de code ou que le site vit dans un dépôt. Si votre travail consiste surtout en exports, analyses et jugement, un agent à base de compétences le couvre sans toucher au terminal.
Combien de compétences créer au départ ? Une. Choisissez une tâche au résultat visible, écrivez la compétence pour qu'elle tienne sur une page, connectez uniquement la source de données dont elle a besoin, et exécutez-la en lecture seule jusqu'à ce que la sortie soit fiable. Les équipes qui créent huit compétences sans en avoir exécuté une seule abandonnent généralement le projet.
Un workflow de SEO agentique peut-il publier du contenu tout seul ? Il le peut, et il ne devrait pas. Gardez la publication, les redirections, la suppression, la modification de code, les fusions et les messages externes derrière une porte d'approbation explicite. La valeur du workflow tient aux preuves qu'il rassemble, pas à l'autorisation qu'il détient.
Combien coûte son exploitation ? Cela dépend des sources de données, pas de l'agent. Search Console est gratuit pour votre propre domaine. Le coût récurrent se situe dans les données de positions, les données de SERP et les services de crawl, et la plupart proposent des offres gratuites suffisantes pour valider un workflow avant de vous engager.
Auteur : Aaron Wolfe, concepteur de systèmes de croissance organique chez Auspia, 15 ans d'expérience en SEO/GEO. Il écrit sur la façon dont les équipes intègrent agents d'IA, données et étapes de revue dans des workflows de recherche qui survivent à un cycle de planification trimestriel.