Ein KI-Sichtbarkeitstracker klingt unkompliziert. Man stellt einem Assistenten ein paar Kategoriefragen, notiert, ob die eigene Marke auftaucht, und zeichnet das über die Zeit auf.
Das Problem liegt weiter oben im Ablauf, vor der Aufzeichnung. Was man misst, bleibt nicht stehen. Schickt man denselben Prompt zweimal an dasselbe Modell, kommen zwei Antworten zurück, die sich nur teilweise überschneiden. Zeichnet man eine davon auf, hat man eine Stichprobe aus einer Verteilung festgehalten und sie anschließend als Tatsache präsentiert.
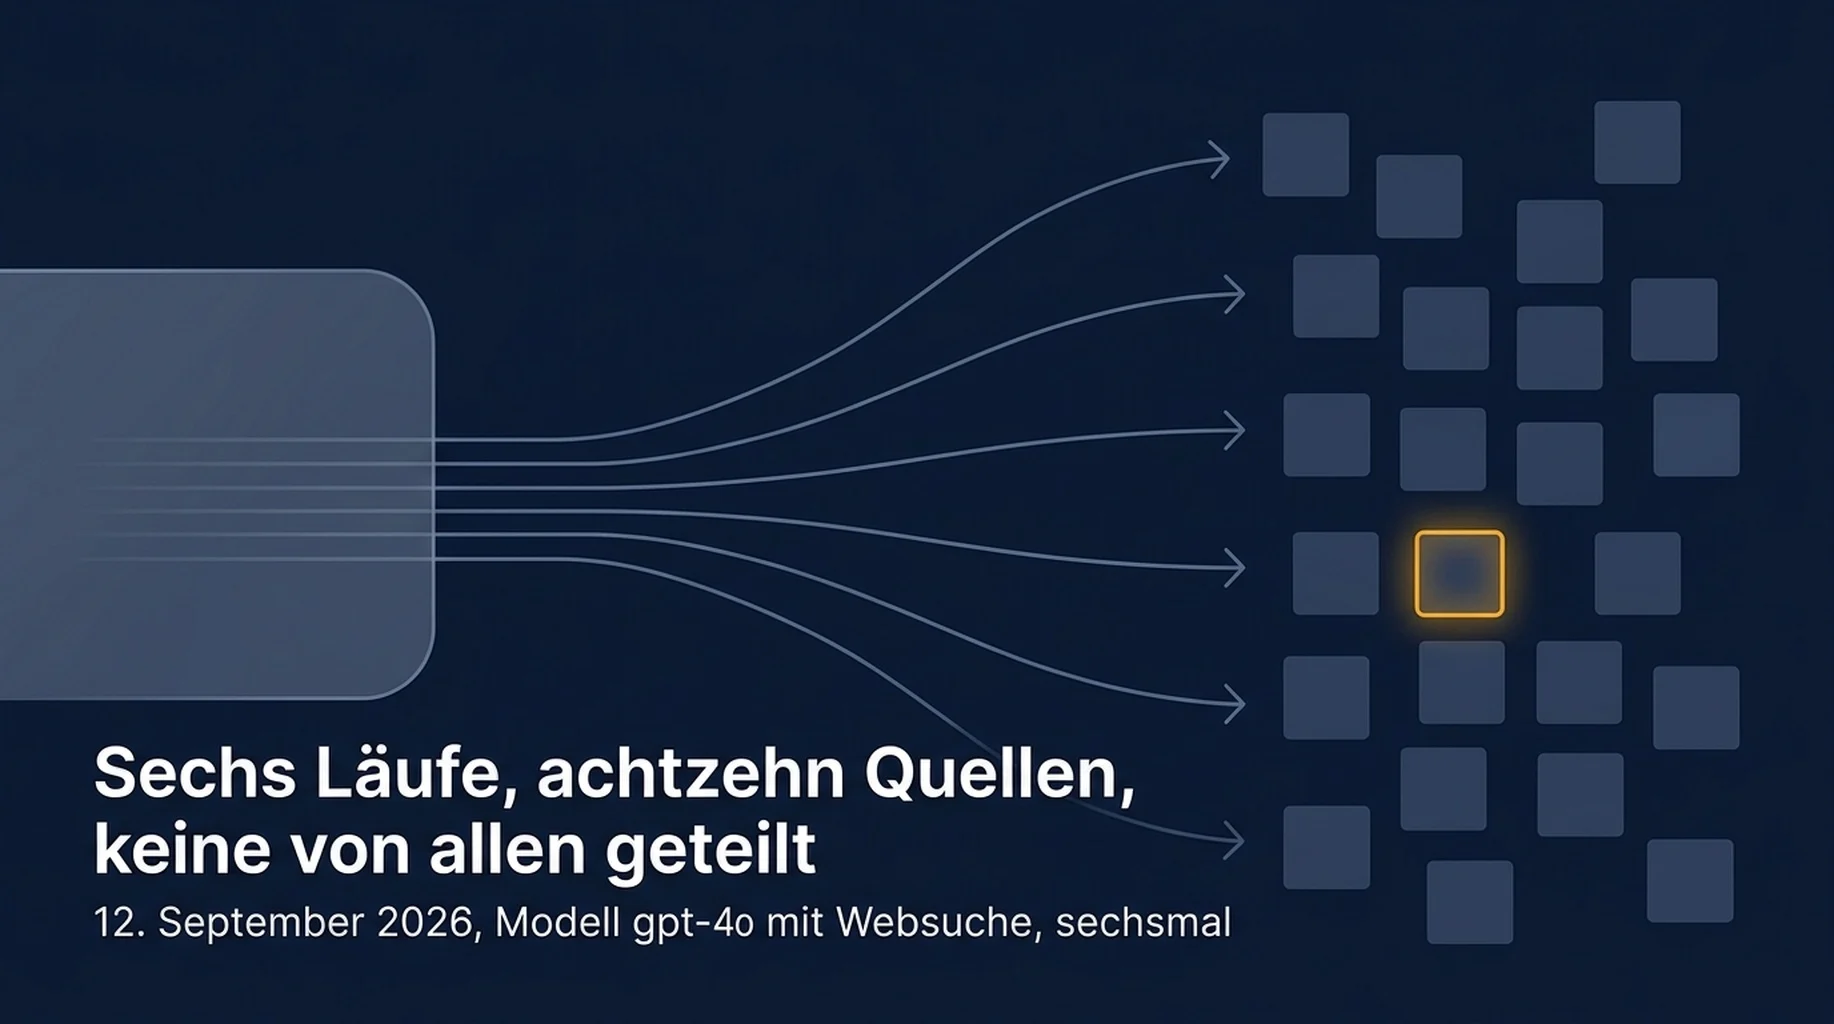
Wir wollten wissen, wie groß diese Streuung tatsächlich ist, also haben wir das Experiment durchgeführt, statt es anzunehmen. Die Kurzfassung: sechs identische Anfragen ergaben achtzehn zitierte Quellen, und keine Quelle wurde in allen sechs zitiert.
Dieser Artikel handelt davon, was wir laufen ließen, was zurückkam, und von den vier Feldern, die ein KI-Sichtbarkeitstracker speichern muss, damit die Zahl auch im nächsten Monat einen zweiten Blick wert ist.
Was wir laufen ließen
Zwei Experimente, beide mit Prompts, die ein SaaS-Team bei einer Kategorierecherche tatsächlich verwenden würde.
Experiment 1: ein Prompt, ein Modell, sechs Läufe. Modell gpt-4o, Websuche aktiviert, Vereinigte Staaten, Englisch. Der Prompt: „Was sind die besten Ranking-Tracking-Tools für ein kleines SaaS-Team im Jahr 2026? Gib eine kurze Liste mit Quellen." Sechs einzelne Live-Aufrufe, nacheinander im selben Sitzungsfenster ausgeführt.
Experiment 2: zwei Modelle, derselbe Prompt, je drei Läufe. Derselbe Prompt ging an Claude Sonnet 5 und an Gemini 3.8 Flash, je dreimal, ohne Websuche. Ohne Suche messen wir, welche Produkte das Modell aus eigenem Wissen nennt, und das ist ein anderes Signal als das, welche Quellen es zitiert.
Wir schickten außerdem einen zweiten Prompt viermal über denselben Websuche-Pfad, um zu sehen, ob das Zitierverhalten über Fragetypen hinweg gleich bleibt: „Wie verfolge ich AI Overviews für meine Website? Gib konkrete Methoden mit Quellen."
Sechs Läufe sind keine große Stichprobe, und wir behandeln sie auch so. Sie reichen, um die Richtung und die ungefähre Größenordnung der Streuung zu zeigen, und genau darum geht es.
Ergebnis 1: achtzehn Quellen, null von allen sechs Läufen geteilt
Die sechs Websuche-Läufe zitierten zusammen 18 verschiedene URLs. Hier ist, wie oft jede Domain vorkam.
Anzahl der Zitierungen (von 6 Läufen) | Domains |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Keine Domain wurde in allen sechs Läufen zitiert. Keine URL wurde in allen sechs Läufen zitiert.
Die entscheidende Zahl ist hier die Überschneidung zwischen den Läufen. Beim Vergleich jedes Laufpaares lag die durchschnittliche Jaccard-Überschneidung der zitierten URLs bei 0,167. In zwei der fünfzehn Paare lag die Überschneidung exakt bei null, das heißt, diese beiden Antworten teilten keine einzige Quelle.
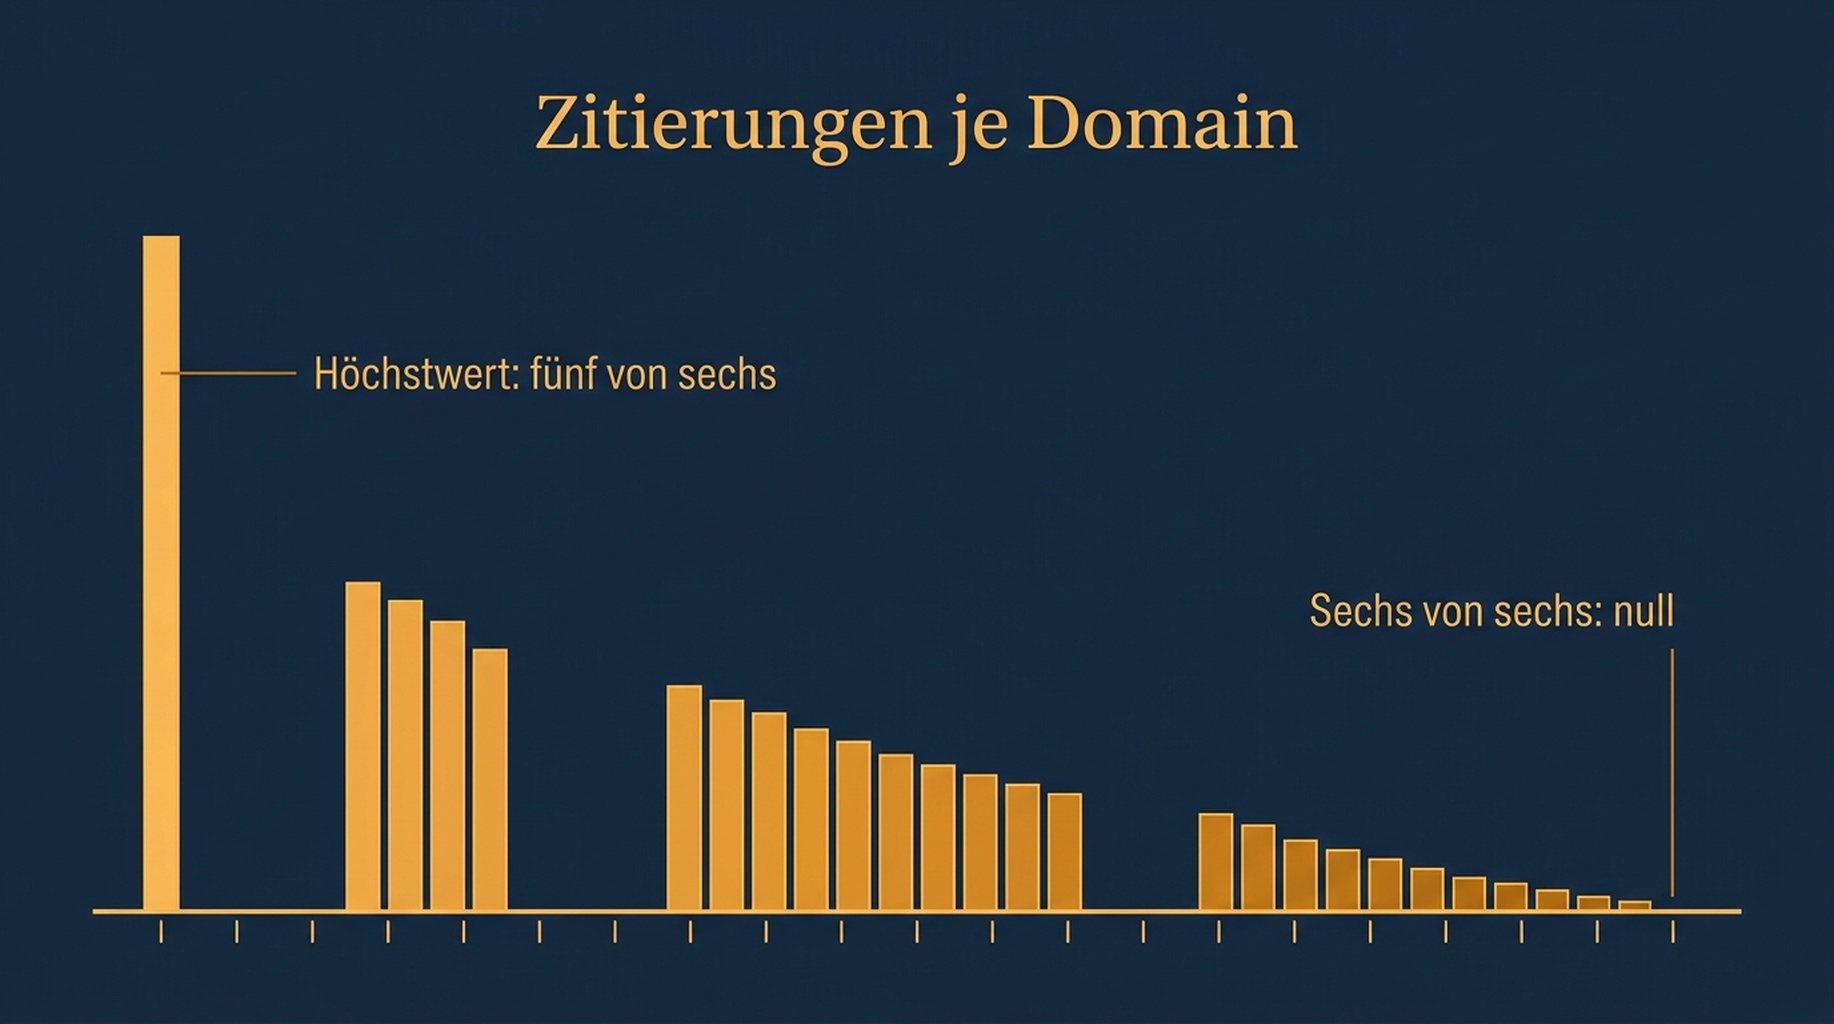
Eine in fünf von sechs Läufen zitierte Quelle ist die Obergrenze, die wir beobachtet haben. Nichts wurde jedes Mal zitiert.
In dieser Tabelle steckt ein zweiter Befund. Die Domains, nach denen das Modell griff, sind überwiegend nicht die bekannten Vergleichsseiten der Kategorie. Neun der achtzehn Domains erschienen genau einmal, und einige sind kleine Seiten, deren Inhalt sich liest wie etwas, das für diese Anfrage zusammengestellt wurde, und nicht wie etwas Recherchiertes. Für eine Marke ist das ein zweischneidiges Schwert. Es bedeutet, dass der Zitierplatz leichter zu gewinnen ist als ein traditionelles Ranking der „besten Tools". Es bedeutet auch, dass der Platz von demjenigen besetzt wird, der eine Seite produziert hat, die in diesem Lauf zur Form der Anfrage passte, und dass er im nächsten Lauf neu besetzt wird.
Ergebnis 2: die Antwort selbst ändert ihre Größe
Die Zitate bewegten sich, und die Antwortlänge bewegte sich mit.
Lauf | Ausgabe-Token | Antwortlänge | Kosten des Laufs |
|---|---|---|---|
1 | 505 | 2.153 Zeichen | $0,0735 |
2 | 860 | 3.728 Zeichen | $0,0770 |
3 | 1.108 | 4.746 Zeichen | $0,0797 |
4 | 832 | 3.555 Zeichen | $0,0765 |
5 | 870 | 3.547 Zeichen | $0,0772 |
6 | 813 | 3.544 Zeichen | $0,0768 |
Die Ausgabelänge reichte von 505 bis 1.108 Token, eine Spanne von 603 Token, rund 73 Prozent des Mittelwerts. Die längste Antwort war mehr als doppelt so lang wie die kürzeste. Fünf der sechs Läufe fielen in ein recht schmales Band zwischen 813 und 1.108 Token; ein Lauf stoppte früh bei 505 und zitierte fünf Quellen statt neun bis vierzehn.
Für die Messung ist das auf eine konkrete Weise wichtig. Wenn Ihr Tracker erfasst, „ob die Marke in der Antwort vorkommt und an welcher Position", dann hat ein kurzer Lauf weniger Plätze, an denen sie vorkommen kann. Ein Team, das einmal pro Woche eine Stichprobe zieht und zufällig einen kurzen Lauf erwischt, verzeichnet ein schlechteres Ergebnis als ein Team, das einen langen Lauf erwischt hat, ohne dass sich auf der Website irgendetwas geändert hätte.
Ergebnis 3: manche Prompts bekommen gar keine Zitierungen
Der zweite Prompt, über das Verfolgen von AI Overviews, lief viermal über denselben Websuche-Pfad und kam jedes Mal mit null Zitierungen zurück.
Lauf | Ausgabe-Token | Antwortlänge | Zitierungen |
|---|---|---|---|
1 | 479 | 2.135 Zeichen | 0 |
2 | 522 | 2.240 Zeichen | 0 |
3 | 534 | 2.312 Zeichen | 0 |
4 | 497 | 2.228 Zeichen | 0 |
Die Antworten waren in der Länge stabil und änderten sich über die vier Läufe nur um 8 Prozent. Aber das Modell antwortete aus eigenem Wissen und nannte keine einzige Quelle, also gab es in der Zitierspalte nichts einzutragen.
Daraus ergibt sich eine bestimmte und irreführende Ablesung des Trackers. Ein Dashboard für die Zitierrate zeigt für diese Frage null, und das sieht nach einem Sichtbarkeitsausfall aus. Ist es nicht. Es ist eine Frageform, die keine Quellensuche auslöst. Die richtige Ablesung lautet „Zitierung nicht anwendbar", und ein Tracker, der das nicht von „Zitierung geprüft, und Sie waren abwesend" unterscheiden kann, schickt Sie auf die Jagd nach einem Problem, das es nicht gibt.
Ergebnis 4: Modellwechsel ist eine andere Messung, keine Wiederholung
Mit ausgeschalteter Websuche maßen wir, welche Produkte jedes Modell nennt. Das isoliert die Empfehlungsmenge des Modells selbst von allem, was der Suchindex in dieser Minute zurückgab.
Claude Sonnet 5 nannte pro Lauf vier bis fünf Produkte. Über drei Läufe nannte es sechs verschiedene Produkte: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat und SerpWatcher. Drei davon erschienen in allen drei Läufen: AccuRanker, Ahrefs und SEMrush. Durchschnittliche paarweise Überschneidung 0,587.
Gemini 3.8 Flash nannte pro Lauf zwei bis fünf Produkte. Über drei Läufe nannte es sieben verschiedene Produkte: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush und Wincher. Nur eines davon, SE Ranking, erschien in allen drei Läufen. Durchschnittliche paarweise Überschneidung 0,306.
Zwischen den beiden Modellen wurden vier Produkte von beiden genannt und fünf nur von einem.
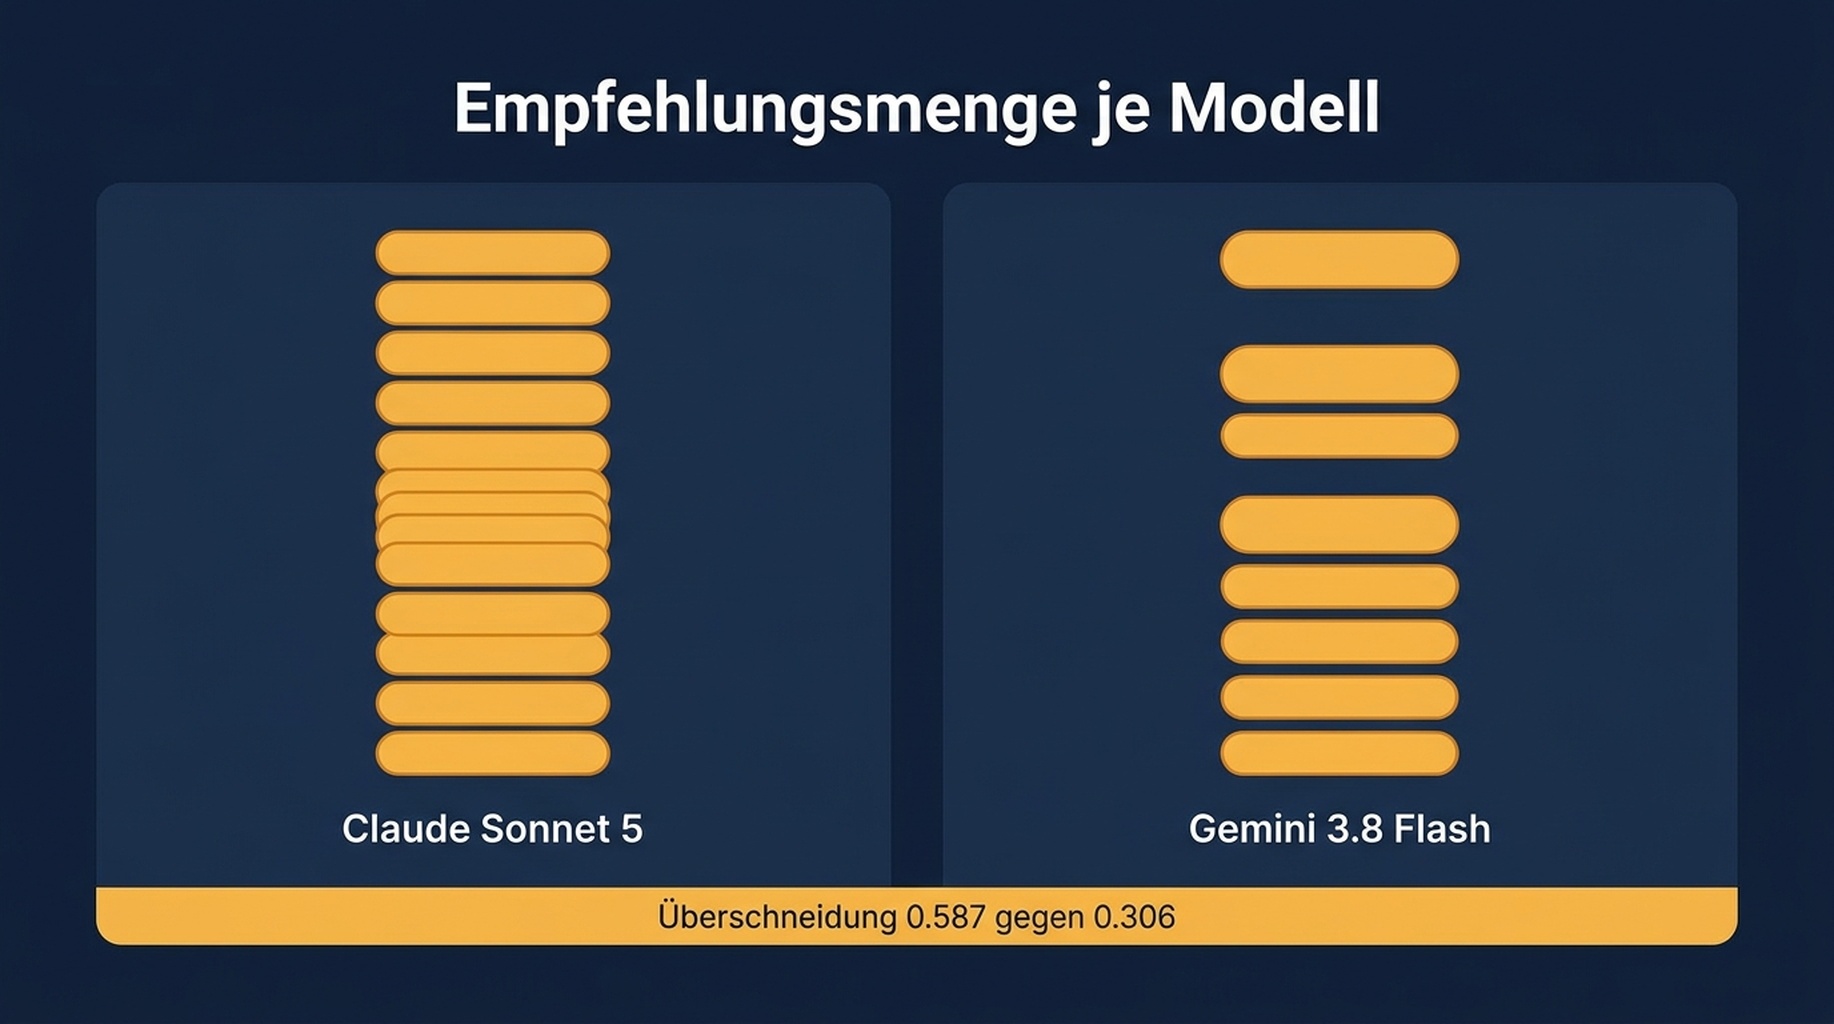
Dieselbe Frage erzeugt bei jedem Modell und in jedem Lauf eine teilweise andere Empfehlungsmenge.
Die praktische Folge: Wenn Sie „KI-Sichtbarkeit" als eine einzige Zahl verfolgen, mitteln Sie über mindestens zwei unabhängige Streuungsquellen, nämlich Lauf und Modell. Eine Marke, die bei einem Assistenten stabil erscheint und bei einem anderen nicht, ist ein echter und umsetzbarer Befund. Eine Marke, deren Einzelstichprobenmessung sich um zwei Positionen bewegt hat, ist Rauschen.
Was ein KI-Sichtbarkeitstracker erfassen sollte
Vier Felder machen aus einem Screenshot eine Messung.
Die Anzahl der Läufe, nicht das Ergebnis eines Laufs. Speichern Sie jeden Lauf und berichten Sie die Spanne. „In 4 von 6 Läufen zitiert" ist eine Tatsache. „Zitiert, Position 3" ist ein Zufall. Sechs Läufe sind eine vernünftige Untergrenze für ein kleines Programm; zwölf sind besser, wenn der Prompt kommerziell wichtig ist.
Das Zitierfeld getrennt vom Erwähnungsfeld. „Das Modell hat uns empfohlen" und „das Modell hat auf uns verlinkt" sind verschiedene Ergebnisse mit verschiedenen Gegenmaßnahmen. Unsere sechs Läufe ergaben 18 Zitierungen aus 18 verschiedenen URLs; ein Tracker, der nur Markenerwähnungen erfasst, hätte von diesem Wechsel nichts eingefangen.
Der Kanalzustand der Antwort. Erfassen Sie, ob der Lauf überhaupt Websuche verwendet hat, und erfassen Sie die Antwortlänge. Ein Lauf mit null Zitierungen und ein Lauf mit null Erwähnungen sehen im Dashboard identisch aus und bedeuten das Gegenteil.
Der Prompt-Text wörtlich, mit Versionsnummer. Die Formulierung des Prompts bestimmt, welche Quellen herangezogen werden. Ändert sich der Prompt zwischen Monaten, bricht die Trendlinie. Versionieren Sie den Prompt so, wie Sie ein Tracking-Skript versionieren.
Die Laufschleife bauen
Manuelle Prüfung übersteht eine einzige Begegnung mit dem Kalender nicht. Die Schleife ist ein Skript, das einen Prompt N-mal ausführt, jede Rohantwort samt ihren Zitierungen speichert und das aktuelle Fenster mit dem vorherigen vergleicht.
Das passt gut zu einem Agenten, weil die Arbeit repetitiv ist, Regeln unterliegt und ein schriftliches Protokoll braucht. In Claude Code oder Codex lautet die nützliche Anweisung, die Rohdatenläufe auf der Festplatte zu lassen und sie niemals zu überschreiben und dann eine Übersichtstabelle statt einer einzelnen Zahl zu berichten. Wenn Sie Search-Console- und Bing-Daten bereits über MCP-Server abrufen, kann dieselbe Sitzung das Zitierprotokoll neben den Impressionen führen, und dort beginnen die beiden Zahlen, zusammen nützlich zu sein. Unsere Notizen dazu, was diese Server offenlegen, stehen in was vier SEO-MCP-Server tatsächlich tun, und die Anwesenheitsseite desselben Problems steht in unserer AI-Overview-Momentaufnahme über vierzig Anfragen.
Eine Designregel ist wichtiger als die übrigen: Die Ausgabe des Trackers sollte eine Verteilung sein. Berichten Sie „in 4 von 6 zitiert", nicht „zitiert". Berichten Sie die Quellenliste, nicht die Top-Quelle. Jedes Dashboard, das sechs Läufe zu einer Zahl verdichtet, hat die einzige Information weggeworfen, die die zusätzlichen Läufe gekauft haben.
Wenn das Ziel der Wettbewerbsvergleich und nicht die Überwachung ist, ist eine zeitlich fortlaufende Ranking-Tracking-Schleife das passendere Werkzeug, und die Abwägungen zwischen Datenquellen stehen in einen Ranking-Tracker aus zwei Quellen bauen.
Grenzen einer Stichprobe aus sechs Läufen
Drei ehrliche Einschränkungen.
Die Stichprobe ist klein. Sechs Läufe umreißen die Streuung nur locker. Sie belegen, dass die Überschneidung zwischen Läufen teilweise ist und dass Paare mit null Überschneidung vorkommen; ein Konfidenzintervall für Ihre Kategorie liefern sie nicht.
Die Ergebnisse sind zeitgebunden. Diese Läufe fanden am 12. September 2026 gegen live laufende Modelle statt. Sowohl die Modelle als auch die Suchergebnisse darunter ändern sich.
Die zitierten Domains sind eine Stichprobe aus einem einzigen kommerziellen Prompt. Eine andere Frageform, etwa eine Vergleichsfrage oder eine How-to-Frage, erzeugt ein anderes Zitiermuster. Der nützliche Schritt ist, dasselbe Design über Ihre zehn kommerziell wichtigsten Prompts laufen zu lassen und festzuhalten, wie sich Ihre Kategorie verhält.
Häufige Fragen
Wie viele Läufe brauche ich, bevor die KI-Sichtbarkeitszahl etwas bedeutet? Sechs ist die praktische Untergrenze für einen einzelnen Prompt, und die Zahl sollte als Zählung aus der Gesamtzahl der Läufe berichtet werden, nicht als Position. Wenn der Prompt Umsatzentscheidungen steuert, liefern zwölf Läufe für ein paar Dollar eine engere Ablesung.
Heißt das, KI-Sichtbarkeit zu verfolgen lohnt sich nicht? Es heißt, dass Verfolgung mit einer Einzelstichprobe sich nicht lohnt. Die Streuung ist der Befund. Ein Tracker, der berichtet „in 4 von 6 Läufen zitiert, die Quellen haben sich seit dem Vormonat um 12 Domains verschoben", beschreibt ein reales System, in dem ein Wettbewerber um Platz ringt.
Warum kam ein Prompt mit null Zitierungen zurück? Das Modell antwortete aus eigenem Wissen, statt Quellen zu suchen. Das ist eine Eigenschaft der Frage, kein Versagen Ihrer Website. Verfolgen Sie es als nicht anwendbar, nicht als null.
Sollte ich ChatGPT, Claude und Gemini getrennt verfolgen? Ja. In unserem Vergleich über drei Läufe überschnitten sich die beiden Modelle bei nur vier von neun genannten Produkten. Eine Mittelung verdeckt eine Entscheidung auf Programmebene darüber, welcher Assistent zuerst optimiert werden sollte.
Lässt sich die Streuung senken, indem man die Temperatur des Modells reduziert? Teilweise, und es lohnt sich, das mit Ihren Prompts zu testen. Aber die Zitiermenge wird auch vom Suchindex bewegt, und den kontrollieren Sie nicht. Die Anzahl der Läufe ist der verlässlichere Hebel.
Auspia-Sicht: Wenn Sie in diesem Quartal KI-Sichtbarkeitsverfolgung aufbauen, bauen Sie zuerst das Laufprotokoll und dann das Dashboard. Das Dashboard ist eine Darstellungsentscheidung. Das Laufprotokoll ist die Messung. Beginnen Sie mit zehn Prompts, je sechs Läufen, wörtlich gespeichert, und Sie lernen in einer Woche mehr, als Ihnen ein ganzes Jahr Einzelstichprobenprüfung sagen würde.
Autor: Ethan Marlowe, Leitung der GEO-Messung über mehr als 500 Prompts bei Auspia. Schreibt über Prompt-Tracking, Zitierberichte und Sichtbarkeits-Dashboards, die den Kontakt mit einem echten Messzyklus überstehen.