Die meisten Teams, die sagen, sie "machen agentisches SEO", fügen in Wahrheit einen langen Prompt in ein Chat-Fenster ein. Beim ersten Mal funktioniert das. Das Problem beginnt beim zweiten Mal: Die Struktur der Ausgabe ändert sich, die Daten sind eine Woche alt, und niemand kann sagen, ob sich die Zahlen bewegt haben oder der Prompt abgedriftet ist.
Die Variante, die hält, unterscheidet sich in genau einem Punkt: Die Methode steht in einer Datei, nicht in deiner Nachricht. Du schreibst das Verfahren einmal, übergibst es einem Agenten, und danach laufen dieselben Prüfungen bei jedem Durchlauf, ob du daran gedacht hast, sie anzufordern, oder nicht.
Das ist die ganze Idee. Was folgt, ist der Aufbau, welcher Agent für welche Aufgabe passt und wo es leise kaputtgeht.
Was "agentisch" tatsächlich verändert
Es gibt drei Dinge, die man automatisieren kann, und sie sind nicht dasselbe.
Workflow-Automatisierung | KI-gestütztes SEO | Agentisches SEO | |
|---|---|---|---|
Wer die Schritte wählt | Du, im Voraus | Du, in jedem Gespräch | Du, einmal, in einer schriftlichen Methode |
Woher die Daten kommen | Fest verdrahtete Integrationen | Was du einfügst | Der Agent holt sie selbst |
Bei unerwarteter Eingabe | Bricht ab | Hängt von deiner Formulierung ab | Folgt einer Regel oder eskaliert |
Konsistenz zwischen Läufen | Perfekt und starr | Niedrig | Hoch und trotzdem anpassungsfähig |
Am besten geeignet für | Große Mengen unveränderlicher Aufgaben | Erkundung und einmalige Fragen | Wiederkehrende Analysen, die Urteilsvermögen brauchen |
Der praktische Unterschied zeigt sich daran, was du nicht mehr tust. In einem Chat-Workflow erklärst du die Website, die Zielgruppe, die Prioritätsregeln und das Ausgabeformat jedes Mal neu. Jede dieser Erklärungen ist eine Gelegenheit, etwas zu vergessen. In einem agentischen Workflow liegen diese Dinge in Dateien, die der Agent bei jedem Lauf liest, und dein Prompt schrumpft auf eine Zeile: Führe die Prüfung auf Content-Verfall für September aus.
Das hat auch einen Preis. Wenn die Aufgabe jedes Mal wirklich anders ist, gibt es keine Methode zum Aufschreiben, und der Aufbau ist Aufwand ohne Ertrag. 50.000 URLs auf ihren Statuscode zu prüfen ist Arbeit für ein Skript, nicht für einen Agenten. Die Trennlinie sind zwei Fragen: Wiederholt sich die Aufgabe, und braucht sie Urteilsvermögen? Wenn beides zutrifft, gewinnt der agentische Ansatz. Wenn eines davon nicht zutrifft, lass es bleiben.
Die vier Schichten und wofür jede da ist
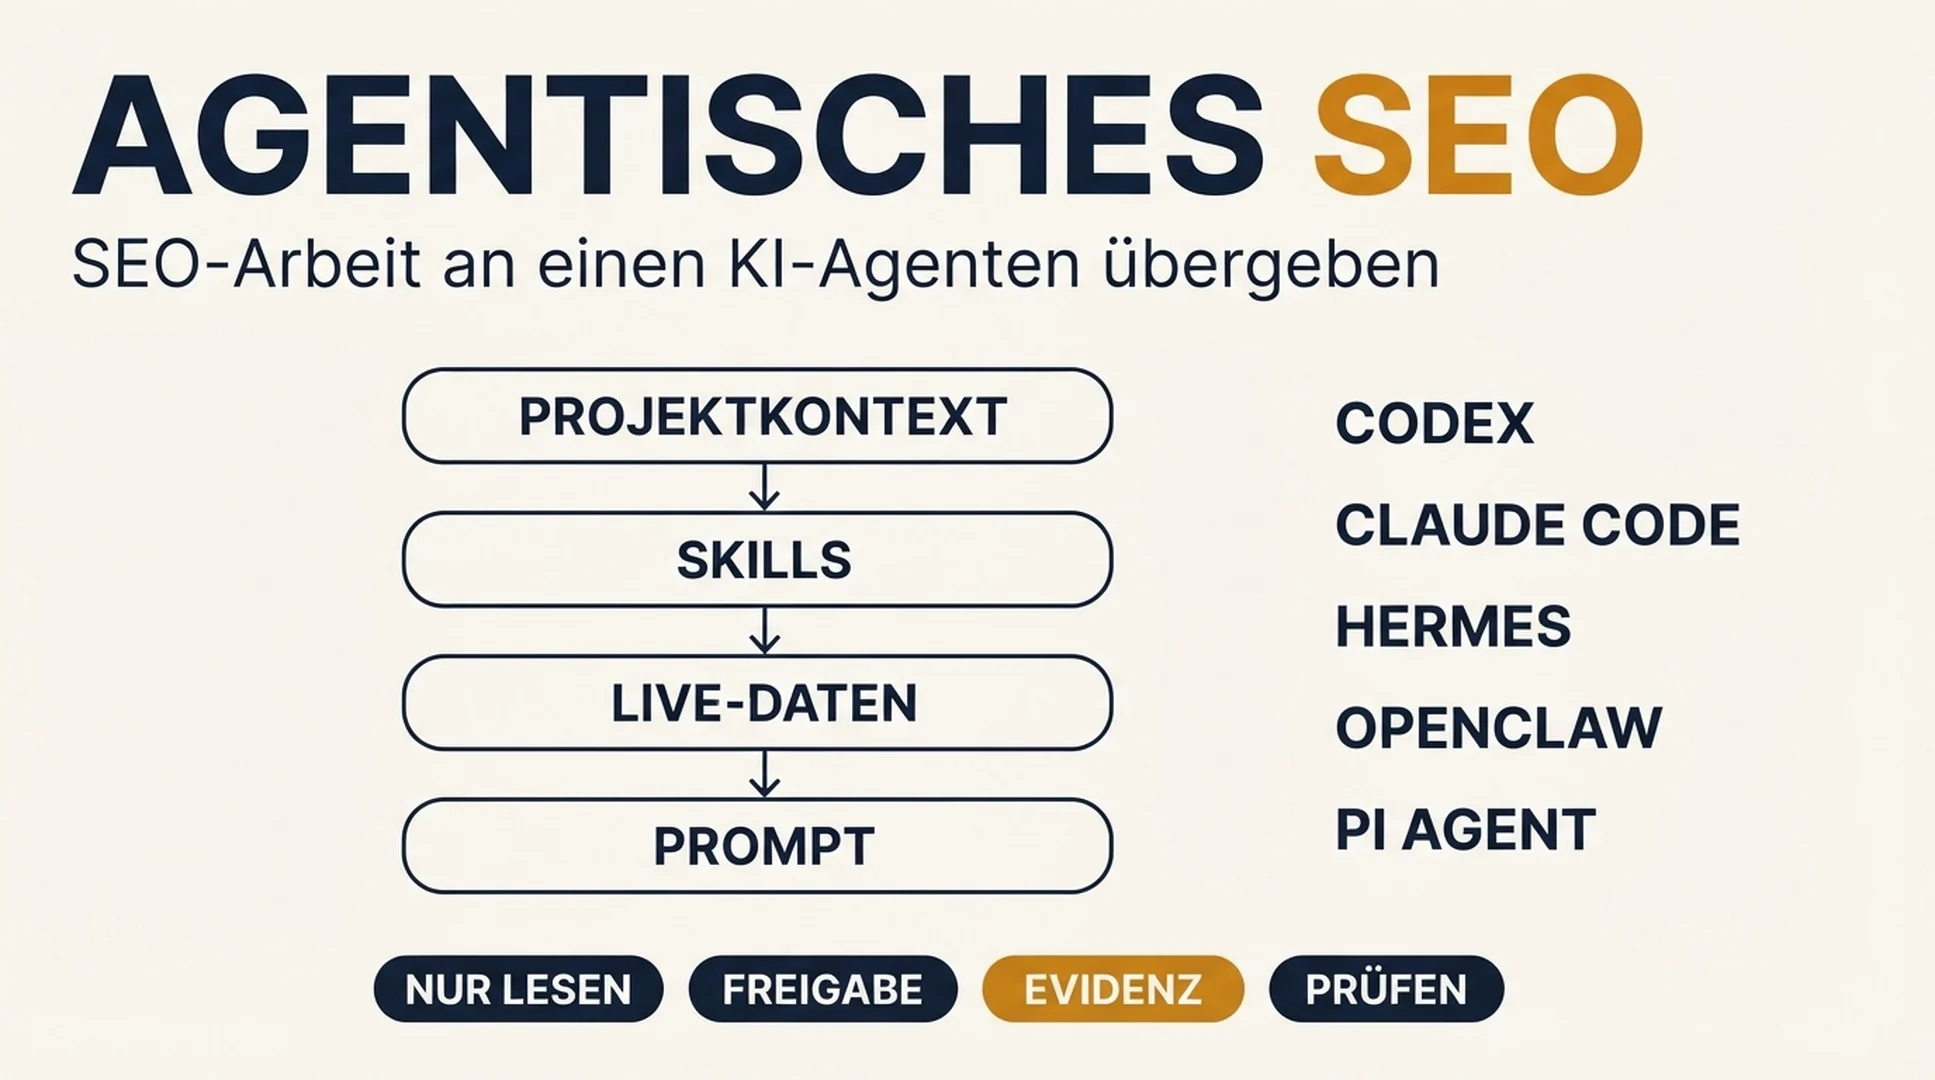
Jedes agentische SEO-Setup, das überlebt, hat dieselben vier Teile. Lass eine weg, und du bekommst einen vorhersehbaren Fehlertyp.
Projektkontext. Ein Ordner mit dem, was sich nicht ändert: die Website, die Märkte, wer warum kauft, was als Conversion zählt, wer die echten Wettbewerber sind, die redaktionellen Regeln. Das ist es, was den Agenten davon abhält, allgemeine Ratschläge für ein Geschäft zu schreiben, das er nicht versteht. Lässt du diese Schicht weg, bekommst du selbstsichere, plausible und nutzlose Ausgaben.
Skills. Schriftlich festgehaltene Verfahren. Jeder sagt, wann er einzusetzen ist, welche Daten er braucht, die Reihenfolge der Schritte, die Bewertungsregeln, das Ausgabeformat und welche Aktionen deine Freigabe erfordern. Diese Schicht macht den Workflow wiederholbar, und sie ist die, die die meisten Teams überspringen.
Zugriff auf Live-Daten. Verbindungen, mit denen der Agent aktuelle Zahlen selbst holt, statt darauf zu warten, dass du exportierst und einfügst. Search Console für die eigene Leistung. Analytics für das Verhalten. Eine Ranking- oder SERP-Quelle für das, was du in der eigenen Domain nicht siehst. Ein Crawler oder eine CMS-Verbindung für Fakten auf Seitenebene. Ohne diese Schicht hast du einen sehr guten Analysten, der mit der Tabelle vom letzten Monat arbeitet.
Der Prompt. Die aktuelle Aufgabe, sonst nichts. Wenn dein Prompt Kontext oder Methode transportiert, gehören diese in die erste und zweite Schicht.
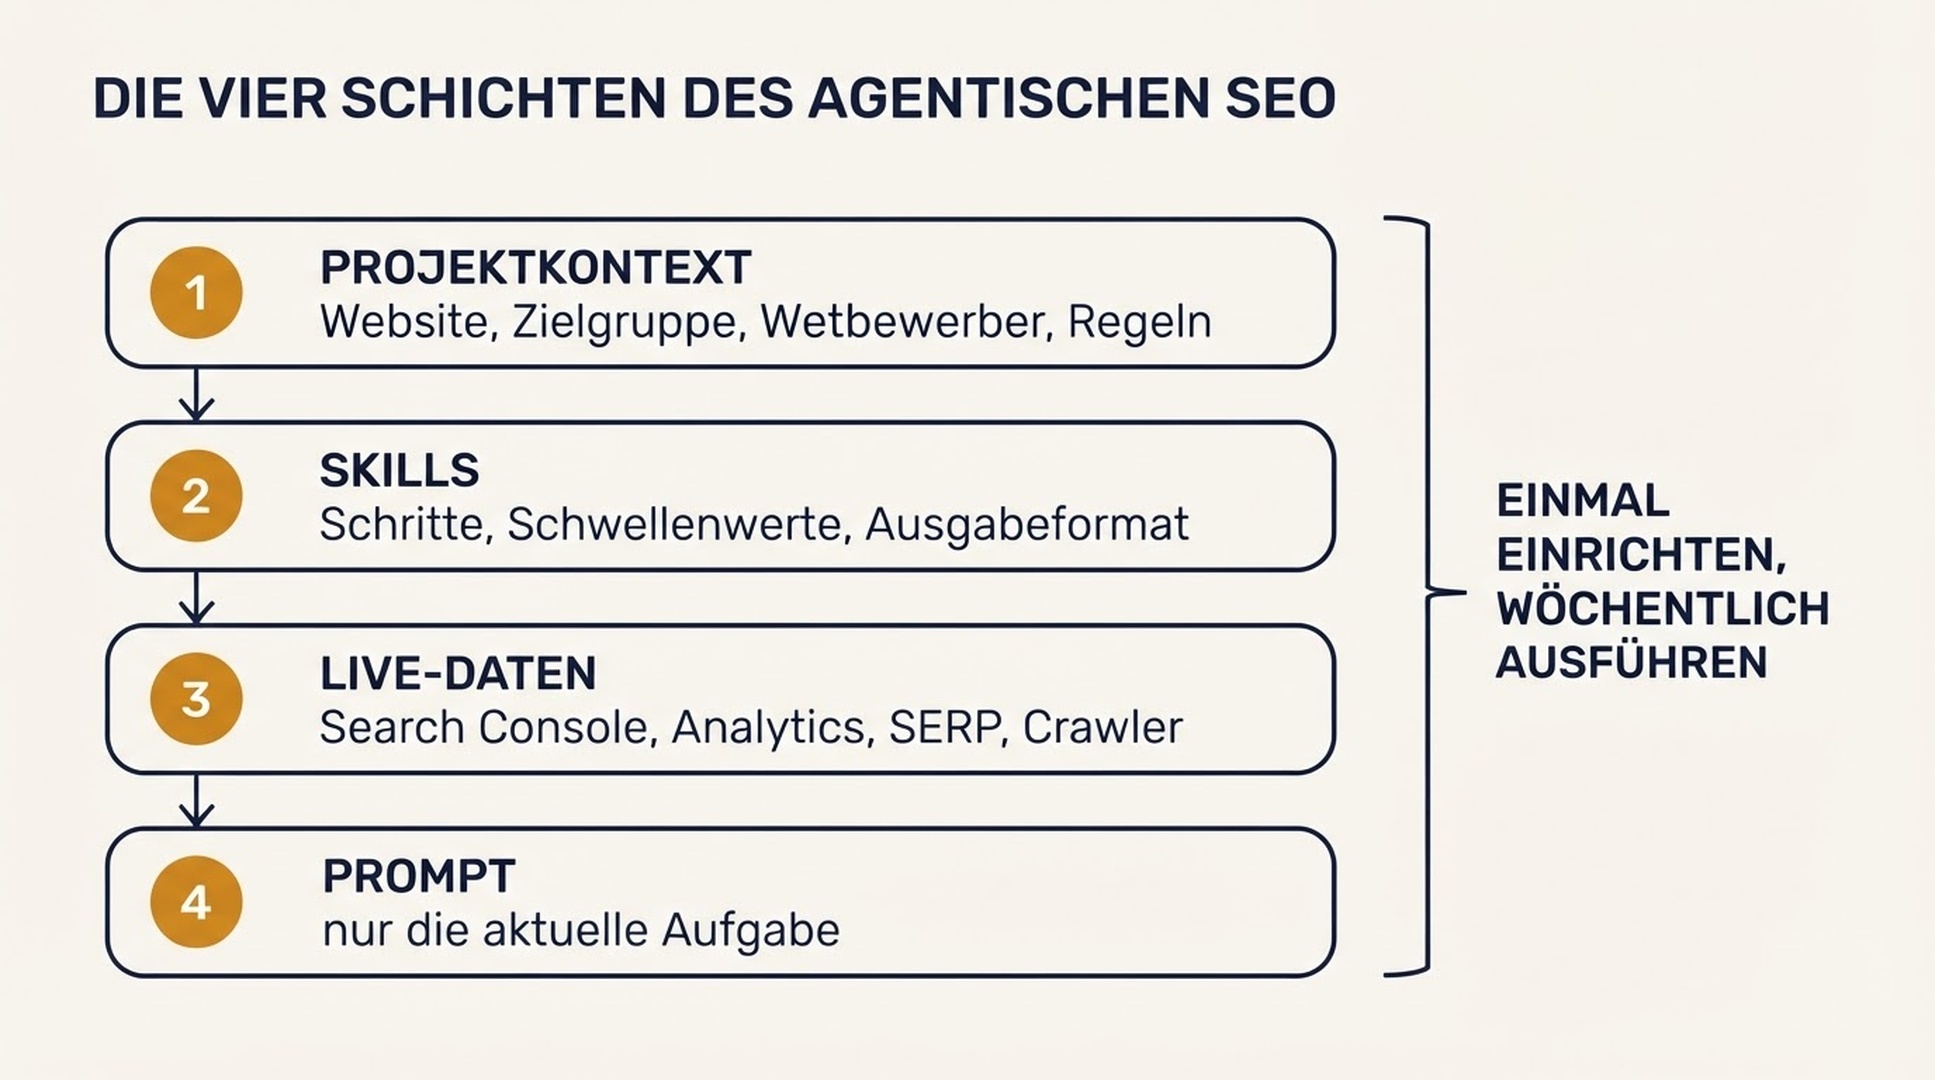
Richte die vier Schichten einmal ein, und der wöchentliche Lauf besteht aus einer Zeile. Wenn das Ergebnis falsch aussieht, prüfe zuerst, welche Schicht versagt hat, bevor du den Prompt umschreibst.
Auspia-Sicht: Das Vier-Schichten-Modell ist die nützlichste Idee in dieser Kategorie und zugleich die Stelle, an der die meisten Teams zu früh aufhören. Sie bauen den Kontextordner, überspringen die Skills und landen bei einem gut informierten Chatbot. Das Produkt ist der Skill. Alles andere ist Leitungsbau.
Welcher Agent für welche Aufgabe
Das ist die Frage, die uns am häufigsten gestellt wird, und die ehrliche Antwort lautet: Die Unterschiede sind weniger wichtig als das Setup. Alles hier Genannte schafft die meisten SEO-Aufgaben, wenn man nur stark genug drückt. Was sie trennt, ist die Stelle, an der jeder am wenigsten umständlich ist, und das entscheidet, ob du ihn in Woche drei noch benutzt.
Agent | Am stärksten bei | Zugriffsmodell | Sinnvolle erste SEO-Aufgabe |
|---|---|---|---|
Codex | Repository-Arbeit, geplante Läufe, überprüfbare Änderungen | Lokale Dateien, Terminal, git, Automatisierung | Wöchentliche Momentaufnahmen im Repository ablegen und einen Pull Request mit dem Bericht öffnen |
Claude Code | Langkontext-Prüfung gegen eine explizit geschriebene Richtlinie | Terminal, Projekt-Gedächtnisdatei, MCP-Verbindungen | Search-Console-Exporte und den Seitenquelltext lesen und ein dokumentiertes Urteil abgeben |
Hermes Agent | Wiederholbare Skills mit Gedächtnis über Sitzungen hinweg | Open-Source-Agent mit Skill-System und dauerhaftem Gedächtnis | Einen Skill installieren und denselben Workflow im selben Rhythmus ausführen |
OpenClaw | Browser-Evidenz unter engen Berechtigungen sammeln | Zuerst Browser, dann lokale Dateien | Erfassen, was die Suche mobil tatsächlich zurückgibt, und dort aufhören |
Pi Agent | Über Monate klein und vorhersehbar bleiben | Minimaler Kern, Markdown-Skills als Erweiterungspunkt | Ein enges, lesbares Verfahren ausführen, wo du alles auditieren willst, was er kann |
Zwei Einschränkungen. Diese Kategorie ändert sich monatlich, prüfe also die aktuellen Limits und Preise in der offiziellen Dokumentation des Anbieters, bevor du ein Team darauf festlegst. Und diese Tabelle ist ein Ausgangspunkt, keine Obergrenze.
Für jeden gibt es bei uns eine einsteigerfreundliche Anleitung: Codex, Claude Code, Hermes Agent, OpenClaw. Alle vier folgen derselben Form: erst nur lesen, eine freigegebene Änderung nach der anderen, vor dem Ausliefern prüfen.
Die praktische Auswahlregel hängt davon ab, wo deine Arbeit bereits liegt. Liegt die Website in einem git-Repository und sind Seitenänderungen Codeänderungen, beginne mit Codex oder Claude Code. Besteht die Arbeit überwiegend aus Exporten, Gesprächen und Urteilsvermögen, beginne mit einem skill-basierten Agenten. Musst du sehen, was ein echter Browser zurückgibt, brauchst du Browserzugriff und eine harte Berechtigungsgrenze. Willst du die kleinstmögliche Oberfläche, die du in einem Durchgang von Anfang bis Ende lesen kannst, ist der minimale Kern von Pi Agent genau dafür gebaut, und der Preis dafür ist, dass<|placeholdermmspan0442|> alles, was du brauchst, in einem Skill lebt, den du selbst hinzufügst.
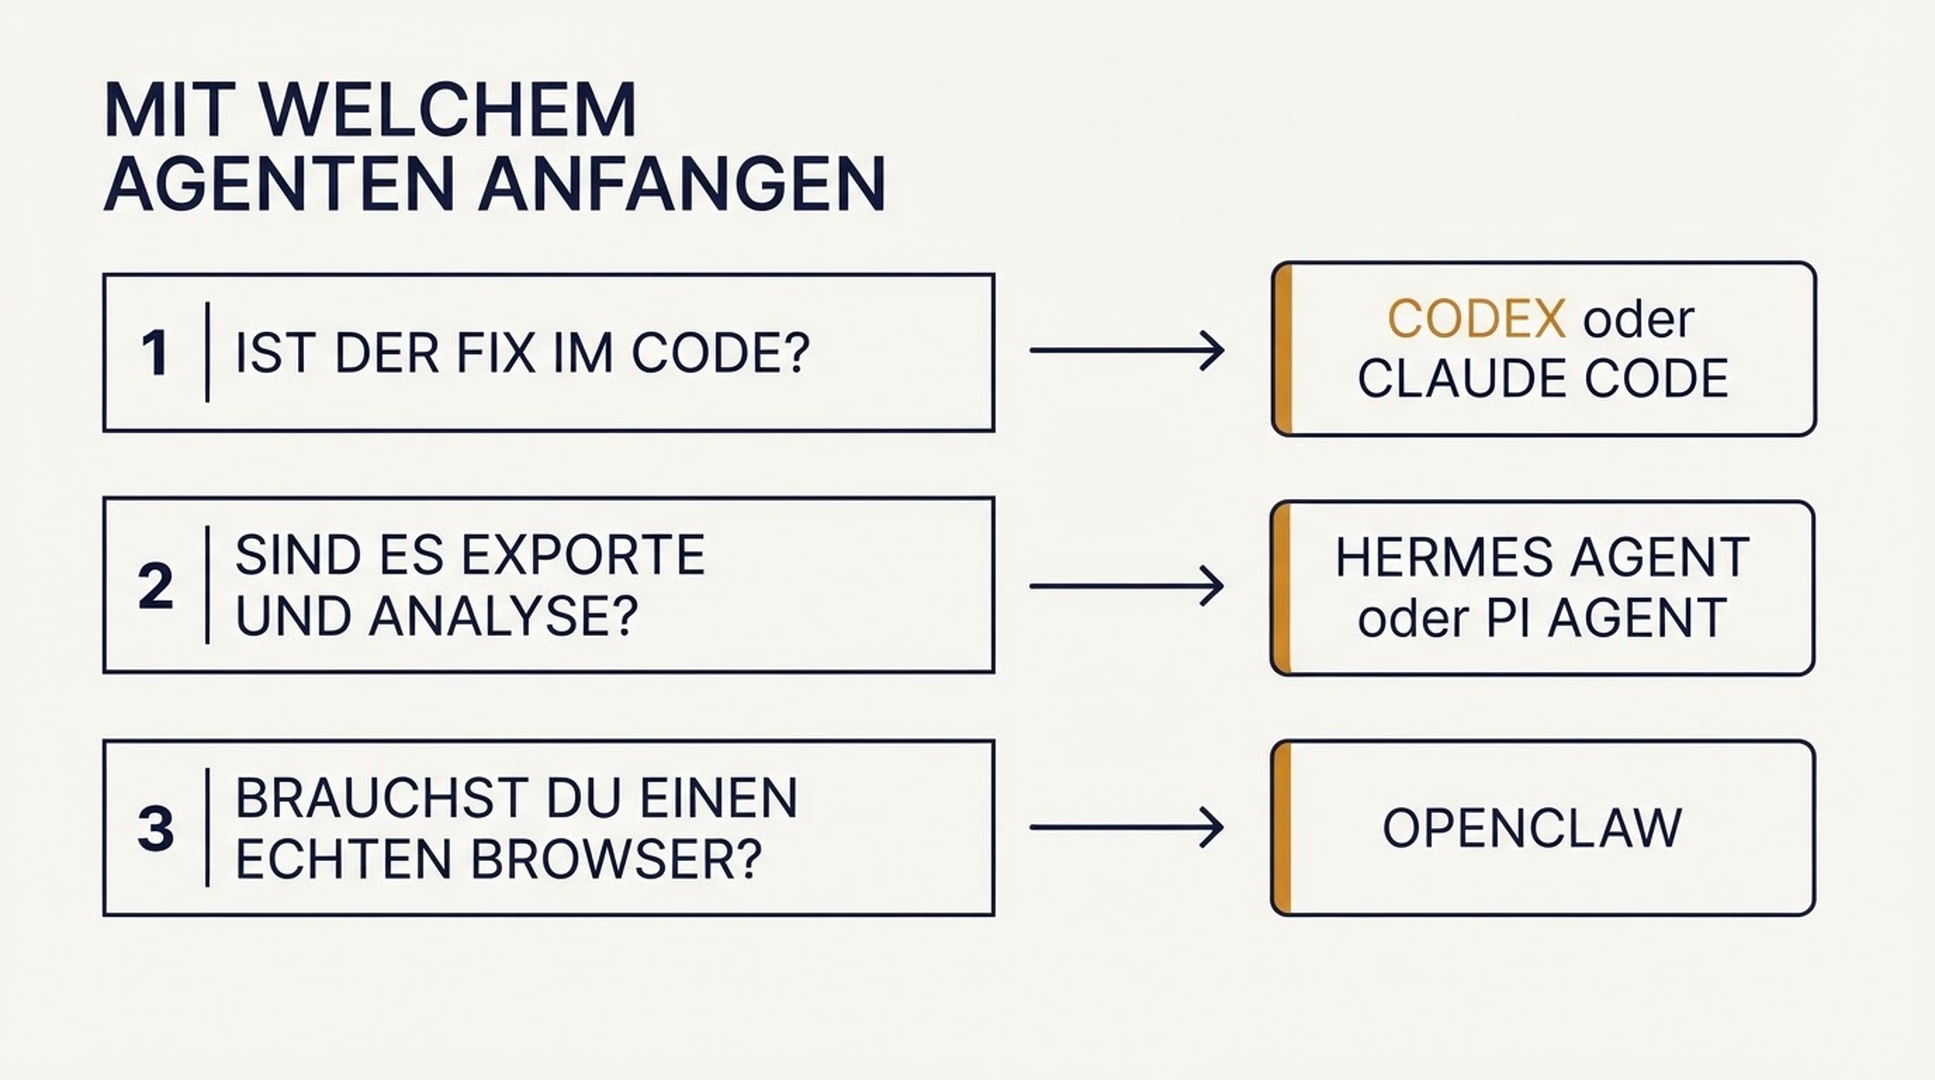
Drei Fragen reduzieren fünf Agenten auf einen. Beantworte sie, bevor du Funktionslisten vergleichst.
Die Aufgaben, die zuerst abgegeben werden sollten
Fang nicht mit der interessanten an. Fang mit der langweiligen an, die sich nach Plan wiederholt und etwas produziert, das jemand liest. Diese amortisieren sich am schnellsten.
Triage von Content-Verfall. Ziehe die Leistung im Periodenvergleich, wirf alles unterhalb der Materialitätsschwelle weg, prüfe zuerst die Indexierung und schau dann auf Rankings, Nachfrage, Links und Kannibalisierung. Du bekommst eine URL-Tabelle mit verlorenen Klicks, der wahrscheinlichen Ursache, der Evidenz und einer primären und einer alternativen Maßnahme. Eine Seite, die Rankings verloren hat, braucht eine Überarbeitung. Eine Seite, die Nachfrage verloren hat, braucht nichts. Eine Seite, die ihr Canonical verloren hat, ist in fünf Minuten repariert. Teams verwechseln diese drei Fälle ständig, und die Verwechslung ist nicht billig.
Triage technischer Probleme. Gruppiere Probleme nach Ursache statt nach Typ, verknüpfe die betroffenen URLs mit Traffic und Rankings, bewerte Wirkung gegen Aufwand und prüfe die obersten Punkte an echten Seiten, bevor du die Fixliste schreibst. Der Wert liegt in dieser Gruppierung. Zehn Zeilen "temporäre Weiterleitung" haben meist eine einzige Ursache, und ein Template zu reparieren ist besser, als zehn URLs zu reparieren.
Bewegungen der Wettbewerber. Isoliere die Seiten und Keywords hinter einer Traffic-Änderung, trenne gebrandmarkt von nicht gebrandmarkt und prüfe jede Änderung gegen einen benannten Treiber: neue Inhalte, verbesserte Rankings, Saisonalität, eine Migration oder ein Datenartefakt. Die Antwort sind der Treiber und das Konfidenzniveau. Eine große Zahl mit niedriger Konfidenz ist ein Grund, genauer hinzuschauen, nicht zu reagieren.
Interne Verlinkung und verwaiste Seiten. Baue einen Kandidatenpool aus Seiten, die bereits ranken oder Links erhalten, finde Passagen, die direkt mit jedem Ziel zusammenhängen, und wende einen Leserwert-Test an: Würde jemand mitten in diesem Satz wirklich dorthin wollen? Die strukturelle Hälfte des Ergebnisses ist oft mehr wert als die Links selbst. Herauszufinden, dass auf die zweitgrößte Seite kein interner Link zeigt, ist ein Fünf-Minuten-Fix mit unverhältnismäßiger Wirkung.
Zuordnung von Zitatlücken. Gruppiere Prompts nach Thema und Kaufphase, finde die meistzitierten Domains und Seiten, trenne die Quellentypen und lies die zitierten Seiten, um abzuleiten, was tatsächlich eine Erwähnung einbringen würde. Rechne damit, dass ein guter Teil der Ausgabe aus Quellen besteht, bei denen die richtige Antwort lautet, gar nicht erst Kontakt aufzunehmen. Foren und Wettbewerber-eigene Ressourcen sind keine Outreach-Ziele.
Regressionsprüfung nach einem Release. Vergleiche einen Crawl vor dem Release mit einem danach bei identischen Einstellungen, bestätige die Vergleichbarkeit, bevor du irgendetwas differenzierst, und klassifiziere jede Abweichung als erwartet, erwartet aber falsch umgesetzt oder ungeplant. Diese Klassifizierung macht den Bericht nutzbar. Ohne sie bleibt eine Wand aus Abweichungen und keine Entscheidung.
Zu den häufigsten haben wir ausführlichere Anleitungen: wöchentliche Ranking-Berichte, tägliches Monitoring, Arbeit am Backlink-Profil und Alert-Design, das dich nicht überflutet.
Fang mit einem Skill an, nicht mit einer Abteilung
Der häufigste Fehler ist, acht Skills, sieben Verbindungen und einen Scheduler aufzubauen, bevor irgendetwas einmal gelaufen ist. Dann funktioniert nichts, und es ist unklar, welches der sechzehn Teile schuld ist.
Mach es stattdessen in dieser Reihenfolge.
Wähle eine Aufgabe mit sichtbarem Ergebnis. Am schnellsten zu validieren ist die Triage technischer Probleme, weil du sie auf einen vorhandenen Crawl richten und das Ergebnis in Minuten beurteilen kannst. Content-Verfall ist am zweiteinfachsten, wenn du Verlauf in der Search Console hast.
Schreib den Skill, bevor du irgendetwas verbindest. Die Skill-Datei sollte auf eine Seite passen und sechs Fragen beantworten: wann sie einzusetzen ist, welche Daten sie braucht, die Reihenfolge der Schritte, die Bewertungs- oder Schwellenregeln, das Ausgabeformat und welche Aktionen eine Freigabe brauchen. Passt sie nicht auf eine Seite, ist die Aufgabe noch nicht klar genug definiert, um sie zu automatisieren.
Verbinde eine einzige Datenquelle. Die, die der Skill tatsächlich braucht. Verbindungen, die du nicht nutzt, vergrößern nur die Oberfläche, ohne Wert zu schaffen.
Führe sie im Nur-Lese-Modus aus und prüfe die Ausgabe von Hand. Nimm zwei Befunde und verifiziere sie selbst gegen die Quelldaten. Wenn die Erklärung des Agenten nicht zu dem passt, was du siehst, liegt das Problem im Skill, nicht im Modell.
Füge das Freigabe-Gate hinzu, bevor du den zweiten Skill hinzufügst. Jede Schreibaktion (veröffentlichen, weiterleiten, löschen, Code bearbeiten, mergen, extern senden) sollte anhalten und warten. Bau diese Gewohnheit auf, solange der Einsatz nur ein Skill ist.
Die Leitplanken, die es vor Fehlern bewahren
Das sind die Regeln, die wir am ersten Tag in die Projektanweisungen aufnehmen würden. Sie sind absichtlich langweilig, und das ist der Punkt.
- Halte Produktionswerkzeuge im Nur-Lese-Modus, bis du eine Schreibaktion freigibst.
- Verlange einen Plan, bevor ein mehrstufiger Workflow beginnt.
- Hol Evidenz mit verbundenen Werkzeugen, statt dich auf Annahmen zu verlassen.
- Folge dem zuständigen Skill, wenn einer existiert, statt zu improvisieren.
- Wiederhole einen fehlgeschlagenen Werkzeugaufruf einmal und zeige dann den Fehler, statt ihn zu umgehen.
- Verlange zu jedem Befund eine Begründung in einem Satz.
- Trenne bestätigte Befunde und Hypothesen direkt in der Ausgabe.
- Kennzeichne fehlende Daten und Schlussfolgerungen mit niedriger Konfidenz, statt die Lücke zu füllen.
- Stoppe, wenn der Workflow ein vereinbartes Limit für URLs, Zeilen oder API-Einheiten überschreitet.
- Frage vor Veröffentlichung, Weiterleitung, Löschung, Codeänderung, Merge oder externem Versand um Freigabe.
Zwei davon leisten mehr als der Rest. Bestätigte Befunde von Hypothesen zu trennen macht die Ausgabe verlässlich genug, um darauf zu handeln. Das Ausgabenlimit verhindert, dass eine falsch konfigurierte Schleife über Nacht das API-Budget verbrennt.
Wo es kaputtgeht
Dünne Conversion-Daten. Eine Entscheidungsmaschine für das Content-Portfolio, die jede URL als behalten, aktualisieren, konsolidieren, weiterleiten, entfernen oder untersuchen einordnet, braucht Conversion-Daten für die Entscheidung. Ist das Tracking nicht richtig eingerichtet, kommen viele Nullen zurück, und der Bericht ist unbrauchbar, bis das behoben ist. Der Agent hat seine Arbeit getan. Die Eingabe war falsch.
Strukturelles Urteil. Ein Agent kann vier Dinge finden, die ein menschliches Briefing übersehen hat, darunter ein Keyword, das eine völlig andere Art von Suchergebnis auslöst und deshalb nicht auf diese Seite gehört. Aber er kann nicht entscheiden, wie der Artikel aufgebaut wird. Diese Entscheidung bleibt bei einem Menschen, und das Gegenteil vorzugeben erzeugt Inhalte, die sich lesen, als wären sie aus Teilen zusammengesetzt.
Stille Erklärungsfehler. Agenten scheitern laut im Datenschritt und leise im Erklärungsschritt. Ein fehlender Export wirft einen Fehler. Eine selbstsichere falsche Ursache nicht. Deshalb ist die Regel mit der Evidenz pro Befund wichtiger, als sie aussieht.
Werkzeuglücken, die du nicht eingeplant hast. Manche Daten sind über eine Verbindung schlicht nicht erreichbar. Eine Ranking-Datenverbindung kann möglicherweise kein Crawl-Projekt anlegen, keinen Crawl auslösen oder den vollständigen Satz gecrawlter URLs exportieren. Plane den Workflow um das herum, was die Verbindung tatsächlich zurückgeben kann, sonst bleibt der Skill auf halbem Weg stecken.
Prüfe das Ergebnis, bevor du der Schleife vertraust
Führe diese Prüfung die ersten drei Male durch, danach einmal im Monat.
- Wähle zwei Befunde zufällig aus und verifiziere sie von Hand gegen die Quelldaten.
- Bestätige, dass der Agent zu jeder datenabhängigen Aussage Quelle und Datum genannt hat.
- Prüfe, ob mindestens ein Befund als niedrig-konfident gekennzeichnet ist. Ein Agent, der sich bei allem sicher ist, unterscheidet nicht.
- Bestätige, dass die Form der Ausgabe mit dem vorherigen Lauf übereinstimmt. Ist sie abgedriftet, hat sich die Skill-Datei geändert oder der Agent folgt ihr nicht mehr.
- Bestätige, dass nichts geschrieben, veröffentlicht oder gesendet wurde, ohne dass ein Freigabe-Gate ausgelöst wurde.
Wenn alle fünf drei Läufe hintereinander bestehen, hast du einen Workflow. Wenn etwas durchfällt, repariere die Schicht, die es verursacht hat, statt den Prompt umzuschreiben.
Häufige Fragen
Was ist agentisches SEO? Agentisches SEO bedeutet, einen definierten SEO-Workflow an einen KI-Agenten zu übergeben, der seine eigenen Daten abruft, einer schriftlichen Methode folgt und bei jedem Lauf eine gleich geformte Analyse zurückgibt. Das entscheidende Merkmal ist nicht Autonomie, sondern Wiederholbarkeit: Die Methode lebt außerhalb des Gesprächs, sodass dieselben Prüfungen greifen, ob du daran gedacht hast, sie anzufordern, oder nicht.
Wie unterscheidet es sich von KI-gestütztem SEO? Der Unterschied liegt darin, wer entscheidet, was als Nächstes passiert. Bei KI-gestütztem SEO wählst du die Schritte in jedem Gespräch und fügst die Daten ein. Bei agentischem SEO definierst du die Methode einmal, der Agent ruft seine eigenen Daten ab und folgt bei unerwarteter Eingabe einer dokumentierten Regel. Workflow-Automatisierung ist ein drittes: perfekte Konsistenz ohne Anpassungsfähigkeit.
Brauche ich einen Coding-Agenten dafür? Nein. Coding-Agenten wie Codex und Claude Code passen besser, wenn die Behebung eine Codeänderung ist oder die Website in einem Repository liegt. Besteht deine Arbeit überwiegend aus Exporten, Analysen und Urteilsvermögen, deckt ein skill-basierter Agent das ab, ohne ein Terminal zu berühren.
Wie viele Skills sollte ich zuerst bauen? Einen. Wähle eine Aufgabe mit sichtbarem Ergebnis, schreib den Skill so, dass er auf eine Seite passt, verbinde nur die Datenquelle, die er braucht, und lass ihn im Nur-Lese-Modus laufen, bis die Ausgabe verlässlich ist. Teams, die acht Skills bauen, ohne einen einzigen ausgeführt zu haben, geben das Projekt meist auf.
Kann ein agentischer SEO-Workflow Inhalte selbst veröffentlichen? Er kann, und er sollte nicht. Halte Veröffentlichung, Weiterleitungen, Löschung, Codeänderungen, Merges und externe Nachrichten hinter einem expliziten Freigabe-Gate. Der Wert des Workflows liegt in der Evidenz, die er zusammenträgt, nicht in der Berechtigung, die er hat.
Was kostet der Betrieb? Das hängt von den Datenquellen ab, nicht vom Agenten. Search Console ist für die eigene Domain kostenlos. Die laufenden Kosten entstehen bei Ranking-Daten, SERP-Daten und Crawling-Diensten, und die meisten haben kostenlose Tarife, die ausreichen, um einen Workflow zu validieren, bevor du dich festlegst.
Autor: Aaron Wolfe, Designer für organische Wachstumssysteme bei Auspia mit 15 Jahren Erfahrung in SEO/GEO. Er schreibt darüber, wie Teams KI-Agenten, Daten und Prüfschritte in Such-Workflows integrieren, die einen Quartalsplanungszyklus überstehen.