Was am Ende dabei herauskommt
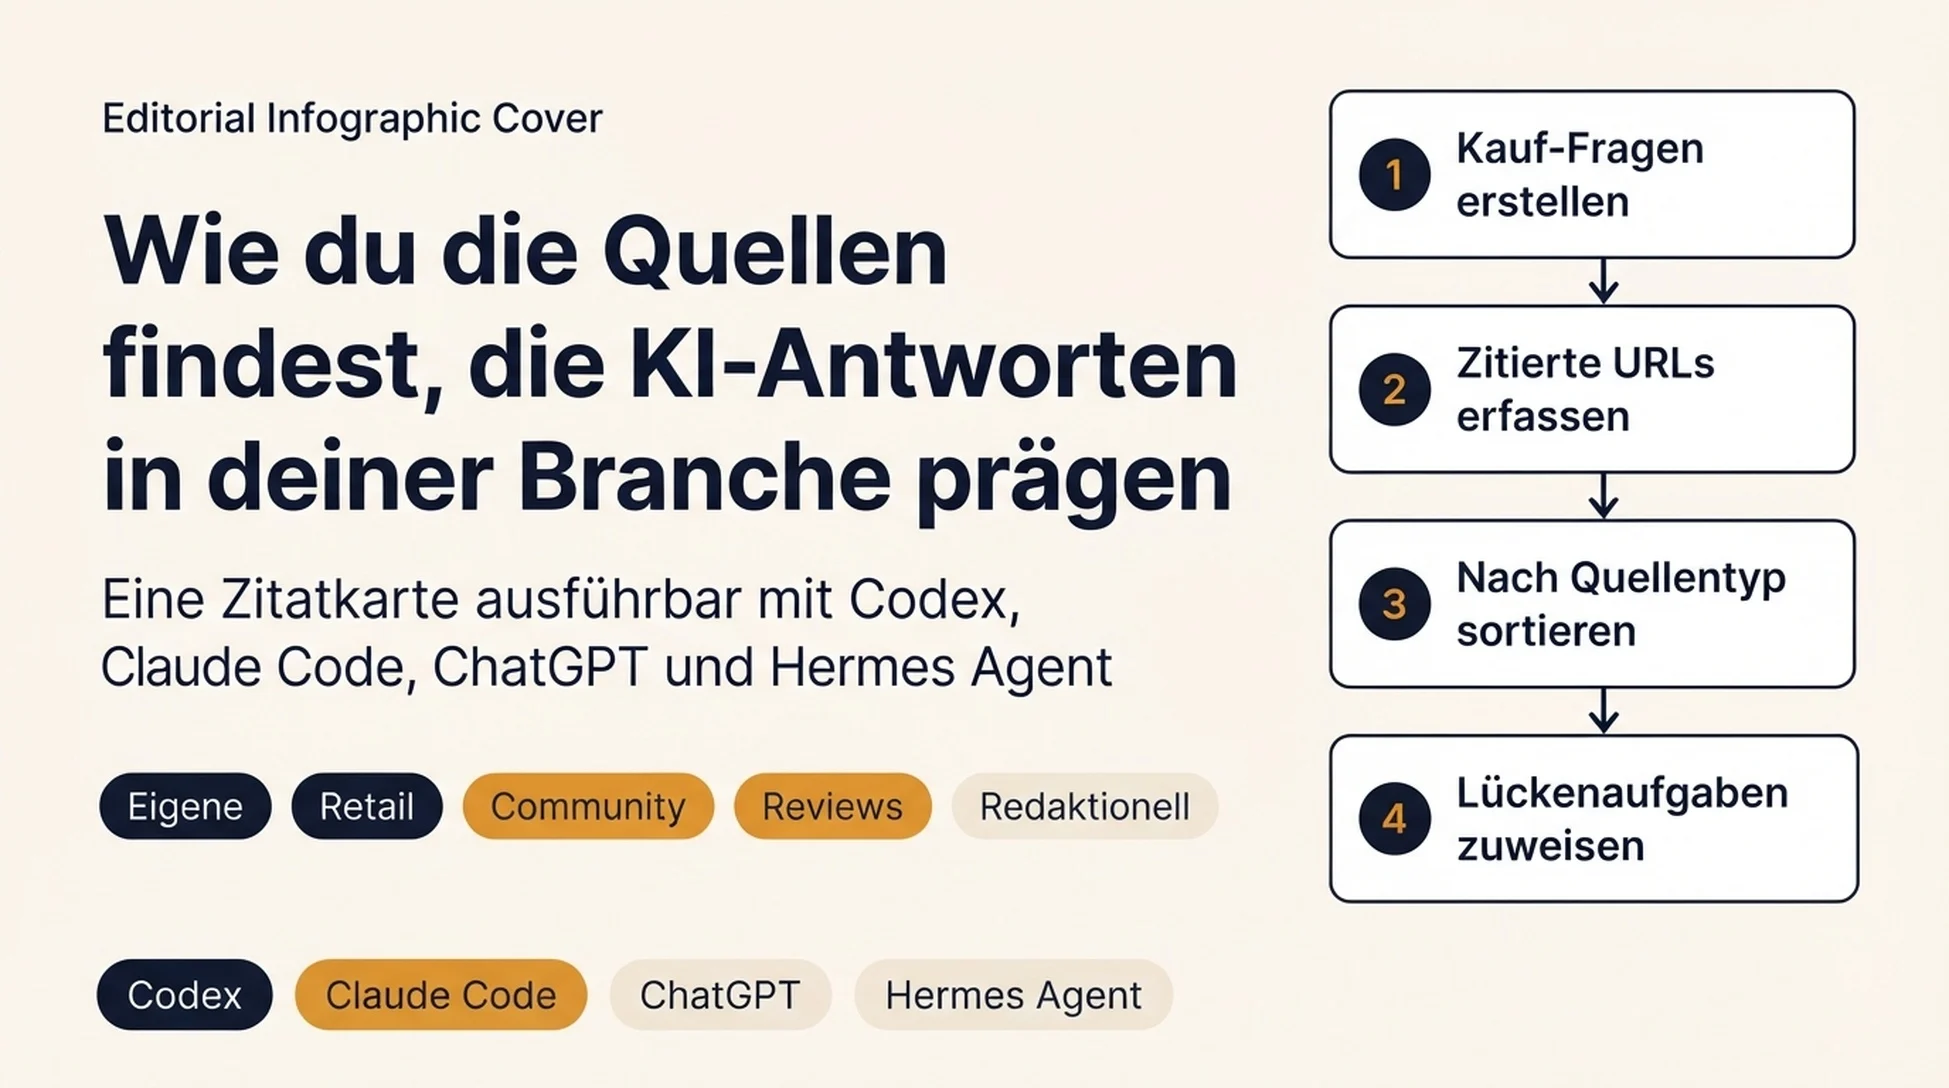
Eine Zitatkarte ist eine Aufzeichnung der Seiten, die eine KI-Engine tatsächlich herangezogen hat, als sie die Fragen deiner Kaufinteressenten beantwortet hat. Nicht, ob deine Marke in der Antwort auftauchte. Sondern aus welchen Quellen die Antwort zusammengesetzt wurde.
Ich habe das in genug Kategorien durchlaufen, um zu wissen, dass das erste Ergebnis meistens ernüchternd ist. Teams gehen davon aus, dass die eigene Website diese Antworten trägt. Häufig tut sie das nicht. In einer B2B-Kategorie machten die Seiten des Anbieters selbst nur einen Bruchteil aus, während eine Review-Seite, die niemand beansprucht hatte, den Großteil der Arbeit leistete.
Genau darum geht es hier. Du hörst auf zu raten und fängst an, die tatsächlichen Seiten anzusehen.
Am Ende dieses Durchlaufs hast du:
- 10 bis 20 echte Kauf-Fragen für eine Produkt- oder Servicekategorie, formuliert in der Sprache des Kunden
- Jede Frage in den KI-Engines ausgeführt, die deine Käufer wirklich nutzen, mit den zitierten Quellen datiert festgehalten
- Diese Quellen nach Typ sortiert, sodass du siehst, woher die Antworten deiner Kategorie kommen
- Eine kurze Liste von Seiten, auf denen ein Wettbewerber zitiert wird und du nicht, jeweils mit einem legitimen nächsten Schritt
- Verantwortliche und ein Überprüfungsdatum, damit die Karte nicht in einem geteilten Laufwerk verrottet
Für wen das gedacht ist: eine interne SEO-, GEO- oder Content-Verantwortliche bzw. ein Agentur-Strategie, der Empfehlungen aussprechen kann, auch wenn jemand anderes umsetzt. Ein kostenpflichtiges Tool ist nicht nötig, hilft aber bei größerem Umfang.
Voraussetzungen: ein Browser, eine Tabellenkalkulation und Lesezugriff auf die eigene Website. Für die Agent-Varianten eine funktionierende Installation des gewählten Agenten und einen Ordner, auf den du ihn richten kannst.
Zeitaufwand: etwa zwei Stunden für den ersten Durchlauf in einer Kategorie. Etwa 45 Minuten davon sind Prompt-Ausführung und Quellen kopieren. Genau diese 45 Minuten lohnen sich, an einen Agenten abzugeben, und der Rest ist der Teil, der dein Urteilsvermögen braucht.
Was fertig bedeutet: Du kannst die drei oder vier Quellentypen benennen, die die Antworten in deiner Kategorie tragen, konkrete Seiten zeigen, auf denen du fehlst und ein Wettbewerber präsent ist, und jemandem eine Aufgabe mit angehängter URL übergeben. Wenn du nur eine Domainliste und das vage Gefühl hast, dass Reddit wichtig ist, bist du nicht fertig.
Auspia-Sicht: Die meisten Teams gehen direkt zu "wir brauchen mehr Markennennungen", weil sie nie angeschaut haben, woraus die Antwort tatsächlich zusammengesetzt wurde. Die Karte verwandelt dieses vage Gefühl in eine Seite, auf der man handeln kann.
Bevor du anfängst: die zwei Entscheidungen, die alles prägen
Zwei Entscheidungen bestimmen, was der Rest produziert. Beide sind leicht falsch zu treffen und beide sind hinterher lästig zu korrigieren.
Wähle eine Kategorie, nicht dein ganzes Geschäft. Ein Unternehmen, das Software verkauft und zusätzlich ein Servicegeschäft betreibt, hat zwei verschiedene Quellen-Ökosysteme. Beide gleichzeitig zu kartieren ergibt einen Durchschnitt, der keines von beiden beschreibt. Nimm die Kategorie mit dem höchsten Umsatzanteil und verschiebe den Rest auf das nächste Quartal.
Wähle die Engines bewusst. Google AI Overview, ChatGPT, Perplexity und Gemini schöpfen nicht aus demselben Pool. Eine Quelle, die in einer Engine an Gewicht verloren hat, kann in einer anderen weiter zählen. Führe mindestens zwei aus. Wenn du nicht weißt, welche zwei, frag das Vertriebsteam, welche Oberfläche Kunden erwähnen, oder prüfe deinen Referral-Traffic aus KI-Domains.
Zieh jetzt eine Grenze. Das ist eine Beobachtungsübung, keine Beweisübung. Du hältst fest, was eine Engine an einem bestimmten Tag zurückgegeben hat. Antworten schwanken zwischen Durchläufen, also ist eine einzelne Beobachtung ein Datenpunkt, kein Trend. Datier alles, sonst ist die ganze Datei nach einem Monat unbrauchbar.
Schritt 1: das Fragenset aufbauen
Schreib 10 bis 20 Fragen auf, die ein Kunde bei der Auswahl stellen würde. Keine Keywords. Fragen, in den Worten des Kunden.
Das ist der Schritt, den die Leute überstürzen, und es ist der Schritt, der entscheidet, ob der Rest die Mühe wert ist. Ein Fragenset aus Keyword-Exporten ergibt eine Karte davon, wie Menschen suchen. Ein Fragenset aus Vertriebsnotizen ergibt eine Karte davon, wie Menschen kaufen. Das sind nicht dieselben Listen.
Material, aus dem du Fragen ziehen kannst:
- Die häufigsten Vor-Kauf-Fragen, die dein Vertriebsteam bekommt
- Support-Tickets aus den ersten 30 Tagen nach dem Kauf
- Der Block "andere fragen auch" bei deinen wichtigsten kommerziellen Suchanfragen
- Deine eigene Keyword-Recherche, in Frageform umgeschrieben
- Wettbewerbsvergleiche, die deine Käufer suchen
Misch die Frageformen, denn jede zieht andere Quellen.
Frageform | Beispiel | Quellen, die sie meist zutage bringt |
|---|---|---|
Kategorie-Passung | "Worauf sollte ein mittelgroßes Logistikunternehmen bei einem Routing-Tool achten?" | Redaktionelle Listen, Review-Seiten |
Direktvergleich | "Tool A oder Tool B für ein 20-köpfiges Team?" | Vergleichsseiten, Community-Threads |
Risiko und Einwand | "Ist Tool A wirklich sicher genug für Gesundheitsdaten?" | Foren, Compliance-Analysen, Anbieter-Dokumentation |
Preis und Wert | "Was kostet Tool A wirklich pro Seat?" | Preisseiten, Community-Threads, Review-Seiten |
Implementierung | "Wie lange dauert die Migration von Tool B?" | Dokumentation, YouTube-Tutorials, Foren |
Erwartetes Ergebnis: eine Tabelle mit einer Zeile pro Frage, einer Spalte für die Frageform und einer Spalte für die Engine, in der du sie ausführen wirst.
Qualitätsprüfung: Lies die Liste noch einmal und frag dich, ob ein echter Käufer das so eintippen würde. Wenn eine Frage nur für jemanden Sinn ergibt, der deine Produkttaxonomie schon kennt, schreib sie um. Zehn Fragen, die ein Käufer wirklich stellt, schlagen fünfzig, die wie ein Keyword-Export klingen.
Wiederherstellungspfad: Wenn du nicht auf zehn Fragen kommst, hast du ein Rechercheproblem, kein Kartierungsproblem. Zieh die letzten 20 Vertriebsnotizen oder die letzten 50 Support-Tickets heran und extrahiere daraus Fragen, bevor du weitermachst.
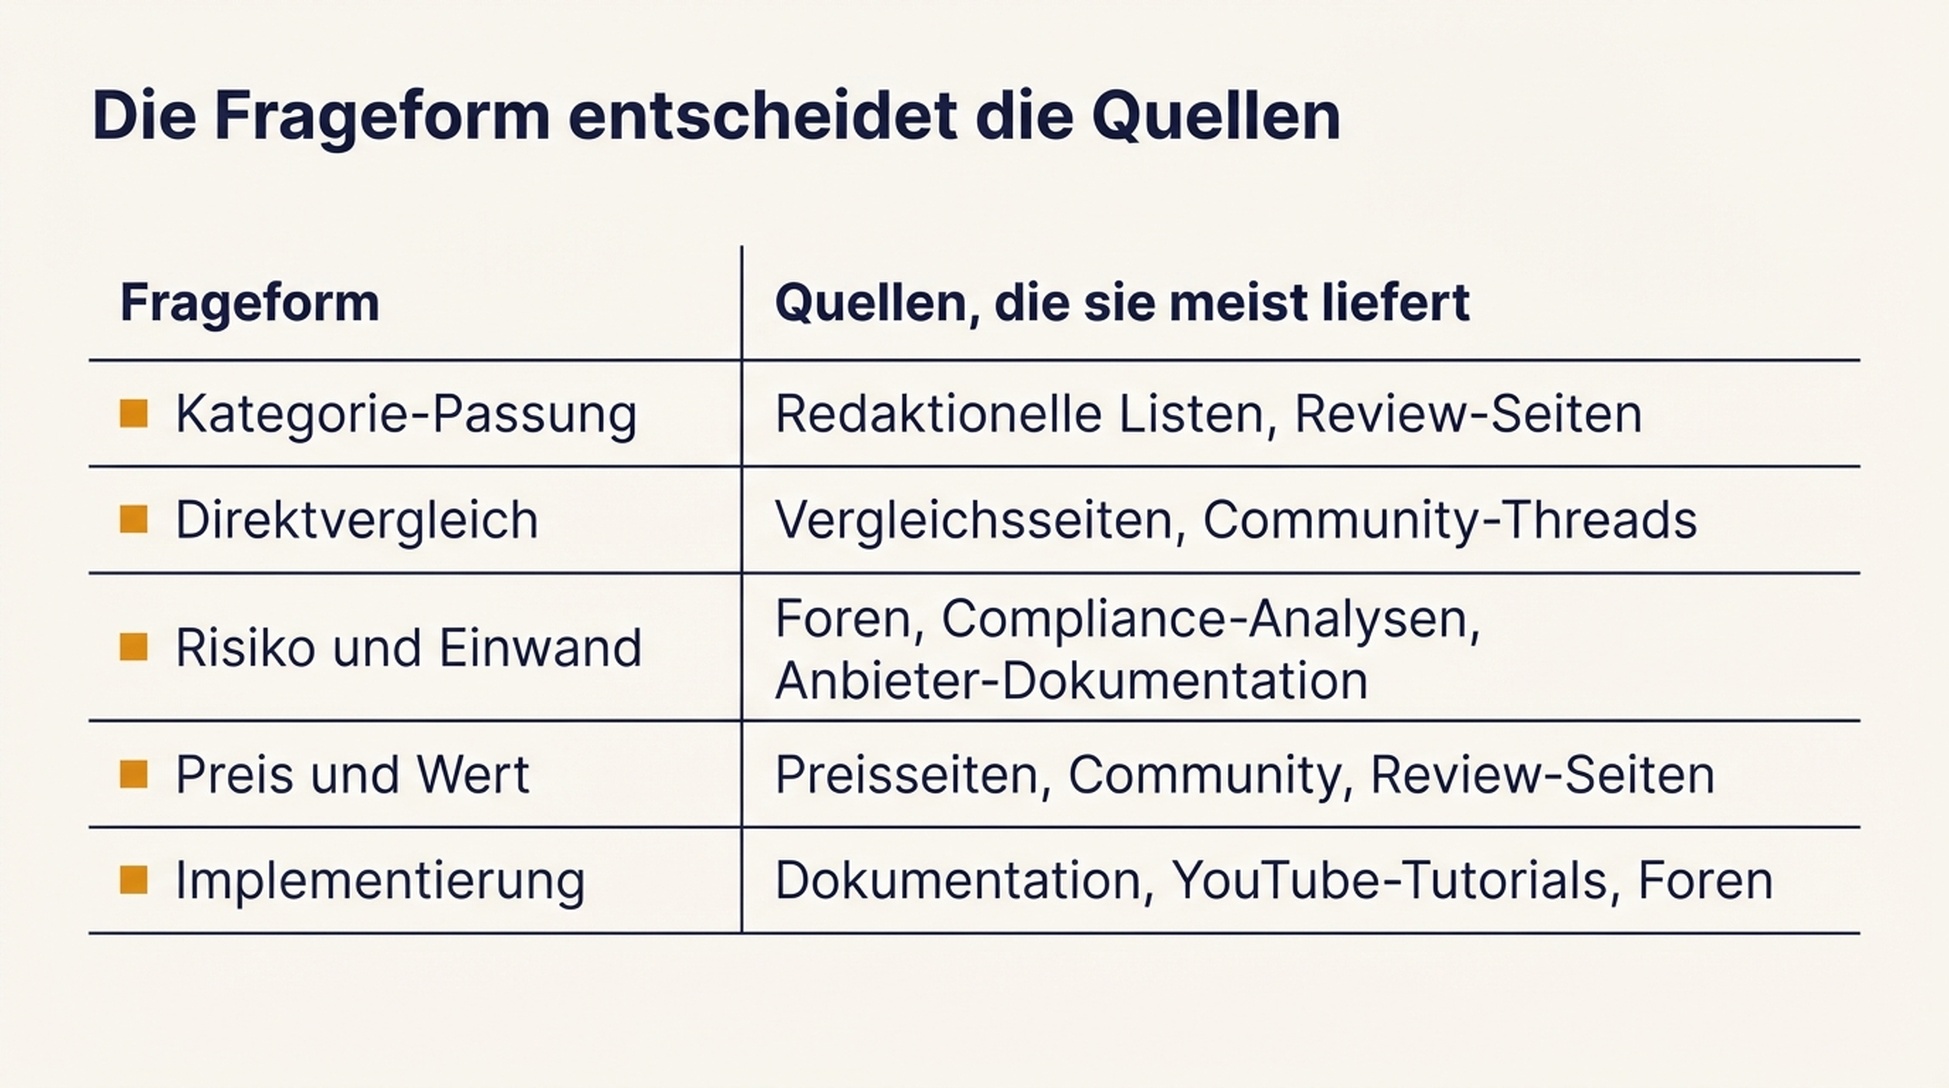
Die Frageform ist die versteckte Variable. Eine Direktvergleichsfrage und eine Risikofrage zum selben Produkt liefern nicht dieselben Quellen.
Schritt 2: die Fragen ausführen und die Quellen erfassen
Hier liegt der mechanische Kern, und hier bricht Handarbeit zusammen. Mach fünf Fragen von Hand, damit du verstehst, wie das Ergebnis aussehen soll. Danach automatisierst du den Rest.
Für jede Frage, in jeder Engine:
- Starte eine neue Unterhaltung. Vorheriger Kontext verändert, was die Engine abruft.
- Stelle die Frage genau so, wie du sie aufgeschrieben hast.
- Öffne das Zitat-Panel oder die Quellenliste. In den meisten Engines ist das ein kleines Symbol neben der Antwort, keine sichtbare Liste.
- Erfasse jede zitierte URL, dazu die Domain und den Quellentyp.
- Notiere Datum, Engine und ob die Antwort überhaupt etwas zitiert hat.
Erfasse in dieser Struktur:
Feld | Warum es zählt |
|---|---|
Frage-ID | Verbindet jede Beobachtung mit der Kauf-Frage |
Engine | Erlaubt später die Trennung nach Engine-Mustern |
Datum und Uhrzeit | Antworten driften; eine undatierte Zeile ist nach einem Monat unbrauchbar |
Zitierte URL | Die tatsächliche Seite, nicht nur die Domain |
Domain | Für Gruppierung und Häufigkeitszählung |
Quellentyp | eigene, Retail/Marktplatz, Community, Review-Verzeichnis, redaktionell |
Wettbewerber vorhanden | Ja/nein, und welcher |
Unsere Marke vorhanden | In der Antwort, in den Quellen, in beidem oder in keinem |
Die letzte Zeile verdient einen Moment. Eine Marke kann in der Antwort genannt werden, ohne dass eine ihrer Seiten zitiert wird. Sie kann auch zitiert werden, ohne prominent genannt zu werden. Das sind zwei verschiedene Signale, und wenn du nur "sind wir aufgetaucht?" verfolgst, liest du beide falsch. Ich habe Teams erlebt, die eine Nennung gefeiert haben, die von einer Seite stammte, die gegen sie argumentierte.
Erwartetes Ergebnis: eine lange Tabelle, eine Zeile pro zitierter Quelle, pro Frage und pro Engine.
Qualitätsprüfung: Klick dich bei mindestens drei Zeilen durch und bestätige, dass die zitierte Seite die Aussage, für die sie zitiert wurde, tatsächlich stützt. Engines zitieren gelegentlich eine Seite, die das Thema erwähnt, ohne die Frage zu beantworten. Solche Zeilen sind Rauschen und sollten markiert werden.
Wiederherstellungspfad: Wenn eine Engine zu einer Frage keine Zitate liefert, ist das ein Befund, kein Fehler. Erfasse es als null Quellen und mach weiter. Fragen, die ohne Abruf beantwortet werden, sind Fragen, die dein eigener Content nicht beeinflussen kann.
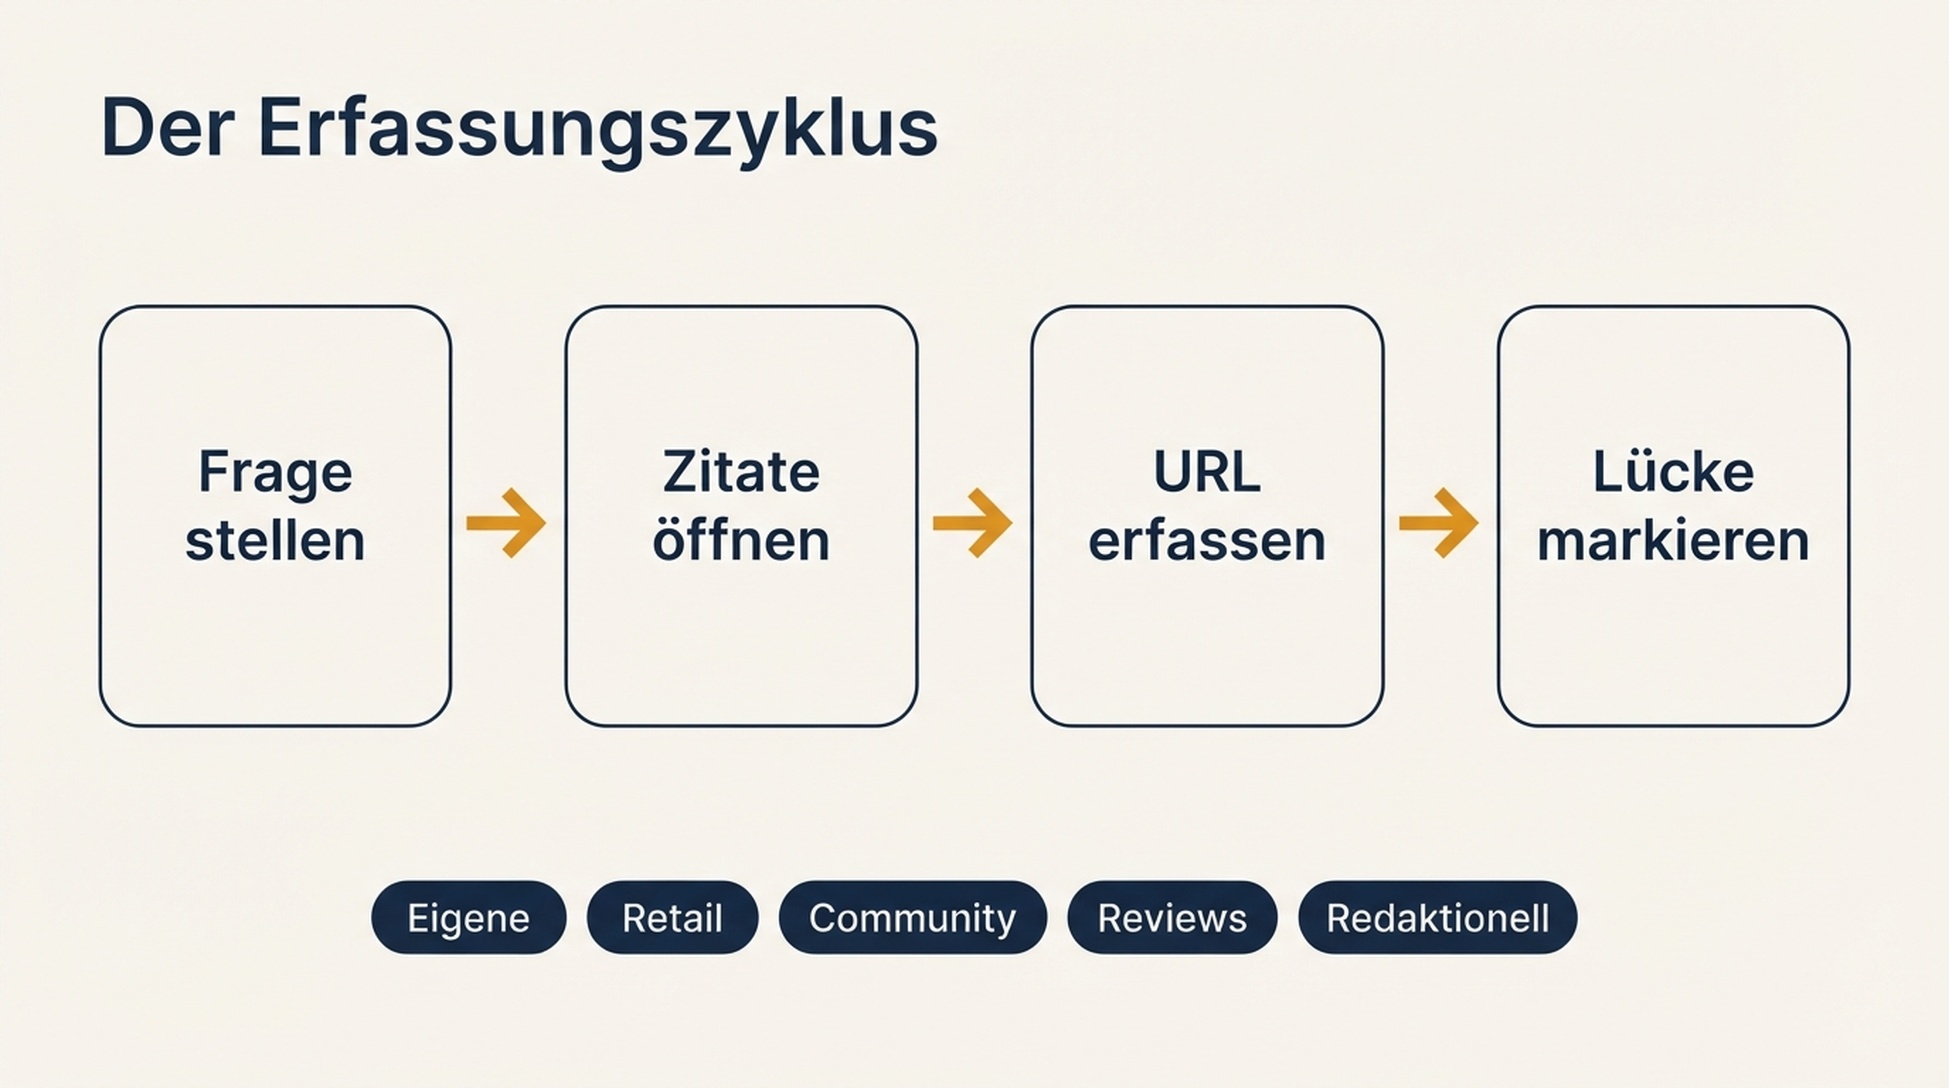
Der Zyklus ist einfach und mühsam. Genau diese Kombination macht ihn zu einem guten Kandidaten für einen Agenten.
Schritt 3: die Quellen nach Typ sortieren
Jetzt faltest du die lange Tabelle zu einem Bild deiner Kategorie zusammen. Ordne jede zitierte URL einem von fünf Eimern zu:
- Eigene: deine Website oder die eines Wettbewerbers
- Retail und Marktplatz: Produktlistings, Preisvergleichsseiten, App-Stores
- Community und UGC: Reddit, YouTube, Quora, Foren, indexierte Discord-Threads
- Review-Verzeichnisse und B2B-Plattformen: G2, Capterra, Clutch, Trustpilot, branchenspezifische Verzeichnisse
- Unabhängig redaktionell und Referenz: Fachpresse, News, Wikipedia, Analysten-Analysen, unabhängige Blogs
Zähl pro Eimer und pro Engine, und du hast deine Zitatkarte.
Was du suchst, ist keine einzelne Zahl. Es ist die Form. Manche Kategorien werden fast vollständig von Community-Threads und Fachpresse getragen, und die eigene Website der Marke spielt kaum eine Rolle. Andere werden von Produktlistings dominiert, weil das Listing selbst die Antwort enthält. Diese Mischung folgt daraus, was Käufer fragen, nicht daraus, wie gut irgendjemandes Website ist. Das ist schwer zu akzeptieren, wenn du zwei Jahre in die Website gesteckt hast.
Erwartetes Ergebnis: eine kleine Tabelle, eine Zeile pro Quellentyp, eine Spalte pro Engine, mit dem Anteil der zitierten Quellen.
Qualitätsprüfung: Wenn ein Eimer mehr als etwa 70% deiner Zitate hält, prüf fünf URLs darin, ob sie wirklich von diesem Typ sind. Ein trafficstarker Aggregator kann sich als redaktionelle Quelle verkleiden, während er tatsächlich ein Verzeichnis ist.
Wiederherstellungspfad: Wenn die Zahlen zufällig wirken, hast du wahrscheinlich Frageformen gemischt und damit das Muster verdeckt. Teile die Tabelle nach Frageform und schau noch einmal. Preisfragen und Risikofragen haben oft völlig unterschiedliche Quellenprofile.
Schritt 4: die Lücken finden, in denen ein Wettbewerber zitiert wird und du nicht
Filtere die lange Tabelle auf Zeilen, in denen ein Wettbewerber auftaucht und deine Marke nicht. Diese gefilterte Liste ist deine Arbeitsliste. Sie ist weit nützlicher als ein allgemeines Mandat "wir brauchen mehr Nennungen", weil jede Zeile schon eine URL und eine Kundenfrage trägt. Gib sie jemandem am Montag, und die Person kann anfangen.
Für jede Zeile: öffne die zitierte Seite und beantworte drei Fragen:
- Gehört unser Produkt wirklich auf diese Seite?
- Wenn ja, was fehlt – ein Listing, das wir nie beansprucht haben, ein Vergleich, in dem wir fehlen, ein Thread, in dem uns niemand erwähnt hat, eine Bewertung, um die wir nie gebeten haben?
- Was ist die kleinste legitime Handlung, die uns dorthin bringt?
Die dritte Frage ist die Stelle, an der Disziplin zählt. Die Handlung unterscheidet sich je Eimer. Hier etwas falsch zu machen bedeutet, dass ein SEO anfängt, Journalisten Kaltakquise zu einem Reddit-Thread zu schicken.
Quellentyp | Legitime Handlung | Was man nicht tun sollte |
|---|---|---|
Review-Verzeichnis | Profil beanspruchen und vervollständigen, Kunden um Bewertungen bitten | Bewertungen kaufen oder gefälschte einschleusen |
Community-Thread | Als namentlich genannter Mitarbeiter ehrlich antworten und die Zugehörigkeit offenlegen | Astroturfing oder einen Link ohne Beitrag abwerfen |
Redaktionell | Einen wirklich nützlichen Blickwinkel anbieten, den das Medium noch nicht behandelt hat | Dieselbe Pressemitteilung an 200 Domains schicken |
Marktplatz oder Retail-Listing | Spezifikationen, Bilder und Beschreibung so korrigieren, dass die Fakten abrufbar sind | Das Listing mit Keywords vollstopfen |
Eigene Seite | Umstrukturieren, damit die konkrete Tatsache leicht zu finden und zu zitieren ist | Einen FAQ-Block anfügen, der nichts beantwortet |
Erwartetes Ergebnis: eine gefilterte, priorisierte Liste. Sortiere nach der Häufigkeit, mit der die Quelle in deinem Fragenset auftaucht, nicht danach, wie renommiert die Domain klingt. Ein Foren-Thread, der in sechs deiner zwanzig Fragen zitiert wird, steht vor einer einmal zitierten Fachpublikation – und ist obendrein viel leichter anzugehen.
Qualitätsprüfung: Bestätige für jede Zeile, die du behältst, dass du die zugehörige Kundenfrage benennen kannst. Wenn nicht, streich die Zeile. Seiten, die für Fragen zitiert werden, die niemand in deiner Pipeline stellt, lenken nur ab.
Wiederherstellungspfad: Wenn die gefilterte Liste immer noch riesig ist, hast du nicht hart genug gefiltert. Begrenze den ersten Durchlauf auf zehn Zeilen, sortiert nach Zitathäufigkeit, und arbeite die ab, bevor du die vollständige Liste wieder öffnest.
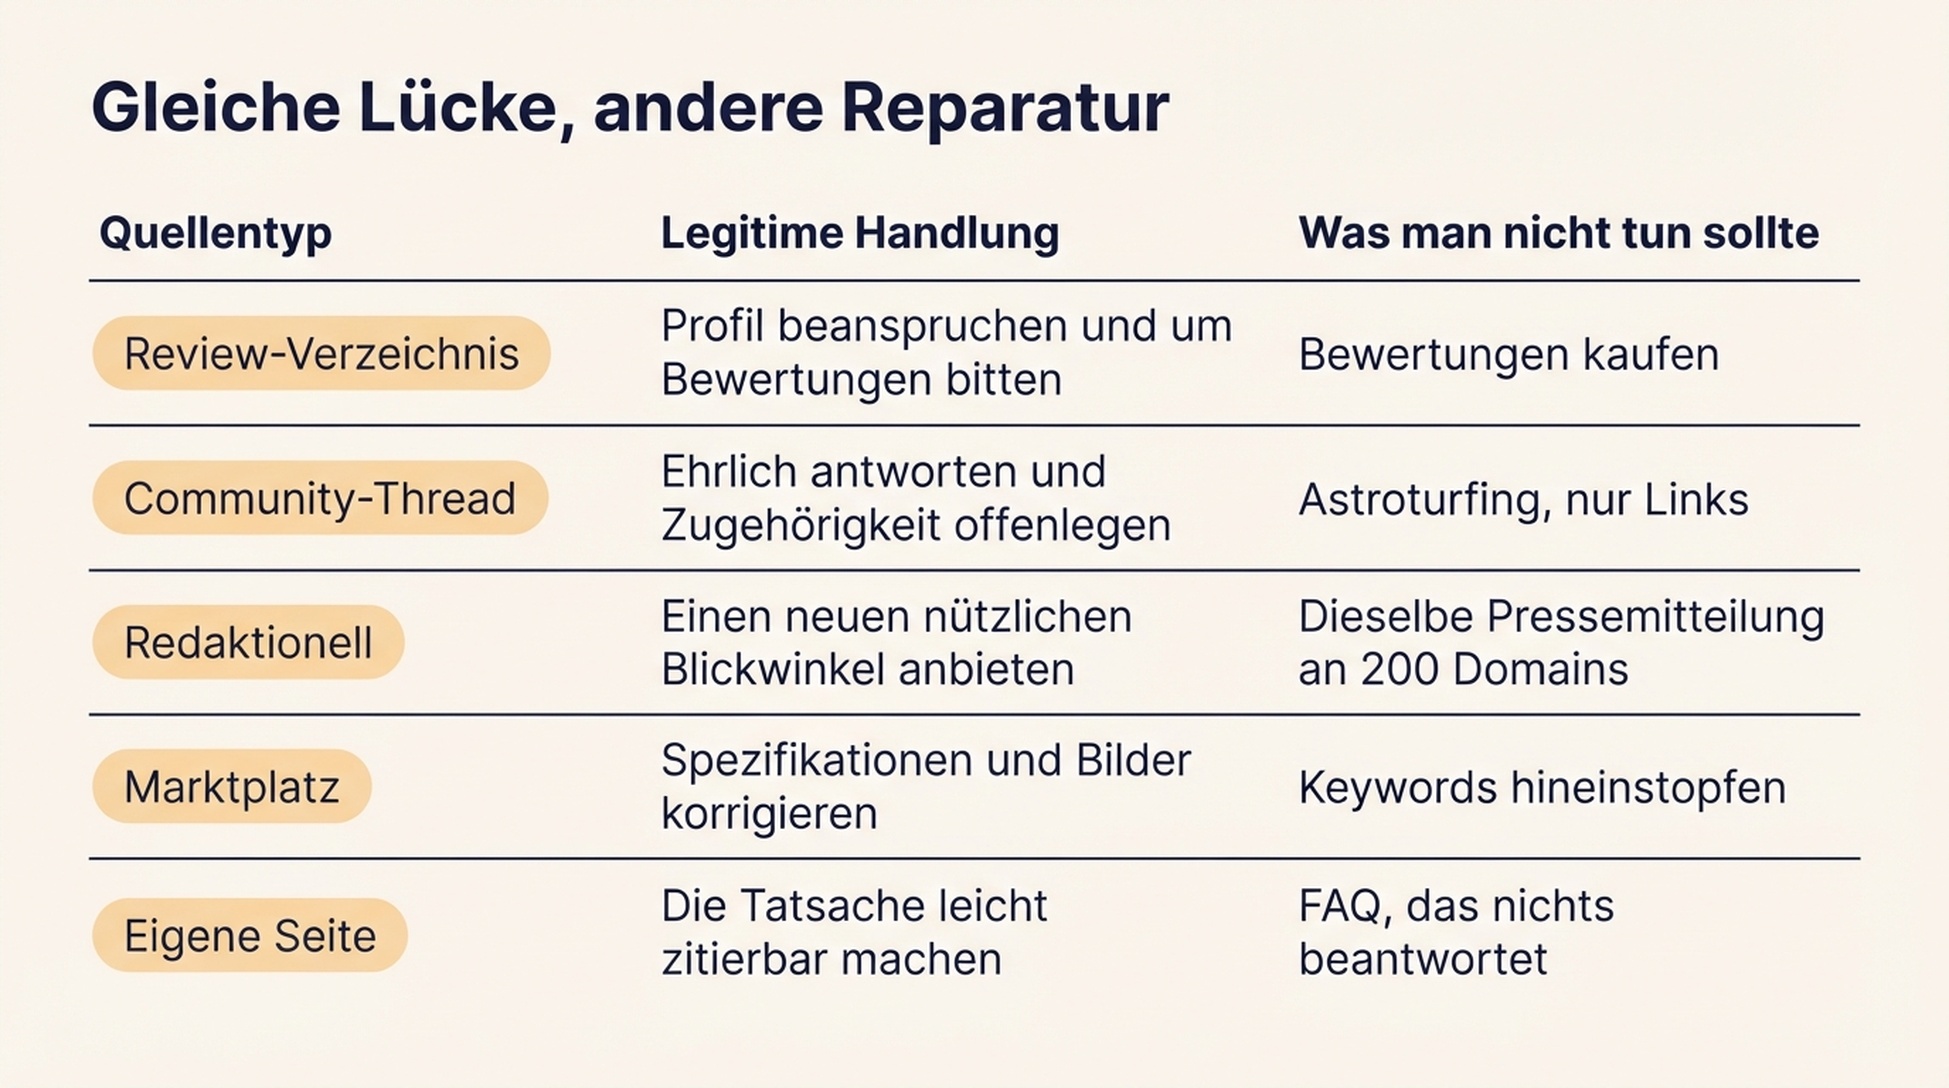
Gleiche Lücke, andere Reparatur. Jede fehlende Zitierung als Outreach-Problem zu behandeln, ist der Weg, auf dem Teams einem Redakteur einen Reddit-Thread verkaufen wollen.
Schritt 5: die mechanische Hälfte an einen Agenten übergeben
Schritt 2 und 3 kosten am meisten Zeit und brauchen am wenigsten Urteilsvermögen. Das ist die Definition von Arbeit, die sich delegieren lässt. Das Fragenset und die Priorisierung bleiben bei einer Person, denn das sind die zwei Stellen, an denen eine falsche Entscheidung die ganze Übung wertlos macht.
Die vier Agenten unten können alle dieselbe Methode ausführen. Was sich ändert, ist, wo die Methode lebt und wie das Ergebnis zurückkommt. Wähle danach, nicht danach, welches Modell diesen Monat einen Benchmark gewinnt.
Codex
Ideal, wenn die Karte in einem Repository leben und bei jedem Durchlauf ein geprüftes Artefakt erzeugen soll. Wenn deine Website ohnehin in git liegt, ist das der Weg mit der geringsten Reibung.
Richte einen Projektordner ein mit einem citation-map/-Verzeichnis, einer questions.csv mit deinem Fragenset und einer SKILL.md, die die Methode festhält: welche Engines geprüft werden, welche Felder erfasst werden, wie eine Quelle klassifiziert wird und wie die Ausgabedatei aussehen soll. Halte eine Datei pro Durchlauf fest, nach Datum benannt, damit du Historie aufbaust statt zu überschreiben.
Lass Codex die Fragen ausführen, Zeilen an die aktuelle Durchlaufdatei anhängen und eine Übersichtstabelle zum Quellenanteil pro Engine erzeugen. Weil die Ausgabe eine Datei in einem Repository ist, bekommst du einen Diff, den du prüfen kannst, bevor irgendetwas als endgültig gilt. Dieser Prüfschritt ist der Punkt: Du kontrollierst die Klassifizierungen, statt die Erfassung neu zu machen.
Eine Regel gehört in jedem Fall in die SKILL.md: Der Agent erfasst, was er beobachtet hat, und leitet keine Zitierung ab, die er nicht gesehen hat. Erfundene Quellen sind der schädlichste Fehlermodus in diesem Workflow. Eine geschriebene Regel plus eine Stichprobe von drei Zeilen fängt das meiste ab, und die drei Zeilen, die du prüfst, sollten bei jedem Durchlauf wechseln.
Claude Code
Ideal, wenn die Methode gegen eine explizit geschriebene Richtlinie gelesen werden muss und du die erfassten Seiten mit langem Kontext prüfen willst.
Leg die Methode in einer CLAUDE.md oder einem Projekt-Skill ab, inklusive deiner Definitionen der Quellentypen und des exakten Ausgabeschemas. Richte Claude Code auf den Durchlauf-Ordner und lass jede zitierte URL klassifizieren und jede Zeile markieren, in der der Seiteninhalt die Zitierung nicht wirklich stützt.
Der zweite Job ist der, für den es sich zu zahlen lohnt. 200 zitierte Seiten zu lesen und zu beurteilen, ob jede die Frage wirklich beantwortet, ist für einen Menschen mühsam und für einen Agenten mit geschriebenem Standard vertretbar. Lass pro Zeile ein Konfidenz-Flag ausgeben und prüfe nur die Zeilen mit niedriger Konfidenz selbst.
ChatGPT
Ideal, wenn du die niedrigsten Einrichtungskosten willst und die Arbeit eine einzelne Sitzung ist statt eines wiederkehrenden Durchlaufs.
Füg die Methode als Custom Instruction oder gespeicherten Projekt-Prompt ein, häng deine Fragenliste an und arbeite sie in Batches pro Engine ab. Frag nach der Ausgabe als Tabelle mit exakt den Spalten aus Schritt 2, damit sie direkt in deine Tabellenkalkulation passt.
Der Haken: ChatGPT ist auch eine der Oberflächen, die du misst. Wenn du die Zitate von ChatGPT selbst kartierst, mach das in einer sauberen Sitzung ohne geladene Methode, sonst verfälschst du die Beobachtung. Nutz eine Sitzung zum Erfassen und eine andere zum Organisieren.
Hermes Agent
Ideal, wenn die Methode als Skill bestehen bleiben und sich über Durchläufe hinweg verbessern soll, ohne dass du sie neu erklärst.
Installier die Zitatkarten-Methode als Hermes-Skill mit Fragenset und Ausgabeschema und führe sie in einer Kadenz aus; monatlich ist meist richtig. Weil der Skill und sein Gedächtnis bestehen bleiben, tragen Korrekturen aus dem ersten Monat in den zweiten. Wenn der Agent ein Verzeichnis fälschlich als redaktionelle Quelle klassifiziert hat, korrigierst du die Regel einmal.
Der Preis dafür ist, dass persistentes Gedächtnis regelmäßige Prüfung braucht. Lies alle paar Durchläufe die Skill-Datei und prüf, ob die angesammelten Korrekturen noch die Methode beschreiben, die du willst, und nicht einen Haufen einmaliger Ausnahmen, die niemand erklären kann.
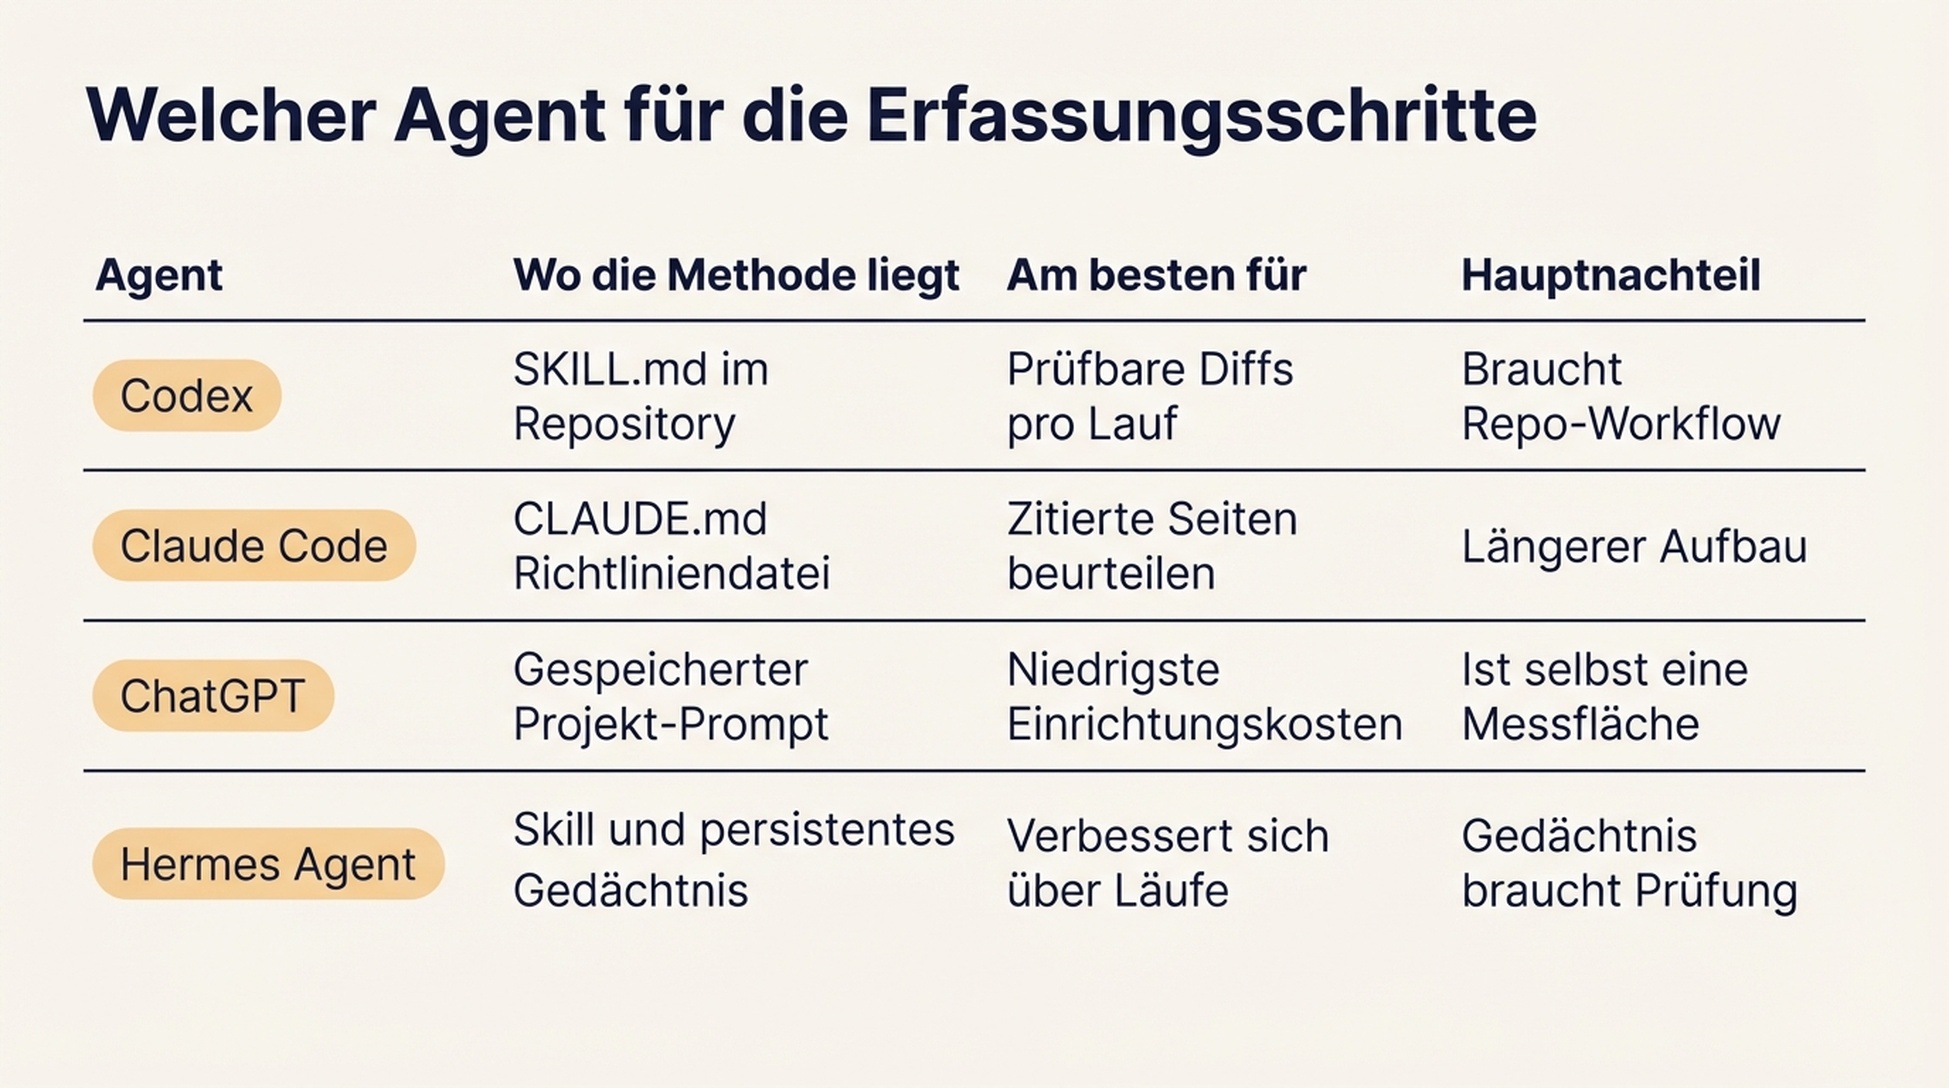
Alle vier führen dieselben fünf Schritte aus. Wähle danach, wo die Methode liegen soll, nicht danach, welches Modell im Benchmark am besten abschneidet.
Schritt 6: die Karte prüfen, bevor du danach handelst
Vergib keine Arbeit aufgrund einer ungeprüften Karte. Führ zuerst diese Prüfung aus. Fünf Minuten hier sparen ein Quartal in die falsche Richtung.
- Führ eine Woche später drei Fragen erneut aus. Wenn sich die Quellenmischung völlig ändert, ist dein Fragenset zu volatil oder deine Stichprobe zu klein. Erfasse die Schwankung, statt den ersten Durchlauf als Wahrheit zu behandeln. Etwas Schwankung ist normal; ein kompletter Austausch ist eine Warnung.
- Bestätige die Engine, nicht nur die Antwort. Eine Quelle, die in Perplexity auftaucht, kann bei derselben Frage in ChatGPT fehlen. Halt die Engine-Spalten im Resümee getrennt; eine zusammengefasste Summe verdeckt genau das Signal, das du brauchst.
- Prüf auch deine eigenen Zitierungen. Wenn deine Marke zitiert wird, öffne die Seite. Manchmal zitiert die Engine eine Seite, auf der du kritisch erwähnt wirst, oder eine, die du nicht kontrollierst. Das ist nützliche Information, kein Sieg.
- Bestätige das Datum in jeder Zeile. Eine undatierte Zitatkarte lässt sich später mit nichts vergleichen.
- Prüf die Quellenanzahl. Wenn eine Frage 40 Quellen zurückgibt und der Rest drei, prüf, ob du ein "Ähnliche"-Panel erfasst hast statt der tatsächlichen Zitate.
Was fertig bedeutet: Du kannst einer Kollegin die Übersichtstabelle und eine gefilterte Arbeitsliste geben, und sie kann handeln, ohne dich zu fragen, was eine Zeile bedeutet.
Die Karte pflegen
Führ den vollen Durchlauf quartalsweise mit demselben Fragenset aus und einen leichten Durchlauf monatlich zu den fünf Fragen mit dem höchsten kommerziellen Wert. Behalte die alten Durchläufe. Das interessante Signal ist selten der Schnappschuss. Es ist die Drift: ein Quellentyp, der leise wächst, oder ein Wettbewerber, der in einem Eimer auftaucht, in dem er vorher nicht war.
Überprüf das Fragenset zweimal im Jahr. Kauf-Fragen ändern sich mit deinem Produkt und deinem Markt, und ein veraltetes Fragenset erzeugt die Karte einer Kategorie, in der du nicht mehr verkaufst.
Eine Sache, der du widerstehen solltest: das in ein Dashboard zu verwandeln. Das Ergebnis ist eine Arbeitsliste mit Verantwortlichen und URLs. Wenn am Ende niemand eine Aufgabe hat, hat die Karte ihre Arbeit nicht getan.
FAQ
Brauche ich ein kostenpflichtiges KI-Sichtbarkeits-Tool dafür? Nein. Die manuelle Variante funktioniert für eine Kategorie und dauert einen halben Tag. Tools verdienen ihre Kosten, wenn du viele Kategorien oder Märkte verfolgst oder historische Trendlinien willst, ohne die Tabelle selbst zu pflegen.
Wie viele Fragen sind genug? 10 bis 20 pro Kategorie. Unter zehn kannst du ein Muster nicht von einem Zufall unterscheiden. Über zwanzig im ersten Durchlauf schaffst du die Analyse nicht, und die Analyse ist der Teil, der die Arbeitsliste erzeugt.
Sollte ich Fragen aufnehmen, bei denen wir schon auftauchen? Ja. Zu wissen, welche Quellen dich tragen, ist genauso nützlich wie zu wissen, welche dich verfehlen, und es sagt dir, was du schützen musst, wenn du deinen Content änderst.
Was, wenn die Engine bei jeder Frage eine andere Antwort gibt? Das ist normal und gehört erfasst. Führ dieselbe Frage dreimal aus und notier die Schwankung. Wenn das Quellenset jedes Mal völlig anders ist, behandle die Frage als unsicher und gib ihr bei der Priorisierung weniger Gewicht.
Kann ich einfach die Quellenliste der Engine nutzen, ohne die Seiten zu öffnen? Für die erste Erfassung ja. Für die Zeilen, bei denen du handeln willst, nein. Du musst die Seite lesen, um zu beurteilen, ob deine Marke dort wirklich hingehört und was ein nützlicher Beitrag wäre.
Worin unterscheidet sich das vom Ranking-Tracking? Ranking-Tracking sagt dir, wo deine Seiten in einer Ergebnisliste erscheinen. Eine Zitatkarte sagt dir, aus welchen Seiten eine Antwort zusammengesetzt wurde. Eine Seite kann auf Platz eins stehen und nie zitiert werden, und eine Seite, die nirgends rankt, kann das Rückgrat einer Antwort sein. Diese Lücke ist der Grund, warum sich ein halber Tag lohnt.
Autor: Ethan Marlowe, GEO-Messverantwortlicher bei Auspia mit über 500 analysierten Prompts. Er schreibt über Prompt-Tracking, Zitat-Reporting, Sichtbarkeits-Dashboards und darüber, wie man eine echte Veränderung der KI-Sichtbarkeit vom Rauschen zwischen Durchläufen unterscheidet.