Tracker widoczności w AI brzmi prosto. Zadajesz asystentowi kilka pytań kategorii, notujesz, czy Twoja marka się pojawiła, i rysujesz to w czasie.
Problem leży wyżej w łańcuchu, przed zapisem. To, co mierzysz, nie stoi w miejscu. Wyślij ten sam prompt do tego samego modelu dwa razy, a dostaniesz dwie odpowiedzi, które pokrywają się tylko częściowo. Zapiszesz jedną z nich i zapisałeś jedną próbkę z rozkładu, a potem przedstawiłeś ją jako fakt.
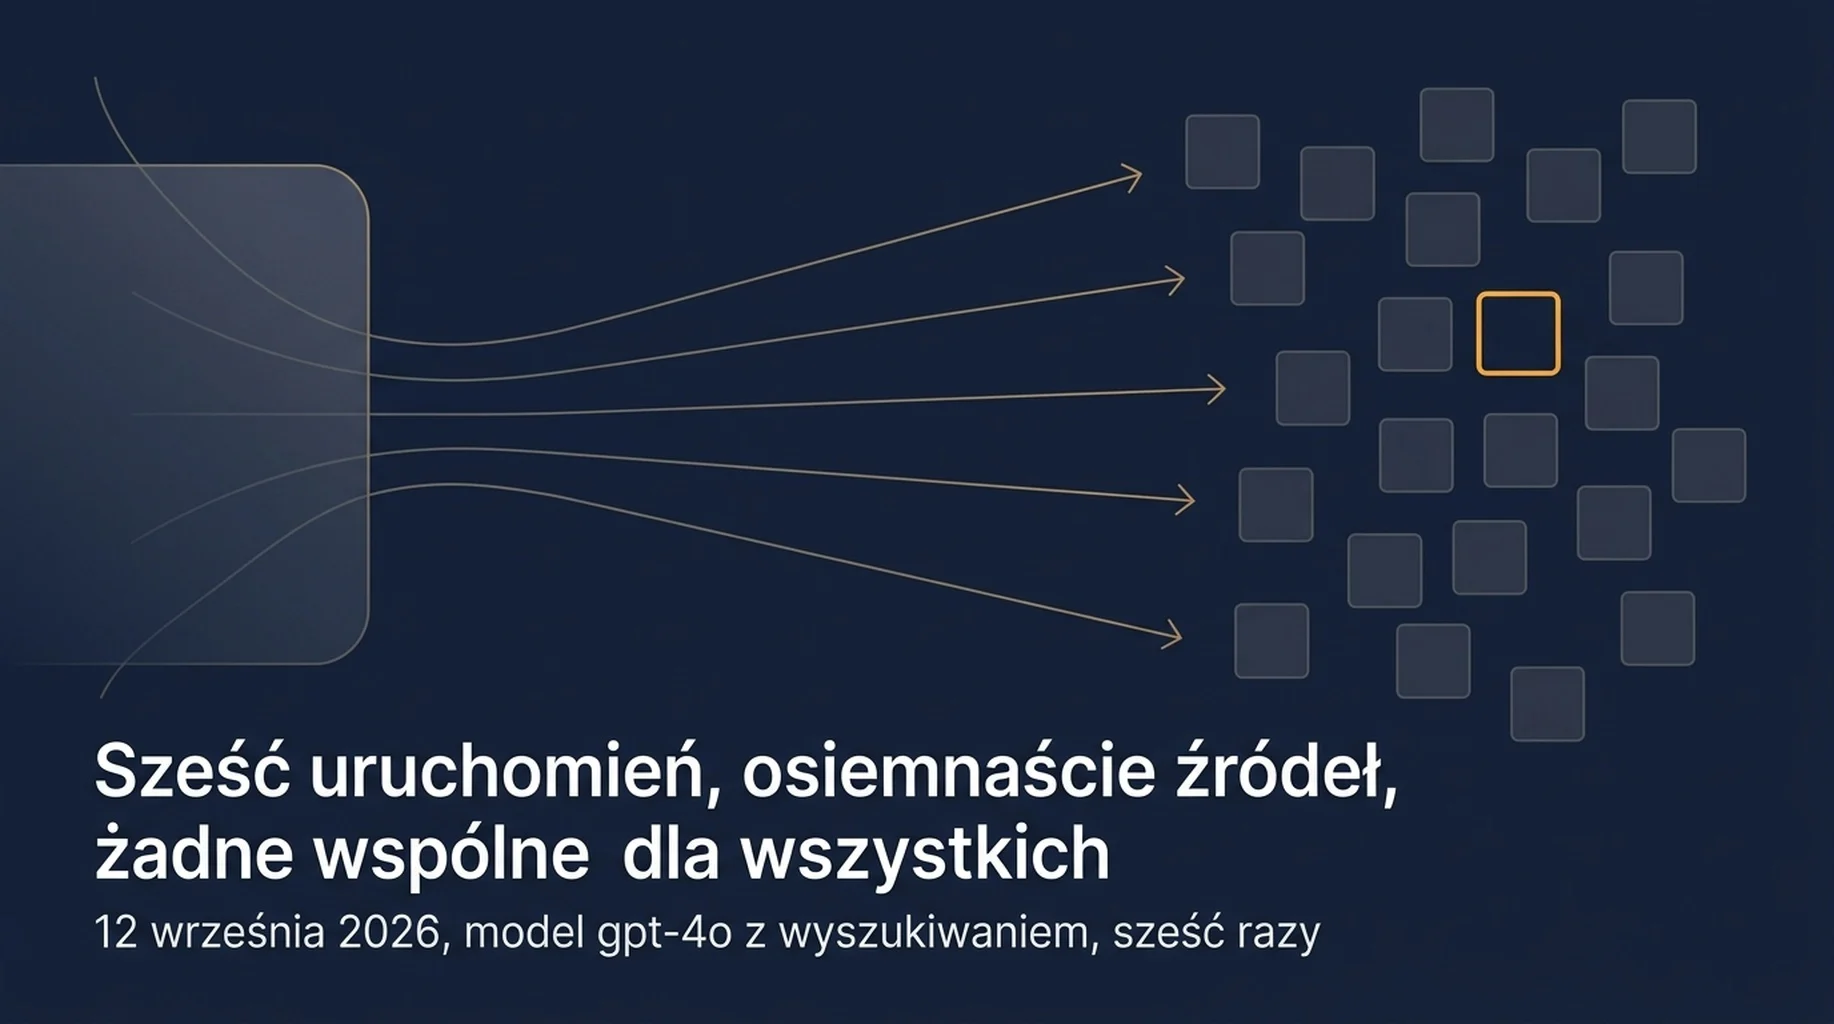
Chcieliśmy wiedzieć, jak duże jest to rozproszenie w rzeczywistości, więc przeprowadziliśmy eksperyment, zamiast go zakładać. Krótka wersja: sześć identycznych żądań dało osiemnaście cytowanych źródeł i żadne źródło nie zostało zacytowane we wszystkich sześciu.
Ten artykuł dotyczy tego, co uruchomiliśmy, co wróciło, oraz czterech pól, które tracker widoczności w AI musi przechowywać, żeby liczba była warta spojrzenia również w przyszłym miesiącu.
Co uruchomiliśmy
Dwa eksperymenty, oba na promptach, których zespół SaaS naprawdę użyłby w badaniu kategorii.
Eksperyment 1: jeden prompt, jeden model, sześć uruchomień. Model gpt-4o, wyszukiwanie w sieci włączone, Stany Zjednoczone, angielski. Prompt: „Jakie są najlepsze narzędzia do śledzenia pozycji dla małego zespołu SaaS w 2026 roku? Podaj krótką listę ze źródłami." Sześć osobnych wywołań na żywo, wykonanych po kolei w tym samym oknie sesji.
Eksperyment 2: dwa modele, ten sam prompt, po trzy uruchomienia. Ten sam prompt trafił do Claude Sonnet 5 i do Gemini 3.8 Flash, po trzy razy do każdego, bez wyszukiwania w sieci. Bez wyszukiwania mierzymy, jakie produkty model wymienia z własnej wiedzy, a to osobny sygnał od tego, jakie źródła cytuje.
Wysłaliśmy też drugi prompt tą samą ścieżką wyszukiwania cztery razy, żeby sprawdzić, czy zachowanie cytowania jest spójne między typami pytań: „Jak śledzić AI Overviews dla swojej strony? Podaj konkretne metody ze źródłami."
Sześć uruchomień to nie duża próbka i traktujemy ją tak, jak na to zasługuje. Wystarczy, żeby pokazać kierunek i przybliżony rząd wielkości zmienności, i o to chodzi.
Wynik 1: osiemnaście źródeł, zero wspólnych dla wszystkich sześciu uruchomień
Sześć uruchomień z wyszukiwaniem zacytowało łącznie 18 różnych adresów URL. Oto, jak często pojawiała się każda domena.
Liczba cytowań (z 6 uruchomień) | Domeny |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Żadna domena nie została zacytowana we wszystkich sześciu uruchomieniach. Żaden adres URL nie został zacytowany we wszystkich sześciu uruchomieniach.
Liczba, która ma tu znaczenie, to pokrycie między uruchomieniami. Porównując każdą parę uruchomień, średnie pokrycie Jaccarda na cytowanych adresach URL wyniosło 0,167. W dwóch z piętnastu par pokrycie było dokładnie zerowe, to znaczy, że te dwie odpowiedzi nie podzieliły ani jednego źródła.
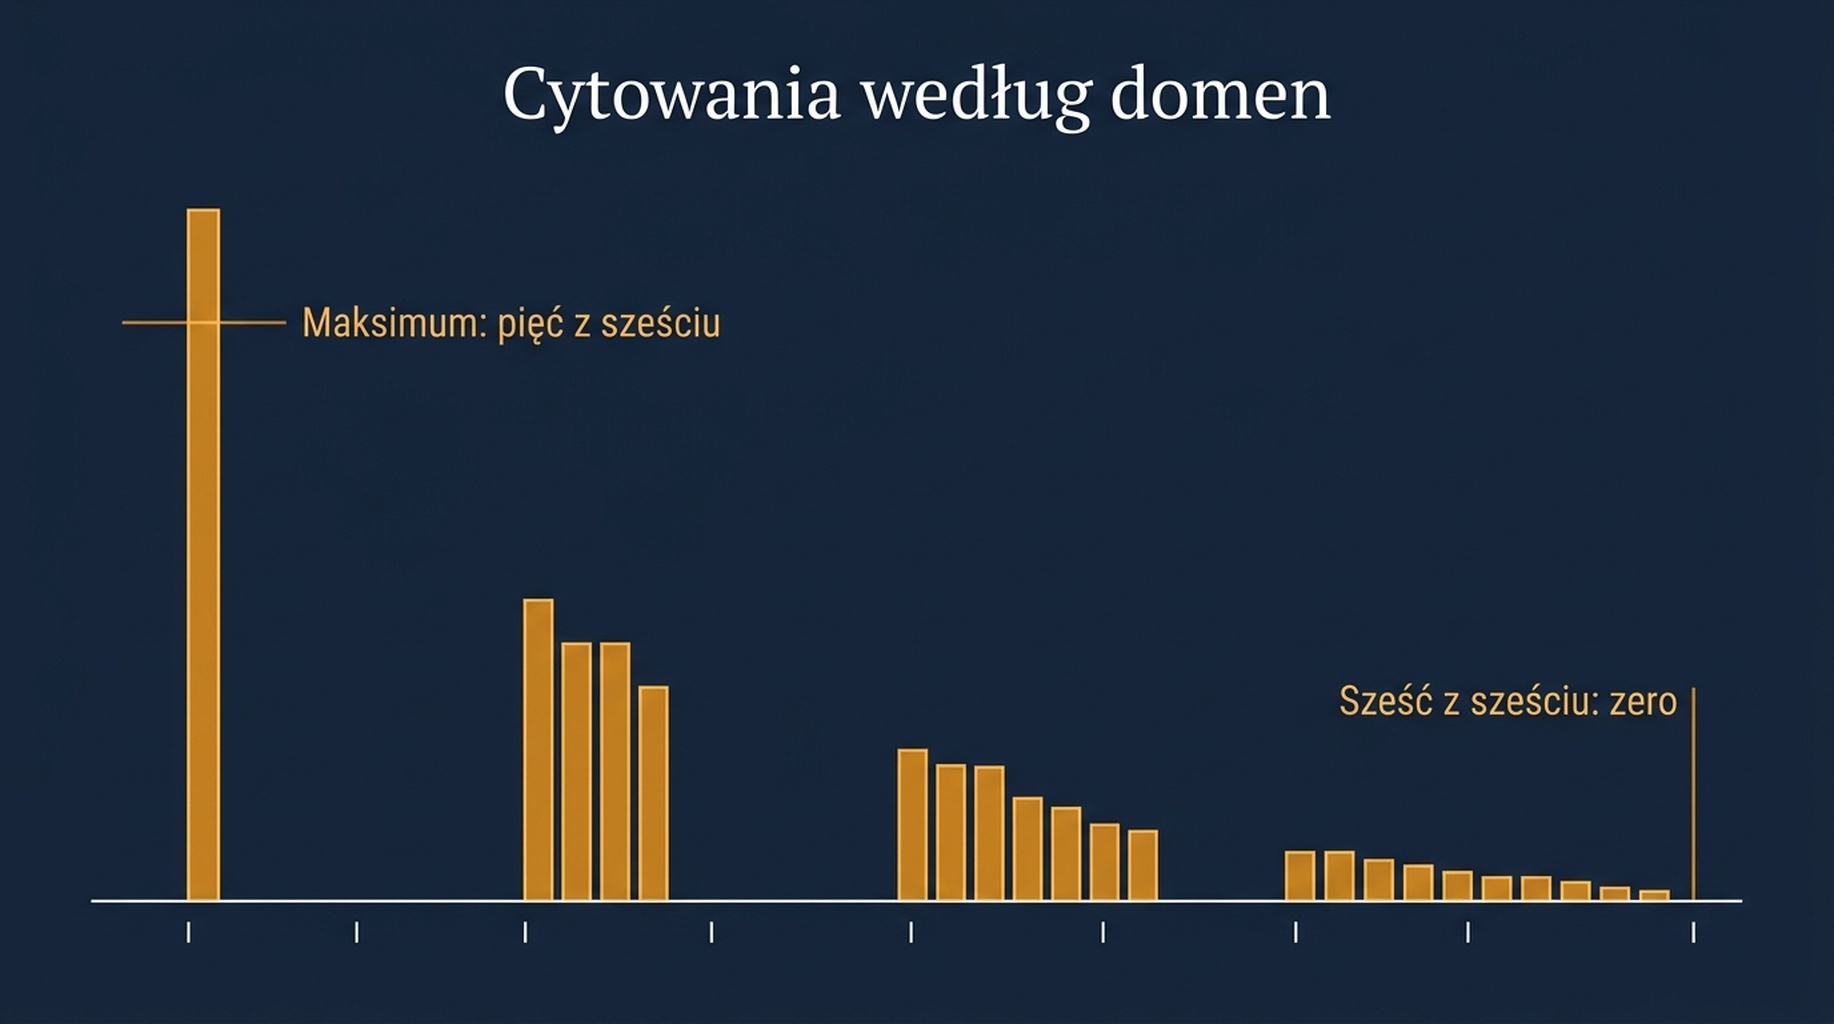
Źródło zacytowane w pięciu z sześciu uruchomień to pułap, który zaobserwowaliśmy. Nic nie było cytowane za każdym razem.
W tej tabeli zakopane jest drugie odkrycie. Domeny, po które model sięgnął, w większości nie są znanymi w tej kategorii serwisami porównawczymi. Dziewięć z osiemnastu domen pojawiło się dokładnie raz, a część z nich to małe serwisy, których treść czyta się jak coś złożonego pod to zapytanie, a nie jak owoc pracy dziennikarskiej. Dla marki to broń obosieczna. Oznacza, że miejsce w cytowaniu łatwiej zdobyć niż pozycję w tradycyjnym rankingu „najlepszych narzędzi". Oznacza też, że miejsce zajmuje ten, kto wyprodukował stronę pasującą do formy zapytania w tamtym uruchomieniu, i że w następnym uruchomieniu zostanie ono zapełnione od nowa.
Wynik 2: sama odpowiedź zmienia rozmiar
Cytowania się ruszały, a długość odpowiedzi ruszała się razem z nimi.
Uruchomienie | Tokeny wyjściowe | Długość odpowiedzi | Koszt uruchomienia |
|---|---|---|---|
1 | 505 | 2 153 znaki | $0,0735 |
2 | 860 | 3 728 znaków | $0,0770 |
3 | 1 108 | 4 746 znaków | $0,0797 |
4 | 832 | 3 555 znaków | $0,0765 |
5 | 870 | 3 547 znaków | $0,0772 |
6 | 813 | 3 544 znaki | $0,0768 |
Długość wyjścia wahała się od 505 do 1 108 tokenów, rozstęp 603 tokeny, około 73 procent średniej. Najdłuższa odpowiedź była ponad dwukrotnie dłuższa od najkrótszej. Pięć z sześciu uruchomień wpadło w dość wąskie pasmo między 813 a 1 108 tokenów; jedno uruchomienie zatrzymało się wcześnie na 505 i zacytowało pięć źródeł zamiast dziewięciu do czternastu.
Dla pomiaru ma to konkretne znaczenie. Jeśli Twój tracker wychwytuje „czy marka pojawia się w odpowiedzi i na której pozycji", to krótkie uruchomienie ma mniej miejsc, w których można się pojawić. Zespół, który próbkuje raz w tygodniu i przypadkiem trafił na krótkie uruchomienie, zapisze gorszy wynik niż zespół, który trafił na długie uruchomienie, choć na stronie nic się nie zmieniło.
Wynik 3: niektóre prompty nie dostają żadnych cytowań
Drugi prompt, o śledzeniu AI Overviews, przeszedł tą samą ścieżką wyszukiwania cztery razy i wrócił z zerem cytowań za każdym razem.
Uruchomienie | Tokeny wyjściowe | Długość odpowiedzi | Cytowania |
|---|---|---|---|
1 | 479 | 2 135 znaków | 0 |
2 | 522 | 2 240 znaków | 0 |
3 | 534 | 2 312 znaków | 0 |
4 | 497 | 2 228 znaków | 0 |
Odpowiedzi były stabilne pod względem długości, zmieniały się tylko o 8 procent przez cztery uruchomienia. Ale model odpowiadał z własnej wiedzy i nie wymienił żadnego źródła, więc w kolumnie cytowań nie było czego zapisać.
Z tego wynika konkretny i mylący odczyt trackera. Panel wskaźnika cytowań pokaże dla tego pytania zero i wygląda to jak porażka widoczności. Nie jest. To forma pytania, która nie wyzwala poszukiwania źródeł. Prawidłowy odczyt to „cytowanie nie dotyczy", a tracker, który nie umie odróżnić tego od „sprawdzono cytowanie i byłaś nieobecna", wyśle Cię w pogoń za problemem, którego nie ma.
Wynik 4: zmiana modelu to inny pomiar, nie powtórzenie
Z wyłączonym wyszukiwaniem zmierzyliśmy, jakie produkty wymienia każdy model. To izoluje własny zbiór rekomendacji modelu od wszystkiego, co zwrócił indeks wyszukiwania w tej minucie.
Claude Sonnet 5 wymieniał od czterech do pięciu produktów na uruchomienie. Przez trzy uruchomienia wymienił sześć różnych produktów: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat i SerpWatcher. Trzy z nich pojawiły się we wszystkich trzech uruchomieniach: AccuRanker, Ahrefs i SEMrush. Średnie pokrycie parami 0,587.
Gemini 3.8 Flash wymieniał od dwóch do pięciu produktów na uruchomienie. Przez trzy uruchomienia wymienił siedem różnych produktów: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush i Wincher. Tylko jeden z nich, SE Ranking, pojawił się we wszystkich trzech uruchomieniach. Średnie pokrycie parami 0,306.
Między dwoma modelami cztery produkty zostały wymienione przez oba, a pięć tylko przez jeden.
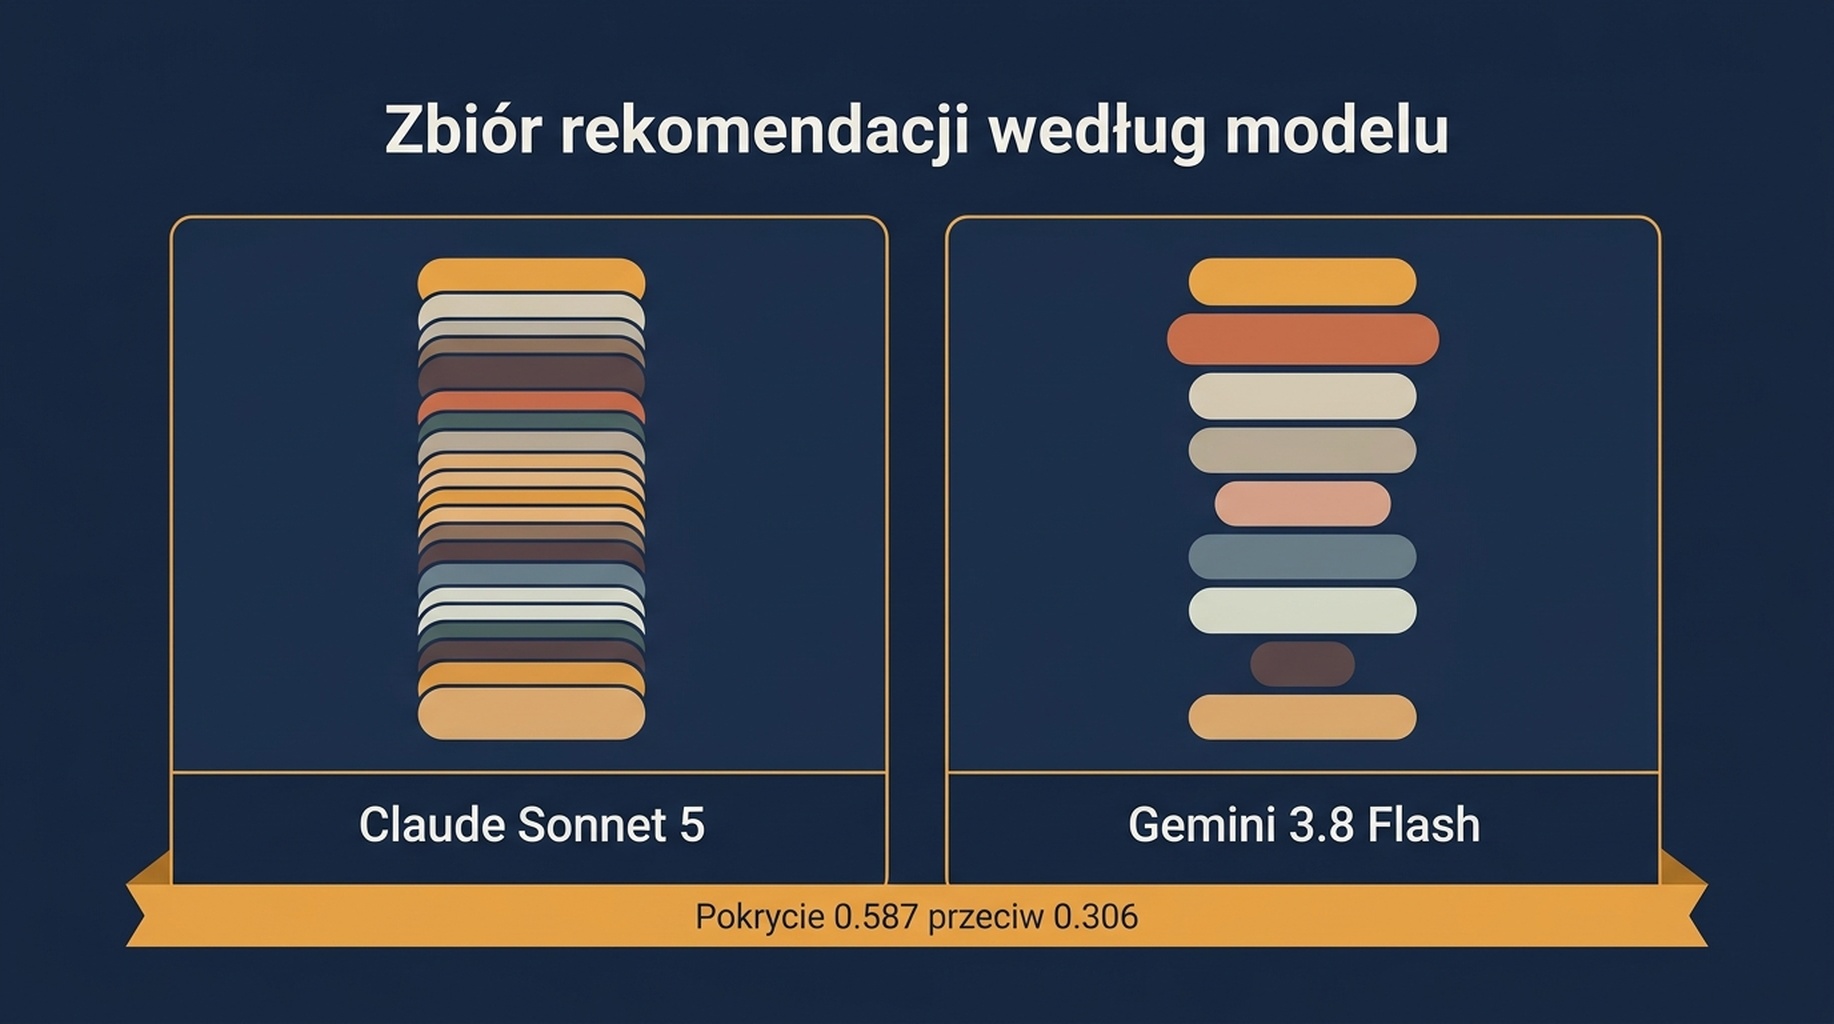
To samo pytanie daje częściowo inny zbiór rekomendacji na każdym modelu i w każdym uruchomieniu.
Praktyczny wniosek: jeśli śledzisz „widoczność w AI" jako jedną liczbę, uśredniasz co najmniej dwa niezależne źródła zmienności, czyli uruchomienie i model. Marka, która pojawia się stabilnie u jednego asystenta, a u innego nie, to prawdziwe i dające się wykorzystać odkrycie. Marka, której pomiar z jednej próbki przesunął się o dwie pozycje, to szum.
Co powinien rejestrować tracker widoczności w AI
Cztery pola zamieniają zrzut ekranu w pomiar.
Liczba uruchomień, nie wynik uruchomienia. Przechowuj każde uruchomienie i raportuj zakres. „Zacytowany w 4 z 6 uruchomień" to fakt. „Zacytowany, pozycja 3" to przypadek. Sześć uruchomień to rozsądne minimum dla małego programu; dwanaście jest lepsze, jeśli prompt ma znaczenie komercyjne.
Pole cytowania osobno od pola wzmianki. „Model nas polecił" i „model podlinkował do nas" to dwa różne wyniki z różnymi sposobami naprawy. Nasze sześć uruchomień dało 18 cytowań z 18 różnych adresów URL; tracker rejestrujący tylko wzmianki o marce nie wychwyciłby z tej huśtawki niczego.
Stan kanału odpowiedzi. Rejestruj, czy uruchomienie w ogóle korzystało z wyszukiwania, i rejestruj długość odpowiedzi. Uruchomienie z zerem cytowań i uruchomienie z zerem wzmianek wyglądają na panelu identycznie i znaczą coś przeciwnego.
Treść promptu słowo w słowo, z numerem wersji. Sformułowanie promptu decyduje o tym, które źródła zostaną podciągnięte. Jeśli prompt zmienia się między miesiącami, linia trendu się urywa. Wersjonuj prompt tak, jak wersjonujesz skrypt śledzący.
Budowanie pętli uruchomień
Ręczna weryfikacja nie przetrwa jednego spotkania z kalendarzem. Pętla to skrypt, który uruchamia prompt N razy, zapisuje każdą surową odpowiedź wraz z jej cytowaniami i porównuje bieżące okno z poprzednim.
To dobrze pasuje do agenta, bo praca jest powtarzalna, ograniczona regułami i wymaga pisemnego rejestru. W Claude Code albo Codex użyteczna instrukcja brzmi: zostawiaj surowe uruchomienia na dysku i nigdy ich nie nadpisuj, a potem raportuj tabelę podsumowującą zamiast jednej liczby. Jeśli już pobierasz dane Search Console i Bing przez serwery MCP, ta sama sesja może trzymać dziennik cytowań obok danych o wyświetleniach, i tam właśnie obie liczby zaczynają być przydatne razem. Nasze notatki o tym, co te serwery ujawniają, są w co naprawdę robią cztery serwery SEO MCP, a strona obecności tego samego problemu jest w naszym zrzucie AI Overview na czterdzieści zapytań.
Jedna zasada projektowa jest ważniejsza od pozostałych: wyjście trackera powinno być rozkładem. Raportuj „zacytowany w 4 z 6", a nie „zacytowany". Raportuj listę źródeł, a nie źródło numer jeden. Każdy panel, który ściska sześć uruchomień w jedną liczbę, wyrzucił jedyną informację, jaką kupiły dodatkowe uruchomienia.
Jeśli celem jest porównanie z konkurencją, a nie monitoring, lepszym narzędziem jest pętla śledzenia pozycji w czasie, a kompromisy między źródłami danych są w jak zbudować tracker pozycji z dwóch źródeł.
Granice próbki sześciu uruchomień
Trzy uczciwe zastrzeżenia.
Próbka jest mała. Sześć uruchomień Zakreśla rozproszenie tylko z grubsza. Ustala, że pokrycie między uruchomieniami jest częściowe i że pary o zerowym pokryciu się zdarzają; nie daje przedziału ufności dla Twojej kategorii.
Wyniki są związane z czasem. Te uruchomienia wykonano 12 września 2026 roku na modelach działających na żywo. Zmieniają się i modele, i wyniki wyszukiwania pod nimi.
Cytowane domeny to próbka z jednego komercyjnego promptu. Inna forma pytania, na przykład pytanie porównawcze albo pytanie „jak zrobić", da inny wzorzec cytowań. Użytecznym ruchem jest uruchomienie tego samego projektu na dziesięciu Twoich najważniejszych komercyjnie promptach i zapisanie, jak zachowuje się Twoja kategoria.
Najczęstsze pytania
Ile uruchomień potrzebuję, zanim liczba widoczności w AI zacznie coś znaczyć? Sześć to praktyczne minimum dla jednego promptu, a liczbę należy raportować jako zliczenie z liczby uruchomień, nie jako pozycję. Jeśli prompt steruje decyzjami o przychodzie, dwanaście uruchomień da ciaśniejszy odczyt za kilka dolarów.
Czy to znaczy, że śledzenie widoczności w AI nie jest warte zachodu? To znaczy, że śledzenie z jednej próbki nie jest warte zachodu. Odkryciem jest sama zmienność. Tracker, który raportuje „zacytowany w 4 z 6 uruchomień, źródła zmieniły się o 12 domen od zeszłego miesiąca", opisuje realny system, w którym ściga się konkurent.
Dlaczego jeden prompt wrócił z zerem cytowań? Model odpowiedział z własnej wiedzy, zamiast szukać źródeł. To właściwość pytania, nie porażka Twojej strony. Śledź to jako nie dotyczy, a nie jako zero.
Czy śledzić ChatGPT, Claude i Gemini osobno? Tak. W naszym porównaniu na trzech uruchomieniach oba modele pokryły się tylko w czterech z dziewięciu wymienionych produktów. Uśrednianie ukrywa decyzję na poziomie programu o tym, którego asystenta optymalizować najpierw.
Czy da się zmniejszyć zmienność, obniżając temperaturę modelu? Częściowo, i warto to sprawdzić na własnych promptach. Ale na zbiór cytowań wpływa też indeks wyszukiwania, a tego nie kontrolujesz. Liczba uruchomień to pewniejsza dźwignia.
Spojrzenie Auspia: jeśli w tym kwartale budujesz śledzenie widoczności w AI, zbuduj najpierw dziennik uruchomień, a potem panel. Panel to wybór sposobu prezentacji. Dziennik uruchomień to pomiar. Zacznij od dziesięciu promptów, po sześć uruchomień każdy, przechowywanych słowo w słowo, a w tydzień dowiesz się więcej, niż powiedziałby Ci cały rok weryfikacji z jednej próbki.
Autor: Ethan Marlowe, kierowanie pomiarem GEO na ponad 500 promptach w Auspia. Pisze o śledzeniu promptów, raportach cytowań i panelach widoczności, które wytrzymują spotkanie z realnym cyklem pomiarowym.