Reguła, którą Google właśnie zapisał
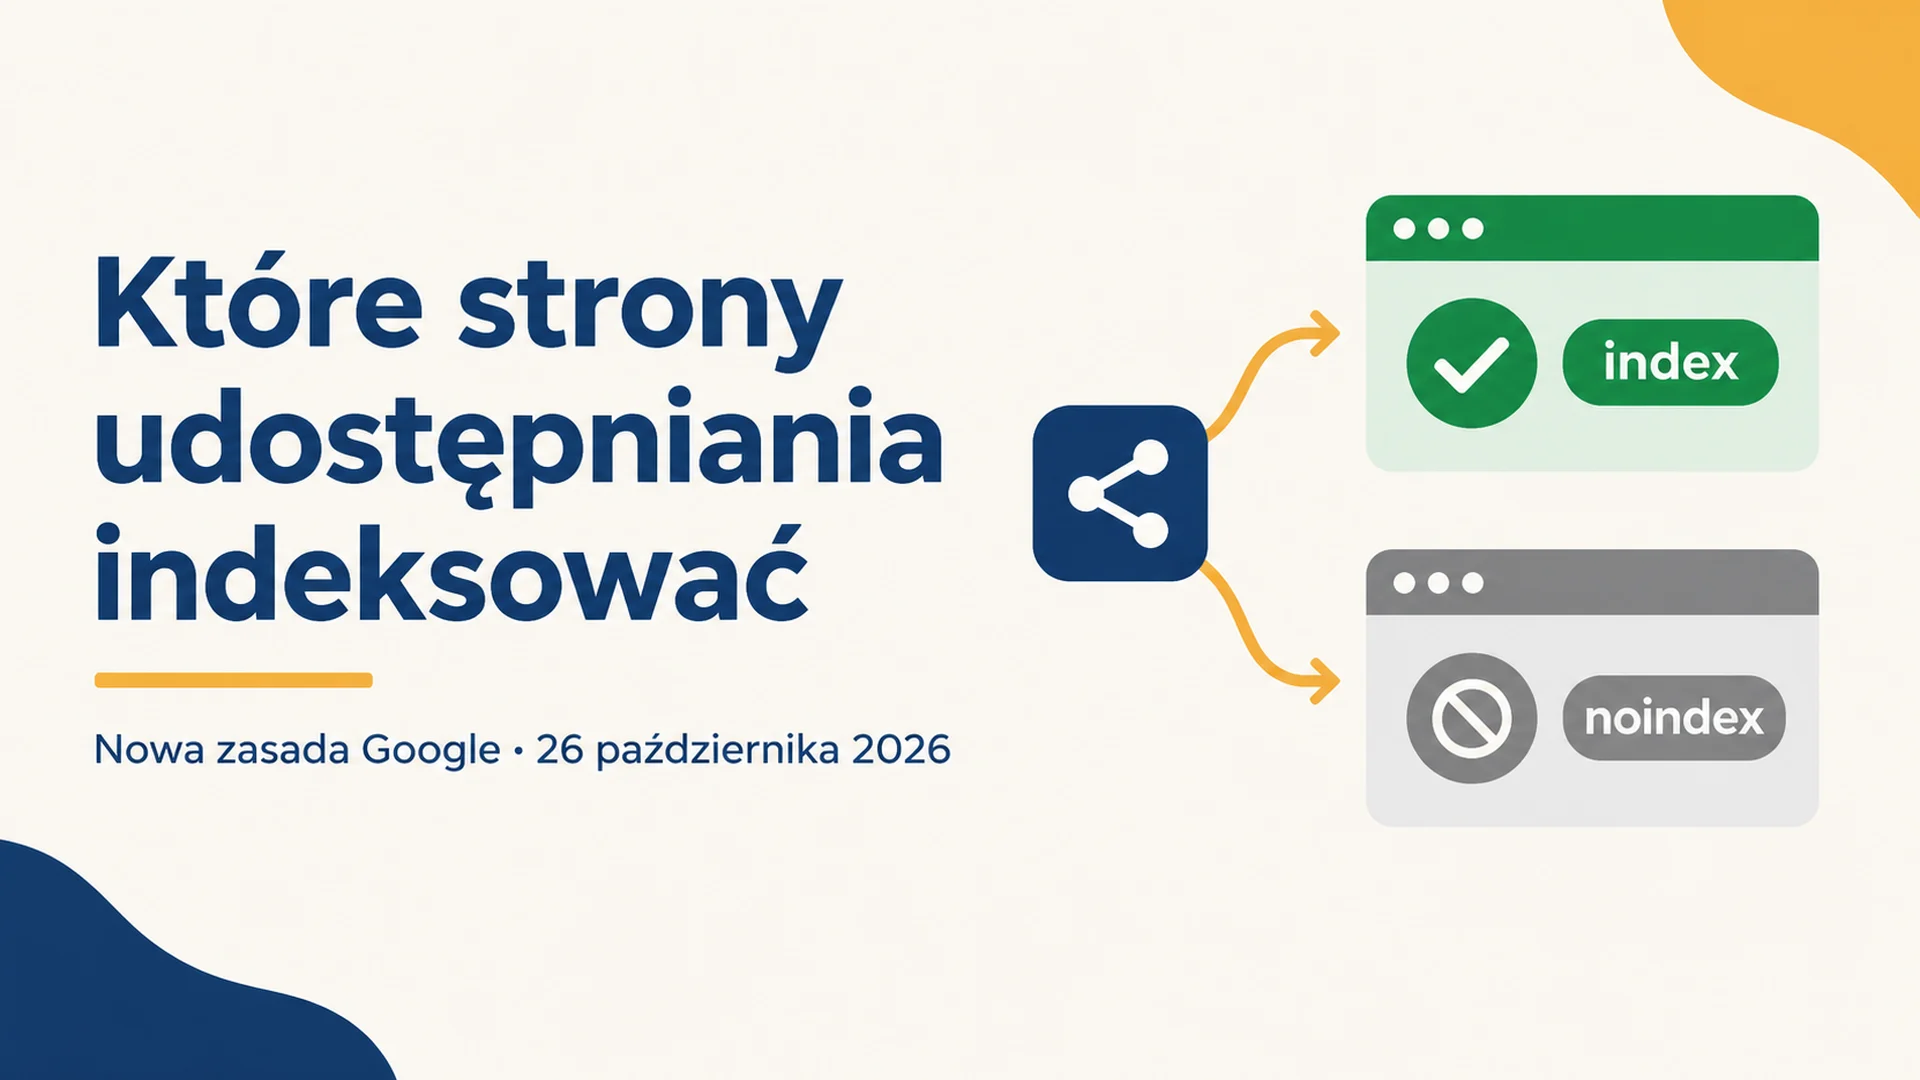
26 października 2026 roku Google dodał do swojego przewodnika po zapobieganiu spamowi generowanemu przez użytkowników sekcję liczącą dwa akapity. To najkrótsza część strony i prawdopodobnie ta, która najmocniej zmieni plany produktowe, bo stawia pytanie, którego większość zespołów nigdy nie wrzuciła na slajd: czy ten URL w ogóle powinien być w indeksie Google?
Sekcja nosi tytuł "Only index content meant for Search" — indeksuj tylko treści przeznaczone dla wyszukiwarki. W tłumaczeniu brzmi to tak:
Jeśli Twoja usługa pozwala użytkownikom tworzyć strony do udostępniania, wygenerowane wyniki lub interaktywne narzędzia, zastanów się, czy te treści powstały po to, by wyszukiwarki je znajdowały, czy tylko po to, by konkretna osoba otwierała je z linku.
Gdy strony powstają do bezpośredniego udostępniania, wspólnej pracy lub praktycznego użytku, a nie po to, by były odkrywane w publicznym wyszukiwaniu, stosuj domyślne noindex (przez meta tag robots albo nagłówek HTTP X-Robots-Tag) lub domyślnie blokuj indeksowanie w robots.txt.
Dziennik zmian Google z tego samego dnia mówi o intencji wprost: przewodnik zaktualizowano o „wskazówki, jak blokować indeksowanie treści udostępnianych przez linki i jak monitorować nadużycia w Search Console", żeby platformy mogły „trzymać poza indeksem tworzone przez użytkowników strony, które nie są przeznaczone dla wyszukiwarki, i szybciej wykrywać spam".
To wszystko. Żadnej nowej ręcznej akcji, żadnego ogłoszenia systemu rankingowego, żadnej listy kar. Jest rekomendacja wartości domyślnej — a niemal wszystkie incydenty z indeksacją rodzą się z wartości domyślnych.
Dla kogo to jest. Dla zespołów, które publikują jakikolwiek URL tworzony przez użytkownika: linki do udostępniania, zapisane czaty, publiczne pulpity, podglądy modeli, buildy aplikacji, wygenerowane raporty, wątki na forach, strony profili, strony opinii, strony ogłoszeń.
Co z tego wyniesiesz. Werdykt dla każdej trasy i każdego typu generowanego URL, mechanizm kontroli, który naprawdę usuwa stronę z indeksu, oraz regułę monitorowania, która łapie opisany przez Google schemat nadużyć.
Czas. Od 45 do 90 minut na pierwsze przejście w jednym produkcie. Dzień, jeśli masz kilka generatorów URL i brak inwentaryzacji tras.
Jak wygląda „gotowe". Każda generowana trasa oznaczona jako index, noindex albo prywatna. Trasy noindex zwracają dyrektywę z serwera, a nie po wykonaniu JavaScriptu. Search Console pokazuje te URL-e jako wykluczone przez noindex, a nie jako „Zaindeksowano, ale zablokowano przez robots.txt".
Co się zmieniło, a co tylko wygląda na nowe
Istotne są cztery zmiany. Reszta strony się nie ruszyła, łącznie ze wskazówkami z grudnia 2025 roku, które nadal obowiązują.
Co zmienił Google | Faktyczny tekst | Dlaczego to ważne dla Ciebie |
|---|---|---|
Zakres przewodnika | Teraz wymienia platformy hostingowe oraz „narzędzia, które pozwalają użytkownikom publikować strony do udostępniania, wygenerowane treści lub aplikacje webowe" | Dosłownie obejmuje to eksporty czatów AI, strony artefaktów, kreatory aplikacji i narzędzia no-code, a nie tylko fora i komentarze |
Jednostka nadużycia | Spamerzy mogą tworzyć „dużą liczbę stron albo witryn" | Google mówi o skali, nie o sprycie. Jedno nadużyte konto potrafi wyprodukować tysiące URL-i |
Nowa sekcja | "Only index content meant for Search" | Najjaśniejsze jak dotąd stwierdzenie, że noindex to rozsądna wartość domyślna dla treści dostępnych wyłącznie z linku |
Monitoring | Sprawdź witrynę lub subdomenę w Search Console, obserwuj skoki na wykresach Indeksowanie stron i Skuteczność w wyszukiwarce, alarmuj, gdy „kilku użytkowników" tworzy „dużą część indeksowalnych URL-i" | Rozdęcie indeksu ma teraz nazwaną metodę wykrywania — i zwykle właśnie to poprzedza jakąś formę egzekwowania |
Co się nie zmieniło: noindex dla postów nowych użytkowników, dopóki nie zdobędą reputacji, oraz nofollow lub ugc na linkach w treściach od nieznanych autorów. Jeśli robisz już jedno i drugie, jesteś przed tą aktualizacją.
Warto powiedzieć to wprost, bo reakcje na X wyprzedziły dokument: to wskazówki dla platform dotyczące ich własnego zapasu URL-i. Nie tworzą nowego naruszenia dla zwykłej strony marketingowej i nie zmieniają rankingu żadnej strony. Zmieniają to, co powinno być w indeksie.
Jeden element kontekstu wyjaśnia timing. Pod koniec lipca 2026 roku linki do udostępniania i strony artefaktów Claude zaczęły pojawiać się w indeksie Google, a ówczesne doniesienia opisywały rekordy medyczne, klucze API i inne prywatne materiały wystawione publicznie, zanim Anthropic załatał lukę w ciągu kilku dni. Te same publikacje wspominały publiczne URL-e aplikacji w kreatorach pokroju Replit i Lovable. Google rzadko pisze nową sekcję przewodnika na podstawie hipotezy. To już się stało.
Pytanie, które rozstrzyga każdy generowany URL
Test Google mieści się w jednym zdaniu i można go zastosować bez zgadywania intencji: czy ta treść powstała po to, by wyszukiwarki ją znajdowały, czy tylko po to, by człowiek z linkiem ją otworzył?
W praktyce odpowiadają na to cztery sygnały. Oceniaj trasę, nie pojedynczą stronę.
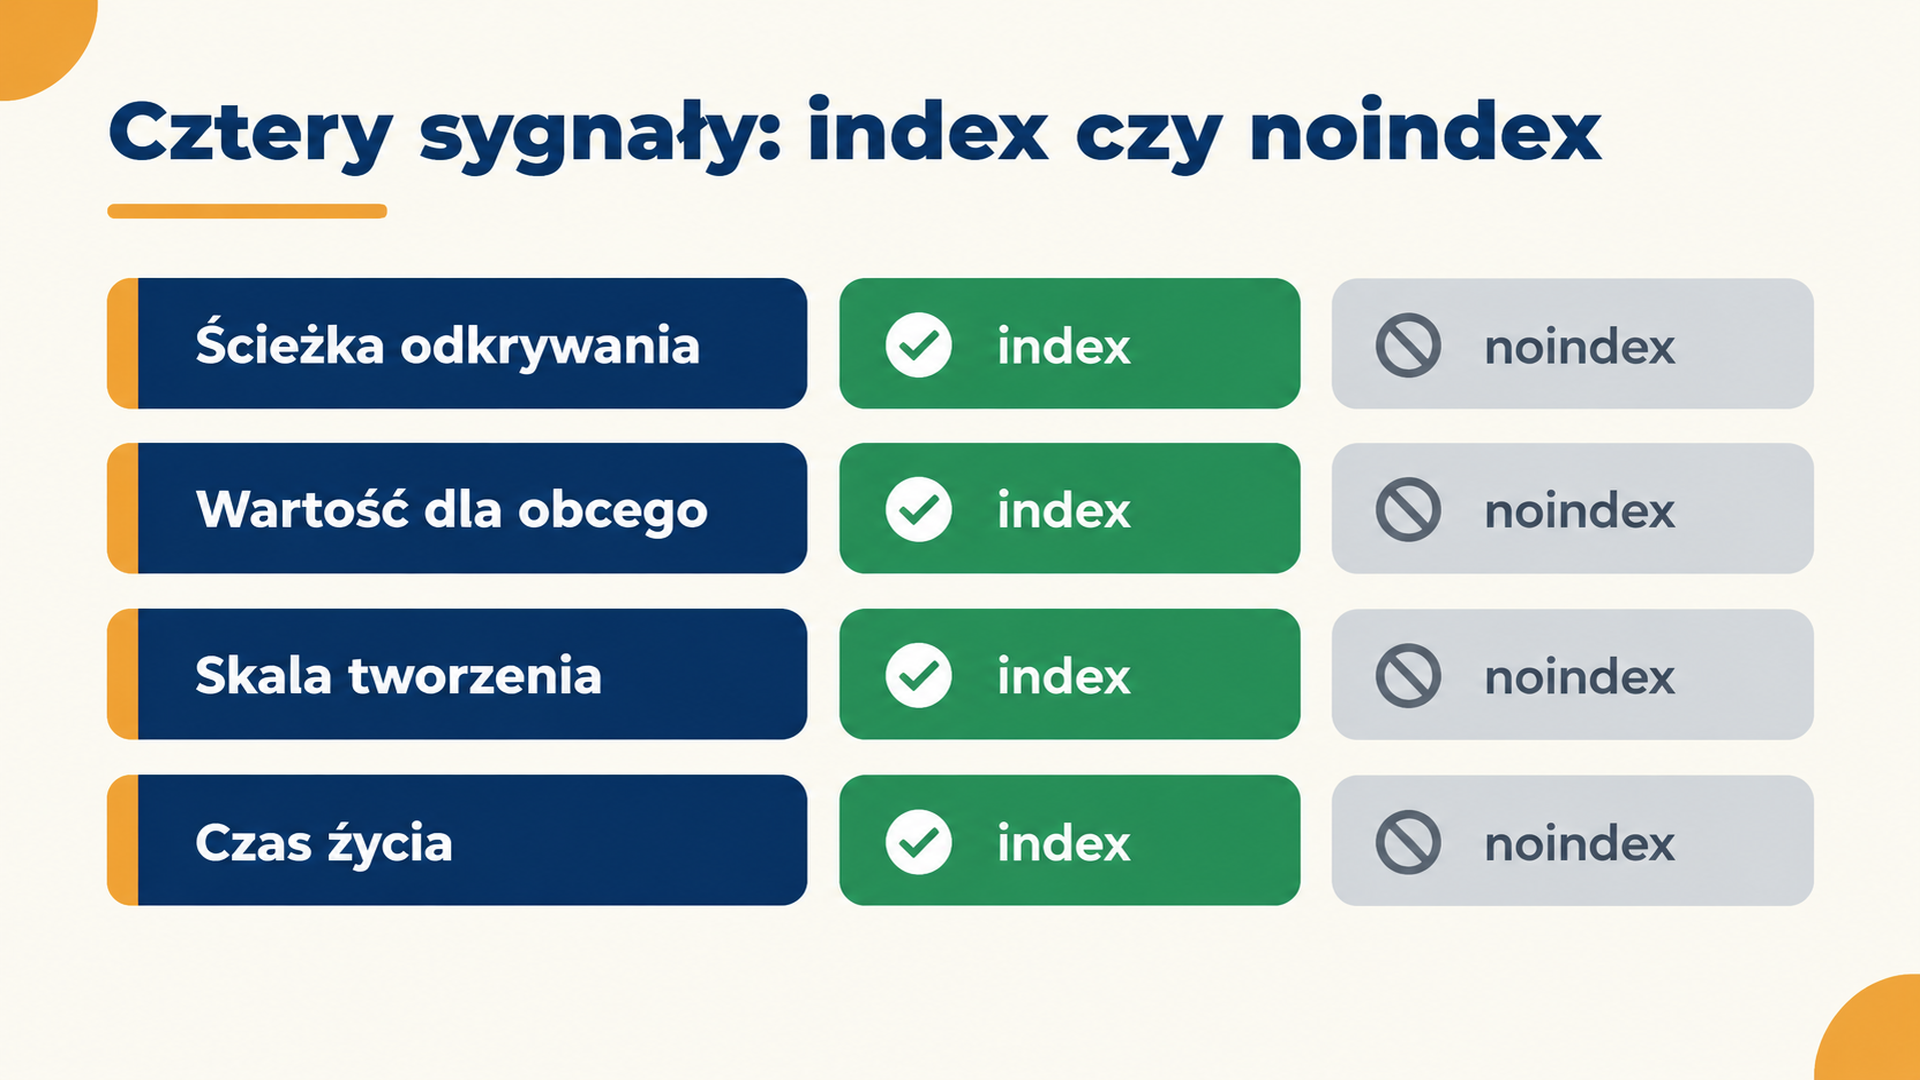
Sygnał | Przechyla ku index | Przechyla ku noindex |
|---|---|---|
Ścieżka odkrywania | Linki z publicznej galerii, sitemapy, strony kategorii lub profilu | Dostępne tylko ze skopiowanego linku albo przycisku „udostępnij" |
Wartość dla obcego | Przydatne bez znajomości autora | Sensowne tylko dla autora, jego zespołu albo odbiorcy |
Skala tworzenia | Jedna strona na temat albo wyselekcjonowany zbiór | Tysiące URL-i z jednego konta, w większości niemal identycznych |
Czas życia | Pozostaje trafne przez miesiące | Chwilowe: czat, build, szkic, tymczasowy eksport |
Trzy z czterech po stronie noindex — werdykt jest jednoznaczny. Wynik mieszany zwykle oznacza, że trasę trzeba rozdzielić: publiczna galeria do indeksowania i osobne wyniki pod nią, których nie indeksujemy. To rozdzielenie jest najczęstszą poprawną odpowiedzią i jednocześnie najczęściej pomijanym krokiem, bo wymaga dwóch szablonów zamiast jednej flagi.
Przydatny test na odmowę: gdyby obcy zobaczył ten URL w wyniku wyszukiwania bez kontekstu, czy tytuł i fragment miałyby dla niego sens? „Czat z Samem, 24 paź" — nie. „Szablon faktury dla grafików na freelansie" — tak. Odmowa nie dotyczy jakości. Dotyczy tego, czy stronę zbudowano, by ją znaleziono, czy by ją wysłano.
Wybierz mechanizm, który naprawdę usuwa URL
Tu można dosłownie posłuchać nowej wskazówki i mimo to ponieść porażkę. Google podaje dwie opcje w jednym zdaniu i nie są one równoważne.
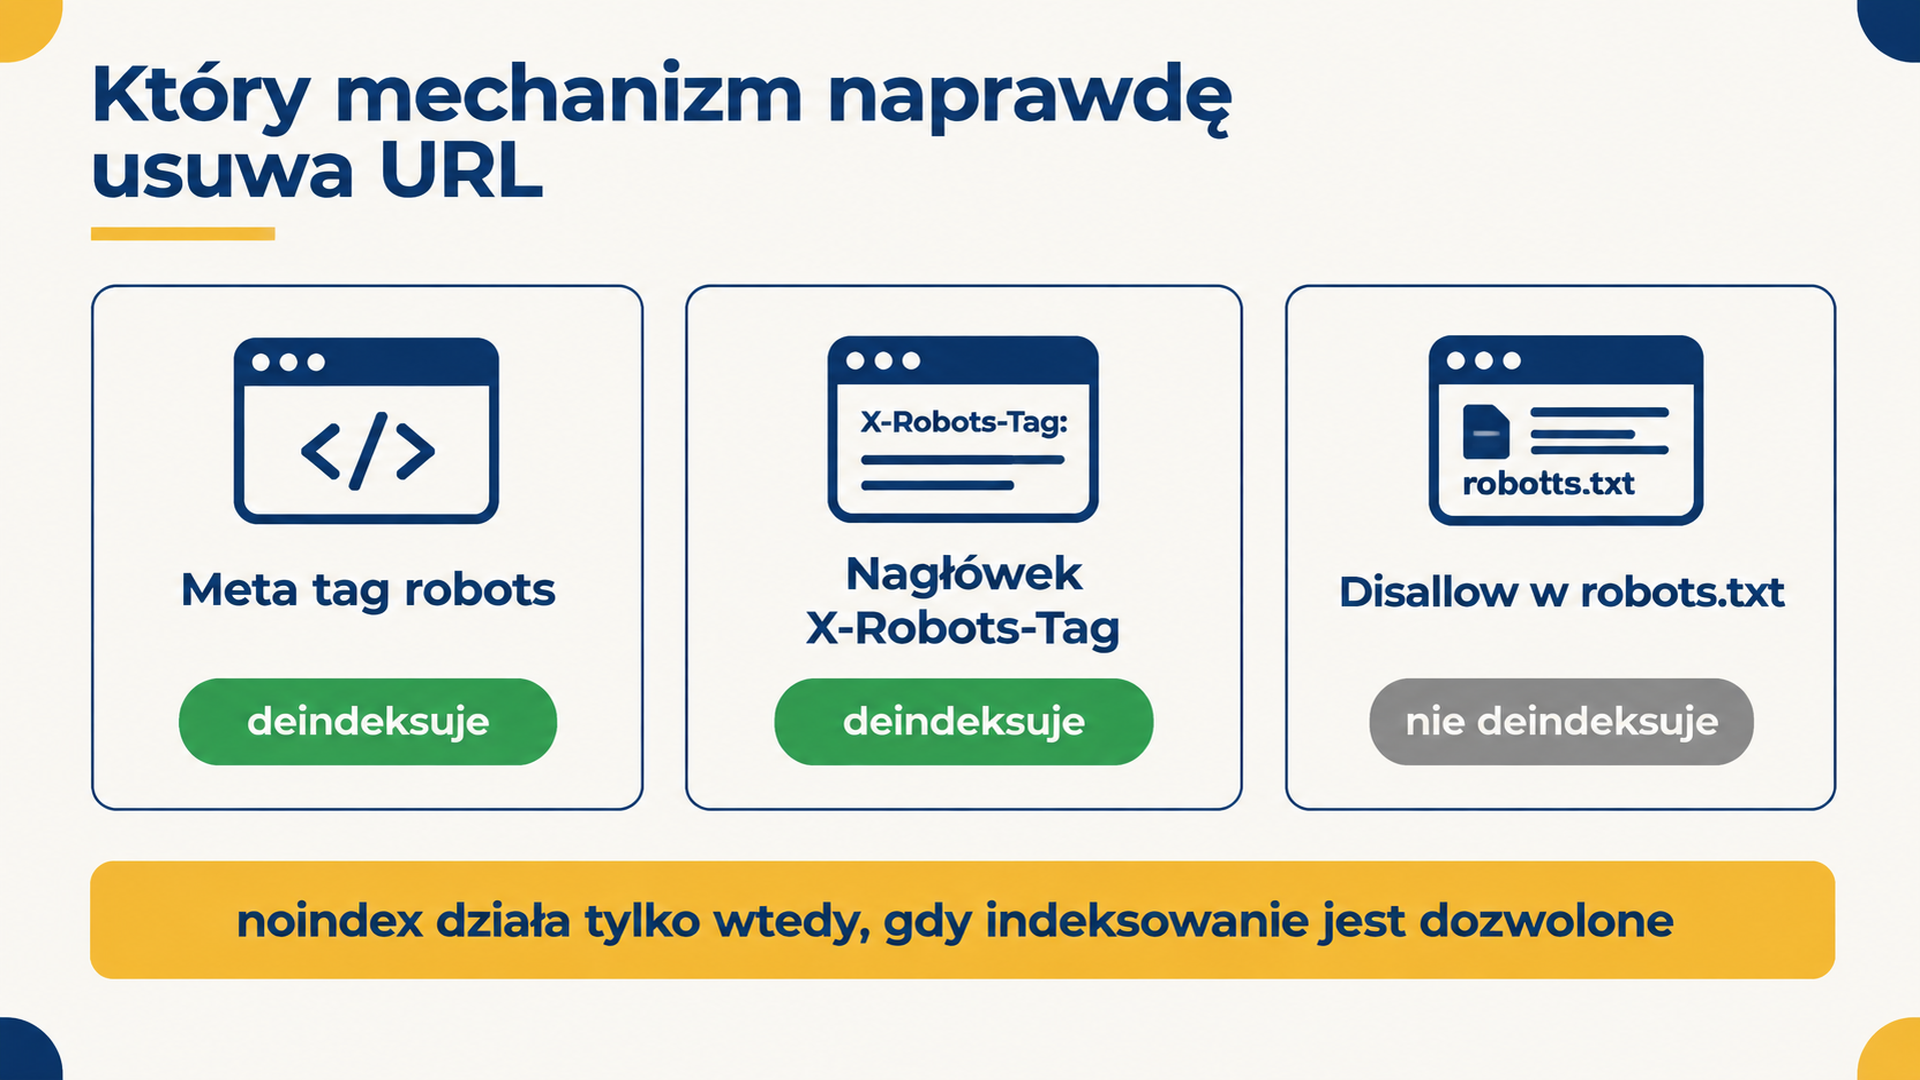
robots.txt kontroluje indeksowanie. Nie usuwa URL-a z indeksu, co Google mówi wprost we wstępie do robots.txt: strona zablokowana tam „może nadal być zaindeksowana, jeśli linkują do niej inne witryny" — a wtedy URL, a być może i tekst linku, może pojawić się w wynikach bez opisu.
noindex kontroluje indeksację, ale tylko jeśli Google może stronę zaindeksować i przeczytać dyrektywę. Dokumentacja Google dotycząca noindex jest jednoznaczna: żeby reguła zadziałała, strona nie może być zablokowana w robots.txt, bo w przeciwnym razie „crawler nigdy nie zobaczy reguły noindex".
Połącz oba fakty, a kolejność staje się istotna.
Mechanizm | Usuwa URL z indeksu | Gdzie zawodzi | Do czego używać |
|---|---|---|---|
Nagłówek odpowiedzi | Tak, gdy Google zaindeksuje stronę i przeczyta nagłówek | Cokolwiek zablokowane w robots.txt albo za logowaniem | Odpowiedzi nie-HTML (PDF, JSON, obrazy) oraz reguły na brzegu lub CDN dla wielu tras |
| Tak, gdy Google zaindeksuje stronę i przeczyta tag | Tagi wstrzykiwane JavaScriptem po załadowaniu; strony zablokowane w robots.txt | Strony udostępniania w HTML renderowane po stronie serwera |
Disallow w | Nie | URL z linkami może zostać w indeksie bez fragmentu | Zmniejszenie obciążenia crawlera, nie prywatność |
Logowanie albo podpisany URL | Tak, przez uniemożliwienie dostępu | Wymaga, by strona była faktycznie prywatna | Wszystko, co zawiera dane innych osób |
410 po wygaśnięciu | Tak, z czasem | Wolniejsze niż 404; nie działa, dopóki URL odpowiada | Ulotne udostępnienia i buildy |
Jedna droga na skróty, której warto unikać: X-Robots-Tag: none nie jest neutralną wartością. Google traktuje to jako noindex plus nofollow. Czasem to dokładnie to, czego chcesz, ale zespoły kopiują to z konfiguracji proxy, nie wiedząc o tym.
Druga droga na skrót, której warto unikać: tagi canonical. Canonical to wskazówka. Jeśli strony nie ma być w indeksie, napisz noindex.
Krok 1: zinwentaryzuj trasy, które tworzą URL-e
Nie da się sklasyfikować czegoś, czego nie ma na liście, a większość zespołów nie docenia liczby, bo myśli o funkcjach, a nie o wzorcach tras.
Otwórz router albo mapę URL-i i wypisz każdy dynamiczny segment. Zwykli podejrzani wyglądają tak:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Potem porównaj z tym, co Google już wie, bo kod i indeks się rozjeżdżają.
Z sitemapy. Pobierz i policz:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Druga komenda daje przybliżony histogram według prefiksu ścieżki. Jeśli generowana trasa jest w Twojej sitemapie, to już błąd: sitemapa to lista stron, o których indeksację prosisz Google.
Z Search Console. Otwórz raport Indeksowanie stron, przefiltruj po prefiksie URL dla każdej kandydackiej trasy i zapisz liczby. To jedyne źródło, które mówi, co Google faktycznie zrobił z tymi URL-ami.
Z logów serwera. Zgrupuj żądania Googlebota po prefiksie:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Oczekiwany wynik. Lista wzorców tras z liczbą URL-i obok, zebrana z co najmniej dwóch źródeł.
Kontrola jakości. Każda trasa, która może zwrócić 200 osobie spoza zespołu, musi być na liście. Jeśli liczby z sitemapy i Search Console różnią się o więcej niż kilka procent dla jednego prefiksu, ustal dlaczego, zanim cokolwiek zmienisz.
Jeśli nic nie znalazłeś. Prawdopodobnie masz router po stronie klienta. Szukaj definicji tras w kodzie frontendu, nie w backendzie, i sprawdź zakładkę sieci na prawdziwym linku do udostępniania.
Krok 2: sklasyfikuj każdą trasę w tabeli, nie na spotkaniu
Zapisz werdykt tam, gdzie ktoś go przeczyta. Jeden wiersz na wzorzec trasy wystarczy.
Trasa | Kto tworzy | Ścieżka odkrywania | Wartość dla obcego | Werdykt | Mechanizm | Właściciel |
|---|---|---|---|---|---|---|
| Dowolny użytkownik | Tylko link | Brak | noindex | Nagłówek | Platforma |
| Kuracja | Linki wewnętrzne, sitemapa | Wysoka | index | Brak | Treść |
| Dowolny użytkownik | Linki z profili | Niska, dopóki konto jest nieaktywne | noindex do zdobycia reputacji | Meta | Zaufanie i bezpieczeństwo |
| Dowolny użytkownik | Tylko link | Brak | noindex | Nagłówek | Platforma |
| Redakcja | Sitemapa | Wysoka | index | Brak | Treść |
Tabela działa tylko wtedy, gdy prawdziwe są trzy rzeczy.
Jedna odpowiedzialna osoba w każdym wierszu. Rozmyta własność to powód, dla którego generowane trasy zostają w indeksie latami.
Zapisz mechanizm obok werdyktu, nie po nim. „noindex" nie jest decyzją, dopóki nikt nie wie, czy chodzi o nagłówek, zmianę szablonu czy regułę CDN.
Zanotuj wyjątek. Jeśli trasa ma być noindex, ale niewielki podzbiór powinien być publiczny, zapisz warunek tego podzbioru teraz. Wycięcie go pół roku później to ścieżka, którą reguła noindex w końcu znika w całości, po cichu.
Krok 3: wdróż mechanizm na poziomie szablonu
Poprawki strona po stronie nie przetrwają następnego wdrożenia. Zastosuj mechanizm tam, gdzie renderowana jest trasa.
Dla stron HTML umieść tag w head renderowanym po stronie serwera. W App Routerze Next.js to metadata; w Astro head layoutu; w Railsach czy Django szablon layoutu. Dokładna składnia ma mniejsze znaczenie niż miejsce: musi być w HTML-u, który otrzymuje Google, a nie dodany efektem po stronie klienta.
<meta name="robots" content="noindex">Dla wszystkiego, co nie jest HTML-em, nie ma meta tagu, więc użyj nagłówka:
X-Robots-Tag: noindexTo obejmuje eksporty PDF, odpowiedzi JSON, generowane obrazy i pobierane pliki CSV. Jeśli te pliki serwuje CDN, ustaw nagłówek na brzegu, żeby nowe trasy dziedziczyły regułę.
Dla całej rodziny tras reguła warstwy pośredniej jest zwykle czystsza niż dotykanie każdego szablonu:
// Przykład dla Express: noindex na wszystkich generowanych URL-ach do udostępniania
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Oczekiwany wynik. Wdrożenie, w którym każda trasa oznaczona jako noindex zwraca dyrektywę w pierwszym bajcie dla anonimowych żądań.
Kontrola jakości. Uruchom curl -sI na opublikowanym URL-u. Powinieneś zobaczyć x-robots-tag: noindex w nagłówkach odpowiedzi, a curl -s powinien pokazać meta tag w źródle strony, zanim wykona się jakikolwiek skrypt.
Ścieżka odzyskania. Jeśli tag pojawia się dopiero po wykonaniu JavaScriptu, przenieś go do renderowania serwerowego. Jeśli framework nie renderuje tagów head dla każdej trasy, użyj nagłówka. Nie publikuj noindex wstrzykniętego przez JS i nie zakładaj, że działa: Google opisuje zachowanie renderowanego noindex jako nieokreślone.
W tym samym pull requeście są jeszcze dwie rzeczy. Usuń trasy noindex z sitemapy, bo wysyłanie URL-a, którego nie chcesz indeksować, to sprzeczność, którą Google rozstrzygnie na swoją korzyść. I dodaj regułę wygasania: gdy link do udostępniania umiera, zwracaj 410, zamiast trzymać stronę z kodem 200 i pustym stanem.
Krok 4: sprawdź, czy Googlebot widzi dyrektywę
Nic z powyższego nie zostało zweryfikowane, dopóki nie sprawdzisz tego tak, jak robi to Google.
Najpierw sprawdź nagłówki odpowiedzi:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagPotem źródłowy HTML, zanim wykona się jakikolwiek skrypt:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Na koniec upewnij się, że robots.txt nie blokuje ścieżki. Jeśli blokuje, Google nigdy nie zaindeksuje strony i nigdy nie przeczyta dyrektywy:
curl -s https://example.com/robots.txtSearch Console to test ostateczny. Poproś o sprawdzenie URL w narzędziu „Sprawdzenie adresu URL" i przeczytaj werdykt.
Poprawny wynik to „Strona nie jest zaindeksowana: wykluczono przez tag 'noindex'". Wynik, który pokazuje, że wpadłeś w pułapkę, to „Zaindeksowano, ale zablokowano przez robots.txt": Google ma URL, nie może przeczytać dyrektywy i może nadal go pokazywać. Jeśli to widzisz, usuń regułę z robots.txt i pozwól noindex zadziałać.
Możesz też pobrać stronę tak, jak widzi ją Googlebot, za pomocą symulatora crawlera. To szybsze niż czekanie na nowe indeksowanie, gdy weryfikujesz dwadzieścia tras: Googlebot Spider Simulator.
Oczekiwany wynik. Każda trasa noindex pokazuje status wykluczenia przez noindex w ciągu kilku dni od następnego indeksowania. Trasy utworzone po zmianie nie powinny w ogóle pojawić się w indeksie.
Ścieżka odzyskania. Jeśli URL jest nadal zaindeksowany po dwóch tygodniach, sprawdź, czy Google może go zaindeksować, czy strona zwraca 200 dla Googlebota i czy jakiś tag canonical lub hreflang nie kieruje wyszukiwarek gdzie indziej. Używaj narzędzia „Usuwanie" tylko jako tymczasowej blokady, dopóki naprawiasz przyczynę; nie zastępuje ono dyrektywy.
Gdy strona do udostępniania jest kanałem wzrostu
Niektóre generowane strony naprawdę powinny być indeksowane, a noindex na wszystko to strzał w stopę. Oto te, które warto chronić:
Wzorzec | Dlaczego zasługuje na indeks | Zabezpieczenie |
|---|---|---|
Publiczne galerie szablonów | Użytkownicy publikują projekt, inni go używają; wynik jest unikalny i trwały | Moderacja nowych zgłoszeń |
Kreatory z publicznymi stronami prezentacyjnymi | Prawdziwy wynik z oznaczeniem „built with" jest kanałem dystrybucji | Trzymaj szablon prezentacyjny osobno od strony marketingowej |
Dokumentacja wyrastająca z wątków użytkowników | Powtarzające się pytanie zasługuje na trwałą, zredagowaną odpowiedź | Indeksuj wyselekcjonowaną odpowiedź, nie surową rozmowę |
Jeśli jesteś w jednej z tych kategorii, starsza wskazówka Google nadal obowiązuje i jest najlepszą dźwignią: noindex na treściach użytkowników bez reputacji, a potem otwarcie, gdy konto ma historię. To daje odporność na spam bez rezygnacji z pętli zaangażowania, i dokładnie ten wzorzec przewodnik zalecał przed tą aktualizacją.
Test dla wszystkich trzech jest ten sam. Jeśli strona zbiera wyświetlenia w Skuteczności w wyszukiwarce za zapytania, które wpisałby obcy, należy do indeksu. Jeśli wyświetlenia pochodzą tylko z własnego ciągu URL i znikąd więcej, nie należy.
Jest jeszcze efekt drugiego rzędu, który warto nazwać. Publiczne URL-e do udostępniania były przez lata tanią powierzchnią pod linki: utwórz stronę na platformie z silną domeną, umieść link do własnej witryny, powtórz na dwudziestu usługach. Patrick Stox naliczył ponad 20 linków z różnych platform w samym wątku. Jeśli platformy posłuchają wskazówki, ta powierzchnia się zwęzi. Jeśli nie, Google ma teraz dokument, na który może się powołać, gdy następnym razem uzna te strony za spam.
Krok 5: instrumentuj schemat, który opisał Google
Sekcja o monitoringu to ta część aktualizacji, którą większość zespołów pominie, i dokładnie ta, która łapie realny incydent, zanim stanie się ręczną akcją.
Cztery kontrole, każda z miejscem, gdzie patrzeć.
Usługa w Search Console. Zweryfikuj witrynę lub subdomenę, żeby ostrzeżenia o ręcznych działaniach i bezpieczeństwie przychodziły mailem. Jeśli prowadzisz platformę z subdomenami dla każdego najemcy, zweryfikuj nadrzędną i co najmniej próbkę podrzędnych; ostrzeżenie, które nigdzie nie trafia, nie jest monitoringiem.
Trend indeksowania stron. Dzisiaj zapisz punkt odniesienia liczby zaindeksowanych URL-i dla każdej generowanej trasy i obserwuj skoki schodkowe, nie szum. Podwojenie liczby zaindeksowanych URL-i w ciągu tygodnia na trasie, która powinna być statyczna, to sygnał.
Anomalie w Skuteczności w wyszukiwarce. Filtruj zapytania niezwiązane z produktem. Spamowe strony przyciągają spamowe zapytania na długo przed tym, jak ktokolwiek się poskarży.
Stosunek tworzenia do indeksacji. To metryka, którą Google nazywa, a prawie nikt nie mierzy: ile indeksowalnych URL-i jedno konto jest w stanie utworzyć dziennie i jaki odsetek nowych takich URL-i pochodzi z 1% najaktywniejszych kont. Próg ostrzegawczy na poziomie 3 median z ostatnich siedmiu dni dla konta jest arbitralny, ale działa; dostrój go do własnego ruchu.
Ten sam stosunek działa jako zabezpieczenie produktu. Jeśli funkcja pozwala użytkownikowi generować tysiąc indeksowalnych URL-i dziennie, to funkcja rozdęcia indeksu, nawet jeśli nikt jej jeszcze nie nadużywa.
Co ta aktualizacja naprawdę mówi
Zdejmij warstwę komunikacyjną — a Google spiera się o propozycję.
Przez dwadzieścia lat polityka spamu opisywała strony: cienkie, zeskrobane, zamaskowane, wypełnione słowami kluczowymi. Te kategorie zakładają, że człowiek albo skrypt decyduje się stronę stworzyć, a Google decyduje, czy zasługuje na ranking. Generowane wyniki łamią ten model. Jedna decyzja produktowa może wygenerować milion URL-i, wszystkie technicznie unikalne, wszystkie technicznie 200, większość bez wartości dla kogokolwiek poza twórcą. Google nie może ich ocenić po kolei i przestał udawać, że może.
Reakcje podzieliły się na dwa obozy. Pierwszy odczytał to jako strzał ostrzegawczy: Marie Haynes pytała, czy pojawią się nowe ręczne działania dla narzędzi AI i kreatorów aplikacji, a Lily Ray odczytała sekcję jako znak, że Google już zmaga się z tym na skalę, cytując artefakty Claude, strony udostępniania ChatGPT i posty w mediach społecznościowych. Drugi wzruszył ramionami. Uważne zespoły od lat trzymają raporty generowane przez użytkowników w noindex, kilka odpowiedzi przekonywało, że problemem są raczej własne generowane strony Google. Oba odczyty mogą być prawdziwe. Wskazówkę czyni istotną nie to, że jest nowa, ale to, że jest teraz zapisana i można się na nią powołać przy egzekwowaniu polityki.
Wskazówka przenosi więc decyzję wyżej w łańcuchu. Od platform oczekuje się decyzji na poziomie szablonu: czy klasa URL należy do indeksu. To pytanie o zarządzanie, nie o SEO, i dlatego porada trafiła do przewodnika po spamie, a nie do dokumentacji indeksowania.
Wyszukiwanie AI stosuje tę samą logikę w obie strony. Funkcje AI Google czerpią z indeksu Google, więc dyrektywa noindex usuwa stronę także z puli i z niebieskich linków. Jeśli generowana strona zbierała cytowania w AI Overviews, spodziewaj się, że to się skończy. W przypadku linku do udostępniania to zwykle dobrze, w przypadku strony szablonu — nie. Inne crawallery AI mają własne reguły, więc osobno zdecyduj, którym z nich pozwolisz indeksować te strony.
Praktyczny wniosek to jedno zdanie, które można przynieść na przegląd projektu: każdy URL, który może utworzyć użytkownik, jest albo powierzchnią produktu, albo zobowiązaniem wobec indeksu, a rozstrzyga o tym szablon.
Najczęstsze pytania
Czy to dotyczy zwykłej strony marketingowej?
Nie, jeśli Twoja witryna nie generuje URL-i na podstawie danych od użytkownika. Strona marketingowa publikuje zbiór stron, o których człowiek zdecydował, że mają istnieć — przeciwieństwo problemu opisanego w przewodniku. Linia o skali wymienia platformy hostingowe i narzędzia pozwalające użytkownikom publikować strony do udostępniania, wygenerowane treści lub aplikacje webowe. Jeśli masz komentarze, forum albo profile członków, obowiązuje starsza wskazówka: nofollow lub ugc na linkach z nieznanych kont i noindex dla nowych użytkowników, dopóki nie zbudują reputacji.
Wykorzystać robots.txt czy meta tag noindex?
noindex, i tylko jedno z dwóch na trasę. Zdanie Google wymienia obie opcje, ale robią różne rzeczy. Disallow w robots.txt blokuje indeksowanie, a URL zablokowany, ale linkowany z zewnątrz, może zostać w wynikach bez fragmentu. noindex działa tylko wtedy, gdy Google może stronę zaindeksować i ją przeczytać. W praktyce oznacza to meta tag albo nagłówek odpowiedzi, nigdy zaś regułę robots.txt na tej samej ścieżce.
Czy stracę ruch, oznaczając strony do udostępniania jako noindex?
Sprawdź trasę przed decyzją, nie po. Jeśli strona zbiera wyświetlenia tylko z własnego ciągu URL, nie przynosi ruchu organicznego i usunięcie jej nic nie kosztuje. Schemat, który traci ruch, polega na usunięciu razem z publiczną galerią tego, co jest w środku. Zostaw galerię w indeksie, ustaw noindex na to, co pod nią, i monitoruj skuteczność w wyszukiwarce dla zapytań o galerię przed zmianą i po.
Czy wyszukiwarki AI respektują noindex?
Funkcje AI Google tak, bo AI Overviews i AI Mode czerpią z tego samego indeksu, więc dyrektywa usuwa stronę i z niebieskich linków, i z odpowiedzi AI. Inne crawallery AI to osobna decyzja. Zachowanie dostawców różni się i zmienia bez dzienników zmian, więc czytaj dokumentację każdego crawlera i pobieraj stronę z jego user agentem, zamiast zakładać, że jedna dyrektywa obejmuje wszystkich.
Autorka: Grace Miller, analityczka ryzyka AI Search w Auspia. Śledzi ponad 200 zmian polityk. Pisze o zasadach platform, ryzyku treści i optymalizacji uwzględniającej polityki.