Penjejak keterlihatan AI kedengaran mudah. Anda tanya pembantu beberapa soalan kategori, catat sama ada jenama anda muncul, dan lukiskan graf sepanjang masa.
Masalahnya terletak di hulu daripada pencatatan. Perkara yang anda ukur tidak duduk diam. Hantar gesaan yang sama kepada model yang sama dua kali dan anda akan dapat dua jawapan yang bertindih hanya sebahagian. Catat salah satu daripadanya dan anda telah mencatat satu sampel daripada taburan, kemudian membentangkannya sebagai fakta.
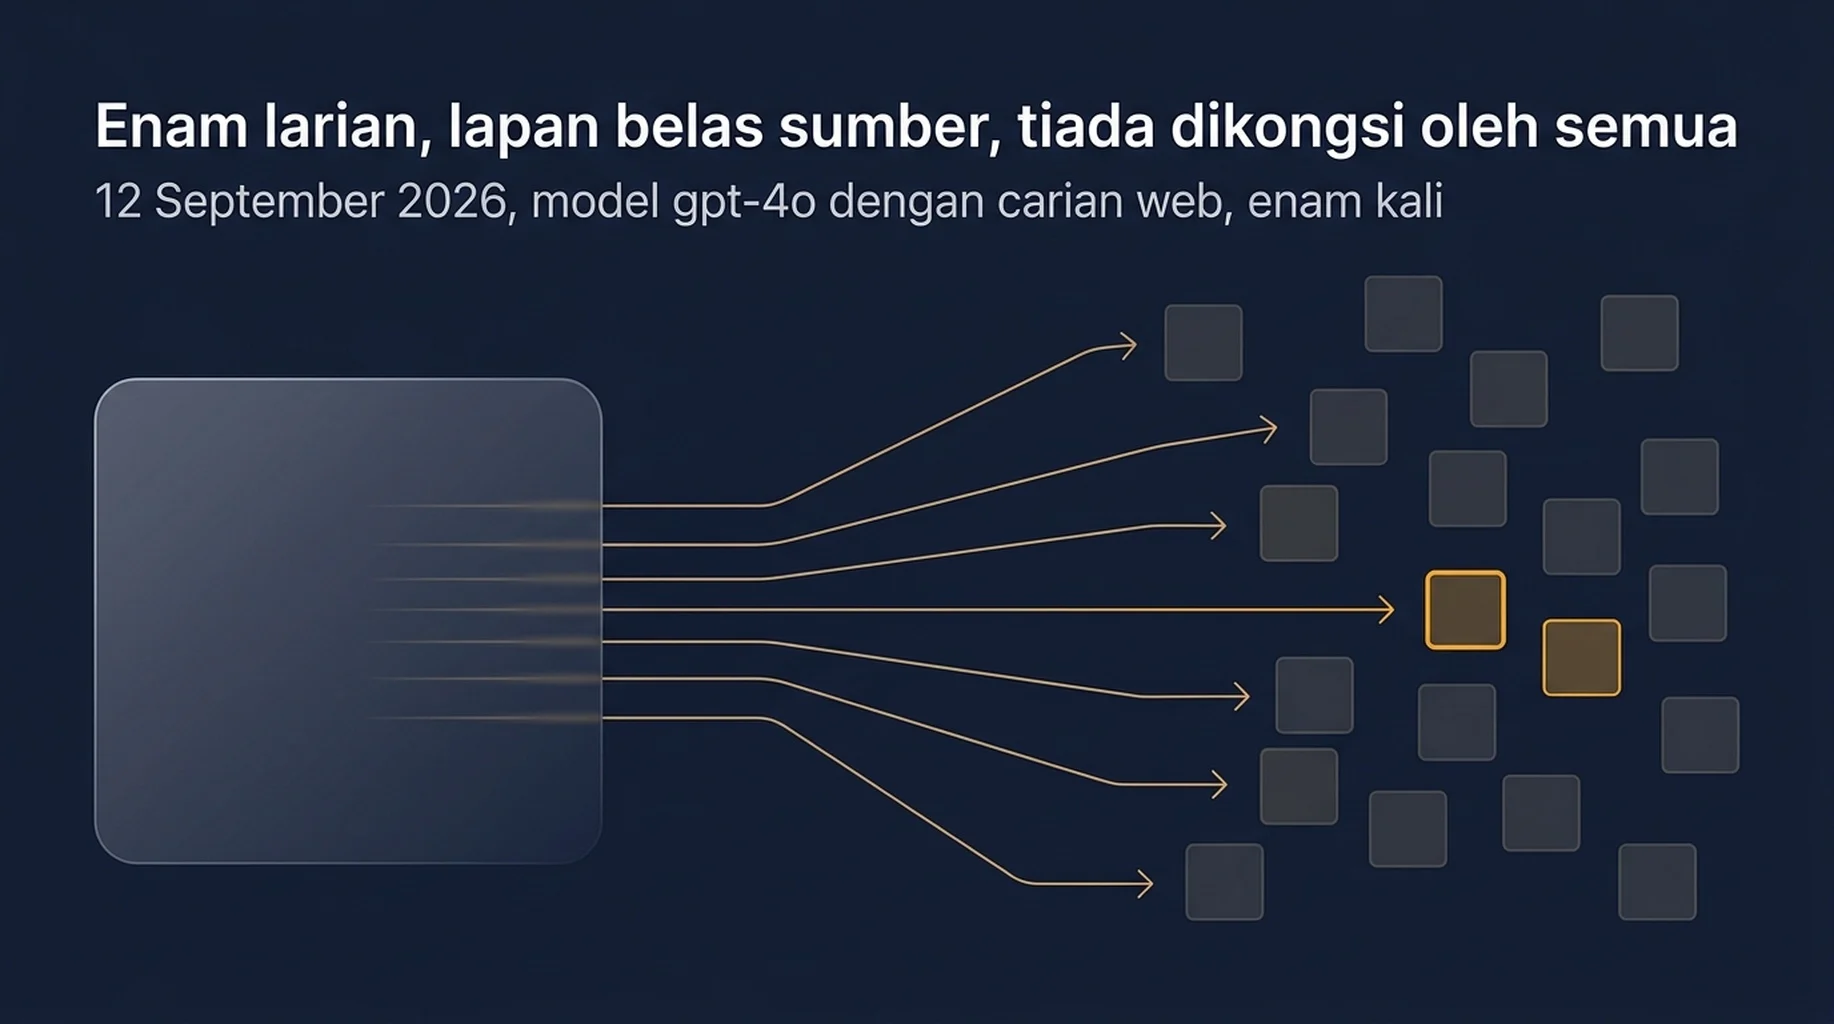
Kami mahu tahu berapa besar serakan itu sebenarnya, jadi kami jalankan eksperimen itu dan bukannya menganggapnya. Versi ringkas: enam permintaan yang serupa menghasilkan lapan belas sumber yang dipetik, dan tiada satu pun sumber dipetik dalam kesemua enam.
Artikel ini membincangkan apa yang kami jalankan, apa yang kembali, dan empat medan yang mesti disimpan oleh penjejak keterlihatan AI supaya angka itu berbaloi dilihat sekali lagi bulan depan.
Apa yang kami jalankan
Dua eksperimen, kedua-duanya menggunakan gesaan yang benar-benar akan digunakan oleh pasukan SaaS dalam kajian kategori.
Eksperimen 1: satu gesaan, satu model, enam larian. Model gpt-4o, carian web dihidupkan, Amerika Syarikat, bahasa Inggeris. Gesaannya: "Apakah alat penjejakan kedudukan terbaik untuk pasukan SaaS kecil pada 2026? Berikan senarai ringkas berserta sumbernya." Enam panggilan langsung yang berasingan, dijalankan berturutan dalam tetingkap sesi yang sama.
Eksperimen 2: dua model, gesaan yang sama, tiga larian setiap satu. Gesaan yang sama dihantar kepada Claude Sonnet 5 dan Gemini 3.8 Flash, tiga kali setiap satu, tanpa carian web. Tanpa carian, apa yang kami ukur ialah produk mana yang model sebut daripada pengetahuannya sendiri, dan itu isyarat yang berbeza daripada sumber mana yang dipetiknya.
Kami juga menghantar gesaan kedua melalui laluan carian web yang sama empat kali, untuk melihat sama ada tingkah laku petikan konsisten merentas jenis soalan: "Bagaimana saya menjejak AI Overviews untuk laman saya? Berikan kaedah konkrit berserta sumbernya."
Enam larian bukan sampel yang besar, dan kami menganggapnya begitu. Ia cukup untuk menunjukkan arah dan magnitud kasar variasi, dan itulah intinya.
Keputusan 1: lapan belas sumber, sifar dikongsi oleh kesemua enam larian
Enam larian carian web itu memetik 18 URL berbeza secara keseluruhan. Berikut ialah kekerapan setiap domain muncul.
Bilangan petikan (daripada 6 larian) | Domain |
|---|---|
5 | cloro.dev |
3 | scalegrowth.digital, techradar.com |
2 | thesharpdigital.com, piperocket.digital, digiinte.com, tajo.io, gtm.help, softwaresift.com |
1 | impressivemagazine.com, theguidex.com, gtmonly.com, honeyb.ai, seo.com, blog.contentforce.ai, crowdreply.io, seomonster.ai, rankpy.com |
Tiada domain dipetik dalam kesemua enam larian. Tiada URL dipetik dalam kesemua enam larian.
Angka yang penting di sini ialah tindihan antara larian. Apabila membandingkan setiap pasangan larian, purata tindihan Jaccard pada URL yang dipetik ialah 0.167. Dalam dua daripada lima belas pasangan, tindihannya tepat sifar, iaitu kedua-dua jawapan itu tidak berkongsi satu pun sumber.
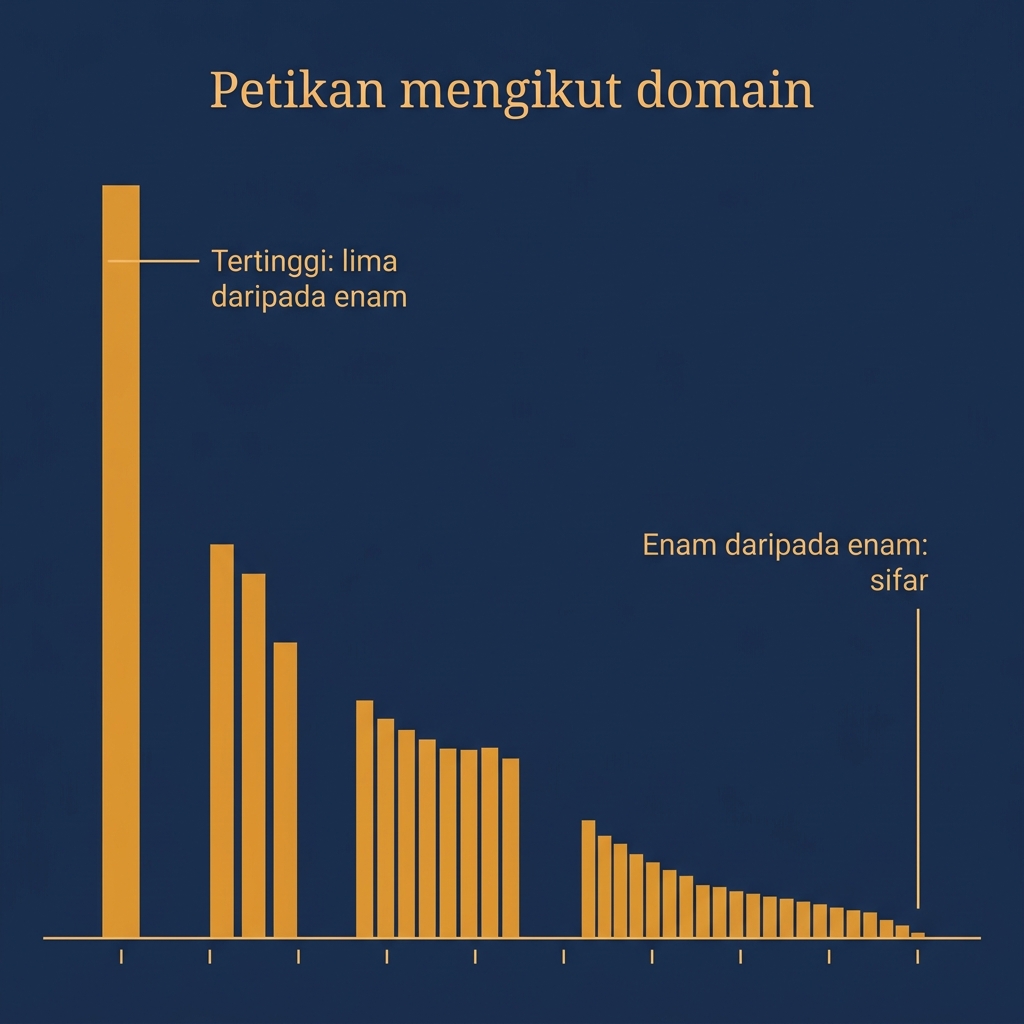
Sumber yang dipetik dalam lima daripada enam larian ialah siling yang kami perhatikan. Tiada apa pun dipetik setiap kali.
Ada penemuan kedua terkubur dalam jadual itu. Domain yang dicapai oleh model sebahagian besarnya bukan laman perbandingan terkenal dalam kategori ini. Sembilan daripada lapan belas domain muncul tepat sekali, dan sebahagian daripadanya ialah laman kecil yang kandungannya terbaca seperti sesuatu yang dihimpun untuk pertanyaan itu, bukan seperti hasil liputan. Bagi jenama, ini pedang bermata dua. Ia bermakna slot petikan lebih mudah dimenangi daripada kedudukan "alat terbaik" lazim. Ia juga bermakna slot itu sedang diisi oleh pihak yang menghasilkan halaman yang sepadan dengan bentuk pertanyaan pada larian itu, dan ia akan diisi semula pada larian berikutnya.
Keputusan 2: jawapan itu sendiri berubah saiz
Petikan bergerak, dan panjang jawapan bergerak bersamanya.
Larian | Token output | Panjang jawapan | Kos larian |
|---|---|---|---|
1 | 505 | 2,153 aksara | $0.0735 |
2 | 860 | 3,728 aksara | $0.0770 |
3 | 1,108 | 4,746 aksara | $0.0797 |
4 | 832 | 3,555 aksara | $0.0765 |
5 | 870 | 3,547 aksara | $0.0772 |
6 | 813 | 3,544 aksara | $0.0768 |
Panjang output berjulat dari 505 hingga 1,108 token, julat 603 token, kira-kira 73 peratus daripada purata. Jawapan terpanjang lebih daripada dua kali jawapan terpendek. Lima daripada enam larian jatuh dalam jalur yang agak sempit antara 813 dan 1,108 token; satu larian berhenti awal pada 505 dan memetik lima sumber dan bukannya sembilan hingga empat belas.
Bagi pengukuran, ini penting secara khusus. Jika penjejak anda menangkap "adakah jenama muncul dalam jawapan, dan pada kedudukan berapa", larian yang pendek mempunyai lebih sedikit slot untuk muncul. Pasukan yang mengambil sampel sekali seminggu dan secara kebetulan mendapat larian pendek akan mencatat keputusan yang lebih buruk daripada pasukan yang mendapat larian panjang, tanpa apa-apa berubah pada laman web.
Keputusan 3: sesetengah gesaan langsung tidak mendapat petikan
Gesaan kedua, tentang menjejak AI Overviews, melalui laluan carian web yang sama empat kali dan kembali dengan sifar petikan setiap kali.
Larian | Token output | Panjang jawapan | Petikan |
|---|---|---|---|
1 | 479 | 2,135 aksara | 0 |
2 | 522 | 2,240 aksara | 0 |
3 | 534 | 2,312 aksara | 0 |
4 | 497 | 2,228 aksara | 0 |
Jawapannya stabil dari segi panjang, hanya berubah 8 peratus merentas empat larian. Tetapi model itu menjawab daripada pengetahuannya sendiri dan tidak menyebut mana-mana sumber, jadi tiada apa yang boleh dicatat dalam lajur petikan.
Daripada itu timbul bacaan penjejak yang khusus dan mengelirukan. Papan pemuka kadar petikan akan menunjukkan sifar untuk soalan ini, dan itu kelihatan seperti kegagalan keterlihatan. Ia bukan. Ini bentuk soalan yang tidak mencetuskan pencarian sumber. Bacaan yang betul ialah "petikan tidak berkenaan", dan penjejak yang tidak dapat membezakannya daripada "petikan diperiksa dan anda tiada" akan membuat anda mengejar masalah yang tidak wujud.
Keputusan 4: menukar model ialah pengukuran lain, bukan pengulangan
Dengan carian web dimatikan, kami mengukur produk mana yang disebut oleh setiap model. Ini mengasingkan set saranan model itu sendiri daripada apa sahaja yang dikembalikan oleh indeks carian pada minit itu.
Claude Sonnet 5 menyebut empat hingga lima produk setiap larian. Merentas tiga larian, ia menyebut enam produk berbeza: AccuRanker, Ahrefs, SEMrush, SE Ranking, Serpstat dan SerpWatcher. Tiga daripadanya muncul dalam ketiga-tiga larian: AccuRanker, Ahrefs dan SEMrush. Purata tindihan berpasangan 0.587.
Gemini 3.8 Flash menyebut dua hingga lima produk setiap larian. Merentas tiga larian, ia menyebut tujuh produk berbeza: AccuRanker, Ahrefs, Looker Studio, Nightwatch, SE Ranking, SEMrush dan Wincher. Hanya satu daripadanya, SE Ranking, muncul dalam ketiga-tiga larian. Purata tindihan berpasangan 0.306.
Antara kedua-dua model, empat produk disebut oleh kedua-duanya dan lima produk disebut oleh satu sahaja.
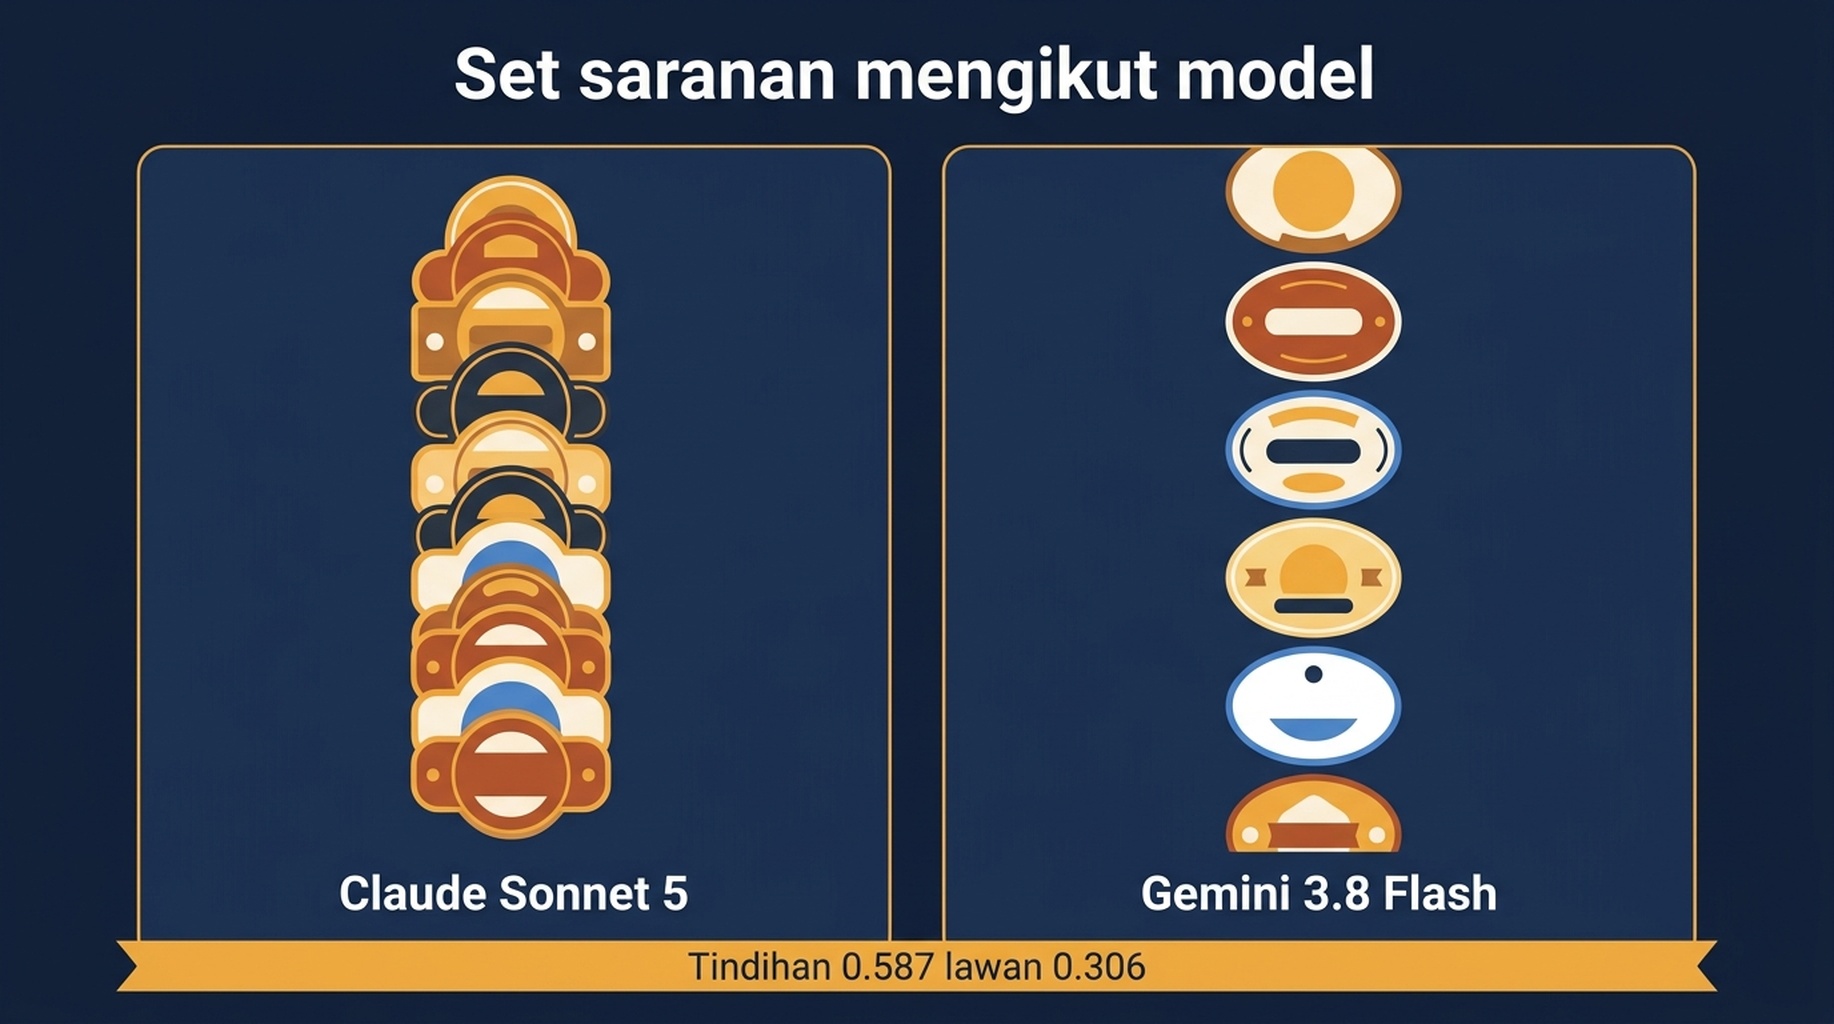
Soalan yang sama menghasilkan set saranan yang berbeza sebahagian pada setiap model dan setiap larian.
Kesimpulan praktikalnya: jika anda menjejak "keterlihatan AI" sebagai satu angka, anda sedang memuratakan sekurang-kurangnya dua sumber variasi yang bebas, iaitu larian dan model. Jenama yang muncul secara konsisten pada satu pembantu dan tidak muncul pada pembantu lain ialah penemuan sebenar yang boleh diambil tindakan. Jenama yang ukuran sampel tunggalnya bergerak dua kedudukan ialah hingar.
Apa yang patut dicatat oleh penjejak keterlihatan AI
Empat medan mengubah tangkapan skrin menjadi pengukuran.
Bilangan larian, bukan keputusan satu larian. Simpan setiap larian dan laporkan julatnya. "Dipetik dalam 4 daripada 6 larian" ialah fakta. "Dipetik, kedudukan 3" ialah kebetulan. Enam larian ialah lantai yang munasabah untuk program kecil; dua belas lebih baik jika gesaan itu penting secara komersial.
Medan petikan berasingan daripada medan sebutan. "Model mengesyorkan kami" dan "model memaut kepada kami" ialah dua keputusan berbeza dengan pembetulan yang berbeza. Enam larian kami menghasilkan 18 petikan daripada 18 URL berbeza; penjejak yang hanya mencatat sebutan jenama tidak akan menangkap apa-apa daripada pergolakan itu.
Status saluran jawapan. Catat sama ada larian itu menggunakan carian web, dan catat panjang jawapan. Larian dengan sifar petikan dan larian dengan sifar sebutan kelihatan serupa pada papan pemuka tetapi bermaksud sebaliknya.
Teks gesaan perkataan demi perkataan, dengan nombor versi. Susunan kata gesaan menentukan sumber mana yang ditarik masuk. Jika gesaan berubah antara bulan, garis trend terputus. Versikan gesaan seperti anda versikan skrip penjejakan.
Membina gelung larian
Pemeriksaan manual tidak bertahan menghadapi satu pertemuan dengan kalendar. Gelung ialah skrip yang menjalankan gesaan N kali, menyimpan setiap respons mentah berserta petikannya, dan membandingkan tetingkap semasa dengan yang sebelumnya.
Ini sesuai untuk ejen kerana kerjanya berulang, terikat pada peraturan dan memerlukan rekod bertulis. Dalam Claude Code atau Codex, arahan yang berguna ialah biarkan larian mentah kekal di cakera dan jangan sekali-kali menimpanya, kemudian laporkan jadual ringkasan dan bukannya satu angka. Jika anda sudah menarik data Search Console dan Bing melalui pelayan MCP, sesi yang sama boleh menyimpan log petikan di sebelah data tayangan, dan di situlah kedua-dua angka mula berguna bersama. Catatan kami tentang apa yang didedahkan pelayan itu ada di apa sebenarnya yang dilakukan empat pelayan SEO MCP, dan sisi kehadiran masalah yang sama ada di gambaran AI Overview empat puluh pertanyaan kami.
Satu peraturan reka bentuk lebih penting daripada yang lain: output penjejak sepatutnya ialah taburan. Laporkan "dipetik dalam 4 daripada 6", bukan "dipetik". Laporkan senarai sumber, bukan sumber nombor satu. Papan pemuka mana pun yang memampatkan enam larian menjadi satu angka sudah membuang satu-satunya maklumat yang dibeli oleh larian tambahan itu.
Jika matlamatnya perbandingan pesaing dan bukan pemantauan, gelung penjejakan kedudukan sepanjang masa ialah alat yang lebih sesuai, dan pertukaran antara sumber data ada di membina penjejak kedudukan daripada dua sumber.
Had sampel enam larian
Tiga kaveat yang jujur.
Sampelnya kecil. Enam larian hanya membingkaikan serakan secara longgar. Ia menetapkan bahawa tindihan antara larian adalah sebahagian dan pasangan tanpa tindihan memang berlaku; ia tidak memberi anda selang keyakinan untuk kategori anda.
Keputusannya terikat pada masa. Larian ini dijalankan pada 12 September 2026 terhadap model yang aktif ketika itu. Model mahupun hasil carian di bawahnya sama-sama berubah.
Domain yang dipetik ialah sampel daripada satu gesaan komersial. Bentuk soalan yang berbeza, seperti soalan perbandingan atau soalan cara, akan menghasilkan corak petikan yang berbeza. Langkah yang berguna ialah menjalankan reka bentuk yang sama pada sepuluh gesaan anda yang paling penting secara komersial dan mencatat bagaimana kategori anda bertindak.
Soalan lazim
Berapa banyak larian yang saya perlukan sebelum angka keterlihatan AI bermakna? Enam ialah lantai praktikal untuk satu gesaan, dan angkanya harus dilaporkan sebagai kiraan daripada bilangan larian, bukan sebagai kedudukan. Jika gesaan itu memandu keputusan hasil, dua belas larian memberi bacaan yang lebih rapat dengan kos beberapa dolar.
Adakah ini bermakna menjejak keterlihatan AI tidak berbaloi? Ia bermakna menjejak dengan sampel tunggal tidak berbaloi. Variasinya itulah penemuannya. Penjejak yang melaporkan "dipetik dalam 4 daripada 6 larian, sumbernya berubah 12 domain sejak bulan lalu" sedang menerangkan sistem sebenar yang sedang direbut oleh pesaing.
Mengapa satu gesaan kembali dengan sifar petikan? Model itu menjawab daripada pengetahuannya sendiri dan bukannya membuat carian sumber. Itu sifat soalan itu, bukan kegagalan laman anda. Jejak sebagai tidak berkenaan, bukan sebagai sifar.
Patutkah saya menjejak ChatGPT, Claude dan Gemini secara berasingan? Ya. Dalam perbandingan tiga larian kami, kedua-dua model hanya bertindih pada empat daripada sembilan produk yang disebut. Pemurataan menyembunyikan keputusan peringkat program tentang pembantu mana yang perlu dioptimumkan dahulu.
Bolehkah variasi dikurangkan dengan menurunkan suhu model? Sebahagiannya boleh, dan berbaloi diuji pada gesaan anda sendiri. Tetapi set petikan juga digerakkan oleh indeks carian, dan itu di luar kawalan anda. Bilangan larian ialah tuas yang lebih boleh dipercayai.
Pandangan Auspia: jika anda membina penjejakan keterlihatan AI pada suku ini, bina log larian sebelum papan pemuka. Papan pemuka ialah pilihan paparan. Log larian ialah pengukurannya. Mulakan dengan sepuluh gesaan, enam larian setiap satu, disimpan perkataan demi perkataan, dan dalam seminggu anda akan belajar lebih banyak daripada apa yang boleh diberitahu oleh pemeriksaan sampel tunggal selama setahun.
Penulis: Ethan Marlowe, menerajui pengukuran GEO merentas lebih 500 gesaan di Auspia. Menulis tentang penjejakan gesaan, laporan petikan, dan papan pemuka keterlihatan yang bertahan menghadapi kitaran pengukuran sebenar.