Peraturan yang baru ditulis Google
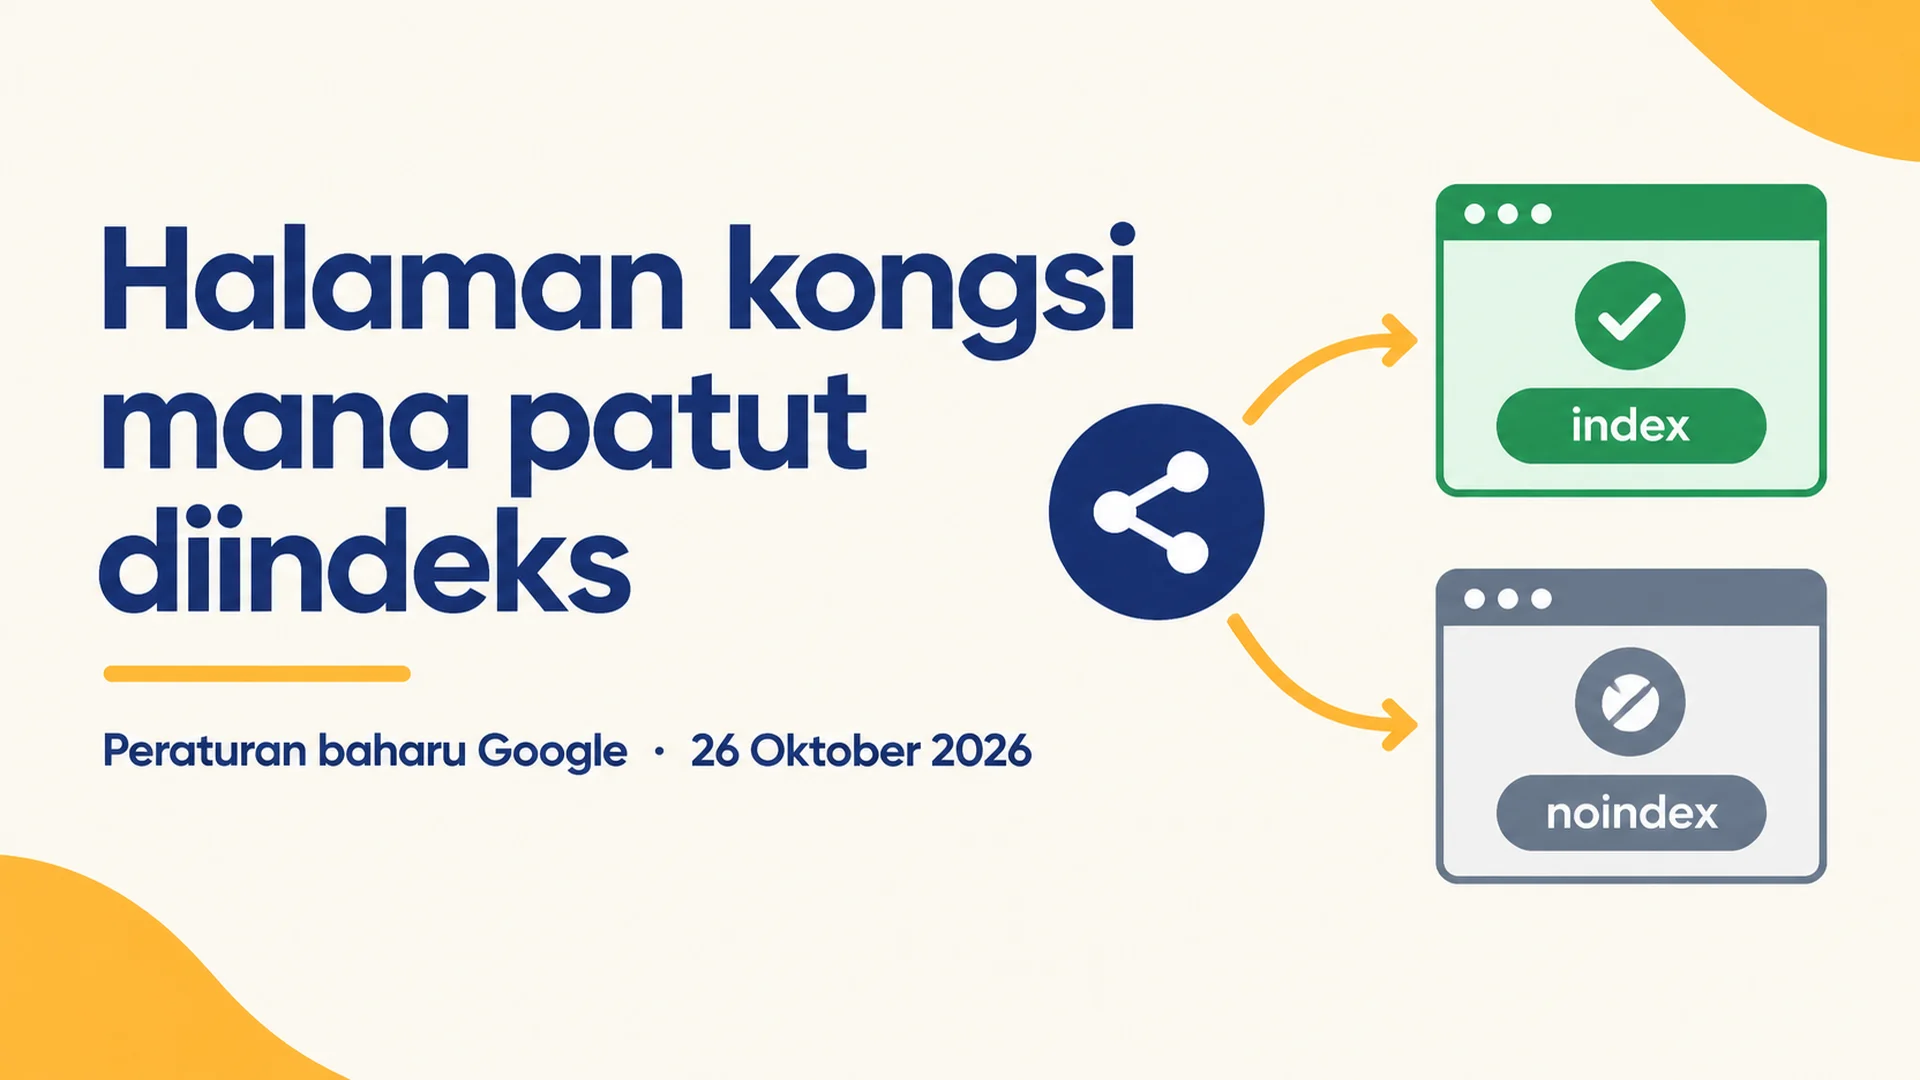
Pada 26 Oktober 2026, Google menambah satu bahagian dua perenggan dalam panduannya tentang cara mengelakkan spam yang dijana pengguna. Ia bahagian terpendek pada halaman itu dan mungkin bahagian yang paling banyak mengubah peta jalan produk, kerana ia mengajukan soalan yang kebanyakan pasukan tidak pernah letakkan pada slaid: patutkah URL ini berada dalam indeks Google langsung?
Bahagian itu bertajuk "Only index content meant for Search" — indeks hanya kandungan yang dimaksudkan untuk Carian. Diterjemahkan, begini bunyinya:
Jika perkhidmatan anda membenarkan pengguna mencipta halaman untuk dikongsi, hasil yang dijana atau alat interaktif, pertimbangkan sama ada kandungan itu dibina untuk ditemui oleh enjin carian, atau hanya untuk dibuka terus oleh seseorang melalui pautan.
Apabila halaman dicipta untuk perkongsian terus, kerjasama atau kegunaan praktikal dan bukan untuk ditemui dalam carian awam, gunakan noindex secara lalai (melalui meta tag robots atau pengepala HTTP X-Robots-Tag) atau sekat crawling dalam robots.txt secara lalai.
Log perubahan Google pada hari yang sama menyatakan niatnya secara langsung: panduan itu dikemas kini dengan "panduan tentang cara menyekat pengindeksan kandungan yang dikongsi melalui pautan dan cara memantau penyalahgunaan dalam Search Console", supaya platform boleh "mengekalkan halaman janaan pengguna yang tidak dimaksudkan untuk Carian di luar indeks dan mengesan spam lebih awal".
Itu sahaja. Tiada tindakan manual baharu, tiada pengumuman sistem kedudukan, tiada senarai hukuman. Ada satu saranan tentang nilai lalai — dan hampir setiap insiden pengindeksan lahir daripada nilai lalai.
Untuk siapa ini. Untuk pasukan yang menerbitkan mana-mana URL yang boleh dicipta pengguna: pautan kongsi, sembang yang disimpan, papan pemuka awam, pratonton model, binaan aplikasi, laporan yang dijana, utas forum, halaman profil, halaman ulasan, halaman senarai.
Apa yang anda dapat. Satu keputusan bagi setiap laluan dan setiap jenis URL yang dijana, kawalan yang benar-benar membuang halaman daripada indeks, dan satu peraturan pemantauan yang menangkap corak penyalahgunaan yang diterangkan Google.
Masa. Antara 45 dan 90 minit untuk pusingan pertama dalam satu produk. Sehari jika anda mempunyai beberapa penjana URL dan tiada inventori laluan.
Rupa "selesai". Setiap laluan yang dijana ditanda index, noindex atau peribadi. Laluan noindex memulangkan arahan daripada pelayan, bukan selepas JavaScript dijalankan. Search Console menunjukkan URL tersebut sebagai dikecualikan kerana noindex, bukan "Diindeks tetapi disekat oleh robots.txt".
Apa yang berubah dan apa yang cuma kelihatan baharu
Empat perubahan yang penting. Selebihnya halaman itu tidak berganjak, termasuk nasihat Disember 2025 yang masih terpakai.
Apa yang diubah Google | Teks sebenar | Mengapa ia penting untuk anda |
|---|---|---|
Skop panduan | Kini menyebut platform pengehosan dan "alat yang membenarkan pengguna menerbitkan halaman untuk dikongsi, kandungan yang dijana atau aplikasi web" | Secara literal ini merangkumi eksport sembang AI, halaman artifak, pembina aplikasi dan alat tanpa kod, bukan hanya forum dan komen |
Unit penyalahgunaan | Penghantar spam boleh mencipta "sejumlah besar halaman atau laman" | Google bercakap tentang skala, bukan kepintaran. Satu akaun yang disalahgunakan boleh mencetak ribuan URL |
Bahagian baharu | "Only index content meant for Search" | Pernyataan paling jelas setakat ini bahawa noindex ialah nilai lalai yang munasabah untuk kandungan yang hanya boleh dicapai melalui pautan |
Pemantauan | Sahkan laman atau subdomain dalam Search Console, pantau lonjakan pada graf Pengindeksan halaman dan Prestasi carian, beri amaran apabila "beberapa pengguna" mencipta "sebahagian besar URL yang boleh diindeks" | Pembengkakan indeks kini mempunyai kaedah pengesanan yang bernama — dan biasanya inilah yang mendahului sesuatu bentuk penguatkuasaan |
Apa yang tidak berubah: noindex untuk catatan pengguna baharu sehingga mereka membina reputasi, dan nofollow atau ugc pada pautan dalam kandungan yang tidak dipercayai. Jika anda sudah melakukan kedua-duanya, anda mendahului kemas kini ini.
Perlu dinyatakan terus, kerana reaksi di X mendahului dokumen: ini panduan untuk platform tentang stok URL mereka sendiri. Ia tidak mencipta pelanggaran baharu untuk laman pemasaran biasa dan tidak mengubah kedudukan mana-mana halaman. Ia mengubah apa yang patut berada dalam indeks.
Satu keping konteks menjelaskan masa. Pada akhir Julai 2026, pautan kongsi dan halaman artifak Claude mula muncul dalam indeks Google, dan laporan pada masa itu menyebut rekod perubatan, kunci API dan bahan peribadi lain terdedah secara terbuka sebelum Anthropic menutup jurang itu dalam beberapa hari. Laporan yang sama menyebut URL aplikasi awam pada pembina seperti Replit dan Lovable. Google jarang menulis bahagian panduan baharu berdasarkan hipotesis. Ia sudah berlaku.
Soalan yang menentukan setiap URL yang dijana
Ujian Google muat dalam satu ayat, dan boleh digunakan tanpa meneka niat: adakah kandungan ini dibina untuk ditemui oleh enjin carian, atau hanya untuk dibuka oleh seseorang yang mempunyai pautan?
Dalam praktiknya, empat isyarat menjawabnya. Nilai laluan, bukan halaman individu.
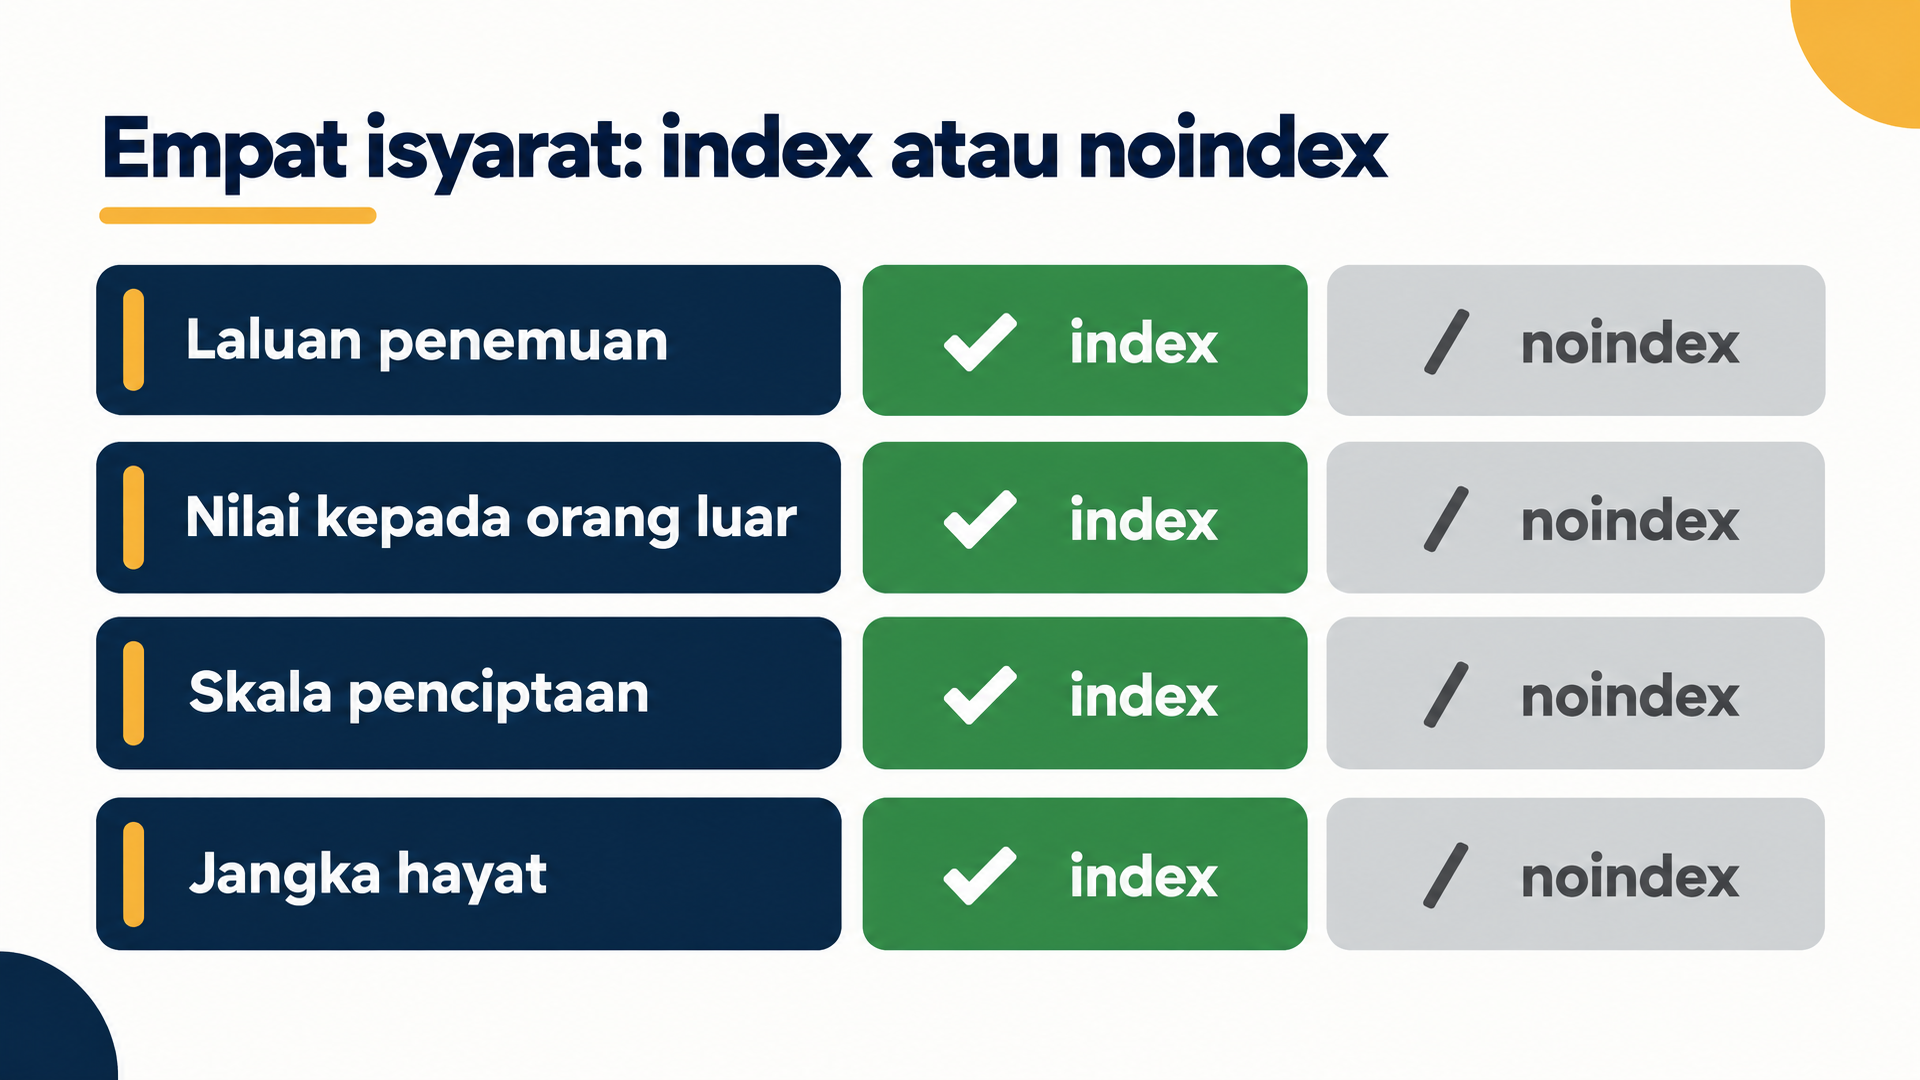
Isyarat | Condong ke index | Condong ke noindex |
|---|---|---|
Laluan penemuan | Pautan daripada galeri awam, sitemap, halaman kategori atau profil | Hanya boleh dicapai melalui pautan yang disalin atau butang "kongsi" |
Nilai kepada orang luar | Berguna tanpa mengenali penulisnya | Bermakna hanya kepada penulis, pasukannya atau penerima |
Skala penciptaan | Satu halaman bagi setiap topik atau satu set yang dikurasi | Ribuan URL daripada satu akaun, kebanyakannya hampir serupa |
Jangka hayat | Kekal tepat selama berbulan-bulan | Sekelip mata: sembang, binaan, draf, eksport sementara |
Tiga daripada empat condong ke noindex bermakna keputusan jelas. Keputusan bercampur biasanya bermaksud laluan itu perlu dipecahkan: satu galeri awam yang patut diindeks dan hasil individu di bawahnya yang tidak. Pemecahan ini jawapan betul yang paling biasa dan juga langkah yang paling kerap terlepas, kerana ia memerlukan dua templat dan bukan satu bendera.
Satu ujian penolakan yang berguna: jika orang luar melihat URL ini dalam hasil carian tanpa konteks, adakah tajuk dan petikan masuk akal baginya? "Sembang dengan Sam, 24 Okt" — tidak. "Templat invois untuk pereka bebas" — ya. Penolakan itu bukan tentang kualiti. Ia tentang sama ada halaman dibina untuk ditemui atau dibina untuk dihantar.
Pilih kawalan yang benar-benar membuang URL
Di sinilah seseorang boleh mengikut nasihat baharu secara literal dan masih gagal. Google menawarkan dua pilihan dalam satu ayat, dan kedua-duanya tidak setara.
robots.txt mengawal crawling. Ia tidak membuang URL daripada indeks, dan Google sendiri menyatakan perkara ini dalam pengenalan kepada robots.txt: halaman yang disekat di situ "mungkin masih diindeks jika laman lain memaut kepadanya" — dan dalam kes itu URL, dan mungkin teks pautan, boleh muncul dalam hasil tanpa penerangan.
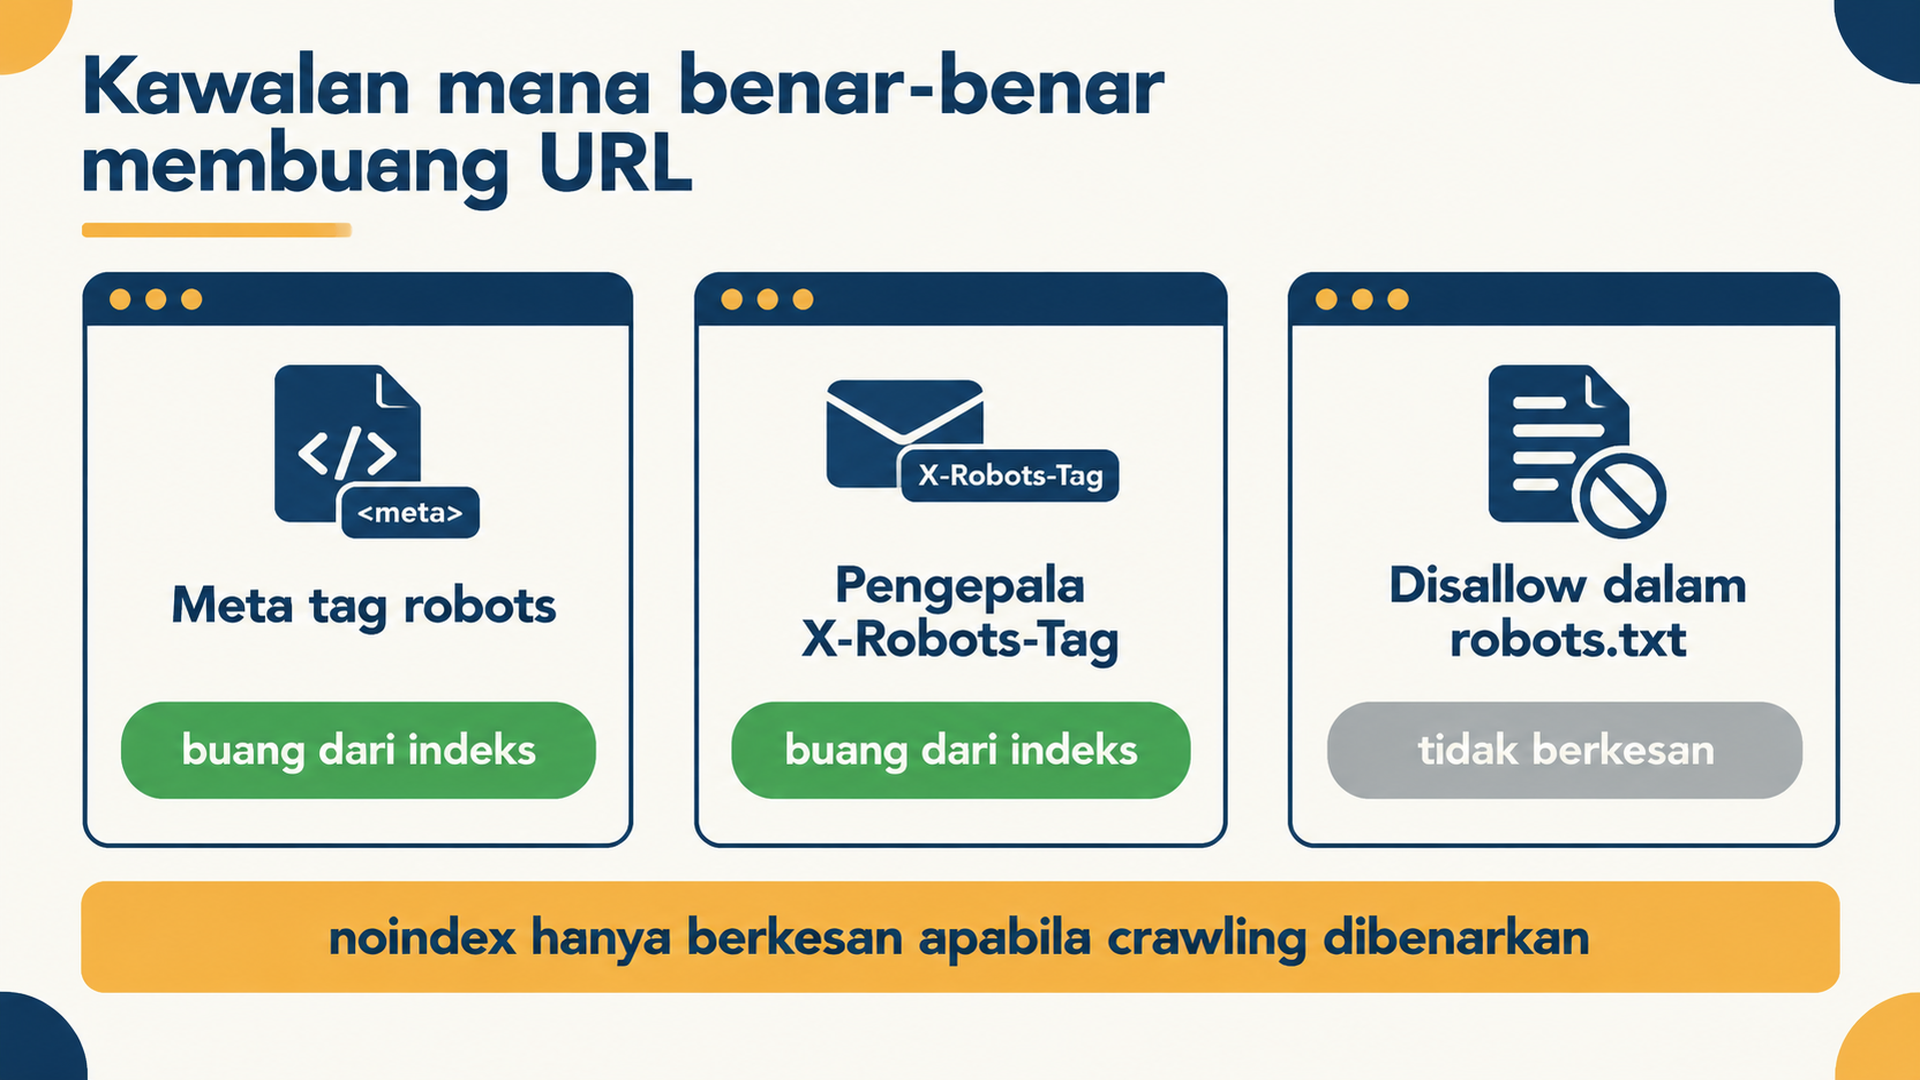
noindex mengawal pengindeksan, tetapi hanya jika Google boleh crawl halaman itu dan membaca arahan tersebut. Dokumentasi Google tentang noindex jelas: untuk peraturan itu berkesan, halaman tidak boleh disekat dalam robots.txt, kerana jika tidak "crawler tidak akan pernah melihat peraturan noindex".
Gabungkan kedua-dua fakta, dan urutan mula penting.
Kawalan | Membuang URL daripada indeks | Gagal di mana | Untuk apa |
|---|---|---|---|
Pengepala respons | Ya, selepas Google crawl dan membacanya | Apa-apa yang disekat dalam robots.txt atau di belakang log masuk | Respons bukan HTML (PDF, JSON, imej) dan peraturan di edge atau CDN untuk banyak laluan |
| Ya, selepas Google crawl dan membacanya | Tag yang dimasukkan JavaScript selepas dimuatkan; halaman yang disekat dalam robots.txt | Halaman kongsi HTML yang dirender di sebelah pelayan |
Disallow dalam | Tidak | URL yang dipautkan mungkin kekal dalam indeks tanpa petikan | Mengurangkan beban crawl, bukan privasi |
Log masuk atau URL bertandatangan | Ya, dengan menjadikan akses mustahil | Memerlukan halaman benar-benar peribadi | Semua yang mengandungi data orang lain |
410 selepas tempoh tamat | Ya, lama-kelamaan | Lebih perlahan daripada 404; tidak berkesan selagi URL masih memberi respons | Kongsi dan binaan sementara |
Satu jalan pintas yang patut dielakkan: X-Robots-Tag: none bukan nilai neutral. Google menganggapnya sebagai noindex tambah nofollow. Kadangkala itulah yang anda mahu, tetapi pasukan sering menyalinnya daripada konfigurasi proksi tanpa menyedarinya.
Jalan pintas kedua yang patut dielakkan: tag canonical. Canonical ialah petunjuk. Jika halaman tidak sepatutnya berada dalam indeks, tulis noindex.
Langkah 1: Inventori laluan yang mencipta URL
Seseorang tidak boleh mengelaskan apa yang tiada dalam senarai, dan kebanyakan pasukan memandang rendah bilangannya kerana mereka berfikir tentang ciri, bukan corak laluan.
Buka router atau peta URL dan senaraikan setiap segmen dinamik. Tersangka biasa kelihatan begini:
/s/:id,/share/:id,/p/:token/chat/:id,/conversation/:id,/thread/:id/u/:handle,/profile/:handle/app/:id,/build/:id,/project/:id/r/:slug,/preview/:token,/report/:id
Kemudian bandingkan dengan apa yang Google sudah tahu, kerana kod dan indeks akan berbeza.
Daripada sitemap. Muat turun dan kira:
curl -s https://example.com/sitemap.xml | grep -c "<loc>"
curl -s https://example.com/sitemap.xml | grep -oE "https://[^<]+" | sed -E 's#https://[^/]+##' | cut -d/ -f2 | sort | uniq -c | sort -rn
Arahan kedua memberikan histogram anggaran mengikut awalan laluan. Jika laluan yang dijana ada dalam sitemap anda, itu sudah satu kesilapan: sitemap ialah senarai halaman yang anda minta Google indeks.
Daripada Search Console. Buka laporan Pengindeksan halaman, tapis mengikut awalan URL bagi setiap laluan calon dan catat angka. Ini satu-satunya sumber yang memberitahu apa Google sebenarnya lakukan dengan URL tersebut.
Daripada log pelayan. Kumpulkan permintaan Googlebot mengikut awalan:
grep -i "Googlebot" access.log | awk '{print $7}' | cut -d/ -f2 | sort | uniq -c | sort -rn | head -20Hasil dijangka. Senarai corak laluan dengan kiraan URL di sebelahnya, diambil daripada sekurang-kurangnya dua sumber.
Semakan kualiti. Setiap laluan yang boleh memulangkan 200 kepada orang di luar pasukan mesti ada dalam senarai. Jika angka daripada sitemap dan Search Console berbeza lebih daripada beberapa peratus bagi satu awalan, ketahui sebabnya sebelum mengubah apa-apa.
Jika tiada apa ditemui. Anda mungkin mempunyai router di sebelah klien. Cari definisi laluan dalam frontend, bukan backend, dan lihat tab rangkaian pada pautan kongsi sebenar.
Langkah 2: Kelaskan setiap laluan dalam jadual, bukan dalam mesyuarat
Tulis keputusan di tempat orang boleh membacanya. Satu baris bagi setiap corak laluan sudah cukup.
Laluan | Siapa yang mencipta | Laluan penemuan | Nilai kepada orang luar | Keputusan | Kawalan | Pemilik |
|---|---|---|---|---|---|---|
| Mana-mana pengguna | Pautan sahaja | Tiada | noindex | Pengepala | Platform |
| Kurasi | Pautan dalaman, sitemap | Tinggi | index | Tiada | Kandungan |
| Mana-mana pengguna | Pautan daripada profil | Rendah selagi tidak aktif | noindex sehingga reputasi terbina | Meta | Kepercayaan dan keselamatan |
| Mana-mana pengguna | Pautan sahaja | Tiada | noindex | Pengepala | Platform |
| Editor | Sitemap | Tinggi | index | Tiada | Kandungan |
Jadual ini berkesan hanya jika tiga perkara benar.
Satu orang bertanggungjawab setiap baris. Pemilikan kabur ialah sebab laluan yang dijana kekal dalam indeks bertahun-tahun.
Catat kawalan di sebelah keputusan, bukan selepasnya. "noindex" bukan keputusan sehingga seseorang tahu sama ada ia pengepala, perubahan templat atau peraturan CDN.
Catat pengecualian. Jika sesuatu laluan dikehendaki noindex tetapi subset kecil patut awam, tulis syarat subset itu sekarang. Memotongnya enam bulan kemudian ialah jalan yang akhirnya menyebabkan peraturan noindex dibuang sepenuhnya, secara senyap.
Langkah 3: Hantar kawalan pada peringkat templat
Pembaikan halaman demi halaman tidak bertahan melepasi penggunaan seterusnya. Gunakan kawalan di tempat laluan dirender.
Untuk halaman HTML, letakkan tag dalam head yang dirender di sebelah pelayan. Dalam Next.js App Router ia metadata; dalam Astro ia head layout; dalam Rails atau Django ia templat layout. Sintaks tepat kurang penting daripada tempat: ia mesti berada dalam HTML yang diterima Google, bukan ditambah oleh kesan di sebelah klien.
<meta name="robots" content="noindex">Untuk semua yang bukan HTML, tiada meta tag, jadi gunakan pengepala:
X-Robots-Tag: noindexIni merangkumi eksport PDF, respons JSON, imej yang dijana dan muat turun CSV. Jika fail ini dihidangkan oleh CDN, tetapkan pengepala di edge supaya laluan baharu mewarisi peraturan itu.
Untuk seluruh keluarga laluan, peraturan middleware biasanya lebih bersih daripada menyentuh setiap templat:
// Contoh Express: noindex pada semua URL kongsi yang dijana
app.use(['/s', '/share', '/report'], (req, res, next) => {
  res.set('X-Robots-Tag', 'noindex');
  next();
});
Hasil dijangka. Satu penggunaan di mana setiap laluan yang ditanda noindex memulangkan arahan dalam bait pertama untuk permintaan tanpa nama.
Semakan kualiti. Jalankan curl -sI pada URL yang diterbitkan. Anda sepatutnya melihat x-robots-tag: noindex dalam pengepala respons, dan curl -s sepatutnya menunjukkan meta tag dalam sumber sebelum mana-mana skrip dijalankan.
Laluan pemulihan. Jika tag hanya muncul selepas JavaScript dijalankan, pindahkannya ke rendering sebelah pelayan. Jika rangka kerja tidak merender tag head untuk setiap laluan, gunakan pengepala. Jangan terbitkan noindex yang dimasukkan melalui JS dan jangan anggap ia berkesan: Google menerangkan tingkah laku noindex yang dirender sebagai tidak menentu.
Ada dua lagi perkara dalam pull request yang sama. Buang laluan noindex daripada sitemap, kerana menghantar URL yang anda tidak mahu diindeks ialah percanggahan yang Google akan selesaikan menurut kepentingannya sendiri. Dan tambah peraturan tamat tempoh: apabila pautan kongsi mati, pulangkan 410 daripada menyimpan halaman pada 200 dengan keadaan kosong.
Langkah 4: Sahkan bahawa Googlebot dapat melihat arahan itu
Tiada apa-apa di atas disahkan sehingga anda menyemaknya seperti cara Google menyemak.
Mula-mula lihat pengepala respons:
curl -sI https://example.com/s/abc123 | grep -i x-robots-tagKemudian sumber HTML, sebelum mana-mana skrip berjalan:
curl -s https://example.com/s/abc123 | grep -i 'name="robots"'Akhir sekali pastikan robots.txt tidak menyekat laluan itu. Jika ia menyekat, Google tidak akan pernah crawl halaman itu dan tidak akan pernah membaca arahan tersebut:
curl -s https://example.com/robots.txtSearch Console ialah ujian muktamad. Minta pemeriksaan URL dalam alat Pemeriksaan URL dan baca keputusannya.
Hasil yang betul ialah "URL tidak diindeks: dikecualikan oleh tag 'noindex'". Hasil yang menunjukkan anda terperangkap ialah "Diindeks tetapi disekat oleh robots.txt": Google mempunyai URL itu, tidak dapat membaca arahannya dan mungkin terus memaparkannya. Jika ini muncul, buang peraturan itu daripada robots.txt dan biarkan noindex melakukan tugasnya.
Anda juga boleh mengambil halaman seperti yang dilihat Googlebot menggunakan simulator crawler. Ia lebih pantas daripada menunggu crawl baharu apabila anda menyemak dua puluh laluan: Googlebot Spider Simulator.
Hasil dijangka. Setiap laluan noindex menunjukkan status dikecualikan kerana noindex dalam beberapa hari selepas crawl seterusnya. Laluan yang dicipta selepas perubahan tidak sepatutnya muncul dalam indeks langsung.
Laluan pemulihan. Jika URL masih diindeks selepas dua minggu, semak sama ada Google boleh crawl-nya, sama ada halaman memulangkan 200 kepada Googlebot, dan sama ada tag canonical atau hreflang sedang menghantar enjin carian ke tempat lain. Gunakan alat Pembuangan hanya sebagai sekatan sementara semasa anda membetulkan puncanya; ia tidak menggantikan arahan tersebut.
Apabila halaman kongsi ialah saluran pertumbuhan
Sesetengah halaman yang dijana memang patut diindeks, dan noindex pada semuanya bermakna menembak kaki sendiri. Inilah yang patut dilindungi:
Corak | Mengapa patut diindeks | Jaminan |
|---|---|---|
Galeri templat awam | Pengguna menerbitkan reka bentuk, orang lain menggunakannya; hasilnya unik dan tahan lama | Moderasi hantaran baharu |
Pembina dengan halaman pameran awam | Hasil sebenar dengan tanda "built with" ialah saluran pengedaran | Simpan templat pameran berasingan daripada halaman pemasaran |
Dokumentasi yang tumbuh daripada utas pengguna | Soalan berulang patut mendapat jawapan kekal yang disunting | Indeks jawapan yang dikurasi, bukan perbualan mentah |
Jika anda dalam salah satu kategori ini, nasihat Google yang lebih lama masih terpakai dan merupakan tuas terbaik: noindex pada kandungan pengguna tanpa reputasi, kemudian buka apabila akaun mempunyai sejarah. Ini memberikan daya tahan terhadap spam tanpa melepaskan gelung penglibatan, dan inilah corak yang disyorkan panduan sebelum kemas kini ini.
Ujian untuk ketiga-tiganya sama. Jika halaman mendapat tayangan dalam Prestasi carian bagi pertanyaan yang orang luar akan taip, ia milik indeks. Jika tayangan datang hanya daripada rentetan URLnya sendiri dan tidak dari mana-mana lagi, ia tidak.
Ada kesan peringkat kedua yang patut dinamakan. URL kongsi awam telah menjadi permukaan pautan murah selama bertahun-tahun: cipta halaman pada platform dengan domain yang kukuh, halakan pautan ke laman anda sendiri, ulang pada dua puluh hartanah. Patrick Stox mengira lebih 20 pautan daripada platform berbeza dalam utas yang sama. Jika platform mengikut panduan, permukaan itu mengecil. Jika tidak, Google kini mempunyai dokumen untuk dirujuk pada masa akan datang apabila ia memutuskan halaman itu spam.
Langkah 5: Instrumentasikan corak yang diterangkan Google
Bahagian pemantauan ialah bahagian kemas kini yang akan dilangkau kebanyakan pasukan, dan justeru bahagian yang menangkap insiden sebenar sebelum ia menjadi tindakan manual.
Empat semakan, setiap satu dengan tempat untuk melihat.
Properti dalam Search Console. Sahkan laman atau subdomain supaya amaran tindakan manual dan keselamatan tiba melalui e-mel. Jika anda mengendalikan platform dengan subdomain bagi setiap penyewa, sahkan induk dan sekurang-kurangnya sampel subdomain; amaran yang tidak sampai ke mana-mana bukan pemantauan.
Trend pengindeksan halaman. Catat garis dasar URL yang diindeks bagi setiap laluan yang dijana hari ini dan pantau lonjakan bertingkat, bukan bunyi bising. URL yang diindeks berganda dalam seminggu pada laluan yang sepatutnya statik ialah isyarat.
Anomali dalam Prestasi carian. Tapis pertanyaan yang tidak berkaitan produk. Halaman spam menarik pertanyaan spam jauh sebelum sesiapa mengadu.
Nisbah penciptaan kepada pengindeksan. Inilah metrik yang dinamakan Google dan hampir tiada siapa mengukurnya: berapa banyak URL yang boleh diindeks dapat dicipta satu akaun sehari dan berapa peratus URL baharu seperti itu datang daripada 1% akaun paling produktif. Ambang amaran pada 3 kali median tujuh hari terakhir bagi setiap akaun adalah sewenang-wenangnya tetapi berkesan; laraskannya mengikut trafik anda.
Nisbah yang sama berguna sebagai pagar keselamatan produk. Jika sesuatu ciri membenarkan pengguna menjana seribu URL yang boleh diindeks sehari, ia ciri yang membengkakkan indeks, walaupun belum ada yang menyalahgunakannya.
Apa yang sebenarnya dikatakan kemas kini ini
Tanggalkan lapisan bahasa — dan Google sedang berhujah tentang satu cadangan.
Dua puluh tahun dasar spam menerangkan halaman: nipis, dicakar, disamarkan, dipenuhi kata kunci. Kategori itu mengandaikan bahawa seseorang manusia atau skrip memutuskan untuk mencipta halaman, dan Google memutuskan sama ada ia layak mendapat kedudukan. Hasil yang dijana memecahkan model itu. Satu keputusan produk boleh mencipta sejuta URL, semuanya unik dari segi teknikal, semuanya memulangkan 200 dari segi teknikal, kebanyakannya tiada nilai kepada orang yang tidak menciptanya. Google tidak boleh menilai satu per satu dan telah berhenti berpura-pura boleh.
Reaksi terbahagi kepada dua kem. Yang pertama membacanya sebagai tembakan amaran: Marie Haynes bertanya sama ada tindakan manual baharu akan menyusul untuk alat AI dan pembina aplikasi, dan Lily Ray menganggap bahagian itu sebagai isyarat tentang apa yang Google sudah lawan pada skala besar, menyebut artifak Claude, halaman kongsi ChatGPT dan catatan media sosial. Kem kedua mengangkat bahu. Pasukan yang berhati-hati telah meletakkan noindex pada laporan janaan pengguna selama bertahun-tahun, beberapa balasan berhujah, dan halaman janaan Google sendiri ialah masalah yang lebih besar. Kedua-dua bacaan boleh benar. Yang menjadikan nasihat itu penting bukan kerana ia baharu, tetapi kerana ia kini ditulis di tempat yang boleh dirujuk semasa penguatkuasaan.
Jadi nasihat itu mengalihkan keputusan lebih tinggi dalam rantaian. Platform dijangka membuat keputusan pada peringkat templat: kelas URL mana yang tergolong dalam indeks. Itu soalan tadbir urus, bukan SEO, dan sebab itulah nasihat itu berada dalam panduan spam dan bukan dokumentasi pengindeksan.
Bagi carian AI, logik yang sama berjalan dalam kedua-dua arah. Ciri AI Google mengambil daripada indeks Google, jadi arahan noindex membuang halaman daripada kumpulan itu dan daripada pautan biru. Jika halaman yang dijana sedang mengumpul sitasi dalam AI Overviews, jangkakan ia berhenti. Bagi pautan kongsi itu biasanya betul, bagi halaman templat tidak. Crawler AI lain mempunyai peraturan sendiri, jadi putuskan secara berasingan yang mana antara mereka dibenarkan crawl halaman ini.
Kesimpulan praktikalnya satu ayat yang boleh dibawa ke semakan reka bentuk: setiap URL yang boleh dicipta pengguna sama ada permukaan produk atau komitmen terhadap indeks, dan templat menentukan yang mana satu.
Soalan lazim
Adakah ini terpakai kepada laman pemasaran biasa?
Tidak, jika laman anda tidak menjana URL daripada input pengguna. Laman pemasaran menerbitkan satu set halaman yang seseorang manusia telah putuskan patut wujud — bertentangan dengan masalah yang diterangkan panduan itu. Baris tentang skala menyebut platform pengehosan dan alat yang membenarkan pengguna menerbitkan halaman untuk dikongsi, kandungan yang dijana atau aplikasi web. Jika anda mempunyai komen, forum atau profil ahli, nasihat yang lebih lama terpakai: nofollow atau ugc pada pautan daripada akaun tidak dipercayai, dan noindex untuk pengguna baharu sehingga mereka membina reputasi.
Guna robots.txt atau meta tag noindex?
noindex, dan hanya satu daripada dua bagi setiap laluan. Ayat Google menyenaraikan kedua-dua pilihan, tetapi kedua-duanya melakukan perkara berbeza. Disallow dalam robots.txt menyekat crawling, dan URL yang disekat tetapi dipaut dari luar mungkin kekal dalam hasil tanpa petikan. noindex hanya berkesan apabila Google boleh crawl halaman itu dan membacanya. Dalam praktiknya ini bermakna meta tag atau pengepala respons, dan tidak pernah peraturan robots.txt pada laluan yang sama.
Adakah saya akan kehilangan trafik jika meletakkan noindex pada halaman kongsi?
Semak laluan itu sebelum keputusan, bukan selepasnya. Jika halaman hanya mendapat tayangan daripada rentetan URLnya sendiri, ia tidak membawa trafik organik dan membuangnya tidak merugikan apa-apa. Corak yang kehilangan trafik ialah apabila galeri awam dirobohkan bersama semua yang ada di dalamnya. Biarkan galeri diindeks, letakkan noindex pada bahagian di bawahnya, dan pantau prestasi carian bagi pertanyaan galeri sebelum dan selepas.
Adakah enjin carian AI mematuhi noindex?
Ciri AI Google ya, kerana AI Overviews dan AI Mode mengambil daripada indeks yang sama, jadi arahan itu membuang halaman daripada pautan biru dan daripada jawapan AI. Crawler AI lain ialah keputusan berasingan. Tingkah laku pembekal berbeza dan berubah tanpa log perubahan, jadi baca dokumentasi setiap crawler dan ambil halaman dengan user agent-nya, daripada menganggap satu arahan meliputi semuanya.
Penulis: Grace Miller, penganalisis risiko AI Search di Auspia. Menjejaki lebih 200 perubahan dasar. Menulis tentang peraturan platform, risiko kandungan dan pengoptimuman yang mengambil kira dasar.